
Cursus
Introductie tot dbt
4 uur
34K
Een van de vereiste concepten die je moet kennen is dat van een datawarehouse. Een warehouse is waar je alle data opslaat die bij een bedrijf hoort.
Bedrijven bouwen warehouses omdat ze analysemogelijkheden en alles wat je verder met data kunt doen mogelijk maken (ahum, gestructureerde data). Ze slaan historische data op, geordend in tabellen, en zijn ingericht voor snel query’en en analyseren.
Er zijn veel tools die datawarehouses implementeren:
enzovoort.
dbt helpt je niet om data te verzamelen of in bovenstaande tools te laden, maar om data daarbinnen te transformeren. Met andere woorden: het doet de T in het ETL/ELT-proces (extractie, transformatie, laden) dat het hart vormt van alle warehouses.
dbt wordt aangeboden via twee interfaces: dbt Core en dbt Cloud.
dbt Core is een open-sourcebibliotheek die het grootste deel van de functionaliteit van dbt implementeert. Het heeft een command-line-interface (het dbt-commando waar je dol op wordt) die je kunt gebruiken om datatransformaties in je projecten te beheren.
dbt Cloud is een enterprise-oplossing voor teams. Bovenop de CLI biedt dbt Cloud ook een gebruiksvriendelijkere webgebaseerde IDE. Daarmee hoef je je minder druk te maken om databaseverbindingen en het bewerken van YAML-bestanden (zoals je in de komende secties zult zien).
dbt Cloud biedt ook extra functies zoals taakscheduling, geavanceerde integraties en support met hoge prioriteit.
Hier is een tabel die de verschillen tussen dbt Core en dbt Cloud samenvat:
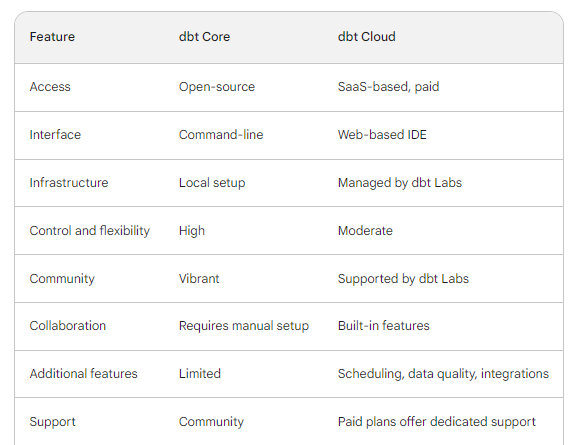
Ondanks de extra functies behandelen we dbt Core, omdat dit het meest geschikt is voor lokale projecten, testen en leren. Je kunt het met pip op elk besturingssysteem installeren (natuurlijk binnen een virtuele omgeving).
Ik gebruik een Conda-omgeving:
$ conda create -n learn_dbt -y
$ pip install dbt-<adapter_name>
Vervang adapter_name door de database die je wilt gebruiken. dbt Labs (het bedrijf achter dbt) heeft veel adapters voor verschillende dataplatforms geïntegreerd.
In dit artikel gebruiken we de dbt-duckdb-adapter om verbinding te maken met een DuckDB-database. Maar je kunt elke adapter gebruiken die op deze pagina van de dbt-docs staat.
$ pip install dbt-duckdb
Dat was het voor de eerste setup!
In feite is een dbt-project een map op je machine met alles wat nodig is om transformaties op je data uit te voeren. Het bevat veel .sql-bestanden (zogenaamde modellen) en YAML-bestanden (voor configuraties).
Om een dbt-project te maken, kun je op de CLI het commando dbt init <project_name> gebruiken:
$ dbt init dbt_learnDe terminal vraagt je een code in te voeren die overeenkomt met je beschikbare dataplatformadapters. Omdat je alleen DuckDB hebt, kun je 1 indrukken.
$ cd dbt_learn
Binnen dbt_learn heb je de volgende structuur:
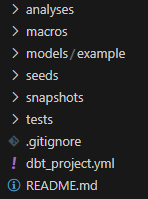
Hier worden data engineers software-engineers, omdat dbt-projecten je het volgende laten doen:
Kortom, dbt-projecten bieden een krachtige manier om datatransformaties te beheren en te orkestreren. Ze brengen de langverwachte voordelen van software-engineering naar de datawereld.
We hebben een dbt-project geïnitialiseerd en nu moeten we verbinding maken met een bestaande database (of er vanaf nul een aanmaken). Hiervoor hebben we een veilige manier nodig om database-inloggegevens aan dbt door te geven om een verbinding tot stand te brengen. Daarvoor gebruiken we een projectprofiel.
Een projectprofiel is een YAML-bestand met de verbindingsgegevens voor je gekozen dataplatform. Het bestand zelf wordt aangemaakt in de map .dbt in $HOME en heet profiles.yml. Zo ziet het er nu uit:
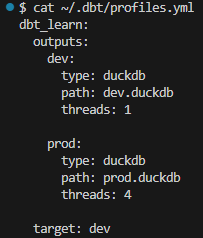
Het bestand vermeldt één profiel met de naam dbt_learn voor ons project. Het specificeert twee outputs: dev en prod.
Outputs zijn afzonderlijke configuraties die verschillende verbindingen met datawarehouses of databases specificeren. Via outputs kun je verbindingen naar verschillende omgevingen beheren:
In ons profiel is onze standaardoutput dev, wat in het veld target staat. Je kunt dit wijzigen naar elke andere output op basis van je behoeften. Voor nu laten we het zo.
Let op: je kunt de profiel- en outputnamen veranderen zolang ze elders in de dbt-bestanden maar correct worden verwezen.
Het veld path geeft de locatie op van een bestaande database genaamd dev.duckdb. Als die niet bestaat, wordt hij door de dbt DuckDB-adapter in onze werkmap aangemaakt (binnen het dbt_learn-project; het veld path specificeert paden relatief aan de projectmap). Omdat we nog geen database dev.duckdb hebben, laten we dbt die aanmaken door dbt debug uit te voeren.
$ dbt debug
De subopdracht debug wordt gebruikt om veel aspecten van het project te testen, zoals:
profiles.ymlprofiles.ymldbt_project.yml, enzovoort.Als je een groene melding “All tests passed” hebt gekregen en er een nieuwe dev.duckdb-database is verschenen, dan kun je door.
Modellen vormen het hart van dbt, omdat ze de feitelijke transformaties vertegenwoordigen waar dbt om bekendstaat.
Een datamodel is een conceptueel idee dat de structuur en relaties binnen een dataset weergeeft. Datamodellen in dbt zijn eenvoudiger en specifieker. Ze hebben de volgende kenmerken:
.sql-bestanden (Python is toegestaan in nieuwere versies van dbt)Ons dbt_learn-project wordt geleverd met twee voorbeeldmodellen in models/example:
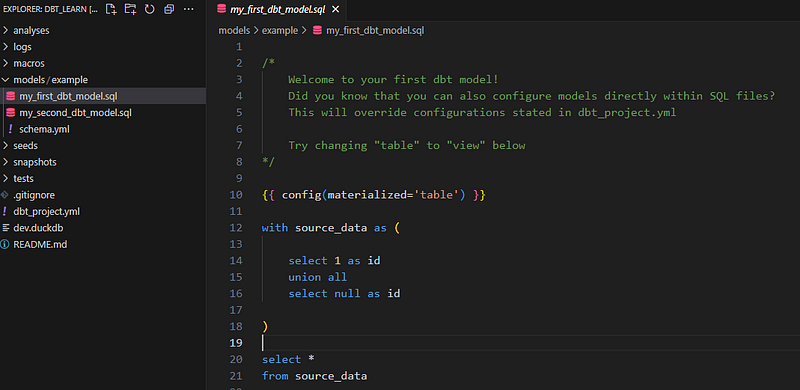
Die verwijderen we en we maken onze eigen:
$ rm -rf models/example
$ mkdir models/stats
$ touch models/stats/average_diamond_price_per_group.sql
In de laatste regel van het bovenstaande codefragment maken we een model met de naam average_diamond_price_per_group in de map stats. Het is belangrijk om beschrijvende modelnamen te gebruiken.
Plak in het model (.sql-bestand) deze dummy test-SQL-query:
SELECT 1 AS Id
en voer het model uit met dbt run:
$ dbt run
Je zou een groene melding “Completed successfully” moeten ontvangen.
Als alles is ingericht, kunnen we wat data in onze dev.duckdb-database laden. We gebruiken hiervoor een parquet-bestand, omdat DuckDB die native ondersteunt.
SELECT AVG(price), cut
 FROM "diamonds.parquet"
GROUP BY cut
De query zou dezelfde succesmelding moeten geven.
Voor deze tutorial heb ik de diamonds-dataset voorbereid als een parquet-bestand. In deze GitHub-gist vind je de snippet om het naar je workspace te downloaden.
We hebben zojuist gezien hoe je ons eerste dbt-model maakt met een SELECT-statement dat wat samenvattende statistieken over een dataset teruggeeft. In de praktijk hangen je modellen af van je bedrijfsvereisten en hoe verschillende medewerkers met je database werken. Daarom focussen we niet op de eigenlijke logica van dbt-modellen, maar op hoe je ze correct implementeert.
In een realistisch project zijn je modellen waarschijnlijk afhankelijk van elkaar, waardoor een soort hiërarchie ontstaat. In de datawereld heet deze hiërarchie een Directed Acyclic Graph (DAG) of lineage-graph.
Één enkele DAG kan het werk doen van 1000 woorden documentatie. Kijk naar dit voorbeeld van de dbt DAGs-pagina:
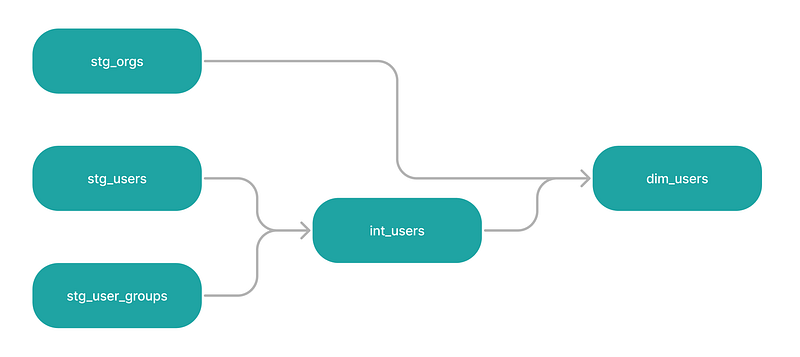
Er staan vier modellen in deze grafiek, allemaal lineair verbonden met downstreammodellen. stg_users en stg_user_groups zijn bovenliggende modellen van int_users, dat op zijn beurt een bovenliggend model is van dim_users, samen met het upstreammodel stg_orgs.
Let op: de woorden upstream en downstream worden vaak gebruikt om de relatieve positie van elk model in de DAG aan te duiden.
Een belangrijk kenmerk van DAG’s is dat er geen gesloten lussen zijn. Dit betekent dat een downstreammodel, dat het resultaat is van eerdere modellen, niet kan worden gejoined met een upstreammodel. Daar komt het woord acyclisch vandaan.
Naast de visuele rijkdom van DAG’s is hun doel om dbt modellen te laten bouwen/updaten volgens hun afhankelijkheden. Als we voor de vier bovenstaande modellen geen DAG definiëren, bouwt dbt ze in alfabetische volgorde. Dat leidt tot allerlei rode meldingen en fouten.
Om een DAG in dbt te definiëren, gebruiken we Jinja-templating.
In de bovenstaande DAG is het model int_users het product van stg_users en stg_user_groups. We moeten deze relatie in ons project specificeren, anders voert dbt run alle modellen alfabetisch uit, wat betekent dat int_users als eerste gaat. Dit resulteert in een fout omdat de afhankelijkheden nog niet zijn gematerialiseerd.
Op dit moment ziet het model int_users er mogelijk zo uit:
SELECT some_column
 FROM stg_users as su
 JOIN stg_user_groups as sug
   ON su.a = sug.a
Nu linken we de drie modellen door ze met Jinja in knopen van een DAG te veranderen:
SELECT some_column
 FROM {{ ref("stg_users") }} as su
 JOIN {{ ref("stg_user_groups" )}} as sug
   ON su.a = sug.a
In plaats van de modelnamen direct te schrijven, plaatsen we ze in een Jinja-functie genaamd ref. De syntaxis is {{ ref("column_name") }} (let op de spaties en de aanhalingstekens). Wanneer onze query wordt gecompileerd, wordt de Jinja-functie vervangen door de daadwerkelijke modelnaam.
Let op dat stg_users en stg_user_groups als .sql-bestanden in je dbt-project moeten bestaan.
Wanneer we nu dbt run uitvoeren, zoekt het naar de afhankelijkheden van elk model, verbindt ze en voert ze dienovereenkomstig uit.
De functie ref in Jinja is niet de enige die we in dbt kunnen gebruiken. Door Jinja’s andere functies en features te gebruiken, kun je de functionaliteit van je SQL-statements aanzienlijk uitbreiden. Hier zijn enkele voorbeelden:
{% set status = 'active' %}  -- Define a variable

SELECT *
FROM customers
WHERE status = {{ status }};
Als we een bestand models/model_properties.yml hebben en dat de volgende velden bevat:
# models/model_properties.yml
version: 2

models:
 - name: my_model
   config:
     target_schema: analytics
Dan kunnen we de velden in elk .sql-bestand met Jinja benaderen:
{% set target_schema = config.target_schema %}

CREATE TABLE {{ target_schema }}.{{ target_table }} AS
...
Conditionals:
{% if some_condition %}
 SELECT * FROM test_data
{% else %}
 SELECT * FROM production_data
{% endif %}
Loops:
SELECT
 order_id,
 {% for payment_method in ["bank_transfer", "credit_card", "gift_card"] %}
   SUM(CASE WHEN payment_method = '{{ payment_method }}' THEN amount END) AS {{ payment_method }}_amount,
 {% endfor %}
 SUM(amount) AS total_amount
FROM {{ ref('raw_payments') }}
GROUP BY 1;
Hier is de macro:
{% macro create_table(table_name, columns) %}
 CREATE TABLE {{ table_name }} (
   {% for column in columns %}
     {{ column.name }} {{ column.type }},
   {% endfor %}
 );
{% endmacro %}
En zo kun je hem in modellen gebruiken:
{% call create_table('my_customer_table', [
   {'name': 'id', 'type': 'integer'},
   {'name': 'name', 'type': 'varchar(255)'},
   {'name': 'email', 'type': 'varchar(255)'},
]) %}

INSERT INTO {{ my_customer_table }} (id, name, email)
SELECT customer_id, customer_name, customer_email
FROM raw_customers;
Wil je meer leren over Jinja in dbt met SQL, bekijk dan deze pagina van de dbt-docs.
Een goede softwareontwikkelaar weet dat je je code constant moet testen op bugs en fouten. Omdat dbt van data engineers softwareontwikkelaars maakt, biedt het een eenvoudige workflow om tests te gebruiken, zowel ingebouwd als op maat.
Momenteel biedt dbt de volgende vier ingebouwde tests:
unique - verifieer dat alle waarden uniek zijnnot_null - controleer op missende waardenaccepted_values - verifieer dat alle waarden binnen een opgegeven lijst vallen; heeft een argument valuesrelationships - verifieert een verbinding met een specifieke tabel of kolom; heeft de argumenten to en fieldOm te specificeren welke tests je op welke kolommen gebruikt, hanteren we een YAML-bestand genaamd model_properties.yml in de map models.
Let op: model_properties.yml is geen vereiste om modellen te laten draaien en het bestand kan elke naam hebben. Maar als je tests wilt maken om de data die je modellen voedt te valideren, dan is dit bestand een must.
Laten we zien hoe je de test not_null gebruikt om te controleren op missende waarden in de kolom cut van de tabel diamonds. Maak eerst een bestand model_properties.yml in models:
$ touch models/model_properties.yml
Plak vervolgens de volgende inhoud erin:
version: 2

models:
 - name: average_diamond_price_per_group
   columns:
     - name: cut
       tests:
         - not_null
In het veld - name onder models geven we aan voor welk model we eigenschappen definiëren. Vervolgens specificeren we de kolom en de naam ervan. Ten slotte schrijven we het veld tests, waaronder we de test not_null opnemen.
Nu kun je deze test gebruiken om datavalidatie uit te voeren voordat je dbt run draait. Het commando is dbt test:
$ dbt test
Als je een foutmelding ontvangt, betekent dit dat de test is mislukt en dat je het probleem in de tabel moet onderzoeken en waar nodig oplossen.
Om dbt succesvol in je projecten te gebruiken, kun je deze aanbevolen workflow volgen:
1. Projectinitialisatie
dbt en maak een nieuw project met dbt init2. Configuratie
profiles.yml in je thuismap.dbt_project.yml voor projectinstellingen (bijv. versie, dependencies).3. Ontwikkeling
.sql-bestanden in de map models voor modeldefinities..yml-bestanden in de map tests voor testdefinities.dbt test om tijdens de ontwikkeling vaak tests te draaien.dbt debug voor troubleshooting.4. Lokale validatie (onderwerpen die we niet hebben behandeld)
Aanvullende best practices:
dbt docs generate gebruiken om later de documentatie van modellen op een webserver te renderen (ja, dat kan).We hebben in deze tutorial veel basisprincipes behandeld, maar zoals ik in het begin al zei, is dbt een enorme tool met veel features. Het kost tijd om het zo onder de knie te krijgen dat je het met een gerust hart in productieomgevingen gebruikt. Waarom zou je deze resources niet gebruiken om dat doel sneller te bereiken?
Begin vandaag nog aan je dbt-reis!
Cursus
Cursus
Cursus
blog
Adel Nehme
15 min

