
Leerpad
Basisprincipes van AI-business
12 uur
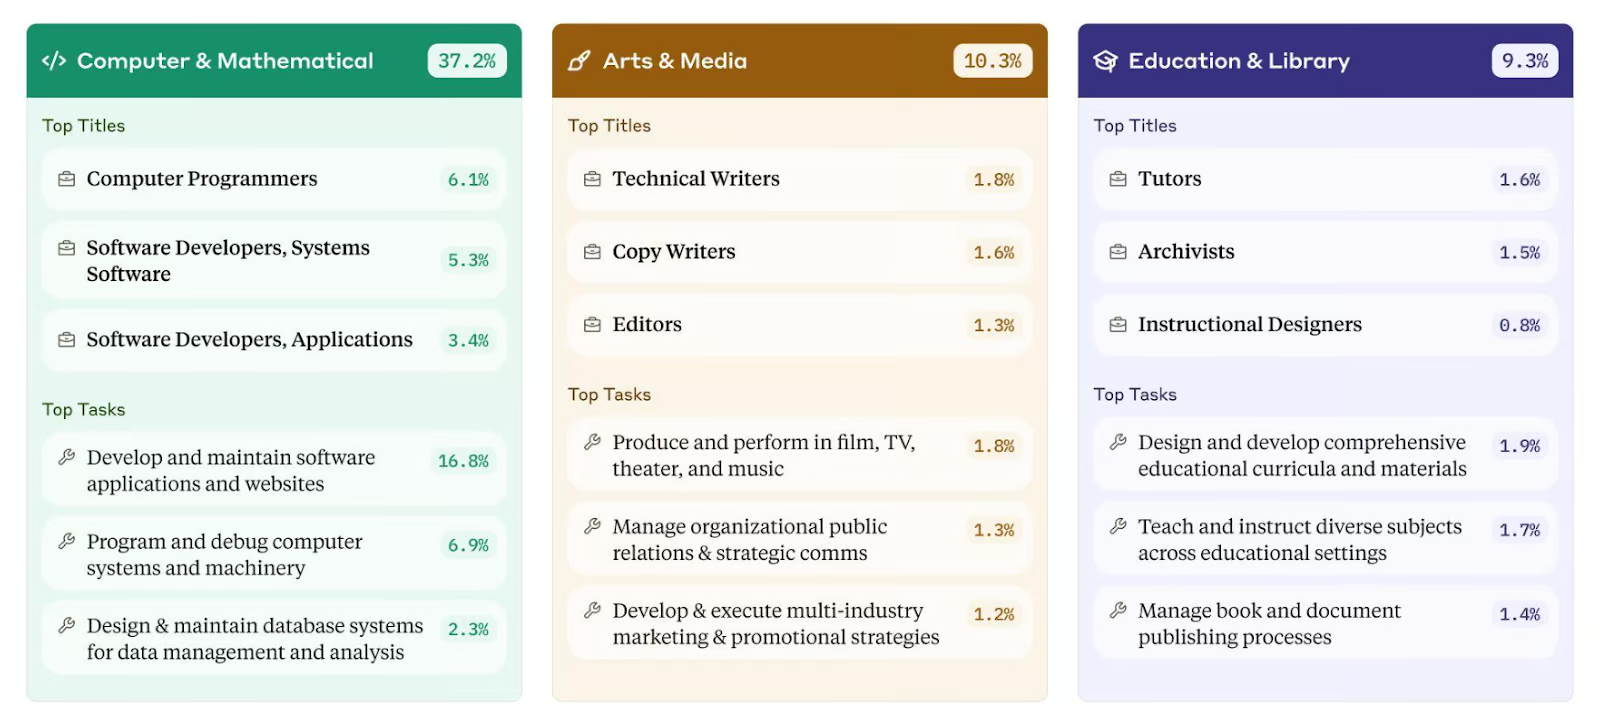
Redeneermodellen worden belangrijker en gangbaarder, en we zien waarom. Als je naar de grafiek hieronder kijkt, valt op dat 37,2% van de gebruikers Claude inzet voor codeer- en wiskundevragen, volgens de Anthropic Economic Index. Dat vertelt ons één ding—sterke redeneermodellen kunnen echte businesswaarde opleveren, zeker nu de adoptie van AI in ondernemingen nog laag is.
Bron: Antrophic Economic Index
Tegelijkertijd is Claude 3.7 niet alleen een redeneermodel—het is een hybride. We kunnen schakelen tussen Thinking Mode (voor gestructureerde redeneertaken) en een standaard chatmodus voor algemene conversatie, schrijven en samenvatten.
Claude 3.7 Sonnet is een veel grotere upgrade dan het versienummer doet vermoeden. De benchmarkdata bevestigt dat het beter presteert dan Claude 3.5 Sonnet in redeneren, coderen en het uitvoeren van real-world taken.
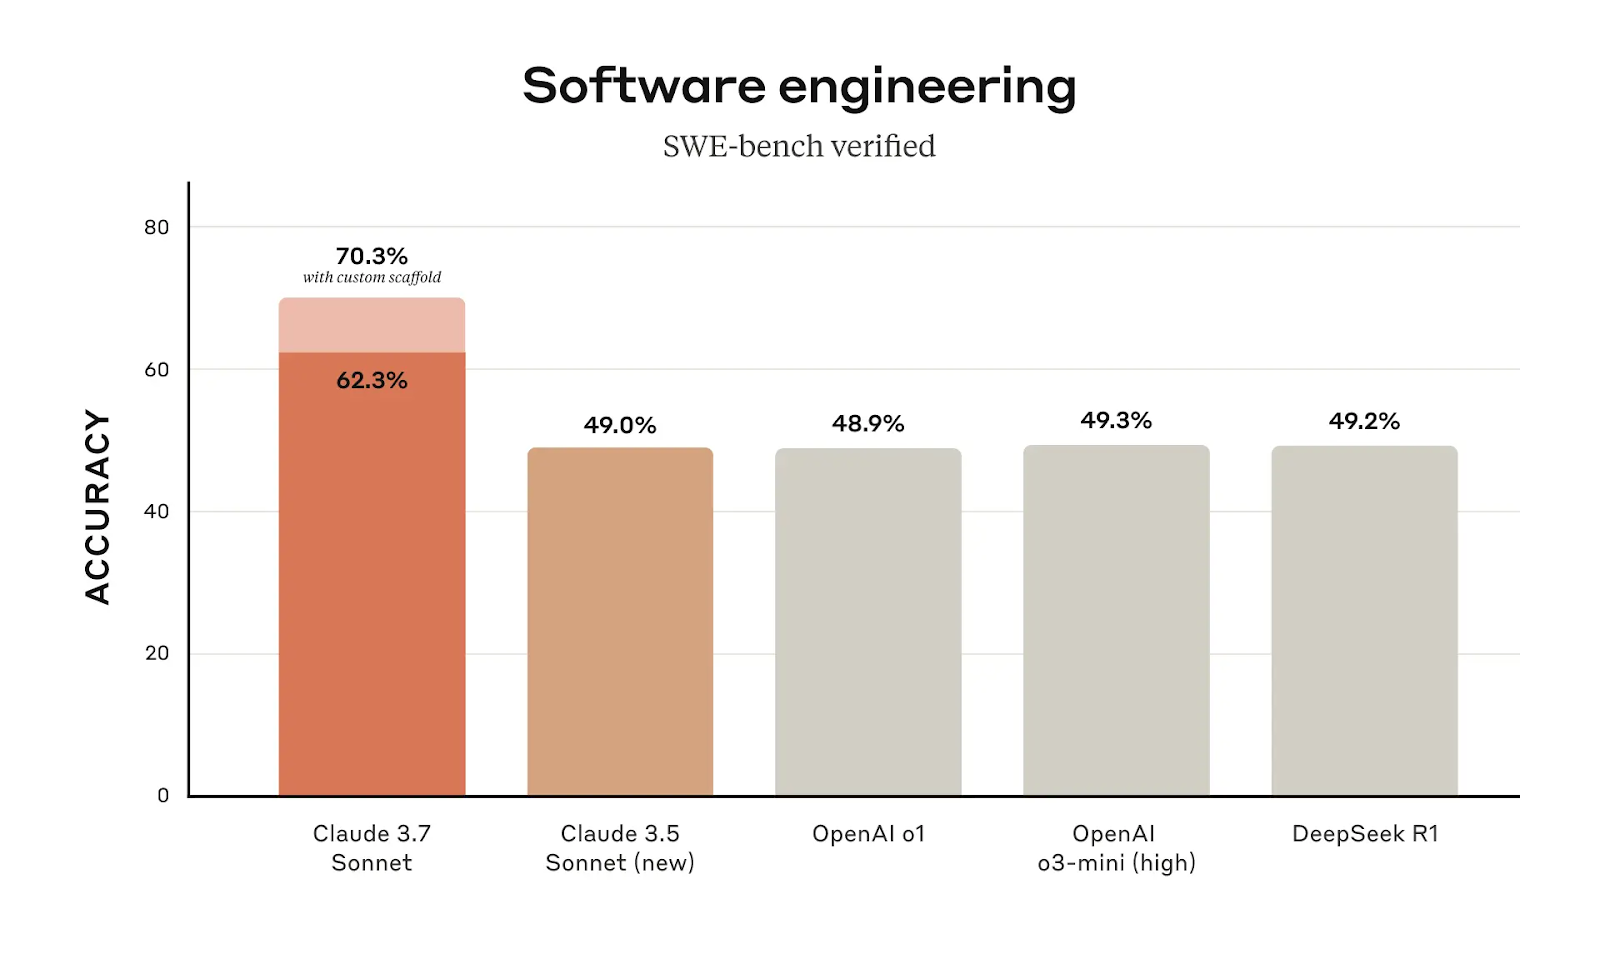
Claude 3.7 Sonnet laat een duidelijke voorsprong zien in software-engineering, met een nauwkeurigheidsscore van 62,3% in SWE-bench Verified, een flinke sprong vanaf 49,0% voor Claude 3.5 Sonnet. Met een custom scaffold (een gestructureerde prompt of extra context die het model helpt om tot een nauwkeurigere oplossing te komen) stijgt die nauwkeurigheid naar 70,3%, waarmee het het best presterende model in deze categorie is.
Bron: Anthropic
Een verbetering van bijna 13% in nauwkeurigheid tussen modelversies is niet slechts een kleine verfijning. Het suggereert dat Claude 3.7 Sonnet is geoptimaliseerd voor beter begrip en uitvoering van programmeertaken. Voor gebruikers die vertrouwen op Claude voor software-engineering, debuggen of automatisering maakt de upgrade een tastbaar verschil.
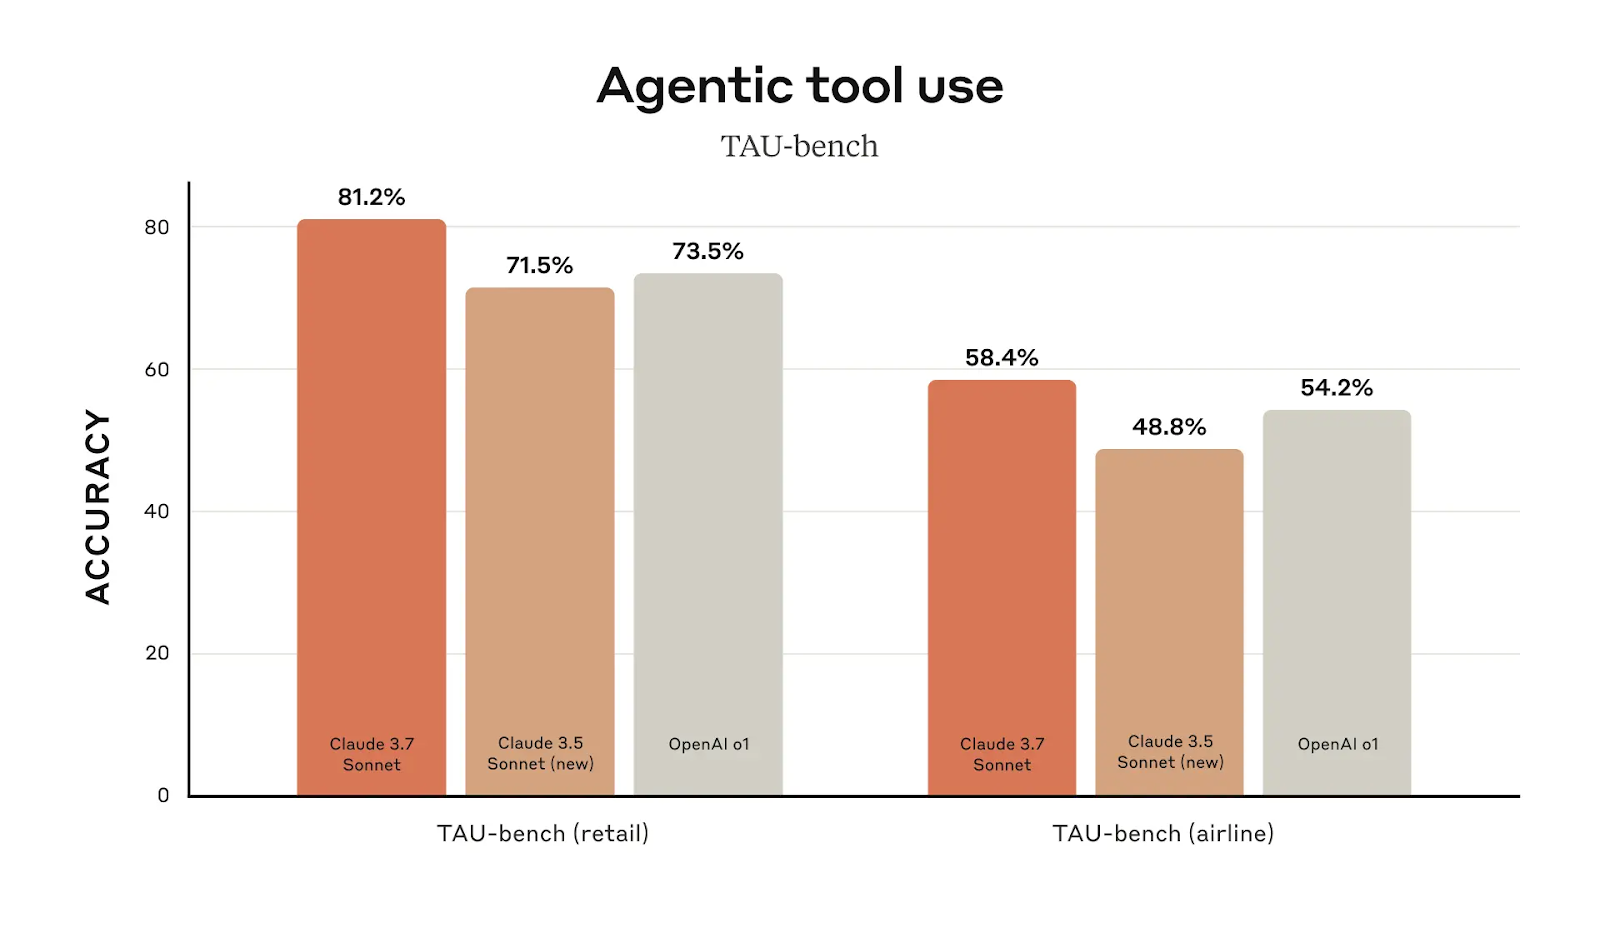
Prestaties in agentisch toolgebruik is een ander gebied waar Claude 3.7 Sonnet zijn voorganger overtreft. Bij retail-gerelateerde taken haalt het 81,2% nauwkeurigheid, omhoog van 71,5% voor Claude 3.5 Sonnet. Bij airline-gerelateerde taken scoort het 58,4%, bijna tien punten hoger dan de vorige versie.
Bron: Anthropic
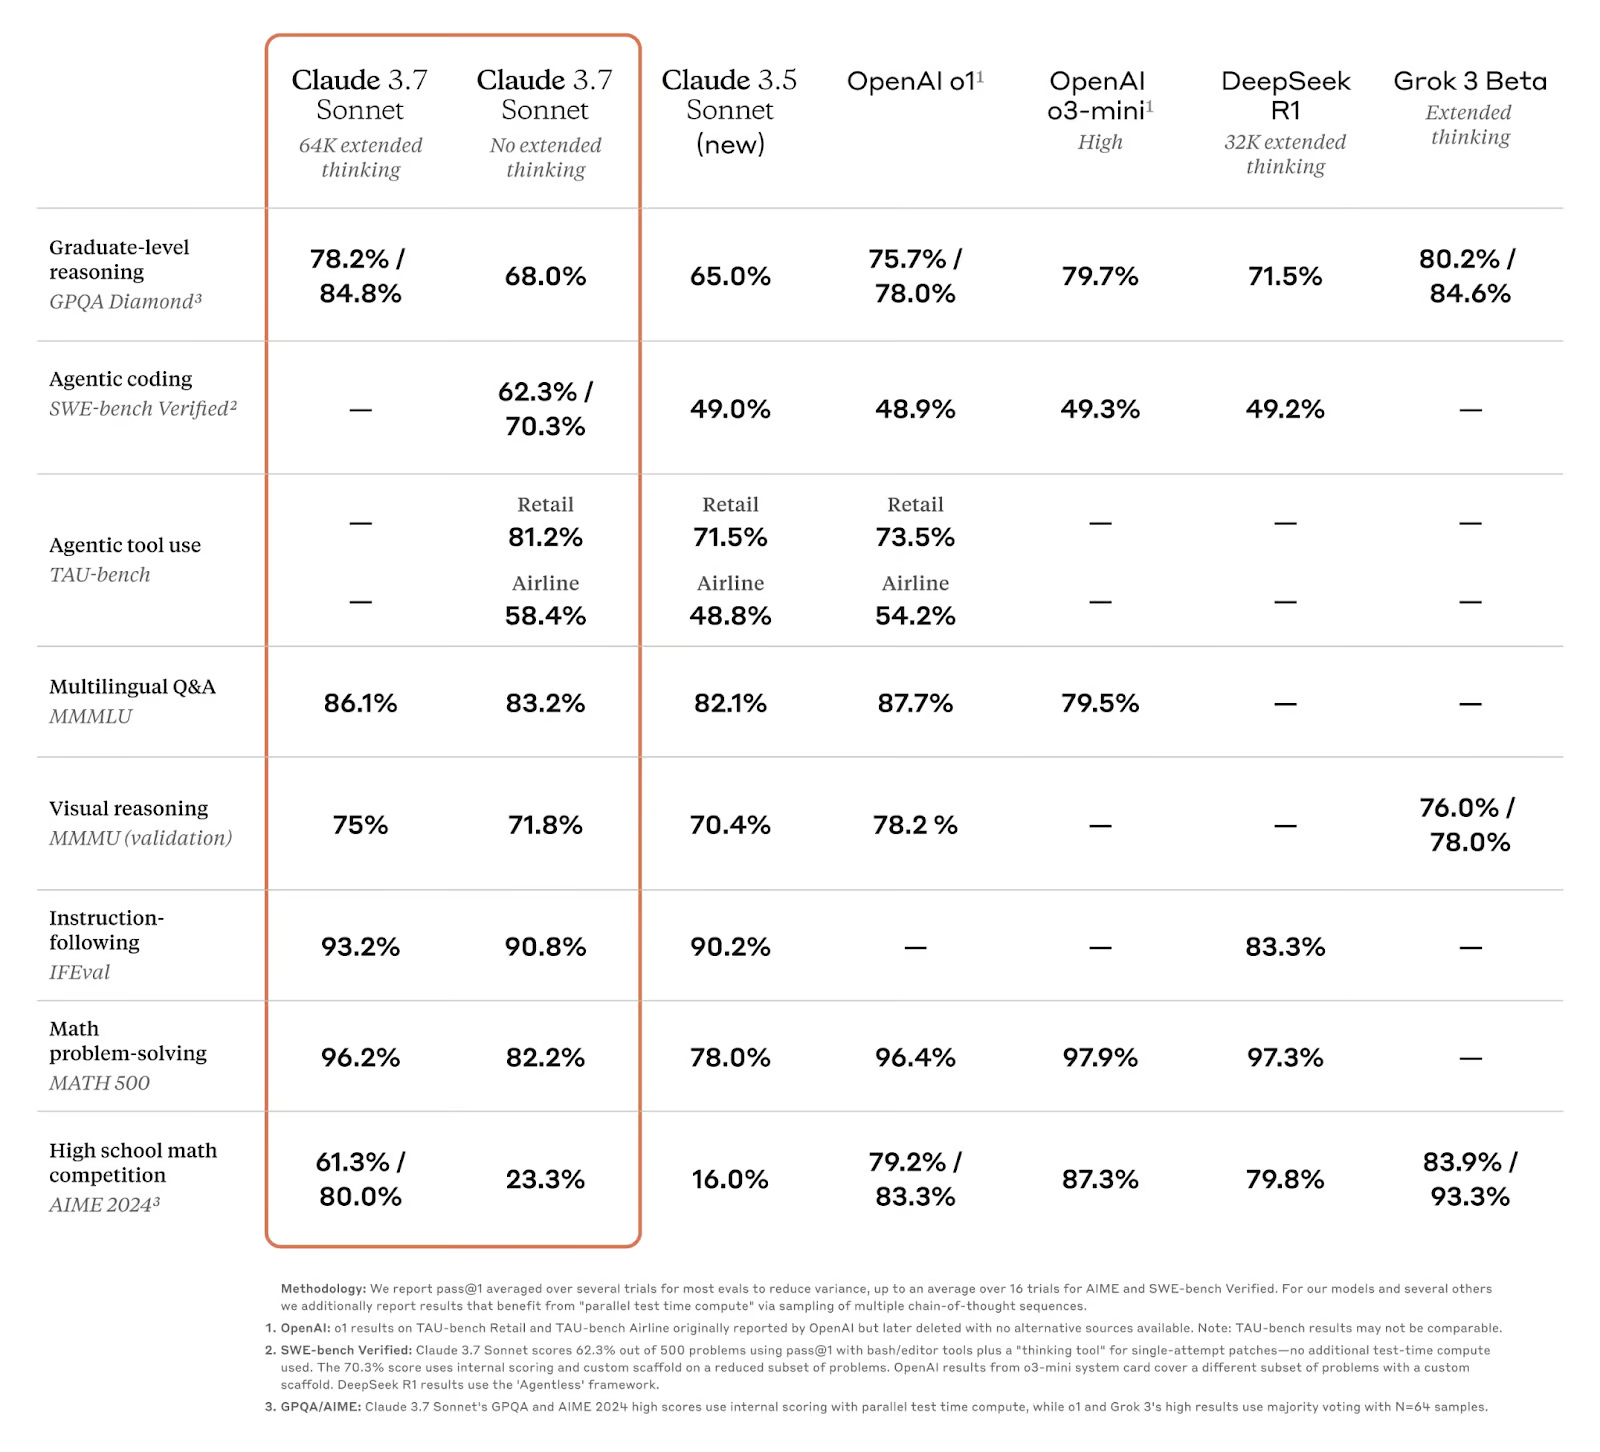
Over alle benchmarks komen de grootste winstpunten door extended thinking mode, waardoor Claude 3.7 op een veel hoger niveau kan presteren bij complexe redeneertaken. Gebruikers die AI inzetten voor gestructureerde workflows, coderen of probleemoplossing zien een duidelijk verschil tussen Claude 3.5 en Claude 3.7, vooral met extended thinking.
Bron: Anthropic
Het meeste van deze vooruitgang komt door Claude’s extended thinking, dus laten we daar meer over te weten komen.
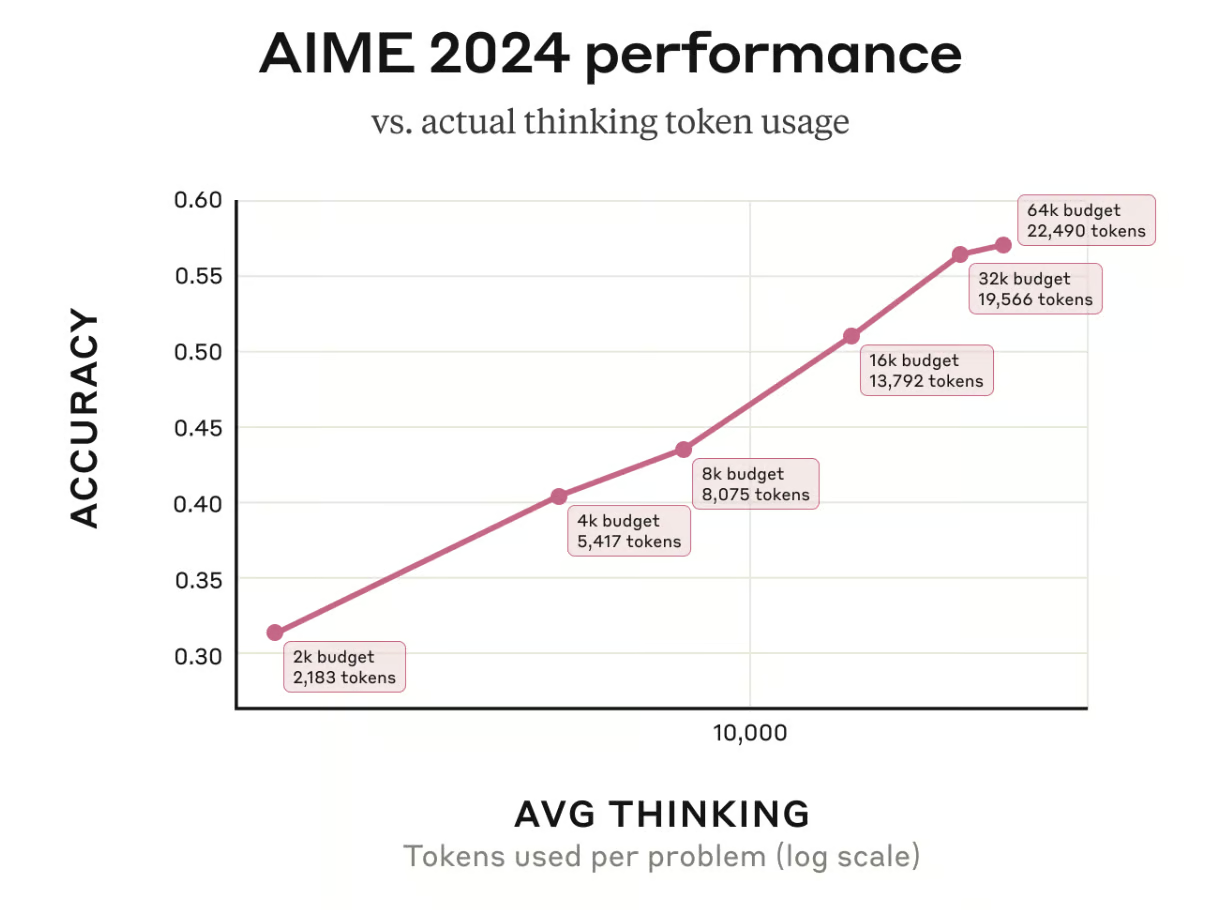
Wanneer ingeschakeld, verhoogt extended thinking mode het aantal redeneerstappen dat Claude neemt voordat een antwoord wordt afgerond. Ontwikkelaars kunnen dit proces fijnregelen door een thinking budget in te stellen, dat bepaalt hoeveel tokens het model kan gebruiken tijdens het doorwerken van een probleem. Zoals te zien is in de AIME 2024-prestatiegrafiek hieronder, verbetert de nauwkeurigheid naarmate er meer tokens worden toegewezen, volgens een logaritmische trend.
Bron: Anthropic
Deze aanpak weerspiegelt menselijke cognitieve inspanning: voor simpele taken volstaan snelle antwoorden, maar voor complexe taken levert diepere analyse betere resultaten op. Claude kan nu beslissen wanneer te pauzeren, te herevalueren en zijn redenering te verfijnen in plaats van standaard direct te antwoorden.
Een van de interessantste aspecten van extended thinking mode is dat Claude’s redeneerproces zichtbaar is voor de gebruiker. Deze functie brengt echter uitdagingen met zich mee. Hoewel het inzicht biedt in AI-redenering, komt het weergegeven denkproces niet altijd perfect overeen met hoe het model daadwerkelijk beslissingen neemt. Het “faithfulness-probleem”—of de zelfgerapporteerde gedachten van een AI zijn interne werking nauwkeurig weergeven—blijft een open onderzoeksvraag.
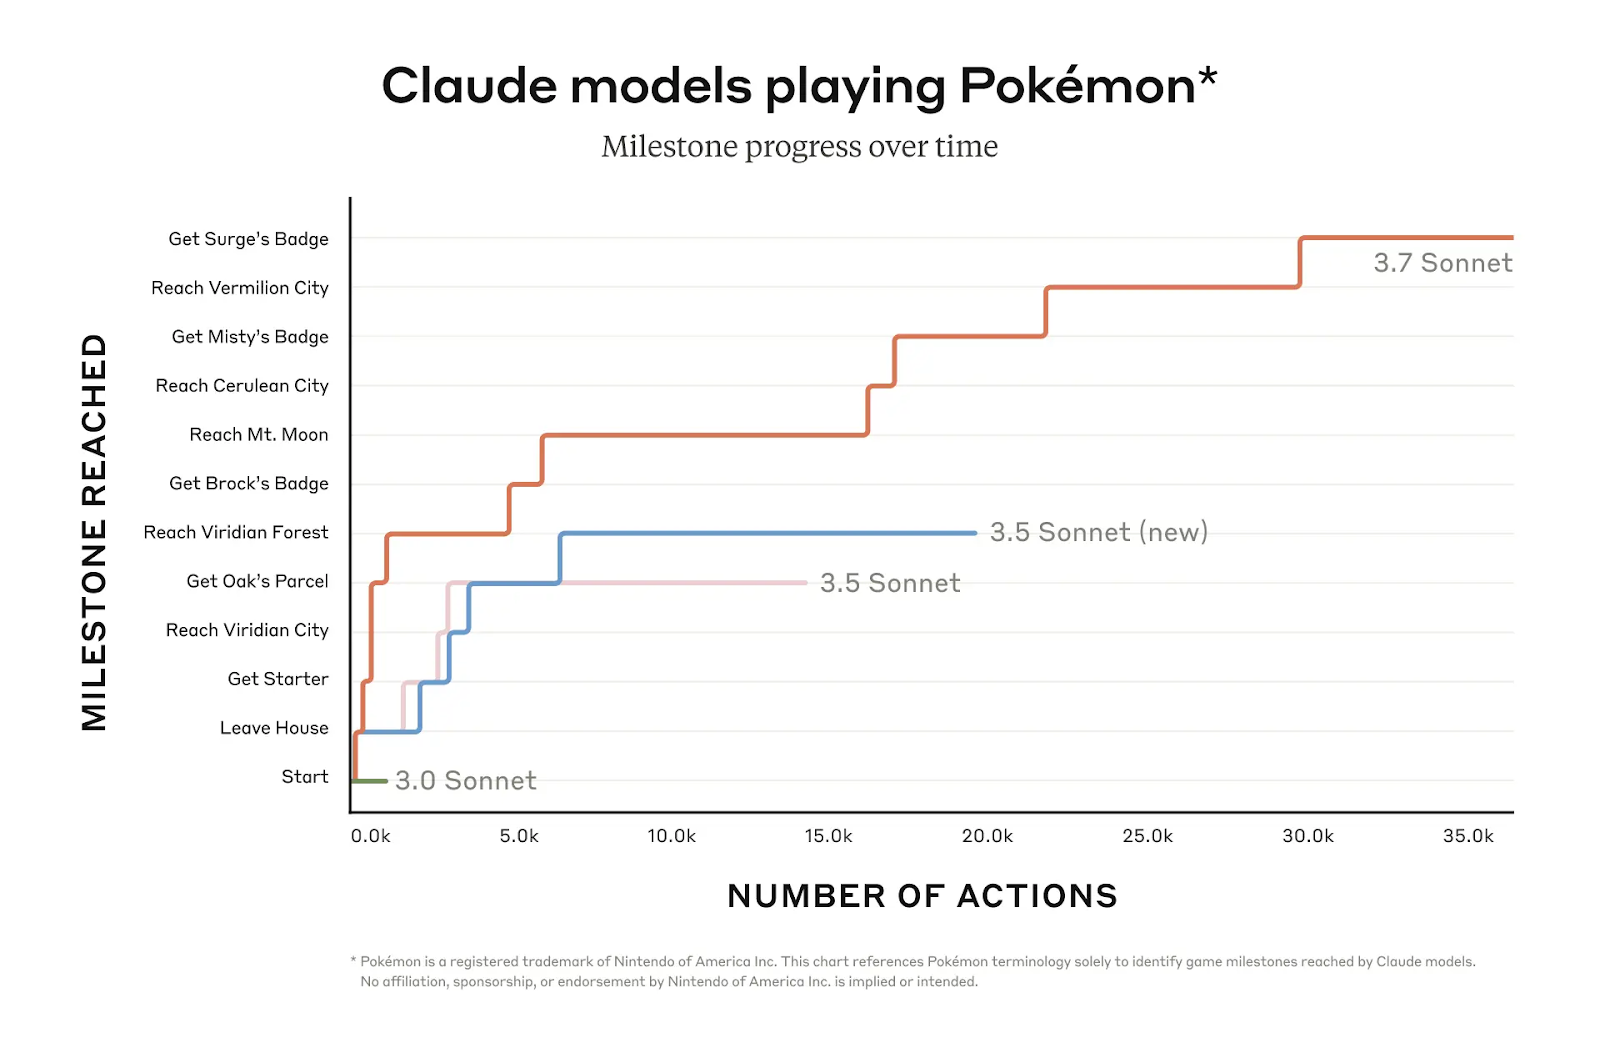
Claude 3.7 Sonnet’s vermogen om zich in te laten met langetermijn- en iteratieve redenering wordt getest in evaluaties zoals OSWorld en Pokémon Red-gameplay. In Pokémon Red, bijvoorbeeld, behaalt Claude 3.7 Sonnet veel meer in-game progressie dan eerdere versies: het doorloopt meerdere mijlpalen terwijl eerdere modellen al vroeg vastlopen.
Bron: Anthropic
We hebben gezien hoe Claude 3.7 Sonnet presteert ten opzichte van de eerdere versie, maar hoe verhoudt het zich tot OpenAI’s o3-mini, DeepSeek-R1 of Grok 3?
Kijkend naar de bijgewerkte benchmarks, heeft Claude 3.7 Sonnet zich gepositioneerd als een van de best presterende modellen, vooral bij taken die veel redeneren vereisen, coderen en agentisch toolgebruik.
Bij redeneren op masterniveau (GPQA Diamond) scoort Claude 3.7 Sonnet 68,0% in standaardmodus en 84,8% in extended thinking mode, waarmee het een van de sterkste modellen in deze categorie is. Het overtreft OpenAI’s o1 (78,0%) en DeepSeek-R1 (71,5%) met een flinke marge en Grok 3 Beta (84,6%) met slechts een kleine marge.
|
Benchmark |
Claude 3.7 Sonnet (Standaard) |
Claude 3.7 Sonnet (Extended Thinking) |
OpenAI o1 |
OpenAI o3-mini (hoog) |
DeepSeek R1 |
Grok 3 Beta |
|
GPQA Diamond (Redeneren op masterniveau) |
68,0% |
84,8% |
78,0% |
79,7% |
71,5% |
84,6% |
|
AIME 2024 (Wiskundewedstrijd middelbare school) |
23,3% |
80,0% |
83,3% |
87,3% |
79,8% |
93,3% |
|
Wiskundeprobleemoplossing (MATH 500) |
82,2% |
96,2% |
96,4% |
97,9% |
97,3% |
- |
De AIME 2024-benchmark, die wiskundeopgaven op wedstrijdniveau voor middelbare scholen test, laat een vergelijkbare trend zien. Claude 3.7 Sonnet maakt een enorme sprong ten opzichte van eerdere versies, met 80,0% wanneer extended thinking is ingeschakeld. Hoewel het DeepSeek-R1 (79,8%) met een kleine marge verslaat, blijft het achter bij OpenAI’s o3-mini (87,3%) en Grok 3 Beta (93,3%).
Bij wiskundeprobleemoplossing (MATH 500) behaalt Claude 3.7 Sonnet 96,2%, dicht in de buurt van OpenAI’s o3-mini (97,9%) en DeepSeek R1 (97,3%).
Claude 3.7 Sonnet boekt zijn grootste winst in codeerbenchmarks. Op SWE-bench Verified (dat AI-modellen evalueert op software-engineeringtaken) scoort Claude 3.7 Sonnet 62,3%, oplopend tot 70,3% met een custom scaffold. Daarmee ligt het ver voor op OpenAI’s o1 (48,9%) en o3-mini (49,3%), evenals DeepSeek R1 (49,2%), dat juist met coderen in gedachten is ontworpen. Dit bevestigt dat Claude 3.7 nu een van de beste AI-modellen is voor programmeergerelateerde taken.
|
Benchmark |
Claude 3.7 Sonnet (Standaard) |
Claude 3.7 Sonnet (Custom Scaffold) |
OpenAI o1 |
OpenAI o3-mini (hoog) |
DeepSeek R1 |
|
SWE-bench Verified (Coderen) |
62,3% |
70,3% |
48,9% |
49,3% |
49,2% |
|
TAU-bench Retail (Toolgebruik) |
81,2% |
- |
73,5% |
- |
- |
|
TAU-bench Airline (Toolgebruik) |
58,4% |
- |
54,2% |
- |
- |
Naast coderen loopt Claude 3.7 Sonnet voorop in agentisch toolgebruik, waardoor het een sterke keuze is voor automatisering en workflow-executie. Op TAU-bench (dat het vermogen van AI test om met externe tools te interageren in gestructureerde omgevingen) scoort Claude 3.7 81,2% bij retail-gerelateerde taken, waarmee het OpenAI o1 (73,5%) voorbijstreeft. Bij airline-gerelateerde taken haalt Claude 3.7 58,4% en presteert daarmee opnieuw beter dan OpenAI o1 (54,2%).
Dit suggereert dat Claude 3.7 goed geschikt is voor bedrijfsapplicaties en gestructureerde workflows, waardoor het een sterke keuze is voor enterprise-gebruikers die AI willen integreren in hun besluitvorming en operationele processen.
Claude 3.7 Sonnet is beschikbaar via meerdere kanalen, waaronder de webinterface van Anthropic, de integratie van Claude in diverse apps en API-toegang voor ontwikkelaars. Hoewel het model een flinke upgrade is, zijn er beperkingen qua beschikbaarheid—vooral als je Thinking Mode wilt gebruiken, die momenteel achter een betaald niveau zit.
Voor algemene gebruikers is Claude 3.7 Sonnet toegankelijk via de officiële website van Anthropic (claude.ai) en de Claude-app. Het is beschikbaar in de gratis laag, maar met beperkingen:
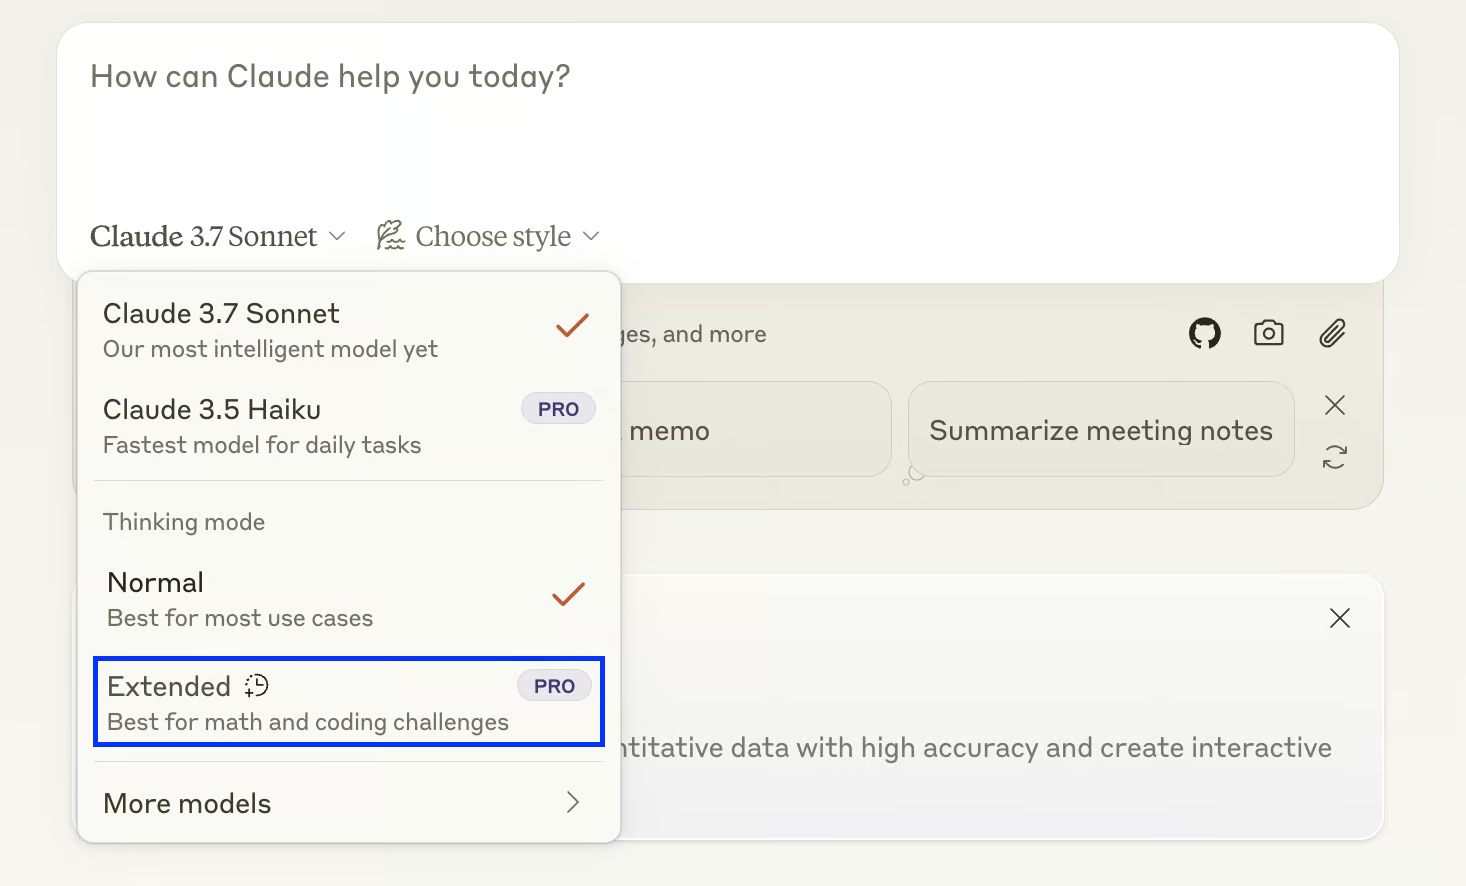
Om Thinking Mode in te schakelen, moet je klikken op Extended in het modelkeuzemenu:
Ontwikkelaars kunnen Claude 3.7 Sonnet integreren in hun applicaties via de API van Anthropic, toegankelijk via Anthropic’s ontwikkelaarsportaal. De API hanteert pay-as-you-go-prijzen op basis van tokenverbruik.
Hier is een overzicht van de API-aanbiedingen van Anthropic:
|
Functie |
Claude 3.7 Sonnet |
Claude 3.5 Sonnet |
Claude 3.5 Haiku |
Claude 3 Opus |
Claude 3 Haiku |
|
Beschrijving |
Ons meest intelligente model |
Ons vorige meest intelligente model |
Ons snelste model |
Krachtig model voor complexe taken |
Snelste en meest compacte model voor bijna directe respons |
|
Sterke punten |
Hoogste niveau van intelligentie en capaciteit met schakelbare extended thinking |
Hoog niveau van intelligentie en capaciteit |
Intelligentie op razendsnelle snelheid |
Topniveau in intelligentie, vloeiendheid en begrip |
Snel en nauwkeurig gericht presteren |
|
Meertalig |
Ja |
Ja |
Ja |
Ja |
Ja |
|
Visie |
Ja |
Ja |
Ja |
Ja |
Ja |
|
Ja |
Nee |
Nee |
Nee |
Nee |
|
|
API-modelnaam |
claude-3-7-sonnet-20250219 |
Geüpgradede versie: claude-3-5-sonnet-20241022 Vorige versie: claude-3-5-sonnet-20240620 |
claude-3-5-haiku-20241022 |
claude-3-opus-20240229 |
claude-3-haiku-20240307 |
|
Vergelijkende latentie |
Snel |
Snel |
Snelst |
Gemiddeld snel |
Snelst |
|
Contextvenster |
200K |
200K |
200K |
200K |
200K |
|
Max output |
Normaal: 8192 tokens Extended thinking:64000 tokens |
8192 tokens |
8192 tokens |
4096 tokens |
4096 tokens |
|
Kosten (Input / Output per MTok) |
$3.00 / $15.00 |
$3.00 / $15.00 |
$0.80 / $4.00 |
$15.00 / $75.00 |
$0.25 / $1.25 |
|
Afbouw trainingsdata |
Okt 2024 |
Apr 2024 |
Juli 2024 |
Aug 2023 |
Aug 2023 |
Bron: Anthropic
Controleer altijd de meest recente API-prijzen.
Anthropic heeft zojuist zijn grootste stap in tijden gezet met Claude 3.7 Sonnet, een model dat het eindelijk brengt in de wereld van redeneer-AI. Op basis van de benchmarks zien we dat het een serieuze concurrent is voor OpenAI’s o3-mini, DeepSeek-R1 en Grok 3, met sterke prestaties in coderen, gestructureerde probleemoplossing en agentisch toolgebruik.
De mogelijkheid om te schakelen tussen generalist- en redeneermodi maakt het veelzijdiger, maar Thinking Mode achter een paywall zetten voelt als een misser, zeker met gratis alternatieven beschikbaar. Toch is Claude 3.7 een grote stap vooruit.
Klaar voor de volgende stap? Bekijk onze Claude 3.7 Sonnet API-video waarin we laten zien hoe je je eigen multimodale onderzoeksassistent bouwt.
Leer AI met deze cursussen!
Leerpad
Leerpad
Cursus
blog
Adel Nehme
15 min

