
Last chance! 50% off DataCamp Premium
Sale ends in
Mythos 5 betekent een stap vooruit ten opzichte van Mythos Preview in elk belangrijk capaciteitsgebied dat Anthropic heeft getest. De winst is het duidelijkst bij autonoom werk met een lange horizon, vooral in wetenschappelijke domeinen van redeneren en visietaken. Zo ziet dat er in de praktijk uit.
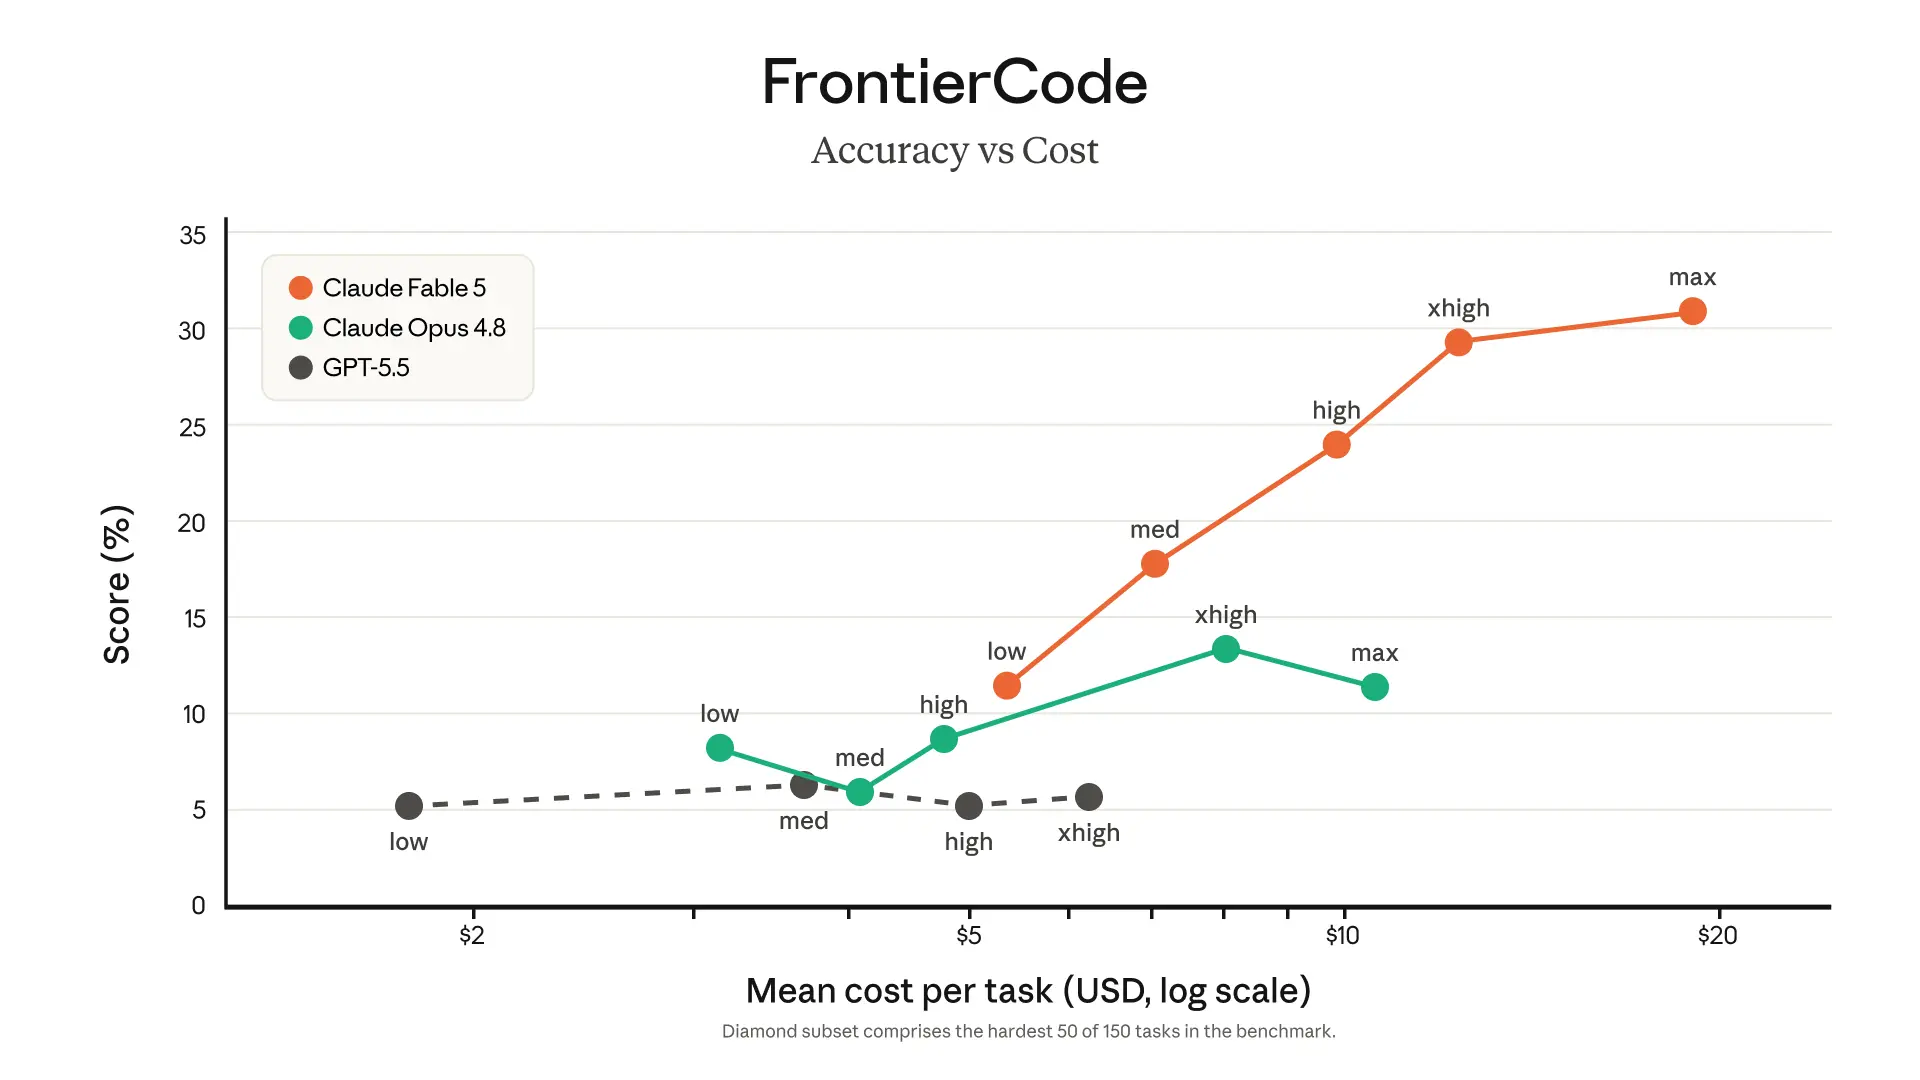
Mythos 5 kan autonomer en langer werken aan grote codebases dan welk eerder Claude-model ook. Stripe meldde dat het model maanden aan engineeringswerk comprimeerde tot dagen en in één dag een migratie door de hele codebase uitvoerde over een Ruby-codebase van 50 miljoen regels. Op FrontierCode (Diamond) scoort het het hoogst onder frontiermodellen, zelfs bij middelhoge inspanning.
Voor securitywerk breidt Mythos 5 de mogelijkheden uit die Mythos Preview waardevol maakten voor Project Glasswing-partners. Die partners gebruikten Mythos Preview om meer dan 10.000 hoge en kritieke beveiligingslekken in productiesystemen te identificeren.
Het interne eiwitontwerpteam van Anthropic gebruikte Mythos 5 om het geneesmiddelontwerp ruwweg tien keer te versnellen. In een gecontroleerde vergelijking evenaarde of overtrof Mythos 5 bekwame menselijke operators over 14 eiwittoehoorden voor de volledige pijplijn:
Negen leverden sterke kandidaten voor geneesmiddelontwerp op die momenteel worden onderzocht.
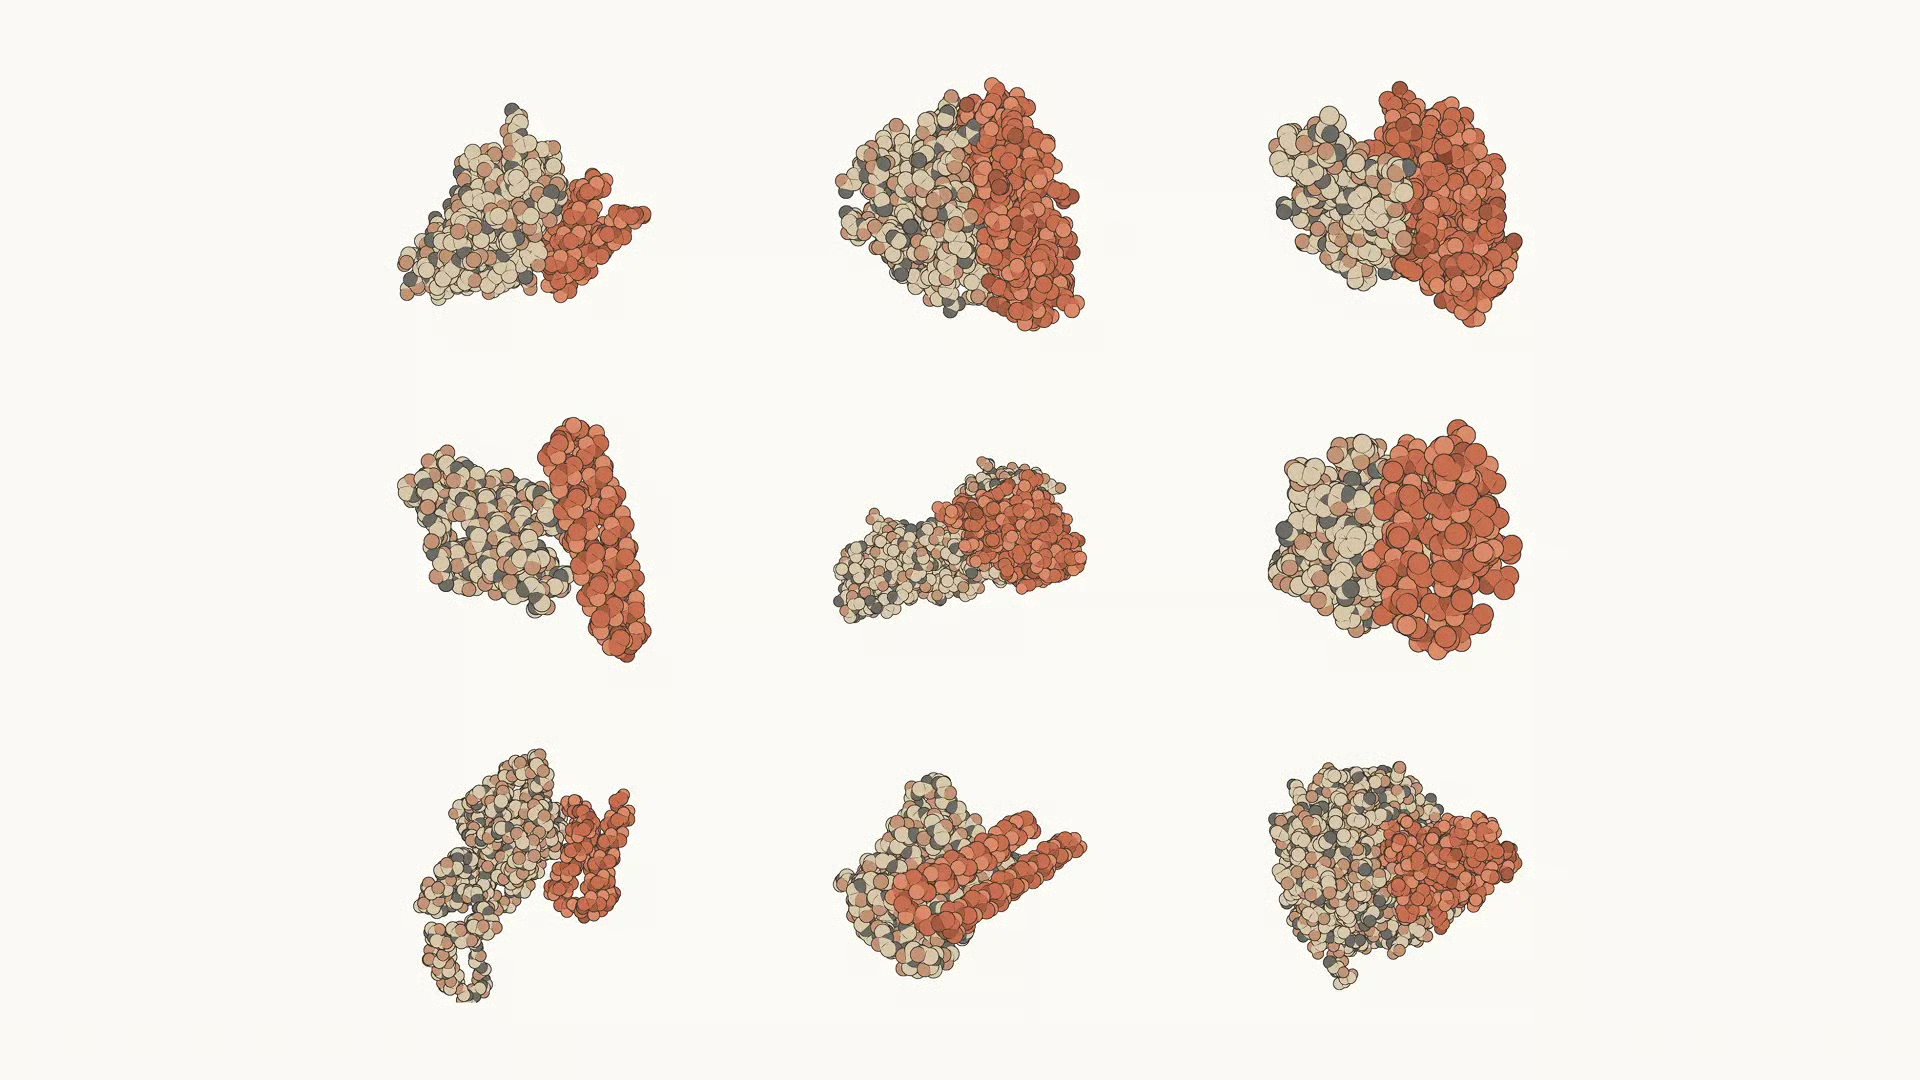
Mythos 5 is het eerste model van Anthropic dat consistent nieuwe wetenschappelijke hypothesen produceert in plaats van bestaande literatuur samen te vatten. In geblindeerde vergelijkingen gaven de wetenschappers van Anthropic ongeveer 80% van de tijd de voorkeur aan de moleculaire-biologiehypothesen ervan, en verschillende zijn doorgezet naar experimentele evaluatie. Eén hypothese over een nieuw E. coli-eiwitmechanisme werd onafhankelijk bevestigd door een lab dat aan hetzelfde probleem werkte.
Mythos 5 voerde nieuw genomicaonderzoek uit gedurende meer dan een week van grotendeels autonoom werk, waarbij het single-cel-data samenstelde voor miljoenen cellen over 138 diersoorten en een aangepast ML-model trainde om equivalente celtypes te identificeren bij ver verwante organismen. Het getrainde model presteerde beter dan een recent in Science gepubliceerd model, ondanks dat het 100 keer kleiner was.
Mythos 5 scoort 93,2% op CharXiv Reasoning met tools en kan precieze getallen halen uit gedetailleerde wetenschappelijke figuren of een webapp herbouwen op basis van alleen screenshots. Bij long-contexttaken verbeterde het geven van bestandsgebaseerd geheugen aan Mythos 5 de prestaties drie keer meer dan dezelfde setup deed voor Opus 4.8, en het bereikte de laatste act van Slay the Spire drie keer zo vaak.
Mythos 5 leidt of deelt de leiding op vrijwel elke benchmark die Anthropic heeft getest, met voordelen ten opzichte van Opus 4.8 die consistent zijn over categorieën in plaats van geconcentreerd in één gebied. De vergelijkingstabel zet het af tegen Claude Mythos Preview, Claude Opus 4.8, GPT 5.5 en Gemini 3.1 Pro.
| Categorie | Benchmark | Claude Mythos 5 / Fable 5 | Claude Mythos Preview | Claude Opus 4.8 | GPT 5.5 | Gemini 3.1 Pro |
|---|---|---|---|---|---|---|
| Agentisch coderen | SWE-Bench Pro | 80.3% | 77.8% | 69.2% | 58.6% | 54.2% |
| Agentisch coderen | FrontierCode (Diamond) | 29.3% (xhigh) | — | 13.4% (xhigh) | 5.7% (xhigh) | — |
| Kenniswerk | GDPval-AA | 1932 | — | 1890 | 1769 | 1314 |
| Kenniswerk visie | GDP.pdf | 29.8% (no tools) | — | 22.5% (no tools) | 24.9% (no tools) | 16.7% (no tools) |
| Ruimtelijk redeneren | Blueprint-Bench 2 | 38.6% | — | 14.5% | 36.2% | 26.5% |
| Toolgebruik | AutomationBench | 17.4% | — | 15.5% | 12.9% | 9.6% |
| Computergebruik | OSWorld-Verified | 85.0% | 85.4% | 83.4% | 78.7% | 76.2% |
| Juridisch | Legal Agent Benchmark | 13.3% | — | 10.4% | 2.1% | 0.0% |
| Multidisciplinair redeneren | Humanity's Last Exam (no tools) | 59.0%* | 56.8% | 49.8% | 41.4% | 44.4% |
| Multidisciplinair redeneren | Humanity's Last Exam (with tools) | 64.5%* | 64.7% | 57.9% | 52.2% | 51.4% |
| Biologie | BioMysteryBench (hard) | 46.1%* | 29.6% | 40.0% | — | — |
| Biologie | BioMysteryBench (human solved) | 83.9%* | 82.6% | 80.4% | — | — |
| Agentisch coderen | Terminal-Bench 2.1 | 88.0%* | — | 82.7% | 83.4% (Codex CLI) | 70.7% (Gemini CLI) |
| Cybersecurity | ExploitBench (Cap%) | 78.0%* | 69.0% | 40.0% | 34.0% | — |
| Gezondheid | HealthBench Professional | 66.0%* | 64.7% | 56.9% | 51.8% | — |
Anthropic rapporteert de scores van Mythos 5 en Fable 5 samen en merkt op dat ze in de meeste gevallen binnen 1–3 procentpunten van elkaar liggen. Benchmarks met een asterisk (*) tonen een groter verschil omdat de veiligheidsclassifiers van Fable 5 gevoelige vragen doorsturen naar Opus 4.8; op die benchmarks presteert Fable 5 dichter bij de Opus-klasse.
Op SWE-Bench Pro scoort Mythos 5 80,3%, vergeleken met 77,8% voor Mythos Preview, 69,2% voor Opus 4.8, 58,6% voor GPT 5.5 en 54,2% voor Gemini 3.1 Pro. De kloof van 11 punten ten opzichte van Opus 4.8 is substantieel op een benchmark die is ontworpen om grondwaarheidslekken te weerstaan.
Voor hoogwaardige en onderhoudbare agentische code in plaats van puur taakvoltooiing, gemeten door FrontierCode (Diamond), is de scheiding nog scherper. Mythos 5 scoort 29,3% op het xhigh-inspanningsniveau, vergeleken met 13,4% voor Opus 4.8 en 5,7% voor GPT 5.5.
Voor terminalwerk pakt Mythos 5 de kroon terug naar Anthropic van OpenAI: Mythos 5 scoort 88,0%* op Terminal-Bench 2.1, vergeleken met 82,7% voor Opus 4.8, 83,4% voor GPT 5.5 (Codex CLI) en 70,7% voor Gemini 3.1 Pro (met Gemini CLI).
GDPval-AA meet prestaties in kenniswerk op een numerieke schaal. Mythos 5 scoort 1932, vergeleken met 1890 voor Opus 4.8, 1769 voor GPT 5.5 en 1314 voor Gemini 3.1 Pro.
Dit verschil is groter bij kenniswerk op PDF-documenten zonder tooltoegang. Mythos 5 scoort 29,8% op GDPpdf, vergeleken met 22,5% voor Opus 4.8, 24,9% voor GPT 5.5 en 16,7% voor Gemini 3.1 Pro.
Humanity's Last Exam (HLE) test redeneren op masterniveau over wetenschap, wiskunde en geesteswetenschappen. Mythos 5 scoort 59,0%* zonder tools en 64,5%* met tools. Mythos Preview scoort respectievelijk 56,8% en 64,7%—praktisch gelijk met tools, maar 2 punten achter zonder. De afstand tot Opus 4.8 is al aanzienlijk (49,8% zonder, 57,9% met), maar nog groter tot de vlaggenschipconcurrenten (GPT 5.5: 41,4% en 52,2%, Gemini 3.1 Pro: 44,4% en 51,4%).
De kloof tussen Mythos 5 en de rest is het duidelijkst in de conditie zonder tools, waar het Opus 4.8 met meer dan 9 punten voorbijstreeft. Dit zijn gemarkeerde scores, wat betekent dat Fable 5 wat lager presteert vanwege de veiligheidsclassifiers.
Op OSWorld-Verified, dat het vermogen van het model test om taken uit te voeren op een echte computerinterface, scoort Mythos 5 85,0%. Mythos Preview zit daar net boven met 85,4%, wat dit de enige benchmark maakt waarop Mythos Preview vooroploopt. Opus 4.8 komt vrij dicht in de buurt (83,4%), terwijl de concurrenten iets verder achterblijven. GPT 5.5 scoort 78,7%, en Gemini 3.1 Pro 76,2%.
AutomationBench meet toolgebruikcapaciteiten. Mythos 5 scoort 17,4%, vergeleken met 15,5% voor Opus 4.8, 12,9% voor GPT 5.5 en 9,6% voor Gemini 3.1 Pro. De lage absolute cijfers in het algemeen suggereren dat toolgebruik een lastig probleem blijft voor alle frontiermodellen.
Ruimtelijk redeneren is een gebied waar de voorsprong van Mythos 5 het grootst is. Het scoort 38,6% in Blueprint-Bench 2, meer dan het dubbele van de 14,5% van Opus 4.8. GPT 5.5 zit dichterbij met 36,2%, en Gemini 3.1 Pro scoort 26,5%.
Dat waren de twee gebieden die in de releasenotes waarschijnlijk de meeste aandacht kregen, en de resultaten laten zien waarom.
ExploitBench meet het aandeel exploits dat het model met succes kan reproduceren (Cap%). Mythos 5 scoort 78,0%*, wat zelfs een significante verbetering is ten opzichte van Mythos Preview (69,0%) en een dramatische stijging vergeleken met de 40,0% van Opus 4.8 en 34,0% van GPT 5.5.
De kloof van 38 punten ten opzichte van Opus 4.8 is de grootste voorsprong op één benchmark in de vergelijkingstabel en verklaart waarom de cyberbeveiligingskaders voor Fable 5 bestaan. Externe red-teaming van Anthropic vond geen universele jailbreaks op langvormige agentische taken, hoewel de UK AISI in een eerste testperiode voortgang boekte richting een dergelijke jailbreak.
BioMysteryBench test biologische redenering op twee moeilijkheidsniveaus. Op de moeilijke subset scoort Mythos 5 46,1%*, vergeleken met 29,6% voor Mythos Preview en 40,0% voor Opus 4.8. Op de door mensen opgeloste subset scoort Mythos 5 83,9%*, Mythos Preview 82,6% en Opus 4.8 80,4%. Voor GPT 5.5 en Gemini 3.1 Pro zijn er geen gerapporteerde scores op een van beide subsets.
Net als bij ExploitBench liggen de scores van Fable 5 dichter bij Opus 4.8 door biologiegerelateerde veiligheidsclassifiers.
Claude Mythos 5 toont opvallende kracht in twee veeleisende professionele domeinen waar nauwkeurigheid en de kwaliteit van redeneren echte gevolgen in de echte wereld hebben: geneeskunde en recht.
In HealthBench Professional scoort Mythos 5 66,0%*, net boven de 64,7% van Mythos Preview. Opus 4.8 scoort 56,9% en GPT 5.5 51,8%.
Op de Legal Agent Benchmark scoort Mythos 5 13,3%, vergeleken met 10,4% voor Opus 4.8 en slechts 2,1% voor GPT 5.5. De absolute scores zijn laag, maar de afstand tussen Mythos 5 en GPT 5.5 of Gemini is duidelijk. Juridisch redeneren blijft een uitdagend grensgebied voor alle modellen.
Claude Mythos 5 kost $10 per miljoen inputtokens en $50 per miljoen outputtokens. Dit is minder dan de helft van de prijs van Claude Mythos Preview ($25/$125), wat de upgrade eenvoudig maakt voor bestaande Glasswing-partners. Ontwikkelaars kunnen via de Claude API toegang krijgen tot het model met het model-ID claude-mythos-5.
Toegang is momenteel beperkt tot twee groepen:
Anthropic is van plan om beide programma's in de loop van de tijd uit te breiden.
Er wordt een breder trusted-accessprogramma gepland zodat cybersecurityorganisaties systematischer kunnen aanvragen, in overleg met de Amerikaanse overheid. Anthropic heeft geen tijdlijn aangekondigd voor algemene beschikbaarheid. Voor de meeste ontwikkelaars is Claude Fable 5 vandaag de praktische optie, met hetzelfde onderliggende model en toegang via standaardabonnementen en API-plannen.
Eén operationeel detail om te benadrukken: Anthropic heeft een beleid voor gegevensretentie van 30 dagen ingevoerd voor al het verkeer van Mythos-klassemodellen. De gegevens worden niet gebruikt voor training en worden in bijna alle gevallen na 30 dagen verwijderd, maar blijven behouden voor veiligheidsmonitoring. Als je met gevoelige gegevens bouwt op Mythos 5, bekijk dan vóór implementatie de ondersteuningsdocumentatie van Anthropic over dit beleid.
Claude Mythos 5 is de duidelijkste verklaring tot nu toe dat het Anthropic menens is om frontier-AI in te zetten in professionele contexten met hoge inzet, en de resultaten onderbouwen dat.
Het verschil op SWE-bench Pro (80,3% vs 69,2%), het verschil op Terminal-Bench 2.1 (88,0% vs 82,7%) en het verschil op ExploitBench (78,0% vs 40,0%) wijzen allemaal op een model dat de moeilijkste taken betrouwbaarder aan kan dan al het andere dat beschikbaar is.
Het beperkte toegangsmodel is een redelijke aanpak gezien de dual-use-risico's, en de ExploitBench-scores maken een overtuigend punt dat de meest capabele offensieve securitytools niet openbaar beschikbaar zouden moeten zijn. De lastigere vraag is of Anthropic het trusted-accessprogramma snel genoeg kan uitbreiden om nuttig te zijn voor de bredere security- en biomedische onderzoeksgemeenschappen voordat concurrenten het gat dichten.
Voor organisaties die in aanmerking komen, is de upgrade van Mythos Preview eenvoudig en kost minder dan de helft.
Top AI-cursussen
Leerpad
Cursus
Cursus
blog
Adel Nehme
15 min


