

Cursus
Softwareontwikkeling met Claude Code
4 uur
9.1K
Oefen en volg je voortgang.
Ga Verder Met GoogleUpdate (1 juli 2026): De toegang tot Claude Fable 5 is hersteld en nu wereldwijd beschikbaar op Claude Platform, Claude.ai, Claude Code en Claude Cowork nadat de exportcontrole is opgeheven. Mythos 5 blijft beperkt tot gescreende Project Glasswing-partners.
Update (2 september 2026): Anthropic heeft de opvolger van het model gepubliceerd. Lees er alles over in onze Claude Fable 5.1-gids en onze Claude Fable 5.1 API-tutorial.
We hoorden voor het eerst over Claude Mythos in april toen we schreven over de release van Claude Opus 4.7. We begrepen toen dat Opus 4.7, hoe indrukwekkend ook op zichzelf, alleen het beste publiek beschikbare model was omdat de Mythos-klasse modellen werden achtergehouden voor brede release.
Welnu, Anthropic heeft ons nu Claude Fable 5 gegeven, een Mythos-klasse model dat veilig is voor algemeen gebruik. Het is zonder twijfel de nieuwe koploper in de belangrijke benchmarktests, waaronder zaken als kenniswerk, software-engineering en wetenschappelijk onderzoek. Het is een grote winst voor Anthropic, dat acht dagen geleden een aanvraag deed voor een Amerikaanse beursgang.
In dit artikel kijken we van dichtbij naar Claude Fable 5, hoe het zich verhoudt tot andere modellen op de markt, zoals GPT-5.5 en Gemini 3.1 Pro, evenals Claudes eigen modellen, zoals Opus 4.8. We geven ook wat advies over wanneer je het model gebruikt, omdat het duurder is. Als je nieuw bent met Claude en graag wilt leren, raad ik je aan om onze gids over hoe je Claude leert te bekijken.
Claude Fable 5 is de naam die Anthropic geeft aan zijn nieuwste en meest capabele model. Het is een model uit de Mythos-klasse, maar het bevat belangrijke waarborgen op cruciale gebieden, met name cybersecurity.
Voor de gebruiker betekent dit dat bepaalde vragen worden beantwoord door het volgende model in de rij, Claude Opus 4.8. Anthropic schat dat dit soort omleiding plaatsvindt bij minder dan 5% van alle queries, wat volgens Anthropic conservatief is. Dat is maar goed ook, aangezien het om cybersecurity gaat. Natuurlijk zal dat percentage sterk variëren, afhankelijk van het soort werk dat je doet.
We zijn vooral enthousiast over Claude Fable 5. Het model is nu zo capabel dat het nieuwe toepassingsgebieden ontsluit: cyberverdedigers zullen het model gebruiken om kritieke systemen te beveiligen, en life sciences-onderzoekers zouden het kunnen inzetten om nieuwe therapieën te verbeteren. Astrofysici kunnen deze modellen gebruiken om sterrenstelsels in kaart te brengen. En zo verder.
Als je de release hebt gelezen, heb je misschien ook van Claude Mythos 5 gehoord. Als je je afvraagt: Claude Mythos 5 is hetzelfde onderliggende model maar met enkele waarborgen opgeheven. Het is niet voor algemeen gebruik: het wordt ingezet als onderdeel van Project Glasswing in samenwerking met de Amerikaanse overheid en vervangt effectief Claude Mythos Preview. We weten minder over Claude Mythos 5, maar we weten wel dat het de sterkste cybersecurity-capaciteiten heeft van elk model ter wereld. Anthropic’s samenwerking met de Amerikaanse overheid is daarvan op zich al een bewijs.
Fable 5 introduceert verschillende opvallende upgrades op het gebied van veiligheid, transparantie, geheugen en gegevensverwerking.
De grootste structurele toevoeging in Fable 5 is een tweefasig classifiersysteem dat is ontworpen om misbruik van de gevaarlijkste capaciteiten van het model te voorkomen. Een probe bewaakt de interne activaties van het model over al het verkeer, en gemarkeerde verzoeken worden opgeschaald naar een apart getraind LLM-classifier die de eindbeslissing neemt. Wanneer een verzoek wordt geblokkeerd, wordt het omgeleid naar Opus 4.8 in plaats van direct geweigerd, zodat de gebruiker toch een nuttig antwoord krijgt.
Dit lijkt op het punt hierboven. Wanneer de classifiers van Fable 5 een query omleiden naar Opus 4.8, krijgen gebruikers een melding welk model hun verzoek heeft afgehandeld. Dit is een nieuwe transparantie, zodat gebruikers zich niet hoeven af te vragen waarom een reactie anders aanvoelde.
Fable 5 kan midden in een taak notities naar een bestand schrijven en daar later naar verwijzen, wat iets anders is dan alleen een groot contextvenster hebben. Dit is een actief werkgeheugen. In Anthropic’s eigen tests verbeterde dit de prestaties aanzienlijk meer dan bij Opus 4.8.
Anthropic introduceert een nieuw beleid voor gegevensbewaring dat van toepassing is op al het Fable 5-verkeer. Gegevens worden 30 dagen bewaard om nieuwe jailbreaks te detecteren en het aantal false positives te verminderen. Anthropic zegt dat deze gegevens niet zullen worden gebruikt voor modeltraining en dat menselijke toegang wordt gelogd.
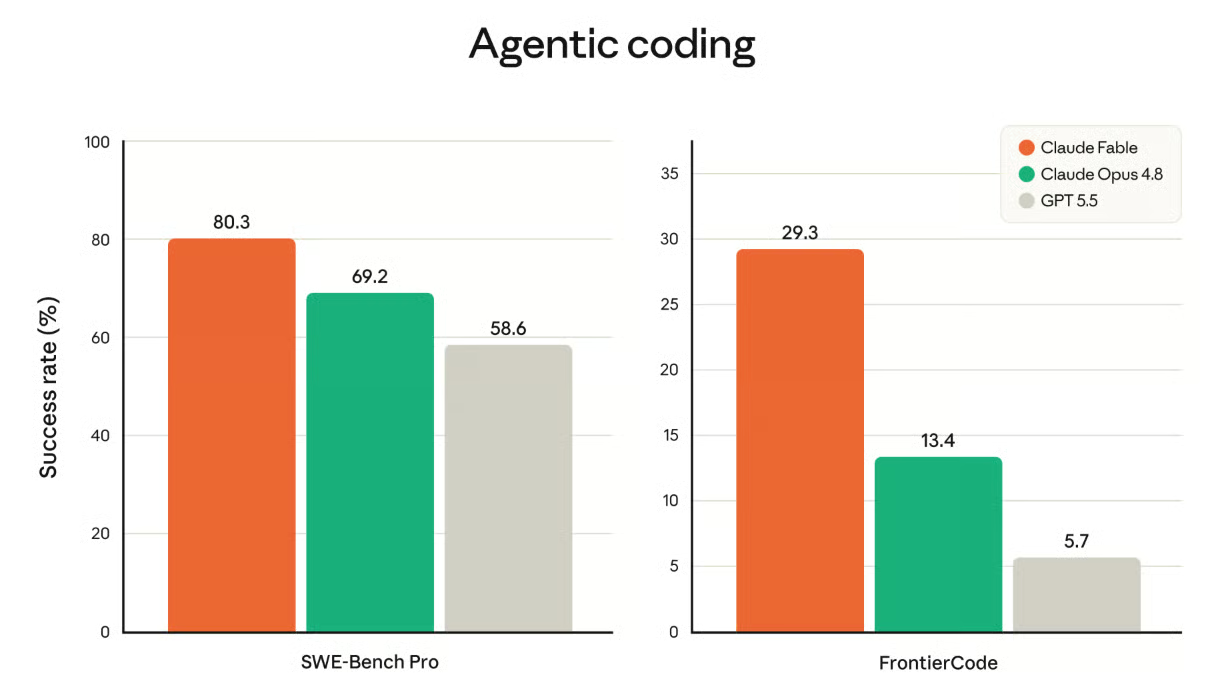
Claude Fable 5 wint glansrijk op alle benchmarktests die we nauw volgen. Op SWE-Bench Pro scoort het 80,3%, voor op de 69,2% van Opus 4.8. Op Humanity's Last Exam met hulpmiddelen scoort het 64,5%, vergeleken met 57,9% voor Opus 4.8 en 52,2% voor GPT-5.5.
| Categorie | Benchmark | Claude Mythos 5 / Fable 5 | Claude Mythos Preview | Claude Opus 4.8 | GPT 5.5 | Gemini 3.1 Pro |
|---|---|---|---|---|---|---|
| Agentisch coderen | SWE-Bench Pro | 80.3% | 77.8% | 69.2% | 58.6% | 54.2% |
| Agentisch coderen | FrontierCode (Diamond) | 29.3% (xhigh) | — | 13.4% (xhigh) | 5.7% (xhigh) | — |
| Kenniswerk | GDPval-AA | 1932 | — | 1890 | 1769 | 1314 |
| Kenniswerk visie | GDP.pdf | 29.8% (no tools) | — | 22.5% (no tools) | 24.9% (no tools) | 16.7% (no tools) |
| Ruimtelijk redeneren | Blueprint-Bench 2 | 38.6% | — | 14.5% | 36.2% | 26.5% |
| Toolgebruik | AutomationBench | 17.4% | — | 15.5% | 12.9% | 9.6% |
| Computergebruik | OSWorld-Verified | 85.0% | 85.4% | 83.4% | 78.7% | 76.2% |
| Juridisch | Legal Agent Benchmark | 13.3% | — | 10.4% | 2.1% | 0.0% |
| Multidisciplinair redeneren | Humanity's Last Exam (no tools) | 59.0%* | 56.8% | 49.8% | 41.4% | 44.4% |
| Multidisciplinair redeneren | Humanity's Last Exam (with tools) | 64.5%* | 64.7% | 57.9% | 52.2% | 51.4% |
| Biologie | BioMysteryBench (hard) | 46.1%* | 29.6% | 40.0% | — | — |
| Biologie | BioMysteryBench (human solved) | 83.9%* | 82.6% | 80.4% | — | — |
| Agentisch coderen | Terminal-Bench 2.1 | 88.0%* | — | 82.7% | 83.4% (Codex CLI) | 70.7% (Gemini CLI) |
| Cybersecurity | ExploitBench (Cap%) | 78.0%* | 69.0% | 40.0% | 34.0% | — |
| Gezondheid | HealthBench Professional | 66.0%* | 64.7% | 56.9% | 51.8% | — |
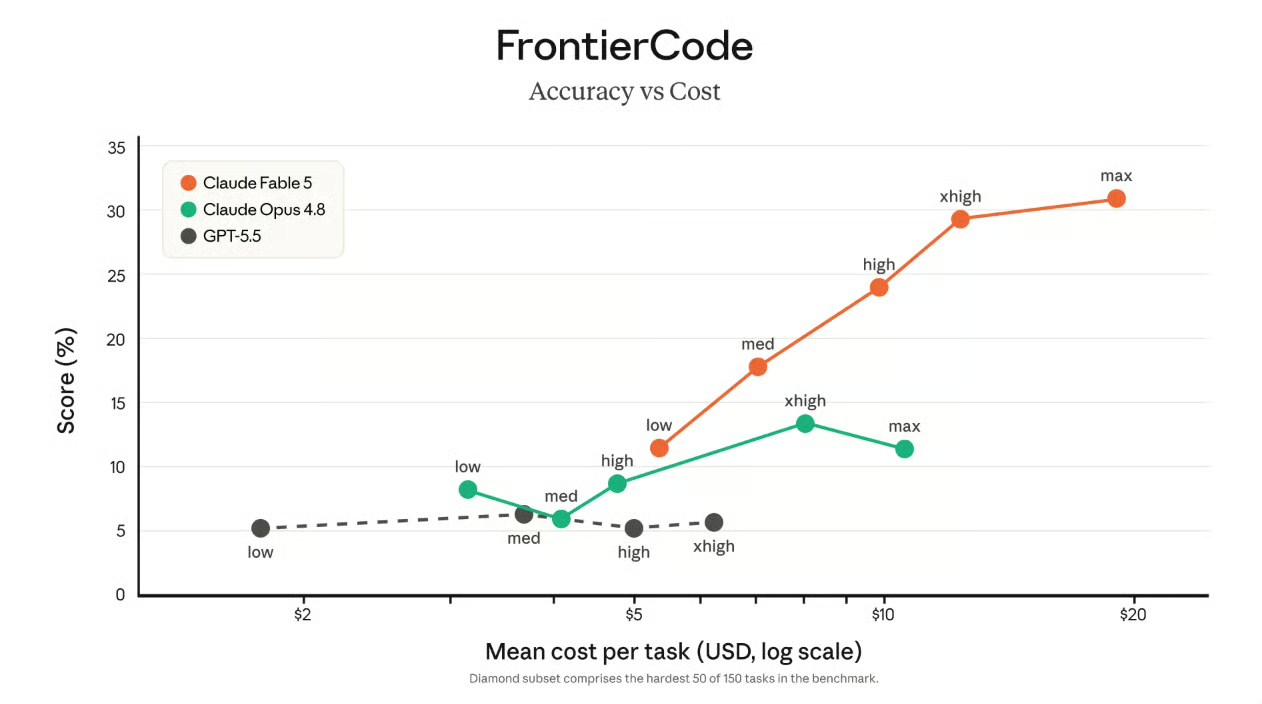
Ik noemde de FrontierCode-benchmarktest maar kwam niet toe aan de details. FrontierCode test niet alleen of een model een coderingstest kan halen, wat op zich al moeilijk is, maar ook of het kan voldoen aan hogere, algemenere standaarden voor hoogwaardige productiecodebases, wat betekent dat de code op schaal performant moet zijn, idiomatisch, gestructureerd voor langdurig onderhoud, enzovoort.
Claude Fable 5 scoort hoger op de FrontierCode-test dan elk ander model zonder zelfs maar de parameters high of xhigh te gebruiken.
Claude Fable 5 is het beste model voor visietaken. In Anthropic’s tests kon Fable 5 de broncode van een webapplicatie volledig herbouwen op basis van alleen screenshots, zonder scaffolding. Dit is dezelfde capaciteit die terugkomt in de 93,2%-score op CharXiv Reasoning met hulpmiddelen.
Het Fable 5-model presteert ook extreem goed op een probleem dat meer mensen waarschijnlijk tegenkomen: het kan exacte getallen extraheren uit gedetailleerde wetenschappelijke figuren zonder veel fouten te maken.
We hebben het het hele jaar veel gehad over het geheugen en de long-contextvaardigheden van AI-modellen. Met Fable 5 brengt Anthropic ons nieuwe dingen om over te praten.
Om te beginnen blijft Fable 5 gefocust over miljoenen tokens. Als je niet bekend bent met het idee: AI-modellen kunnen bij lange taken ‘vergeten’ of het eerdere context kwijtraken naarmate het gesprek langer wordt. Maar Fable 5 is beter in het behouden van consistent, coherent gedrag, zelfs wanneer de taak heel lang is. Hoe lang is heel lang? Ter context: een miljoen tokens is een roman van 700 pagina’s.
Anthropic vertelt ons ook, interessant genoeg, dat Fable 5 zijn output verbetert met zijn eigen notities. Het model kan dus midden in een taak dingen opschrijven (bijvoorbeeld naar een bestand) en daar later naar verwijzen (de dingen die het heeft opgeschreven). Het is vergelijkbaar met iemand die aantekeningen maakt terwijl die een probleem uitwerkt. Dit is iets anders dan een lang geheugen hebben. Het model gebruikt externe opslag als denktool.
De tabel hierboven laat al zien dat Fable 5 in elke categorie wint. Maar een nuttige vraag is de aard van elke voorsprong: waar het een kloof is, waar het dubbeltje op zijn kant staat, en waarom.
GPT-5.5 is de dichtstbijzijnde rivaal, en bij de meeste taken liggen de twee bijna gelijk. Blueprint-Bench 2 ruimtelijk redeneren is 36,2 voor GPT-5.5 en 38,6 voor Fable 5. Ze blijven dicht bij elkaar, zelfs bij lange agentische taken, zolang het model feedback krijgt terwijl het werkt. Op Terminal-Bench 2.1, waar de terminal fouten meteen aangeeft, is het 83,4 tegen 88,0.
Eén situatie doorbreekt het patroon: een lange taak die pas achteraf wordt beoordeeld. Daar kan het model zijn eigen fouten niet opvangen, dus stapelen ze zich op en loopt het sterkere model uit. SWE-Bench Pro is het duidelijkste geval, met 58,6 voor GPT-5.5 tegen 80,3 voor Fable 5.
Voor een gedetailleerde vergelijking, lees onze post: Claude Fable 5 vs GPT-5.5: benchmarks, prijzen en welke je moet kiezen.
Gemini 3.1 Pro loopt achter op Fable 5 over de hele linie, en de kloof wordt groter bij het werk dat het meest telt. Op GDPval-AA kenniswerk scoort het 1314 tegenover 1932 voor Fable 5. Op Terminal-Bench 2.1 is het 70,7 tegenover 88,0. De kloof is kleiner bij kortere, afgebakende taken — ruimtelijk redeneren is 26,5 tegen 38,6 — maar sluit nooit. Het patroon wijst op een model dat korte problemen behoorlijk afhandelt maar de draad kwijtraakt bij de lange, tool-zware workflows waarin Fable 5 juist uitblinkt.
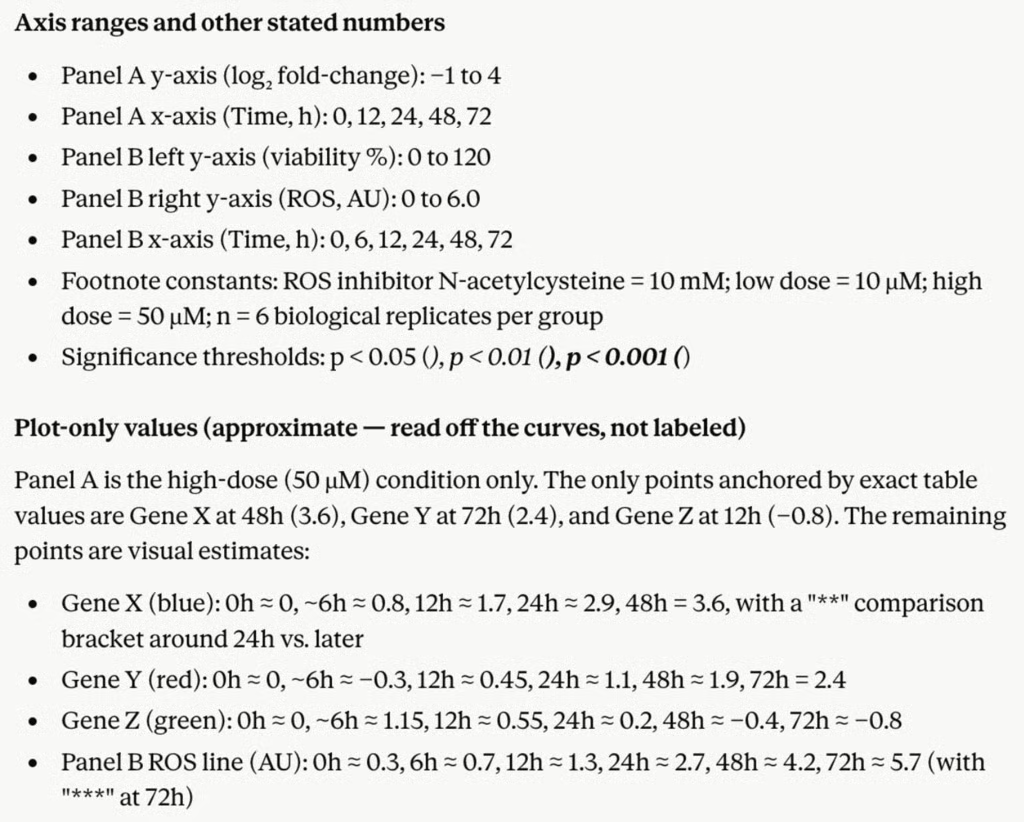
Een van de specifieke claims in de release van Anthropic is dat Fable 5 exacte getallen uit gedetailleerde wetenschappelijke figuren kan halen zonder veel fouten te maken.
Om dit te testen, hebben we een wetenschappelijke figuur met twee panelen gemaakt, gemodelleerd naar het soort output dat je in een celbiologiepaper vindt: overlappende tijdreeksen van genexpressie op een log₂-as, een dual-axis-paneel dat percentages koppelt aan andere metingen in arbitraire eenheden, enzovoort.
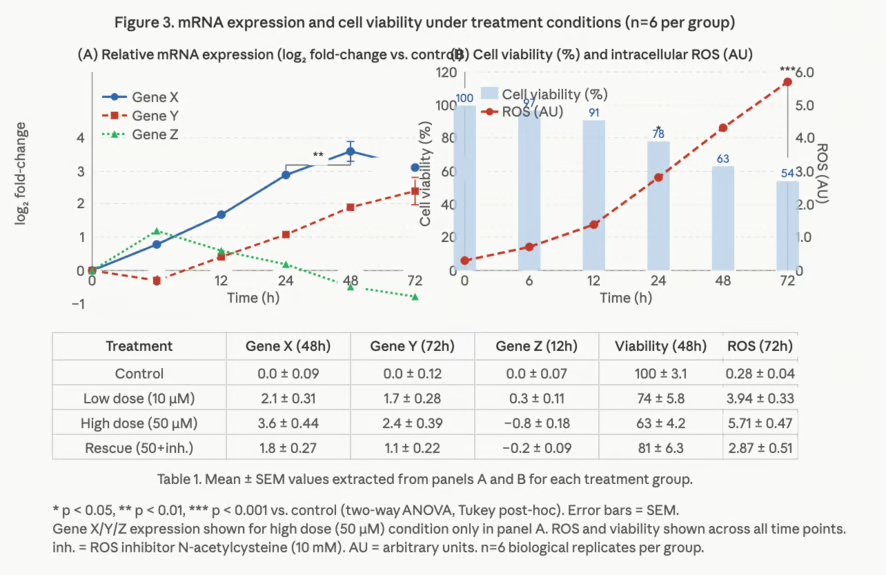
We dachten dat dit lastig zou zijn. De dubbele y-assen in paneel B gebruiken verschillende schalen en verschillende eenheden. Gen Z gaat op bepaalde plekken het negatieve log₂-gebied in.
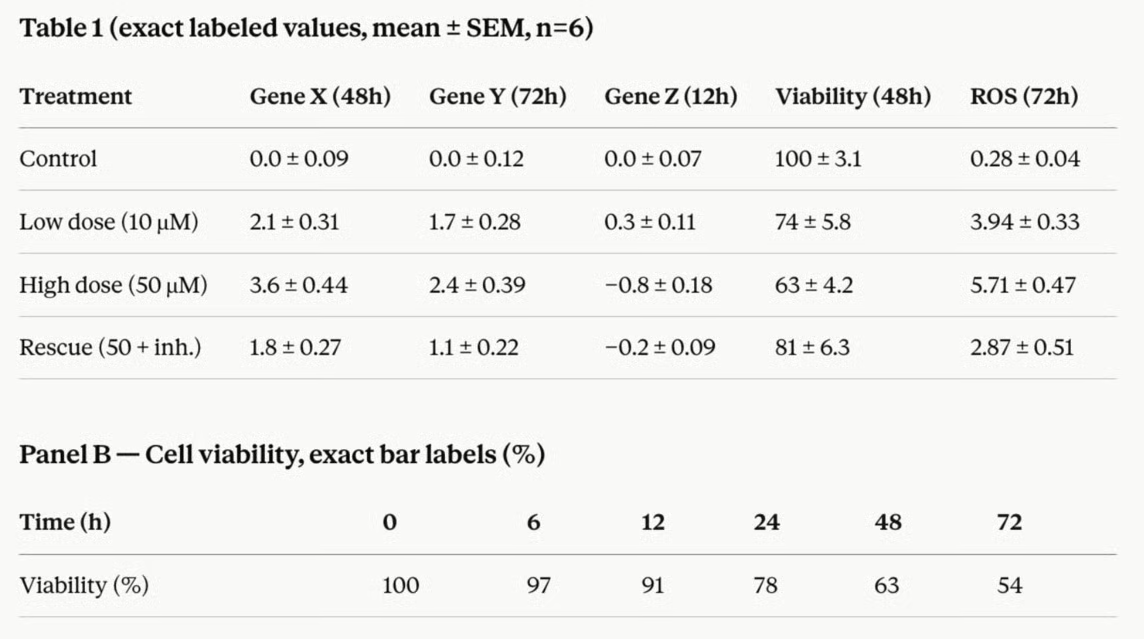
We vroegen Fable 5 om alle numerieke waarden uit beide panelen en de tabel te extraheren.
please extract all numeric valuesHet resultaat was zo goed als perfect. Mijn eigen tabel waarmee ik de grafiek maakte, had voor Gen Z een waarde van -0,05 op 48 uur. Fable 5 gaf aan dat het -0,04 was op dit punt, niet -0,05.
In de release laat Anthropic ons feedback/productgetuigenissen zien van vroege toegang van klanten of partners, zoals GitHub en Figma. Ze zeggen positieve dingen, maar dat is te verwachten. Elke modelrelease van Anthropic heeft deze sectie.
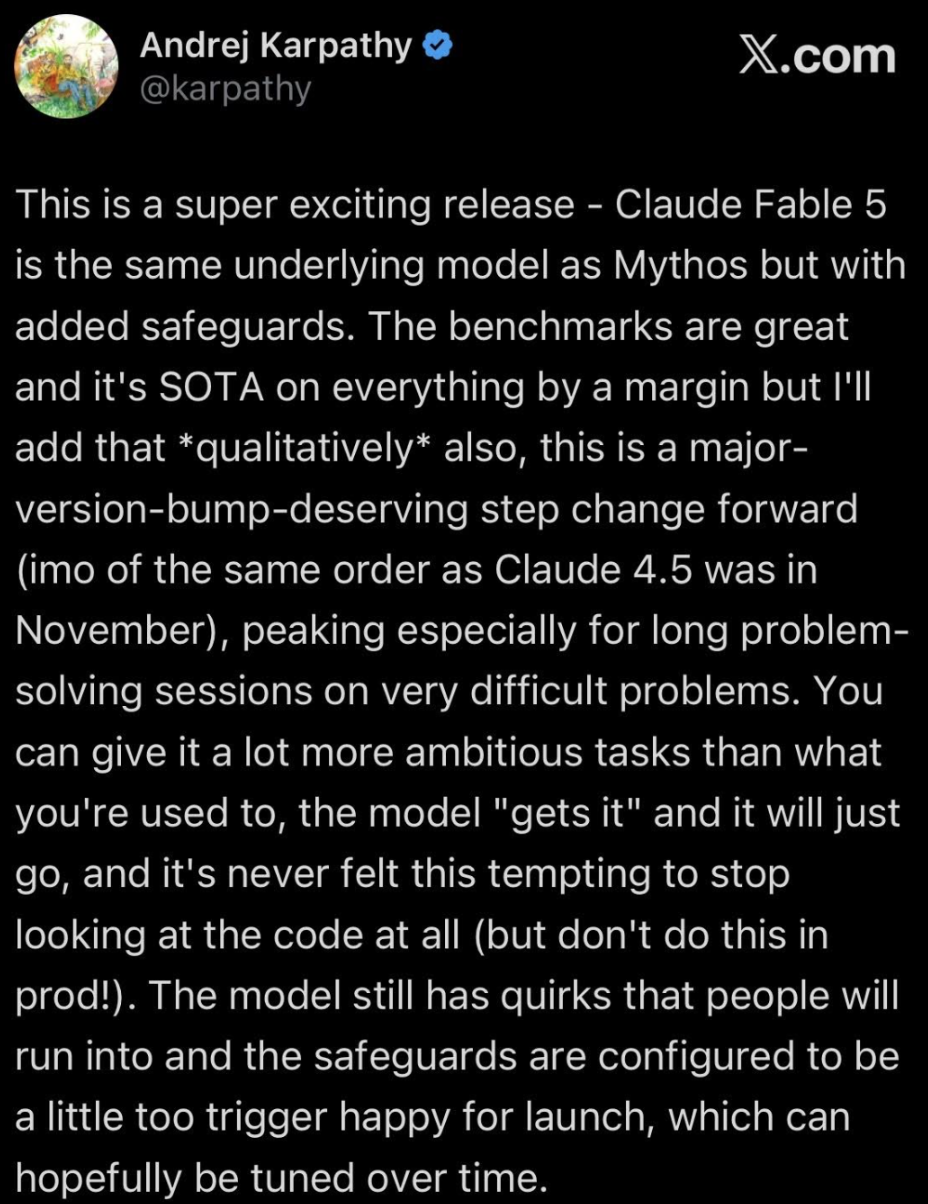
X geeft ons een minder gecureerde mening. Wat meteen opviel: Andrej Karpathy heeft het model in feite een lovende review gegeven, waarbij hij erkent dat Fable 5 state of the art is op alle relevante benchmarks met marge, en het model ook een stapverandering noemt zoals Opus 4.5 in november was. In de rest van de post geeft hij volop andere ideeën wat je met Fable 5 kunt doen, zoals:
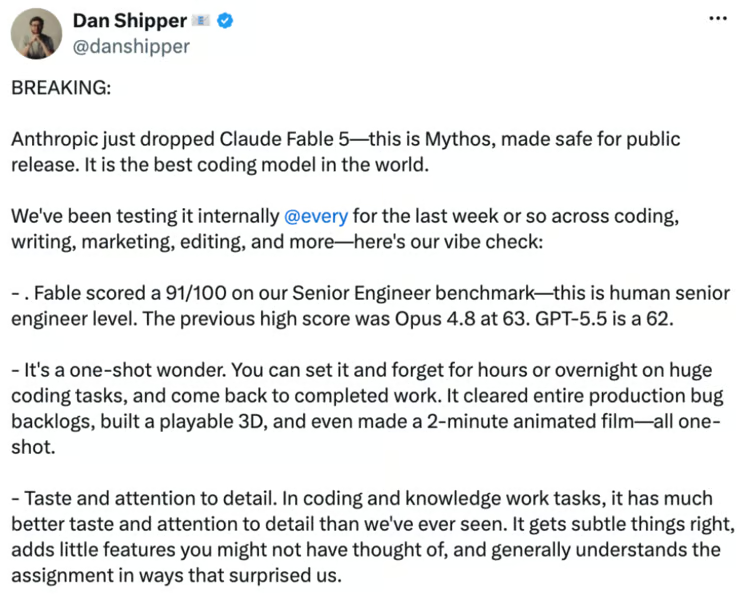
Dan Shipper, de CEO van Every, zegt iets soortgelijks, dat Fable 5 de benchmarktests wegblies, om te beginnen, en ook dat het een ‘one-shot wonder’ is: je kunt het op een groot project zetten en de volgende ochtend terugkomen en afgerond werk hebben. (Hij had vroege toegang, vandaar.)
Er is wat kritiek ter nuancering: hij zegt dat het model traag en token-hongerig is, wat een andere manier is om te zeggen duur. Hij zegt dat het twee keer zo duur is als Opus. Dus hij erkent, terecht, dat je het model alleen moet gebruiken voor dingen die het echt vereisen.
Ik noemde dat Claude Fable 5 Claude Mythos 5 is, maar dan met waarborgen. Dat betekent dat Fable 5 zo krachtig is dat het, zonder beperkingen, zinvolle hulp kan bieden aan kwaadwillenden op gebieden zoals cybersecurity en biologie. Dat is de gedachte.
Zo werken de waarborgen op hoofdlijnen. Het is een tweefasig classifiersysteem:
Er zijn drie hoofdgebieden die de classifiers afdekken.
Bekijk het voor/na-verhaal van de waarborgen in één visual. De roze balken zijn Claude Mythos 5 zonder waarborgen — het ruwe onderliggende model. Het is extreem capabel over alle vier de benchmarks: 88,4% op Firefox exploit-ontwikkeling, 83,8% op CyberGym kwetsbaarheidsreproductie, enzovoort.
De oranje balken zijn Claude Fable 5 met de classifiers actief, en ze staan allemaal op 0,0% bij elke benchmark. De waarborgen vlakken de prestaties af, wat goed is — nul is waar ze op mikken.
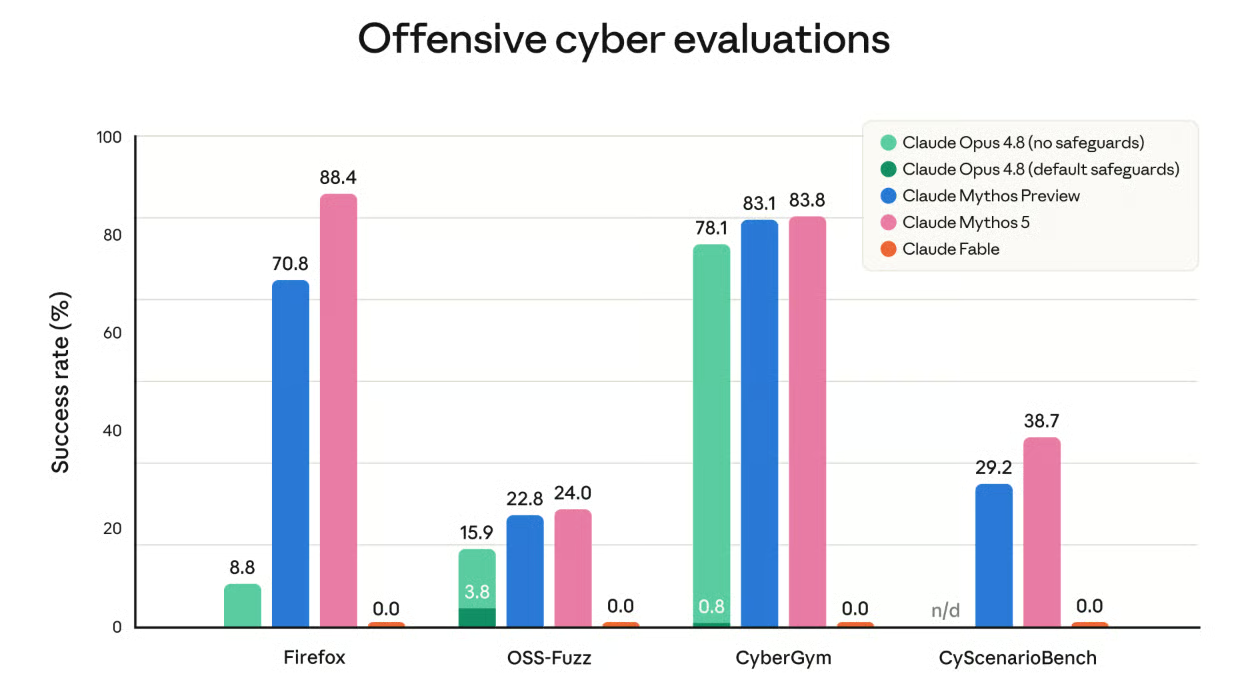
Ik vind deze grafiek fijn omdat hij Opus 4.8 in context plaatst. Zelfs zonder waarborgen scoort Opus 4.8 veel lager dan Mythos 5. Dit laat zien waarom de classifiers in de eerste plaats nodig waren. De sprong in capaciteit tussen Opus en Mythos is wat brede release risicovol maakte en vertraagde.
Als je een Pro-, Max-, Team- of Enterprise-abonnement hebt, is Fable 5 nu meteen beschikbaar zonder extra kosten — maar alleen tot 22 juni.
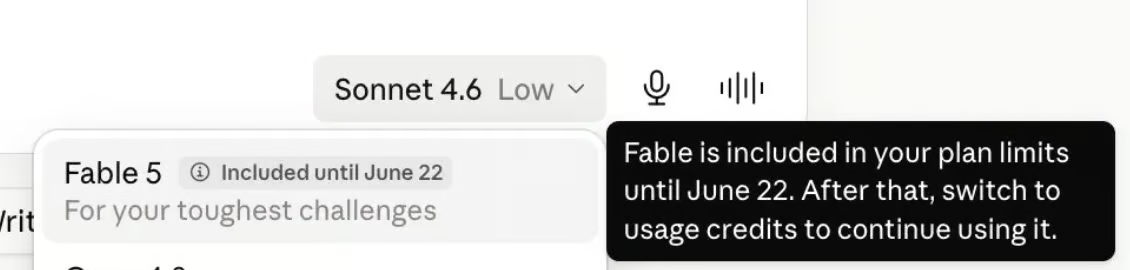
Na 22 juni is toegang afhankelijk van gebruikscredits, het pay-as-you-go-systeem van Anthropic dat boven op je bestaande abonnement zit. Dit is waarschijnlijk mede waarom Dan Shipper ons voor de kosten waarschuwde.
Voor ontwikkelaars via de API is het eenvoudiger:
Vergelijk je met de standaardprijzen van Opus 4.8 ($5 input / $25 output), dan is Fable 5 inderdaad twee keer zo duur, zoals Dan zegt. Maar als je Opus 4.8 al in fast-modus gebruikt, kost Fable 5 hetzelfde terwijl het een capabeler model is.
Belangrijke opmerking, voor het geval je je net als ik afvroeg: wanneer een query terugvalt op Opus 4.8, zoals gebeurt met het veiligheidsclassifiersysteem, wordt gefactureerd tegen de tarieven van Opus 4.8 in plaats van Fable 5.
Claude Mythos 5, de Mythos-versie zonder waarborgen, is niet beschikbaar voor het grote publiek. Toegang is beperkt tot Project Glasswing-partners.
Anthropic had ons geplaagd met Project Glasswing en het veelbelovend genaamde Mythos-model. Maar maandenlang zat dit beste-model-ter-wereld — en dat is het echt — achter een overheidspartnerschap op slot.
Dat is veranderd, een week nadat Anthropic een Amerikaanse beursgang aanvroeg. Nu is het model uit de Mythos-klasse beschikbaar op een Pro-abonnement. (Toegang is ook gebaseerd op gebruikscredits. Zie de laatste sectie voor de details.)
Waar we staan: Anthropic heeft modellen die zonder beperkingen genoeg kunnen om serieuze schade te veroorzaken. We weten dat het geen marketingpraat is, omdat het bedrijf een heel parallel classifiersysteem heeft gebouwd om waarborgen toe te voegen.
Waar we naartoe gaan: het prestatieniveau schuift steeds verder op, de benchmarktests worden steeds vervangen door moeilijkere versies en de releasedoorlooptijd van modellen wordt steeds korter. Ook de infrastructuur voor waarborgen wordt steeds uitgebreider om te compenseren. Met de beursgang mogelijk al dit jaar, zal er veel gesproken worden over hoe concurrentiedruk botst met veiligheidskwesties.
Leren met DataCamp
Cursus
Cursus
Oefen en volg je voortgang.
Ga Verder Met Googleblog
Adel Nehme
15 min

