De rekenkosten voor het trainen van large language models (LLM’s) lopen steeds verder uit de hand. Zo kostte de training van GPT-4 OpenAI ongeveer 100 miljoen dollar. Het grootste deel van de kosten komt door matrixvermenigvuldigingen (kortweg MatMul), dus het is logisch dat onderzoekers en ontwikkelaars hebben geprobeerd die volledig te schrappen of efficiënter te maken.
Het paper "Scalable MatMul-free Language Modeling" introduceert een baanbrekende aanpak die dit probleem direct aanpakt. Door MatMul volledig uit LLM’s te verwijderen hebben de auteurs een model ontwikkeld dat concurrerend presteert, terwijl het de reken- en geheugeneisen aanzienlijk verlaagt.
Bron: Rui-Jie Zhu et. al
Alle modellen uit het paper zijn beschikbaar op HuggingFace—je kunt ze online proberen of lokaal met de libraries van HuggingFace. Ook hebben de onderzoekers hun code op GitHub gedeeld, zodat anderen hun modellen kunnen trainen.
Als je de kubische tijdscomplexiteit van matrixvermenigvuldiging beter wilt begrijpen, raad ik deze introductie aan tot Big-O-notatie en tijdscomplexiteit, met een speciaal onderdeel over de tijdscomplexiteit van MatMul-LLM’s.
Ik heb ook een vergelijking gemaakt tussen MatMul-vrije en MatMul-LLM’s—je vindt die in dit artikel: Matmul-Free vs MatMul LLMs: Speed and Memory Consumption.
De MatMul-bottleneck in large language models
Moderne, transformer-gebaseerde LLM’s leunen zwaar op matrixvermenigvuldigingen, die centraal staan in kerncomponenten zoals attention-mechanismen en feedforward-lagen. De reken- en geheugenkosten van MatMul zijn aanzienlijk en hebben impact op zowel training als inferentie. Naarmate LLM’s groter worden, nemen het aantal parameters en de complexiteit van de berekeningen toe, waardoor MatMul een grote bottleneck wordt.
Een veelvoorkomend voorbeeld is wanneer het VRAM van een GPU onvoldoende is voor de modelgrootte, waardoor gebruikers gedwongen zijn om te trainen of te infereren op CPU’s. CPU’s zijn niet geoptimaliseerd voor geparallelliseerde MatMul-bewerkingen zoals GPU’s, wat tot aanzienlijk tragere berekeningen leidt. Dit creëert een frustrerende vicieuze cirkel waarin de beschikbare hardware niet volledig benut kan worden door geheugengrenzen, zelfs als de rekenkracht voldoende is.
Door de jaren heen hebben onderzoekers verschillende strategieën onderzocht om de rekenlast van MatMul te verminderen. Kwantisatie, waarbij de precisie van gewichten en activaties wordt verlaagd, is een populaire aanpak. Door getallen met minder bits weer te geven, kan kwantisatie de rekenkosten en het geheugengebruik van MatMul verlagen.
Toch gaat deze methode vaak ten koste van modelnauwkeurigheid en verwijdert ze MatMul niet volledig. Opmerkelijke pogingen zoals BitNet van Microsoft laten zien dat het mogelijk is LLM’s te schalen met binaire of ternaire kwantisatie, maar deze modellen blijven voor bepaalde onderdelen, zoals self-attention, op MatMul vertrouwen.
Er zijn ook alternatieve architecturen voorgesteld om de inefficiënties van MatMul aan te pakken. Benaderingen zoals AdderNet vervangen vermenigvuldigingen door optellingen in bepaalde netwerkcomponenten, en binaire/ternaire neurale netwerken maken gebruik van vereenvoudigde rekenbewerkingen
Hoewel deze methoden verbeteringen bieden, lukt het doorgaans niet om MatMul volledig te verwijderen en richten ze zich slechts op specifieke delen van het model. Daardoor blijven de totale rekenkosten hoog, wat de schaalbaarheid en efficiëntie van LLM’s beperkt.
Hoe MatMul-vrije taalmodellen werken
Om te begrijpen hoe MatMul-vrije LM’s werken, bekijken we de onderliggende architectuur en hoofdcomponenten.
MatMul vervangen door ternaire bewerkingen
In traditionele neurale netwerken gebruiken dense lagen (die alle neuronen tussen twee opeenvolgende lagen verbinden) MatMul om inputdata te transformeren. De auteurs vervangen deze door BitLinear-lagen, die ternaire gewichten gebruiken. In plaats van gewichten die elke reële waarde kunnen aannemen, zijn ze beperkt tot drie waarden: -1, 0 of 1.
De gewichten worden aanvankelijk met volledige precisie getraind en vervolgens tijdens training gekwantiseerd naar ternaire waarden met een proces dat "absmean-kwantisatie" heet. Dit schaalt de gewichtenmatrix met de gemiddelde absolute waarde en rondt elk element af naar het dichtstbijzijnde ternaire geheel getal (-1, 0 of 1).
Door deze vereenvoudiging kunnen vermenigvuldigingen in MatMul worden vervangen door optellingen en aftrekkingen. Een getal vermenigvuldigen met -1 staat bijvoorbeeld gelijk aan het negatief nemen, vermenigvuldigen met 0 levert 0 op, en vermenigvuldigen met 1 laat het getal onveranderd.
Kerncomponenten: MLGRU EN GLU
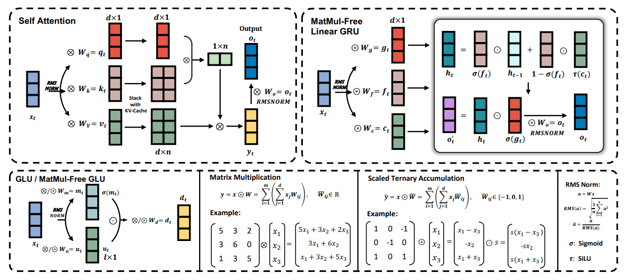
De onderstaande figuur geeft een overzicht van de belangrijkste componenten van het MatMul-vrije taalmodel, waaronder de MatMul-vrije Linear Gated Recurrent Unit (MLGRU) en de MatMul-vrije Gated Linear Unit (GLU):
Bron: Rui-Jie Zhu et. al
De figuur is opgedeeld in verschillende secties (van linksboven naar rechtsonder):
- Self-attention: Deze sectie laat zien hoe het traditionele self-attention-mechanisme werkt met matrixvermenigvuldigingen.
- MatMul-vrije lineaire GRU: Dit deel toont de architectuur van de MLGRU en hoe die invoersequenties verwerkt met elementgewijze bewerkingen en gating-mechanismen in plaats van MatMul.
- GLU / MatMul-vrije GLU: Deze sectie laat zien hoe de GLU informatie mengt over verschillende dimensies van de embeddings van het model, met ternaire gewichten om MatMul te elimineren.
- Matrixvermenigvuldiging vs. geschaalde ternaire accumulatie: Deze vergelijking toont hoe standaard matrixvermenigvuldiging wordt vervangen door geschaalde ternaire accumulatie, wat de berekeningen vereenvoudigt.
- RMS norm: Deze sectie beschrijft de RMSNorm-bewerking, die de activaties normaliseert vóór kwantisatie.
De MLGRU verwerkt de invoersequentie token voor token. Bij elke stap neemt hij de embedding van het huidige token en de vorige verborgen toestand als input. De verborgen toestand fungeert als geheugen en slaat informatie op van eerdere tokens. De MLGRU werkt deze verborgen toestand vervolgens bij met een reeks elementgewijze bewerkingen en gating-mechanismen. Deze gates, in wezen vectoren met getallen tussen 0 en 1, sturen de informatiestroom door te bepalen welke delen van de vorige verborgen toestand en de huidige token-embedding het meest relevant zijn voor de volgende stap. Dit gaat zo door totdat de hele sequentie is verwerkt.
De MatMul-vrije gated linear unit (GLU) is een andere sleutelcomponent van het MatMul-vrije taalmodel. Hij mengt informatie over de verschillende dimensies van de interne representatie van woorden (embeddings). Simpel gezegd helpt hij het model de verschillende aspecten of kenmerken van elk woord te begrijpen.
De GLU doet dit via een gating-mechanisme dat de informatiestroom tussen verschillende embeddingkanalen regelt. Dit mechanisme lijkt op de gates in de MLGRU, maar werkt op de kanaaldimensie in plaats van de tokendimensie.
De MatMul-vrije GLU is een aangepaste versie van de standaard GLU, ontworpen om matrixvermenigvuldigingen te elimineren met BitLinear-lagen: dense lagen met ternaire gewichten (gewichten die alleen -1, 0 of 1 kunnen aannemen). In de MatMul-vrije GLU wordt de input eerst met twee aparte BitLinear-lagen getransformeerd. De output van de ene laag gaat door de SiLU-activatiefunctie en wordt vervolgens elementgewijs vermenigvuldigd met de output van de andere laag. Deze gegate output gaat daarna door een andere BitLinear-laag om de uiteindelijke output te produceren.
Dit is slechts een high-level uitleg van de MLGRU- en GLU-componenten. Raadpleeg vooral het originele researchpaper voor een meer gedetailleerd begrip van de interne werking en wiskundige formuleringen.
Het onderzoek bekijkt de scaling laws van MatMul-vrije modellen en vergelijkt hun prestaties met traditionele Transformer-architecturen naarmate de modelgrootte toeneemt.
Prestaties en schaalbaarheid
Opvallend genoeg blijkt dat het prestatieverschil tussen beide benaderingen kleiner wordt naarmate de modelgrootte groeit. Dit is een belangrijk inzicht, omdat het suggereert dat MatMul-vrije modellen steeds competitiever worden met traditionele Transformers bij opschaling, en ze mogelijk voorbijstreven op zeer grote schaal.
Bron: Rui-Jie Zhu et. al
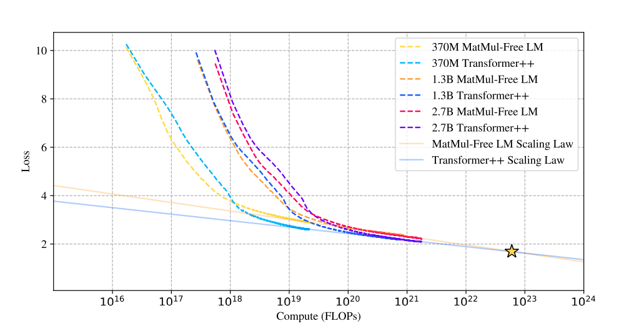
Deze grafiek met de vergelijking van scaling laws laat zien dat de verliescurves van MatMul-vrije LM’s en traditionele Transformers naar elkaar toe bewegen naarmate het aantal floating-point operations (FLOPs) toeneemt.
Aanvankelijk vertonen MatMul-vrije LM’s een hogere loss door de beperkingen van ternaire gewichten. Die kloof wordt echter kleiner naarmate de modelgrootte toeneemt, en op een bepaald punt (ster) kruisen de curves elkaar, wat op vergelijkbare prestaties wijst. Dit suggereert een steilere scaling law voor MatMul-vrije modellen, wat betekent dat hun prestaties sneller verbeteren bij toenemende grootte dan bij traditionele Transformers.
Benchmarkresultaten
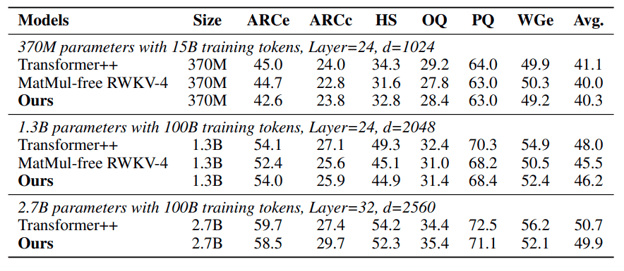
De competitieve prestaties van MatMul-vrije LM’s worden verder bevestigd door hun goede resultaten op diverse zero-shot benchmarks. Bij taken zoals ARC-Easy, ARC-Challenge, Hellaswag, Winogrande, PIQA en OpenbookQA presteren deze modellen vaak gelijk aan of beter dan traditionele Transformers, ondanks hun aanzienlijk lagere rekencomplexiteit. Dat onderstreept de effectiviteit van de alternatieve bewerkingen en architecturale keuzes in MatMul-vrije LM’s.
Bron: Rui-Jie Zhu et. al
De tabel met zero-shot-nauwkeurigheid laat zien dat MatMul-vrije LM’s competitief presteren op verschillende taken. Zo haalt het MatMul-vrije LM met 2,7B parameters in de ARC-Challenge, een bijzonder moeilijke benchmark, een nauwkeurigheid die hoger is dan die van een traditioneel Transformer-model.
Ook op de Winogrande- en OpenbookQA-taken laten de MatMul-vrije LM’s sterke prestaties zien, wat aangeeft dat het schrappen van MatMul het vermogen van het model om taal te begrijpen en genereren niet ondermijnt.
Geheugenefficiëntie
Een van de meest in het oog springende voordelen van MatMul-vrije LM’s is hun uitzonderlijke geheugenefficiëntie. Door vermenigvuldigingsintensieve bewerkingen te vervangen door eenvoudige optellingen en aftrekkingen dankzij ternaire gewichten, realiseren deze modellen forse verminderingen in geheugengebruik.
Tijdens training kan een geoptimaliseerde GPU-implementatie het geheugenverbruik tot 61% verlagen vergeleken met niet-geoptimaliseerde modellen. Bij inferentie zijn de besparingen nog spectaculairder, met reducties van meer dan een factor tien. Dit maakt MatMul-vrije LM’s bijzonder aantrekkelijk voor inzet op apparaten met beperkte resources, zoals smartphones, waar geheugen vaak de beperkende factor is.
Bron: Rui-Jie Zhu et. al
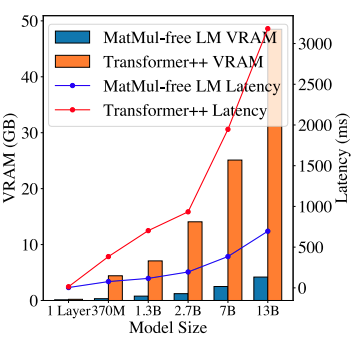
Deze grafiek met de vergelijking van GPU-geheugen en latentie illustreert de efficiëntiewinst van MatMul-vrije LM’s. Het geheugengebruik bij inferentie van een MatMul-vrij LM met 2,7B parameters is aanzienlijk lager dan dat van een vergelijkbare traditionele Transformer. Deze kleinere geheugenvoetafdruk maakt niet alleen de inzet van grotere modellen op beperkte hardware mogelijk, maar vertaalt zich ook in lagere latentie, waardoor deze modellen geschikter zijn voor realtime-toepassingen waar responsiviteit cruciaal is.
Van geoptimaliseerde GPU’s naar custom FPGA-design
Een van de belangrijkste verbeteringen in het paper is de geoptimaliseerde GPU-implementatie van MatMul-vrije LM’s. De auteurs bereikten 25,6% hogere trainingssnelheid en tot 61,0% minder geheugengebruik door fused kernels te gebruiken in hun eigen GPU-implementatie. Deze kernels combineren meerdere bewerkingen tot één, efficiënter proces, waardoor de overhead van geheugen-toegang en databeweging afneemt.
Om de lichte bewerkingen van MatMul-vrije LM’s verder uit te buiten, ontwikkelden de auteurs een custom FPGA-accelerator in SystemVerilog. FPGA’s (Field-Programmable Gate Arrays) bieden een flexibel en efficiënt hardwareplatform voor gespecialiseerde rekentaken.
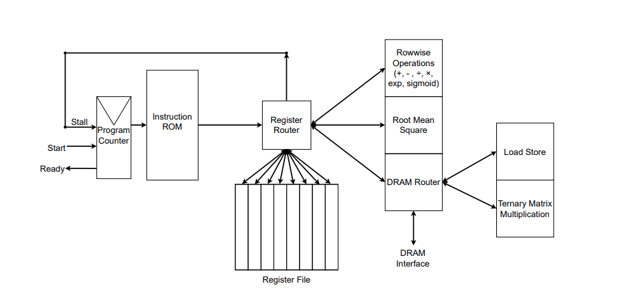
De custom accelerator is ontworpen om de eenvoud van ternaire bewerkingen en elementgewijze producten te benutten en zo aanzienlijke efficiëntiewinst te behalen. De RTL-implementatie (Register Transfer Level) is cruciaal in het FPGA-ontwerpproces. Hierbij specificeer je het hardwaregedrag op hoog niveau, dat vervolgens wordt gesynthetiseerd tot de daadwerkelijke FPGA-configuratie. Het custom RTL-ontwerp voor de MatMul-vrije LM’s zorgt ervoor dat de FPGA de lichte bewerkingen efficiënt kan afhandelen, met minder stroomverbruik en hogere doorvoer als resultaat.
Bron: Rui-Jie Zhu et. al
De figuur toont de RTL-implementatie van de custom FPGA-accelerator. Rechts van de Register Router zie je de functies die hij implementeert. De auteurs ontwikkelden ook een eigen assembler om assembly-bestanden met custom instructies om te zetten naar een instruction ROM, die je rechts in de figuur ziet. De instructies gaan naar de Register Router, die het geheugen (Register File) beheert en instructies uitvoert.
Verder vermeldden de auteurs in een reactie op een GitHub-issue dat de volledige specificaties van hun FPGA-implementatie nog worden geoptimaliseerd en dat de SystemVerilog-code later openbaar wordt gemaakt.
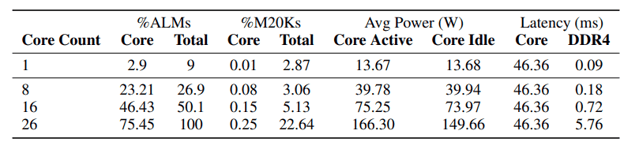
De onderstaande tabel toont het resourcegebruik en de prestatiecijfers voor de FPGA-implementatie van MatMul-vrije tokengeneratie.
Bron: Rui-Jie Zhu et. al
De data laat zien dat de totale latentie bij een toenemend aantal cores (verwerkingseenheden) binnen de FPGA aanvankelijk relatief stabiel blijft. De latentie neemt echter sterk toe van 16 naar 26 cores, wat suggereert dat de DDR4-interface, verantwoordelijk voor datatransfer, een bottleneck wordt naarmate de vraag naar datatransfer met het aantal cores groeit.
Hoewel de ternaire matrixvermenigvuldiging momenteel de totale latentie domineert, verwachten de auteurs dat optimalisatie van deze unit in toekomstige implementaties de bottleneck naar de DDR4-interface zal verschuiven.
Een van de meest intrigerende claims uit het paper is dat de MatMul-vrije aanpak LLM’s dichter bij de efficiëntie van het brein brengt qua rekenwerk en energieverbruik. De auteurs stellen dat hun modellen de efficiëntie van biologische neurale netwerken nabootsen en een mensachtige leessnelheid behalen.
Het rechtstreeks vergelijken van de efficiëntie van deze modellen met de complexe werking van biologische neurale netwerken is echter ingewikkeld en vereist verder onderzoek. De rekenmechanismen van het brein verschillen sterk en zijn veel complexer dan de vereenvoudigde bewerkingen in MatMul-vrije LM’s.
MatMul-vrij: implicaties en toekomstige richtingen
Het paper "Scalable MatMul-free Language Modeling" daagt een fundamentele aanname in natural language processing uit: dat matrixvermenigvuldiging (MatMul) essentieel is om hoog presterende LLM’s te bouwen.
Door de haalbaarheid van MatMul-vrije architecturen te tonen, opent dit onderzoek een nieuw front in LLM-ontwerp, dat aanzet tot het verkennen van alternatieve bewerkingen en rekenparadigma’s. Dit kan een golf van innovatie ontketenen, waarbij onderzoekers nieuwe modelarchitecturen ontwikkelen.
Hardwareversnelling voor lichte modellen
De verschuiving naar MatMul-vrije modellen draait niet alleen om software—het gaat ook om hardware. Traditionele chips zoals GPU’s zijn uitstekend in matrixvermenigvuldiging, maar niet per se de beste match voor deze nieuwe, lichte modellen.
De custom FPGA-accelerator die de onderzoekers bouwden, biedt een blik op de toekomst van AI-hardware—gespecialiseerde chips die elke druppel performance uit deze efficiënte modellen persen. Dit kan leiden tot een nieuwe generatie AI-apparaten die sneller, energiezuiniger en toegankelijker zijn voor een breder publiek.
Milieu-impact en duurzaamheid
Als iemand die om het milieu geeft, ben ik vooral enthousiast over het potentieel van MatMul-vrije modellen om de CO₂-voetafdruk van AI te verkleinen. Het enorme energieverbruik van de huidige large language models is een reëel probleem. Door de rekenvraag aanzienlijk te verlagen, kan dit onderzoek de weg vrijmaken voor energiezuinigere AI-technologieën met een kleinere ecologische voetafdruk.
Open onderzoeksvragen en toekomstig werk
Hoewel het paper "Scalable MatMul-free Language Modeling" een grote stap voorwaarts is, opent het ook diverse sporen voor vervolgonderzoek—het verkennen van verschillende MatMul-vrije architecturen, het evalueren van hun prestaties op een breder scala aan taken, en het wiskundig begrijpen van de theoretische grenzen van deze aanpak zijn slechts enkele veelbelovende richtingen.
Daarnaast zou het ontwikkelen van gestandaardiseerde benchmarks en evaluatiemetrieken specifiek voor MatMul-vrije modellen eerlijke vergelijkingen vergemakkelijken en de vooruitgang in dit veld versnellen. De reis naar echt efficiënte en toegankelijke AI is nog maar net begonnen, en de mogelijkheden zijn legio. Ook ik kijk persoonlijk erg uit naar toekomstige MatMul-vrije assistent-chatbots!
Conclusie
Het paper "Scalable MatMul-free Language Modeling" levert een belangrijke bijdrage aan het LLM-domein met een nieuwe aanpak die matrixvermenigvuldigingen (MatMul) elimineert.
Deze doorbraak pakt de reken- en geheugenbottlenecks van traditionele LLM’s aan en effent het pad voor efficiëntere en beter schaalbare modellen. Door gebruik te maken van additieve bewerkingen en ternaire gewichten tonen de auteurs aan dat je concurrerende prestaties kunt behouden terwijl je de benodigde resources flink terugbrengt.
De potentiële impact van dit onderzoek op de toekomst van LLM-ontwikkeling en -inzet is groot. MatMul-vrije modellen vormen een levensvatbaar alternatief voor conventionele architecturen, waardoor lichte, efficiënte modellen mogelijk worden die goed passen bij omgevingen met beperkte resources, zoals edge-devices en mobiele platforms.
Wil je meer leren over artificial intelligence? Bekijk dan deze AI-cursussen.




De rekenkosten voor het trainen van large language models (LLM’s) lopen steeds verder uit de hand. Zo kostte de training van GPT-4 OpenAI ongeveer 100 miljoen dollar. Het grootste deel van de kosten komt door matrixvermenigvuldigingen (kortweg MatMul), dus het is logisch dat onderzoekers en ontwikkelaars hebben geprobeerd die volledig te schrappen of efficiënter te maken.
Het paper "Scalable MatMul-free Language Modeling" introduceert een baanbrekende aanpak die dit probleem direct aanpakt. Door MatMul volledig uit LLM’s te verwijderen hebben de auteurs een model ontwikkeld dat concurrerend presteert, terwijl het de reken- en geheugeneisen aanzienlijk verlaagt.
Bron: Rui-Jie Zhu et. al
Alle modellen uit het paper zijn beschikbaar op HuggingFace—je kunt ze online proberen of lokaal met de libraries van HuggingFace. Ook hebben de onderzoekers hun code op GitHub gedeeld, zodat anderen hun modellen kunnen trainen.
Als je de kubische tijdscomplexiteit van matrixvermenigvuldiging beter wilt begrijpen, raad ik deze introductie aan tot Big-O-notatie en tijdscomplexiteit, met een speciaal onderdeel over de tijdscomplexiteit van MatMul-LLM’s.
Ik heb ook een vergelijking gemaakt tussen MatMul-vrije en MatMul-LLM’s—je vindt die in dit artikel: Matmul-Free vs MatMul LLMs: Speed and Memory Consumption.
De MatMul-bottleneck in large language models
Moderne, transformer-gebaseerde LLM’s leunen zwaar op matrixvermenigvuldigingen, die centraal staan in kerncomponenten zoals attention-mechanismen en feedforward-lagen. De reken- en geheugenkosten van MatMul zijn aanzienlijk en hebben impact op zowel training als inferentie. Naarmate LLM’s groter worden, nemen het aantal parameters en de complexiteit van de berekeningen toe, waardoor MatMul een grote bottleneck wordt.
Een veelvoorkomend voorbeeld is wanneer het VRAM van een GPU onvoldoende is voor de modelgrootte, waardoor gebruikers gedwongen zijn om te trainen of te infereren op CPU’s. CPU’s zijn niet geoptimaliseerd voor geparallelliseerde MatMul-bewerkingen zoals GPU’s, wat tot aanzienlijk tragere berekeningen leidt. Dit creëert een frustrerende vicieuze cirkel waarin de beschikbare hardware niet volledig benut kan worden door geheugengrenzen, zelfs als de rekenkracht voldoende is.
Door de jaren heen hebben onderzoekers verschillende strategieën onderzocht om de rekenlast van MatMul te verminderen. Kwantisatie, waarbij de precisie van gewichten en activaties wordt verlaagd, is een populaire aanpak. Door getallen met minder bits weer te geven, kan kwantisatie de rekenkosten en het geheugengebruik van MatMul verlagen.
Toch gaat deze methode vaak ten koste van modelnauwkeurigheid en verwijdert ze MatMul niet volledig. Opmerkelijke pogingen zoals BitNet van Microsoft laten zien dat het mogelijk is LLM’s te schalen met binaire of ternaire kwantisatie, maar deze modellen blijven voor bepaalde onderdelen, zoals self-attention, op MatMul vertrouwen.
Er zijn ook alternatieve architecturen voorgesteld om de inefficiënties van MatMul aan te pakken. Benaderingen zoals AdderNet vervangen vermenigvuldigingen door optellingen in bepaalde netwerkcomponenten, en binaire/ternaire neurale netwerken maken gebruik van vereenvoudigde rekenbewerkingen
Hoewel deze methoden verbeteringen bieden, lukt het doorgaans niet om MatMul volledig te verwijderen en richten ze zich slechts op specifieke delen van het model. Daardoor blijven de totale rekenkosten hoog, wat de schaalbaarheid en efficiëntie van LLM’s beperkt.
Hoe MatMul-vrije taalmodellen werken
Om te begrijpen hoe MatMul-vrije LM’s werken, bekijken we de onderliggende architectuur en hoofdcomponenten.
MatMul vervangen door ternaire bewerkingen
In traditionele neurale netwerken gebruiken dense lagen (die alle neuronen tussen twee opeenvolgende lagen verbinden) MatMul om inputdata te transformeren. De auteurs vervangen deze door BitLinear-lagen, die ternaire gewichten gebruiken. In plaats van gewichten die elke reële waarde kunnen aannemen, zijn ze beperkt tot drie waarden: -1, 0 of 1.
De gewichten worden aanvankelijk met volledige precisie getraind en vervolgens tijdens training gekwantiseerd naar ternaire waarden met een proces dat "absmean-kwantisatie" heet. Dit schaalt de gewichtenmatrix met de gemiddelde absolute waarde en rondt elk element af naar het dichtstbijzijnde ternaire geheel getal (-1, 0 of 1).
Door deze vereenvoudiging kunnen vermenigvuldigingen in MatMul worden vervangen door optellingen en aftrekkingen. Een getal vermenigvuldigen met -1 staat bijvoorbeeld gelijk aan het negatief nemen, vermenigvuldigen met 0 levert 0 op, en vermenigvuldigen met 1 laat het getal onveranderd.
Kerncomponenten: MLGRU EN GLU
De onderstaande figuur geeft een overzicht van de belangrijkste componenten van het MatMul-vrije taalmodel, waaronder de MatMul-vrije Linear Gated Recurrent Unit (MLGRU) en de MatMul-vrije Gated Linear Unit (GLU):
Bron: Rui-Jie Zhu et. al
De figuur is opgedeeld in verschillende secties (van linksboven naar rechtsonder):
De MLGRU verwerkt de invoersequentie token voor token. Bij elke stap neemt hij de embedding van het huidige token en de vorige verborgen toestand als input. De verborgen toestand fungeert als geheugen en slaat informatie op van eerdere tokens. De MLGRU werkt deze verborgen toestand vervolgens bij met een reeks elementgewijze bewerkingen en gating-mechanismen. Deze gates, in wezen vectoren met getallen tussen 0 en 1, sturen de informatiestroom door te bepalen welke delen van de vorige verborgen toestand en de huidige token-embedding het meest relevant zijn voor de volgende stap. Dit gaat zo door totdat de hele sequentie is verwerkt.
De MatMul-vrije gated linear unit (GLU) is een andere sleutelcomponent van het MatMul-vrije taalmodel. Hij mengt informatie over de verschillende dimensies van de interne representatie van woorden (embeddings). Simpel gezegd helpt hij het model de verschillende aspecten of kenmerken van elk woord te begrijpen.
De GLU doet dit via een gating-mechanisme dat de informatiestroom tussen verschillende embeddingkanalen regelt. Dit mechanisme lijkt op de gates in de MLGRU, maar werkt op de kanaaldimensie in plaats van de tokendimensie.
De MatMul-vrije GLU is een aangepaste versie van de standaard GLU, ontworpen om matrixvermenigvuldigingen te elimineren met BitLinear-lagen: dense lagen met ternaire gewichten (gewichten die alleen -1, 0 of 1 kunnen aannemen). In de MatMul-vrije GLU wordt de input eerst met twee aparte BitLinear-lagen getransformeerd. De output van de ene laag gaat door de SiLU-activatiefunctie en wordt vervolgens elementgewijs vermenigvuldigd met de output van de andere laag. Deze gegate output gaat daarna door een andere BitLinear-laag om de uiteindelijke output te produceren.
Dit is slechts een high-level uitleg van de MLGRU- en GLU-componenten. Raadpleeg vooral het originele researchpaper voor een meer gedetailleerd begrip van de interne werking en wiskundige formuleringen.
MatMul-vrij vs. Transformers
Het onderzoek bekijkt de scaling laws van MatMul-vrije modellen en vergelijkt hun prestaties met traditionele Transformer-architecturen naarmate de modelgrootte toeneemt.
Prestaties en schaalbaarheid
Opvallend genoeg blijkt dat het prestatieverschil tussen beide benaderingen kleiner wordt naarmate de modelgrootte groeit. Dit is een belangrijk inzicht, omdat het suggereert dat MatMul-vrije modellen steeds competitiever worden met traditionele Transformers bij opschaling, en ze mogelijk voorbijstreven op zeer grote schaal.
Bron: Rui-Jie Zhu et. al
Deze grafiek met de vergelijking van scaling laws laat zien dat de verliescurves van MatMul-vrije LM’s en traditionele Transformers naar elkaar toe bewegen naarmate het aantal floating-point operations (FLOPs) toeneemt.
Aanvankelijk vertonen MatMul-vrije LM’s een hogere loss door de beperkingen van ternaire gewichten. Die kloof wordt echter kleiner naarmate de modelgrootte toeneemt, en op een bepaald punt (ster) kruisen de curves elkaar, wat op vergelijkbare prestaties wijst. Dit suggereert een steilere scaling law voor MatMul-vrije modellen, wat betekent dat hun prestaties sneller verbeteren bij toenemende grootte dan bij traditionele Transformers.
Benchmarkresultaten
De competitieve prestaties van MatMul-vrije LM’s worden verder bevestigd door hun goede resultaten op diverse zero-shot benchmarks. Bij taken zoals ARC-Easy, ARC-Challenge, Hellaswag, Winogrande, PIQA en OpenbookQA presteren deze modellen vaak gelijk aan of beter dan traditionele Transformers, ondanks hun aanzienlijk lagere rekencomplexiteit. Dat onderstreept de effectiviteit van de alternatieve bewerkingen en architecturale keuzes in MatMul-vrije LM’s.
Bron: Rui-Jie Zhu et. al
De tabel met zero-shot-nauwkeurigheid laat zien dat MatMul-vrije LM’s competitief presteren op verschillende taken. Zo haalt het MatMul-vrije LM met 2,7B parameters in de ARC-Challenge, een bijzonder moeilijke benchmark, een nauwkeurigheid die hoger is dan die van een traditioneel Transformer-model.
Ook op de Winogrande- en OpenbookQA-taken laten de MatMul-vrije LM’s sterke prestaties zien, wat aangeeft dat het schrappen van MatMul het vermogen van het model om taal te begrijpen en genereren niet ondermijnt.
Geheugenefficiëntie
Een van de meest in het oog springende voordelen van MatMul-vrije LM’s is hun uitzonderlijke geheugenefficiëntie. Door vermenigvuldigingsintensieve bewerkingen te vervangen door eenvoudige optellingen en aftrekkingen dankzij ternaire gewichten, realiseren deze modellen forse verminderingen in geheugengebruik.
Tijdens training kan een geoptimaliseerde GPU-implementatie het geheugenverbruik tot 61% verlagen vergeleken met niet-geoptimaliseerde modellen. Bij inferentie zijn de besparingen nog spectaculairder, met reducties van meer dan een factor tien. Dit maakt MatMul-vrije LM’s bijzonder aantrekkelijk voor inzet op apparaten met beperkte resources, zoals smartphones, waar geheugen vaak de beperkende factor is.
Bron: Rui-Jie Zhu et. al
Deze grafiek met de vergelijking van GPU-geheugen en latentie illustreert de efficiëntiewinst van MatMul-vrije LM’s. Het geheugengebruik bij inferentie van een MatMul-vrij LM met 2,7B parameters is aanzienlijk lager dan dat van een vergelijkbare traditionele Transformer. Deze kleinere geheugenvoetafdruk maakt niet alleen de inzet van grotere modellen op beperkte hardware mogelijk, maar vertaalt zich ook in lagere latentie, waardoor deze modellen geschikter zijn voor realtime-toepassingen waar responsiviteit cruciaal is.
Van geoptimaliseerde GPU’s naar custom FPGA-design
Een van de belangrijkste verbeteringen in het paper is de geoptimaliseerde GPU-implementatie van MatMul-vrije LM’s. De auteurs bereikten 25,6% hogere trainingssnelheid en tot 61,0% minder geheugengebruik door fused kernels te gebruiken in hun eigen GPU-implementatie. Deze kernels combineren meerdere bewerkingen tot één, efficiënter proces, waardoor de overhead van geheugen-toegang en databeweging afneemt.
Om de lichte bewerkingen van MatMul-vrije LM’s verder uit te buiten, ontwikkelden de auteurs een custom FPGA-accelerator in SystemVerilog. FPGA’s (Field-Programmable Gate Arrays) bieden een flexibel en efficiënt hardwareplatform voor gespecialiseerde rekentaken.
De custom accelerator is ontworpen om de eenvoud van ternaire bewerkingen en elementgewijze producten te benutten en zo aanzienlijke efficiëntiewinst te behalen. De RTL-implementatie (Register Transfer Level) is cruciaal in het FPGA-ontwerpproces. Hierbij specificeer je het hardwaregedrag op hoog niveau, dat vervolgens wordt gesynthetiseerd tot de daadwerkelijke FPGA-configuratie. Het custom RTL-ontwerp voor de MatMul-vrije LM’s zorgt ervoor dat de FPGA de lichte bewerkingen efficiënt kan afhandelen, met minder stroomverbruik en hogere doorvoer als resultaat.
Bron: Rui-Jie Zhu et. al
De figuur toont de RTL-implementatie van de custom FPGA-accelerator. Rechts van de Register Router zie je de functies die hij implementeert. De auteurs ontwikkelden ook een eigen assembler om assembly-bestanden met custom instructies om te zetten naar een instruction ROM, die je rechts in de figuur ziet. De instructies gaan naar de Register Router, die het geheugen (Register File) beheert en instructies uitvoert.
Verder vermeldden de auteurs in een reactie op een GitHub-issue dat de volledige specificaties van hun FPGA-implementatie nog worden geoptimaliseerd en dat de SystemVerilog-code later openbaar wordt gemaakt.
De onderstaande tabel toont het resourcegebruik en de prestatiecijfers voor de FPGA-implementatie van MatMul-vrije tokengeneratie.
Bron: Rui-Jie Zhu et. al
De data laat zien dat de totale latentie bij een toenemend aantal cores (verwerkingseenheden) binnen de FPGA aanvankelijk relatief stabiel blijft. De latentie neemt echter sterk toe van 16 naar 26 cores, wat suggereert dat de DDR4-interface, verantwoordelijk voor datatransfer, een bottleneck wordt naarmate de vraag naar datatransfer met het aantal cores groeit.
Hoewel de ternaire matrixvermenigvuldiging momenteel de totale latentie domineert, verwachten de auteurs dat optimalisatie van deze unit in toekomstige implementaties de bottleneck naar de DDR4-interface zal verschuiven.
Een van de meest intrigerende claims uit het paper is dat de MatMul-vrije aanpak LLM’s dichter bij de efficiëntie van het brein brengt qua rekenwerk en energieverbruik. De auteurs stellen dat hun modellen de efficiëntie van biologische neurale netwerken nabootsen en een mensachtige leessnelheid behalen.
Het rechtstreeks vergelijken van de efficiëntie van deze modellen met de complexe werking van biologische neurale netwerken is echter ingewikkeld en vereist verder onderzoek. De rekenmechanismen van het brein verschillen sterk en zijn veel complexer dan de vereenvoudigde bewerkingen in MatMul-vrije LM’s.
MatMul-vrij: implicaties en toekomstige richtingen
Het paper "Scalable MatMul-free Language Modeling" daagt een fundamentele aanname in natural language processing uit: dat matrixvermenigvuldiging (MatMul) essentieel is om hoog presterende LLM’s te bouwen.
Door de haalbaarheid van MatMul-vrije architecturen te tonen, opent dit onderzoek een nieuw front in LLM-ontwerp, dat aanzet tot het verkennen van alternatieve bewerkingen en rekenparadigma’s. Dit kan een golf van innovatie ontketenen, waarbij onderzoekers nieuwe modelarchitecturen ontwikkelen.
Hardwareversnelling voor lichte modellen
De verschuiving naar MatMul-vrije modellen draait niet alleen om software—het gaat ook om hardware. Traditionele chips zoals GPU’s zijn uitstekend in matrixvermenigvuldiging, maar niet per se de beste match voor deze nieuwe, lichte modellen.
De custom FPGA-accelerator die de onderzoekers bouwden, biedt een blik op de toekomst van AI-hardware—gespecialiseerde chips die elke druppel performance uit deze efficiënte modellen persen. Dit kan leiden tot een nieuwe generatie AI-apparaten die sneller, energiezuiniger en toegankelijker zijn voor een breder publiek.
Milieu-impact en duurzaamheid
Als iemand die om het milieu geeft, ben ik vooral enthousiast over het potentieel van MatMul-vrije modellen om de CO₂-voetafdruk van AI te verkleinen. Het enorme energieverbruik van de huidige large language models is een reëel probleem. Door de rekenvraag aanzienlijk te verlagen, kan dit onderzoek de weg vrijmaken voor energiezuinigere AI-technologieën met een kleinere ecologische voetafdruk.
Open onderzoeksvragen en toekomstig werk
Hoewel het paper "Scalable MatMul-free Language Modeling" een grote stap voorwaarts is, opent het ook diverse sporen voor vervolgonderzoek—het verkennen van verschillende MatMul-vrije architecturen, het evalueren van hun prestaties op een breder scala aan taken, en het wiskundig begrijpen van de theoretische grenzen van deze aanpak zijn slechts enkele veelbelovende richtingen.
Daarnaast zou het ontwikkelen van gestandaardiseerde benchmarks en evaluatiemetrieken specifiek voor MatMul-vrije modellen eerlijke vergelijkingen vergemakkelijken en de vooruitgang in dit veld versnellen. De reis naar echt efficiënte en toegankelijke AI is nog maar net begonnen, en de mogelijkheden zijn legio. Ook ik kijk persoonlijk erg uit naar toekomstige MatMul-vrije assistent-chatbots!
Conclusie
Het paper "Scalable MatMul-free Language Modeling" levert een belangrijke bijdrage aan het LLM-domein met een nieuwe aanpak die matrixvermenigvuldigingen (MatMul) elimineert.
Deze doorbraak pakt de reken- en geheugenbottlenecks van traditionele LLM’s aan en effent het pad voor efficiëntere en beter schaalbare modellen. Door gebruik te maken van additieve bewerkingen en ternaire gewichten tonen de auteurs aan dat je concurrerende prestaties kunt behouden terwijl je de benodigde resources flink terugbrengt.
De potentiële impact van dit onderzoek op de toekomst van LLM-ontwikkeling en -inzet is groot. MatMul-vrije modellen vormen een levensvatbaar alternatief voor conventionele architecturen, waardoor lichte, efficiënte modellen mogelijk worden die goed passen bij omgevingen met beperkte resources, zoals edge-devices en mobiele platforms.
Wil je meer leren over artificial intelligence? Bekijk dan deze AI-cursussen.