Last chance! 50% off DataCamp Premium
Sale ends in
Als iemand die regelmatig geavanceerde modellen zoals OpenAI’s ChatGPT en Anthropic's Claude gebruikt, heb ik uit eerste hand gezien hoe hun prestaties achteruitgaan naarmate de invoerprompts langer worden, wat leidt tot problemen met samenhang en relevantie bij langere teksten.
Om deze beperkingen aan te pakken introduceren onderzoekers van Microsoft en de University of Illinois SAMBA—een nieuwe hybride architectuur die state space models (SSM’s) combineert met sliding window attention (SWA).
Hun aanpak benut de sterke punten van zowel SSM’s, die uitstekend zijn in het beheren van langetermijnafhankelijkheden, als SWA, dat contextvensters afhandelt en de rekentracteerbaarheid behoudt. Door deze technieken te combineren, bereikt SAMBA efficiënte taalmodellering met in de praktijk onbeperkte contextlengte.
In dit artikel verkennen we de architectuur van SAMBA en het unieke vermogen om lange tekststukken te verwerken zonder context te verliezen. We benadrukken ook het potentieel om de mogelijkheden van taalmodellen bij het verwerken en genereren van uitgebreide sequenties aanzienlijk te vergroten, waarmee een nieuwe standaard in taalmodellering wordt gezet.
Om te begrijpen waarom SAMBA zo innovatief is, moeten we eerst de uitdagingen begrijpen waar traditionele taalmodellen tegenaan lopen bij lange tekstsequenties.
Traditionele transformer-gebaseerde modellen, hoe krachtig ook, hebben grote moeite met lange tekstsequenties door hun kwadratische complexiteit ten opzichte van de contextlengte. Deze kwadratische complexiteit komt voort uit het self-attention-mechanisme, waarbij ieder token aandacht moet besteden aan elk ander token in de sequentie.
Daardoor nemen de reken- en geheugenkosten snel toe naarmate de sequentie langer wordt, waardoor deze modellen onpraktisch worden voor taken die zeer lange teksten moeten verwerken.
Deze beperking dwingt ons vaak om input af te kappen of andere suboptimale strategieën te gebruiken om binnen de hardwarebeperkingen te blijven. Uiteindelijk verkleint dit de capaciteit van het model om prestaties over langere sequenties vast te houden—een uitdaging die ik tegenkwam bij het ontwikkelen van een applicatie die lange documenten moet verwerken.
State Space Models (SSM’s) bieden een alternatief met lineaire complexiteit, waardoor ze rekenkundig efficiënter zijn voor lange sequenties. SSM’s houden een evoluerende toestand bij, zodat ze uitgebreide afhankelijkheden aankunnen zonder de prohibitieve kosten van transformers.
Toch hebben SSM’s hun beperkingen. Door hun Markoviaanse karakter, waarbij de huidige toestand alleen afhangt van de vorige, hebben ze vaak moeite met geheugenherstel over lange sequenties. Deze beperkte geheugenherinnering vermindert hun effectiviteit in uitgebreide contextmodellering, vooral in toepassingen die vereisen dat informatie van veel eerder in de sequentie wordt vastgehouden en geraadpleegd.
Gezien de sterke en zwakke punten van zowel transformers als SSM’s is er een sterke behoefte aan hybride benaderingen die de voordelen van beide benutten en hun beperkingen mitigeren. Het combineren van SSM’s met aandachtmechanismen is een veelbelovende oplossing.
Deze hybride aanpak gebruikt de efficiëntie en langetermijnafhankelijkheidseigenschappen van SSM’s naast het dynamische en gefocuste attention-mechanisme van transformers. Door deze twee methoden te integreren, kunnen we een model creëren dat lange sequenties soepel verwerkt met verbeterd geheugenherstel en contextueel begrip.
SAMBA biedt een elegante oplossing voor dit contextknelpunt door de sterke punten van twee verschillende benaderingen te combineren.
Het kernidee achter SAMBA is het afwisselen van Mamba, een SSM, met SwiGLU- en sliding window attention (SWA)-lagen. Deze hybride structuur legt zowel recursieve structuren als precieze geheugenopvraging vast.
SAMBA is hier een voorbeeld van door de sterke punten van SSM’s en attention-mechanismen te combineren om lange contexten te beheren en toch gedetailleerde informatie te behouden.
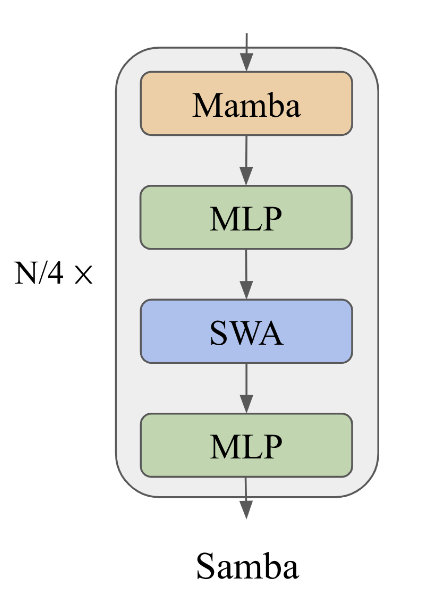
Een diagram dat de SAMBA-architectuur illustreert. Bron: Ren et al. (2024)
Mamba-lagen in SAMBA zijn bedreven in het vastleggen van tijdsafhankelijke semantiek en bieden een robuust raamwerk voor het verwerken van sequentiële data. Deze lagen werken door een toestand bij te houden en bij te werken die de temporele afhankelijkheden in de data weerspiegelt.
Mamba bereikt dit met selectieve toestandsruimten, waardoor het model zich kan richten op relevante input en belangrijke informatie over lange sequenties kan vasthouden. Dit selectieve gatingmechanisme is cruciaal voor snel decoderen en zorgt ervoor dat het model sequentiële patronen met hoge nauwkeurigheid en minimale rekenkosten kan interpreteren en voorspellen.
Sliding window attention-lagen vullen de Mamba-lagen aan door complexe, niet-Markoviaanse afhankelijkheden binnen een beperkt contextvenster aan te pakken. SWA werkt met een venstergrootte die over de invoersequentie schuift en zo lineaire rekencomplexiteit waarborgt.
Hierdoor kan het model high-definition signalen ophalen uit de midden- tot kortetermijngeschiedenis die niet door de recursieve toestanden van Mamba kunnen worden vastgelegd. Door de focus dynamisch aan te passen, zorgen SWA-lagen ervoor dat het model samenhang en context behoudt, vooral bij taken die contextueel relevante reacties over lange input vereisen.
SwiGLU-lagen in SAMBA faciliteren niet-lineaire transformatie en versterken kennisherinnering. Deze lagen introduceren niet-lineariteit in het model, waardoor het complexere patronen en interacties in de data kan vastleggen.
Bovendien zorgen SwiGLU-lagen ervoor dat het model informatie kan verwerken en terughalen, wat bijdraagt aan de robuustheid en veelzijdigheid. Deze niet-lineaire transformatie is essentieel voor het vermogen van het model om van trainingsdata naar real-world toepassingen te generaliseren.
Nu we de architectuur van SAMBA hebben verkend, bekijken we de prestaties en efficiëntie in vergelijking met andere modellen.
SAMBA laat goede prestaties zien op diverse benchmarks voor taalbegrip en redeneren, en overtreft zowel puur attention-gebaseerde als SSM-gebaseerde modellen. SAMBA is onder meer geëvalueerd op taken als MMLU, GSM8K en HumanEval, met een score van 71,2 voor MMLU, 69,6 voor GSM8K en 54,9 voor HumanEval.
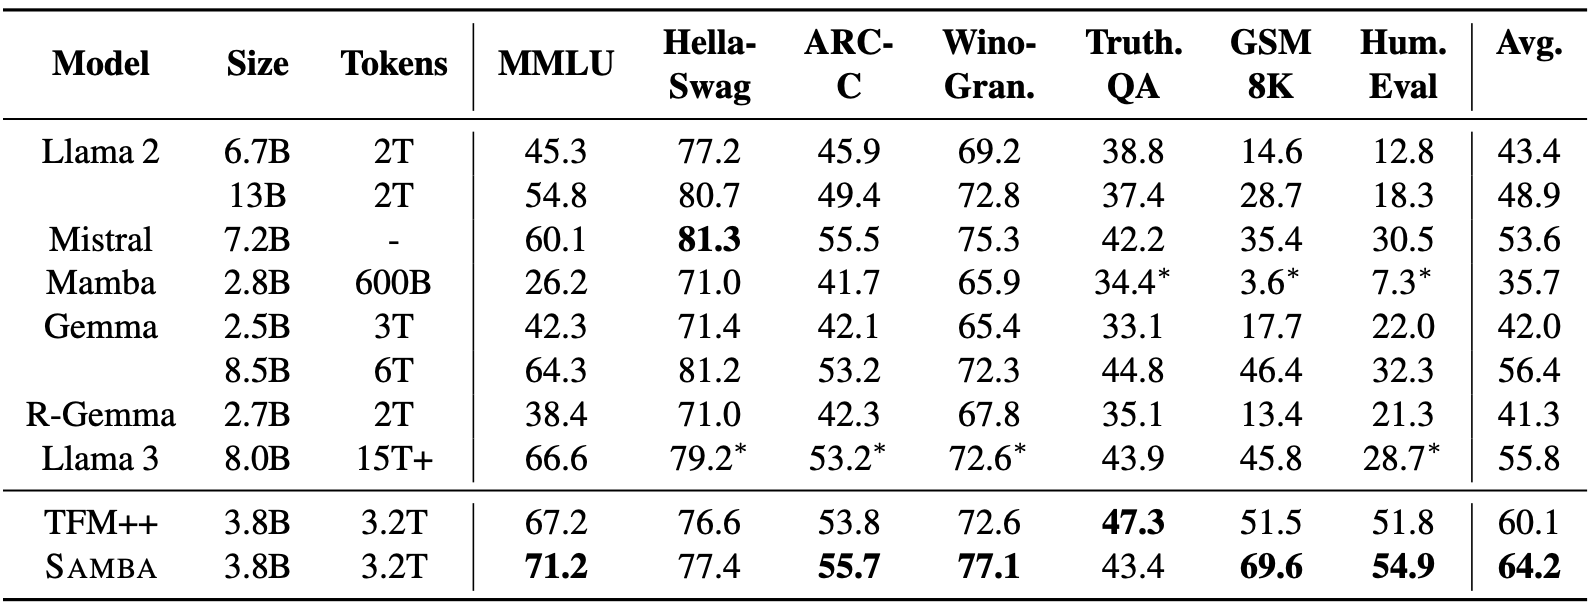
Bron: Ren et al. (2024)
Deze resultaten overtreffen die van andere state-of-the-artmodellen, waaronder TFM++ en Llama-3, en tonen aan dat SAMBA diverse taken op het gebied van taalbegrip aankan. Zo behaalde SAMBA 18,1% hogere nauwkeurigheid op GSM8K dan TFM++, wat de kracht van de hybride architectuur onderstreept die SSM met attention-mechanismen combineert.
Een van de meest opvallende kenmerken van SAMBA is het vermogen om aanzienlijk langere contextlengtes aan te kunnen met behoud van efficiëntie. Ondanks pre-training op sequenties van 4K kan SAMBA extrapoleren tot 1M tokens met verbeterde perplexity en nog steeds lineaire decodeercomplexiteit in de tijd behouden.
Dit wordt bereikt door de gelaagde combinatie van Mamba’s selectieve toestandsruimten met SWA, waardoor het model hoge prestaties kan leveren zonder kwadratische rekencomplexiteit.
In de praktijk behaalt SAMBA een 3,64× hogere decodeerdoorvoer vergeleken met de Llama-3-architectuur, met name voor sequenties tot 128K tokens, wat de schaalbaarheid en het vermogen om lange contexten te verwerken aantoont.
De hybride architectuur van SAMBA vergroot de geheugenherinnering aanzienlijk vergeleken met pure SSM’s. In tests zoals Passkey Retrieval liet SAMBA bijna perfecte geheugenopvraging zien tot 256K contextlengte na slechts 500 fine-tuningstappen, terwijl op SWA gebaseerde modellen moeite hadden voorbij 4K.
Deze uitzonderlijke prestaties zijn te danken aan de gecombineerde sterke punten van Mamba’s recursieve structuren voor tijdsafhankelijke semantiek en de geheugenopvragingsmogelijkheden van SWA. Daardoor blinkt SAMBA uit in taken voor zowel korte- als langetermijngeheugen, wat het tot een robuuste oplossing maakt voor toepassingen die uitgebreide contextbegrip vereisen.
Laten we de specifieke ontwerpkeuzes en strategieën bekijken die bijdragen aan de indrukwekkende prestaties van SAMBA.
SAMBA gebruikt een geavanceerde hybridisatiestrategie die Mamba-, SWA- en Multi-Layer Perceptron (MLP)-lagen combineert. Deze aanpak optimaliseert prestaties voor taalmodellering met lange context door de unieke eigenschappen van elk onderdeel te benutten:
Het SAMBA-paper verkent verschillende lineaire recursieve modellen en attention-mechanismen om de meest optimale combinatie te identificeren. Alternatieven zoals Multi-Scale Retention en GLA werden overwogen als mogelijke vervangers voor Mamba. Meer informatie over de Mamba-architectuur vind je in deze introductiegids voor de Mamba LLM-architectuur.
Deze verkenningen waren gericht op het balanceren van rekenefficiëntie en prestaties bij taalmodelleringstaken. De vergelijking liet zien dat hoewel deze alternatieven enkele voordelen boden, de combinatie van Mamba met SWA- en MLP-lagen de beste algehele prestaties en schaalbaarheid behaalde.
Analyse van de entropie van aandachtverdelingen leverde waardevolle inzichten op in de prestaties van SAMBA en vergelijkbare modellen zoals Mistral. De aandachtentropie-analyse toonde aan dat SAMBA een stabieler en betrouwbaarder geheugenherstel behoudt over langere contexten.
Bijvoorbeeld, in de Passkey Retrieval-taak liet SAMBA bijna perfecte opvraging zien tot 256K contextlengtes en presteerde daarmee aanzienlijk beter dan Mistral. De heatmap-analyse gaf aan dat de hybride architectuur van SAMBA zorgt voor hoge opvraagaccuratesse op verschillende posities van de passkey, wat de uitzonderlijke langafstandsopvragingscapaciteiten onderstreept.
Gezien het vermogen om lange sequenties effectief te verwerken, opent SAMBA een breed scala aan potentiële toepassingen.
Het vermogen van SAMBA om een onbeperkte contextlengte aan te kunnen, biedt grote mogelijkheden voor uiteenlopende taken met lange context. Het kan samenhang en relevantie behouden over uitgebreide sequenties, wat het bijzonder geschikt maakt voor toepassingen zoals:
De architectuur van SAMBA is ontworpen met efficiëntie in gedachten en pakt de typische beperkingen van zowel puur attention-gebaseerde als SSM-gebaseerde modellen aan. Enkele belangrijke voordelen zijn:
Vooruitkijkend zijn er verschillende interessante paden voor toekomstig werk die de mogelijkheden van SAMBA verder kunnen ontwikkelen:
SAMBA is een belangrijke stap vooruit in taalmodellering, met een nieuwe hybride architectuur die SSM’s combineert met sliding SWA- en MLP-lagen. De belangrijkste innovaties en voordelen van de SAMBA-architectuur zijn de hybridisatie van SSM en attention-mechanismen, efficiëntie bij lange contexten en verbeterd geheugenherstel.
Hoewel hiermee onze verkenning van de SAMBA-architectuur is afgerond, is een goede manier om een dieper begrip te krijgen van de architectuur en haar innovaties te experimenteren met de implementatie op GitHub.
Wil je meer leren over de nieuwste AI-innovaties? Dan raad ik deze blogposts aan:
Leer AI met deze cursussen!
Cursus
Leerpad
Cursus
blog
Adel Nehme
15 min