
Last chance! 50% off DataCamp Premium
Sale ends in
Het snelgroeiende vakgebied data science draait op data, maar het verzamelen van grote, gelabelde datasets kan een flinke bottleneck zijn in het modelontwikkelingsproces. Hier komt few-shot learning om de hoek kijken: een vernieuwende aanpak waarmee je met slechts een handvol voorbeelden al waardevolle inzichten kunt ontsluiten.
In tegenstelling tot traditionele supervised learning-methoden die enorme hoeveelheden data vereisen, stelt few-shot learning modellen in staat om snel te leren en zich aan te passen. Dat maakt het bijzonder relevant in domeinen waar data schaars is, duur om te verzamelen of gevoelig van aard.
Dit artikel biedt een uitgebreide verkenning van few-shot learning en gaat in op het belang, de mechanismen en de uiteenlopende toepassingen in verschillende sectoren.
Few-shot learning (FSL) is een subveld van machine learning waarin modellen patronen leren herkennen en voorspellingen doen op basis van een zeer klein aantal trainingsvoorbeelden. Dit staat haaks op traditioneel supervised learning, dat vaak enorme hoeveelheden gelabelde data nodig heeft voor effectieve training.
FSL legt de nadruk op generaliseren in plaats van memoriseren. Een van de vroegste werken is de paper “Language Models are Few Shot Learners” van Tom B. Brown e.a., die de noodzaak van uitgebreide fine-tuning ter discussie stelt.
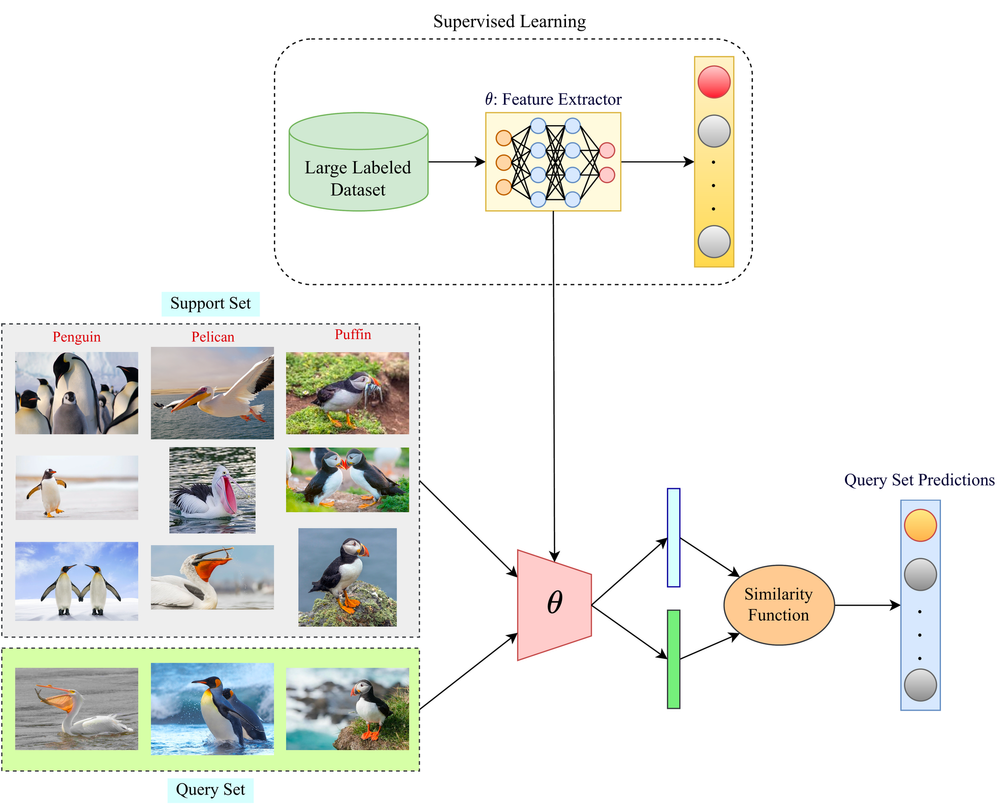
Een diagram dat het verschil illustreert tussen supervised learning en few-shot learning. Het gedeelte over supervised learning toont een grote gelabelde dataset die wordt gebruikt om een feature-extractormodel te trainen, terwijl het gedeelte over few-shot learning laat zien hoe met een kleine supportset en een similariteitsfunctie voorspellingen worden gedaan op een queryset. Bron: Paperspace
Denk aan een kind dat leert verschillende dieren te herkennen. Met maar een paar voorbeelden van honden, katten en vogels kan het snel deze dieren herkennen en onderscheiden, ook als het rassen of soorten tegenkomt die het nog niet eerder heeft gezien.
Dit vermogen om te generaliseren op basis van beperkte data is kenmerkend voor menselijke intelligentie, en precies dat is wat few-shot learning wil bereiken.
De sleutel ligt in het kunnen onderscheiden van de onderliggende structuur en kenmerken die een categorie definiëren.
Mensen hebben een aangeboren vermogen om essentiële informatie uit beperkte ervaringen te halen en die kennis toe te passen in nieuwe situaties. Few-shot learning-modellen proberen dit na te bootsen door een algemeen begrip te leren van de onderliggende structuur van de data op basis van eerdere ervaringen.
Die kennis wordt vervolgens benut om zich snel aan te passen aan nieuwe taken met minimale extra informatie, net zoals het kind een nieuw hondenras herkent op basis van bestaande kennis over honden.
FSL helpt de ontwikkelaar te focussen op modelontwikkeling in plaats van dataverzameling. Het vermogen om van beperkte data te leren biedt verschillende voordelen:
Few-shot learning valt onder de bredere paraplu van n-shot learning en omvat verschillende technieken op basis van het aantal gegeven voorbeelden:
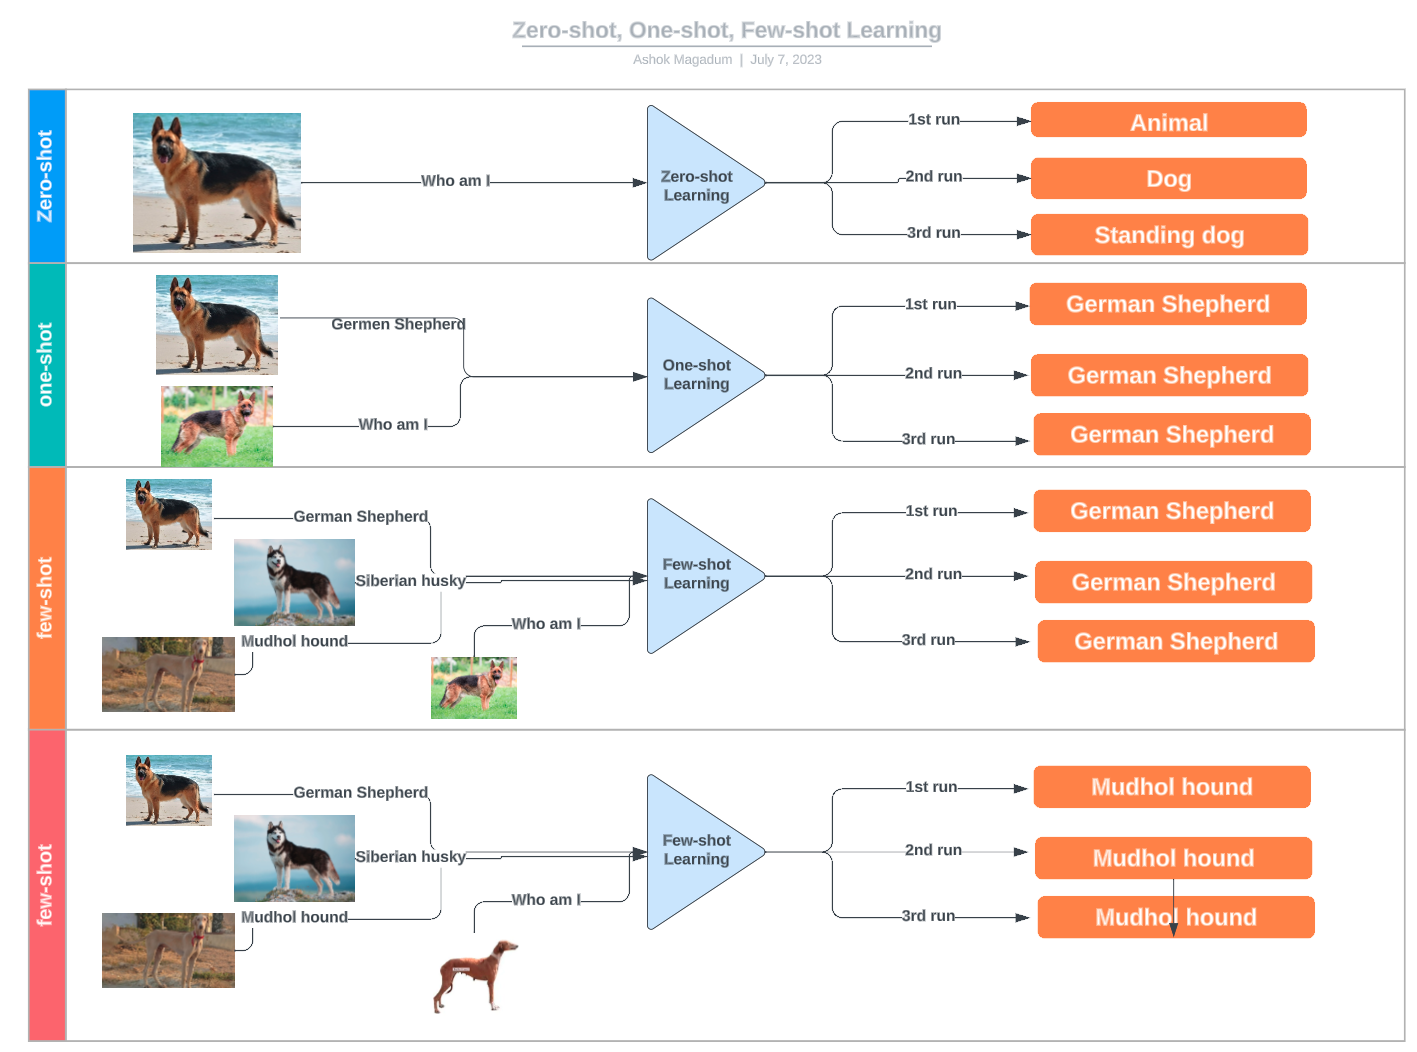
Een diagram dat de verschillen tussen zero-shot, one-shot en few-shot learning illustreert aan de hand van voorbeelden van hondenrasclassificatie. Bron: LinkedIn
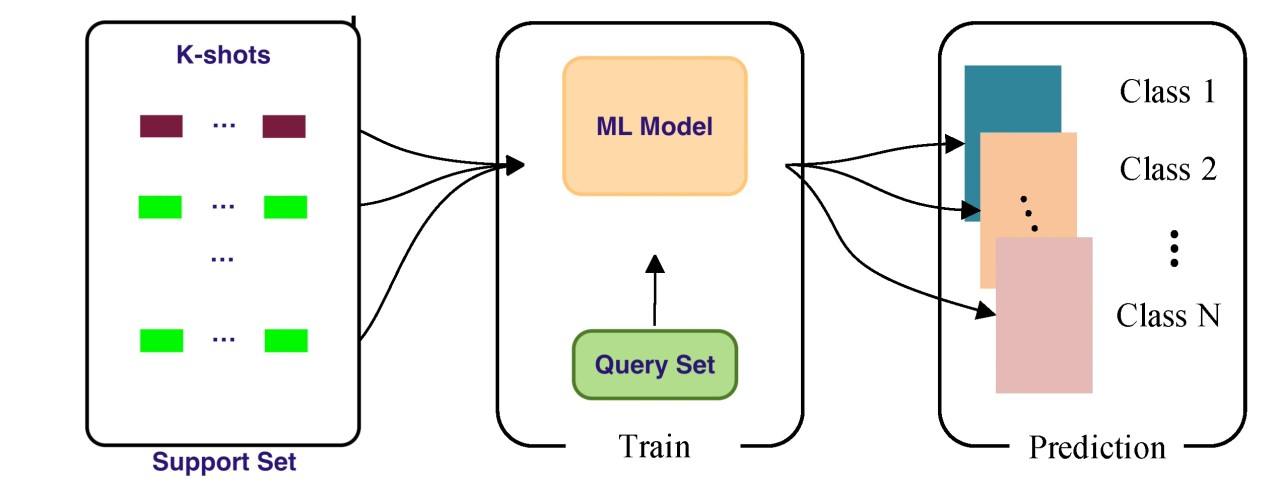
Een diagram dat het few-shot learning-proces illustreert. Het toont een supportset met k-shotvoorbeelden voor meerdere klassen, een machinelearningmodel dat wordt getraind op een queryset, en vervolgens voorspellingen doet voor nieuwe datainstanties over verschillende klassen. Bron: LinkedIn
In tegenstelling tot traditioneel supervised learning, dat steunt op uitgebreide trainingsdatasets, benutten few-shot learning-modellen voorafgaande kennis en leerervaringen om zich met minimale extra data snel aan te passen aan nieuwe taken. Door de onderliggende structuur en kenmerkende eigenschappen te onderscheiden die een concept definiëren, kunnen deze modellen effectief generaliseren en met slechts enkele voorbeelden nauwkeurige voorspellingen doen voor nieuwe instanties.
Die kennis wordt vervolgens toegepast om zich snel aan te passen aan nieuwe taken via een similariteitsfunctie die de klassen in de query- en supportsets met minimale extra informatie kan matchen.
Ter context: met de queryset bedoelen we hier de samples uit zowel oude als nieuwe categorieën waarop het model generaliseert en die worden gebruikt om de prestaties te evalueren. De supportset bestaat daarentegen uit de paar gelabelde samples uit elke nieuwe categorie data, die worden gebruikt om de parameters van het model te updaten:
MAML leert een algemene model-initialisatie die met slechts een paar gradientstappen kan worden gefinetuned voor specifieke taken. Het is een veelzijdige en krachtige meta-learningaanpak die modellen in staat stelt zich opmerkelijk efficiënt aan nieuwe taken aan te passen.
De kracht zit in het vermogen om een model-initialisatie te leren die snel leren mogelijk maakt via slechts enkele gradient descent-stappen op een nieuwe taak.
Dit maakt het model in feite “makkelijk te fine-tunen”, waardoor het met minimale data snel de finesses van nieuwe taken oppikt.
MAML werkt volgens het principe van het leren van een set initiële parameters θ die sterk gevoelig zijn voor veranderingen in de taak. Die gevoeligheid zorgt ervoor dat kleine aanpassingen aan de parameters de verliesfunctie van elke taak uit de taakdistributie p(T) aanzienlijk kunnen verbeteren wanneer ze worden geüpdatet in de richting van de gradiënt van dat verlies.
Hier is een overzicht van het MAML-algoritme:
Metric learning richt zich op het leren van een afstandsfunctie die de similariteit tussen datapunten meet. Het concentreert zich op het leren van een afstandsfunctie, aangeduid als d(x, x'), die de similariteit meet tussen datapunten x en x'. Zo kunnen modellen nieuwe datapunten classificeren door ze te vergelijken met een paar bekende voorbeelden.
Transfer learning benut kennis die is opgedaan bij een brontaak om de prestaties op een gerelateerde doeltaak te verbeteren.
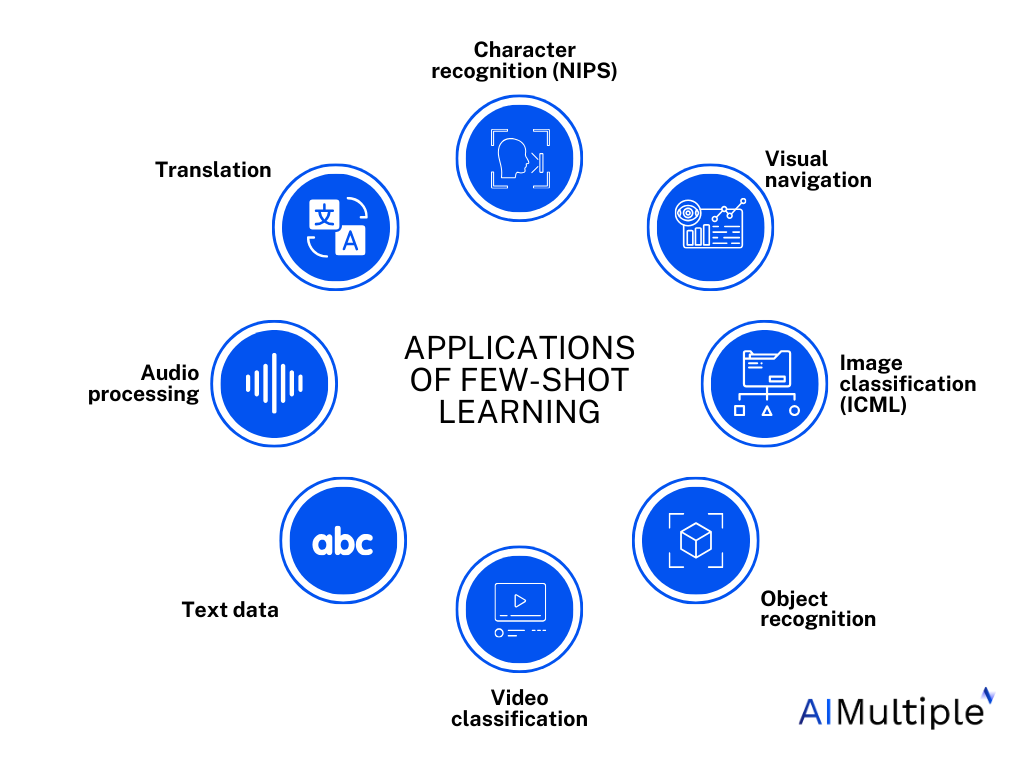
Een overzicht van de toepassingen van FSL in verschillende domeinen. Bron: AI Multiple Research
De toepassingen van few-shot learning zijn breed en reiken ver, van computer vision en natural language processing tot robotica en gezondheidszorg. In computer vision kan few-shot learning systemen bijvoorbeeld in staat stellen zeldzame objecten te herkennen of subtiele patronen in medische beeldvorming te identificeren met slechts een handvol trainingsvoorbeelden.
In natural language processing kan few-shot learning de weg vrijmaken voor gepersonaliseerde taalmodellen die iemands unieke schrijfstijl of dialect kunnen nabootsen, wat contentcreatie en communicatie kan veranderen. Daarnaast biedt het groot potentieel voor het behoud en de vertaling van low-resource-talen, wat culturele uitwisseling en inclusiviteit bevordert.
Misschien liggen de meest ingrijpende toepassingen in geneesmiddelenontwikkeling en de gezondheidszorg. Door modellen te trainen op beperkte data uit klinische trials of zeldzame ziektegevallen, kan few-shot learning de ontwikkeling van levensreddende behandelingen versnellen en nauwkeurigere diagnoses mogelijk maken, wat uiteindelijk de patiëntuitkomsten verbetert.
Despite its immense potential, few-shot learning is not without its challenges. One of the primary hurdles is the risk of overfitting, where models become too specialized on the limited training data and fail to generalize effectively to new instances. Additionally, selecting the appropriate similarity measure or distance function is crucial for accurate performance, and task ambiguity or noisy data can further impede model effectiveness.
Toch hebben deze uitdagingen juist geleid tot een golf aan onderzoek en innovatie. Benaderingen zoals meta-learning, metric learning en transfer learning zijn naar voren gekomen als veelbelovende strategieën om de capaciteiten van few-shot learning te vergroten. Technieken zoals Model-Agnostic Meta-Learning (MAML) en Prototypical Networks hebben opmerkelijk succes laten zien in het snel aanpassen aan nieuwe taken met minimale data.
Naarmate het veld zich verder ontwikkelt, kunnen we nog geavanceerdere en robuustere few-shot learning-methoden verwachten, die de grenzen verleggen van wat mogelijk is met beperkte data. Uiteindelijk schuilt de ware kracht van few-shot learning in het democratiseren van AI, waardoor het toegankelijk wordt voor domeinen en toepassingen die eerder werden belemmerd door dataschaarste, en zo een nieuw tijdperk inluiden van data-efficiënte, aanpasbare en inclusieve kunstmatige intelligentie.
Few-shot learning is een belangrijke stap vooruit binnen machine learning en stelt ons in staat om inzichten te halen uit beperkte data. Door de verschillende benaderingen en toepassingen te begrijpen, kunnen beginnende datapractitioners dit krachtige hulpmiddel inzetten om echte problemen in uiteenlopende domeinen aan te pakken.
Naarmate het onderzoek vordert, kunnen we nog meer innovatieve en efficiënte few-shot learning-technieken verwachten, die de grenzen van data science verder verleggen.
Wil je andere machine learning-concepten onder de knie krijgen? Bekijk dan onze Machine Learning Scientist with Python carrièretrack.
Blijf leren met DataCamp
Leerpad
Cursus
Leerpad
blog
Adel Nehme
15 min

