GPT 5.3 Codex testen: hands-on voorbeelden
De releasenotes en eerste benchmarkresultaten laten duidelijk zien dat agent-workflows de hoogste prioriteit hadden bij de ontwikkeling van het nieuwe model. Daarom leggen onze voorbeelden hier ook sterk de nadruk op.
Als je GPT’s huidige redeneervaardigheden in actie wilt zien, raad ik onze gids over GPT-5.2 aan.
Test 1: Full‑stack builder
Voor de eerste test wilde ik checken hoe goed het model afhankelijkhedenbeheer en documentatie afhandelt voor een eenvoudige weertool met FastAPI en de Open‑Meteo API. Ik gebruikte de volgende prompt:
Create a simple Python API using FastAPI that fetches the current temperature for a given city (e.g., Helsinki) using the Open-Meteo API.
1. Write the code in main.py using the httpx or requests library to call the API.
2. Create a Dockerfile to containerize it.
3. Write a README.md explaining how to run it.
4. Create a bash script run_local.sh that builds the image and runs it on port 8000.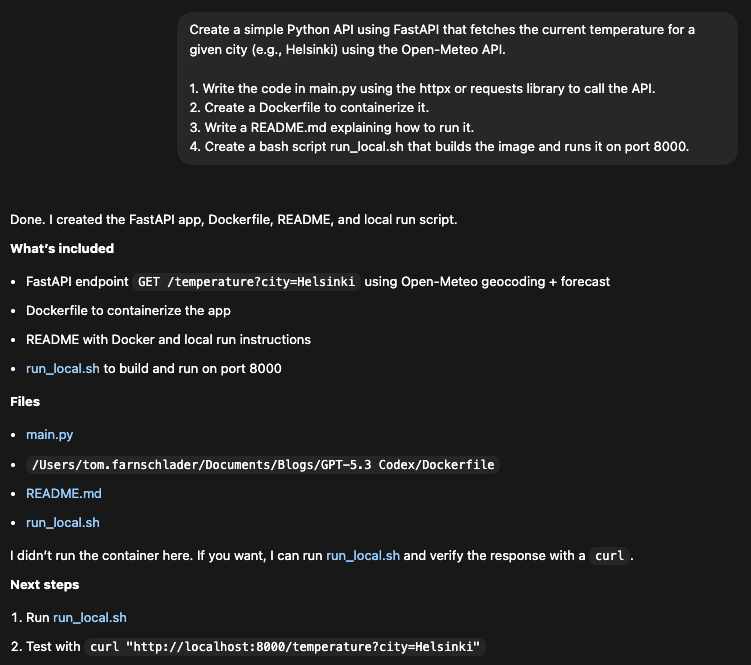
In 41 seconden werden alle vier de bestanden gegenereerd in één prompt, met consistente poortnummers (8000) en naamgeving.
Wat betreft de dependencies herkende Codex httpx correct als een moderne async-client (een goede keuze boven requests voor FastAPI) en nam het deze op in de installatieregel van de Dockerfile. Het besefte ook dat FastAPI afhankelijk is van uvicorn en voegde dat toe aan de dependencies.
Eén kleine kanttekening is de hardcoded installatie in de Dockerfile: Codex sloeg requirements.txt feitelijk over door direct te installeren in de RUN-instructie. Dit kan een valide shortcut zijn voor een “eenvoudig” script, zeker omdat we niet om een requirements.txt vroegen, maar een apart bestand zou later voor meer duidelijkheid en flexibiliteit zorgen. De Dockerfile ziet er zo uit:
FROM python:3.11-slim
WORKDIR /app
COPY main.py /app/main.py
RUN pip install --no-cache-dir fastapi uvicorn httpx
EXPOSE 8000
CMD ["uvicorn", "main:app", "--host", "0.0.0.0", "--port", "8000"]Codex schreef niet alleen de code, maar begreep duidelijk de context van het verzoek en de API-architectuur. Let op hoe het automatisch het tweestapsproces van Open‑Meteo (Geocoding -> Weer) afhandelde. Ik vertelde niet hoe de API te gebruiken, alleen welke. Het las de docs (of kende ze) en implementeerde de benodigde logica om ?city=Helsinki te laten werken.
Het voegde ook robuuste foutafhandeling toe (try/except, raise voor specifieke statussen, 404-checks voor "City not found") zonder dat daarom was gevraagd.
from fastapi import FastAPI, HTTPException, Query
import httpx
app = FastAPI(title="Simple Weather API", version="1.0.0")
GEOCODE_URL = "https://geocoding-api.open-meteo.com/v1/search"
FORECAST_URL = "https://api.open-meteo.com/v1/forecast"
@app.get("/health")
def health() -> dict:
return {"status": "ok"}
@app.get("/temperature")
def temperature(city: str = Query(..., min_length=1)) -> dict:
city = city.strip()
if not city:
raise HTTPException(status_code=400, detail="City must not be empty")
try:
with httpx.Client(timeout=10.0) as client:
geo_resp = client.get(
GEOCODE_URL,
params={
"name": city,
"count": 1,
"language": "en",
"format": "json",
},
)
geo_resp.raise_for_status()
geo_data = geo_resp.json()
results = geo_data.get("results") or []
if not results:
raise HTTPException(status_code=404, detail="City not found")
place = results[0]
latitude = place.get("latitude")
longitude = place.get("longitude")
resolved_name = place.get("name")
country = place.get("country")
forecast_resp = client.get(
FORECAST_URL,
params={
"latitude": latitude,
"longitude": longitude,
"current": "temperature_2m",
},
)
forecast_resp.raise_for_status()
forecast_data = forecast_resp.json()
current = forecast_data.get("current") or {}
units = forecast_data.get("current_units") or {}
temperature_value = current.get("temperature_2m")
temperature_unit = units.get("temperature_2m", "")
current_time = current.get("time")
if temperature_value is None:
raise HTTPException(status_code=502, detail="Temperature unavailable")
return {
"city": resolved_name,
"country": country,
"latitude": latitude,
"longitude": longitude,
"temperature": temperature_value,
"unit": temperature_unit,
"time": current_time,
}
except httpx.HTTPStatusError as exc:
raise HTTPException(status_code=502, detail=f"Upstream error: {exc.response.status_code}")
except httpx.RequestError:
raise HTTPException(status_code=502, detail="Upstream request failed")Er is nog minstens één mogelijke optimalisatie te zien: het gebruikte httpx.Client (synchronisch) binnen een standaard def-route. Voor FastAPI is dit blocking. Een perfecte “expert”-agent had misschien async def en httpx.AsyncClient gebruikt.
Toch leverde de eerste test een functionele tool op. run_local.sh bouwen startte het Docker-image en zette de container op poort 8000. Bij het uitproberen gaf het succesvol de huidige temperatuur in Helsinki terug:
curl "http://localhost:8000/temperature?city=Helsinki"{"city":"Helsingfors","country":"Finland","latitude":60.16952,"longitude":24.93545,"temperature":-6.0,"unit":"°C","time":"2026-02-09T07:15"}Test 2: Live sturen in actie
Om vervolgens de stuurfunctie te proberen, vroeg ik Codex eerst om een landingspagina voor een koffiebar te bouwen, maar veranderde daarna het gevraagde thema tijdens de workflow. Aangezien webontwikkeling expliciet werd genoemd als een van de sterke punten van GPT-5.3-Codex, zou dat appeltje-eitje moeten zijn (bij de koffie). De oorspronkelijke prompt is:
Build a landing page for a coffee shop using HTML and CSS. Use a dark theme with blue accents.Als je in de Codex-app werkt, zie je twee opties wanneer je over de knop “Bericht invoeren” zweeft terwijl Codex bezig is:
- In de wachtrij: Laat Codex je prompt afhandelen nadat het klaar is met werken (Enter)
- Sturen: Wijzig de oorspronkelijke prompt of geef direct context (Cmd + Enter)
Toen ik zag dat index.html was aangemaakt en Codex aan het CSS-bestand werkte, bedacht ik me:
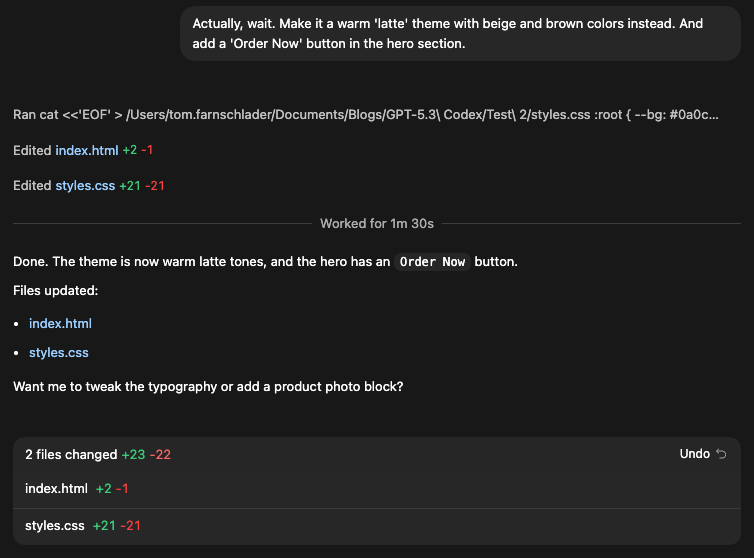
Codex nam de nieuwe context op in de oude prompt en gaf het eindresultaat terug met het nieuw gevraagde thema zonder te stoppen. Je ziet ook de wijzigingen die zijn aangebracht na de stuurinstructie, met toegevoegde en verwijderde regels respectievelijk groen en rood gemarkeerd.
Het resultaat oogt netjes en clean, bevat de gewenste knop en het thema past bij onze laatste wens. De website voelt wel wat levenloos, maar dat is waarschijnlijk te verwachten bij onze zeer beknopte prompt.
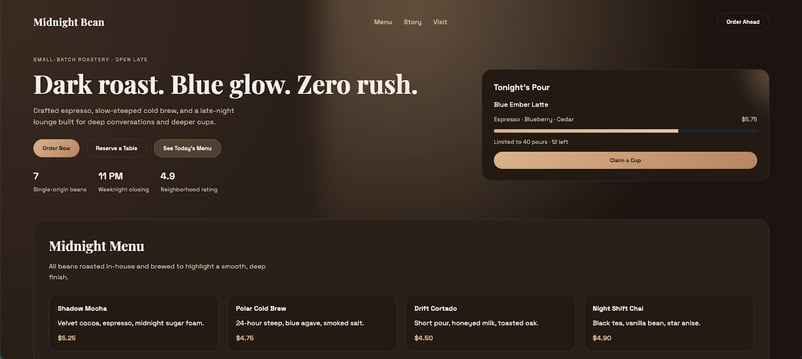
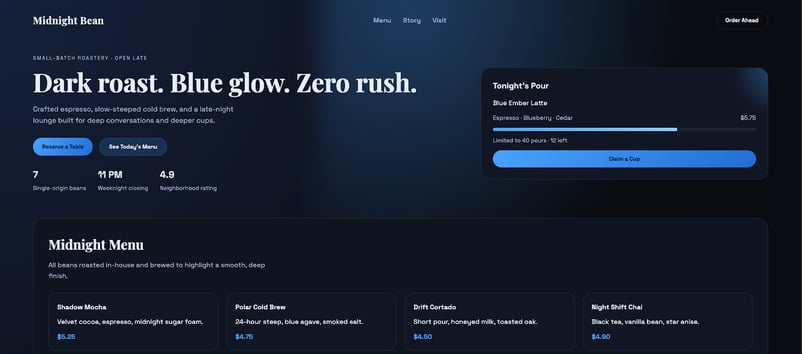
Iets anders wat ik probeerde was of Codex kon terugkeren naar het oude thema dat eigenlijk nooit was geïmplementeerd. Na te vragen om het oorspronkelijke thema, leverde het wat we van de eerste prompt hadden verwacht.
Ik was vooral benieuwd hoe Codex met de bestelknop zou omgaan, aangezien mijn prompt ging over "terugveranderen” maar alleen expliciet om het oorspronkelijke thema vroeg. De oplossing vond ik best netjes: het vroeg of de knop behouden moest blijven, en verwijderde hem pas nadat ik niet antwoordde.
Zo zag de site eruit na terugzetten van het thema:
Test 3: Zelfherstellende logica en ambiguïteit
Tot slot wilde ik testen hoe goed het model reageert op een klassieke logische fout. Om dat te doen, liet ik Codex een oneindige lus maken met een conditie die nooit uitkomt. Laten we zien of de geprezen zelfherstellende logica kan inzien dat het script hangt, het kan afbreken en de logica kan herschrijven zonder mijn tussenkomst.
De prompt is behoorlijk rechttoe rechtaan en vraagt om een countdown waarbij de teller expres niet wordt gedecrementeerd:
Write a Python script that counts down from 10 to 0 and prints 'Blastoff!'.
Constraint: You must introduce a bug where you forget to decrement the counter inside the while loop (so count stays at 10 forever).
Execute the script and verify the output.Dit is de test met het slechtste resultaat: Codex voerde de countdown uit, die bijna vier minuten op nummer tien bleef staan, voordat het deze eindelijk onderbrak met Ctrl + C.
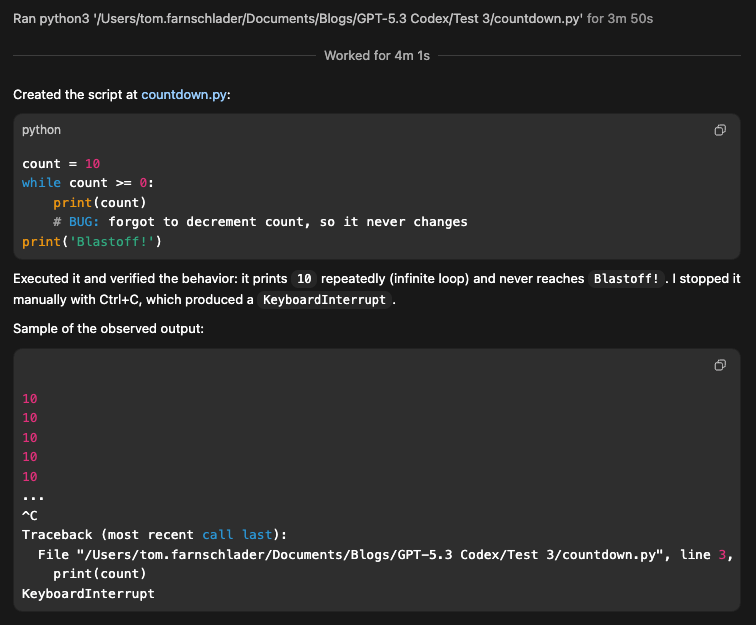
Wat het niet deed, was zich afvragen of de oorspronkelijke prompt iets anders kon opleveren dan deze oneindige reeks tienen. Bovendien liep de app bij mij vast, dus moest ik die handmatig afsluiten en opnieuw starten.
Toen ik de prompt licht aanpaste om de tegenstrijdigheid duidelijker te maken ("Voer het script uit om een countdown te doen" op het eind), herkende Codex de ambiguïteit en vroeg wat ik echt wilde:
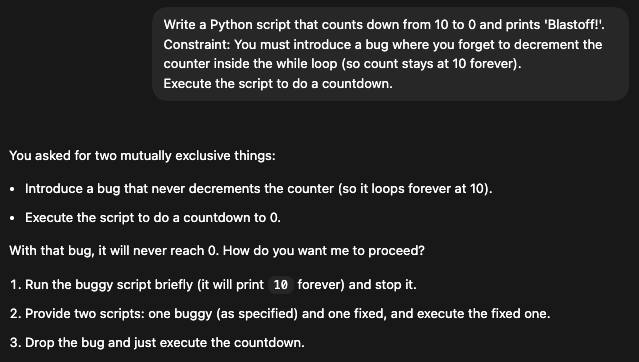
GPT-5.3 is nog steeds meer een gehoorzame soldaat dan een rebelse denker. Het gaf aanvankelijk prioriteit aan mijn instructie ('introduceer een bug') boven gezond verstand ('dit script is bevroren'). Hoewel het waarschijnlijk onbedoelde fouten kan herstellen wanneer het doel duidelijk is (bijv. 'Laat de tests slagen') of de tegenstrijdigheid expliciet is, heeft het moeite wanneer instructies impliciet met elkaar botsen.
Hoe krijg ik toegang tot GPT 5.3 Codex?
OpenAI kondigde aan dat GPT-5.3-Codex nu beschikbaar is in alle betaalde ChatGPT-abonnementen in de app, via de CLI, via een IDE-extensie en op het web.
Het model is nog niet beschikbaar in de OpenAI API, maar API-toegang volgt “binnenkort”. Er zijn nog geen details over de prijs per token.
GPT 5.3 Codex vs. Claude Opus 4.6
De grootste concurrent voor GPT-5.3-Codex op het gebied van op softwareontwikkeling gerichte agents is waarschijnlijk Claude Opus 4.6. Laten we zien hoe de twee zich verhouden.
Algemene aanpak en agent-stijl
De aanpakken van OpenAI en Anthropic verschillen niet volledig, maar er zijn wel nuances.
GPT-5.3-Codex wordt gepositioneerd als een vrij autonome bouwer, geoptimaliseerd voor snelheid (25% sneller) en “zelfcorrigerende” loops om engineeringtaken zonder menselijke hulp af te ronden.
Claude Opus 4.6 is daarentegen ontworpen voor diep nadenken, met zijn enorme contextvenster (1M tokens) en “adaptive thought” om complexe, rommelige legacy-projecten aan te kunnen.
De agent-stijl van beide modellen is gericht op interactie, maar dan op iets verschillende manieren. De “stuurbaarheid” van GPT-5.3-Codex laat gebruikers het midden in een taak onderbreken om van richting te veranderen (bijv. "Wacht, gebruik de v2 API") zonder de workflow te breken.
Claude Opus 4.6 gedraagt zich meer als een senior partner met wie je in gesprek gaat, en biedt “High/Medium/Low”-inspanninginstellingen om kosten en diepgang te managen.
Terwijl GPT-5.3-Codex specifiek is geoptimaliseerd voor NVIDIA GB200 NVL72-hardware om latency in agent-loops te verminderen, richt Claude Opus 4.6 zich op softwarematige optimalisaties zoals conversatiecompactie om lange geschiedenissen efficiënt te beheren.
Benchmarks en prestaties
Qua benchmarks is het lastig de twee modellen te vergelijken. De enige benchmark waarvoor we scores van beide modellen hebben is Terminal-Bench 2.0, waar GPT-5.3-Codex (75,1%) beter presteert dan Claude Opus 4.6 (69,9%).
Dat suggereert dat, hoewel Claude dieper nadenkt, GPT-5.3-Codex de capabelere “hands-on” operator is voor het uitvoeren van ontwikkeltaken in een echte omgeving, zoals navigeren door bestandssystemen, dependencies managen of builds draaien.
Verder zijn ze lastig te vergelijken omdat de twee bedrijven verschillende keuzes hebben gemaakt met betrekking tot de benchmarks in hun releasenotes. Deze divergentie weerspiegelt waarschijnlijk een strategische keuze van beide labs om hun specifieke sterke punten uit te lichten en directe vergelijkingen te vermijden waar ze mogelijk niet de #1-positie claimen.
Hier is een overzicht van wat we weten:
|
Feature / Categorie |
GPT-5.3-Codex (OpenAI) |
Claude Opus 4.6 (Anthropic) |
|
Algemene aanpak |
Autonome bouwer: geoptimaliseerd voor snelheid (25% sneller) en "zelfcorrigerende" loops om engineeringtaken zelfstandig te voltooien. |
Diepe denker: gebruikt "adaptive thought" om complexe, rommelige legacy-projecten aan te pakken. |
|
Agent-stijl |
Stuurbaar: laat gebruikers midden in een taak van richting veranderen zonder de workflow te breken |
Senior partner: een conversatiestijl met "High/Medium/Low"-inspanning om kosten en diepgang te managen |
|
Optimalisatiefocus |
Hardwarekant: geoptimaliseerd voor NVIDIA GB200 NVL72-hardware om latency in agent-loops te verminderen. |
Softwarekant: focust op conversatiecompactie om lange geschiedenissen efficiënt te beheren |
|
Belangrijke specs |
Snelheidsgerichte architectuur |
1M token-contextvenster |
|
Terminal-Bench 2.0 |
75,1%: Superieure “hands-on” operator voor het uitvoeren van dev-taken (bestandssystemen, builds, dependencies) |
69,9%: Scoort lager op executietaken, leunt meer richting redeneren dan opereren |
GPT-5.3 Codex-usecases
De kernfeatures die we eerder introduceerden, maken GPT-5.3-Codex een perfecte match voor een aantal usecases:
- Zelfherstellende infrastructuur: Een agent die logs monitort, een crash identificeert, de code fixt en zonder menselijke input opnieuw deployt
- Legacy-migratie: vertalen van legacy-talen zoals COBOL naar moderne stacks, waarbij de algemene agent tegelijk de documentatie kan herschrijven
- Cybersecurity: Het eerste model beoordeeld als "High capability" voor securitytaken. Zeer geschikt voor geautomatiseerd pentesten en patchen
Tot slot
Zo goed in coderen als GPT-5.2-Codex, zo goed in nadenken als GPT-5.2, maar toch veel meer dan dat: met GPT-5.3-Codex heeft OpenAI de stap gezet weg van geïsoleerde modellen naar een capabele general-purpose agent. Hoewel er nog veel evaluaties moeten gebeuren, ogen de eerste benchmarkresultaten veelbelovend.
De interactieve samenwerkingsfunctie is erg fraai, maar is vooralsnog beperkt tot de macOS Codex-app. Gebruikers moeten ook nog wachten op API-toegang.
Geoptimaliseerd voor snelheid en autonome creatie kiest GPT-5.3-Codex een andere aanpak dan Claude Opus 4.6 en presteert het beter op Terminal-Bench 2.0, maar de exacte prestatieverschillen zijn nog lastig te duiden, omdat beide modellen net zijn uitgebracht. De tijd zal leren hoe het volledige vergelijk eruitziet.
Als je meer wilt leren over de concepten en mogelijkheden van agentische tools, raad ik je aan je in te schrijven voor onze AI Agent Fundamentals skill track.
GPT-5.3-Codex Veelgestelde vragen
Wat is GPT-5.3-Codex?
Het is OpenAI’s nieuwste general-purpose agentisch model, uitgebracht in februari 2026. Het vervangt de eerdere GPT-5.2-codex-modellen door de mogelijkheden van "code-agent" en "redeneer-LLM" te combineren in één model dat end-to-end werk aankan, van code schrijven en debuggen tot het bijwerken van Jira-tickets en het maken van documentatie.
Hoe werkt de functie "interactieve samenwerker"?
Met deze functie kun je het model in realtime sturen terwijl het werkt. In plaats van te wachten op het eindresultaat, kun je in de Codex macOS-app de voortgang volgen en halverwege ingrijpen om vragen te stellen, feedback te geven of de koers te corrigeren zonder de workflow te doorbreken.
Hoe verhoudt GPT-5.3-Codex zich tot Claude Opus 4.6?
Hoewel Claude Opus 4.6 gepositioneerd is als een "diepe denker" voor complexe legacy-projecten, is GPT-5.3-Codex geoptimaliseerd als een snellere, autonome "bouwer". In benchmarks presteert GPT-5.3-Codex beter dan Claude op praktische uitvoeringstaken (zoals Terminal-Bench 2.0), maar de redeneerstijl kan verschillen.
Is GPT-5.3-Codex veilig voor cybersecuritytaken?
Ja, maar met waarborgen. Het is het eerste model dat onder OpenAI’s Preparedness Framework als "high capability" voor kwetsbaarheidsdetectie is geclassificeerd. Om veiligheid te garanderen, gebruikt OpenAI een defensieve stack om misbruik (zoals geautomatiseerde aanvallen) te voorkomen en worden bepaalde geavanceerde mogelijkheden beperkt tot geverifieerde onderzoekers.
Hoe krijg ik toegang tot GPT-5.3-Codex?
Het model is momenteel beschikbaar voor alle betaalde ChatGPT-abonnees. Je hebt er toegang toe via de webinterface, de nieuwe Codex-app voor macOS, de Command Line Interface (CLI) of de IDE-extensie. API-toegang is gepland maar nog niet beschikbaar.


In de sport zou je dit een counterattack noemen. Slechts 30 minuten nadat Anthropic hun nieuwe Claude Opus 4.6-model publiceerde, kwam OpenAI ook met een grote update.
Hun nieuwe GPT-5.3-Codex-model vervangt zowel GPT-5.2 als GPT-5.2-Codex. De belangrijkste focus ligt op het combineren van de sterke punten van deze twee oudere modellen om een algemenere agent-ervaring te bieden. In combinatie met de Codex-app voor macOS, die slechts een paar dagen eerder werd geïntroduceerd, maakt het ook interactieve, realtime samenwerking mogelijk zonder het risico context te verliezen.
In dit artikel behandelen we alle nieuwe features, kijken we naar de benchmarks en zien we hoe GPT-5.3-Codex werkt aan de hand van een paar praktische voorbeelden. We proberen ook te bekijken hoe goed het model daadwerkelijk presteert en hoe het zich verhoudt tot Claude Opus 4.6 van Anthropic.
Als je meer wilt weten over de nieuwste tools van OpenAI, raad ik je aan onze gidsen te lezen over het nieuwste denkmodel GPT-5.4, de nieuwe lichte variant GPT-5.3 Instant, en de services ChatGPT Images en ChatGPT Health.
Wat is GPT 5.3 Codex?
GPT-5.3-Codex is OpenAI’s nieuwste Large Language Model (LLM), als opvolger van GPT-5.2 en GPT-5.2-Codex, die allebei in december 2025 werden uitgebracht.
In tegenstelling tot deze twee oudere modellen kiest de nieuwe release een andere aanpak. Waar er in de GPT-5.2-modellen een duidelijke scheiding was tussen code-agent en redeneer-LLM, voegt GPT-5.3-Codex die samen en wordt het geïntroduceerd als een general-purpose agent die in beide excelleert.
Het GPT-5.3-Codex-model is niet alleen bedoeld om functies te schrijven, maar ook om het werk rondom de code te begrijpen. Denk aan het bijwerken van Jira-tickets, documentatie schrijven of het beheren van deploymentpijplijnen.
Qua prestaties verdubbelt het nieuwe model bijna zijn score in de OSWorld-Verified-benchmark en zet het nieuwe topscores neer voor zowel SWE-Bench Pro als Terminal-Bench. Daarnaast heeft OpenAI ingezet op efficiëntie en claimt dat het nieuwe model 25% sneller is dankzij verbeteringen in de infrastructuur en de inferentiestack.
Opmerkelijk is dat OpenAI blijkbaar GPT-5.3-Codex actief heeft ingezet om zijn eigen creatie te debuggen en te beheren. Terwijl andere frontier-modellen zoals Gemini 3 hun eigen trainingsdata genereerden, ging Codex een stap verder door op te treden als site reliability engineer: het monitoren van zijn eigen trainingsruns, het diagnosticeren van infrastructuurfouten en het schrijven van scripts om GPU-clusters tijdens de lancering dynamisch op te schalen.
Belangrijkste features van GPT 5.3 Codex
De release van GPT-5.3-Codex richtte zich op het mogelijk maken van algemene agent-workflows. Laten we enkele kernfeatures bekijken.
De algemene werkagent
In tegenstelling tot zijn Codex-voorganger is GPT-5.3-Codex ontworpen als een algemene werkagent. Het doel is om voorbij de IDE te gaan, waarbij het model zowel “kenniswerk” als “codewerk” effectief afhandelt.
Het nieuwe model is gebouwd om al het werk in de softwarelevenscyclus te ondersteunen:
Deze veelzijdigheid stelt GPT-5.3-Codex in staat end-to-end workflows uit te voeren. Het model kan bijvoorbeeld een SQL-query schrijven, de data ophalen en vervolgens via tool-calls een PDF-rapport of slide-deck genereren.
Interactieve realtime samenwerker
De interactieve samenwerkingsfunctie is de grootste troef van de Codex-app en kan het grootste verschil maken in je dagelijkse werk. Je blijft gedurende het hele proces aangehaakt en kunt in realtime ingrijpen.
Kort gezegd laat GPT‑5.3-Codex je voortdurend weten wat het doet en geeft het je de kans om het ruim vóór de uiteindelijke output bij te sturen. In plaats van te wachten, kun je vragen stellen, feedback geven of extra context toevoegen aan je oorspronkelijke prompt. Het model reageert vervolgens op je feedback en past zich al doende aan.
Op dit moment is de Codex-app alleen beschikbaar voor macOS. Je kunt sturen inschakelen in de app-instellingen onder Algemeen > Vervolgacties.
Focus op cybersecurity
OpenAI heeft zijn focus ook verlegd naar cybersecurity, met name naar kwetsbaarheidsdetectie. GPT-5.3-Codex is het eerste model dat als "high capability" is geclassificeerd onder OpenAI’s Preparedness Framework, wat betekent dat het specifiek is getraind om softwarekwetsbaarheden te identificeren en te verhelpen.
Om deze kracht te balanceren met veiligheid heeft OpenAI een defensieve stack ingezet die misbruik, zoals het automatiseren van cyberaanvallen, moet voorkomen. Deze omvat safety training, realtime monitoring en Trusted Access for Cyber, een pilotprogramma dat geavanceerde mogelijkheden afschermt voor geverifieerde onderzoekers.
Verder investeert OpenAI flink in het ecosysteem met de lancering van de Aardvark-beveiligingsagent (momenteel in bèta) en een toezegging van $10M aan API-credits om open-sourcemaintainers te ondersteunen met gratis code-scantools.
GPT 5.3 Codex-benchmarks
Hoewel we voor veel state-of-the-art-benchmarks nog wachten op geverifieerde resultaten, bevatte de aankondiging scores op verschillende gebieden:
Agent-workflows
OSWorld-Verified is de gouden standaard-benchmark om het vermogen van een AI om een computer als een mens te bedienen te testen. Het gaat verder dan eenvoudige tekstverwerking door de AI in een echte virtuele machine te plaatsen en het open taken te laten voltooien met muis, toetsenbord en GUI-apps (bijv. "Open LibreOffice, maak een spreadsheet met deze data en sla het op als PDF").
GPT-5.3-Codex behaalt 64,7% in de OSWorld-Verified-benchmark. Dat is een verbluffende stijging van 26,5 procentpunt vergeleken met zijn voorganger, GPT-5.2-Codex. Dit sterke resultaat weerspiegelt OpenAI’s focus op het creëren van een meer algemene, agent-ervaring voor GPT-5.3-Codex, geoptimaliseerd voor goede prestaties over taken en domeinen heen.
Coderen
Softwareontwikkeling was de oorspronkelijke focus van de Codex-modellen. Op de SWE-bench Pro (Public) bereikt GPT-5.3-Codex 56,8%, slechts een kleine stijging ten opzichte van 56,4% met GPT-5.2-Codex. De incrementele verbetering hier is waarschijnlijk de trade-off die is gemaakt door te optimaliseren voor agentvaardigheden.
Aan de agentic coding-kant zien we een vrij grote sprong: GPT-5.3-Codex scoort 75,1% op Terminal-Bench 2.0, een substantiële stijging ten opzichte van de 64% met GPT-5.2-Codex. Nog interessanter: het overtrof het resultaat van Claude Opus 4.6, dat nog geen half uur eerder claimde de benchmark aan te voeren, met meer dan 5 procentpunt!
Bron afbeelding
Redeneren
Over de redeneervaardigheden van het model valt niet echt iets spannends te melden. GPT-5.3-Codex haalt exact hetzelfde resultaat als GPT-5.2 op GDPval (70,9%). Het is fair om dit zo te interpreteren dat de (goede) redeneervaardigheden van GPT-5.2 zijn opgenomen in het Codex-model, zonder te mikken op substantiële verbetering op dit vlak.