
Cursus
Werken met de OpenAI API
3 uur
185.3K
In deze tutorial leer je hoe je een end-to-end data-engineeringpijplijn maakt met GPT-5.2 Codex via de VSCode-extensie. In plaats van het model te vragen om alles in één keer te bouwen, bouwen we de MVP laag voor laag en begeleiden we de agent stap voor stap door ontwerp, implementatie en testen.
Deze aanpak sluit aan bij hoe GPT-5.2 Codex in de praktijk het best werkt en weerspiegelt realistische data-engineeringworkflows. Bekijk ook zeker onze gids over de nieuwere versie van het model, GPT-5.3 Codex, en OpenAI’s nieuwe denkmodel, GPT-5.4.
Wil je meer leren over werken met het OpenAI-ecosysteem? Bekijk dan de Working with the OpenAI API-cursus.
GPT 5.2 Codex is de nieuwste generatie agentische codeermodellen van OpenAI, gebouwd voor realistische software-engineeringworkflows. Het bouwt voort op recente verbeteringen in begrip van lange context, grote refactors en migraties, betrouwbaar gebruik van tools en sterke native Windows-ondersteuning.
Deze verbeteringen maken het bijzonder effectief voor langdurig, end-to-end ontwikkelwerk binnen IDE’s zoals VSCode. De afgelopen maanden is de OpenAI Codex VSCode-extensie aanzienlijk verbeterd en concurreert nu rechtstreeks met Claude Code voor complexe, agentgestuurde ontwikkeling.
We beginnen met het aanmaken van een nieuwe GitHub-repository voor onze data-engineering-MVP.
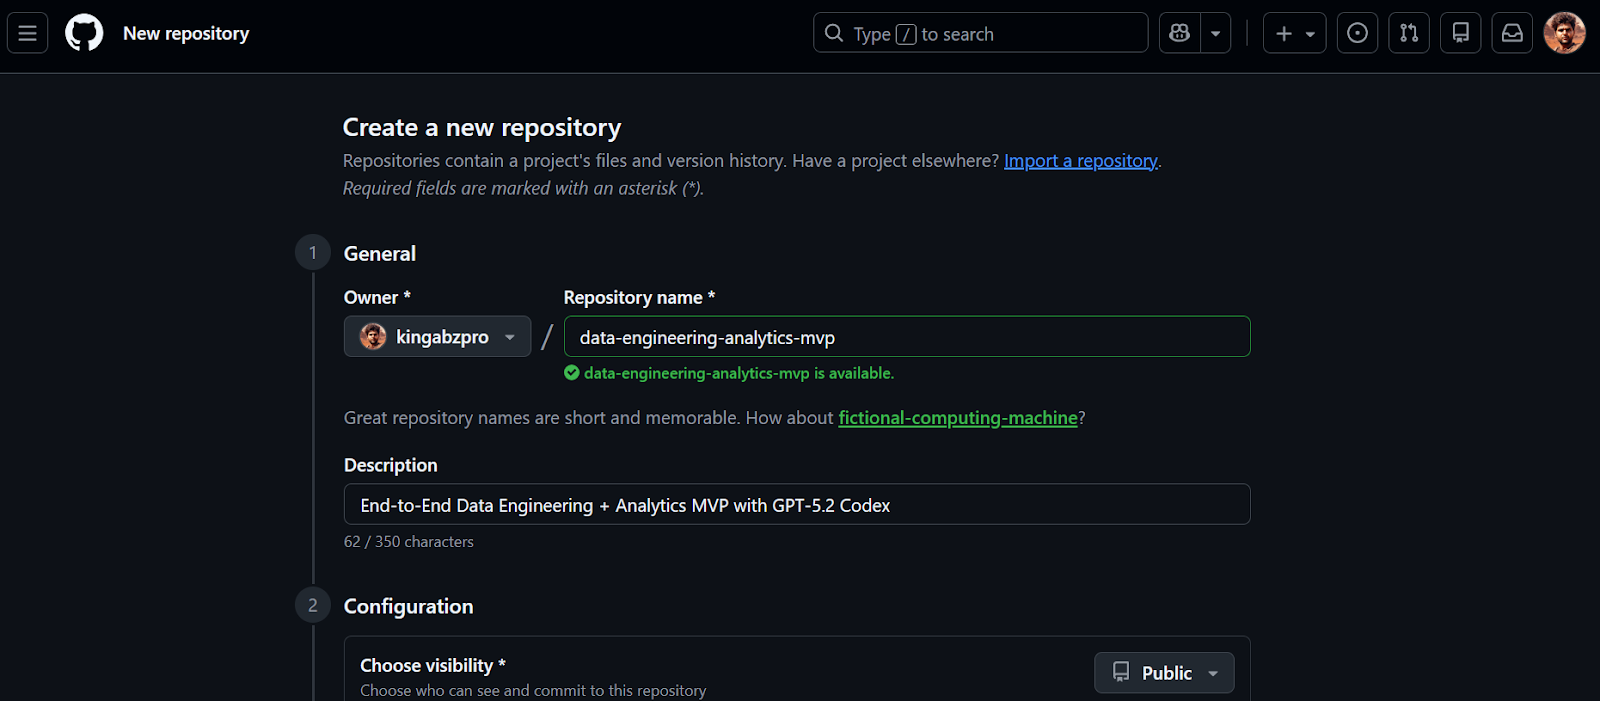
Zodra de repository is aangemaakt, kopieer je de repository-URL. We gebruiken deze URL in de volgende stap om het project lokaal te clonen.
Zorg ervoor dat je Visual Studio Code hebt geïnstalleerd en een actief ChatGPT Plus-account hebt voordat je begint. De Free- en Go-abonnementen bieden geen toegang tot Codex-modellen in de VSCode-extensie.
1. Clone de repository met de URL die je eerder hebt gekopieerd.
2. Ga naar de map van de repository en start VSCode.
git clone https://github.com/kingabzpro/data-engineering-analytics-mvp.git
cd data-engineering-analytics-mvp
code .
3. Ga naar Extensions (Ctrl + Shift + X), zoek naar OpenAI Codex en installeer deze. Dit duurt slechts enkele seconden.
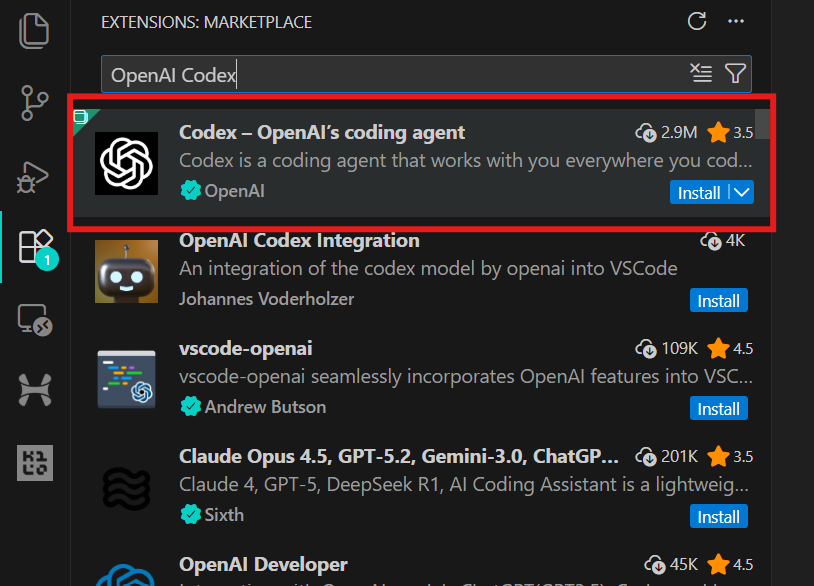
4. Klik op het OpenAI-pictogram in het linkerpaneel om de Codex-extensie te starten. Je wordt gevraagd in te loggen met je ChatGPT-account of een API-account. Kies het ChatGPT-account: je wordt doorgestuurd naar de browser om toegang goed te keuren. Ga na goedkeuring terug naar VSCode; Codex is nu klaar voor gebruik.
Dit project is bewust afgebakend als een Minimum Viable Product (MVP). Het doel is niet om een productieklare dataplatform te bouwen, maar om een complete end-to-end data-engineeringsslice te maken die laat zien hoe echte analytics-systemen zijn opgezet.
In deze MVP bouwen we een eenvoudige maar geloofwaardige analyticspijplijn die:
raw_events)fct_events) te producerenDe volledige flow ziet er zo uit:
CSV file
  ↓
raw_events        (raw ingestion, 1:1 with source)
  ↓
fct_events        (typed, deduplicated, transformed)
  ↓
metrics           (daily count, 7-day rolling avg, top category)
  ↓
Streamlit UI (local dashboard)In deze stap gebruiken we GPT-5.2 Codex om de initiële structuur van het project te genereren. Het doel is nog niet om features te bouwen, maar om een schone, uitvoerbare basis te creëren die we stap voor stap uitbreiden.
Om Codex gefocust te houden, gebruiken we een klein controleblok, de Codex Harness. Deze harness plak je bovenaan elke prompt en zorgt ervoor dat Codex binnen de MVP-scope blijft, consistente output produceert en schone, te reviewen commits maakt.
Codex Harness (plak in elke taak):
You are GPT-5.2 Codex working in my GitHub repository.

MVP ONLY:
CSV → raw table → transform → 3 metrics → Streamlit dashboard.

SCOPE RULES:
- Implement ONLY what this task asks.
- No auth, schedulers, cloud services, or extra pages.

OUTPUT:
- Be descriptive.
- After changes include:
  1) What changed
  2) Files touched
  3) How to run locally
  4) Quick verification step
- Commit after each major step with a clear message.
Voor we code schrijven, krijgt Codex expliciet de instructie om websearch te gebruiken om de nieuwste Python 3.11-compatibele versies van alle dependencies te verifiëren. Zo voorkom je verouderde of incompatibele packages.
IMPORTANT: USE WEB SEARCH FIRST
TASK 1 (SCAFFOLD):
Use Python 3.11 + uv + DuckDB + Streamlit + Pydantic + pytest.

Create repo structure:
- backend/
  - db.py
  - ingest.py
  - pipeline.py
  - models.py
  - sql/
- app/
  - app.py
- data/
  - sample.csv
- tests/

Add:
1) data/sample.csv (~50 rows) with columns:
   event_time, user_id, event_name, category, amount
2) DuckDB schema for raw_events
3) a command to ingest sample.csv and print row count
4) pyproject.toml for uv
5) README with exact local run steps

Stop after scaffolding. Commit.
De scaffolding-taak maakt:
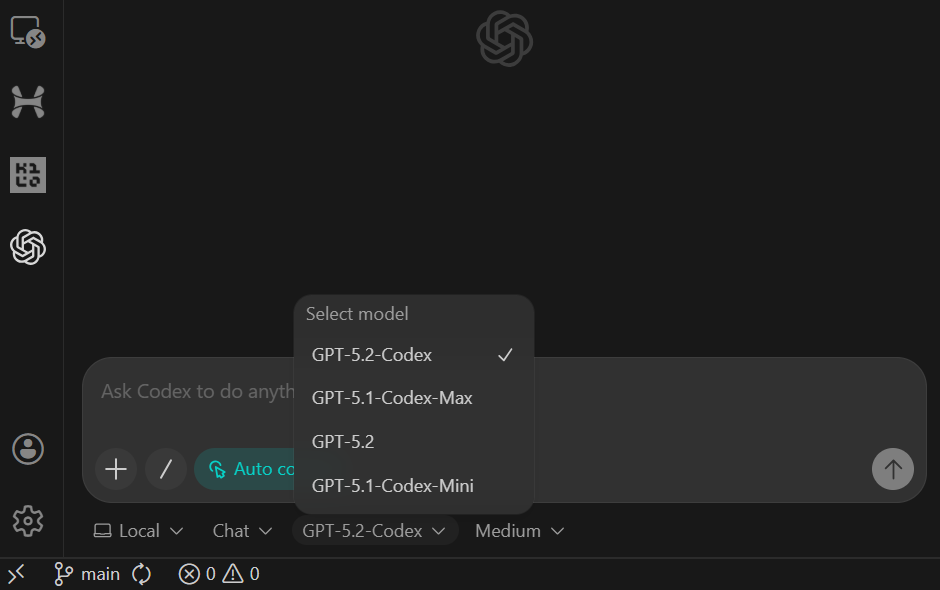
sample.csvraw_eventspyproject.toml en READMENa het plakken van de prompt schakel je het model naar Agent (Full Access) en controleer je dat GPT-5.2 Codex is geselecteerd (dit is de standaard).
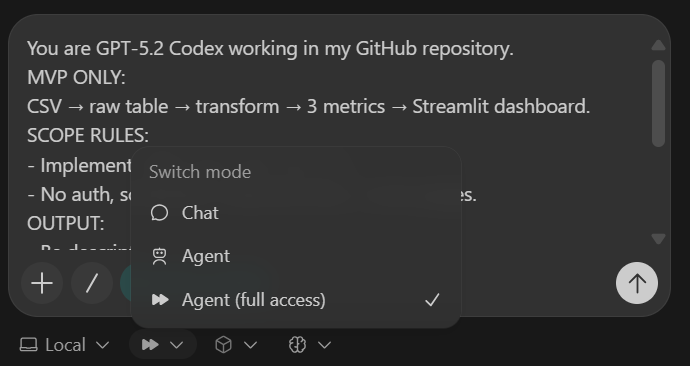
Zodra de taak voltooid is, zie je dat alle mappen en bestanden automatisch zijn aangemaakt.
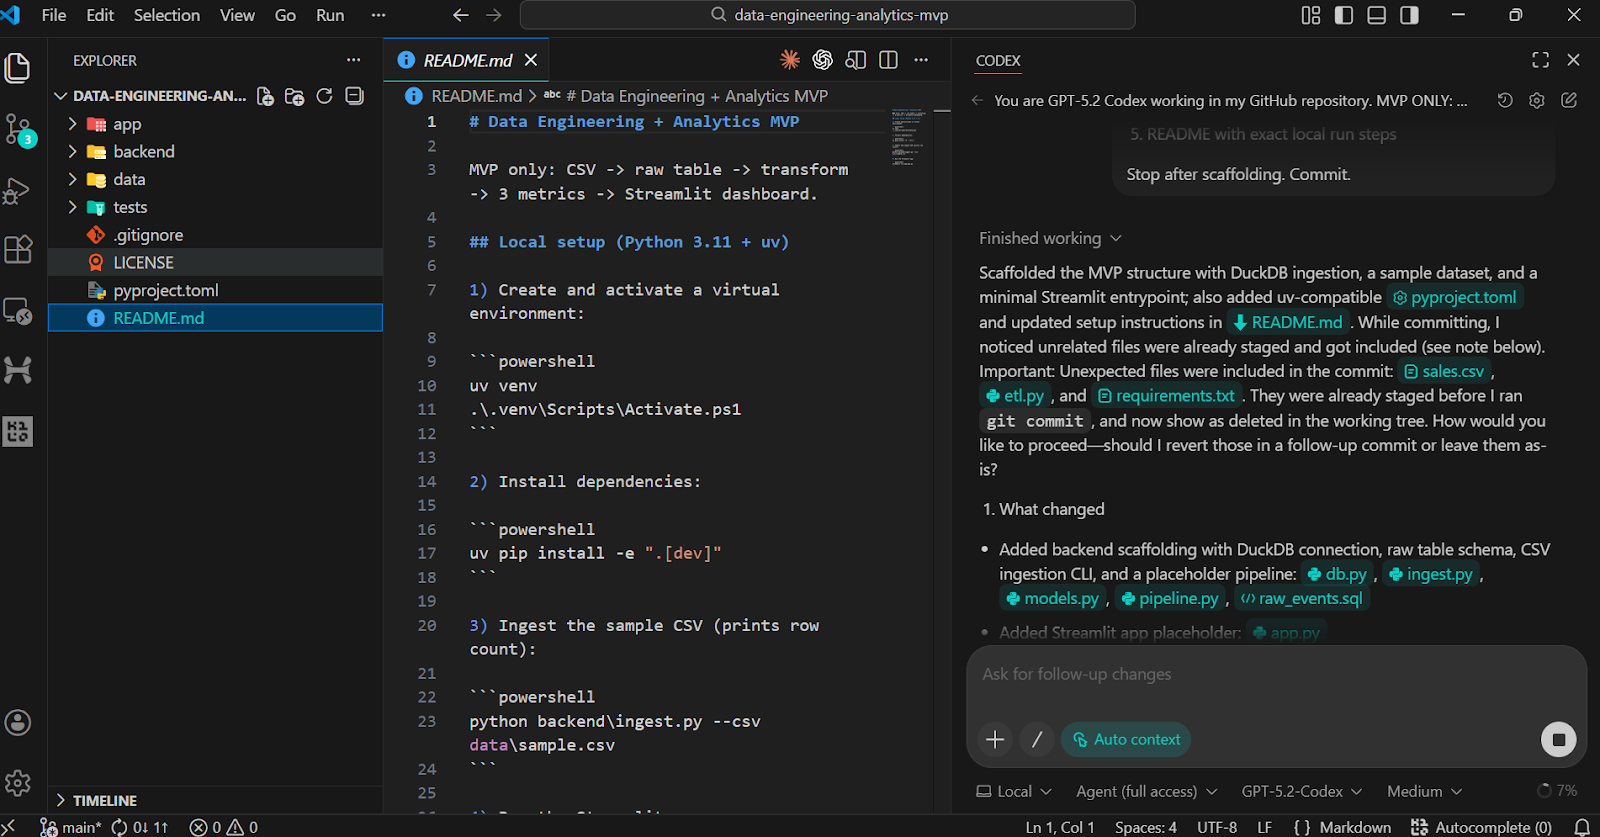
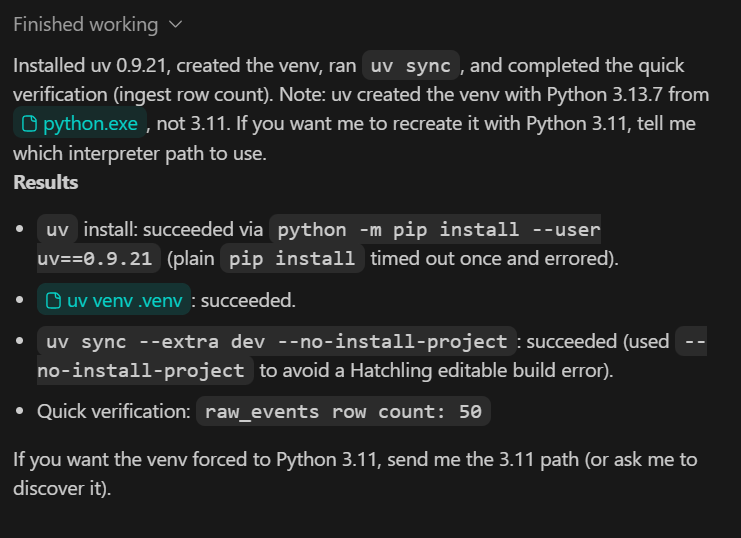
Om de scaffold te valideren, vraag je Codex om de installatie- en verificatiestappen lokaal uit te voeren.
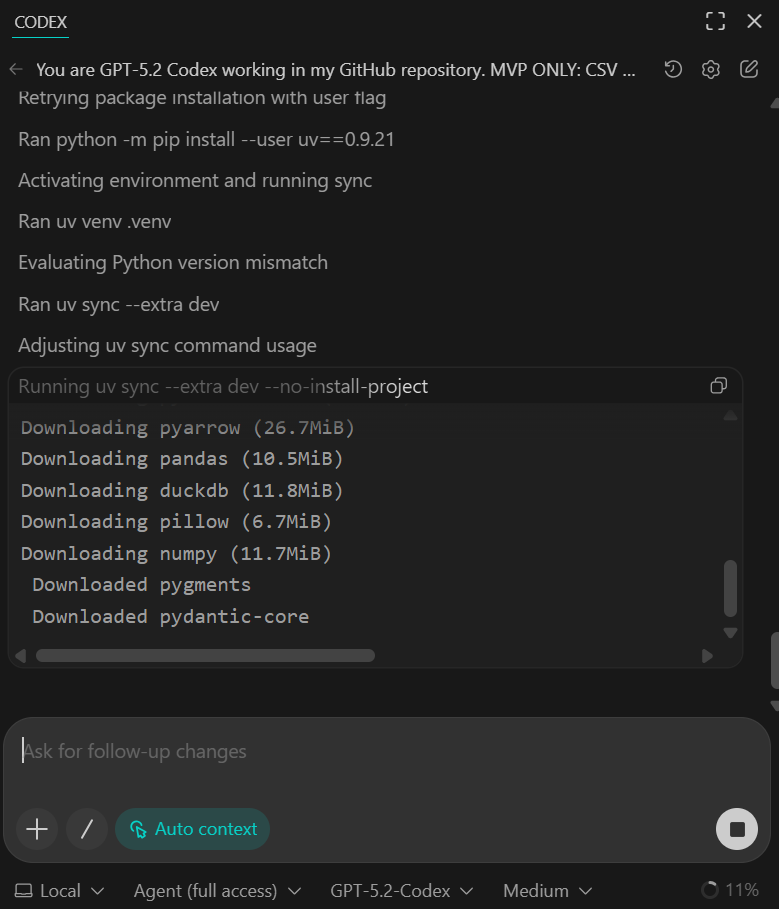
Je zou moeten zien dat alle dependencies succesvol zijn geïnstalleerd en dat het snelle verificatiescript bevestigt dat 50 rijen zijn ingelezen uit de voorbeeldset.
In dit stadium is de voorbeelddata bewust klein. In latere stappen vervangen we die door een grotere, realistischer dataset.
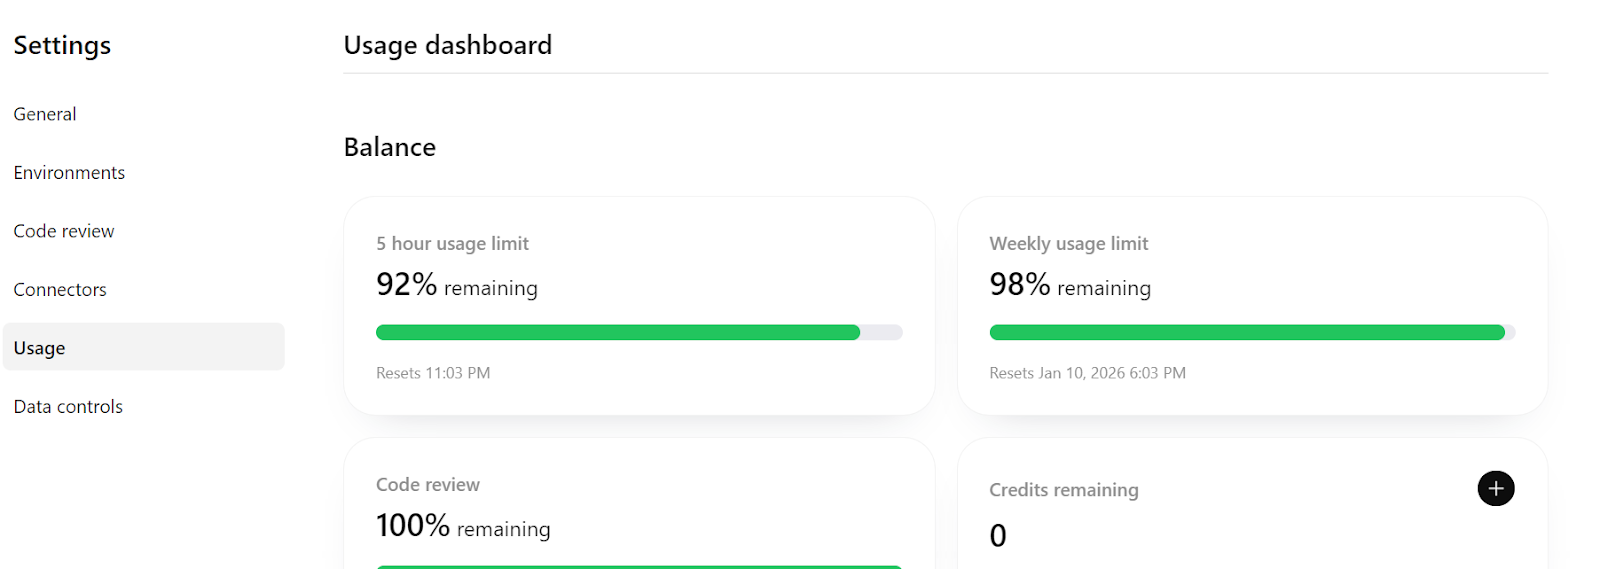
Tot slot, als je https://chatgpt.com/codex/settings/usage bekijkt, zie je dat het grootste deel van je gebruiksquota nog beschikbaar is. Je kunt dus gerust blijven bouwen en itereren aan dit project, en het desgewenst uitbreiden richting een productiegerichtere pijplijn.
In deze stap zorgen we ervoor dat het ingestieproces idempotent is, wat betekent dat je het veilig opnieuw kunt draaien zonder dubbele data te creëren. Dit is fundamenteel in data engineering, omdat ingestiejobs vaak opnieuw moeten worden geprobeerd of uitgevoerd.
TASK 2 (IDEMPOTENT INGEST):
Make CSV ingestion idempotent.
- Rerunning ingest must not duplicate rows
- Validate required columns
- Validate event_time parseable and amount numeric

Add pytest:
- ingest twice → row count unchanged

Update README verification section.
Commit.
Wat deze stap oplevert:
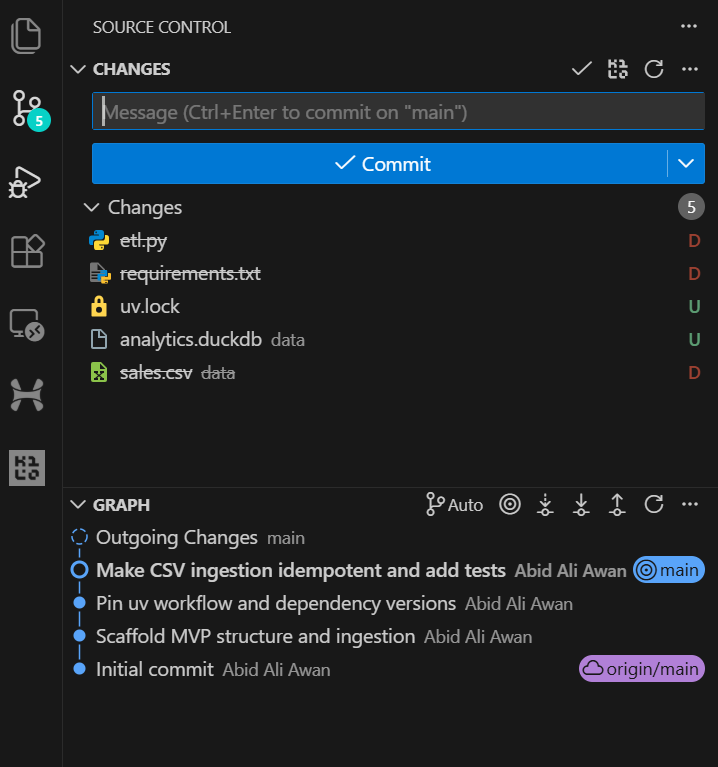
Na voltooiing van de taak kun je de Git-geschiedenis in VSCode bekijken en zien dat de AI-agent de wijzigingen automatisch commit na de grote update. Dit zorgt voor een schone en traceerbare ontwikkelgeschiedenis.
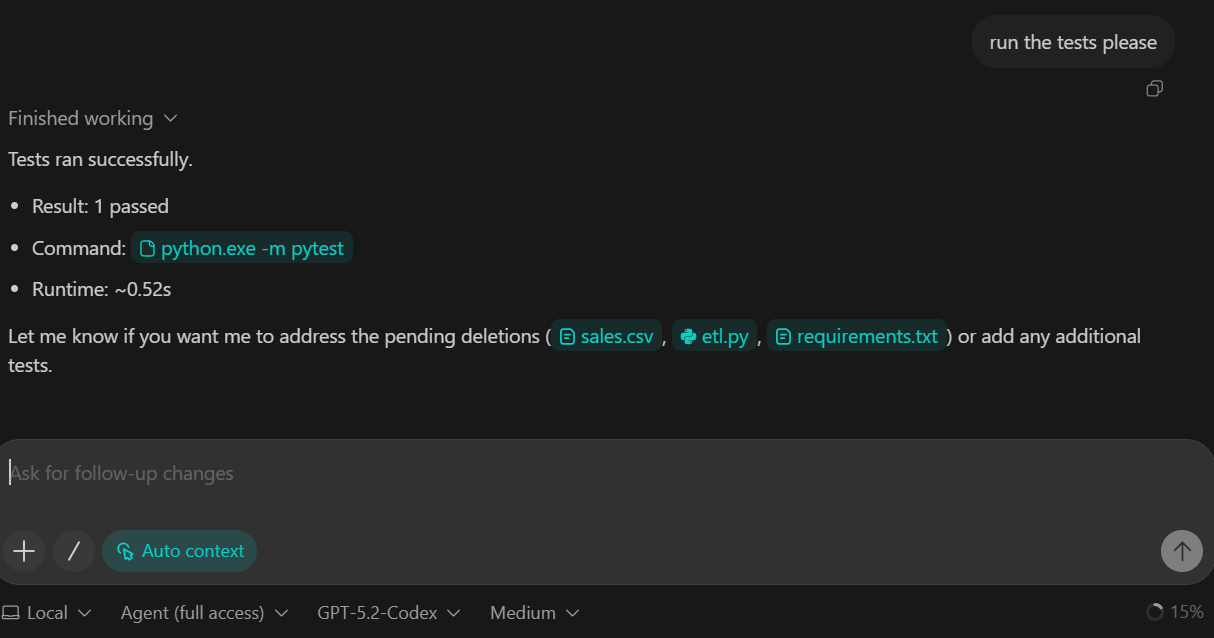
We hebben GPT-5.2 Codex gevraagd om de testsuite uit te voeren als onderdeel van deze taak. De tests zijn succesvol uitgevoerd en alle checks zijn geslaagd.
In deze stap introduceren we de transformatielaag van de pijplijn. Transformaties worden geïmplementeerd met DuckDB SQL, waarmee we ruwe data omzetten in een schone, analytics-klare facttabel.
TASK 3 (TRANSFORM SQL):
Create backend/sql/010_fct_events.sql:
- typed columns
- deterministic dedupe

Execute transform from backend/pipeline.py.
Add sanity checks to README:
- raw_events count
- fct_events count

Commit.
Wat deze stap oplevert:
raw_events omzet in fct_events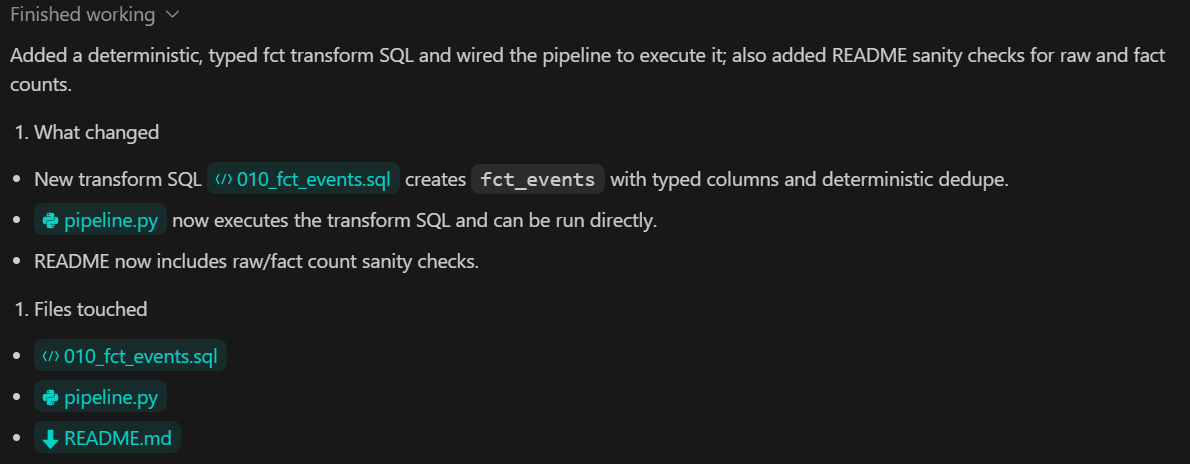
In deze stap voegen we de metrics-laag toe, die verantwoordelijk is voor het berekenen van analytische output uit de getransformeerde data. Metrics worden afgeleid met DuckDB SQL en via een getypte Python-interface beschikbaar gemaakt voor de rest van het systeem.
TASK 4 (METRICS):
Create backend/sql/020_metrics.sql.
Expose metrics via a Python function returning a Pydantic model.

Add pytest validating:
- keys exist
- types correct

Commit.
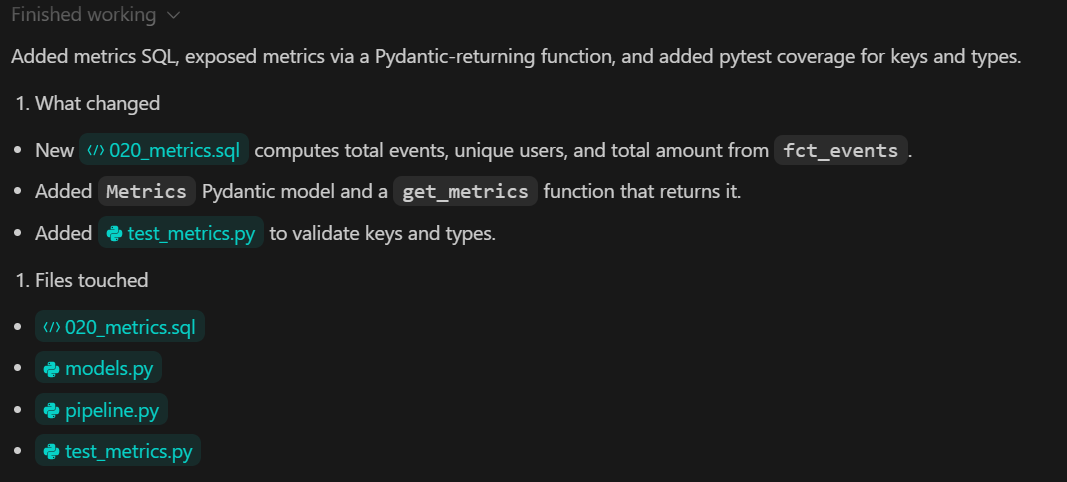
Wat deze stap oplevert:
In deze stap bouwen we het lokale analytics-dashboard met Streamlit. Het dashboard is alleen verantwoordelijk voor visualisatie. Het berekent geen metrics en transformeert geen data. Alle waarden worden gelezen uit de metrics-laag die in de vorige stap is gemaakt.
TASK 5 (STREAMLIT UI):
Build app/app.py:
- 3 KPI cards
- line chart for daily_count
- UI calls backend metrics function

Add a minimal smoke test.
Commit.
Na voltooiing geeft Codex instructies om de DuckDB-database opnieuw op te bouwen en de volledige datapijplijn te draaien. Voor deze stap gebruiken we een nieuwe database met een grotere dataset.
python backend\ingest.py --csv data\sample.csv
python backend\pipeline.py
Na het draaien van de ingestie bevestigt de output het aantal ruwe events dat in DuckDB is geladen:
raw_events row count: 3738Zodra de pijplijn klaar is, start je de Streamlit-applicatie:
streamlit run app\app.pyJe kunt het dashboard openen door naar de URL http://localhost:8501 te gaan in je browser.
You can now view your Streamlit app in your browser.

  Local URL: http://localhost:8501
  Network URL: http://192.168.18.10:8501
Als er een fout verschijnt wanneer het dashboard voor het eerst laadt, is dat te verwachten tijdens vroege iteraties. Kopieer de foutmelding en geef die door aan GPT-5.2 Codex.
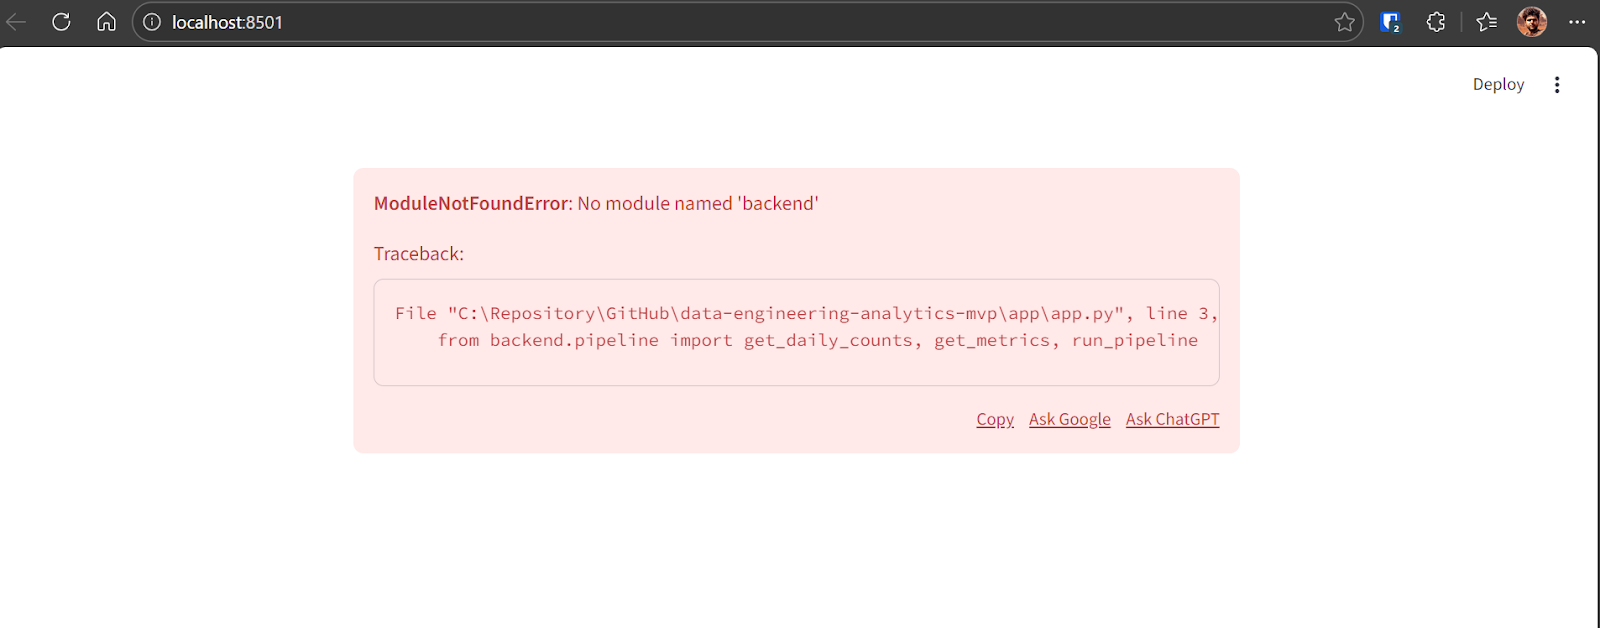
Codex zal het probleem identificeren en de benodigde fix toepassen. Na de correctie draait de applicatie succesvol en toont:
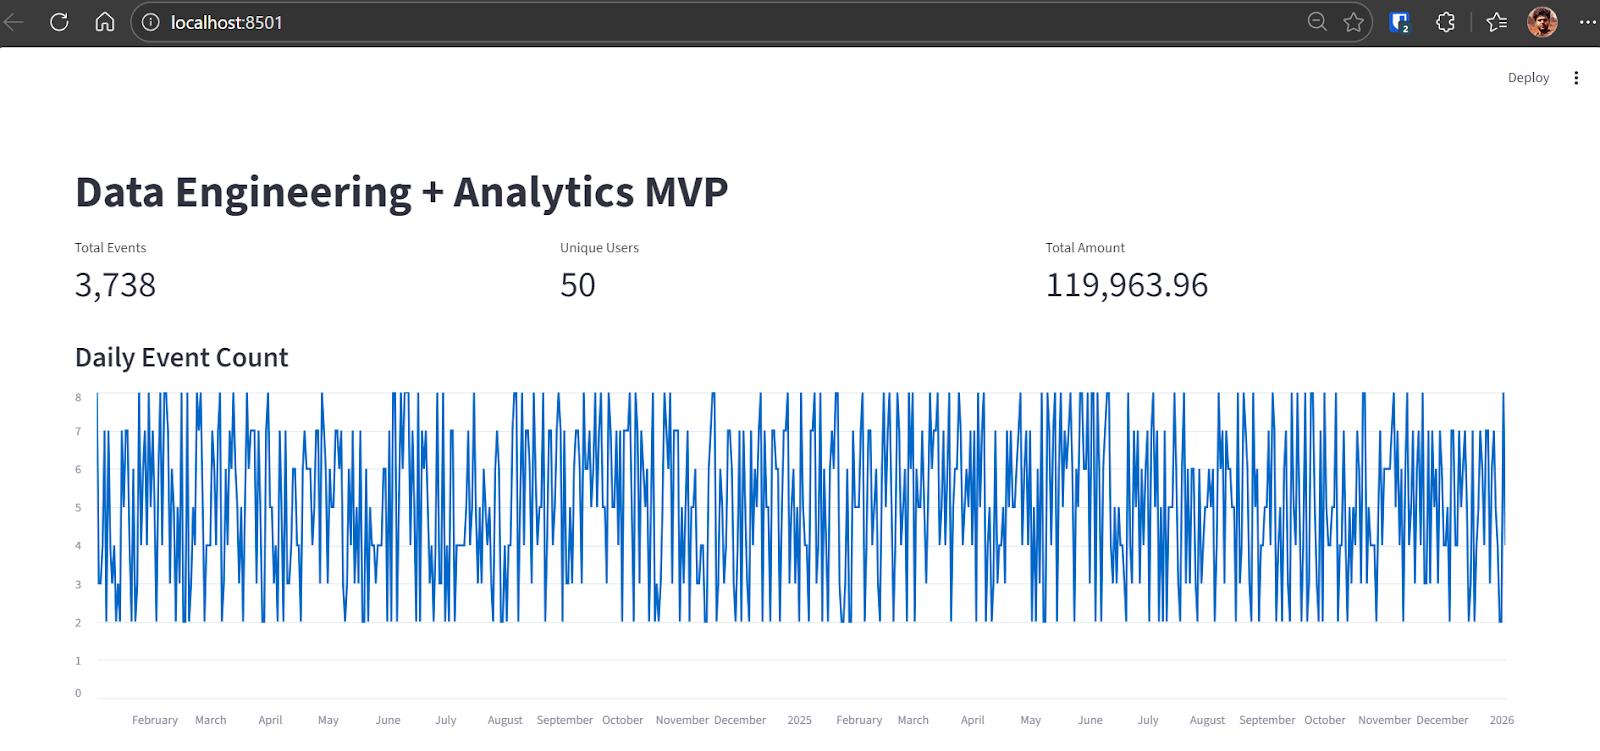
Op dit punt is de end-to-end MVP-pijplijn compleet en volledig functioneel.
In deze laatste stap focussen we op verificatie en betrouwbaarheid. Het doel is één commando te bieden dat bewijst dat de hele pijplijn correct werkt, van ingestie tot metrics en testen.
TASK 6 (VERIFY):
Add a verify command that:
- rebuilds DB from scratch
- ingests sample.csv
- runs transforms
- runs pytest

Document as "Local Demo" and "Verify" in README.
Commit.
Wat deze stap oplevert:
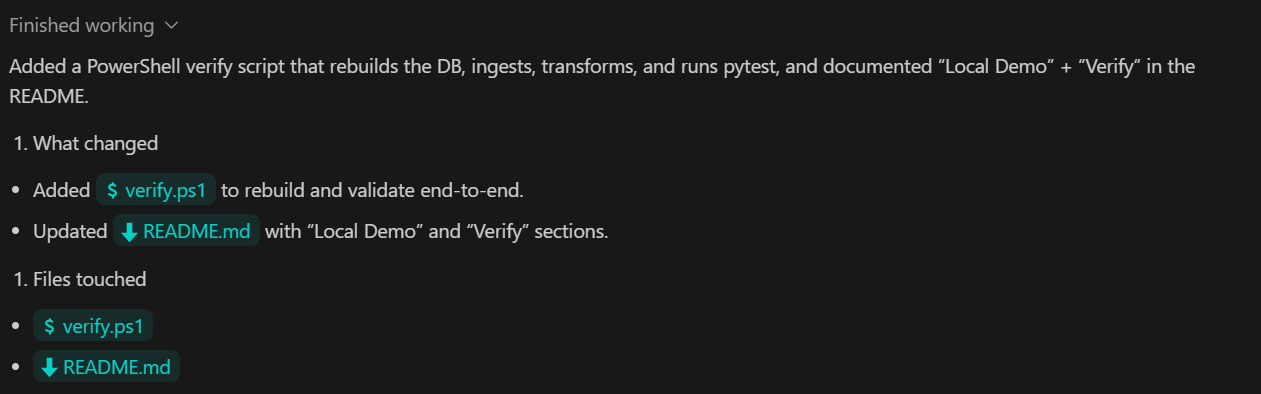
We hebben Codex gevraagd de README bij te werken, alle wijzigingen te committen en naar de GitHub-remote te pushen.
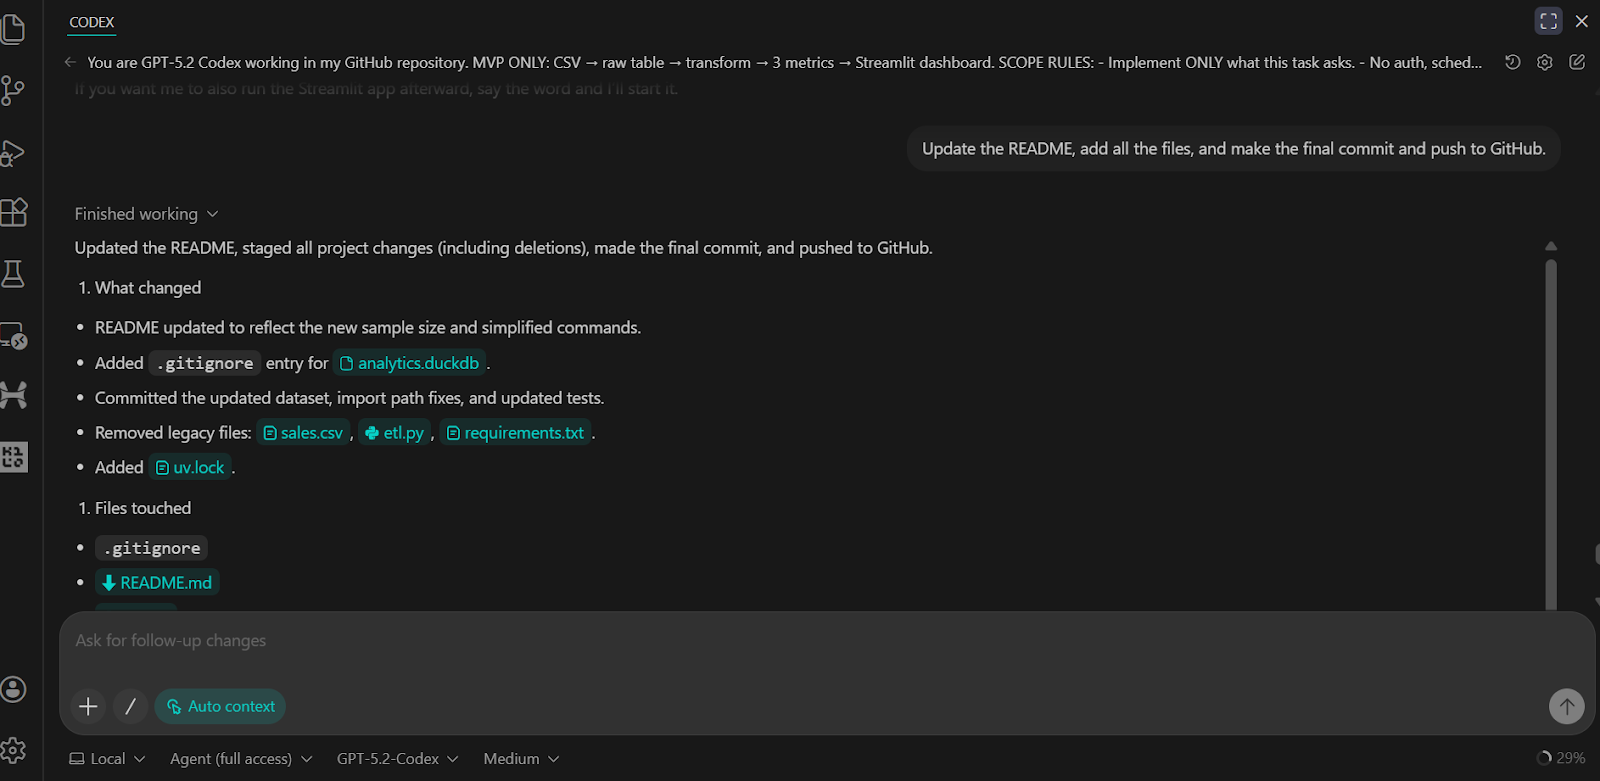
Het resultaat is een complete en goed gestructureerde GitHub-repository met alle scripts, tests, backendlogica en duidelijke instructies om het project te draaien en te verifiëren.
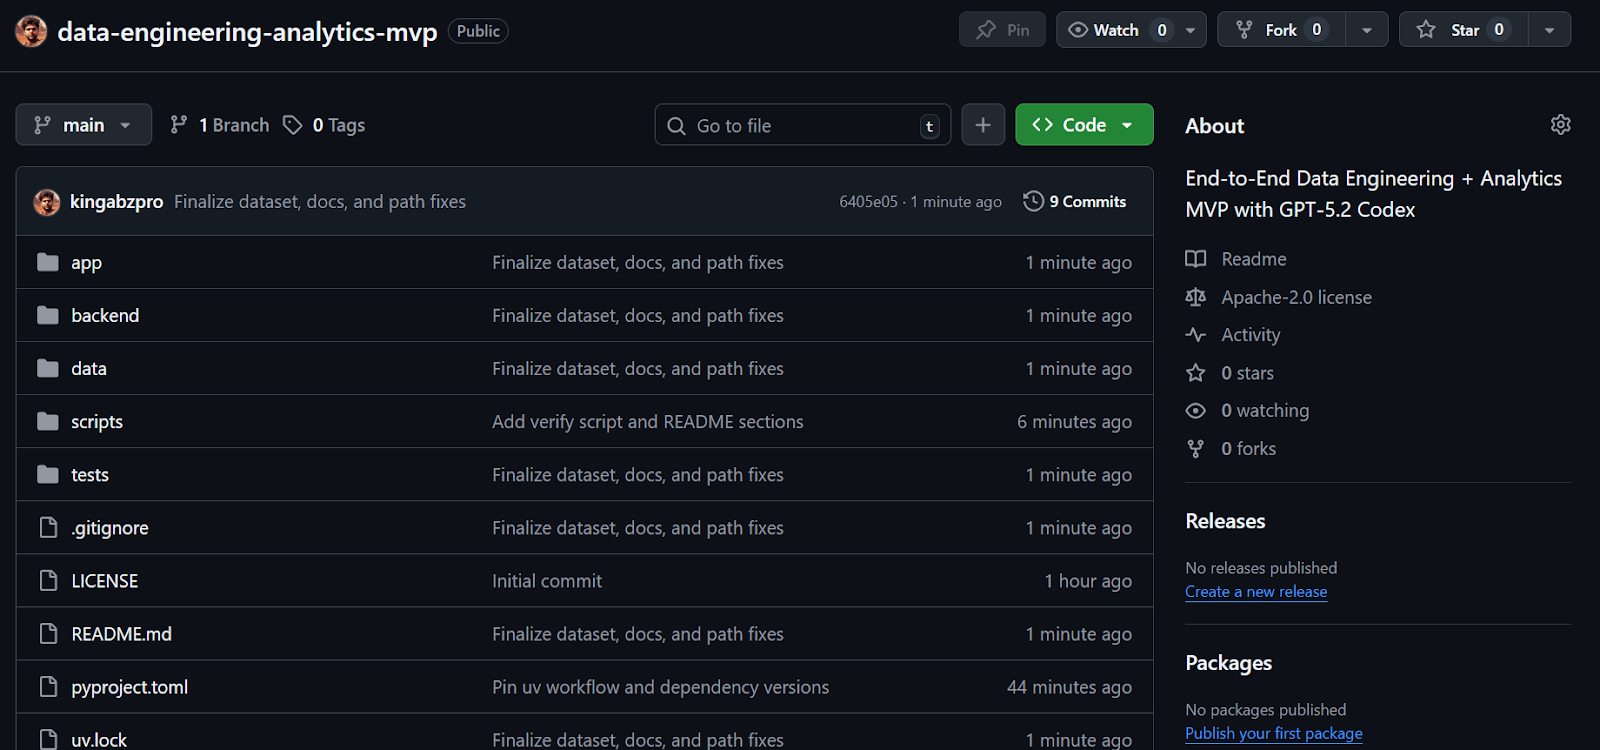
Bron: kingabzpro/data-engineering-analytics-mvp
Ik heb Codex in het verleden af en toe via de CLI en in VSCode gebruikt, maar de recente updates met GPT-5.2 Codex maken een duidelijk verschil. Het model is aanzienlijk beter in het bouwen van complete systemen, het debuggen van problemen en het werken met tools zoals MCP en interne tooling. Het toont ook een veel sterker begrip van een bestaande codebase, waardoor iteratieve ontwikkeling veel efficiënter wordt.
Van begin tot eind kostte het me minder dan dertig minuten om deze hele MVP te scaffolden, te debuggen en end-to-end te draaien. Codex nam repository-setup, dependencybeheer, data-ingestie, SQL-transformaties, testen en het Streamlit-dashboard grotendeels uit handen. De ontwikkelcyclus voelde strak en voorspelbaar—precies wat je wilt als je snel bouwt.
Dit project is bewust een MVP. Er is extra iteratie en hardening nodig om productie-klaar te worden. Toch volgt de kernstructuur nauw hoe echte data-engineeringssystemen zijn ontworpen, wat het tot een solide basis maakt om op voort te bouwen.
Als je dit project wil uitbreiden richting een meer productiegerichte dataplatform, zijn de volgende componenten logische vervolgstappen, maar hier bewust weggelaten om de scope gefocust te houden:
Deze tools zijn gebruikelijk in productiesystemen, maar door ze hier buiten beschouwing te laten, blijft het project simpel, lokaal en gemakkelijk te begrijpen—terwijl het nog steeds realistische data-engineeringpatronen weerspiegelt.
Topcursussen op DataCamp
Cursus
Cursus
Cursus
blog
Adel Nehme
15 min

