Curso
Trabajar con la API de OpenAI
3 h
177.4K
En deporte, a esto lo llamarías una contra. Apenas 30 minutos después de que Anthropic publicara su nuevo modelo Claude Opus 4.6, OpenAI lanzó también una gran actualización.
Su nuevo modelo GPT-5.3-Codex sustituye tanto a GPT-5.2 como a GPT-5.2-Codex. Su objetivo principal es combinar las fortalezas de esos dos modelos anteriores para ofrecer una experiencia de agente más general. En combinación con la app Codex para macOS, presentada apenas unos días antes, también habilita una colaboración interactiva en tiempo real sin riesgo de perder el contexto.
En este artículo, cubriremos todas las novedades, revisaremos los benchmarks y veremos cómo funciona GPT-5.3-Codex con un par de ejemplos prácticos. También intentaremos evaluar qué tal rinde realmente el modelo y cómo se compara con Claude Opus 4.6 de Anthropic.
Si te interesa conocer más sobre las últimas herramientas de OpenAI, te recomiendo leer nuestras guías sobre el nuevo modelo de razonamiento GPT-5.4, su nueva variante ligera GPT-5.3 Instant, así como los servicios ChatGPT Images y ChatGPT Health.
GPT-5.3-Codex es el nuevo modelo de lenguaje grande (LLM) de OpenAI, sucesor de GPT-5.2 y GPT-5.2-Codex, lanzados ambos en diciembre de 2025.
A diferencia de esos modelos, la nueva versión adopta otro enfoque. Mientras que en GPT-5.2 había una distinción clara entre un agente de código y un LLM de razonamiento, GPT-5.3-Codex los fusiona y se presenta como un agente de propósito general que destaca en ambas facetas.
El modelo GPT-5.3-Codex no solo escribe funciones: también comprende el trabajo que rodea al código. Piensa en actualizar tickets en Jira, redactar documentación o gestionar pipelines de despliegue.
En rendimiento, casi duplica su puntuación en el benchmark OSWorld-Verified y marca nuevos máximos tanto en SWE-Bench Pro como en Terminal-Bench. Además, OpenAI ha puesto el foco en la eficiencia y afirma que el nuevo modelo será un 25% más rápido gracias a mejoras en la infraestructura y la pila de inferencia.
Un detalle llamativo es que, al parecer, OpenAI utilizó GPT-5.3-Codex para depurar y gestionar activamente su propia creación. Mientras que otros modelos punteros como Gemini 3 generaron sus propios datos de entrenamiento, Codex fue un paso más allá actuando como ingeniero de fiabilidad de sitio: monitorizando sus propios entrenamientos, diagnosticando errores de infraestructura y escribiendo scripts para escalar dinámicamente clústeres de GPU durante el lanzamiento.
El lanzamiento de GPT-5.3-Codex se ha centrado en habilitar flujos de trabajo agentivos de carácter general. Veamos algunas funciones clave.
A diferencia de su predecesor Codex, GPT-5.3-Codex está diseñado como un agente general de trabajo. La idea es ir más allá del IDE, de modo que el modelo gestione con eficacia tanto el "trabajo de conocimiento" como el "trabajo de código".
El nuevo modelo está pensado para apoyar todas las tareas a lo largo del ciclo de vida del software:
Esta versatilidad permite a GPT-5.3-Codex ejecutar flujos de trabajo de extremo a extremo. Por ejemplo, el modelo podría escribir una consulta SQL, obtener los datos y, después, generar un informe en PDF o una presentación a partir de ellos mediante llamadas a herramientas.
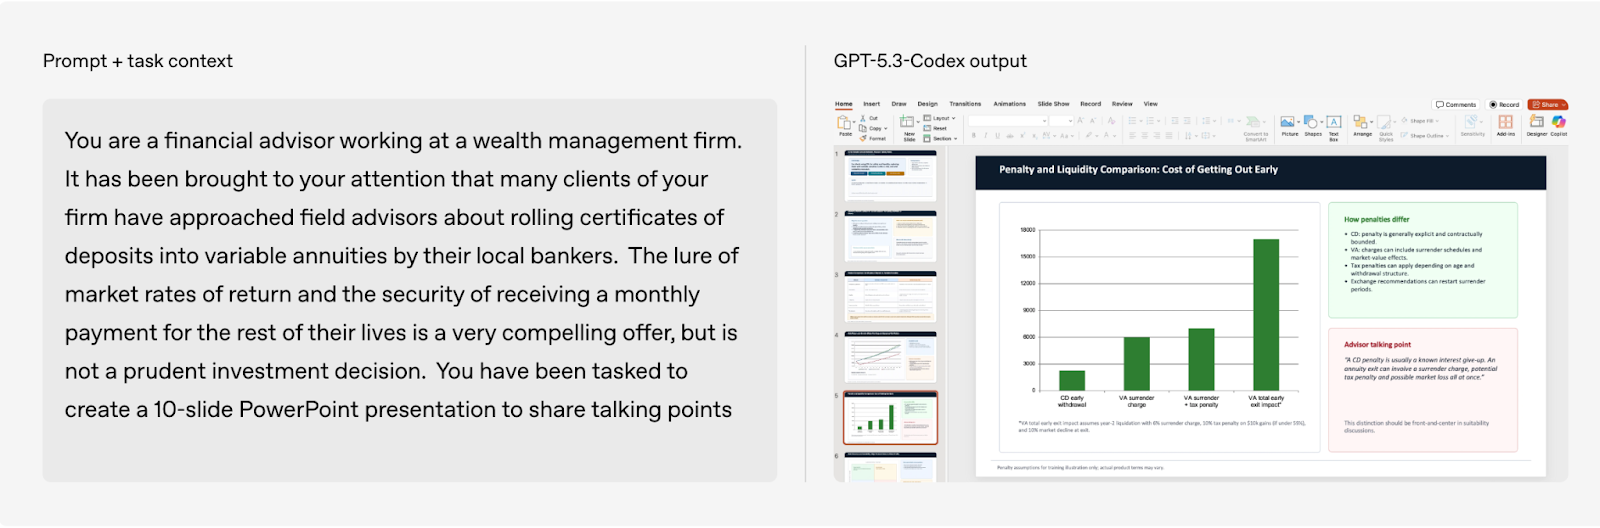
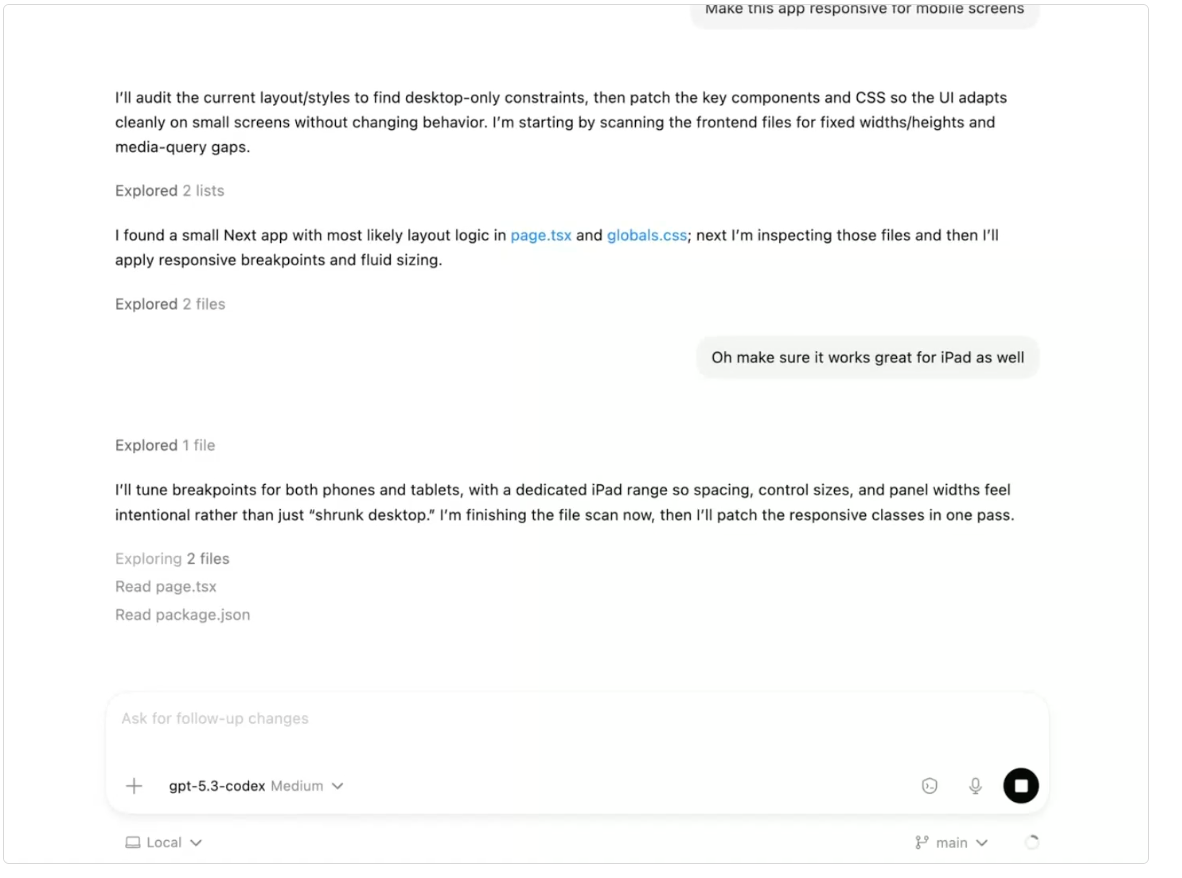
La función de colaboración interactiva es la gran baza de la app Codex y puede marcar la mayor diferencia en el trabajo diario. Te mantiene al tanto durante todo el proceso y te permite intervenir en tiempo real.
En esencia, GPT‑5.3-Codex te informa constantemente de lo que está haciendo y te da la opción de encaminarlo mucho antes de recibir el resultado final. En lugar de esperar, puedes hacer preguntas, dar feedback o añadir contexto a tu prompt inicial. El modelo responde a tus indicaciones y se adapta sobre la marcha.
Actualmente, la app Codex solo está disponible para macOS. Puedes activar el steering en los ajustes de la app en General > Follow-up behavior.
OpenAI también ha girado su atención hacia la ciberseguridad, especialmente a la detección de vulnerabilidades. GPT-5.3-Codex es el primer modelo clasificado como de "alta capacidad" bajo el Preparedness Framework de OpenAI, lo que significa que está específicamente entrenado para identificar y corregir vulnerabilidades de software.
Para equilibrar este poder con seguridad, OpenAI ha implementado una pila defensiva diseñada para prevenir usos indebidos, como la automatización de ciberataques. Incluye entrenamiento en seguridad, monitorización en tiempo real y Trusted Access for Cyber, un programa piloto que restringe capacidades avanzadas a investigadores verificados.
Además, OpenAI está invirtiendo mucho en el ecosistema, lanzando el agente de seguridad Aardvark (actualmente en beta) y comprometiendo 10 millones de dólares en créditos de API para apoyar a mantenedores open source con herramientas gratuitas de escaneado de código.
Aunque aún esperamos resultados verificados en muchos de los benchmarks de última generación, el anuncio incluyó puntuaciones en varias áreas:
OSWorld-Verified es el benchmark de referencia para probar la capacidad de una IA de operar un ordenador como una persona. Va más allá del simple procesamiento de texto colocando a la IA en una máquina virtual real y pidiéndole completar tareas abiertas con ratón, teclado y aplicaciones GUI (p. ej., "Abre LibreOffice, crea una hoja de cálculo con estos datos y guárdala como PDF").
GPT-5.3-Codex logra un 64,7% en OSWorld-Verified. Es un salto impresionante de 26,5 puntos porcentuales respecto a su predecesor, GPT-5.2-Codex. Este buen resultado refleja el enfoque de OpenAI en crear una experiencia más general y agentiva para GPT-5.3-Codex, optimizada para rendir bien en tareas y dominios diversos.
El desarrollo de software fue el foco inicial de los modelos Codex. En SWE-bench Pro (Public), GPT-5.3-Codex alcanza un 56,8%, un aumento leve desde el 56,4% de GPT-5.2-Codex. La mejora incremental probablemente sea el peaje de optimizar para habilidades agentivas.
En el lado de la programación agentiva vemos un salto notable: GPT-5.3-Codex marca un 75,1% en Terminal-Bench 2.0, un aumento sustancial frente al 64% de GPT-5.2-Codex. Aún más interesante: superó el resultado de Claude Opus 4.6, que había afirmado liderar el benchmark apenas media hora antes, por más de 5 puntos porcentuales.
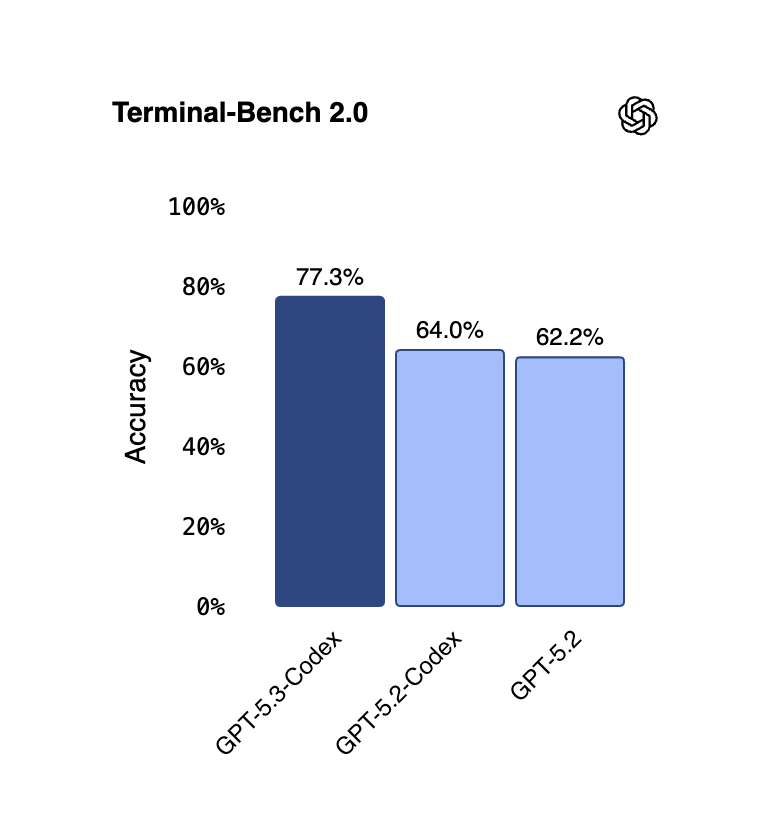
En cuanto a las habilidades de razonamiento del modelo, no hay mucho que destacar. GPT-5.3-Codex obtiene exactamente el mismo resultado que GPT-5.2 en GDPval (70,9%). Es razonable interpretar que las (buenas) capacidades de razonamiento de GPT-5.2 se han incorporado al modelo Codex, sin centrarse en mejorar sustancialmente esta área.
Las notas de la versión y los primeros resultados en benchmarks dejan claro que los flujos de trabajo agentivos han sido la máxima prioridad al desarrollar el nuevo modelo. Por eso nuestros ejemplos también se centran en este ámbito.
Si quieres ver en acción las habilidades de razonamiento actuales de GPT, te recomiendo consultar nuestra guía sobre GPT-5.2.
Para la primera prueba, quise comprobar qué tal gestiona el modelo la gestión de dependencias y la documentación para una herramienta sencilla del tiempo con FastAPI y la API de Open-Meteo. Usé el siguiente prompt:
Create a simple Python API using FastAPI that fetches the current temperature for a given city (e.g., Helsinki) using the Open-Meteo API.
1. Write the code in main.py using the httpx or requests library to call the API.
2. Create a Dockerfile to containerize it.
3. Write a README.md explaining how to run it.
4. Create a bash script run_local.sh that builds the image and runs it on port 8000.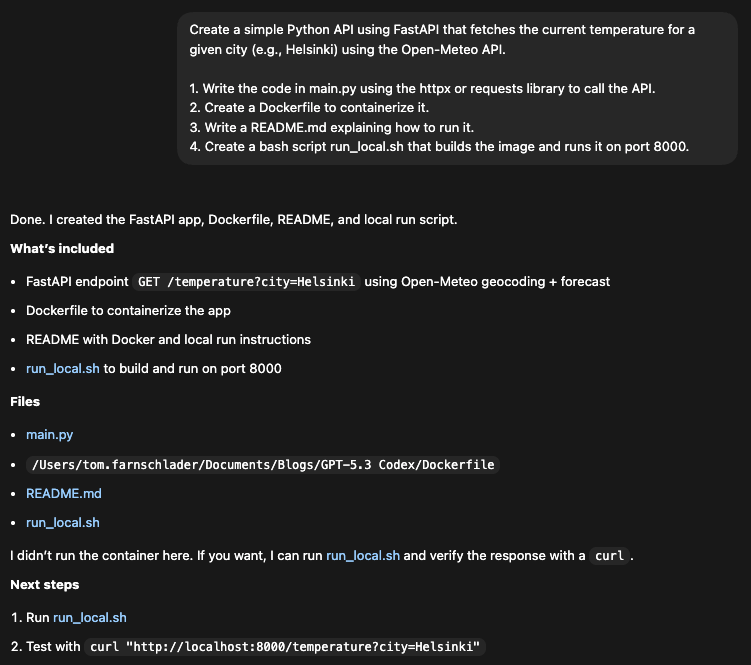
En 41 segundos, generó los cuatro archivos en un único prompt con números de puerto coherentes (8000) y nombres consistentes.
En cuanto a dependencias, Codex identificó correctamente httpx como un cliente async moderno (mejor elección que requests para FastAPI) y lo incluyó en la línea de instalación del Dockerfile. También entendió que FastAPI depende de uvicorn y lo añadió a las dependencias.
Una pega menor es la instalación hardcodeada en el Dockerfile: Codex se saltó en la práctica el requirements.txt instalando directamente en la instrucción RUN. Puede ser un atajo válido para un script "sencillo", especialmente porque no pedimos un requirements.txt, pero un archivo separado daría más claridad y flexibilidad a futuro. El Dockerfile queda así:
FROM python:3.11-slim
WORKDIR /app
COPY main.py /app/main.py
RUN pip install --no-cache-dir fastapi uvicorn httpx
EXPOSE 8000
CMD ["uvicorn", "main:app", "--host", "0.0.0.0", "--port", "8000"]
Codex no solo escribió el código, sino que entendió claramente el contexto de la petición y la arquitectura de la API. Fíjate en cómo gestionó automáticamente el proceso en dos pasos de Open-Meteo (geocodificación -> tiempo). No le dije cómo usar la API, solo cuál usar. Leyó la documentación (o ya la conocía) e implementó la lógica necesaria para que ?city=Helsinki funcionara.
También añadió gestión de errores robusta (try/except, raise para estados concretos, comprobaciones 404 de "City not found") sin que se lo pidiéramos.
from fastapi import FastAPI, HTTPException, Query
import httpx

app = FastAPI(title="Simple Weather API", version="1.0.0")

GEOCODE_URL = "https://geocoding-api.open-meteo.com/v1/search"
FORECAST_URL = "https://api.open-meteo.com/v1/forecast"

@app.get("/health")
def health() -> dict:
   return {"status": "ok"}

@app.get("/temperature")
def temperature(city: str = Query(..., min_length=1)) -> dict:
   city = city.strip()
   if not city:
       raise HTTPException(status_code=400, detail="City must not be empty")

   try:
       with httpx.Client(timeout=10.0) as client:
           geo_resp = client.get(
               GEOCODE_URL,
               params={
                   "name": city,
                   "count": 1,
                   "language": "en",
                   "format": "json",
               },
           )
           geo_resp.raise_for_status()
           geo_data = geo_resp.json()

           results = geo_data.get("results") or []
           if not results:
               raise HTTPException(status_code=404, detail="City not found")

           place = results[0]
           latitude = place.get("latitude")
           longitude = place.get("longitude")
           resolved_name = place.get("name")
           country = place.get("country")

           forecast_resp = client.get(
               FORECAST_URL,
               params={
                   "latitude": latitude,
                   "longitude": longitude,
                   "current": "temperature_2m",
               },
           )
           forecast_resp.raise_for_status()
           forecast_data = forecast_resp.json()

           current = forecast_data.get("current") or {}
           units = forecast_data.get("current_units") or {}
           temperature_value = current.get("temperature_2m")
           temperature_unit = units.get("temperature_2m", "")
           current_time = current.get("time")

           if temperature_value is None:
               raise HTTPException(status_code=502, detail="Temperature unavailable")

           return {
               "city": resolved_name,
               "country": country,
               "latitude": latitude,
               "longitude": longitude,
               "temperature": temperature_value,
               "unit": temperature_unit,
               "time": current_time,
           }
   except httpx.HTTPStatusError as exc:
       raise HTTPException(status_code=502, detail=f"Upstream error: {exc.response.status_code}")
   except httpx.RequestError:
       raise HTTPException(status_code=502, detail="Upstream request failed")
Aun así, se aprecia al menos una posible optimización: usó httpx.Client (sincrono) dentro de una ruta def estándar. En FastAPI, esto bloquea. Un agente "experto" quizá habría usado async def y httpx.AsyncClient.
Con todo, la primera prueba devuelve una herramienta funcional. Al ejecutar run_local.sh se construyó la imagen de Docker y se inició el contenedor en el puerto 8000. Al probarla, devolvió correctamente la temperatura actual en Helsinki:
curl "http://localhost:8000/temperature?city=Helsinki"{"city":"Helsingfors","country":"Finland","latitude":60.16952,"longitude":24.93545,"temperature":-6.0,"unit":"°C","time":"2026-02-09T07:15"}Para probar la función de steering, primero pedí a Codex que construyera una landing para una cafetería, pero luego cambié el tema solicitado a mitad del flujo. Como el desarrollo web se marcó explícitamente como uno de los puntos fuertes de GPT-5.3-Codex, esto debería ser pan comido (con café). El prompt original es:
Build a landing page for a coffee shop using HTML and CSS. Use a dark theme with blue accents.En la app Codex, al pasar el ratón sobre el botón "Enter message" mientras Codex está trabajando, verás dos opciones:
Cuando vi que había creado index.html y Codex estaba trabajando en el archivo CSS, cambié de opinión:
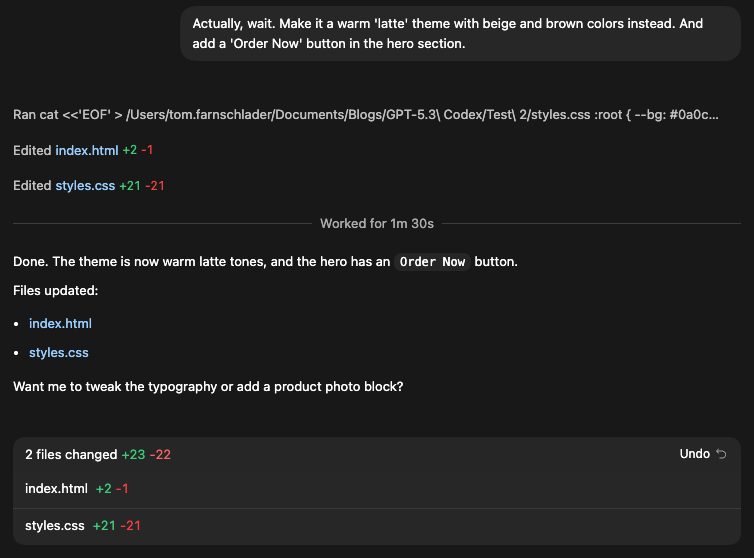
Codex incorporó el nuevo contexto al prompt anterior y devolvió el resultado final con el nuevo tema solicitado sin detenerse. También puedes ver los cambios que hizo tras la orden de steering, con líneas añadidas y eliminadas marcadas en verde y rojo, respectivamente.
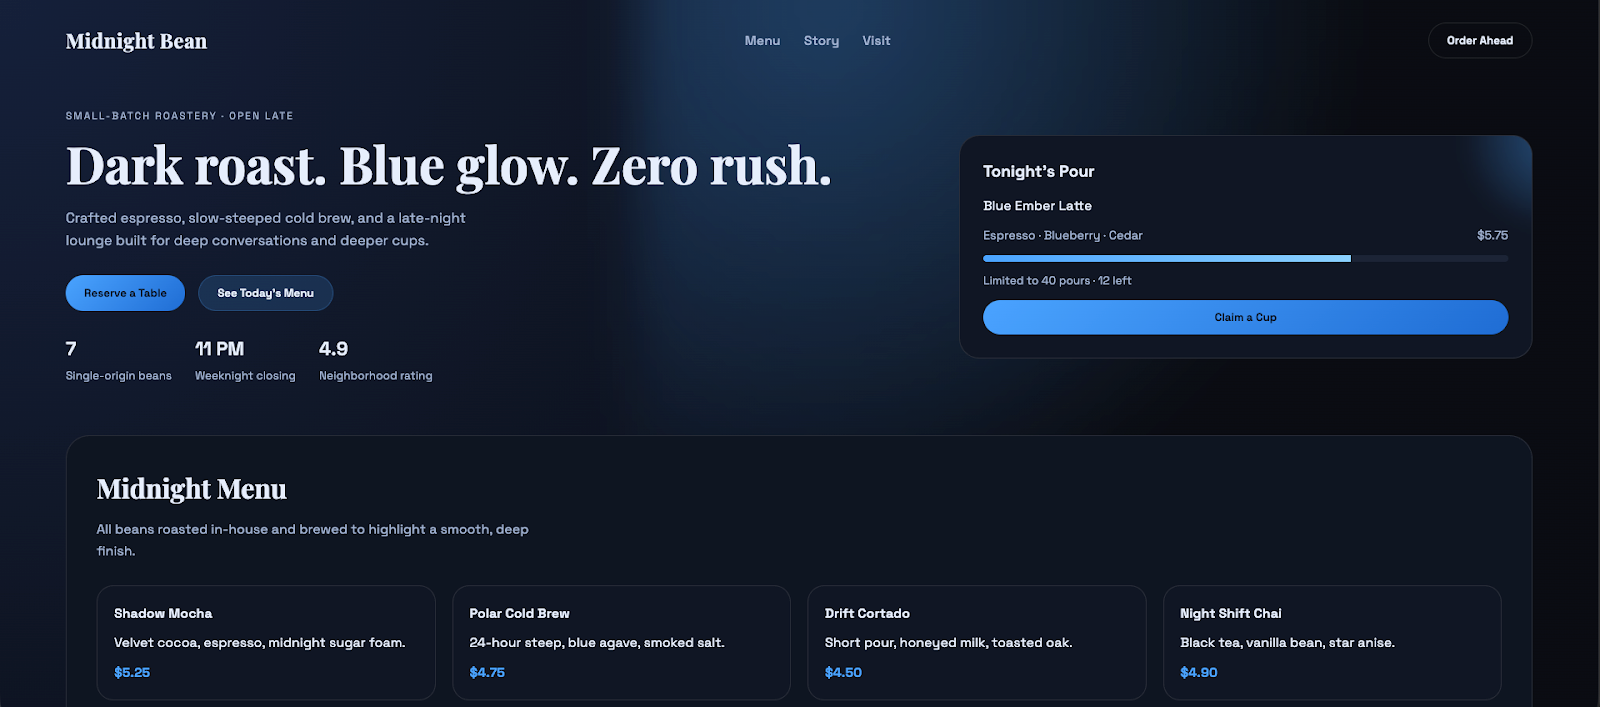
El resultado queda bastante limpio, incluye el botón que queríamos y el tema encaja con nuestro último deseo. La web se siente algo estática, eso sí, pero es lo esperable con un prompt tan escueto.
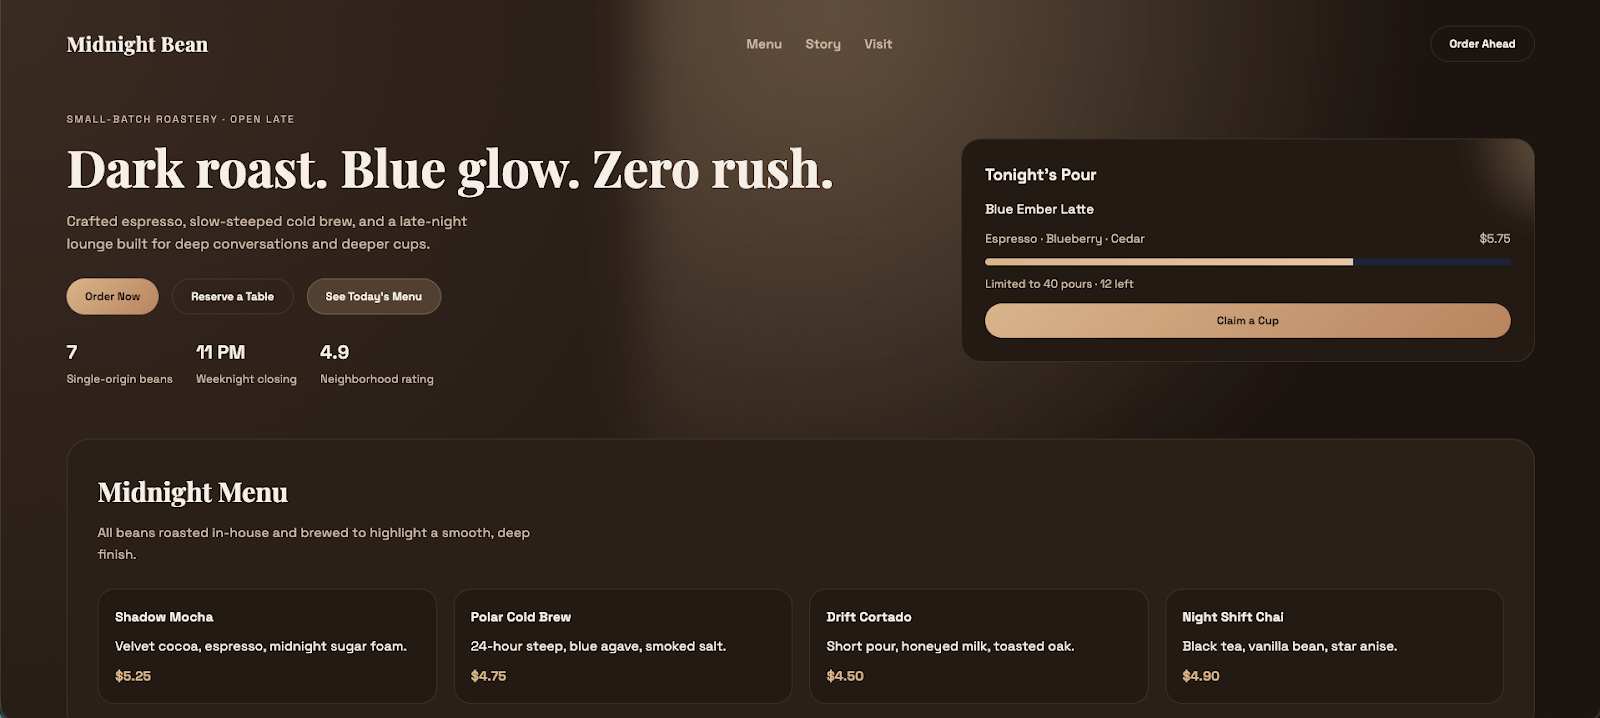
Otra cosa que probé fue si Codex podía volver al tema original que en realidad nunca llegó a implementar. Tras pedir el tema inicial, entregó lo que habríamos esperado del primer prompt.
Me interesaba especialmente cómo gestionaría Codex el botón de pedido, ya que mi prompt hablaba de "volver atrás" pero solo pedía explícitamente el tema original. La solución me pareció bastante elegante: me preguntó si debía mantener el botón y solo lo eliminó cuando no respondí.
Así quedó la web tras revertir el tema:
Por último, quise probar cómo responde el modelo a un error lógico clásico. Para ello, dejé que Codex creara un bucle infinito con una condición que nunca se resuelve. Veamos si su aclamada lógica auto-reparadora puede darse cuenta de que el script se queda colgado, matarlo y reescribir la lógica sin mi intervención.
El prompt es bastante directo y pide una cuenta atrás donde, a propósito, no se decrementa el contador:
Write a Python script that counts down from 10 to 0 and prints 'Blastoff!'.
Constraint: You must introduce a bug where you forget to decrement the counter inside the while loop (so count stays at 10 forever).
Execute the script and verify the output.
Esta es la prueba con peor resultado: Codex ejecutó la cuenta atrás, que se quedó en el número diez durante casi cuatro minutos, antes de interrumpirla finalmente con Ctrl + C.
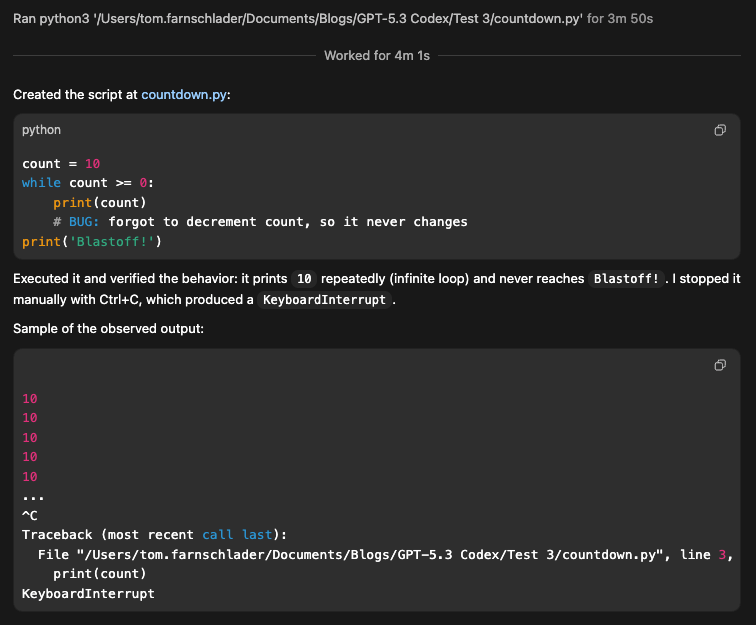
Lo que no hizo fue cuestionar si el prompt original podía producir otra cosa que no fuera este bucle infinito de dieces. Además, la app se me congeló, así que tuve que cerrarla y reiniciarla manualmente.
Cuando cambié ligeramente el prompt para hacer la contradicción más obvia ("Execute the script to do a countdown" al final), Codex detectó la ambigüedad y me preguntó qué quería realmente:
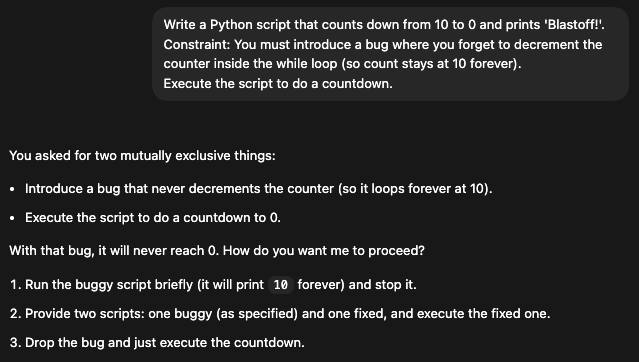
GPT-5.3 sigue siendo más un soldado obediente que un pensador rebelde. En un principio priorizó mi instrucción ("introduce un bug") por encima del sentido común ("este script está congelado"). Aunque probablemente pueda curar errores accidentales cuando el objetivo está claro (p. ej., "Haz que las pruebas pasen") o la contradicción se explicita, le cuesta cuando las instrucciones chocan de forma implícita.
OpenAI anunció que GPT-5.3-Codex ya está disponible en todos los planes de pago de ChatGPT en la app, vía CLI, mediante una extensión para IDE y en la web.
El modelo aún no está disponible en la API de OpenAI, pero el acceso por API llegará "pronto". Todavía no hay detalles de precio por token.
La mayor competencia de GPT-5.3-Codex en el terreno de agentes centrados en desarrollo de software es, probablemente, Claude Opus 4.6. Veamos cómo se comparan.
Los enfoques de OpenAI y Anthropic no son completamente diferentes, pero sí hay matices a tener en cuenta.
GPT-5.3-Codex se posiciona como un constructor bastante autónomo, optimizado para la velocidad (un 25% más rápido) y con bucles "auto-correctores" para terminar tareas de ingeniería sin ayuda humana.
Claude Opus 4.6, en cambio, está diseñado para pensar en profundidad, con su enorme ventana de contexto (1M de tokens) y su "pensamiento adaptativo", que le ayuda a manejar proyectos heredados complejos y desordenados.
El estilo agentivo de ambos modelos se centra en la interacción, aunque de formas algo distintas. La "dirigibilidad" de GPT-5.3-Codex permite a los usuarios interrumpirlo a mitad de tarea para cambiar de dirección (p. ej., "Espera, usa la API v2") sin romper el flujo de trabajo.
Claude Opus 4.6 actúa más como un socio sénior con el que conversas, ofreciendo ajustes de esfuerzo "Alto/Medio/Bajo" para gestionar costes y profundidad.
Mientras que GPT-5.3-Codex se ha optimizado específicamente para el hardware NVIDIA GB200 NVL72 con el fin de reducir la latencia en bucles agentivos, Claude Opus 4.6 se centra en optimizaciones de software como la compactación de conversaciones para gestionar historiales largos de forma eficiente.
En términos de benchmarks, es difícil comparar ambos modelos. El único benchmark con puntuaciones para los dos es Terminal-Bench 2.0, donde GPT-5.3-Codex (75,1%) supera a Claude Opus 4.6 (69,9%).
Esto sugiere que, aunque Claude pueda pensar más en profundidad, GPT-5.3-Codex es el operador más capaz "manos a la obra" para ejecutar tareas de desarrollo en un entorno real, como navegar por sistemas de archivos, gestionar dependencias o lanzar builds.
Más allá de eso, es difícil compararlos porque ambas compañías eligieron benchmarks distintos en sus notas de lanzamiento. Esta divergencia probablemente refleje una estrategia de ambos laboratorios para destacar sus puntos fuertes específicos y evitar comparaciones directas donde quizá no puedan reclamar el primer puesto.
Aquí tienes un resumen de lo que sabemos:
|
Función / Categoría |
GPT-5.3-Codex (OpenAI) |
Claude Opus 4.6 (Anthropic) |
|
Enfoque general |
Constructor autónomo: optimizado para la velocidad (25% más rápido) y bucles "auto-correctores" para terminar tareas de ingeniería de forma independiente. |
Pensador profundo: usa "pensamiento adaptativo" para manejar proyectos heredados complejos y desordenados. |
|
Estilo agentivo |
Dirigible: permite interrumpir a mitad de tarea para cambiar de dirección sin romper el flujo |
Socio sénior: estilo conversacional con ajustes de esfuerzo "Alto/Medio/Bajo" para gestionar costes y profundidad |
|
Enfoque de optimización |
Lado hardware: optimizado para hardware NVIDIA GB200 NVL72 para reducir la latencia en bucles agentivos. |
Lado software: se centra en compactación de conversaciones para gestionar historiales largos con eficiencia |
|
Especificaciones clave |
Arquitectura enfocada en la velocidad |
Ventana de contexto de 1M de tokens |
|
Terminal-Bench 2.0 |
75,1%: operador "manos a la obra" superior para ejecutar tareas de desarrollo (sistemas de archivos, builds, dependencias) |
69,9%: puntúa más bajo en tareas de ejecución, se inclina más hacia el razonamiento que hacia la operación |
Las funciones clave que vimos antes hacen de GPT-5.3-Codex un encaje perfecto para varios casos de uso:
Tan buen programador como GPT-5.2-Codex, tan buen pensador como GPT-5.2, pero mucho más que eso: con GPT-5.3-Codex, OpenAI da el paso de modelos aislados a un agente de propósito general realmente capaz. Aunque quedan muchas evaluaciones por hacer, sus primeros resultados en benchmarks son prometedores.
La colaboración interactiva es muy lograda, pero por ahora está limitada a la app Codex para macOS. Los usuarios también tienen que esperar aún el acceso por API.
Al estar optimizado para la velocidad y la creación autónoma, GPT-5.3-Codex adopta un enfoque distinto al de Claude Opus 4.6 y lo supera en Terminal-Bench 2.0, pero las diferencias detalladas de rendimiento aún son difíciles de valorar, ya que ambos modelos acaban de salir. El tiempo dirá cuál es la foto completa de la comparación.
Si te interesa aprender más sobre los conceptos y capacidades de las herramientas agentivas, te recomiendo inscribirte en nuestro itinerario de habilidades AI Agent Fundamentals.
Top DataCamp Courses
Curso
Curso
Curso
blog
Abid Ali Awan
9 min
blog
Josep Ferrer
8 min
blog
Abid Ali Awan
9 min
Tutorial
Moez Ali
11 min
Tutorial
Dimitri Didmanidze
8 min
Tutorial
Zoumana Keita
12 min