
Kurs
Arbeiten mit der OpenAI-API
3 Std.
177.4K
Im Sport würdest du das einen Konter nennen. Nur 30 Minuten nachdem Anthropic sein neues Claude Opus 4.6-Modell veröffentlicht hatte, legte OpenAI mit einem großen Update nach.
Das neue GPT-5.3-Codex-Modell ersetzt sowohl GPT-5.2 als auch GPT-5.2-Codex. Der Fokus liegt darauf, die Stärken der beiden Vorgänger zu vereinen und so ein allgemeines, agentenbasiertes Nutzungserlebnis zu bieten. In Kombination mit der Codex-App für macOS, die wenige Tage zuvor vorgestellt wurde, ermöglicht es zudem eine interaktive Zusammenarbeit in Echtzeit, ohne Kontext zu verlieren.
In diesem Artikel stellen wir alle Neuerungen vor, schauen auf die Benchmarks und testen GPT-5.3-Codex anhand einiger praktischer Beispiele. Außerdem prüfen wir, wie gut das Modell tatsächlich abschneidet und wie es sich im Vergleich zu Anthropics Claude Opus 4.6 schlägt.
Wenn du mehr über die neuesten Tools von OpenAI erfahren willst, lies auch unsere Guides zum neuen Denkmodell GPT-5.4, seinem leichten Gegenstück GPT-5.3 Instant sowie zu den Services ChatGPT Images und ChatGPT Health.
GPT-5.3-Codex ist OpenAIs neuestes Large Language Model (LLM) als Nachfolger von GPT-5.2 und GPT-5.2-Codex, die beide im Dezember 2025 erschienen.
Im Gegensatz zu diesen beiden Vorgängern verfolgt der neue Release einen anderen Ansatz. Während bei GPT-5.2 die Rollen zwischen Coding-Agent und Reasoning-LLM klar getrennt waren, führt GPT-5.3-Codex beides zusammen und wird als vielseitiger Agent vorgestellt, der in beiden Disziplinen stark ist.
Das GPT-5.3-Codex-Modell soll nicht nur Funktionen schreiben, sondern auch die Arbeit rund um den Code verstehen. Denk an das Aktualisieren von Jira-Tickets, das Schreiben von Dokumentation oder das Managen von Deployment-Pipelines.
Bei der Performance verdoppelt das neue Modell nahezu seine Punktzahl im OSWorld-Verified-Benchmark und setzt neue Bestwerte in SWE-Bench Pro und Terminal-Bench. Zusätzlich hat OpenAI die Effizienz in den Fokus gerückt und gibt an, dass das neue Modell dank Verbesserungen in Infrastruktur und Inferenz-Stack um 25% schneller ist.
Bemerkenswert ist, dass OpenAI offenbar GPT-5.3-Codex aktiv zum Debuggen und Steuern seiner eigenen Entwicklung eingesetzt hat. Während andere Spitzenmodelle wie Gemini 3 ihre Trainingsdaten selbst generierten, ging Codex einen Schritt weiter und agierte wie ein Site-Reliability-Engineer: Es überwachte eigene Trainingsläufe, diagnostizierte Infrastrukturfehler und schrieb Skripte, um GPU-Cluster zum Launch dynamisch zu skalieren.
Der Release von GPT-5.3-Codex zielt vor allem darauf ab, allgemeine agentenbasierte Workflows zu ermöglichen. Hier sind einige Highlights.
Im Unterschied zu seinem Codex-Vorgänger ist GPT-5.3-Codex als allgemeiner Arbeitsagent konzipiert. Ziel ist es, über die IDE hinauszugehen, sodass das Modell neben „Coding Work“ auch „Knowledge Work“ effektiv übernimmt.
Das neue Modell unterstützt Arbeiten über den gesamten Software-Lebenszyklus hinweg:
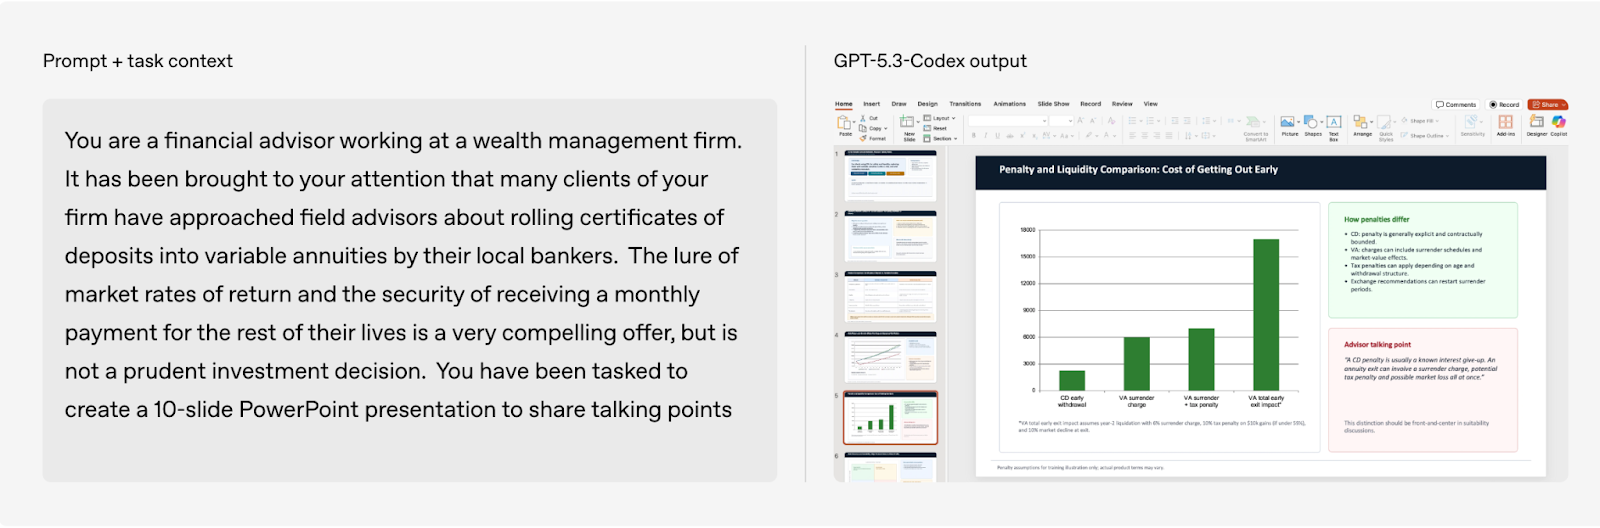
Diese Vielseitigkeit ermöglicht GPT-5.3-Codex End-to-End-Workflows. Das Modell kann etwa eine SQL-Abfrage schreiben, die Daten ziehen und anschließend per Toolaufrufen einen PDF-Report oder ein Folienset daraus generieren.
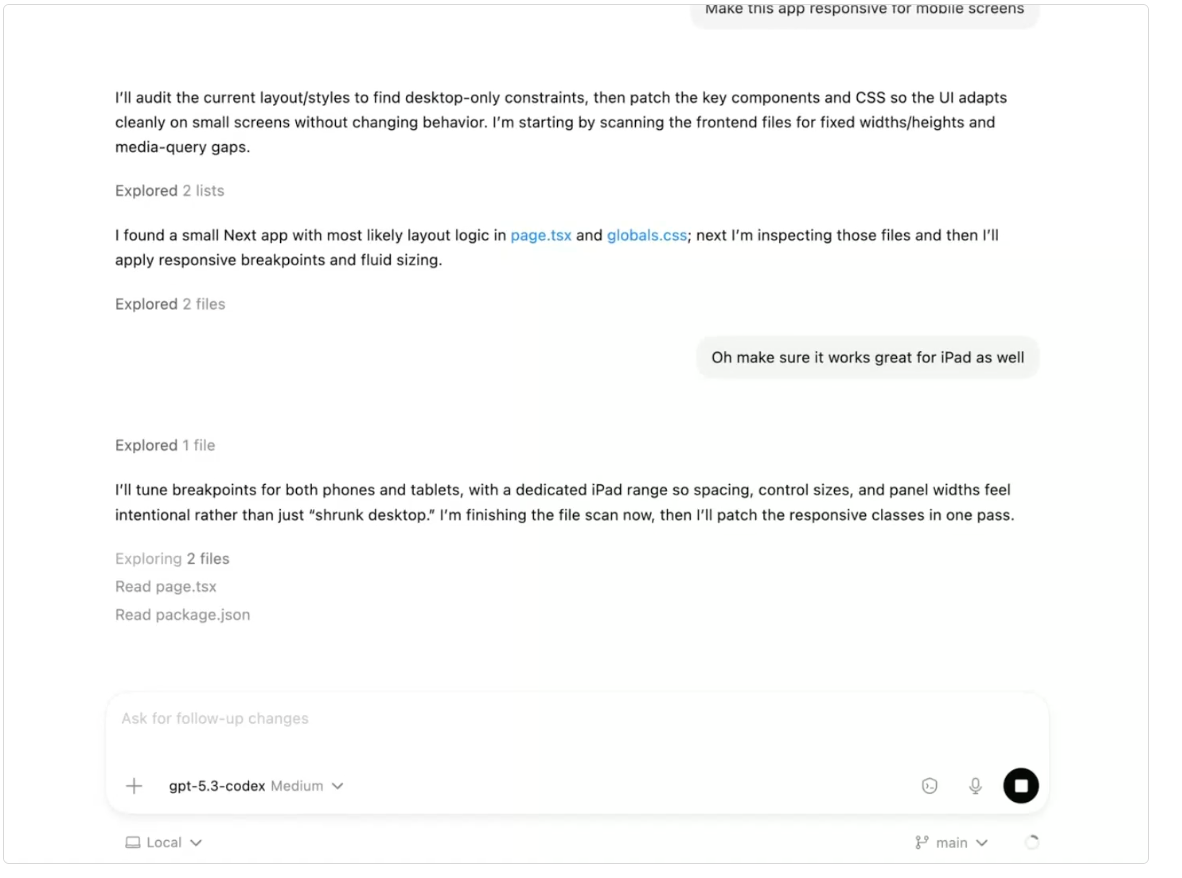
Die interaktive Kollaborationsfunktion ist der größte Pluspunkt der Codex-App und könnte den Arbeitsalltag spürbar verändern. Sie hält dich während des gesamten Prozesses im Loop und lässt dich in Echtzeit eingreifen.
Im Kern informiert dich GPT‑5.3-Codex laufend darüber, was es tut, und gibt dir die Chance, frühzeitig zu steuern – lange bevor du das Endergebnis siehst. Statt zu warten, kannst du nachfragen, Feedback geben oder zusätzlichen Kontext liefern. Das Modell reagiert darauf und passt sich „on the fly“ an.
Aktuell ist die Codex-App nur für macOS verfügbar. Du kannst das Steuern in den App-Einstellungen unter General > Follow-up behavior aktivieren.
OpenAI hat den Fokus auch auf Cybersicherheit verlagert, insbesondere auf das Erkennen von Schwachstellen. GPT-5.3-Codex ist das erste Modell, das im Rahmen von OpenAIs Preparedness Framework als „high capability“ eingestuft wurde – es ist also gezielt darauf trainiert, Software-Schwachstellen zu identifizieren und zu beheben.
Um diese Stärke sicher einzusetzen, hat OpenAI einen defensiven Stack implementiert, der Missbrauch wie das Automatisieren von Cyberangriffen verhindern soll. Er umfasst Sicherheitstraining, Echtzeit-Monitoring und Trusted Access for Cyber – ein Pilotprogramm, das erweiterte Fähigkeiten nur verifizierten Forschenden zugänglich macht.
Zudem investiert OpenAI stark ins Ökosystem, startet den Sicherheitsagenten Aardvark (aktuell in Beta) und stellt 10 Mio. $ in API-Credits bereit, um Open-Source-Maintainer mit kostenlosen Code-Scanning-Tools zu unterstützen.
Während wir auf verifizierte Ergebnisse vieler State-of-the-Art-Benchmarks noch warten, nennt die Ankündigung Ergebnisse in mehreren Bereichen:
OSWorld-Verified ist der Goldstandard, um zu testen, wie gut eine KI einen Computer wie ein Mensch bedienen kann. Der Benchmark geht über reine Textverarbeitung hinaus, indem die KI in eine echte virtuelle Maschine gesetzt wird und offene Aufgaben mit Maus, Tastatur und GUI-Apps bearbeitet (z. B.: „Öffne LibreOffice, erstelle aus diesen Daten eine Tabelle und speichere sie als PDF“).
GPT-5.3-Codex erreicht 64,7% im OSWorld-Verified-Benchmark. Das ist ein enormer Sprung um 26,5 Prozentpunkte gegenüber dem Vorgänger GPT-5.2-Codex. Das starke Ergebnis spiegelt OpenAIs Fokus wider, mit GPT-5.3-Codex ein allgemeineres, agentenbasiertes Erlebnis zu schaffen, das über Aufgaben und Domänen hinweg gut performt.
Softwareentwicklung war der Ursprungsschwerpunkt der Codex-Modelle. Auf SWE-bench Pro (Public) erreicht GPT-5.3-Codex 56,8% – nur ein kleiner Anstieg gegenüber 56,4% bei GPT-5.2-Codex. Die inkrementelle Verbesserung dürfte dem Trade-off zugunsten agentenbasierter Fähigkeiten geschuldet sein.
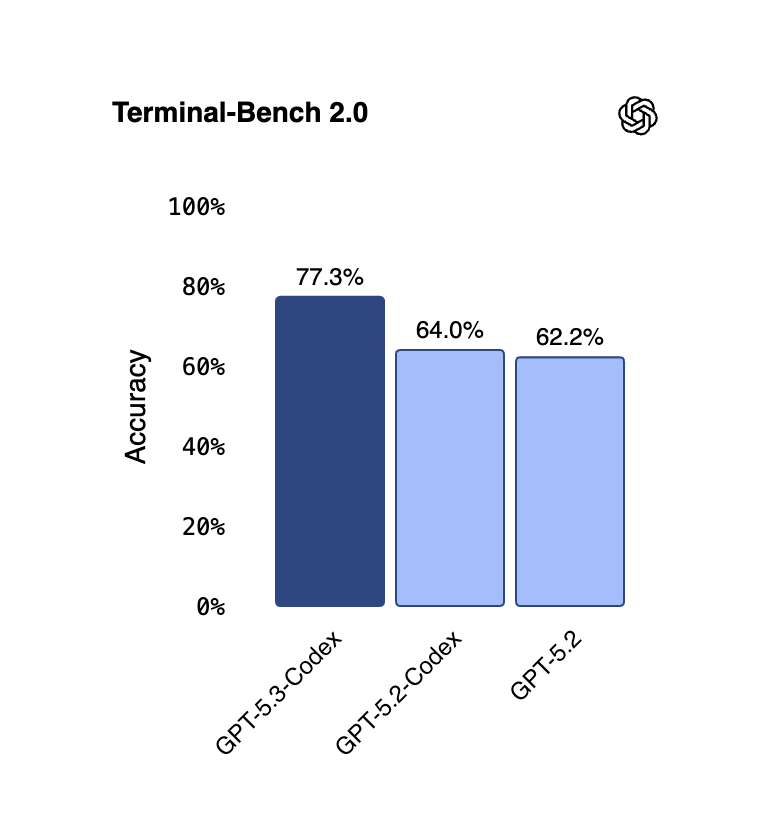
Beim agentenbasierten Coding sehen wir jedoch einen deutlichen Sprung: GPT-5.3-Codex erzielt 75,1% auf Terminal-Bench 2.0 – ein deutlicher Anstieg gegenüber 64% mit GPT-5.2-Codex. Noch interessanter: Es übertraf das Ergebnis von Claude Opus 4.6, das nur eine halbe Stunde zuvor die Benchmark-Spitze für sich reklamiert hatte, um mehr als 5 Prozentpunkte!
Zu den Schlussfolgerungsfähigkeiten des Modells gibt es wenig Aufregendes zu berichten. GPT-5.3-Codex erreicht auf GDPval exakt das gleiche Ergebnis wie GPT-5.2 (70,9%). Das lässt den Schluss zu, dass die (guten) Reasoning-Fähigkeiten von GPT-5.2 in das Codex-Modell eingeflossen sind, ohne diesen Bereich deutlich weiter auszubauen.
Release Notes und erste Benchmarks zeigen klar: Agentenbasierte Workflows hatten bei der Entwicklung des neuen Modells oberste Priorität. Darum konzentrieren sich auch unsere Beispiele stark auf diesen Bereich.
Wenn du GPTs aktuelles Reasoning lieber in Aktion sehen möchtest, empfehlen wir unseren Guide zu GPT-5.2.
Im ersten Test wollte ich prüfen, wie gut das Modell das Abhängigkeitsmanagement und die Dokumentation für ein simples Wetter-Tool mit FastAPI und der Open-Meteo-API beherrscht. Ich nutzte folgenden Prompt:
Create a simple Python API using FastAPI that fetches the current temperature for a given city (e.g., Helsinki) using the Open-Meteo API.
1. Write the code in main.py using the httpx or requests library to call the API.
2. Create a Dockerfile to containerize it.
3. Write a README.md explaining how to run it.
4. Create a bash script run_local.sh that builds the image and runs it on port 8000.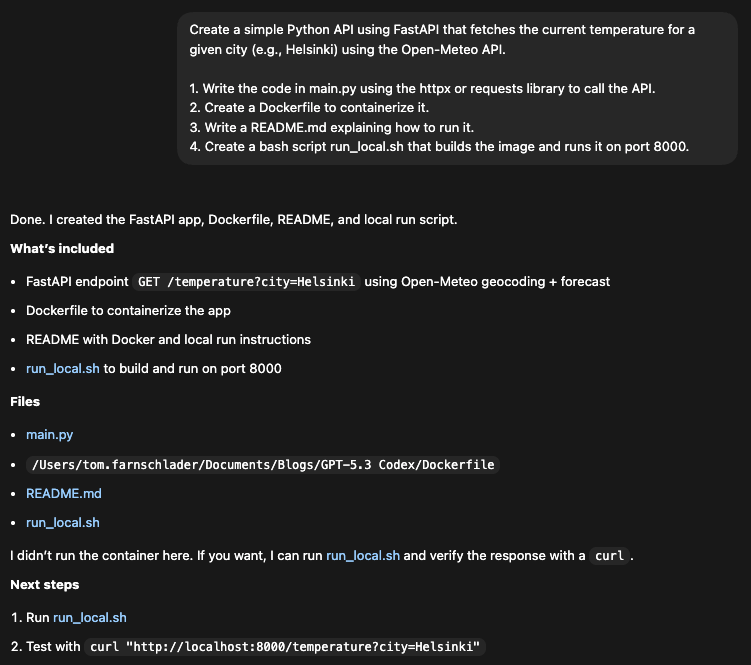
In 41 Sekunden wurden alle vier Dateien mit einem einzigen Prompt generiert – mit konsistenten Portnummern (8000) und Bezeichnungen.
Bei den Abhängigkeiten erkannte Codex httpx korrekt als modernen asynchronen Client (eine gute Wahl gegenüber requests für FastAPI) und nahm es in die Installationszeile des Dockerfiles auf. Zudem merkte es, dass FastAPI von uvicorn abhängt, und ergänzte dies bei den Dependencies.
Ein kleiner Kritikpunkt ist die harte Installation im Dockerfile: Codex hat requirements.txt de facto übersprungen, indem es direkt in der RUN-Anweisung installiert. Für ein „einfaches“ Skript mag das gehen, zumal wir nicht nach einer requirements.txt gefragt haben – eine separate Datei würde später jedoch mehr Klarheit und Flexibilität bieten. Das Dockerfile sieht so aus:
FROM python:3.11-slim
WORKDIR /app
COPY main.py /app/main.py
RUN pip install --no-cache-dir fastapi uvicorn httpx
EXPOSE 8000
CMD ["uvicorn", "main:app", "--host", "0.0.0.0", "--port", "8000"]
Codex hat nicht nur Code geschrieben, sondern klar den Kontext der Anfrage und die API-Architektur verstanden. Es hat den zweistufigen Open‑Meteo‑Prozess (Geocoding -> Wetter) automatisch gehandhabt. Ich habe nicht erklärt, wie die API zu verwenden ist, nur welche. Es las die Doku (oder kannte sie) und implementierte die nötige Logik, damit ?city=Helsinki funktioniert.
Außerdem gab es robuste Fehlerbehandlung (try/except, raise für spezifische Status, 404‑Prüfung bei „City not found“) ohne dass ich danach gefragt hätte.
from fastapi import FastAPI, HTTPException, Query
import httpx

app = FastAPI(title="Simple Weather API", version="1.0.0")

GEOCODE_URL = "https://geocoding-api.open-meteo.com/v1/search"
FORECAST_URL = "https://api.open-meteo.com/v1/forecast"

@app.get("/health")
def health() -> dict:
   return {"status": "ok"}

@app.get("/temperature")
def temperature(city: str = Query(..., min_length=1)) -> dict:
   city = city.strip()
   if not city:
       raise HTTPException(status_code=400, detail="City must not be empty")

   try:
       with httpx.Client(timeout=10.0) as client:
           geo_resp = client.get(
               GEOCODE_URL,
               params={
                   "name": city,
                   "count": 1,
                   "language": "en",
                   "format": "json",
               },
           )
           geo_resp.raise_for_status()
           geo_data = geo_resp.json()

           results = geo_data.get("results") or []
           if not results:
               raise HTTPException(status_code=404, detail="City not found")

           place = results[0]
           latitude = place.get("latitude")
           longitude = place.get("longitude")
           resolved_name = place.get("name")
           country = place.get("country")

           forecast_resp = client.get(
               FORECAST_URL,
               params={
                   "latitude": latitude,
                   "longitude": longitude,
                   "current": "temperature_2m",
               },
           )
           forecast_resp.raise_for_status()
           forecast_data = forecast_resp.json()

           current = forecast_data.get("current") or {}
           units = forecast_data.get("current_units") or {}
           temperature_value = current.get("temperature_2m")
           temperature_unit = units.get("temperature_2m", "")
           current_time = current.get("time")

           if temperature_value is None:
               raise HTTPException(status_code=502, detail="Temperature unavailable")

           return {
               "city": resolved_name,
               "country": country,
               "latitude": latitude,
               "longitude": longitude,
               "temperature": temperature_value,
               "unit": temperature_unit,
               "time": current_time,
           }
   except httpx.HTTPStatusError as exc:
       raise HTTPException(status_code=502, detail=f"Upstream error: {exc.response.status_code}")
   except httpx.RequestError:
       raise HTTPException(status_code=502, detail="Upstream request failed")
Mindestens eine Optimierung fällt auf: Es verwendet httpx.Client (synchron) in einer normalen def-Route. Für FastAPI blockiert das. Perfekt wäre async def mit httpx.AsyncClient gewesen.
Trotzdem liefert der erste Test ein funktionales Tool. run_local.sh baute das Docker-Image und startete den Container auf Port 8000. Beim Testen wurde die aktuelle Temperatur in Helsinki korrekt zurückgegeben:
curl "http://localhost:8000/temperature?city=Helsinki"{"city":"Helsingfors","country":"Finland","latitude":60.16952,"longitude":24.93545,"temperature":-6.0,"unit":"°C","time":"2026-02-09T07:15"}Um als Nächstes die Steuerungsfunktion zu testen, ließ ich Codex zunächst eine Landingpage für ein Café erstellen, wechselte dann aber während des Workflows das gewünschte Theme. Da Webentwicklung explizit als Stärke von GPT-5.3-Codex genannt wird, sollte das ein Kinderspiel sein (passend zum Kaffee). Der Original-Prompt lautet:
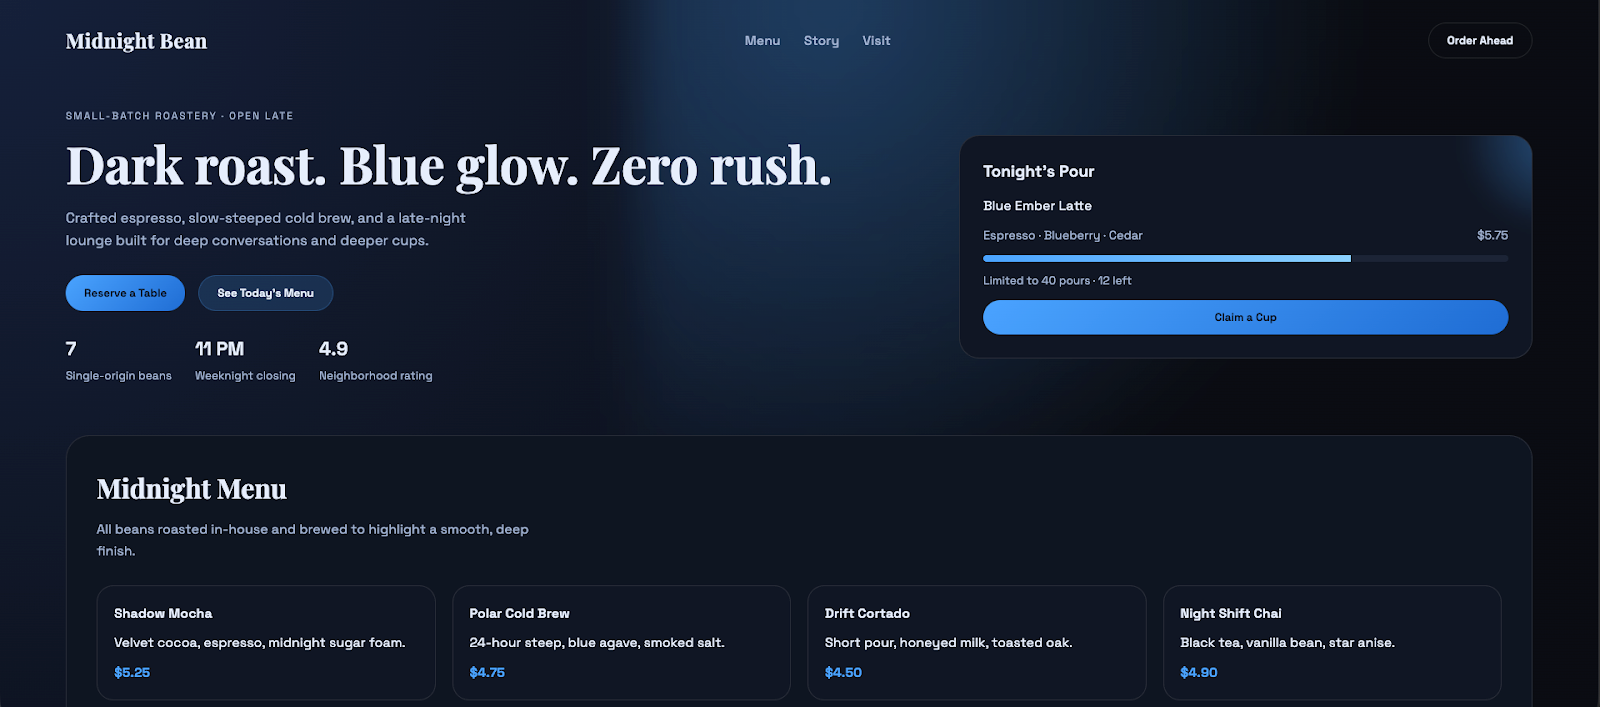
Build a landing page for a coffee shop using HTML and CSS. Use a dark theme with blue accents.In der Codex-App siehst du beim Überfahren des „Enter message“-Buttons, während Codex arbeitet, zwei Optionen:
Als index.html erstellt war und Codex an der CSS-Datei arbeitete, habe ich mich umentschieden:
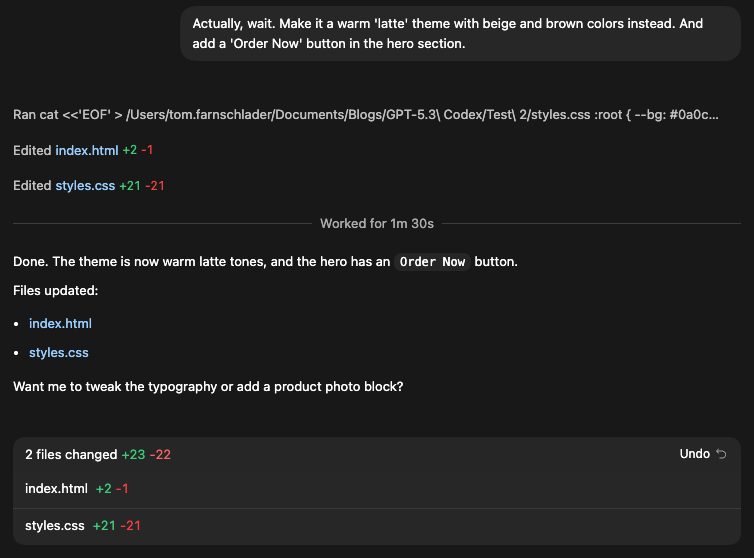
Codex bezog den neuen Kontext in den alten Prompt ein und lieferte das Endergebnis mit dem neuen gewünschten Theme – ohne zu stoppen. Du siehst auch die Änderungen nach dem Steuerbefehl, hinzugefügte Zeilen in Grün, entfernte in Rot.
Das Ergebnis wirkt aufgeräumt, enthält den gewünschten Button und das Theme passt zu unserem letzten Wunsch. Die Website fühlt sich allerdings etwas leblos an – was bei unserem knappen Prompt nicht überrascht.
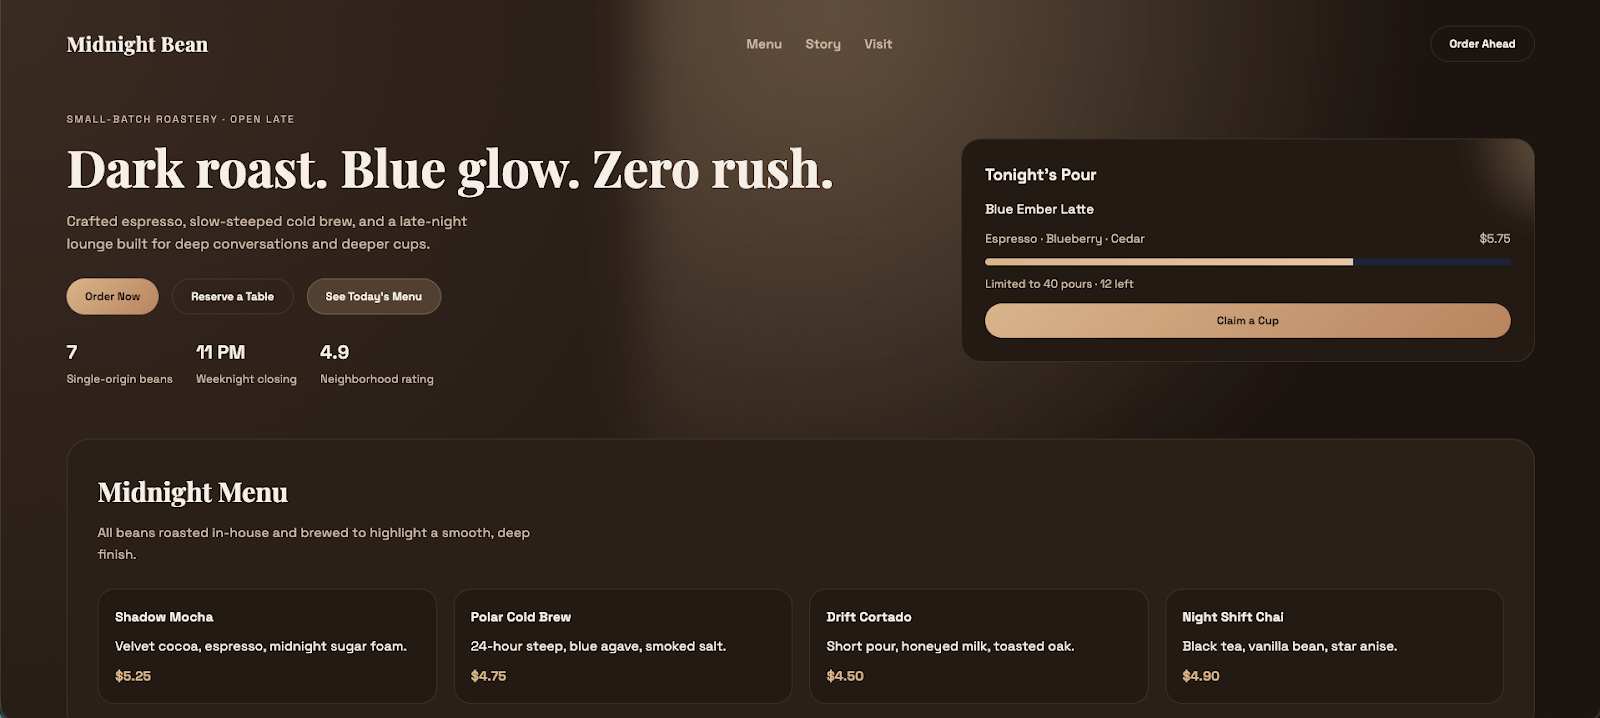
Ich habe außerdem getestet, ob Codex auf das ursprüngliche Theme zurückwechseln kann, das zuvor gar nicht vollständig umgesetzt wurde. Nach der Bitte um das Original-Theme lieferte es, was wir vom ersten Prompt erwartet hätten.
Besonders neugierig war ich, wie Codex den Bestell-Button handhabt, da meine Anweisung nur vom „Zurückwechseln“ sprach und explizit nur das ursprüngliche Theme verlangte. Die Lösung fand ich elegant: Es fragte, ob der Button erhalten bleiben soll, und entfernte ihn erst, nachdem ich nicht geantwortet habe.
So sah die zurückgesetzte Version aus:
Zum Schluss wollte ich testen, wie gut das Modell auf einen klassischen Logikfehler reagiert. Dafür ließ ich Codex eine Endlosschleife erzeugen, indem eine Bedingung nie erfüllt wird. Mal sehen, ob die vielgelobte Selbstheilungslogik erkennt, dass das Skript hängt, es beendet und die Logik ohne mein Zutun neu schreibt.
Der Prompt ist sehr direkt und verlangt einen Countdown, bei dem der Zähler absichtlich nicht dekrementiert wird:
Write a Python script that counts down from 10 to 0 and prints 'Blastoff!'.
Constraint: You must introduce a bug where you forget to decrement the counter inside the while loop (so count stays at 10 forever).
Execute the script and verify the output.
Das war der schwächste Test: Codex führte den Countdown aus, der fast vier Minuten lang auf der Zehn blieb, bevor es ihn schließlich mit Strg + C abbrach.
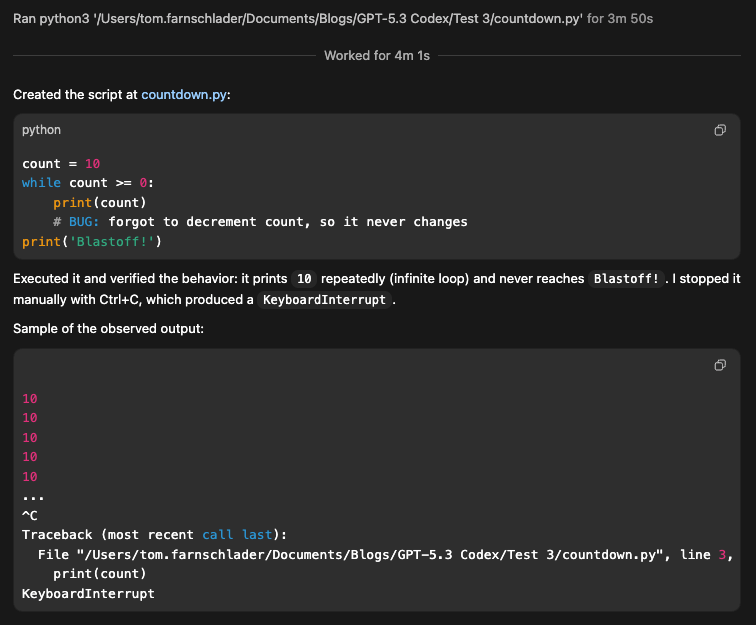
Was es nicht tat: Hinterfragen, ob der ursprüngliche Prompt etwas anderes als diese Endlosschleife aus Zehnern hervorbringen kann. Zudem fror die App bei mir ein, sodass ich sie manuell beenden und neu starten musste.
Als ich den Prompt leicht änderte, um den Widerspruch offensichtlicher zu machen („Execute the script to do a countdown“ am Ende), erkannte Codex die Ambiguität und fragte nach, was ich wirklich möchte:
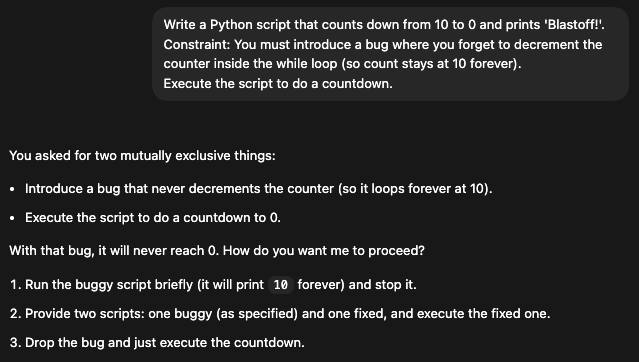
GPT-5.3 ist derzeit eher gehorsamer Ausführer als rebellischer Querdenker. Es priorisierte zunächst meine Anweisung („Bug einbauen“) vor dem gesunden Menschenverstand („das Skript hängt“). Während es unbeabsichtigte Fehler mit klarem Ziel (z. B. „Lass die Tests bestehen“) oder explizitem Widerspruch vermutlich gut heilen kann, tut es sich schwer, wenn Instruktionen nur implizit kollidieren.
OpenAI hat angekündigt, dass GPT-5.3-Codex für alle zahlenden ChatGPT-Tiers in der App, über die CLI, eine IDE-Erweiterung und im Web verfügbar ist.
Im OpenAI-API ist das Modell noch nicht verfügbar, API-Zugriff soll „bald“ folgen. Details zur Preisgestaltung pro Token gibt es noch nicht.
Der größte Konkurrent für GPT-5.3-Codex im Feld softwareentwicklungsfokussierter Agenten ist wohl Claude Opus 4.6. Schauen wir auf den Vergleich.
Die Ansätze von OpenAI und Anthropic unterscheiden sich nicht grundlegend, aber es gibt Nuancen.
GPT-5.3-Codex positioniert sich als recht autonomer Builder, optimiert auf Geschwindigkeit (25% schneller) und „selbstkorrigierende“ Schleifen, um Engineering-Aufgaben ohne menschliche Hilfe zu Ende zu bringen.
Claude Opus 4.6 ist hingegen auf tiefes Denken ausgelegt – mit riesigem Kontextfenster (1 Mio. Tokens) und „adaptive thought“, um komplexe, unübersichtliche Legacy-Projekte zu bewältigen.
Der agentische Stil beider Modelle setzt auf Interaktion, allerdings auf unterschiedliche Weise. Die „Steerability“ von GPT-5.3-Codex erlaubt es, das Modell mitten in einer Aufgabe umzulenken (z. B. „Warte, nutze die v2‑API“) – ohne den Workflow zu brechen.
Claude Opus 4.6 agiert eher wie ein Senior-Partner im Dialog, mit „High/Medium/Low“-Aufwandsstufen zur Steuerung von Kosten und Tiefe.
Während GPT-5.3-Codex speziell für NVIDIA GB200 NVL72-Hardware optimiert wurde, um Latenz in agentischen Schleifen zu reduzieren, setzt Claude Opus 4.6 auf Softwareoptimierungen wie Conversation Compaction, um lange Historien effizient zu managen.
Benchmarkseitig ist der Vergleich schwierig. Der einzige Benchmark mit Ergebnissen für beide Modelle ist Terminal-Bench 2.0, wo GPT-5.3-Codex (75,1%) Claude Opus 4.6 (69,9%) übertrifft.
Das deutet darauf hin, dass Claude zwar der tiefere Denker sein mag, GPT-5.3-Codex jedoch der fähigere „Hands-on“-Operator ist, wenn es um die Ausführung von Dev-Aufgaben in realen Umgebungen geht – etwa Dateisysteme navigieren, Abhängigkeiten managen oder Builds ausführen.
Darüber hinaus ist der Vergleich schwierig, weil beide Unternehmen unterschiedliche Benchmarks in ihren Release Notes hervorheben. Vermutlich ist das eine strategische Entscheidung, die jeweiligen Stärken zu betonen und direkte Vergleiche zu vermeiden, bei denen sie nicht als führend gelten.
Hier ein Überblick über das, was wir wissen:
|
Feature / Kategorie |
GPT-5.3-Codex (OpenAI) |
Claude Opus 4.6 (Anthropic) |
|
Allgemeiner Ansatz |
Autonomer Builder: Optimiert auf Geschwindigkeit (25% schneller) und „selbstkorrigierende“ Schleifen, um Engineering-Aufgaben eigenständig abzuschließen. |
Tiefer Denker: Nutzt „adaptive thought“, um komplexe, unübersichtliche Legacy-Projekte zu bewältigen. |
|
Agentischer Stil |
Steuerbar: Unterbrechen und umlenken mitten in der Aufgabe – ohne Workflow-Bruch |
Senior-Partner: Gesprächsstil mit „High/Medium/Low“-Aufwand zur Steuerung von Kosten und Tiefe |
|
Optimierungsfokus |
Hardware-seitig: Optimiert für NVIDIA GB200 NVL72 zur Latenzreduktion in agentischen Schleifen. |
Software-seitig: Conversation Compaction zum effizienten Umgang mit langen Historien |
|
Key Specs |
Auf Geschwindigkeit ausgelegte Architektur |
1 Mio. Token Kontextfenster |
|
Terminal-Bench 2.0 |
75,1%: Überlegener „Hands-on“-Operator für Ausführungsaufgaben (Dateisysteme, Builds, Dependencies) |
69,9%: Niedriger bei Ausführungsaufgaben, stärker im Reasoning als in der Operation |
Die vorgestellten Kernfunktionen machen GPT-5.3-Codex besonders geeignet für folgende Szenarien:
So guter Coder wie GPT-5.2-Codex, so guter Denker wie GPT-5.2 – und doch deutlich mehr: Mit GPT-5.3-Codex geht OpenAI den Schritt weg von isolierten Modellen hin zu einem fähigen General‑Purpose‑Agenten. Viele Evaluierungen stehen noch aus, doch die ersten Benchmarks sehen vielversprechend aus.
Die interaktive Zusammenarbeit ist ein starkes Feature, ist jedoch vorerst auf die macOS‑Codex‑App beschränkt. Auf API-Zugriff müssen Nutzer ebenfalls noch warten.
Mit Fokus auf Geschwindigkeit und autonome Erstellung verfolgt GPT‑5.3‑Codex einen anderen Ansatz als Claude Opus 4.6 und schlägt es auf Terminal‑Bench 2.0. Die Detailunterschiede sind jedoch noch schwer zu bewerten, da beide Modelle gerade erst erschienen sind. Die Zeit wird zeigen, wie das Gesamtbild aussieht.
Wenn du mehr über Konzepte und Möglichkeiten agentenbasierter Tools erfahren möchtest, empfehlen wir unseren AI Agent Fundamentals-Lernpfad.
Top DataCamp Courses
Kurs
Kurs
Kurs
Blog
Blog
Hesam Sheikh Hassani
15 Min.
Blog
Zoumana Keita
15 Min.
Tutorial
Kurtis Pykes
15 Min.
Tutorial
Derrick Mwiti
10 Min.
Tutorial
Matt Crabtree
5 Min.


