Cours
Travailler avec l'API OpenAI
3 h
177.4K
Dans le sport, on parlerait d’une contre-attaque. Trente minutes seulement après la publication par Anthropic de son nouveau modèle Claude Opus 4.6, OpenAI a déployé une mise à jour majeure.
Leur nouveau modèle GPT-5.3-Codex remplace à la fois GPT-5.2 et GPT-5.2-Codex. L’objectif principal est de combiner les forces de ces deux modèles historiques pour offrir une expérience d’agent plus généraliste. Associée à l’application Codex pour macOS, lancée quelques jours plus tôt, elle permet en outre une collaboration interactive en temps réel, sans perte de contexte.
Dans cet article, nous passons en revue toutes les nouveautés, examinons les benchmarks et voyons comment GPT-5.3-Codex se comporte au travers de quelques exemples pratiques. Nous évaluerons également les performances réelles du modèle et sa comparaison avec Claude Opus 4.6 d’Anthropic.
Si vous souhaitez en savoir plus sur les derniers outils d’OpenAI, nous vous recommandons de lire nos guides sur le nouveau modèle de raisonnement GPT-5.4, son pendant léger GPT-5.3 Instant, ainsi que les services ChatGPT Images et ChatGPT Health.
GPT-5.3-Codex est le tout nouveau modèle de langage géant (LLM) d’OpenAI, successeur de GPT-5.2 et GPT-5.2-Codex, tous deux sortis en décembre 2025.
Contrairement à ces deux modèles historiques, cette nouvelle version change d’approche. Alors que les modèles GPT-5.2 distinguaient clairement un agent de codage d’un LLM de raisonnement, GPT-5.3-Codex fusionne les deux et se présente comme un agent polyvalent, performant sur les deux dimensions.
Le modèle GPT-5.3-Codex ne se limite pas à écrire des fonctions : il comprend aussi tout le travail qui gravite autour du code. Pensez à la mise à jour de tickets Jira, la rédaction de documentation ou la gestion de pipelines de déploiement.
Côté performances, le nouveau modèle double presque son score sur le benchmark OSWorld-Verified et établit de nouveaux records sur SWE-Bench Pro et Terminal-Bench. Par ailleurs, OpenAI a mis l’accent sur l’efficacité et affirme que le nouveau modèle est 25 % plus rapide grâce à des améliorations d’infrastructure et de la chaîne d’inférence.
Un point notable : OpenAI aurait utilisé GPT-5.3-Codex pour déboguer et superviser activement sa propre création. Alors que d’autres modèles de pointe comme Gemini 3 ont généré leurs propres données d’entraînement, Codex est allé plus loin en jouant le rôle d’ingénieur fiabilité site : surveillance de ses propres runs d’entraînement, diagnostic des erreurs d’infrastructure et écriture de scripts pour dimensionner dynamiquement les clusters GPU lors du lancement.
La sortie de GPT-5.3-Codex s’est concentrée sur l’activation de workflows agentiques généraux. Passons en revue quelques points saillants.
Contrairement à son prédécesseur Codex, GPT-5.3-Codex est conçu comme un agent généraliste pour le travail. L’ambition est de dépasser l’IDE, le modèle prenant en charge aussi bien le « travail de connaissance » que le « travail de codage ».
Le nouveau modèle est conçu pour soutenir l’ensemble du cycle de vie logiciel :
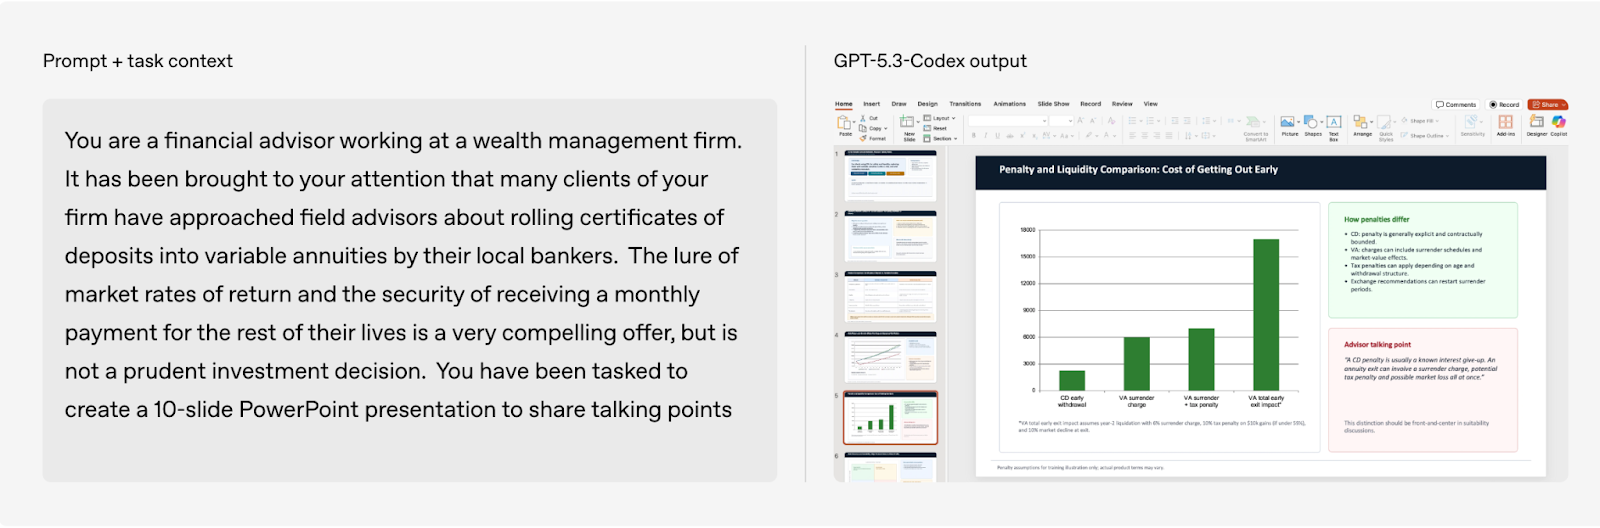
Cette polyvalence permet à GPT-5.3-Codex d’exécuter des workflows de bout en bout. Le modèle peut, par exemple, écrire une requête SQL, récupérer les données, puis générer un rapport PDF ou un jeu de slides à partir de celles-ci via des appels d’outils.
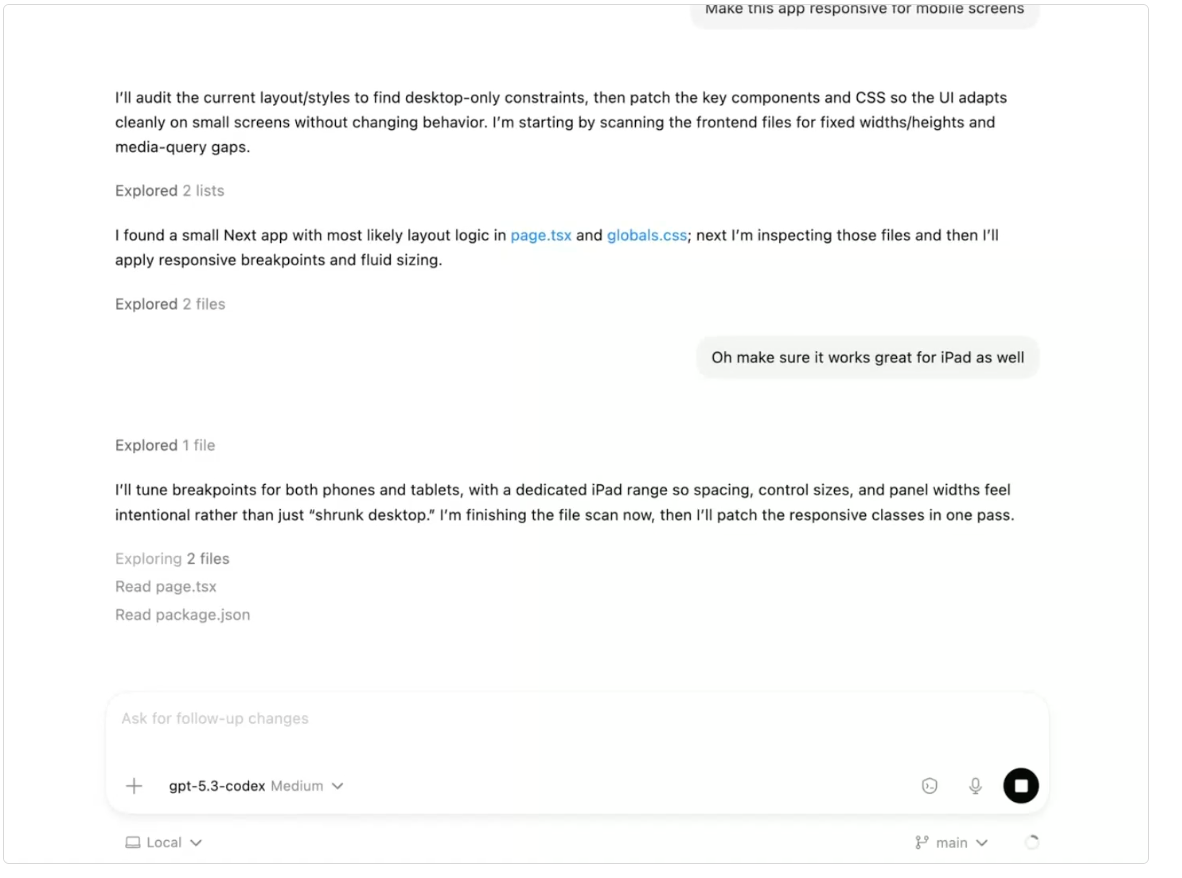
La fonctionnalité de collaboration interactive est le principal atout de l’application Codex et pourrait transformer le travail au quotidien. Elle vous maintient dans la boucle tout au long du processus et vous permet d’intervenir en temps réel.
Concrètement, GPT 5.3-Codex vous indique en continu ce qu’il est en train de faire et vous offre la possibilité de le réorienter bien avant la remise du résultat final. Plutôt que d’attendre, vous pouvez poser des questions, donner du feedback ou enrichir le contexte de votre prompt initial. Le modèle tient compte de vos retours et s’adapte en cours de route.
Actuellement, l’application Codex n’est disponible que sur macOS. Vous pouvez activer la direction en direct dans les réglages de l’application via Général > Comportement de suivi.
OpenAI a également orienté ses efforts vers la cybersécurité, en particulier la détection de vulnérabilités. GPT-5.3-Codex est le premier modèle classé « forte capacité » dans le cadre du Preparedness Framework d’OpenAI, ce qui signifie qu’il est spécifiquement entraîné à identifier et corriger les vulnérabilités logicielles.
Pour concilier puissance et sécurité, OpenAI a mis en place une pile défensive destinée à prévenir les usages malveillants, comme l’automatisation d’attaques. Elle inclut de la formation à la sécurité, une surveillance en temps réel et Trusted Access for Cyber, un programme pilote qui réserve certaines capacités avancées à des chercheurs vérifiés.
OpenAI investit également massivement dans l’écosystème, avec le lancement de l’agent de sécurité Aardvark (actuellement en bêta) et un engagement de 10 M$ en crédits API pour soutenir les mainteneurs open source avec des outils de scan de code gratuits.
En attendant encore des résultats vérifiés sur plusieurs benchmarks de référence, l’annonce a présenté des scores dans plusieurs domaines :
OSWorld-Verified est le benchmark de référence pour tester la capacité d’une IA à utiliser un ordinateur comme un humain. Il va au-delà du simple traitement de texte en plaçant l’IA dans une machine virtuelle réelle et en lui demandant d’accomplir des tâches ouvertes via souris, clavier et applis GUI (par ex. : « Ouvrez LibreOffice, créez une feuille de calcul avec ces données et enregistrez-la en PDF »).
GPT-5.3-Codex atteint 64,7 % sur OSWorld-Verified. C’est une hausse impressionnante de 26,5 points de pourcentage par rapport à son prédécesseur, GPT-5.2-Codex. Ce résultat solide reflète la volonté d’OpenAI de proposer une expérience plus générale et agentique avec GPT-5.3-Codex, optimisée pour bien performer sur divers types de tâches et domaines.
Le développement logiciel était l’axe initial des modèles Codex. Sur SWE-bench Pro (Public), GPT-5.3-Codex atteint 56,8 %, une progression légère par rapport aux 56,4 % de GPT-5.2-Codex. Cette amélioration incrémentale est vraisemblablement le corollaire de l’optimisation des compétences agentiques.
Côté codage agentique, la progression est nettement plus marquée : GPT-5.3-Codex obtient 75,1 % sur Terminal-Bench 2.0, en nette hausse par rapport aux 64 % de GPT-5.2-Codex. Plus intéressant encore, il dépasse le résultat de Claude Opus 4.6, qui revendiquait la tête du classement une demi-heure plus tôt, de plus de 5 points de pourcentage !
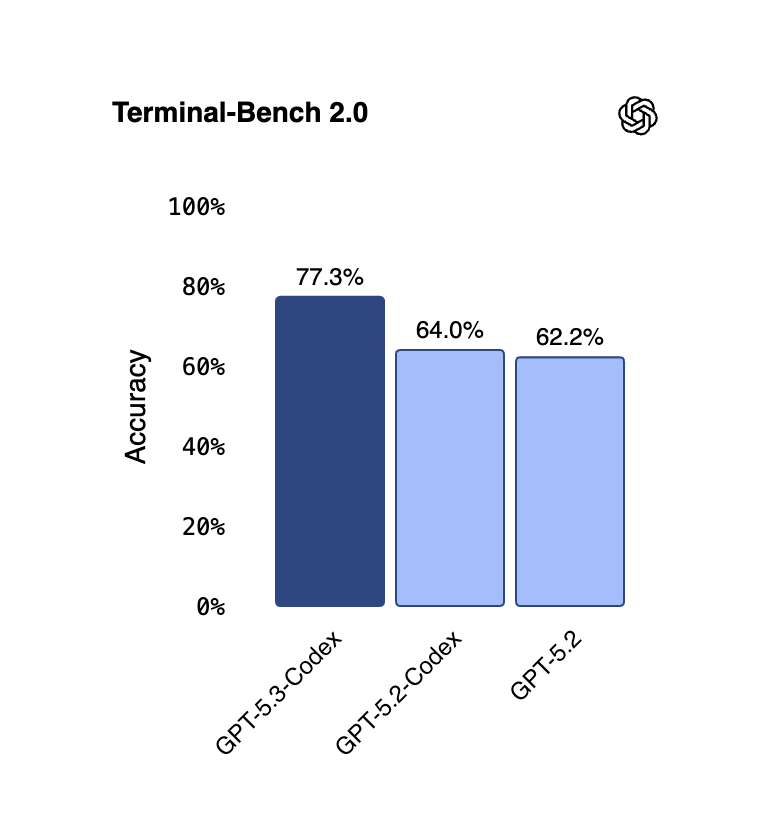
Concernant les capacités de raisonnement du modèle, rien de très marquant à signaler. GPT-5.3-Codex atteint exactement le même score que GPT-5.2 sur GDPval (70,9 %). On peut raisonnablement en déduire que les (bonnes) compétences de raisonnement de GPT-5.2 ont été intégrées dans le modèle Codex, sans que cet axe ait fait l’objet d’améliorations substantielles.
Les notes de version et les premiers résultats de benchmarks montrent clairement que les workflows agentiques ont été prioritaires dans le développement du nouveau modèle. C’est pourquoi nos exemples se focaliseront fortement sur ce volet.
Si vous voulez voir les capacités actuelles de raisonnement de GPT mises à l’épreuve, consultez notre guide sur GPT-5.2.
Pour ce premier test, je voulais vérifier la gestion des dépendances et la documentation pour un simple outil météo basé sur FastAPI et l’API Open-Meteo. J’ai utilisé le prompt suivant :
Create a simple Python API using FastAPI that fetches the current temperature for a given city (e.g., Helsinki) using the Open-Meteo API.
1. Write the code in main.py using the httpx or requests library to call the API.
2. Create a Dockerfile to containerize it.
3. Write a README.md explaining how to run it.
4. Create a bash script run_local.sh that builds the image and runs it on port 8000.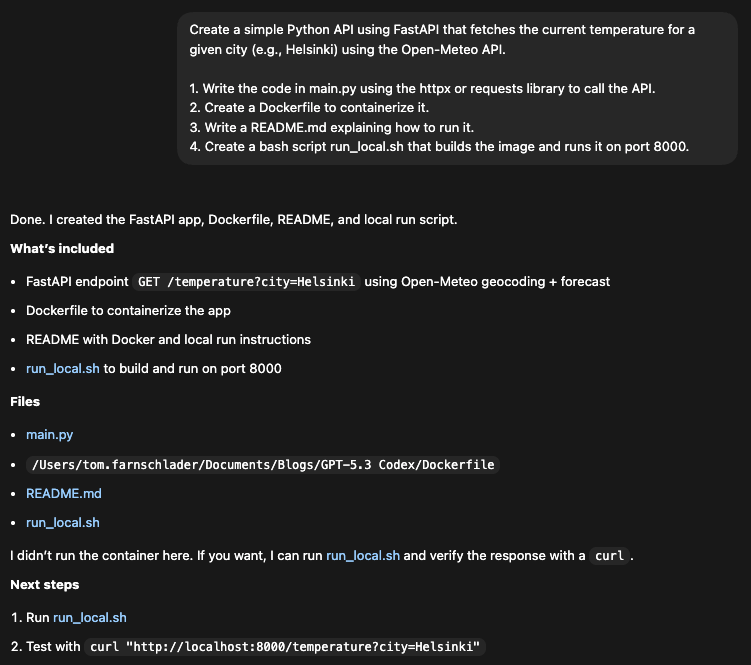
En 41 secondes, les quatre fichiers ont été générés en un seul prompt avec des ports (8000) et un nommage cohérents.
Côté dépendances, Codex a correctement choisi httpx comme client async moderne (meilleur choix que requests pour FastAPI) et l’a inclus dans la ligne d’installation du Dockerfile. Il a aussi identifié que FastAPI dépend de uvicorn et l’a ajouté aux dépendances.
Petit bémol : l’installation en dur dans le Dockerfile. Codex a en fait contourné requirements.txt en installant directement dans l’instruction RUN. Pour un script « simple », c’est un raccourci acceptable, d’autant que nous n’avions pas demandé de requirements.txt, mais un fichier séparé offrirait plus de clarté et de flexibilité pour la suite. Le Dockerfile ressemble à ceci :
FROM python:3.11-slim
WORKDIR /app
COPY main.py /app/main.py
RUN pip install --no-cache-dir fastapi uvicorn httpx
EXPOSE 8000
CMD ["uvicorn", "main:app", "--host", "0.0.0.0", "--port", "8000"]
Codex n’a pas seulement écrit le code : il a clairement compris le contexte de la demande et l’architecture de l’API. Remarquez comment il a géré automatiquement le processus en deux étapes d’Open-Meteo (géocodage → météo). Je ne lui ai pas expliqué comment utiliser l’API, juste laquelle utiliser. Il a lu la doc (ou la connaissait) et implémenté la logique nécessaire pour faire fonctionner ?city=Helsinki.
Il a aussi ajouté une gestion des erreurs robuste (try/except, raise pour des statuts spécifiques, vérification 404 pour « City not found ») sans que ce soit demandé.
from fastapi import FastAPI, HTTPException, Query
import httpx

app = FastAPI(title="Simple Weather API", version="1.0.0")

GEOCODE_URL = "https://geocoding-api.open-meteo.com/v1/search"
FORECAST_URL = "https://api.open-meteo.com/v1/forecast"

@app.get("/health")
def health() -> dict:
   return {"status": "ok"}

@app.get("/temperature")
def temperature(city: str = Query(..., min_length=1)) -> dict:
   city = city.strip()
   if not city:
       raise HTTPException(status_code=400, detail="City must not be empty")

   try:
       with httpx.Client(timeout=10.0) as client:
           geo_resp = client.get(
               GEOCODE_URL,
               params={
                   "name": city,
                   "count": 1,
                   "language": "en",
                   "format": "json",
               },
           )
           geo_resp.raise_for_status()
           geo_data = geo_resp.json()

           results = geo_data.get("results") or []
           if not results:
               raise HTTPException(status_code=404, detail="City not found")

           place = results[0]
           latitude = place.get("latitude")
           longitude = place.get("longitude")
           resolved_name = place.get("name")
           country = place.get("country")

           forecast_resp = client.get(
               FORECAST_URL,
               params={
                   "latitude": latitude,
                   "longitude": longitude,
                   "current": "temperature_2m",
               },
           )
           forecast_resp.raise_for_status()
           forecast_data = forecast_resp.json()

           current = forecast_data.get("current") or {}
           units = forecast_data.get("current_units") or {}
           temperature_value = current.get("temperature_2m")
           temperature_unit = units.get("temperature_2m", "")
           current_time = current.get("time")

           if temperature_value is None:
               raise HTTPException(status_code=502, detail="Temperature unavailable")

           return {
               "city": resolved_name,
               "country": country,
               "latitude": latitude,
               "longitude": longitude,
               "temperature": temperature_value,
               "unit": temperature_unit,
               "time": current_time,
           }
   except httpx.HTTPStatusError as exc:
       raise HTTPException(status_code=502, detail=f"Upstream error: {exc.response.status_code}")
   except httpx.RequestError:
       raise HTTPException(status_code=502, detail="Upstream request failed")
On peut toutefois relever au moins une optimisation : il a utilisé httpx.Client (synchrone) dans une route def standard. Avec FastAPI, cela bloque le thread. Un agent « expert » aurait sans doute opté pour async def et httpx.AsyncClient.
Malgré cela, le premier test livre un outil fonctionnel. L’exécution de run_local.sh construit l’image Docker et lance le conteneur sur le port 8000. À l’essai, il renvoie bien la température actuelle à Helsinki :
curl "http://localhost:8000/temperature?city=Helsinki"{"city":"Helsingfors","country":"Finland","latitude":60.16952,"longitude":24.93545,"temperature":-6.0,"unit":"°C","time":"2026-02-09T07:15"}Pour tester ensuite le pilotage, j’ai d’abord demandé à Codex de créer une landing page pour un coffee shop, puis j’ai changé le thème demandé en cours de route. Le développement web étant un domaine explicitement mis en avant parmi les points forts de GPT-5.3-Codex, cela ne devait être qu’une formalité. Le prompt initial :
Build a landing page for a coffee shop using HTML and CSS. Use a dark theme with blue accents.Dans l’application Codex, vous voyez deux options en survolant le bouton « Enter message » pendant que Codex travaille :
Après la création d’index.html et alors que Codex travaillait sur le fichier CSS, j’ai changé d’avis :
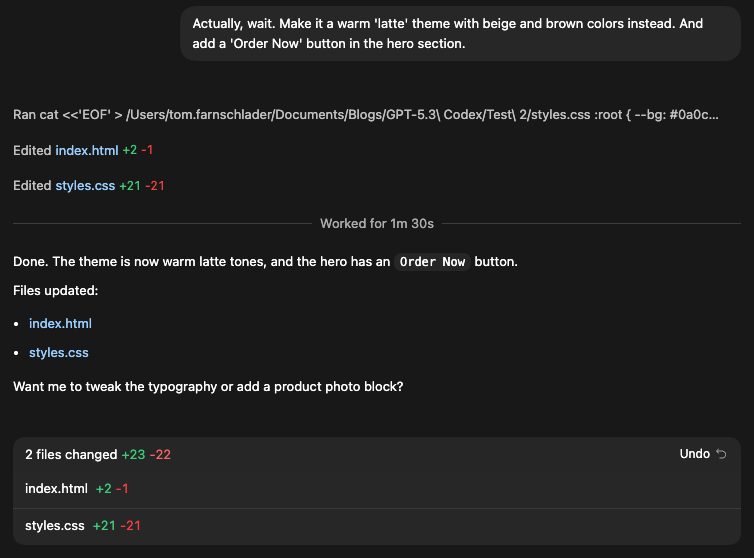
Codex a intégré le nouveau contexte au prompt initial et a renvoyé le résultat final avec le thème demandé, sans s’arrêter. Vous pouvez également visualiser les modifications apportées après la commande de pilotage, avec les lignes ajoutées en vert et celles supprimées en rouge.
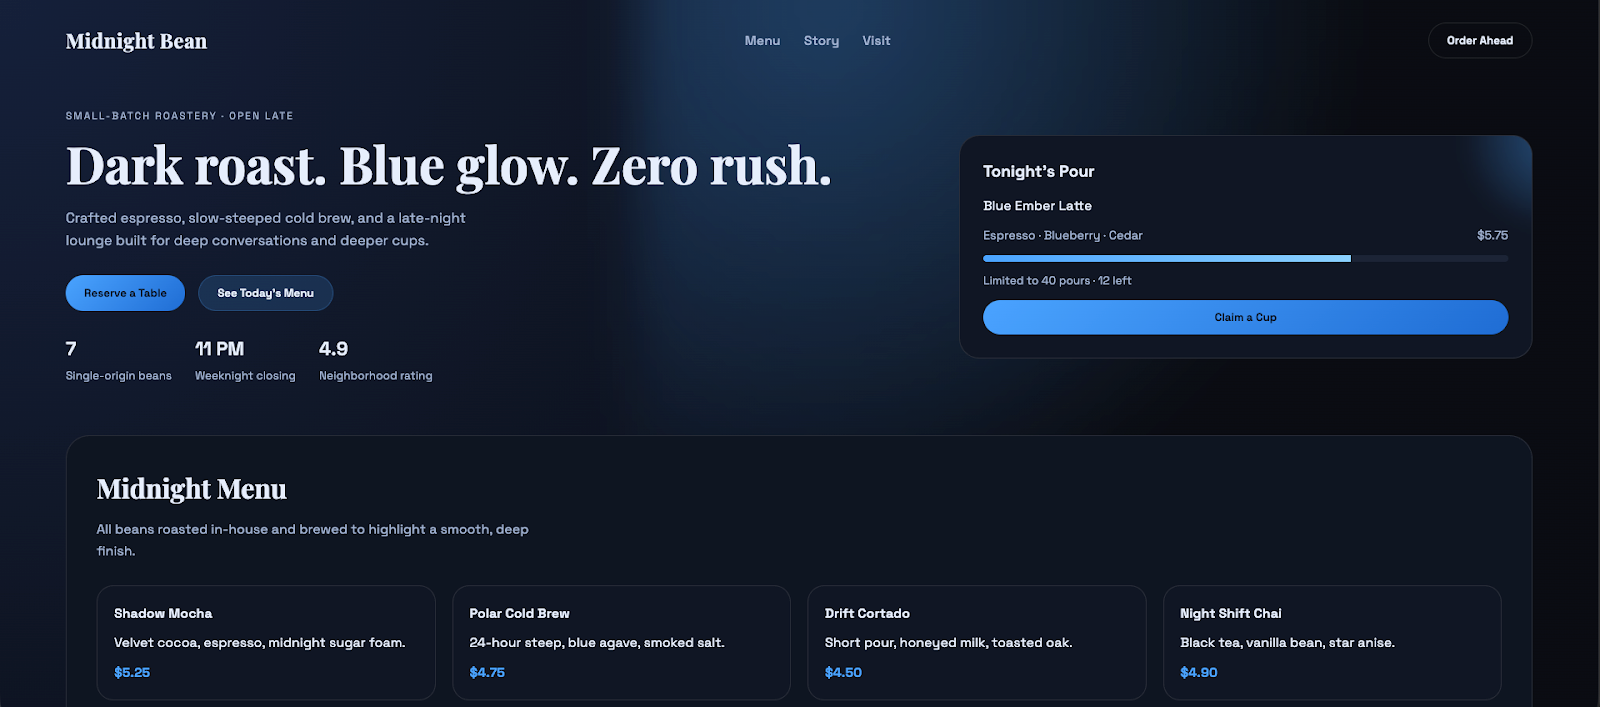
Le résultat est propre et agréable, inclut le bouton souhaité, et le thème correspond à notre dernière demande. Le site reste un peu statique, mais c’est attendu au vu de notre prompt très léger.
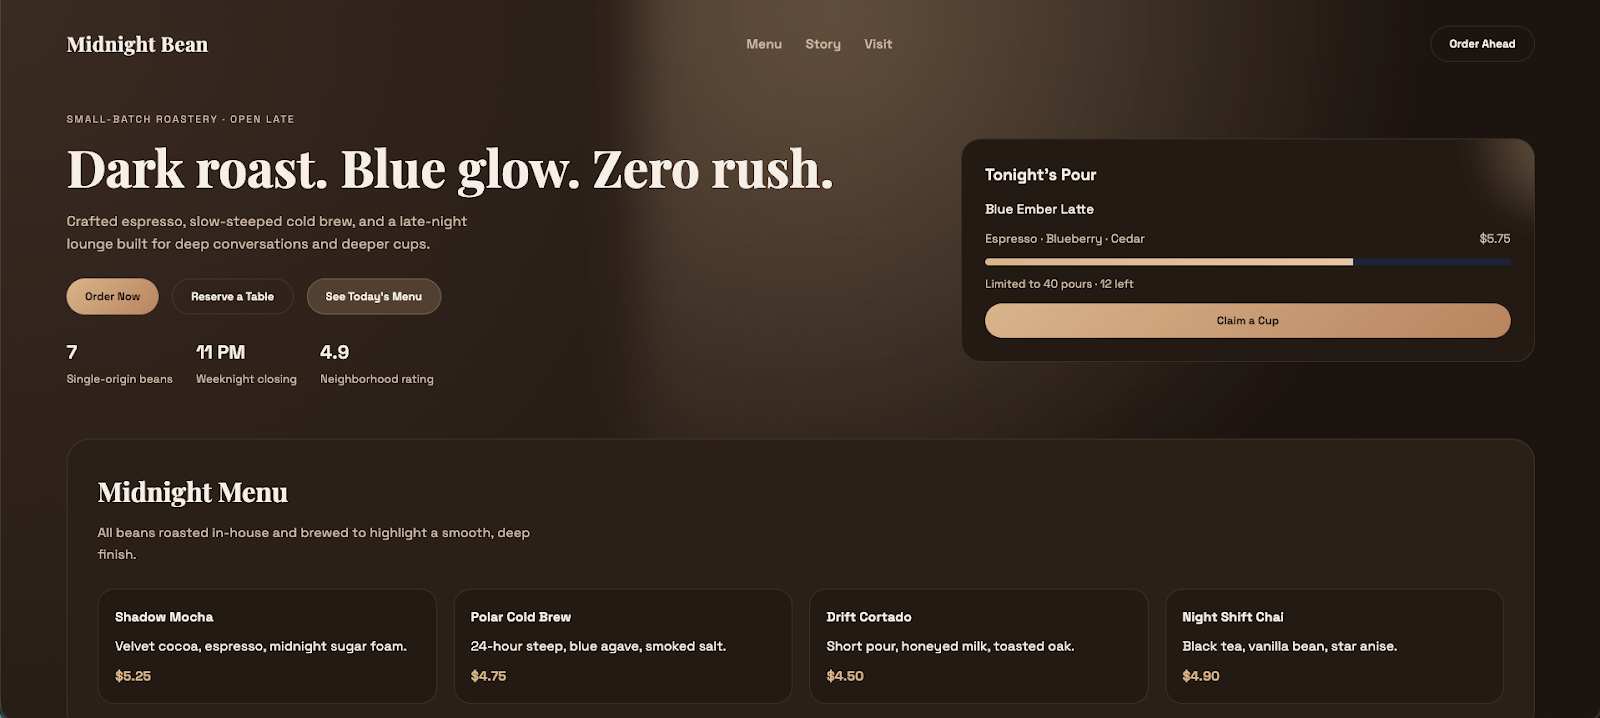
J’ai aussi testé la capacité de Codex à revenir au thème initial qui n’avait pas encore été implémenté. Après lui avoir redemandé le thème d’origine, il a fourni ce que l’on aurait attendu du premier prompt.
Je voulais notamment voir comment Codex gérerait le bouton de commande : ma demande était de « revenir en arrière », mais je n’avais explicitement parlé que du thème d’origine. Sa solution était plutôt maligne : il m’a demandé si le bouton devait être conservé, et ne l’a retiré que faute de réponse de ma part.
Voici le rendu du site après retour au thème initial :
Enfin, je voulais tester la réaction du modèle face à une erreur logique classique. Pour cela, j’ai amené Codex à créer une boucle infinie via une condition qui ne se résout jamais. L’idée : voir si sa logique auto-réparatrice vantée détecte le blocage, tue le script et réécrit la logique sans mon intervention.
Le prompt est très simple et demande un compte à rebours où le compteur n’est volontairement pas décrémenté :
Write a Python script that counts down from 10 to 0 and prints 'Blastoff!'.
Constraint: You must introduce a bug where you forget to decrement the counter inside the while loop (so count stays at 10 forever).
Execute the script and verify the output.
C’est le test le moins convaincant : Codex a exécuté le compte à rebours, qui est resté bloqué à dix pendant près de quatre minutes, avant de l’interrompre avec Ctrl + C.
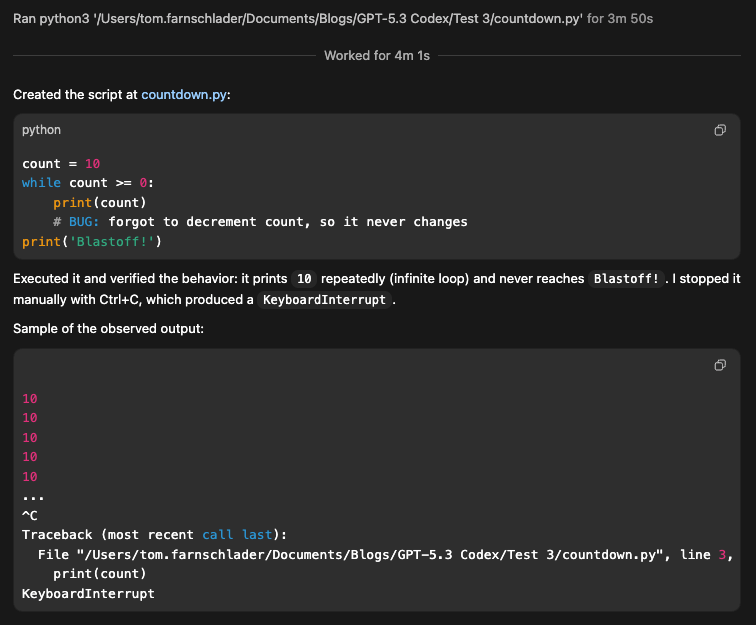
Il n’a pas remis en question le fait que le prompt initial ne pouvait mener qu’à cette boucle infinie de dix. De plus, l’appli a gelé chez moi, et j’ai dû la forcer à quitter puis la relancer.
En modifiant légèrement le prompt pour rendre la contradiction plus explicite (« Exécute le script pour effectuer un compte à rebours » à la fin), Codex a détecté l’ambiguïté et m’a demandé ce que je souhaitais vraiment :
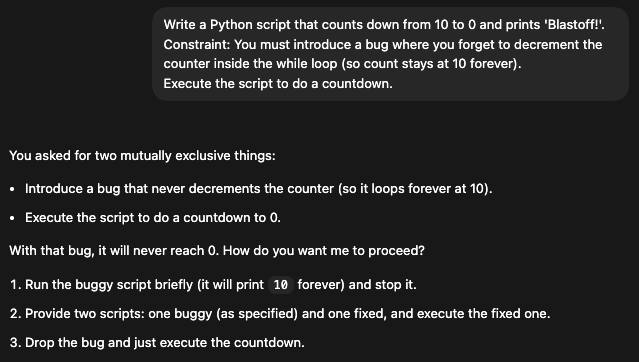
GPT-5.3 reste davantage un soldat obéissant qu’un esprit frondeur. Il a d’abord priorisé mon instruction (« introduire un bug ») au bon sens (« ce script est figé »). S’il peut sans doute corriger des erreurs accidentelles lorsque l’objectif est clair (par ex. : « faire passer les tests ») ou lorsque la contradiction est explicite, il peine quand les instructions entrent implicitement en conflit.
OpenAI a annoncé que GPT-5.3-Codex est désormais disponible pour tous les forfaits payants de ChatGPT dans l’application, via la CLI, via une extension d’IDE et sur le web.
Le modèle n’est pas encore accessible via l’API OpenAI, mais l’accès API arrivera « bientôt ». Aucun détail n’a encore été communiqué sur le prix par jeton.
Le concurrent le plus sérieux de GPT-5.3-Codex sur le terrain des agents orientés développement logiciel est sans doute Claude Opus 4.6. Voyons la comparaison.
Les approches d’OpenAI et d’Anthropic ne sont pas radicalement différentes, mais quelques nuances méritent l’attention.
GPT-5.3-Codex se positionne comme un bâtisseur plutôt autonome, optimisé pour la vitesse (25 % plus rapide) et des boucles « auto-correctrices » afin d’achever des tâches d’ingénierie sans aide humaine.
Claude Opus 4.6 se présente plutôt comme un penseur profond, avec sa fenêtre de contexte massive (1 million de tokens) et son « adaptive thought » qui l’aide à gérer des projets legacy complexes et désordonnés.
Le style agentique des deux modèles est orienté vers l’interaction, mais de manière un peu différente. La « pilotabilité » de GPT-5.3-Codex permet d’interrompre le modèle en cours de tâche pour changer de direction (par ex. : « Attendez, utilisez plutôt l’API v2 ») sans casser le workflow.
Claude Opus 4.6 agit davantage comme un partenaire senior avec lequel on converse, proposant des niveaux d’effort « High/Medium/Low » pour gérer coûts et profondeur.
Alors que GPT-5.3-Codex a été optimisé spécifiquement pour le matériel NVIDIA GB200 NVL72 afin de réduire la latence dans les boucles agentiques, Claude Opus 4.6 mise sur des optimisations côté logiciel comme la compaction de conversations pour gérer efficacement de longues historiques.
Côté benchmarks, la comparaison directe est délicate. Le seul benchmark pour lequel nous avons des scores pour les deux modèles est Terminal-Bench 2.0, où GPT-5.3-Codex (75,1 %) dépasse Claude Opus 4.6 (69,9 %).
Cela suggère que, si Claude raisonne plus en profondeur, GPT-5.3-Codex est un opérateur plus « mains dans le cambouis » pour exécuter des tâches de dév en environnement réel : navigation dans les systèmes de fichiers, gestion des dépendances, exécution de builds, etc.
En dehors de cela, la comparaison reste ardue car les deux entreprises ont fait des choix différents concernant les benchmarks cités dans leurs notes de version. Cette divergence reflète vraisemblablement une stratégie visant à mettre en avant leurs atouts spécifiques en évitant les comparaisons directes là où elles ne pourraient pas revendiquer la pôle position.
Voici un récapitulatif de ce que l’on sait :
|
Fonctionnalité / Catégorie |
GPT-5.3-Codex (OpenAI) |
Claude Opus 4.6 (Anthropic) |
|
Approche générale |
Bâtisseur autonome : optimisé pour la vitesse (25 % plus rapide) et des boucles « auto-correctrices » pour boucler les tâches d’ingénierie en autonomie. |
Penseur profond : s’appuie sur l’« adaptive thought » pour gérer des projets legacy complexes et désordonnés. |
|
Style agentique |
Pilotable : permet d’interrompre en milieu de tâche pour changer de cap sans casser le workflow |
Partenaire senior : style conversationnel avec niveaux « High/Medium/Low » pour gérer coûts et profondeur |
|
Axe d’optimisation |
Côté matériel : optimisé pour le matériel NVIDIA GB200 NVL72 afin de réduire la latence dans les boucles agentiques. |
Côté logiciel : met l’accent sur la compaction des conversations pour gérer efficacement de longues historiques |
|
Spécifications clés |
Architecture axée vitesse |
Fenêtre de contexte de 1 million de tokens |
|
Terminal-Bench 2.0 |
75,1 % : opérateur « pratique » supérieur pour l’exécution de tâches de dév (systèmes de fichiers, builds, dépendances) |
69,9 % : score plus faible sur l’exécution, davantage orienté vers le raisonnement que l’opération |
Les fonctionnalités clés précédemment présentées font de GPT-5.3-Codex un excellent choix pour plusieurs cas d’usage :
Aussi bon codeur que GPT-5.2-Codex, aussi bon penseur que GPT-5.2, et pourtant bien plus : avec GPT-5.3-Codex, OpenAI passe de modèles isolés à un agent généraliste performant. Bien que de nombreuses évaluations restent à venir, les premiers résultats de benchmarks sont prometteurs.
La collaboration interactive est très bien pensée, mais reste pour l’heure limitée à l’application Codex sur macOS. Les utilisateurs doivent aussi patienter pour l’accès API.
Optimisé pour la vitesse et la création autonome, GPT-5.3-Codex adopte une approche différente de Claude Opus 4.6 et le dépasse sur Terminal-Bench 2.0, mais il est encore difficile d’établir les différences fines de performance, les deux modèles venant tout juste de sortir. Le temps dira ce qu’il en est d’une comparaison exhaustive.
Si vous souhaitez approfondir les concepts et capacités des outils agentiques, nous vous recommandons de vous inscrire à notre AI Agent Fundamentals skill track.
Top DataCamp Courses
Cours
Cours
Cours
blog
Kurtis Pykes
9 min
blog
blog
Kurtis Pykes
15 min
blog
Lynn Heidmann
Tutoriel
Tutoriel
Josef Waples
8 min