

Cursus
MLOps-concepten
2 uur
46.3K
Oefen en volg je voortgang.
Ga Verder Met GoogleMachine Learning Operations (MLOps) is uitgegroeid tot een van de meest gewilde vakgebieden in tech. Nu datateams steeds vaker machinelearningmodellen in productieomgevingen inzetten, blijft de vraag naar MLOps-professionals groeien.
Wil je aan de slag als MLOps-engineer? Wij helpen je die stap te zetten!
In dit artikel vind je de belangrijkste MLOps-sollicitatievragen, met uitgebreide uitleg en antwoorden, zodat je je effectief kunt voorbereiden op je komende gesprek.
MLOps, kort voor Machine Learning Operations, is een discipline die machine learning combineert met DevOps-praktijken om de levenscyclus van machinelearningmodellen te stroomlijnen en te automatiseren.
Het primaire doel van MLOps is de kloof te overbruggen tussen data science en IT-operations, zodat machinelearningmodellen effectief worden ontwikkeld, uitgerold, bewaakt en efficiënt onderhouden in productieomgevingen.
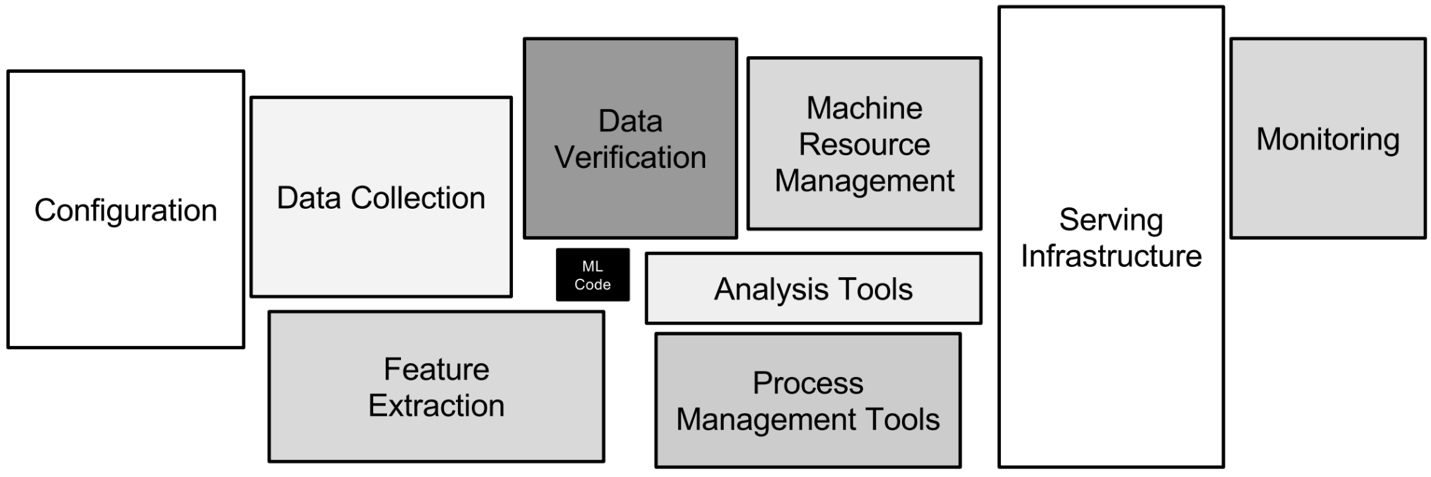
De verschillende technische aspecten binnen MLOps. Afbeelding door auteur
Deze rol is belangrijk omdat ze datateams in staat stelt om machinelearningmodellen in productieomgevingen te deployen en er tegelijkertijd voor te zorgen dat ze schaalbaar en goed te onderhouden zijn. In wezen versnelt MLOps innovatie, verhoogt het de operationele efficiëntie en helpt het bedrijven het volle potentieel van hun datagedreven initiatieven te benutten.
De vereiste vaardigheden in MLOps zijn:
Ja, een MLOps-engineer is net een eenhoorn! En precies daarom zijn ze zo gewild en stijgen hun salarissen gestaag.
In deze sectie behandelen we fundamentele MLOps-sollicitatievragen die je begrip van kernconcepten en -principes toetsen. Deze vragen zijn bedoeld om je kennis van de basisverantwoordelijkheden en uitdagingen van MLOps te testen en je vermogen om je kennis effectief over te brengen.
Maak je deze vragen eigen om een sterke basis te leggen ter voorbereiding op meer gevorderde onderwerpen en om je deskundigheid in het vakgebied te tonen.
Beschrijving: Deze vraag test je begrip van de fundamentele verschillen tussen MLOps en DevOps, die vaak door elkaar worden gehaald.
Antwoord: MLOps en DevOps zijn allebei samenwerkingsgerichte strategieën, maar dienen verschillende doelen. DevOps richt zich op het automatiseren van softwareontwikkeling, testen en uitrol, en het standaardiseren van omgevingen om deze processen te stroomlijnen.
MLOps daarentegen is toegespitst op machinelearningworkflows, met nadruk op het beheren en onderhouden van datapijplijnen en modellen. Waar DevOps routinetaken automatiseert en applicatie-uitrol standaardiseert, richt MLOps zich op het experimentele karakter van machine learning, inclusief taken als datavalidatie, evaluatie van modelkwaliteit en doorlopende modelvalidatie.
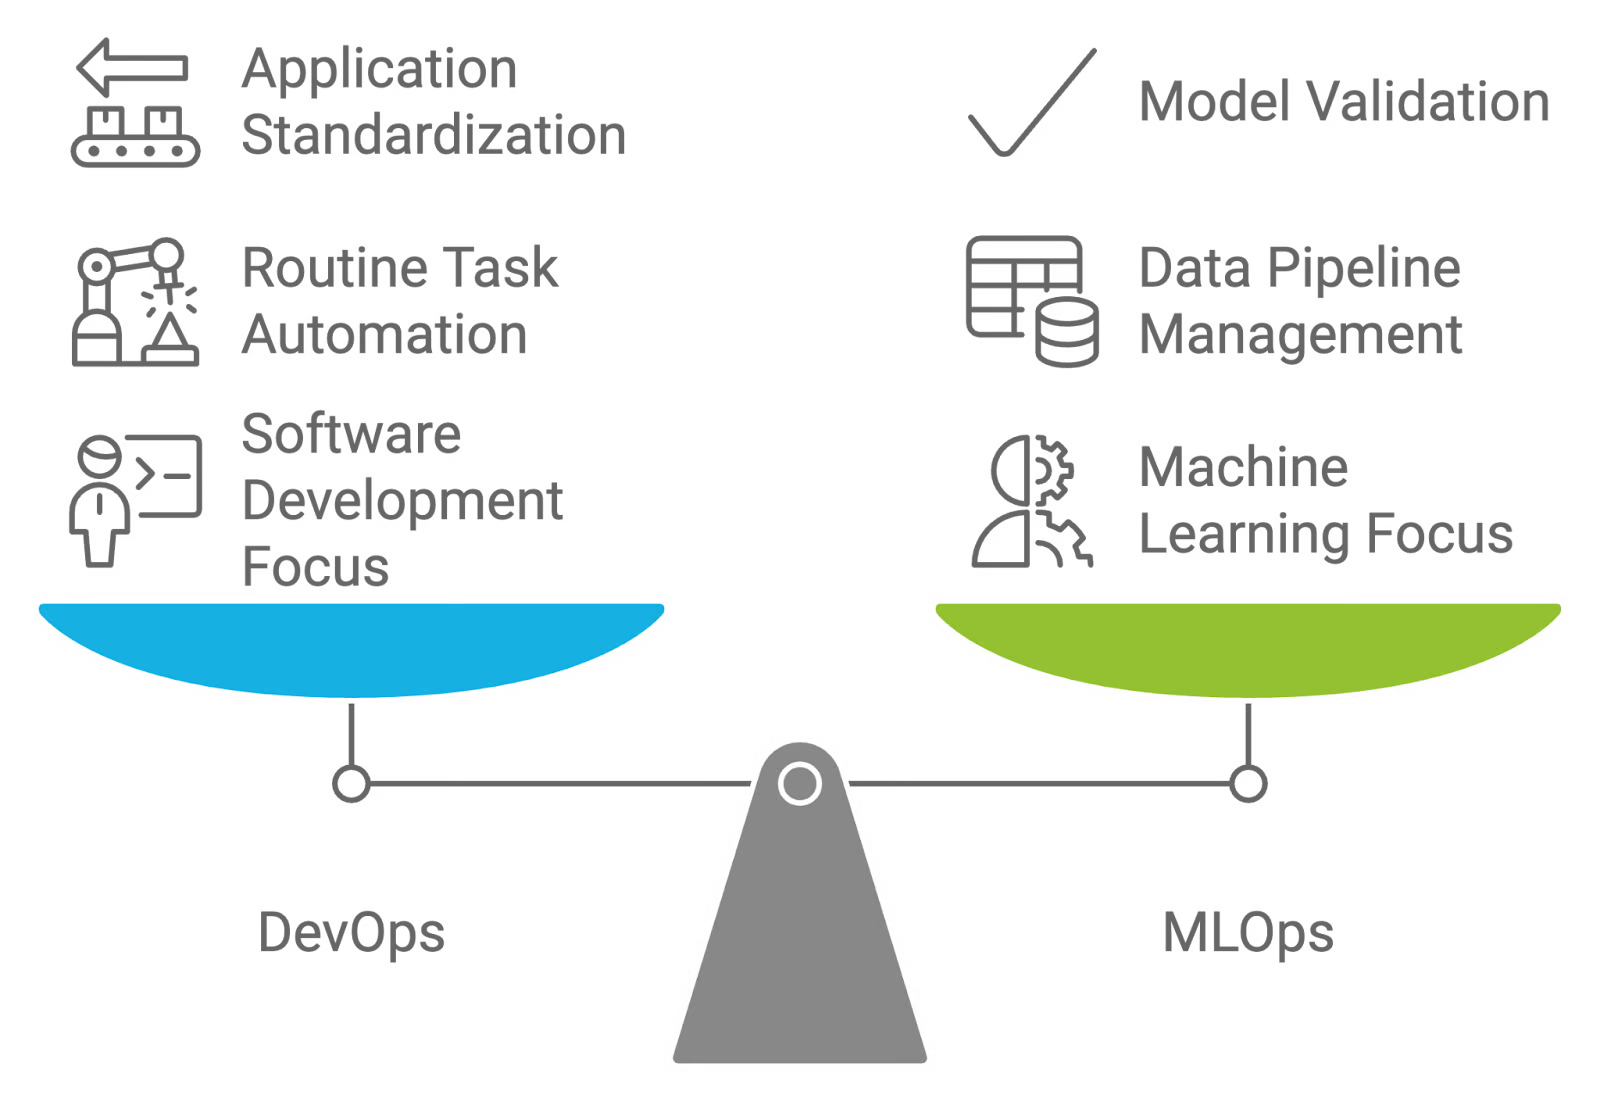
DevOps versus MLOps vergeleken. Afbeelding door auteur gemaakt met napkin.ai
Beschrijving: Deze vraag beoordeelt je kennis van de impact van veranderende data op modelnauwkeurigheid en het belang van het monitoren en updaten van modellen.
Antwoord: Modeldrift en conceptdrift verwijzen naar veranderingen in de prestaties van machinelearningmodellen in de tijd door evoluerende patronen en onderliggende relaties in data:
Beschrijving: Deze vraag onderzoekt je kennis van testpraktijken om te waarborgen dat een machinelearningmodel betrouwbaar is en goed presteert voordat het in een productieomgeving wordt uitgerold.
Antwoord: Er zijn verschillende tests die moeten worden uitgevoerd voordat je een ML-model in productie zet. Deze tabel geeft een volledig overzicht van elk testtype, inclusief de doelstellingen, gebruikte tools en wanneer het moet worden toegepast tijdens de machinelearning-ontwikkelcyclus:
|
Testtype |
Doel |
Gebruikte tools |
Wanneer te gebruiken |
|
Unittesten |
Controleer afzonderlijke modelcomponenten, zoals preprocessingstappen en functie-extractiefuncties. |
PyTest, unittest, scikit-learn (voor transformaties) |
Tijdens ontwikkeling, bij implementatie of update van modelcomponenten. |
|
Integratietesten |
Zorg dat het model correct samenwerkt met andere systeemonderdelen en databronnen in de productieomgeving. |
Docker, Kubernetes, Jenkins, Apache Kafka |
Na unittesten, bij uitrol van het model naar een productie-achtige omgeving. |
|
Performancetesten |
Evalueer de nauwkeurigheid, precisie, recall en andere relevante metrics van het model met een validatieset. |
Scikit-learn, TensorFlow, PyTorch, MLflow |
Na integratietesten, om te waarborgen dat het model aan de verwachte prestatienormen voldoet. |
|
Stresstesten |
Beoordeel hoe het model omgaat met hoge loads en grote datavolumes, en waarborg schaalbaarheid. |
Apache JMeter, Locust, Dask |
Voor uitrol in omgevingen met hoog datavolume of wanneer schaalbaarheid een aandachtspunt is. |
|
A/B-testen |
Vergelijk de prestaties van het model met bestaande modellen of baselines in een live-omgeving. |
Optimizely, SciPy, Google Optimize |
Na uitrol, bij het valideren van modelprestaties in productie en het optimaliseren van modelversies. |
|
Robuustheidstesten |
Zorg dat het model bestand is tegen data-anomalieën en randgevallen. |
Libraries voor adversarial robustness (bijv. CleverHans), custom scripts |
Na performancetesten, om betrouwbaarheid onder abnormale of onverwachte omstandigheden te bevestigen. |
Beschrijving: Deze vraag beoordeelt je begrip van de rol en betekenis van versiebeheer in MLOps-praktijken. De focus ligt op hoe het beheren van verschillende versies van modellen, data en code bijdraagt aan effectieve uitrol en onderhoud.
Antwoord: Versiebeheer is cruciaal in MLOps omdat het helpt veranderingen aan modellen, datasets en code gedurende hun levenscyclus te beheren en te volgen. Met versiebeheersystemen zoals Git voor code en tools zoals DVC (Data Version Control) voor datasets en modellen wordt gewaarborgd dat alle wijzigingen gedocumenteerd en omkeerbaar zijn.
Deze werkwijze ondersteunt reproduceerbaarheid, vergemakkelijkt samenwerking binnen teams en maakt het eenvoudig om bij problemen terug te draaien naar eerdere versies. Het waarborgt consistentie en betrouwbaarheid in modelprestaties, wat belangrijk is voor hoogwaardige deployments.
Wil je meer leren over dit concept? Lees dan The Complete Guide to Data Version Control (DVC). Dat bereidt je voor op dit soort vragen tijdens je gesprek!
Beschrijving: Deze vraag is bedoeld om je kennis te toetsen van verschillende methoden om machinelearningmodellen te verpakken voor deployment. Het test je begrip van hoe je modellen voorbereidt voor integratie in uiteenlopende omgevingen en applicaties.
Antwoord: Er zijn verschillende effectieve manieren om machinelearningmodellen te verpakken:
Een goede manier om meer te leren over het verpakken van modellen is vertrouwd raken met containerisatie. Docker is een basistool die elke MLOps-engineer zou moeten kennen. Wil je je kennis opfrissen? Bekijk dan de cursus Introduction to Docker.
Beschrijving: Deze vraag toetst je kennis van het monitoren van modellen in productie en inzicht in welke metrics cruciaal zijn om doorlopende prestaties en betrouwbaarheid te waarborgen.
Antwoord: Monitoring is essentieel in MLOps om te zorgen dat modellen in productie blijven presteren zoals verwacht. Te volgen metrics zijn onder meer accuracy, precision, recall en andere prestatie-indicatoren om degradatie te detecteren.
Ook monitoring van datadrift is cruciaal, omdat veranderingen in dataptronenen de voorspellingen van het model kunnen beïnvloeden. Daarnaast helpen infrastructuurmetrics zoals latency en resourcegebruik (bijv. CPU, geheugen) om de schaalbaarheid en responsiviteit van het systeem te waarborgen.
Beschrijving: Deze vraag beoordeelt je begrip van mogelijke obstakels en hoe je die aanpakt om succesvolle deployment te waarborgen.
Antwoord: Veelvoorkomende problemen bij deployment van ML-modellen zijn:
Werkgevers zoeken probleemoplossers, zeker als het om data gaat in een rol als MLOps. Wil je bijblijven met twee heel belangrijke onderwerpen in het ML-tijdperk? Bekijk dan de cursussen Introduction to Data Quality en Introduction to Data Security.
Beschrijving: Deze vraag test je vermogen om Canary- en Blue-Green-methoden te onderscheiden en hun voordelen bij het uitrollen van nieuwe changes.
Antwoord: Canary- en Blue-Green-deploymentstrategieën worden beide gebruikt om updates uit te rollen, maar verschillen in aanpak:
Beide strategieën verlagen uitrolrisico’s en downtime, maar Canary richt zich op incrementele releases en geleidelijke blootstelling, terwijl Blue-Green een naadloze switch tussen omgevingen bewerkstelligt.
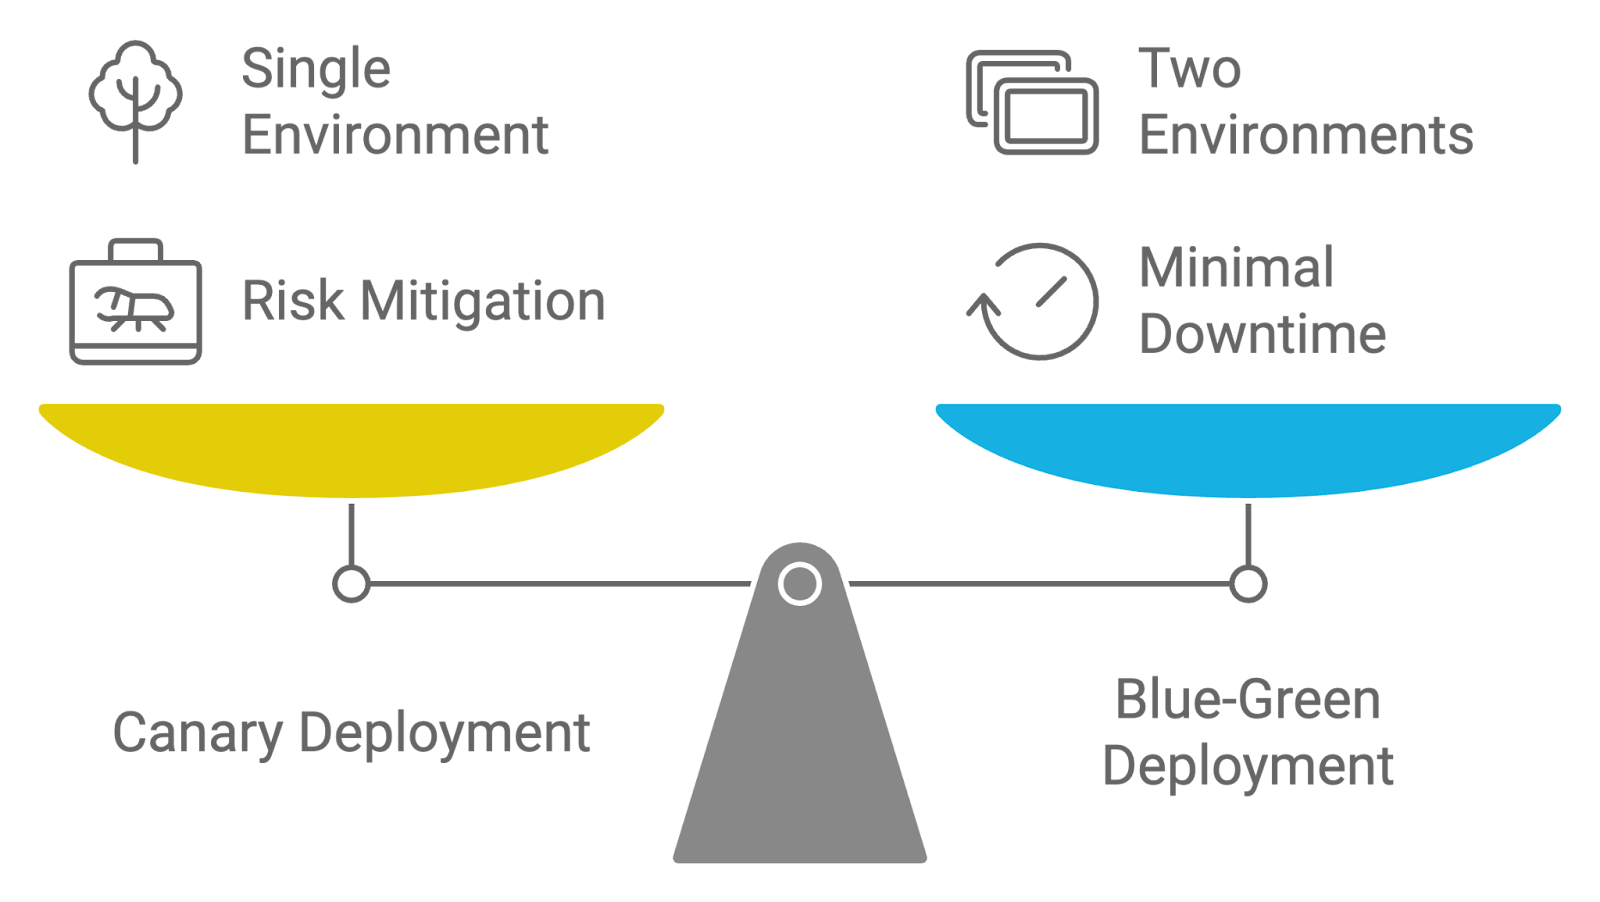
Deploymentstrategieën vergeleken: Canary versus Blue-Green. Afbeelding door auteur gemaakt met napkin.ai
Beschrijving: Deze vraag test je kennis van strategieën en tools om hertraining te automatiseren wanneer nieuwe data beschikbaar komt.
Antwoord: Het automatiseren van hertraining in MLOps houdt in dat je een pijplijn opzet die hertraining triggert als aan bepaalde voorwaarden is voldaan, zoals prestatieafname of de beschikbaarheid van nieuwe data.
Tools zoals Airflow of Kubeflow kunnen deze workflows orkestreren en taken automatiseren zoals data-inname, feature engineering, modeltraining en evaluatie. Doorlopende monitoring is essentieel om te waarborgen dat het model aan prestatiedrempels voldoet vóór deployment, en versiebeheertools zoals DVC helpen verschillende modelversies tijdens hertraining te volgen.
In deze sectie gaan we in op technische MLOps-vragen die je praktische vaardigheden en begrip van gevorderde concepten toetsen.
Deze vragen richten zich op de technische aspecten van het deployen, beheren en optimaliseren van machinelearningmodellen, en beoordelen je vaardigheid met tools, technieken en best practices in het vakgebied.
Beschrijving: Deze vraag test je kennis van het opzetten van CI/CD-pijplijnen specifiek voor ML-workflows. Het beoordeelt je vermogen om het uitrolproces te automatiseren en modelupdates efficiënt te beheren.
Antwoord: Het implementeren van CI/CD voor ML-modellen houdt in dat je pijplijnen opzet die het proces van codewijzigingen tot deployment automatiseren.
Je kunt bijvoorbeeld Jenkins of GitHub Actions gebruiken om builds en tests te triggeren zodra er wijzigingen zijn in modelcode of data. De pijplijn bevat fasen zoals:
Door deze fasen te automatiseren zorg je ervoor dat modellen consequent en betrouwbaar worden bijgewerkt met minimale handmatige interventie.
Wil je je CI/CD-kennis verbeteren? Volg dan de cursus CI/CD for Machine Learning. Daarmee steel je de show tijdens je sollicitatie!
Beschrijving: Deze vraag richt zich op je begrip van effectief databeheer binnen MLOps. Ze beoordeelt je vermogen om datakwaliteit, versiebeheer en organisatie te borgen voor robuuste en betrouwbare ML-workflows.
Antwoord: Best practices voor databeheer in MLOps zijn onder meer:
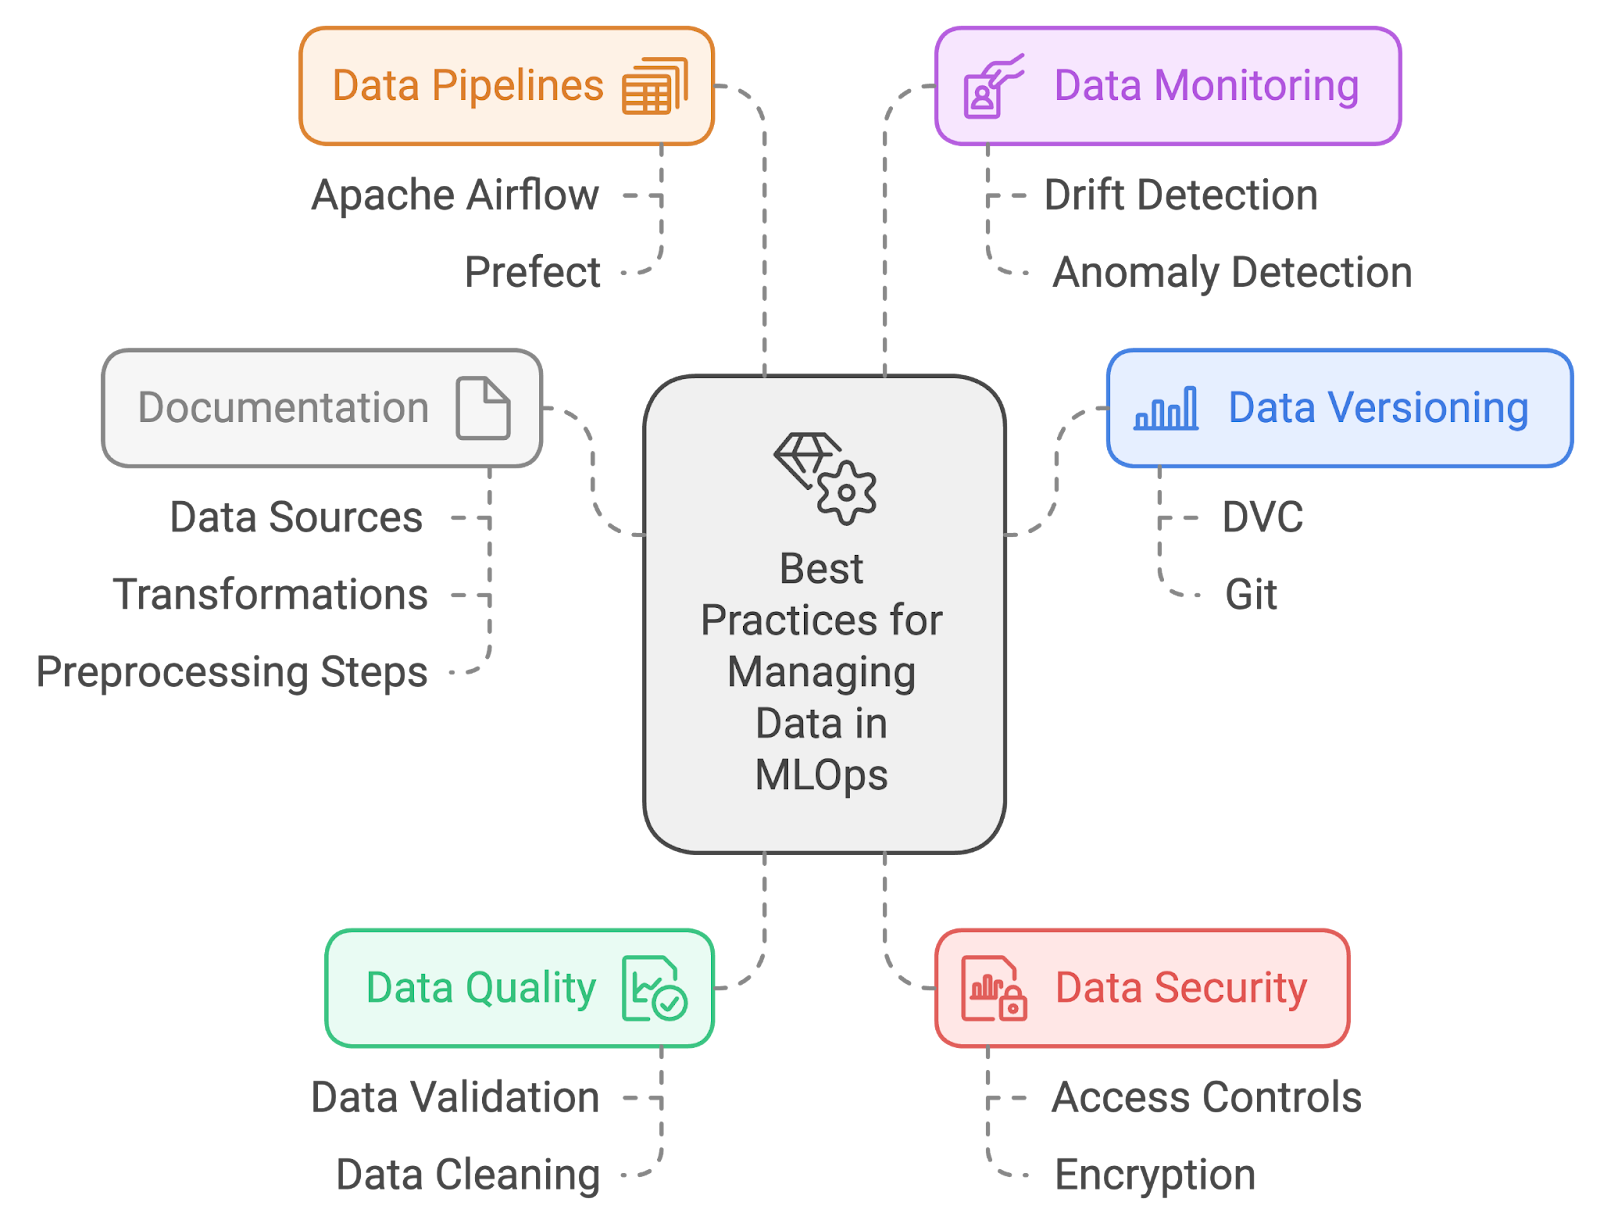
Best practices voor databeheer. Afbeelding door auteur gemaakt met napkin.ai
Beschrijving: Deze vraag beoordeelt hoe je deze processen integreert in geautomatiseerde workflows.
Antwoord: Feature engineering en preprocessing in een MLOps-pijplijn pak je aan door deze stappen te automatiseren voor consistentie en reproduceerbaarheid. Gebruik tools zoals Apache Airflow of Prefect om datapijplijnen te maken die taken uitvoeren zoals:
Beschrijving: Deze vraag beoordeelt je begrip van het volgen en waarborgen van doorlopende prestaties en betrouwbaarheid van het model, inclusief de tools en strategieën die je voor effectieve monitoring gebruikt.
Antwoord: Modelmonitoring in productie omvat verschillende praktijken om te garanderen dat het model presteert zoals verwacht en betrouwbaar blijft in de tijd:
De cursus Machine Learning Monitoring helpt je om dit soort vragen nog gedetailleerder te kunnen beantwoorden!
Beschrijving: Deze vraag onderzoekt je aanpak om te waarborgen dat ML-experimenten consistent kunnen worden gerepliceerd. Ze toetst je begrip van praktijken die reproduceerbaarheid ondersteunen.
Antwoord: Het waarborgen van reproduceerbaarheid omvat:
Beschrijving: Deze vraag beoordeelt je begrip van de unieke uitdagingen om ML-modellen van ontwikkeling naar productie te brengen.
Antwoord: Het operationaliseren van ML-modellen kent verschillende uitdagingen. Een van de grootste is het waarborgen van consistentie tussen ontwikkel- en productieomgevingen, wat problemen in reproduceerbaarheid kan geven.
Datadrift is een andere zorg, omdat data in productie over tijd kan veranderen, waardoor de nauwkeurigheid afneemt.
Bovendien zijn het integreren van modellen in bestaande systemen, het monitoren van prestaties en het automatiseren van hertraining vaak complexe taken die effectieve samenwerking tussen data science en engineering vereisen.
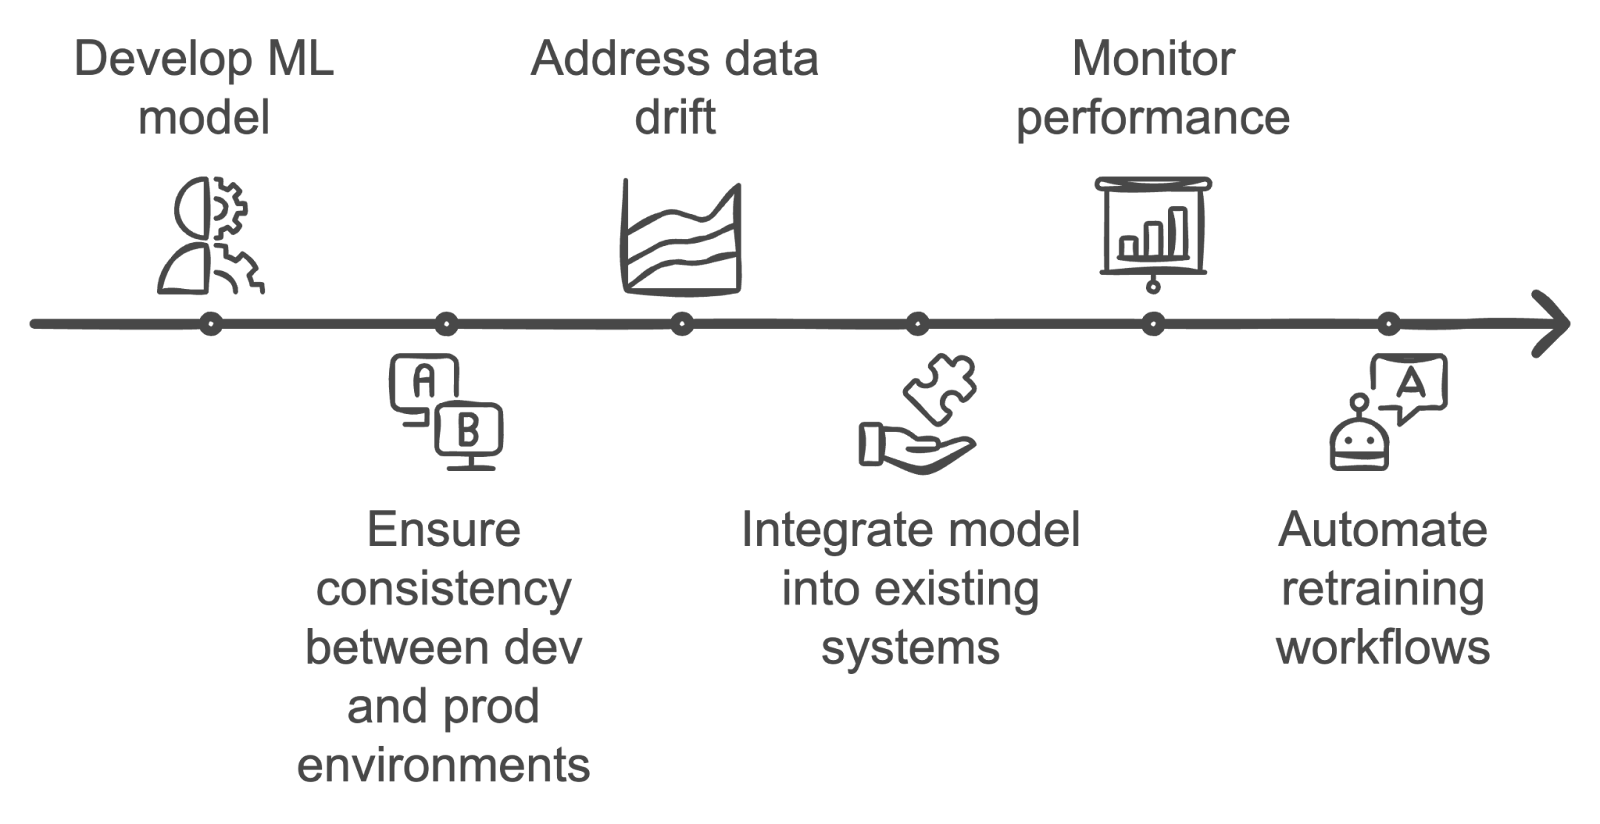
Uitdagingen bij het operationaliseren van ML-modellen overwinnen. Afbeelding door auteur gemaakt met napkin.ai
Beschrijving: Deze vraag beoordeelt je begrip van het automatiseren van hertraining wanneer nieuwe data beschikbaar is of de prestaties afnemen.
Antwoord: Geautomatiseerde hertraining houdt in dat je een pijplijn opzet die modelprestaties en datadrift monitort. Als de nauwkeurigheid onder een drempel zakt of nieuwe data beschikbaar komt, kunnen tools zoals Apache Airflow of Kubeflow hertraining triggeren.
Hertraining omvat het ophalen van nieuwe data, preprocessing, het (opnieuw) trainen van het model met dezelfde of bijgewerkte hyperparameters, en het valideren van het nieuwe model. Na hertraining wordt het bijgewerkte model automatisch naar productie gedeployed.
Beschrijving: Deze vraag test je kennis van modelinterpretatie en hoe je transparantie in voorspellingen waarborgt.
Antwoord: Tools zoals SHAP (SHapley Additive exPlanations) en LIME (Local Interpretable Model-agnostic Explanations) worden veel gebruikt voor uitlegbaarheid.
Deze tools helpen voorspellingen te duiden door de bijdrage van individuele features te tonen. Uitlegbaarheid is cruciaal in MLOps omdat het vertrouwen bij stakeholders vergroot en zorgt voor naleving van regelgeving, vooral in sectoren als financiën en zorg. Het helpt ook mogelijke bias of dataproblemen in het model te identificeren.
Deze sectie behandelt vragen over cloud- en infrastructuuraspecten van MLOps. Ze beoordelen je expertise in het deployen, beheren en schalen van ML-modellen in cloudomgevingen.
Beschrijving: Deze vraag onderzoekt je kennis van het deployen van ML-modellen in een cloudomgeving. Ze beoordeelt je begrip van cloudplatforms, uitrolprocessen en tools voor modelbeheer in de cloud.
Antwoord: Het deployen van ML-modellen in de cloud omvat de volgende stappen:
Beschrijving: Deze vraag verkent je begrip van serverless computing en de toepassing ervan bij ML-deployment, en beoordeelt je vermogen om voordelen tegenover uitdagingen af te wegen.
Antwoord: Serverless architecturen bieden diverse voordelen, zoals minder operationele overhead doordat je geen servers hoeft te beheren, en automatische schaalbaarheid op basis van realtime vraag, wat kosten kan besparen omdat je betaalt voor daadwerkelijk verbruik.
Er zijn echter ook uitdagingen. Zo zijn er limieten qua executietijd en resources die niet altijd geschikt zijn voor alle typen ML-modellen, zeker niet voor modellen met hoge rekenbehoefte.
Cold-startlatency kan ook een probleem zijn: eerste requests na een periode van inactiviteit kunnen vertraging oplopen. Ondanks deze uitdagingen kan serverless zeer effectief zijn voor bepaalde workloads, mits deze factoren goed worden beheerd.
Een andere manier om dit te bekijken is met deze tabel die de voor- en nadelen van serverless samenvat per aspect:
|
Aspect |
Serverless: pro’s |
Serverless: con’s |
|
Operationele overhead |
Geen serverbeheer nodig; minder infrastructuurcomplexiteit. |
Kennis van cloudplatforms vereist om serverless omgevingen te beheren. |
|
Schaalbaarheid |
Automatische schaalbaarheid op basis van realtime vraag, kosten-efficiënt. |
Kan onvoorspelbaar zijn voor budgettering bij frequente schaalacties. |
|
Kosten-efficiëntie |
Je betaalt alleen voor gebruikte resources, wat kosten kan verlagen. |
Kan duur worden bij veelvuldige of langdurige functie-aanroepen. |
|
Executielimieten |
Geschikt voor lichte of kortdurende taken. |
Beperkt door executietijd en resources; minder geschikt voor rekenintensieve ML-modellen. |
|
Cold start |
Verlaagt overhead door on-demand schalen. |
Cold-startvertragingen kunnen optreden en latencygevoelige apps beïnvloeden. |
|
Geschiktheid voor ML-modellen |
Werkt goed voor kleinschalige ML-taken, inferentie of batchverwerking. |
Niet geschikt voor langlopende, rekenintensieve ML-modellen. |
Beschrijving: Deze vraag beoordeelt je strategieën om compute-resources tijdens ML-training in de cloud te optimaliseren en beheren. Ze evalueert je vermogen om cloudresources efficiënt te gebruiken.
Antwoord: Het beheren van compute-resources omvat:
Beschrijving: Deze vraag onderzoekt je aanpak om databeveiliging en compliance te borgen tijdens ML-deployment in de cloud, met focus op best practices en regelgeving.
Antwoord: Databeveiliging en compliance waarborgen omvat:
Beveiliging en compliance zijn misschien niet het eerste waar een engineer aan denkt, maar ze worden steeds belangrijker. De cursus Understanding GDPR, samen met de andere suggesties in dit artikel, helpt je om snel bij te spijkeren.
Beschrijving: Deze vraag verkent strategieën om cloudkosten voor ML-training en -deployment te beheren en optimaliseren, en beoordeelt je kennis van kostenbeheertechnieken.
Antwoord: Strategieën voor kostenbeheer zijn onder meer:
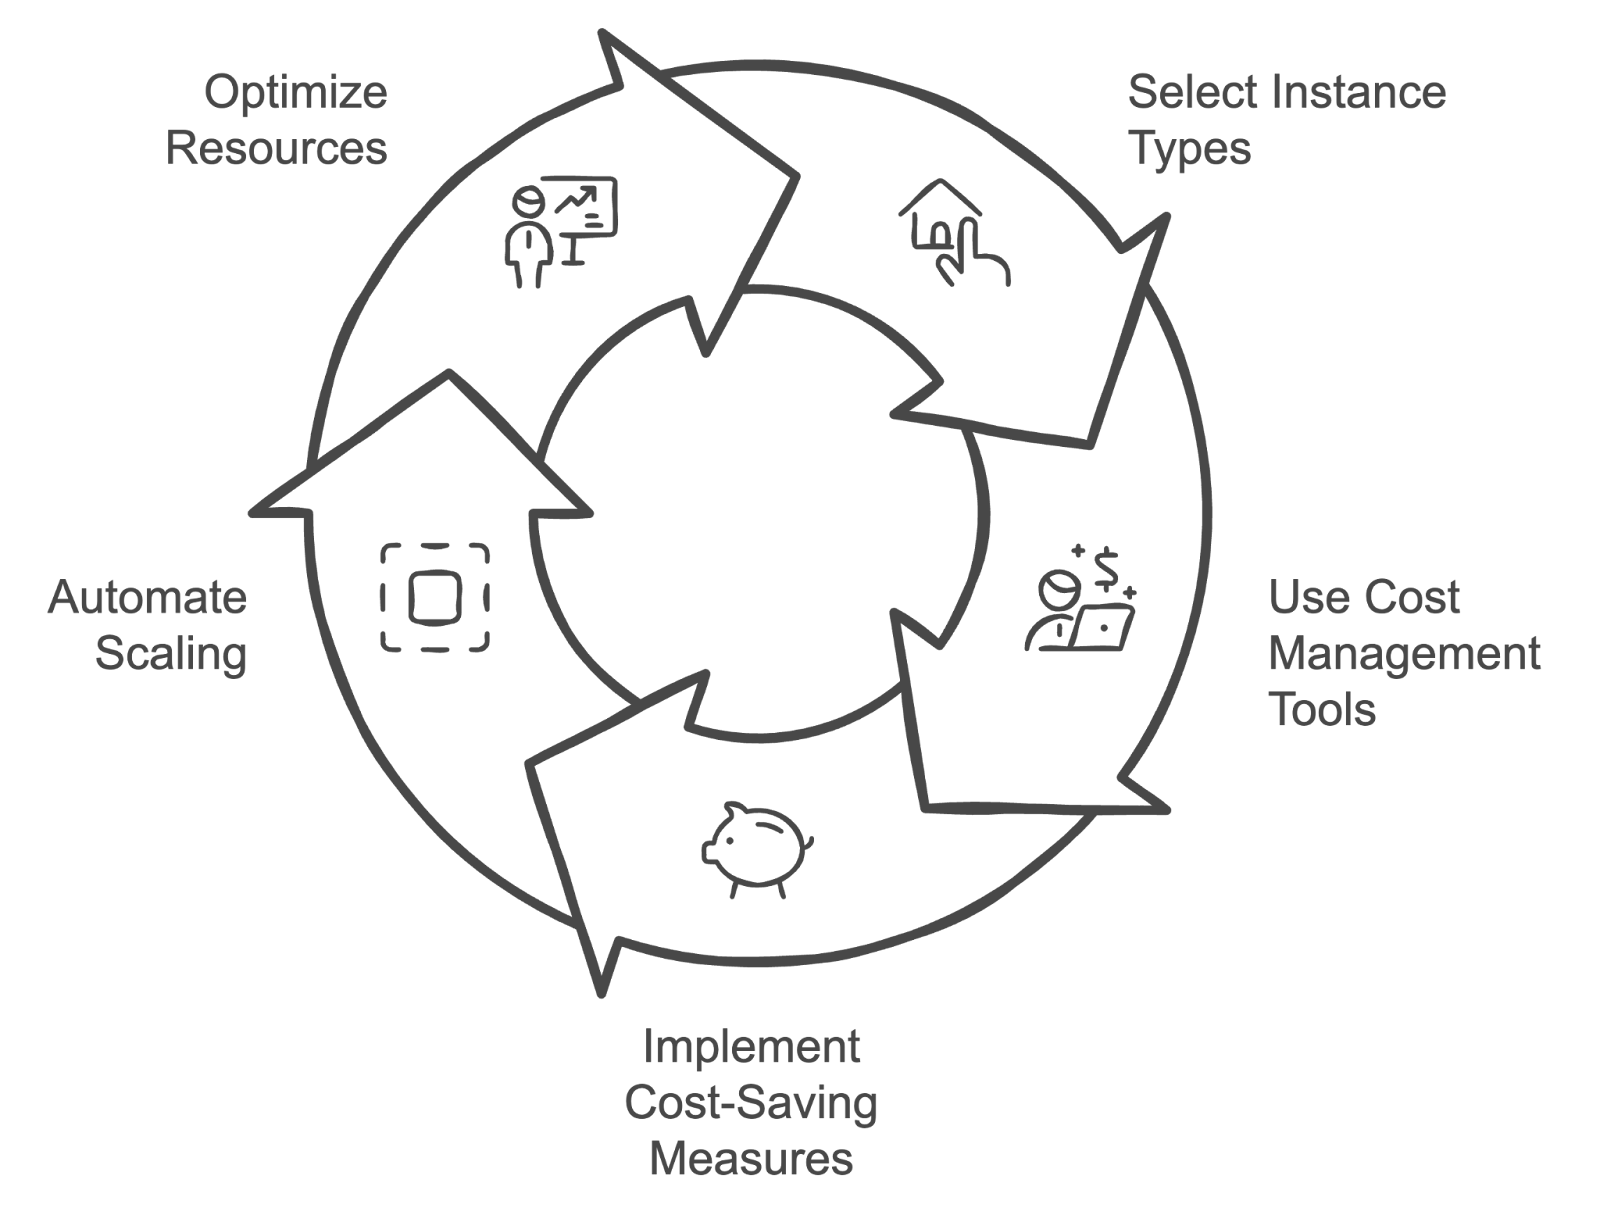
Cyclus voor cloudkostenbeheer. Afbeelding door auteur gemaakt met napkin.ai
Beschrijving: Deze vraag verkent je begrip van de trade-offs tussen deployment op edge-devices versus in de cloud.
Antwoord: Clouddeployment draait modellen op gecentraliseerde servers en biedt schaalbaarheid en eenvoudiger onderhoud, maar mogelijk met hogere latency.
Edge-deployment draait modellen direct op devices zoals smartphones of IoT-apparaten, wat latency verlaagt en dataprivacy verbetert, maar beperkt kan zijn door rekenresources. Edge is ideaal voor realtime toepassingen, terwijl cloud beter past bij modellen met veel rekenkracht en flexibiliteit.
Beschrijving: Deze vraag toetst je kennis van het bouwen van robuuste systemen voor het deployen van ML-modellen.
Antwoord: Hoge beschikbaarheid bereik je door modellen over meerdere availability zones of regio’s te deployen en automatische failovermechanismen in te stellen.
Load balancers kunnen verkeer verdelen om knelpunten te voorkomen. Voor fouttolerantie helpen regelmatige back-ups, redundantie en health checks om systeemstoringen te voorkomen. Cloudservices zoals AWS Elastic Load Balancing en autoscaling zorgen ervoor dat bij uitval van een instantie andere instanties het zonder downtime overnemen.
Deze sectie gaat in op gedrags- en probleemoplossende aspecten van MLOps, en beoordeelt hoe kandidaten echte uitdagingen benaderen, met teams samenwerken en omgaan met diverse issues bij het deployen en beheren van ML-modellen.
Beschrijving: Deze vraag beoordeelt probleemoplossend vermogen in praktijksituaties.
Voorbeeldantwoord: "Er was een situatie waarin een model in productie een duidelijke prestatiedaling vertoonde. De eerste stap was het doornemen van logs en metrics om anomalieën te vinden. Al snel bleek dat de datapijplijn data aanleverde met een gewijzigde structuur door recente updates in bronsystemen.
Vervolgens heb ik de data gevalideerd tegen de verwachte input van het model en verschillen gecontroleerd. Na bevestiging van het dataprobleem heb ik met het data-engineeringteam samengewerkt om de pijplijn te corrigeren. Daarna heb ik een hotfix uitgerold om de inputverwerking in het model bij te werken.
Tot slot heb ik het model na deployment nauwlettend gemonitord om te bevestigen dat de prestaties terugkeerden naar het verwachte niveau en de bevindingen en oplossing met stakeholders gedeeld."
Beschrijving: Deze vraag beoordeelt je aanpak voor het beheren van verschillende versies van ML-modellen in teamverband.
Voorbeeldantwoord: “Ik gebruik versiebeheersystemen zoals MLflow of DVC om modelversies te beheren en te tracken. Elke versie krijgt een unieke identifier en bij elke update hoort uitgebreide documentatie, zodat teamleden de wijzigingen begrijpen.
Daarnaast zorg ik dat nieuwe modellen grondig worden getest in een stagingomgeving vóór deployment naar productie, om verstoringen te voorkomen en prestaties te borgen.”
Beschrijving: Deze vraag beoordeelt je vermogen om effectief samen te werken met verschillende teams, zoals data scientists, engineers en productmanagers, en hoe je uitdagingen in cross-functionele settings aanpakt.
Voorbeeldantwoord: "Een uitdagende situatie betrof de coördinatie tussen data scientists, engineers en productmanagers om een nieuw model met complexe afhankelijkheden te deployen. De sleutel was het vanaf het begin inrichten van duidelijke communicatielijnen.
We planden regelmatige meetings om doelen af te stemmen, voortgang te volgen en blokkades te adresseren. Om kenniskloofjes te overbruggen, organiseerde ik kennissessies waarin teamleden hun expertise deelden.
Verder hielp het gebruik van projectmanagementtools om taken en mijlpalen te tracken, zodat iedereen op de hoogte bleef van de status. Zo werd ieders inbreng meegenomen en werkten we samen toe naar een succesvolle deployment."
Beschrijving: Deze vraag verkent je strategieën om ML-modellen te schalen voor groeiende vraag, en beoordeelt je begrip van de technische en operationele kanten van schaalbaarheid.
Voorbeeldantwoord: "Het schalen van ML-modellen om meer load aan te kunnen bestaat uit een paar cruciale stappen.
Eerst analyseer ik de huidige prestatiemetrics om mogelijke knelpunten te identificeren. Om meer vraag aan te kunnen, maak ik gebruik van cloudgebaseerde autoscaling om resources dynamisch aan te passen aan het verkeer.
Daarnaast optimaliseer ik het model zelf met technieken zoals quantization of pruning om het resourceverbruik te verlagen zonder prestatieverlies.
Ook voer ik loadtesten uit om hoger verkeer te simuleren en de robuustheid te waarborgen.
En tot slot implementeer ik continue monitoring om op de hoogte te blijven van de modelprestaties, zodat ik resource-allocatie kan bijsturen en prestaties onder wisselende load kan handhaven.”
Beschrijving: Deze vraag beoordeelt je communicatie en verwachtingsmanagement wanneer een model niet de verwachte resultaten levert.
Voorbeeldantwoord: "Wanneer prestaties achterblijven, zet ik in op transparante communicatie met stakeholders. Ik leg de beperkingen van het model uit en de oorzaken van de prestaties, of het nu gaat om datakwaliteit, overfitting of onrealistische verwachtingen.
Vervolgens stel ik samen met hen realistischere doelen op, geef ik datagedreven inzichten en stel ik verbeteringen voor, zoals meer trainingsdata verzamelen of de modelarchitectuur aanpassen."
Beschrijving: Deze vraag beoordeelt je vermogen om lange-termijn codekwaliteit te prioriteren naast korte-termijn deadlines.
Voorbeeldantwoord: "We hadden een strakke deadline om een model te deployen voor een nieuwe productfeature. We prioriteerden snelle levering door bepaalde niet-kritieke delen, zoals uitgebreide documentatie en niet-essentiële tests, tijdelijk over te slaan.
Na de release hebben we tijd ingepland om de codebase te herzien en deze punten aan te pakken, zodat de technische schuld na de lancering werd geminimaliseerd. Zo haalden we de deadline én bewaakten we de stabiliteit op lange termijn."
Voorbereiden op een MLOps-sollicitatie vraagt om een combinatie van technische kennis, inzicht in de omgeving van het bedrijf en helder communiceren over je ervaringen. Hier zijn enkele essentiële tips om je klaar te stomen:
Zorg dat je de kernconcepten van MLOps goed beheerst. Maak je vertrouwd met populaire tools en platforms die in MLOps worden gebruikt, zoals MLflow, Kubernetes en clouddiensten als AWS SageMaker of Google AI Platform.
De MLOps skill track is de perfecte resource: vier relevante cursussen waarmee je up-to-date blijft met MLOps-concepten en -praktijken.
Onderzoek de specifieke technologieën en tools die het bedrijf gebruikt waar je solliciteert. Als je hun tech stack begrijpt, kun je je antwoorden toespitsen op hun omgeving en laten zien dat je een goede match bent. Kijk naar hun voorkeur voor clouddiensten, versiebeheersystemen en modelmanagementpraktijken, zodat je laat zien dat je naadloos in hun workflow past.
Wees klaar om specifieke projecten of ervaringen te bespreken waarin je MLOps-praktijken toepaste. Kies voorbeelden die je probleemoplossend vermogen laten zien, je samenwerking met cross-functionele teams en je ervaring met deployment en schaalbaarheid (indien mogelijk). Gebruik deze voorbeelden om je praktische kennis te illustreren en hoe je uitdagingen in eerdere rollen hebt aangepakt.
Oefen regelmatig met codeeropdrachten die bij MLOps horen, zoals scripts schrijven voor deployment, workflows automatiseren of datapijplijnen ontwikkelen.
MLOps ontwikkelt zich snel, dus het is belangrijk dat je op de hoogte blijft van trends, tools en best practices. Volg brancheblogs, neem deel aan relevante fora of webinars en ga het gesprek aan met de MLOps-community om je kennis actueel te houden.
MLOps overbrugt de kloof tussen data science en operations, zodat ML-modellen effectief worden gedeployed, onderhouden en opgeschaald.
In dit artikel hebben we een reeks sollicitatievragen behandeld: algemene MLOps-concepten, technische aspecten, cloud- en infrastructuuroverwegingen en gedragsmatige probleemoplossing. Door deze vragen te oefenen, vergroot je je kans op succes tijdens sollicitaties en vergroot je de kans op het binnenhalen van de baan!
Bekijk de volgende resources om verder te leren:
Leer meer over MLOps met deze cursussen!
Cursus
Cursus
Oefen en volg je voortgang.
Ga Verder Met Googleblog
Adel Nehme
15 min

