

Corso
Concetti di MLOps
2 ore
46.3K
Pratica and corso your progress.
Continua Con GoogleLe Machine Learning Operations (MLOps) sono emerse come uno dei campi più richiesti nel tech. Man mano che i team dati distribuiscono sempre più modelli di machine learning in ambienti di produzione, la domanda di professionisti MLOps continuerà a crescere.
Se stai cercando di intraprendere una carriera come MLOps engineer, siamo qui per aiutarti a fare il salto!
In questo articolo troverai le principali domande di colloquio su MLOps, con spiegazioni e risposte dettagliate, per aiutarti a prepararti al meglio per il tuo prossimo colloquio.
MLOps, abbreviazione di Machine Learning Operations, è una disciplina che combina il machine learning con le pratiche DevOps per ottimizzare e automatizzare il ciclo di vita dei modelli di machine learning.
L'obiettivo principale di MLOps è colmare il divario tra data science e IT operations, assicurando che i modelli di machine learning vengano sviluppati in modo efficace, distribuiti, monitorati e mantenuti in modo efficiente in ambienti di produzione.
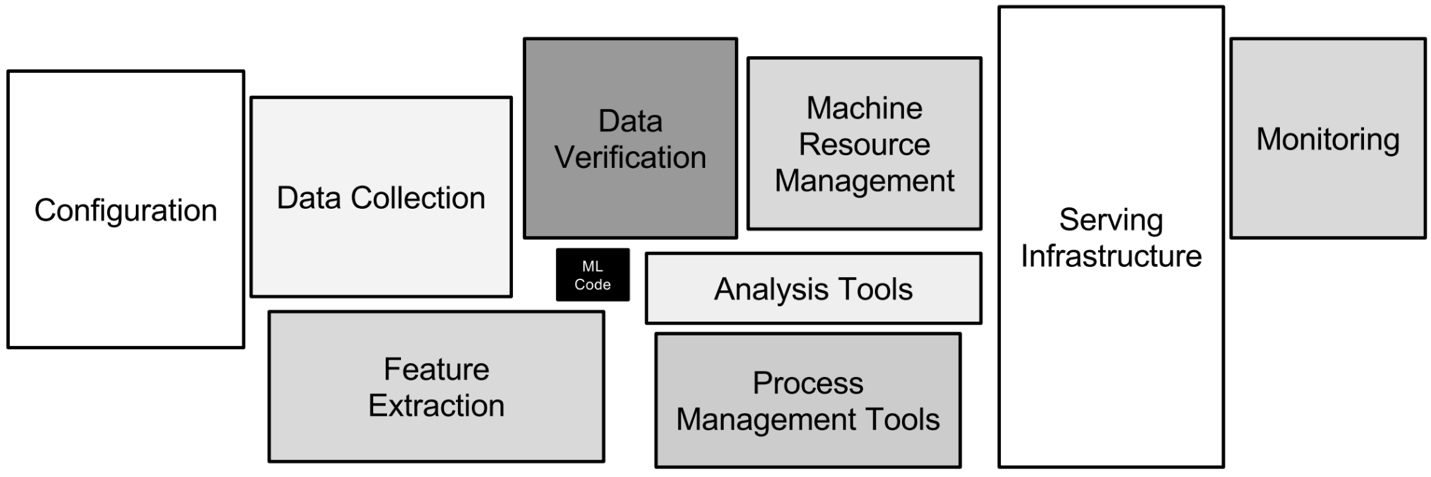
I diversi aspetti tecnici delle MLOps. Immagine dell'autore
Questo ruolo è importante perché permette ai team dati di distribuire modelli di machine learning in ambienti di produzione garantendo al contempo che possano essere scalati e mantenuti in modo efficace. In sostanza, le MLOps accelerano l'innovazione, migliorano l'efficienza operativa e aiutano le aziende a sbloccare tutto il potenziale delle iniziative data-driven.
Le competenze richieste nelle MLOps includono:
Sì, un MLOps engineer è come un unicorno! Ed è proprio per questo che sono molto richiesti e ricevono salari sempre più alti.
In questa sezione esploreremo domande fondamentali di colloquio su MLOps che valutano la tua comprensione dei concetti e dei principi chiave. Queste domande sono progettate per testare la tua conoscenza delle responsabilità e delle sfide di base delle MLOps e la tua capacità di comunicare efficacemente ciò che sai.
Familiarizzati con queste domande per costruire solide basi in vista di argomenti più avanzati e per dimostrare la tua competenza nel campo.
Descrizione: questa domanda verifica la comprensione delle differenze fondamentali tra MLOps e DevOps, che spesso vengono confuse.
Risposta: MLOps e DevOps sono entrambe strategie focalizzate sulla collaborazione, ma con scopi diversi. DevOps si concentra sull'automazione di sviluppo, test e distribuzione di applicazioni software, standardizzando gli ambienti per snellire questi processi.
Al contrario, MLOps è ritagliato sui workflow di machine learning, con enfasi sulla gestione e manutenzione di data pipeline e modelli. Mentre DevOps mira ad automatizzare le attività di routine e standardizzare la distribuzione delle applicazioni, MLOps affronta la natura sperimentale del machine learning, includendo attività come validazione dei dati, valutazione della qualità del modello e validazione continua del modello.
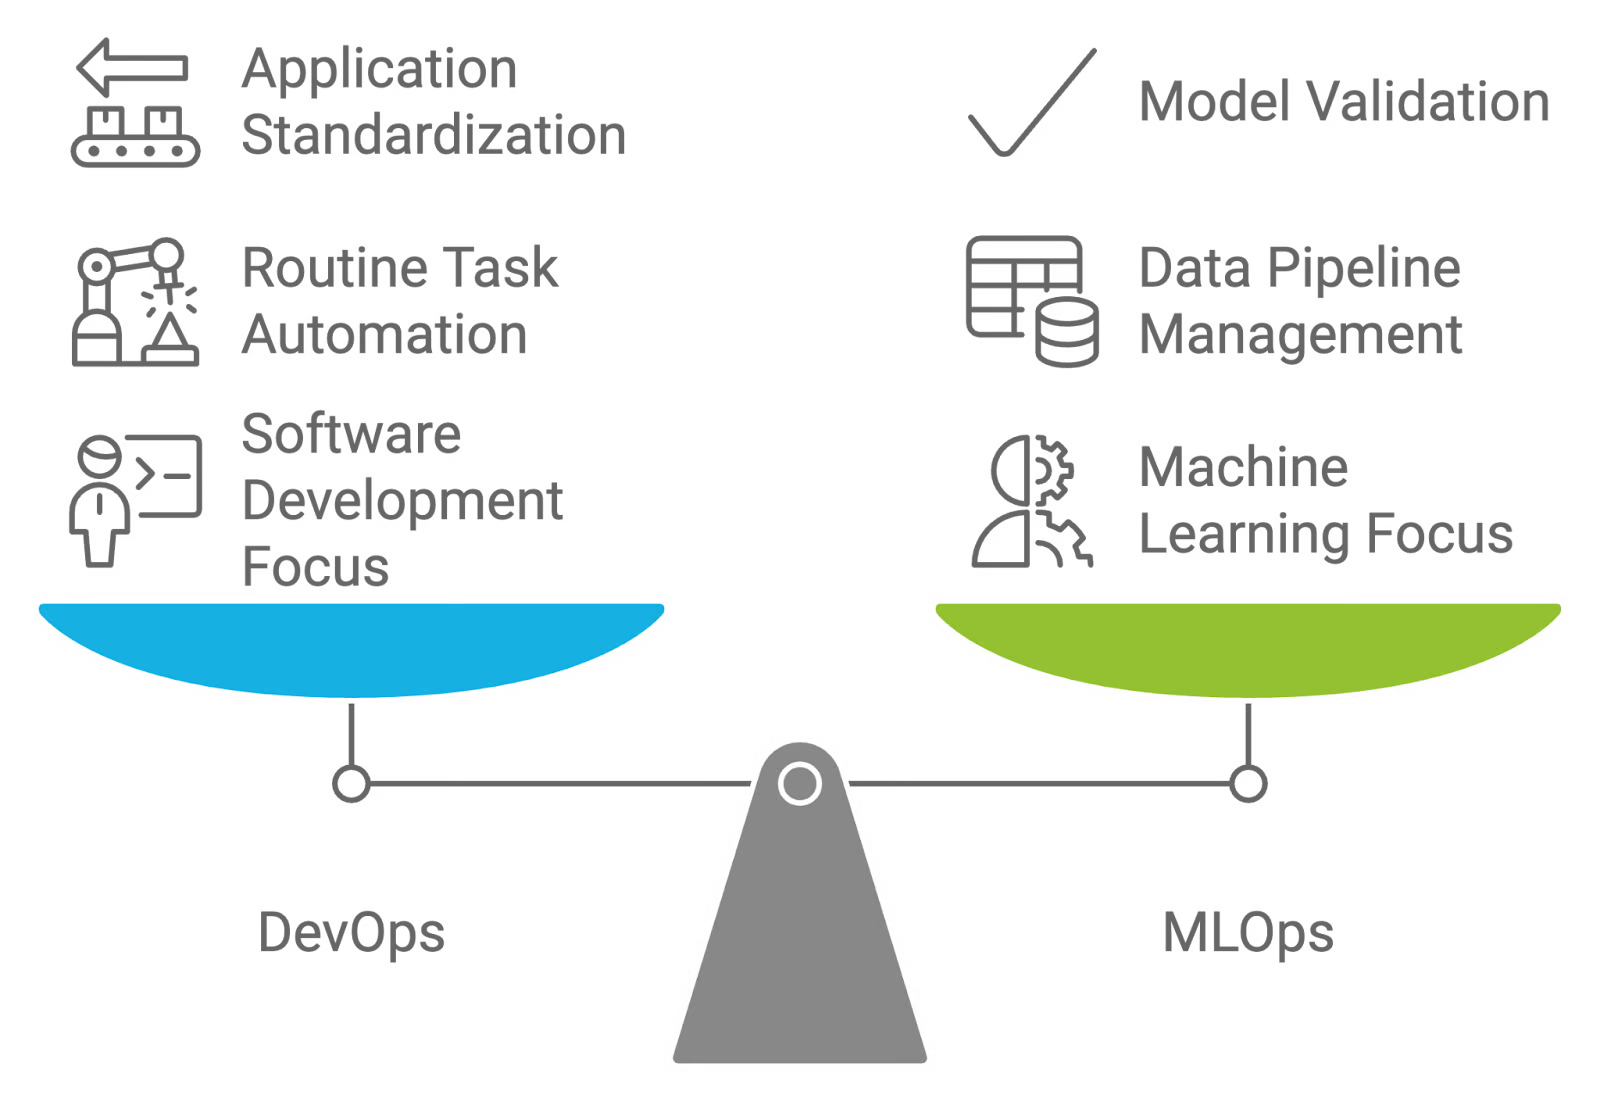
Confronto tra DevOps e MLOps. Immagine dell'autore creata con napkin.ai
Descrizione: questa domanda di colloquio valuta la tua conoscenza dell'impatto dei dati in evoluzione sull'accuratezza del modello e dell'importanza di monitorare e aggiornare i modelli.
Risposta: Il model drift e il concept drift si riferiscono ai cambiamenti nelle prestazioni dei modelli di machine learning nel tempo a causa dell'evoluzione dei pattern dei dati e delle relazioni sottostanti:
Descrizione: questa domanda di colloquio esamina la tua conoscenza delle pratiche di testing per assicurare che un modello di machine learning sia affidabile e performante prima della distribuzione in produzione.
Risposta: esistono diversi test da condurre prima di distribuire un modello ML in produzione. Questa tabella offre una panoramica completa di ciascun tipo di test, inclusi obiettivi, strumenti utilizzati e quando applicarlo durante il ciclo di sviluppo del machine learning:
|
Tipo di test |
Obiettivo |
Strumenti utilizzati |
Quando usarlo |
|
Unit testing |
Verificare i singoli componenti del modello, come i passaggi di preprocessing e le funzioni di estrazione delle feature. |
PyTest, unittest, scikit-learn (per le trasformazioni) |
Durante lo sviluppo, quando si implementano o aggiornano componenti del modello. |
|
Integration testing |
Assicurarsi che il modello interagisca correttamente con altri componenti del sistema e sorgenti dati in produzione. |
Docker, Kubernetes, Jenkins, Apache Kafka |
Dopo l'unit testing, quando si distribuisce il modello in un ambiente simile alla produzione. |
|
Performance testing |
Valutare accuratezza, precision, recall e altre metriche rilevanti utilizzando un dataset di validazione. |
Scikit-learn, TensorFlow, PyTorch, MLflow |
Dopo l'integration testing, per assicurare che il modello soddisfi gli standard attesi di performance. |
|
Stress testing |
Valutare come il modello gestisce carichi elevati e grandi volumi di dati, garantendone la scalabilità. |
Apache JMeter, Locust, Dask |
Prima della distribuzione in ambienti ad alto volume di dati o quando la scalabilità è un problema. |
|
A/B testing |
Confrontare le prestazioni del modello con modelli esistenti o metriche baseline in un ambiente live. |
Optimizely, SciPy, Google Optimize |
Dopo la distribuzione, per validare le prestazioni in produzione e ottimizzare le versioni del modello. |
|
Robustness testing |
Assicurarsi che il modello sia resiliente ad anomalie e casi limite nei dati. |
Librerie per la robustezza avversaria (es. CleverHans), script personalizzati |
Dopo il performance testing, per confermare l'affidabilità in condizioni anomale o inattese. |
Descrizione: questa domanda di colloquio valuta la tua comprensione del ruolo e dell'importanza del version control nelle pratiche MLOps. Si concentra su come la gestione di diverse versioni di modelli, dati e codice contribuisca a una distribuzione e manutenzione efficaci.
Risposta: il version control è vitale nelle MLOps perché aiuta a gestire e tracciare i cambiamenti di modelli, dataset e codice lungo tutto il loro ciclo di vita. Usare sistemi come Git per il codice e strumenti come DVC (Data Version Control) per dataset e modelli garantisce che tutte le modifiche siano documentate e reversibili.
Questa pratica supporta la riproducibilità, facilita la collaborazione tra i membri del team e consente un facile rollback a versioni precedenti in caso di problemi. Assicura coerenza e affidabilità nelle prestazioni del modello, aspetto importante per mantenere distribuzioni di alta qualità.
Per approfondire il concetto, consulta La guida completa a Data Version Control (DVC). Ti preparerà a questo tipo di domande durante il colloquio!
Descrizione: questa domanda di colloquio mira a valutare la tua conoscenza dei diversi metodi per impacchettare i modelli di machine learning per la distribuzione. Verifica la tua capacità di preparare i modelli all'integrazione in vari ambienti e applicazioni.
Risposta: ci sono diversi modi efficaci per impacchettare i modelli di machine learning:
Un ottimo modo per approfondire l'impacchettamento dei modelli è familiarizzare con la containerizzazione. Docker è uno strumento fondamentale che ogni MLOps engineer dovrebbe conoscere. Per rinfrescare le tue conoscenze, vai al corso Introduction to Docker.
Descrizione: questa domanda valuta la tua conoscenza del monitoraggio dei modelli in produzione e la comprensione di quali metriche sono critiche per garantire performance e affidabilità nel tempo.
Risposta: il monitoring è essenziale nelle MLOps per assicurare che i modelli continuino a performare come atteso in produzione. Le metriche da tracciare includono accuratezza, precision, recall e altri indicatori di performance per rilevare il degrado del modello.
Il monitoraggio del data drift è altrettanto critico, poiché i cambiamenti nei pattern dei dati possono influenzare le previsioni del modello. Inoltre, metriche infrastrutturali come latenza e uso delle risorse (ad es., CPU, memoria) aiutano a garantire che il sistema rimanga scalabile e reattivo.
Descrizione: questa domanda di colloquio valuta la tua comprensione dei potenziali ostacoli e di come affrontarli per garantire una distribuzione di successo.
Risposta: I problemi comuni nella distribuzione di modelli ML includono:
Tutti i datori di lavoro cercano capacità di problem solving, soprattutto quando si tratta di gestire i dati in un ruolo come le MLOps. Per metterti in pari su due temi molto importanti nell'era dell'ML, dai un'occhiata ai corsi Introduction to Data Quality e Introduction to Data Security.
Descrizione: questa domanda di colloquio verifica la capacità di distinguere tra i metodi di distribuzione Canary e Blue-Green e i loro vantaggi nel rilascio di nuove modifiche.
Risposta: le strategie di distribuzione Canary e Blue-Green vengono utilizzate per gestire il rollout degli aggiornamenti, ma differiscono nell'approccio:
Entrambe le strategie mirano a ridurre rischi e downtime, ma i deployment Canary puntano su rilasci incrementali ed esposizione graduale, mentre i deployment Blue-Green garantiscono uno switch senza soluzione di continuità tra ambienti.
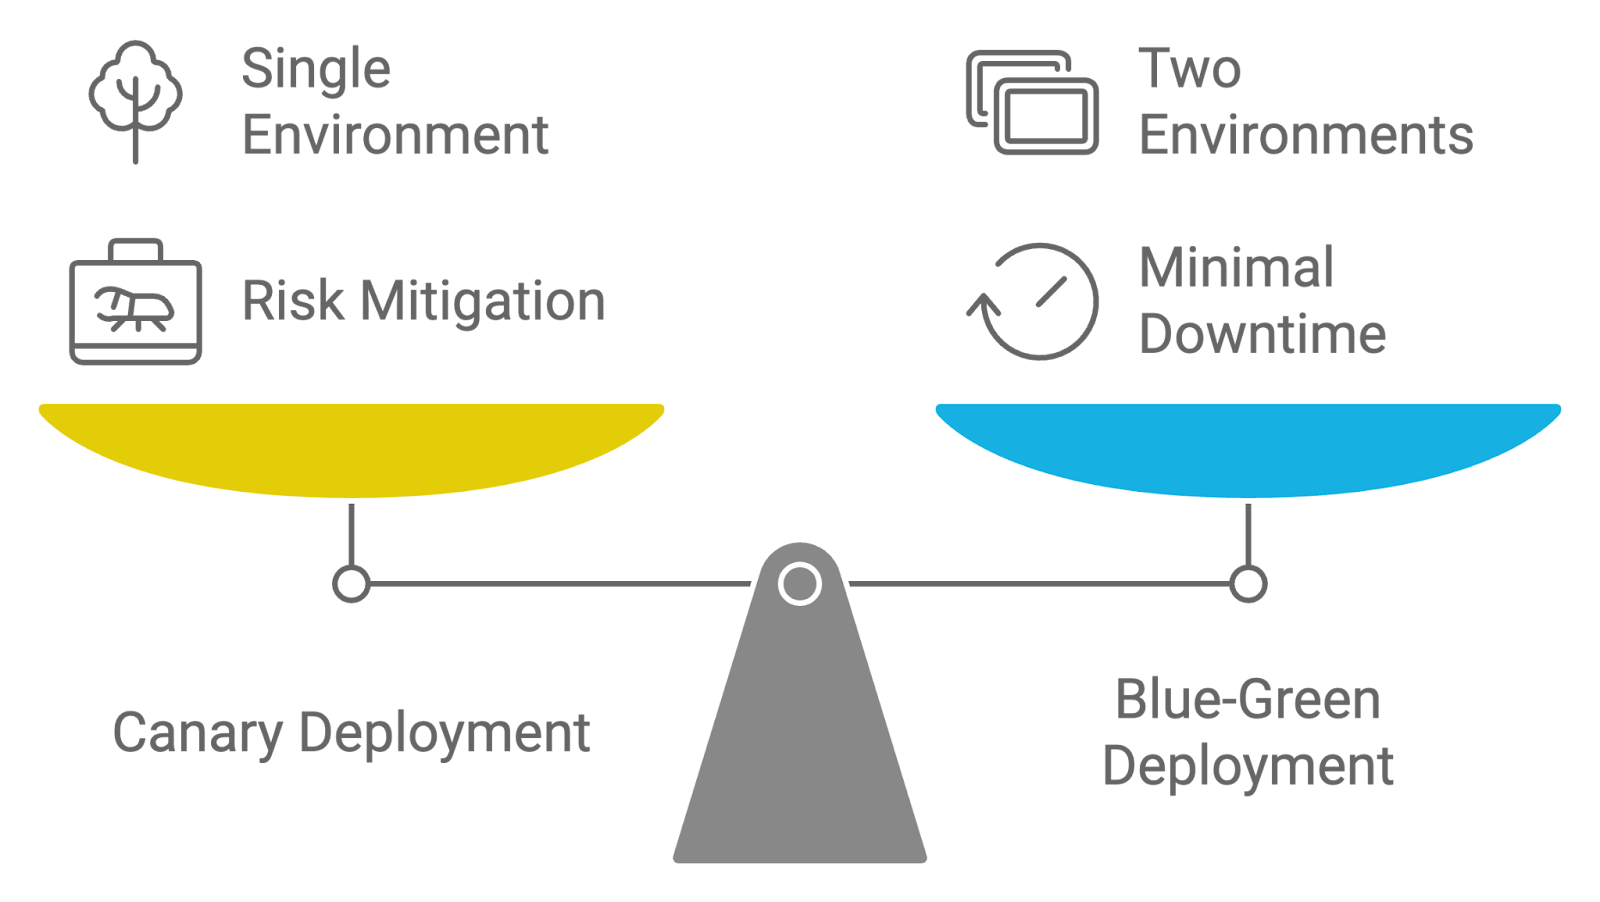
Confronto tra strategie di distribuzione: Canary contro Blue-Green. Immagine dell'autore creata con napkin.ai
Descrizione: questa domanda valuta la conoscenza delle strategie e degli strumenti usati per automatizzare il riaddestramento dei modelli man mano che diventano disponibili nuovi dati.
Risposta: automatizzare il riaddestramento del modello nelle MLOps implica configurare una pipeline che attivi il riaddestramento quando si verificano determinate condizioni, come il degrado delle prestazioni o la disponibilità di nuovi dati.
Strumenti come Airflow o Kubeflow possono orchestrare questi workflow, automatizzando attività come ingestione dati, feature engineering, training del modello e valutazione. Il monitoraggio continuo è essenziale per assicurare che il modello soddisfi le soglie di performance prima della distribuzione, e strumenti di versioning come DVC aiutano a tracciare le diverse versioni durante il riaddestramento.
In questa sezione analizzeremo domande tecniche di colloquio su MLOps che valutano le tue competenze pratiche e la comprensione di concetti avanzati.
Queste domande si concentrano sugli aspetti tecnici di distribuzione, gestione e ottimizzazione dei modelli di machine learning e sono progettate per valutare la tua padronanza di strumenti, tecniche e best practice del settore.
Descrizione: questa domanda verifica la conoscenza della configurazione di pipeline CI/CD specifiche per i workflow di machine learning. Valuta la capacità di automatizzare il processo di distribuzione e gestire gli aggiornamenti del modello in modo efficiente.
Risposta: implementare la CI/CD per i modelli di machine learning significa configurare pipeline che automatizzano il processo dai cambiamenti al codice fino alla distribuzione.
Per esempio, puoi usare Jenkins o GitHub Actions per attivare build e test ogni volta che cambia il codice del modello o i dati. La pipeline include fasi come:
Automatizzando queste fasi, garantisci aggiornamenti dei modelli coerenti e affidabili con un intervento manuale minimo.
Se vuoi migliorare la tua conoscenza della CI/CD, segui il corso CI/CD for Machine Learning. Ti farà brillare al colloquio!
Descrizione: questa domanda di colloquio si concentra sulla comprensione di pratiche efficaci di data management nelle MLOps. Valuta la capacità di gestire qualità, versioning e organizzazione dei dati per supportare workflow ML solidi e affidabili.
Risposta: le best practice per la gestione dei dati nelle MLOps includono:
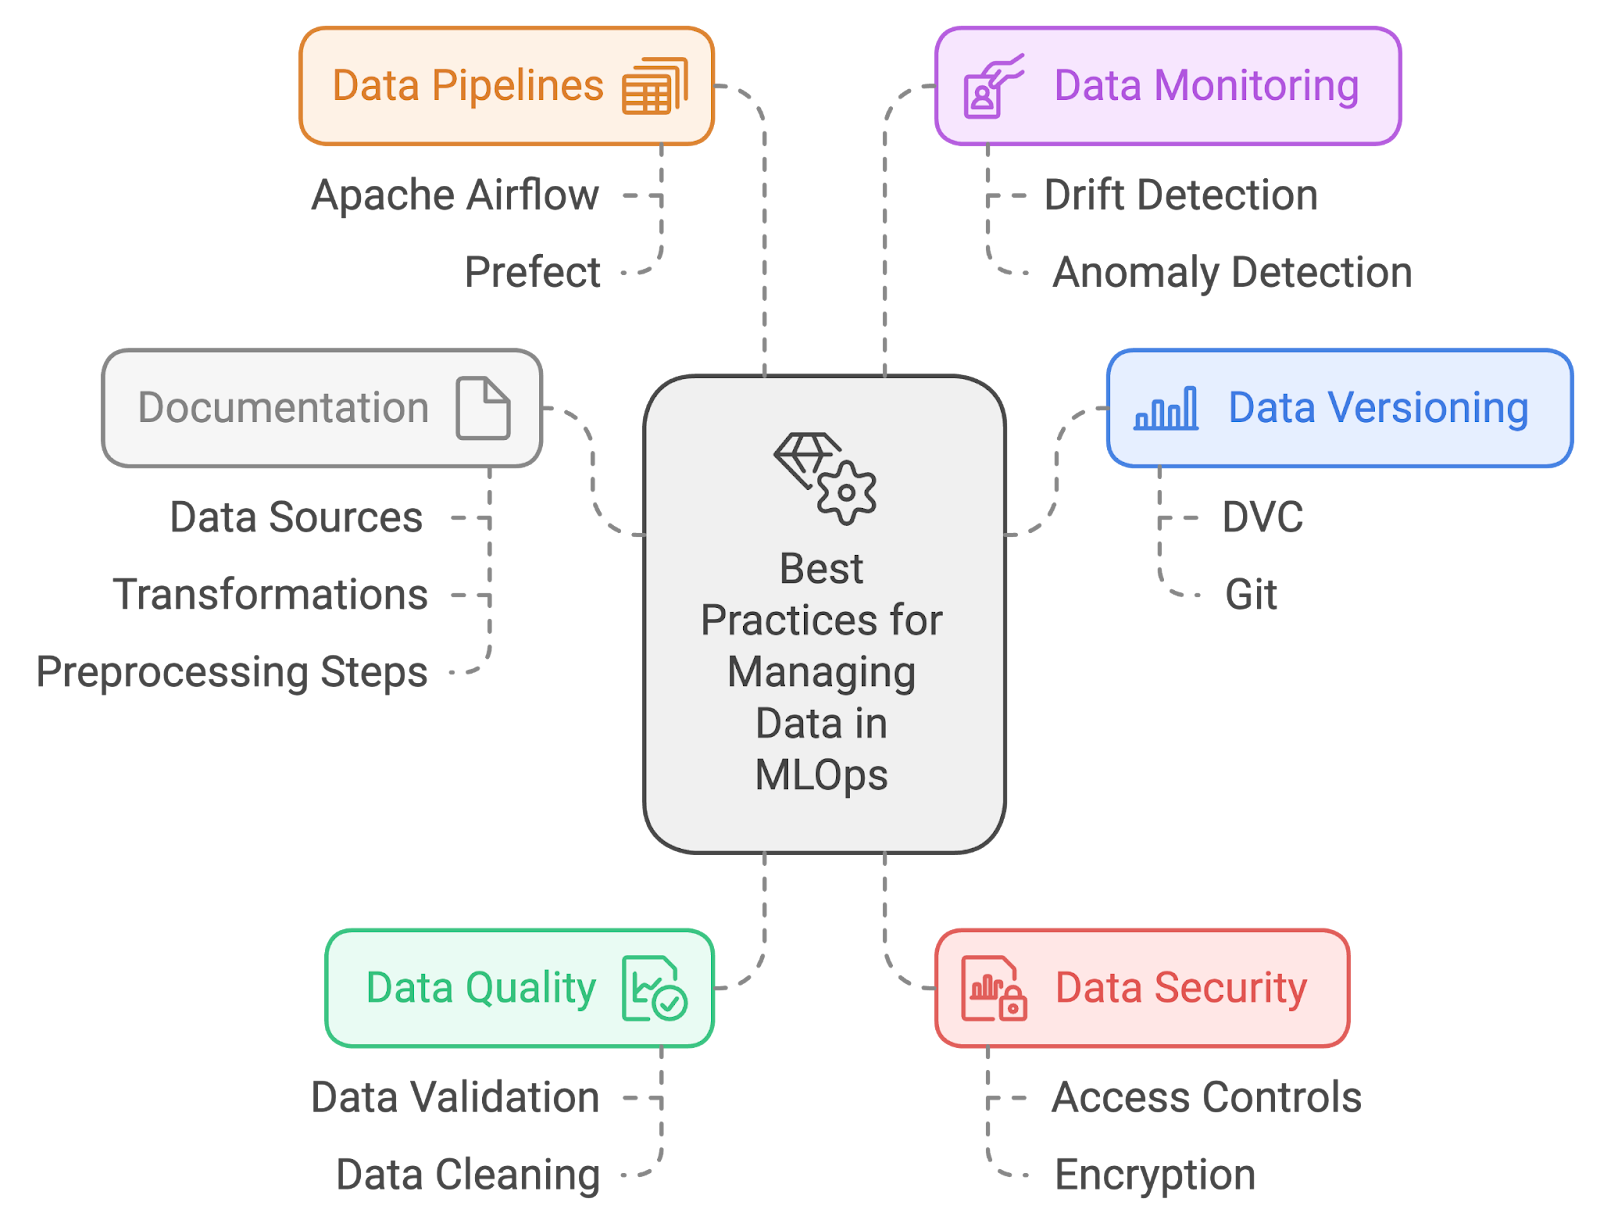
Best practice di data management. Immagine dell'autore creata con napkin.ai
Descrizione: questa domanda valuta come integri questi processi in workflow automatizzati.
Risposta: gestire feature engineering e preprocessing in una pipeline MLOps significa automatizzare questi passaggi per garantire coerenza e riproducibilità. Puoi usare strumenti come Apache Airflow o Prefect per creare pipeline dati che eseguono attività come:
Descrizione: questa domanda valuta la comprensione di come tracciare e garantire prestazioni e affidabilità del modello nel tempo, inclusi strumenti e strategie per un monitoraggio efficace.
Risposta: implementare il monitoraggio del modello in produzione implica diverse pratiche per garantire che il modello performi come previsto e rimanga affidabile nel tempo:
Il corso Machine Learning Monitoring ti metterà al passo per rispondere a domande come questa con più dettaglio!
Descrizione: questa domanda esplora il tuo approccio per assicurarti che gli esperimenti di machine learning possano essere replicati in modo coerente. Valuta la comprensione delle pratiche che supportano la riproducibilità.
Risposta: garantire la riproducibilità degli esperimenti di machine learning implica:
Descrizione: questa domanda valuta la comprensione delle sfide uniche nel portare i modelli di machine learning dagli ambienti di sviluppo a quelli di produzione.
Risposta: operativizzare i modelli di machine learning presenta diverse sfide. Una delle difficoltà principali è garantire coerenza tra ambienti di sviluppo e produzione, che può portare a problemi di riproducibilità.
Il data drift è un'altra preoccupazione, poiché i dati in produzione possono cambiare nel tempo riducendo l'accuratezza del modello.
Inoltre, integrare i modelli nei sistemi esistenti, monitorarne le prestazioni e automatizzare i workflow di riaddestramento sono spesso compiti complessi che richiedono una collaborazione efficace tra team di data science e di engineering.
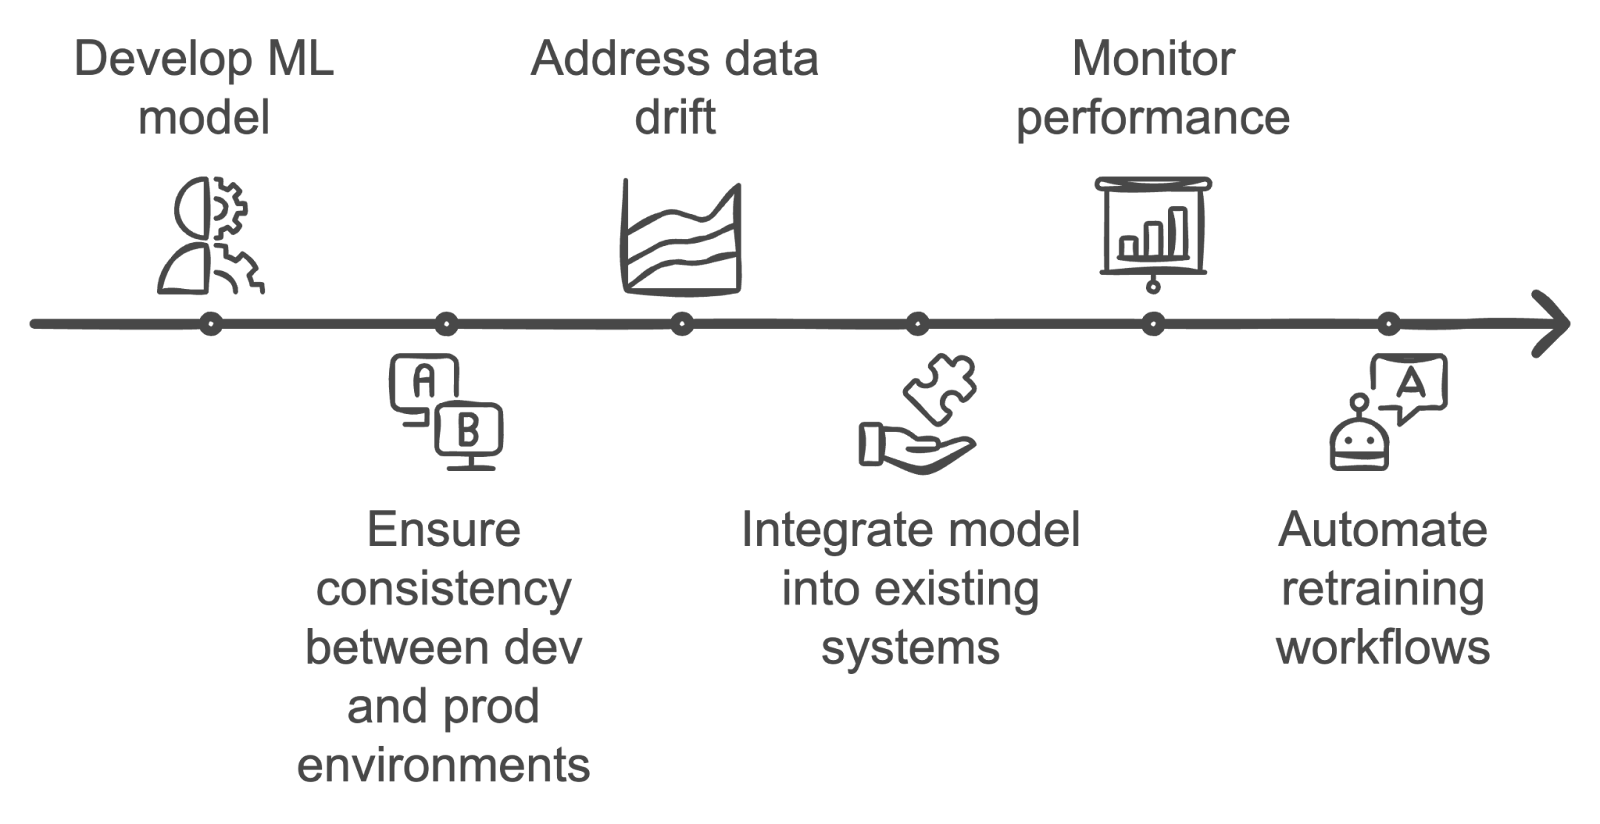
Superare le sfide nell'operativizzazione dei modelli ML. Immagine dell'autore creata con napkin.ai
Descrizione: questa domanda valuta la tua comprensione dell'automazione del riaddestramento quando sono disponibili nuovi dati o le prestazioni del modello degradano.
Risposta: implementare il riaddestramento automatico del modello implica configurare una pipeline che monitori le prestazioni del modello e il data drift. Quando l'accuratezza scende sotto una soglia o quando sono disponibili nuovi dati, strumenti come Apache Airflow o Kubeflow possono attivare il riaddestramento.
Il riaddestramento include il recupero dei nuovi dati, il preprocessing, l'addestramento del modello con gli stessi iperparametri o aggiornati e la validazione del nuovo modello. Dopo il riaddestramento, il modello aggiornato viene distribuito automaticamente in produzione.
Descrizione: questa domanda verifica la conoscenza dell'interpretabilità del modello e come garantisci trasparenza nelle previsioni.
Risposta: strumenti come SHAP (SHapley Additive exPlanations) o LIME (Local Interpretable Model-agnostic Explanations) sono comunemente usati per la spiegabilità del modello.
Questi strumenti scompongono le previsioni del modello mostrando il contributo delle singole feature. La spiegabilità è fondamentale nelle MLOps perché costruisce fiducia negli stakeholder e assicura che i modelli rispettino le normative, specialmente in settori come finanza e sanità. Aiuta anche a individuare potenziali bias o problemi legati ai dati nel modello.
Questa sezione copre domande di colloquio incentrate sugli aspetti cloud e infrastrutturali delle MLOps. Valutano la tua esperienza nel distribuire, gestire e scalare modelli di machine learning negli ambienti cloud.
Descrizione: questa domanda esamina la tua conoscenza della distribuzione di modelli di machine learning in un ambiente cloud. Valuta la comprensione delle piattaforme cloud, dei processi di deployment e degli strumenti usati per gestire i modelli nel cloud.
Risposta: distribuire modelli ML sul cloud comporta i seguenti passaggi:
Descrizione: questa domanda esplora la comprensione del computing serverless e della sua applicazione nel deployment di modelli ML, valutando la capacità di bilanciare benefici e sfide.
Risposta: le architetture serverless offrono diversi vantaggi, come la riduzione dell'overhead operativo, non essendoci bisogno di gestire i server, e lo scaling automatico basato sulla domanda in tempo reale, che può tradursi in risparmi poiché la fatturazione è legata all'uso effettivo del compute.
Tuttavia, ci sono anche sfide. Ad esempio, esistono limiti al tempo di esecuzione e all'allocazione delle risorse che potrebbero non essere adatti a tutti i tipi di modelli ML, in particolare quelli ad alta intensità computazionale.
La latenza da cold start può essere un problema: le richieste iniziali dopo periodi di inattività possono subire ritardi. Nonostante queste sfide, le architetture serverless possono essere molto efficaci per determinati carichi se questi fattori vengono gestiti adeguatamente.
Un altro modo per vederlo è con questa tabella che riassume pro e contro delle architetture serverless in base a specifici aspetti:
|
Aspetto |
Pro del serverless |
Contro del serverless |
|
Overhead operativo |
Nessuna gestione dei server; complessità infrastrutturale ridotta. |
Richiede conoscenza delle piattaforme cloud per gestire ambienti serverless. |
|
Scalabilità |
Scaling automatico basato sulla domanda in tempo reale, con efficienza dei costi. |
Può essere imprevedibile per il budgeting se lo scaling è frequente. |
|
Efficienza dei costi |
Paghi solo per le risorse utilizzate, con potenziale riduzione dei costi. |
Può diventare costoso se molte funzioni vengono invocate spesso o per tempi lunghi. |
|
Limiti di esecuzione |
Adatto a task leggeri o di breve durata. |
Limitato da tempo di esecuzione e risorse; può non gestire modelli ML intensivi. |
|
Cold start |
Riduce l'overhead operativo grazie allo scaling on demand. |
Possibili ritardi da cold start dopo inattività, impattando le app sensibili alla latenza. |
|
Idoneità dei modelli ML |
Funziona bene per task ML su piccola scala, inferenza o batch processing. |
Modelli ML ad alta computazione con task di lunga durata non sono adatti. |
Descrizione: questa domanda valuta le tue strategie per ottimizzare e gestire le risorse computazionali durante il training dei modelli ML nel cloud. Esamina la capacità di assicurare un uso efficiente delle risorse cloud.
Risposta: gestire le risorse computazionali implica:
Descrizione: questa domanda esamina l'approccio al mantenimento della sicurezza dei dati e della conformità durante il deployment dei modelli ML nel cloud, con focus su best practice e requisiti normativi.
Risposta: garantire sicurezza e conformità implica:
Sicurezza e conformità possono essere l'ultima cosa a cui un ingegnere vuole pensare, ma stanno diventando sempre più importanti. Il corso Understanding GDPR, insieme agli altri suggeriti in questo articolo, ti metterà al passo.
Descrizione: questa domanda esplora le strategie per gestire e ottimizzare i costi cloud legati al training e al deployment di modelli ML, valutando la conoscenza delle tecniche di cost management.
Risposta: le strategie per gestire i costi cloud includono:
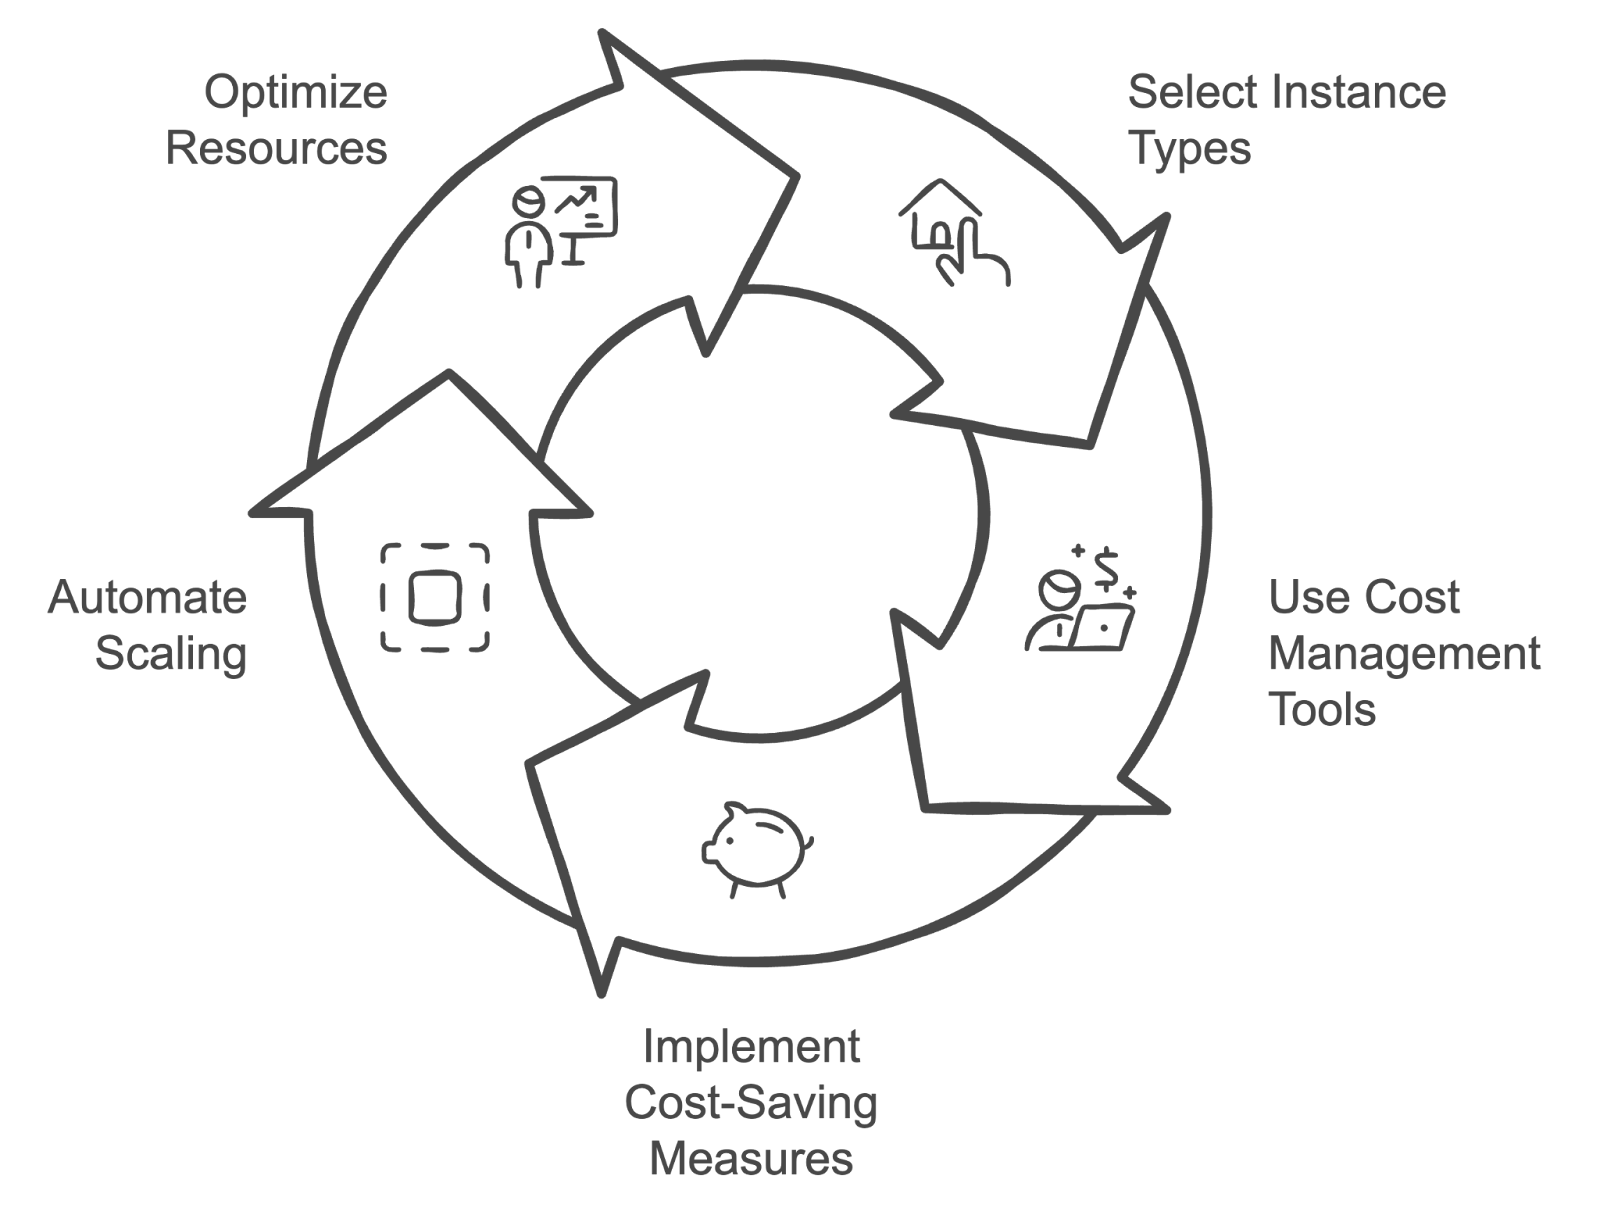
Ciclo di gestione dei costi cloud. Immagine dell'autore creata con napkin.ai
Descrizione: questa domanda esplora la comprensione dei compromessi tra la distribuzione di modelli su dispositivi edge e sul cloud.
Risposta: il deployment su cloud prevede l'esecuzione dei modelli su server centralizzati, offrendo scalabilità e manutenzione più semplice ma con potenziali problemi di latenza.
Il deployment edge prevede l'esecuzione dei modelli direttamente su dispositivi come smartphone o IoT, riducendo la latenza e migliorando la privacy dei dati, ma può essere limitato dalle risorse computazionali. L'edge è ideale per applicazioni in tempo reale, mentre il cloud è più adatto a modelli che richiedono potenza computazionale e flessibilità significative.
Descrizione: questa domanda valuta la conoscenza nella costruzione di sistemi resilienti per il deployment dei modelli di machine learning.
Risposta: garantire alta disponibilità implica distribuire i modelli su più zone o regioni di disponibilità e configurare meccanismi di failover automatico.
I load balancer possono distribuire il traffico per evitare colli di bottiglia. Per la tolleranza ai guasti, backup regolari, ridondanza e health check possono prevenire i malfunzionamenti. Sfruttare servizi cloud come AWS Elastic Load Balancing e le funzionalità di autoscaling aiuta anche ad assicurare che, se un'istanza fallisce, le altre subentrino senza downtime.
Questa sezione approfondisce gli aspetti comportamentali e di problem solving delle MLOps, valutando come i candidati affrontano sfide reali, collaborano con i team e gestiscono varie questioni nella distribuzione e gestione dei modelli di machine learning.
Descrizione: questa domanda valuta le capacità di problem solving in scenari reali.
Risposta di esempio: "C'è stata una situazione in cui un modello distribuito in produzione ha iniziato a mostrare un notevole calo delle prestazioni. Il primo passo è stato analizzare log e metriche del modello per identificare anomalie. È emerso che la pipeline dati stava fornendo dati con struttura cambiata a causa di aggiornamenti recenti nei sistemi sorgente.
Il passo successivo è stato validare i dati rispetto all'input atteso dal modello e verificare discrepanze. Dopo aver confermato il problema dei dati, ho coordinato con il team di data engineering per correggere la pipeline. Quindi ho distribuito un hotfix per aggiornare la gestione degli input corretti nel modello.
Infine, ho monitorato da vicino il modello dopo la distribuzione per assicurarmi che le prestazioni tornassero ai livelli attesi e ho comunicato risultati e risoluzione agli stakeholder."
Descrizione: questa domanda valuta l'approccio alla gestione di diverse versioni dei modelli di machine learning quando si lavora in team.
Risposta di esempio: “Uso sistemi di version control come MLflow o DVC per gestire e tracciare le diverse versioni dei modelli. A ogni versione assegno un identificatore univoco e fornisco una documentazione dettagliata per ogni aggiornamento, in modo che i membri del team comprendano le modifiche.
Inoltre, mi assicuro che i nuovi modelli siano testati a fondo in un ambiente di staging prima della produzione, il che aiuta a evitare interruzioni e a mantenere le prestazioni.”
Descrizione: questa domanda valuta la capacità di lavorare efficacemente con team diversi, come data scientist, ingegneri e product manager, e come navighi e risolvi le sfide in un contesto cross-funzionale.
Risposta di esempio: "Una situazione impegnativa ha riguardato il coordinamento tra data scientist, ingegneri e product manager per distribuire un nuovo modello con dipendenze complesse. La chiave della collaborazione efficace è stata stabilire fin da subito canali di comunicazione chiari.
Sono state programmate riunioni regolari per allinearci sugli obiettivi, tracciare i progressi e affrontare gli ostacoli. Per colmare gap di conoscenza, ho facilitato sessioni di condivisione in cui ciascuno poteva discutere la propria area di competenza.
Inoltre, l'uso di strumenti di project management per tracciare task e milestone ha aiutato a tenere tutti aggiornati sullo stato del progetto. Questo approccio ha assicurato che il contributo di ciascuno fosse considerato e che lavorassimo insieme verso una distribuzione di successo."
Descrizione: questa domanda esplora le strategie per scalare i modelli ML per soddisfare una domanda crescente, valutando la comprensione degli aspetti tecnici e operativi della scalabilità.
Risposta di esempio: "Scalare i modelli ML per gestire un carico utenti maggiore comporta alcuni passaggi critici.
Per prima cosa, analizzerei le metriche di performance del modello attuale per individuare eventuali colli di bottiglia. Per gestire l'aumento della domanda, sfrutterei soluzioni cloud di auto-scaling per adeguare dinamicamente le risorse in base al traffico.
Inoltre, ottimizzarei il modello stesso con tecniche come quantization o pruning per ridurre il consumo di risorse senza sacrificare le prestazioni.
Implementerei anche test di carico per simulare traffico elevato e garantire la robustezza del sistema.
E, ultimo ma non meno importante, attiverei un monitoraggio continuo per restare aggiornato sulle prestazioni del modello, così da poter regolare l'allocazione delle risorse secondo necessità e mantenere le performance con carichi variabili.”
Descrizione: questa domanda valuta la capacità di gestire comunicazione e aspettative quando un modello non offre i risultati attesi.
Risposta di esempio: "Quando le prestazioni non soddisfano le aspettative, punto su una comunicazione trasparente con gli stakeholder. Spiego i limiti del modello e i motivi delle sue prestazioni, che si tratti di problemi di qualità dei dati, overfitting o aspettative iniziali irrealistiche.
Poi lavoro con loro per fissare obiettivi più realistici, fornisco insight basati sui dati e propongo miglioramenti, come raccogliere più dati di training o modificare l'architettura del modello."
Descrizione: questa domanda valuta la capacità di dare priorità tra il mantenimento della qualità del codice nel lungo periodo e il rispetto delle scadenze a breve termine.
Risposta di esempio: "In un'occasione avevamo una scadenza serrata per distribuire un modello a supporto di una nuova funzionalità. Abbiamo dato priorità alla consegna rapida saltando alcune parti non critiche della codebase, come la documentazione completa e i test non essenziali.
Dopo il rilascio, abbiamo dedicato tempo a rivedere la codebase e affrontare questi aspetti, riducendo il debito tecnico nel post-lancio. Questo ci ha permesso di rispettare la scadenza mantenendo la stabilità del progetto nel lungo periodo."
Prepararsi a un colloquio MLOps richiede una combinazione di conoscenze tecniche, comprensione dell'ambiente dell'azienda e una comunicazione chiara delle esperienze passate. Ecco alcuni consigli essenziali per aiutarti a prepararti:
Assicurati di avere una solida padronanza dei concetti core delle MLOps. Familiarizza con strumenti e piattaforme popolari usati nelle MLOps, come MLflow, Kubernetes e servizi cloud come AWS SageMaker o Google AI Platform.
La MLOps skill track è la risorsa perfetta perché contiene quattro corsi rilevanti che ti assicurano di essere aggiornato su concetti e pratiche MLOps.
Ricerca le tecnologie e gli strumenti specifici usati dall'azienda con cui sosterrai il colloquio. Capire il loro stack tecnologico ti aiuterà a calibrare le risposte in linea con il loro ambiente e a dimostrare che sei un buon fit. Informati sui servizi cloud preferiti, i sistemi di version control e le pratiche di gestione dei modelli per mostrare che sei pronto a integrarti senza intoppi nel loro workflow.
Sii pronto a discutere progetti o esperienze specifiche in cui hai applicato pratiche MLOps. Prepara esempi che evidenzino le tue capacità di problem solving, la capacità di lavorare con team cross-funzionali e l'esperienza con il deployment e lo scaling di modelli (se possibile). Usa questi esempi per illustrare la tua conoscenza pratica e come hai affrontato con successo le sfide in ruoli precedenti.
Esercitati regolarmente con esercizi di coding relativi alle MLOps, come scrivere script per il deployment dei modelli, automatizzare workflow o sviluppare data pipeline.
Il campo delle MLOps evolve rapidamente, quindi è importante restare aggiornato su trend, strumenti e best practice più recenti. Segui blog di settore, partecipa a forum o webinar pertinenti e coinvolgiti nella community MLOps per mantenere le tue conoscenze attuali e rilevanti.
Le MLOps sono un campo che colma il divario tra data science e operations, assicurando che i modelli di machine learning vengano distribuiti, mantenuti e scalati in modo efficace.
In questo post abbiamo trattato un ventaglio di domande di colloquio che spaziano dai concetti generali MLOps, agli aspetti tecnici, alle considerazioni su cloud e infrastruttura, fino alle competenze comportamentali di problem solving. Esercitarti con queste domande aumenterà significativamente le possibilità di successo durante i colloqui e ti darà più chance di ottenere il lavoro!
Consulta le seguenti risorse per continuare a imparare:
Scopri di più su MLOps con questi corsi!
Corso
Corso
Pratica and corso your progress.
Continua Con Googleblog
Abid Ali Awan
15 min
blog
Abid Ali Awan
10 min
blog
Tim Lu
12 min



