
Pertanyaan Wawancara MLOps Dasar
Di bagian ini, kita akan mengeksplorasi pertanyaan wawancara MLOps mendasar yang menilai pemahaman Anda tentang konsep dan prinsip inti. Pertanyaan-pertanyaan ini dirancang untuk menguji pengetahuan Anda tentang tanggung jawab dan tantangan dasar MLOps serta kemampuan Anda menyampaikan pengetahuan tersebut secara efektif.
Kenali pertanyaan-pertanyaan ini untuk membangun fondasi yang kuat sebagai persiapan menuju topik yang lebih lanjut dan untuk menunjukkan kompetensi Anda di bidang ini.
Apa perbedaan antara MLOps dan DevOps?
Deskripsi: Pertanyaan ini menguji pemahaman Anda tentang perbedaan mendasar antara MLOps dan DevOps, yang sering kali tertukar.
Jawaban: MLOps dan DevOps sama-sama berfokus pada kolaborasi, tetapi memiliki tujuan yang berbeda. DevOps berpusat pada otomatisasi pengembangan, pengujian, dan penerapan aplikasi perangkat lunak, menstandardisasi lingkungan untuk merampingkan proses tersebut.
Sebaliknya, MLOps disesuaikan dengan alur kerja machine learning, dengan penekanan pada pengelolaan dan pemeliharaan pipeline data dan model. Sementara DevOps bertujuan mengotomatisasi tugas rutin dan menstandardisasi penerapan aplikasi, MLOps menangani sifat eksperimental machine learning, termasuk tugas seperti validasi data, evaluasi kualitas model, dan validasi model yang berkelanjutan.
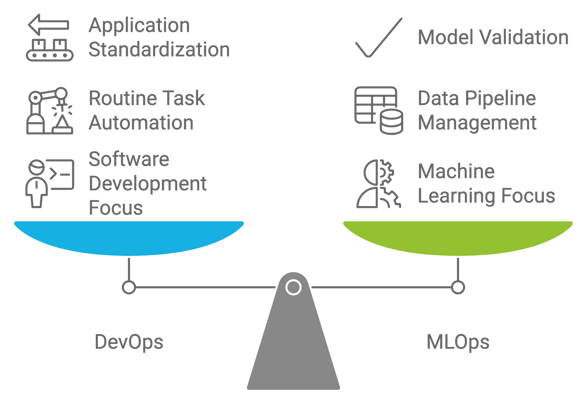
Membandingkan dan mengontraskan DevOps dan MLOps. Gambar oleh penulis dibuat dengan napkin.ai
Apa itu model drift atau concept drift?
Deskripsi: Pertanyaan ini mengevaluasi pengetahuan Anda tentang dampak perubahan data terhadap akurasi model dan pentingnya pemantauan serta pembaruan model.
Jawaban: Model drift dan concept drift mengacu pada perubahan kinerja model machine learning dari waktu ke waktu akibat pola data dan hubungan yang mendasarinya berkembang:
- Model drift: Terjadi ketika kinerja model memburuk karena data yang ditemui di produksi menyimpang dari data pelatihan. Ini bisa terjadi akibat perubahan distribusi data, fitur, atau hubungan antara fitur dan variabel target. Misalnya, model yang dilatih pada data finansial historis dapat berkinerja buruk jika terjadi perubahan ekonomi yang tiba-tiba.
- Concept drift: Ini adalah jenis model drift tertentu ketika distribusi atau hubungan yang mendasari antara fitur masukan dan variabel target berubah. Drift ini dapat membuat prediksi model menjadi kurang akurat karena asumsi model terhadap data tidak lagi berlaku. Sebagai contoh, jika model memprediksi churn pelanggan berdasarkan perilaku historis, model mungkin perlu diperbarui jika perilaku pelanggan berubah signifikan seiring waktu.
Pengujian apa yang harus dilakukan sebelum menerapkan model ML ke produksi?
Deskripsi: Pertanyaan ini menilai pengetahuan Anda tentang praktik pengujian untuk memastikan model machine learning andal dan berkinerja baik sebelum diterapkan ke lingkungan produksi.
Jawaban: Ada sejumlah pengujian yang harus dilakukan sebelum menerapkan model ML ke produksi. Tabel ini memberikan gambaran komprehensif dari setiap jenis pengujian, termasuk tujuan, alat yang digunakan, dan kapan pengujian harus diterapkan selama siklus pengembangan machine learning:
|
Jenis pengujian |
Tujuan |
Alat yang digunakan |
Kapan digunakan |
|
Unit testing |
Memverifikasi komponen model individual, seperti langkah prapemrosesan dan fungsi ekstraksi fitur. |
PyTest, unittest, scikit-learn (untuk transformasi) |
Selama pengembangan, saat mengimplementasikan atau memperbarui komponen model. |
|
Integration testing |
Memastikan model berinteraksi dengan benar dengan komponen sistem lain dan sumber data di lingkungan produksi. |
Docker, Kubernetes, Jenkins, Apache Kafka |
Setelah unit testing, saat menerapkan model ke lingkungan mirip produksi. |
|
Performance testing |
Mengevaluasi akurasi, presisi, recall, dan metrik relevan lainnya menggunakan dataset validasi. |
Scikit-learn, TensorFlow, PyTorch, MLflow |
Setelah integration testing, untuk memastikan model memenuhi standar kinerja yang diharapkan. |
|
Stress testing |
Menilai bagaimana model menangani beban tinggi dan volume data besar, memastikan skalabilitas. |
Apache JMeter, Locust, Dask |
Sebelum penerapan di lingkungan dengan volume data tinggi atau saat skalabilitas menjadi perhatian. |
|
A/B testing |
Membandingkan kinerja model dengan model yang ada atau metrik baseline di lingkungan live. |
Optimizely, SciPy, Google Optimize |
Pasca penerapan, saat memvalidasi kinerja model di produksi dan mengoptimalkan versi model. |
|
Robustness testing |
Memastikan model tangguh terhadap anomali data dan kasus tepi. |
Pustaka adversarial robustness (mis., CleverHans), skrip kustom |
Setelah performance testing, untuk mengonfirmasi keandalan dalam kondisi abnormal atau tak terduga. |
Apa pentingnya version control untuk MLOps?
Deskripsi: Pertanyaan ini mengevaluasi pemahaman Anda tentang peran dan pentingnya version control dalam praktik MLOps. Fokusnya pada bagaimana mengelola berbagai versi model, data, dan kode berkontribusi pada penerapan dan pemeliharaan model yang efektif.
Jawaban: Version control sangat penting dalam MLOps karena membantu mengelola dan melacak perubahan pada model, dataset, dan kode sepanjang siklus hidupnya. Menggunakan sistem version control seperti Git untuk kode dan alat seperti DVC (Data Version Control) untuk dataset dan model memastikan semua perubahan terdokumentasi dan dapat dibatalkan.
Praktik ini mendukung reprodusibilitas, memfasilitasi kolaborasi antar anggota tim, dan memungkinkan rollback mudah ke versi sebelumnya jika terjadi masalah. Ini memastikan konsistensi dan keandalan kinerja model, yang penting untuk menjaga kualitas penerapan.
Untuk mempelajari lebih lanjut konsep ini, tinjau Panduan Lengkap Data Version Control (DVC). Panduan ini akan mempersiapkan Anda untuk jenis pertanyaan seperti ini saat wawancara!
Apa saja cara untuk memaketkan Model ML?
Deskripsi: Pertanyaan ini bertujuan menilai pengetahuan Anda tentang berbagai metode untuk memaketkan model machine learning agar siap diterapkan. Ini menguji pemahaman Anda tentang cara mempersiapkan model untuk diintegrasikan ke berbagai lingkungan dan aplikasi.
Jawaban: Ada beberapa cara efektif untuk memaketkan model machine learning:
- Container: Dengan alat seperti Docker, model dapat dikemas bersama dependensi dan pengaturan lingkungannya ke dalam sebuah container. Ini memastikan model berjalan konsisten di berbagai sistem dan lingkungan.
- Serialisasi: Model dapat diserialisasi ke format seperti file pickle (.pkl) untuk Python, atau file joblib. Metode ini menyimpan objek model terlatih, sehingga dapat dimuat dan digunakan kembali nanti.
- Arsip model: Alat seperti format SavedModel dari TensorFlow atau ONNX (Open Neural Network Exchange) menyediakan cara baku untuk menyimpan model, sehingga dapat saling bekerja antar berbagai framework dan platform.
- API: Menerapkan model sebagai API RESTful atau gRPC memungkinkan model diakses melalui jaringan. Pendekatan ini memaketkan model menjadi sebuah layanan yang dapat diintegrasikan dengan aplikasi lain.
- Fungsi serverless: Platform seperti AWS Lambda atau Google Cloud Functions dapat digunakan untuk memaketkan model menjadi fungsi serverless, memungkinkan eksekusi sesuai permintaan tanpa mengelola infrastruktur.
Cara yang bagus untuk mempelajari lebih lanjut tentang pemaketan model adalah membiasakan diri dengan kontainerisasi. Docker adalah alat mendasar yang harus diketahui setiap insinyur MLOps. Untuk menyegarkan pengetahuan Anda, kunjungi kursus Introduction to Docker.
Mengapa pemantauan penting dalam MLOps, dan metrik apa yang harus Anda lacak?
Deskripsi: Pertanyaan ini mengevaluasi pengetahuan Anda tentang pemantauan model di produksi dan pemahaman metrik mana yang krusial untuk memastikan kinerja dan keandalan berkelanjutan.
Jawaban: Pemantauan sangat penting dalam MLOps untuk memastikan model terus berkinerja sesuai harapan di produksi. Metrik yang perlu dilacak meliputi akurasi, presisi, recall, dan indikator kinerja lainnya untuk mendeteksi degradasi model.
Pemantauan data drift juga krusial, karena perubahan pola data dapat memengaruhi prediksi model. Selain itu, metrik infrastruktur seperti latensi dan penggunaan sumber daya (mis., CPU, memori) membantu memastikan sistem tetap dapat diskalakan dan responsif.
Apa saja masalah umum dalam penerapan model ML?
Deskripsi: Pertanyaan ini menilai pemahaman Anda tentang potensi hambatan dan cara mengatasinya untuk memastikan penerapan model yang sukses.
Jawaban: Masalah umum dalam penerapan model ML meliputi:
- Model drift: Seiring waktu, kinerja model dapat menurun karena perubahan pola atau hubungan data. Karena itu, model memerlukan pemantauan dan pelatihan ulang berkelanjutan untuk menjaga akurasi.
- Kualitas dan kompatibilitas data: Memastikan data di produksi sesuai kualitas dan format dengan data pelatihan sangat penting. Data yang tidak konsisten atau berkualitas buruk dapat menyebabkan kinerja model tidak andal.
- Skalabilitas: Model perlu menangani beban yang bervariasi dan volume data besar secara efisien. Infrastruktur yang tidak memadai atau model yang kurang optimal dapat menyebabkan kemacetan kinerja dan waktu respons lambat.
- Masalah integrasi: Model harus terintegrasi dengan baik dengan sistem dan aplikasi yang ada. Tantangan integrasi dapat muncul karena perbedaan format data, antarmuka, atau kompatibilitas infrastruktur.
- Keamanan dan privasi: Sangat penting memastikan model dan data terlindungi dari akses tidak sah dan pelanggaran. Kekhawatiran keamanan mencakup perlindungan data sensitif dan pengelolaan kontrol akses.
Semua pemberi kerja mencari keterampilan pemecahan masalah, terutama dalam menangani data pada peran seperti MLOps. Untuk mengejar ketertinggalan pada dua topik yang sangat penting di era ML, lihat kursus Introduction to Data Quality dan Introduction to Data Security.
Apa perbedaan antara strategi penerapan Canary dan Blue-Green?
Deskripsi: Pertanyaan ini menguji kemampuan Anda membedakan metode penerapan Canary dan Blue-Green serta manfaatnya untuk meluncurkan perubahan baru.
Jawaban: Strategi penerapan Canary dan Blue-Green sama-sama digunakan untuk mengelola peluncuran pembaruan, namun berbeda dalam pendekatannya:
- Canary deployment: Strategi ini melibatkan merilis versi baru aplikasi ke sebagian kecil pengguna terlebih dahulu sebelum meluncurkannya ke seluruh basis pengguna. Istilah "Canary" mengacu pada praktik menggunakan sampel kecil yang representatif untuk menguji rilis baru dan memantau kinerja serta dampaknya. Jika versi baru berkinerja baik dan tidak muncul masalah kritis, peluncuran diperluas secara bertahap ke pengguna lainnya. Pendekatan ini membantu mengurangi risiko dengan memungkinkan tim mengidentifikasi dan mengatasi masalah sejak dini.
- Blue-Green deployment: Dalam strategi ini, dua lingkungan produksi yang identik, disebut "Blue" dan "Green", dipelihara. Pada satu waktu, satu lingkungan (mis., Blue) aktif dan melayani seluruh trafik, sementara yang lain (mis., Green) idle atau digunakan untuk staging. Ketika versi baru siap, versi tersebut diterapkan ke lingkungan idle (Green). Setelah versi baru diuji dan diverifikasi menyeluruh, trafik dialihkan dari lingkungan lama (Blue) ke yang baru (Green). Pendekatan ini meminimalkan downtime dan memungkinkan rollback cepat jika terjadi masalah.
Kedua strategi bertujuan mengurangi risiko penerapan dan downtime, namun Canary menekankan rilis bertahap dan paparan gradual, sementara Blue-Green memastikan perpindahan yang mulus antar lingkungan.
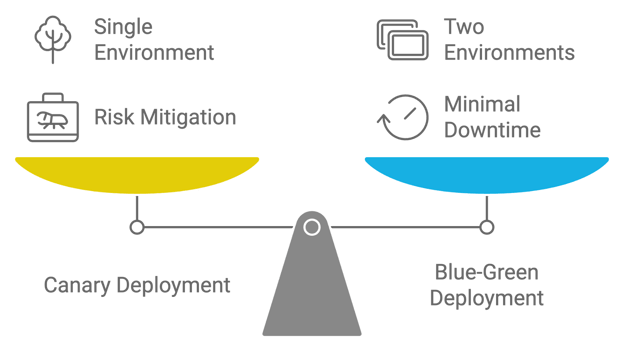
Membandingkan strategi penerapan: Canary versus Blue-Green. Gambar oleh penulis dibuat dengan napkin.ai
Bagaimana pendekatan Anda mengotomatiskan pelatihan ulang model dalam pipeline MLOps?
Deskripsi: Pertanyaan ini menguji pengetahuan Anda tentang strategi dan alat yang digunakan untuk mengotomatiskan pelatihan ulang model saat data baru tersedia.
Jawaban: Mengotomatiskan pelatihan ulang model dalam MLOps melibatkan penyiapan pipeline yang memicu pelatihan ulang ketika kondisi tertentu terpenuhi, seperti degradasi kinerja atau ketersediaan data baru.
Alat seperti Airflow atau Kubeflow dapat mengorkestrasi alur kerja tersebut, mengotomatiskan tugas seperti ingest data, rekayasa fitur, pelatihan model, dan evaluasi. Pemantauan berkelanjutan penting untuk memastikan model memenuhi ambang kinerja sebelum diterapkan, dan alat versioning seperti DVC membantu melacak berbagai versi model selama pelatihan ulang.
Pertanyaan Wawancara MLOps Teknis
Di bagian ini, kita akan membahas pertanyaan wawancara MLOps teknis yang menilai keterampilan praktis dan pemahaman Anda tentang konsep tingkat lanjut.
Pertanyaan-pertanyaan ini berfokus pada aspek teknis penerapan, pengelolaan, dan pengoptimalan model machine learning, dan dirancang untuk mengevaluasi kemahiran Anda dengan alat, teknik, dan praktik terbaik di bidang ini.
Bagaimana Anda akan mengimplementasikan pipeline CI/CD untuk model machine learning?
Deskripsi: Pertanyaan ini menguji pengetahuan Anda dalam menyiapkan pipeline CI/CD khusus untuk alur kerja machine learning. Ini menilai kemampuan Anda mengotomatiskan proses penerapan dan mengelola pembaruan model secara efisien.
Jawaban: Mengimplementasikan CI/CD untuk model machine learning melibatkan penyiapan pipeline yang mengotomatiskan proses dari perubahan kode hingga penerapan.
Sebagai contoh, Anda dapat menggunakan Jenkins atau GitHub Actions untuk memicu build dan pengujian setiap kali ada perubahan pada kode model atau data. Pipeline mencakup tahapan seperti:
- Build: Kompilasi dan paketkan kode serta artefak model.
- Test: Jalankan unit test, integration test, dan pemeriksaan validasi model.
- Deploy: Otomatiskan penerapan ke lingkungan staging atau produksi.
- Monitor: Pantau terus kinerja model dan data untuk mendeteksi anomali.
Dengan mengotomatiskan tahapan ini, Anda memastikan model diperbarui secara konsisten dan andal dengan intervensi manual minimal.
Jika Anda perlu meningkatkan pengetahuan CI/CD, ikuti kursus CI/CD for Machine Learning. Kursus ini akan membuat Anda bersinar saat wawancara!
Apa praktik terbaik untuk mengelola data dalam MLOps?
Deskripsi: Pertanyaan ini berfokus pada pemahaman Anda tentang praktik pengelolaan data yang efektif dalam MLOps. Ini menilai kemampuan Anda menangani kualitas, versioning, dan pengorganisasian data untuk mendukung alur kerja machine learning yang tangguh dan andal.
Jawaban: Praktik terbaik untuk mengelola data dalam MLOps meliputi:
- Versioning data: Gunakan alat seperti DVC (Data Version Control) atau Git-LFS untuk melacak dan mengelola perubahan pada dataset. Ini memastikan reprodusibilitas dan memudahkan rollback ke versi data sebelumnya jika diperlukan.
- Kualitas data: Terapkan validasi dan pembersihan data yang ketat untuk memastikan data berkualitas tinggi. Ini mencakup pemeriksaan nilai hilang, outlier, dan inkonsistensi sebelum melatih model.
- Keamanan data: Lindungi data sensitif dengan menerapkan kontrol akses dan enkripsi. Pastikan kepatuhan terhadap regulasi privasi data dan lindungi dari akses tidak sah.
- Pipeline data: Otomatiskan ingest, prapemrosesan, dan transformasi data menggunakan alat seperti Apache Airflow atau Prefect. Ini memastikan data disiapkan secara konsisten dan tersedia untuk pelatihan dan evaluasi.
- Pemantauan data: Pantau data secara berkelanjutan untuk mendeteksi drift dan anomali. Implementasi solusi pemantauan membantu mendeteksi perubahan distribusi data yang dapat memengaruhi kinerja model.
- Dokumentasi: Pertahankan dokumentasi yang jelas tentang sumber data, transformasi, dan langkah prapemrosesan. Ini mendukung reprodusibilitas dan membantu memahami pipeline data serta dampaknya terhadap hasil model.
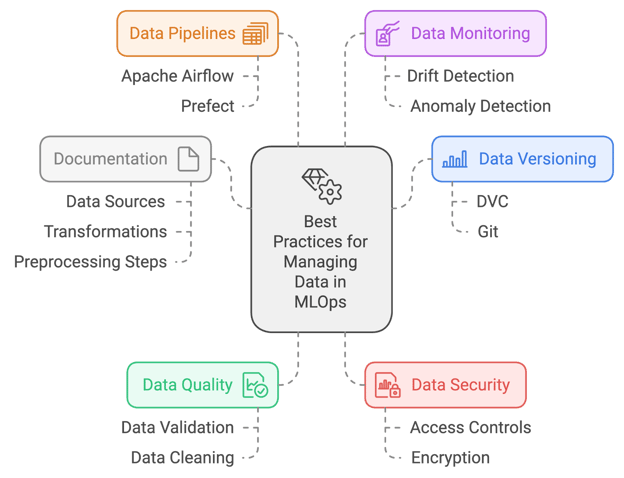
Praktik terbaik pengelolaan data. Gambar oleh penulis dibuat dengan napkin.ai
Bagaimana Anda menangani feature engineering dan prapemrosesan dalam pipeline MLOps?
Deskripsi: Pertanyaan ini mengevaluasi bagaimana Anda mengintegrasikan proses ini ke dalam alur kerja otomatis.
Jawaban: Menangani feature engineering dan prapemrosesan dalam pipeline MLOps melibatkan otomatisasi langkah-langkah ini untuk memastikan konsistensi dan reprodusibilitas. Anda dapat menggunakan alat seperti Apache Airflow atau Prefect untuk membuat pipeline data yang melakukan tugas seperti:
- Pembersihan data: Menghapus nilai hilang dan outlier.
- Ekstraksi fitur: Membuat fitur baru dari data mentah.
- Normalisasi: Menskalakan fitur ke rentang yang konsisten.
- Transformasi: Menerapkan transformasi seperti penyandian variabel kategorikal.
Bagaimana Anda mengimplementasikan pemantauan model di lingkungan produksi?
Deskripsi: Pertanyaan ini menilai pemahaman Anda tentang cara melacak dan memastikan kinerja serta keandalan model yang berkelanjutan, termasuk alat dan strategi yang Anda gunakan untuk pemantauan efektif.
Jawaban: Mengimplementasikan pemantauan model di lingkungan produksi melibatkan beberapa praktik untuk menjamin bahwa model berkinerja sesuai harapan dan tetap andal dari waktu ke waktu:
- Menetapkan metrik kinerja: Mulailah dengan mengidentifikasi metrik penting yang mencerminkan kinerja model, seperti akurasi, presisi, recall, dan latensi. Metrik ini akan memandu upaya pemantauan dan membantu menilai efektivitas model.
- Menyiapkan alat pemantauan: Gunakan alat dan platform pemantauan, seperti Prometheus dan Grafana atau solusi cloud-native, untuk melacak dan memvisualisasikan metrik ini secara real time. Pengaturan ini memungkinkan Anda memantau kinerja model secara berkelanjutan.
- Mengonfigurasi peringatan: Tetapkan peringatan berdasarkan metrik kinerja. Tetapkan ambang yang memicu notifikasi jika kinerja model menurun atau jika terdeteksi anomali, memastikan setiap masalah segera ditangani.
- Menerapkan logging: Terapkan logging yang komprehensif untuk menangkap informasi terperinci tentang prediksi model, interaksi sistem, dan kesalahan apa pun. Data ini penting untuk pemecahan masalah dan memahami perilaku model.
- Menganalisis dan bertindak: Secara rutin tinjau data kinerja dan log yang dikumpulkan untuk mengidentifikasi tren, masalah, atau area yang perlu ditingkatkan. Gunakan analisis ini untuk mengambil keputusan terkait penyesuaian atau pelatihan ulang model agar efektivitasnya tetap terjaga di produksi.
Kursus Machine Learning Monitoring akan membantu Anda memahami detail untuk menjawab pertanyaan seperti ini!
Bagaimana Anda memastikan reprodusibilitas eksperimen dalam machine learning?
Deskripsi: Pertanyaan ini mengeksplorasi pendekatan Anda untuk memastikan eksperimen machine learning dapat direplikasi secara konsisten. Ini menilai pemahaman Anda tentang praktik yang mendukung reprodusibilitas.
Jawaban: Memastikan reprodusibilitas eksperimen machine learning melibatkan:
- Version control: Gunakan sistem version control seperti Git untuk kode dan DVC untuk data guna melacak dan mengelola perubahan dalam eksperimen.
- Manajemen lingkungan: Gunakan alat seperti Conda atau Docker untuk membuat dan mengelola lingkungan pengembangan dan runtime yang konsisten.
- Seed randomness: Tetapkan seed acak untuk algoritma dan pembagian data agar hasil konsisten di berbagai run.
- Dokumentasi: Pertahankan dokumentasi terperinci tentang pengaturan eksperimen, parameter, dan konfigurasi untuk mendukung reprodusibilitas dan memfasilitasi replikasi.
Apa tantangan dalam mengoperasionalkan model machine learning?
Deskripsi: Pertanyaan ini menilai pemahaman Anda tentang tantangan unik saat membawa model machine learning dari pengembangan ke lingkungan produksi.
Jawaban: Mengoperasionalkan model machine learning menghadirkan sejumlah tantangan. Salah satu kesulitannya adalah memastikan konsistensi antara lingkungan pengembangan dan produksi, yang dapat menimbulkan masalah reprodusibilitas.
Data drift juga menjadi perhatian, karena data di produksi dapat berubah seiring waktu sehingga menurunkan akurasi model.
Selain itu, mengintegrasikan model ke sistem yang ada, memantau kinerjanya, dan mengotomatiskan alur kerja pelatihan ulang sering kali merupakan tugas yang kompleks yang membutuhkan kolaborasi efektif antara tim data science dan rekayasa.
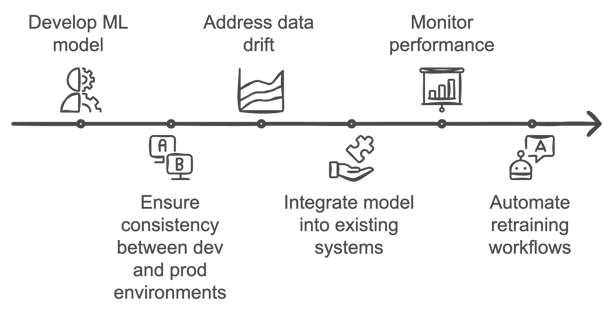
Mengatasi tantangan dalam mengoperasionalkan model ML. Gambar oleh penulis dibuat dengan napkin.ai
Bagaimana Anda mengimplementasikan pelatihan ulang model dalam pipeline MLOps yang otomatis
Deskripsi: Pertanyaan ini mengevaluasi pemahaman Anda tentang otomatisasi pelatihan ulang model saat data baru tersedia atau kinerja model menurun.
Jawaban: Mengimplementasikan pelatihan ulang otomatis melibatkan penyiapan pipeline yang memantau kinerja model dan data drift. Ketika akurasi model turun di bawah ambang atau saat data baru tersedia, alat seperti Apache Airflow atau Kubeflow dapat memicu pelatihan ulang.
Pelatihan ulang mencakup pengambilan data baru, prapemrosesan, melatih model dengan hyperparameter yang sama atau diperbarui, dan memvalidasi model baru. Setelah pelatihan ulang, model yang diperbarui secara otomatis diterapkan ke produksi.
Alat apa yang Anda gunakan untuk explainability model, dan mengapa itu penting?
Deskripsi: Pertanyaan ini menguji pengetahuan Anda tentang interpretabilitas model dan bagaimana Anda memastikan transparansi dalam prediksi model.
Jawaban: Alat seperti SHAP (SHapley Additive exPlanations) atau LIME (Local Interpretable Model-agnostic Explanations) umum digunakan untuk explainability model.
Alat ini membantu menguraikan prediksi model dengan menunjukkan kontribusi masing-masing fitur. Explainability penting dalam MLOps karena membangun kepercayaan dengan pemangku kepentingan dan memastikan model mematuhi regulasi, terutama di industri seperti keuangan dan kesehatan. Ini juga membantu mengidentifikasi potensi bias atau masalah terkait data dalam model.
Pertanyaan Wawancara MLOps tentang Cloud dan Infrastruktur
Bagian ini mencakup pertanyaan wawancara yang berfokus pada aspek cloud dan infrastruktur MLOps. Pertanyaan-pertanyaan ini menilai keahlian Anda dalam menerapkan, mengelola, dan menskalakan model machine learning di lingkungan cloud.
Bagaimana Anda menerapkan model ML di cloud?
Deskripsi: Pertanyaan ini menilai pengetahuan Anda tentang penerapan model machine learning di lingkungan cloud. Ini menilai pemahaman Anda tentang platform cloud, proses penerapan, dan alat yang digunakan untuk mengelola model di cloud.
Jawaban: Menerapkan model ML di cloud melibatkan langkah-langkah berikut:
- Pemaketan model: Kemasi model beserta dependensi dan konfigurasinya.
- Unggah dan terapkan: Unggah paket ke layanan cloud seperti AWS SageMaker, Google AI Platform, atau Azure Machine Learning. Gunakan alat penerapan layanan tersebut untuk membuat endpoint atau layanan guna mengakses model.
- Konfigurasi: Atur auto-scaling untuk menangani beban yang bervariasi dan konfigurasikan langkah keamanan, termasuk kontrol akses dan enkripsi.
- Pemantauan: Pantau terus kinerja model menggunakan alat berbasis cloud untuk memastikan model memenuhi tujuan kinerja dan untuk mendeteksi masalah sejak dini.
Apa manfaat dan tantangan menggunakan arsitektur serverless untuk penerapan model ML?
Deskripsi: Pertanyaan ini mengeksplorasi pemahaman tentang komputasi serverless dan penerapannya dalam penerapan model ML, menilai kemampuan menimbang manfaat terhadap tantangan.
Jawaban: Arsitektur serverless menawarkan beberapa manfaat, termasuk pengurangan beban operasional karena tidak perlu mengelola server, serta penskalaan otomatis berdasarkan permintaan real-time, yang dapat menghasilkan penghematan biaya karena biaya didasarkan pada penggunaan komputasi aktual.
Namun, ada juga tantangan terkait arsitektur serverless. Misalnya, ada batasan waktu eksekusi dan alokasi sumber daya yang mungkin tidak cocok untuk semua jenis model ML, terutama yang membutuhkan komputasi tinggi.
Latensi cold start juga bisa menjadi masalah, di mana permintaan awal setelah periode tidak aktif mungkin mengalami penundaan. Terlepas dari tantangan tersebut, arsitektur serverless bisa sangat efektif untuk beban kerja tertentu jika faktor-faktor ini dikelola dengan tepat.
Cara lain untuk melihat ini adalah melalui tabel yang merangkum kelebihan dan kekurangan arsitektur serverless berdasarkan aspek tertentu:
|
Aspek |
Kelebihan serverless |
Kekurangan serverless |
|
Beban operasional |
Tidak perlu pengelolaan server; kompleksitas infrastruktur berkurang. |
Memerlukan pengetahuan platform cloud untuk mengelola lingkungan serverless. |
|
Skalabilitas |
Penskalaan otomatis berdasarkan permintaan real-time, menghasilkan efisiensi biaya. |
Dapat sulit diprediksi untuk penganggaran jika penskalaan sering terjadi. |
|
Efisiensi biaya |
Bayar hanya untuk sumber daya yang digunakan, berpotensi mengurangi biaya. |
Dapat menjadi mahal jika banyak fungsi sering dipanggil atau berdurasi lama. |
|
Batas eksekusi |
Cocok untuk tugas ringan atau berdurasi singkat. |
Dibatasi oleh waktu eksekusi dan alokasi sumber daya, mungkin tidak menangani model ML yang intensif sumber daya. |
|
Cold start |
Mengurangi beban operasional dengan penskalaan sesuai permintaan. |
Penundaan cold start dapat terjadi setelah periode tidak aktif, memengaruhi aplikasi yang sensitif terhadap latensi. |
|
Kecocokan model ML |
Bekerja baik untuk tugas ML skala kecil, inferensi, atau pemrosesan batch. |
Model ML berkomputasi tinggi dengan tugas berdurasi lama tidak cocok. |
Bagaimana Anda mengelola sumber daya komputasi untuk pelatihan model ML di lingkungan cloud?
Deskripsi: Pertanyaan ini menilai strategi Anda untuk mengoptimalkan dan mengelola sumber daya komputasi selama pelatihan model ML di cloud. Ini mengevaluasi kemampuan Anda memastikan penggunaan sumber daya cloud yang efisien.
Jawaban: Mengelola sumber daya komputasi melibatkan:
- Pemilihan instance: Pilih tipe instance yang sesuai (mis., GPU atau TPU) berdasarkan kebutuhan pelatihan.
- Auto-scaling: Manfaatkan fitur cloud untuk menyesuaikan sumber daya secara dinamis sesuai permintaan beban kerja.
- Manajemen biaya: Terapkan langkah penghematan biaya, seperti menggunakan spot instance atau preemptible VM.
- Pemantauan dan optimasi: Pantau secara berkala pemanfaatan sumber daya dengan alat seperti AWS CloudWatch atau Google Cloud Monitoring dan sesuaikan konfigurasi berdasarkan data kinerja dan biaya.
Bagaimana Anda memastikan keamanan data dan kepatuhan saat menerapkan model ML di cloud?
Deskripsi: Pertanyaan ini menilai pendekatan untuk menjaga keamanan data dan kepatuhan saat penerapan model ML di lingkungan cloud, dengan fokus pada praktik terbaik dan persyaratan regulasi.
Jawaban: Memastikan keamanan data dan kepatuhan melibatkan:
- Enkripsi: Enkripsi data saat istirahat dan saat transit menggunakan layanan penyedia cloud.
- Kontrol akses: Terapkan kebijakan identitas dan manajemen akses yang ketat untuk membatasi akses.
- Audit rutin: Lakukan audit keamanan dan pemeriksaan kepatuhan untuk mematuhi regulasi seperti GDPR atau HIPAA.
- Pemantauan berkelanjutan: Gunakan alat keamanan cloud untuk pemantauan berkelanjutan dan deteksi ancaman.
- Praktik terbaik: Tetap mengikuti praktik terbaik dan panduan keamanan terbaru dari penyedia cloud.
Keamanan dan kepatuhan mungkin menjadi hal terakhir yang ingin dipikirkan seorang insinyur, tetapi keduanya semakin penting. Kursus Understanding GDPR, bersama kursus lain yang disarankan sepanjang artikel ini, akan membantu Anda mengejar ketertinggalan.
Strategi apa yang Anda gunakan untuk mengelola biaya cloud terkait pelatihan dan penerapan model ML?
Deskripsi: Pertanyaan ini mengeksplorasi strategi untuk mengelola dan mengoptimalkan biaya cloud terkait pelatihan dan penerapan model ML, menilai pengetahuan tentang teknik manajemen biaya.
Jawaban: Strategi untuk mengelola biaya cloud meliputi:
- Pemilihan instance: Pilih tipe dan ukuran instance yang tepat untuk disesuaikan dengan beban kerja dan hindari kelebihan penyediaan.
- Alat manajemen biaya: Gunakan alat seperti AWS Cost Explorer atau Google Cloud Billing (jika Anda menggunakan platform tersebut) untuk melacak dan menganalisis pengeluaran.
- Langkah penghematan biaya: Terapkan strategi penghematan seperti menggunakan reserved instance atau spot instance.
- Penskalaan otomatis: Gunakan penskalaan otomatis untuk menyelaraskan penggunaan sumber daya dengan permintaan.
- Optimasi sumber daya: Secara berkala tinjau dan sesuaikan alokasi sumber daya berdasarkan metrik kinerja dan data biaya untuk memastikan efisiensi biaya.
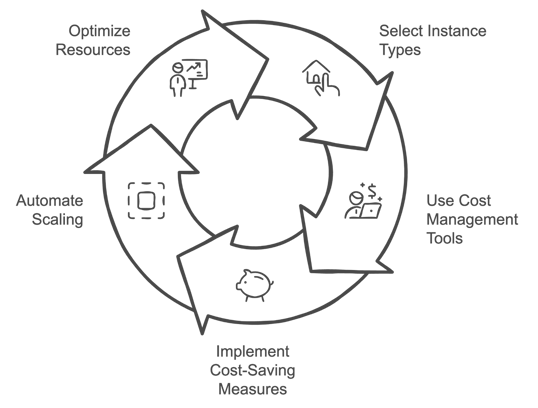
Siklus manajemen biaya cloud. Gambar oleh penulis dibuat dengan napkin.ai
Apa perbedaan antara penerapan edge dan cloud dalam MLOps?
Deskripsi: Pertanyaan ini mengeksplorasi pemahaman Anda tentang trade-off antara menerapkan model pada perangkat edge dibandingkan cloud.
Jawaban: Penerapan cloud melibatkan menjalankan model pada server terpusat, menawarkan skalabilitas dan kemudahan pemeliharaan namun berpotensi menghadapi masalah latensi.
Penerapan edge melibatkan menjalankan model langsung pada perangkat seperti ponsel pintar atau perangkat IoT, yang mengurangi latensi dan meningkatkan privasi data namun dibatasi oleh sumber daya komputasi. Penerapan edge ideal untuk aplikasi pemrosesan real-time, sedangkan penerapan cloud lebih cocok untuk model yang memerlukan daya komputasi dan fleksibilitas signifikan.
Bagaimana Anda memastikan ketersediaan tinggi dan fault tolerance untuk model ML di produksi?
Deskripsi: Pertanyaan ini menilai pengetahuan Anda dalam membangun sistem yang tangguh untuk penerapan model machine learning.
Jawaban: Memastikan ketersediaan tinggi melibatkan penerapan model di beberapa zona ketersediaan atau wilayah dan menyiapkan mekanisme failover otomatis.
Load balancer dapat mendistribusikan trafik untuk menghindari bottleneck. Untuk fault tolerance, pencadangan rutin, redundansi, dan health check dapat mencegah kegagalan sistem. Memanfaatkan layanan cloud seperti AWS Elastic Load Balancing dan fitur autoscaling juga membantu memastikan jika satu instance gagal, instance lain dapat mengambil alih tanpa downtime.
Pertanyaan Wawancara MLOps tentang Perilaku dan Pemecahan Masalah
Bagian ini membahas aspek perilaku dan pemecahan masalah dalam MLOps, menilai bagaimana kandidat menghadapi tantangan dunia nyata, berkolaborasi dengan tim, dan menangani berbagai isu dalam penerapan serta pengelolaan model machine learning.
Ceritakan saat Anda harus melakukan troubleshooting pada model di produksi. Langkah apa yang Anda ambil?
Deskripsi: Pertanyaan ini menilai keterampilan pemecahan masalah dalam skenario dunia nyata.
Contoh jawaban: "Ada situasi di mana model yang diterapkan di produksi mulai menunjukkan penurunan kinerja yang signifikan. Langkah pertama adalah menelusuri log dan metrik model untuk mengidentifikasi anomali. Ternyata pipeline data memasok data yang berubah strukturnya akibat pembaruan terbaru pada sistem sumber.
Langkah berikutnya adalah memvalidasi data terhadap masukan yang diharapkan model dan memeriksa ketidaksesuaian. Setelah mengonfirmasi masalah data, saya berkoordinasi dengan tim rekayasa data untuk memperbaiki pipeline data. Lalu saya merilis hotfix untuk memperbarui penanganan input yang dikoreksi pada model.
Terakhir, saya memantau model dengan saksama setelah penerapan untuk memastikan kinerja kembali ke tingkat yang diharapkan dan mengomunikasikan temuan serta penyelesaiannya kepada para pemangku kepentingan."
Bagaimana Anda menangani versioning model dalam lingkungan kolaboratif?
Deskripsi: Pertanyaan ini menilai pendekatan Anda dalam mengelola berbagai versi model machine learning saat bekerja dalam tim.
Contoh jawaban: “Saya menggunakan sistem version control seperti MLflow atau DVC untuk mengelola dan melacak berbagai versi model. Setiap versi diberi pengenal unik, dan dokumentasi terperinci disediakan untuk setiap pembaruan agar anggota tim memahami perubahan.
Selain itu, saya memastikan model baru diuji menyeluruh di lingkungan staging sebelum diterapkan ke produksi, yang membantu menghindari gangguan dan menjaga kinerja model.”
Gambarkan situasi menantang saat Anda harus bekerja dengan tim lintas fungsi. Bagaimana Anda memastikan kolaborasi yang efektif?
Deskripsi: Pertanyaan ini menilai kemampuan Anda bekerja secara efektif dengan berbagai tim, seperti data scientist, engineer, dan product manager, serta bagaimana Anda menavigasi dan menyelesaikan tantangan dalam pengaturan lintas fungsi.
Contoh jawaban: "Salah satu situasi menantang melibatkan koordinasi antara data scientist, engineer, dan product manager untuk menerapkan model baru dengan dependensi yang kompleks. Kunci kolaborasi efektif adalah menetapkan jalur komunikasi yang jelas sejak awal.
Rapat rutin dijadwalkan untuk menyelaraskan tujuan, melacak progres, dan mengatasi hambatan. Untuk menjembatani kesenjangan pengetahuan, saya memfasilitasi sesi berbagi pengetahuan di mana anggota tim dapat membahas bidang keahlian masing-masing.
Selain itu, penggunaan alat manajemen proyek untuk melacak tugas dan milestone membantu semua orang tetap terbarui tentang status proyek. Pendekatan ini memastikan masukan setiap anggota tim dipertimbangkan dan kami bekerja bersama menuju penerapan yang sukses."
Bagaimana pendekatan Anda dalam menskalakan model ML untuk menangani peningkatan beban pengguna?
Deskripsi: Pertanyaan ini mengeksplorasi strategi Anda untuk menskalakan model machine learning guna mengakomodasi permintaan yang meningkat, menilai pemahaman tentang aspek teknis dan operasional skalabilitas.
Contoh jawaban: "Menskalakan model ML untuk menangani peningkatan beban pengguna melibatkan beberapa langkah penting.
Pertama, saya akan menganalisis metrik kinerja model saat ini untuk mengidentifikasi potensi bottleneck. Untuk menangani peningkatan permintaan, saya akan memanfaatkan solusi auto-scaling berbasis cloud untuk menyesuaikan sumber daya secara dinamis berdasarkan trafik.
Selain itu, mengoptimalkan model itu sendiri melalui teknik seperti kuantisasi atau pruning dapat membantu mengurangi konsumsi sumber daya tanpa mengorbankan kinerja.
Saya juga akan menerapkan load testing untuk mensimulasikan trafik yang lebih tinggi dan memastikan ketangguhan sistem.
Dan terakhir, saya akan menerapkan pemantauan berkelanjutan untuk selalu mengetahui kinerja model, sehingga saya dapat menyesuaikan alokasi sumber daya sesuai kebutuhan dan mempertahankan kinerja di bawah beban yang bervariasi.”
Bagaimana Anda menangani ekspektasi pemangku kepentingan ketika kinerja model tidak memenuhi prediksi awal?
Deskripsi: Pertanyaan ini menilai kemampuan Anda mengelola komunikasi dan ekspektasi ketika model gagal memberikan hasil yang diharapkan.
Contoh jawaban: "Ketika kinerja model tidak memenuhi ekspektasi, saya fokus pada komunikasi yang transparan dengan para pemangku kepentingan. Saya menjelaskan keterbatasan model dan alasan kinerjanya, apakah karena masalah kualitas data, overfitting, atau ekspektasi awal yang tidak realistis.
Saya kemudian bekerja sama untuk menetapkan tujuan yang lebih realistis, memberikan wawasan berbasis data, dan mengusulkan perbaikan, seperti mengumpulkan lebih banyak data pelatihan atau menyesuaikan arsitektur model."
Bisakah Anda menggambarkan saat Anda harus menyeimbangkan technical debt dengan pengiriman proyek tepat waktu?
Deskripsi: Pertanyaan ini menilai kemampuan Anda memprioritaskan antara menjaga kualitas kode jangka panjang dan memenuhi tenggat proyek jangka pendek.
Contoh jawaban: "Pernah suatu kali kami memiliki tenggat ketat untuk menerapkan model bagi fitur produk baru. Kami memprioritaskan pengiriman cepat dengan melewati bagian tertentu yang tidak kritis dari basis kode, seperti dokumentasi komprehensif dan pengujian non-esensial.
Setelah rilis, kami mengalokasikan waktu untuk meninjau kembali basis kode dan menangani isu-isu tersebut, memastikan technical debt diminimalkan pascapeluncuran. Hal ini memungkinkan kami memenuhi tenggat sekaligus menjaga stabilitas proyek jangka panjang."
Tips Mempersiapkan Wawancara MLOps
Mempersiapkan wawancara MLOps memerlukan kombinasi pengetahuan teknis, pemahaman tentang lingkungan perusahaan, dan komunikasi yang jelas mengenai pengalaman Anda sebelumnya. Berikut beberapa tips penting untuk membantu Anda bersiap:
Perdalam konsep dan alat
Pastikan Anda memiliki pemahaman yang kuat tentang konsep inti MLOps. Kenali alat dan platform populer yang digunakan dalam MLOps, seperti MLflow, Kubernetes, dan layanan berbasis cloud seperti AWS SageMaker atau Google AI Platform.
MLOps skill track adalah sumber yang sempurna karena berisi empat kursus relevan yang memastikan Anda selalu mengikuti konsep dan praktik MLOps terkini.
Pahami tumpukan teknologi perusahaan
Teliti teknologi dan alat spesifik yang digunakan oleh perusahaan tempat Anda melamar. Memahami tumpukan teknologi mereka akan membantu Anda menyesuaikan jawaban agar selaras dengan lingkungan mereka dan menunjukkan bahwa Anda cocok. Telusuri layanan cloud pilihan, sistem version control, dan praktik manajemen model mereka untuk menunjukkan bahwa Anda siap berintegrasi dengan mulus ke alur kerja mereka.
Siapkan contoh pekerjaan sebelumnya
Bersiaplah untuk membahas proyek atau pengalaman spesifik saat Anda menerapkan praktik MLOps. Siapkan contoh yang menyoroti keterampilan pemecahan masalah, kemampuan bekerja dengan tim lintas fungsi, dan pengalaman Anda dalam penerapan serta penskalaan model (jika memungkinkan). Gunakan contoh ini untuk menggambarkan pengetahuan praktis Anda dan bagaimana Anda berhasil mengatasi tantangan di peran sebelumnya.
Latih coding
Secara rutin latih latihan coding terkait MLOps, seperti menulis skrip untuk penerapan model, mengotomatiskan alur kerja, atau mengembangkan pipeline data.
Tetap terkini
Bidang MLOps berkembang pesat, jadi penting untuk selalu mengikuti tren, alat, dan praktik terbaik terbaru. Ikuti blog industri, berpartisipasi dalam forum atau webinar terkait, dan terlibat dengan komunitas MLOps untuk menjaga pengetahuan Anda tetap mutakhir dan relevan.
Kesimpulan
MLOps adalah bidang yang menjembatani kesenjangan antara data science dan operasi, memastikan model machine learning diterapkan, dipelihara, dan diskalakan secara efektif.
Sepanjang tulisan ini, kami membahas berbagai pertanyaan wawancara yang mencakup konsep umum MLOps, aspek teknis, pertimbangan cloud dan infrastruktur, serta keterampilan perilaku dan pemecahan masalah. Berlatih pertanyaan-pertanyaan ini akan secara signifikan meningkatkan peluang keberhasilan Anda selama wawancara dan memberi Anda kesempatan lebih besar untuk mendapatkan pekerjaan!
Lihat sumber berikut untuk melanjutkan pembelajaran Anda:
FAQs
Keterampilan utama apa yang harus disoroti seorang insinyur MLOps selama wawancara?
Seorang insinyur MLOps harus menekankan kemahiran dalam otomatisasi, khususnya dengan pipeline CI/CD untuk model machine learning, serta pengalaman dengan platform cloud seperti AWS, GCP, atau Azure. Pengetahuan tentang alat kontainerisasi seperti Docker dan Kubernetes sangat penting untuk mengelola infrastruktur pada skala besar. Soroti pemahaman Anda tentang seluruh siklus hidup machine learning, dari pelatihan model hingga penerapan dan pemantauan, seraya menunjukkan soft skill seperti komunikasi dan kolaborasi, karena MLOps memerlukan kerja tim lintas departemen.
Bagaimana saya dapat menunjukkan pengalaman bekerja dengan sistem machine learning skala besar?
Untuk menunjukkan pengalaman dengan sistem ML skala besar, rujuk proyek spesifik di mana Anda menangani dataset besar atau mengoptimalkan kinerja model di produksi. Bahas alat yang Anda gunakan, seperti Kubernetes untuk penerapan atau Spark untuk pemrosesan terdistribusi. Gunakan metrik terukur untuk menunjukkan dampak Anda, seperti mengurangi waktu inferensi atau mengelola dataset berskala terabita. Ini akan memberikan bukti konkret atas kapabilitas Anda.
Bagaimana saya harus mempersiapkan diri untuk wawancara teknis MLOps?
Untuk mempersiapkan wawancara teknis MLOps, perdalam kembali dasar-dasar machine learning sekaligus fokus pada pengetahuan Anda tentang pipeline CI/CD dan penerapan berbasis cloud. Latih penerapan model menggunakan kontainer dan platform cloud, pastikan Anda dapat mengartikulasikan cara menskalakan dan memantau model secara efektif. Pengalaman langsung dan simulasi wawancara dapat membantu Anda mengasah keterampilan pemecahan masalah teknis, terutama terkait otomatisasi dan infrastruktur.
Apa saja kesalahan umum yang dilakukan kandidat selama wawancara MLOps, dan bagaimana cara menghindarinya?
Kesalahan umum adalah terlalu fokus pada algoritma machine learning dan mengabaikan sisi operasional MLOps. Kandidat harus menyeimbangkan pemahaman ML dengan pengelolaan infrastruktur. Penting juga untuk tidak mengabaikan pemantauan dan pemeliharaan, yang krusial untuk sistem produksi. Selalu dukung jawaban Anda dengan contoh praktis dari pengalaman sebelumnya, hindari jawaban teoretis atau terlalu umum.
Bagaimana saya bisa menonjol dalam wawancara MLOps?
Untuk menonjol, tunjukkan pemahaman lintas fungsi tentang MLOps dengan menjelaskan bagaimana Anda berkolaborasi dengan data scientist, engineer, dan tim DevOps. Soroti kemampuan Anda mengimplementasikan otomatisasi dan menskalakan sistem secara efektif, dan dukung poin Anda dengan contoh nyata saat Anda memberikan hasil terukur. Menunjukkan minat pada tren yang sedang berkembang seperti arsitektur serverless atau edge computing juga akan membantu Anda tampil sebagai kandidat yang visioner.





Machine Learning Operations (MLOps) telah muncul sebagai salah satu bidang yang paling diminati di dunia teknologi. Seiring tim data semakin sering menerapkan model machine learning ke lingkungan produksi, permintaan untuk profesional MLOps akan terus meningkat.
Jika Anda ingin berkarier sebagai insinyur MLOps, kami siap membantu Anda mengambil langkah tersebut!
Dalam artikel ini, kami akan menyajikan pertanyaan wawancara MLOps teratas, beserta penjelasan dan jawaban terperinci, untuk membantu Anda mempersiapkan diri secara efektif menghadapi wawancara mendatang.
Apa Itu MLOps, dan Mengapa Penting?
MLOps, singkatan dari Machine Learning Operations, adalah disiplin yang menggabungkan machine learning dengan praktik DevOps untuk merampingkan dan mengotomatiskan siklus hidup model machine learning.
Tujuan utama MLOps adalah menjembatani kesenjangan antara data science dan operasi TI, memastikan model machine learning dikembangkan secara efektif, diterapkan, dipantau, dan dipelihara secara efisien di lingkungan produksi.
Berbagai aspek teknis yang terlibat dalam MLOps. Gambar oleh penulis
Peran ini penting karena memungkinkan tim data untuk menerapkan model machine learning di lingkungan produksi sekaligus memastikan model dapat diskalakan dan dipelihara secara efektif. Intinya, MLOps mempercepat inovasi, meningkatkan efisiensi operasional, dan membantu perusahaan membuka potensi penuh dari inisiatif berbasis data mereka.
Keterampilan yang dibutuhkan dalam MLOps meliputi:
Ya, seorang insinyur MLOps itu seperti unicorn! Dan itulah tepatnya alasan mengapa mereka sangat dicari dan menerima gaji yang semakin tinggi.