

Khóa học
Các khái niệm về MLOps
2 giờ
46.3K
Luyện tập và Lộ trình tiến trình của bạn.
Tiếp Tục Với GoogleVận hành Học máy (MLOps) đã nổi lên như một trong những lĩnh vực được săn đón nhất trong công nghệ. Khi các nhóm dữ liệu ngày càng triển khai mô hình học máy vào môi trường sản xuất, nhu cầu đối với các chuyên gia MLOps sẽ tiếp tục tăng.
Nếu bạn đang theo đuổi sự nghiệp kỹ sư MLOps, chúng tôi ở đây để giúp bạn bứt phá!
Trong bài viết này, chúng tôi sẽ cung cấp các câu hỏi phỏng vấn MLOps hàng đầu, kèm giải thích chi tiết và đáp án, giúp bạn chuẩn bị hiệu quả cho buổi phỏng vấn sắp tới.
MLOps, viết tắt của Machine Learning Operations, là một lĩnh vực kết hợp học máy với các thực hành DevOps để hợp lý hóa và tự động hóa vòng đời của các mô hình học máy.
Mục tiêu chính của MLOps là thu hẹp khoảng cách giữa khoa học dữ liệu và vận hành CNTT, đảm bảo các mô hình học máy được phát triển hiệu quả, triển khai, giám sát và bảo trì tối ưu trong môi trường sản xuất.
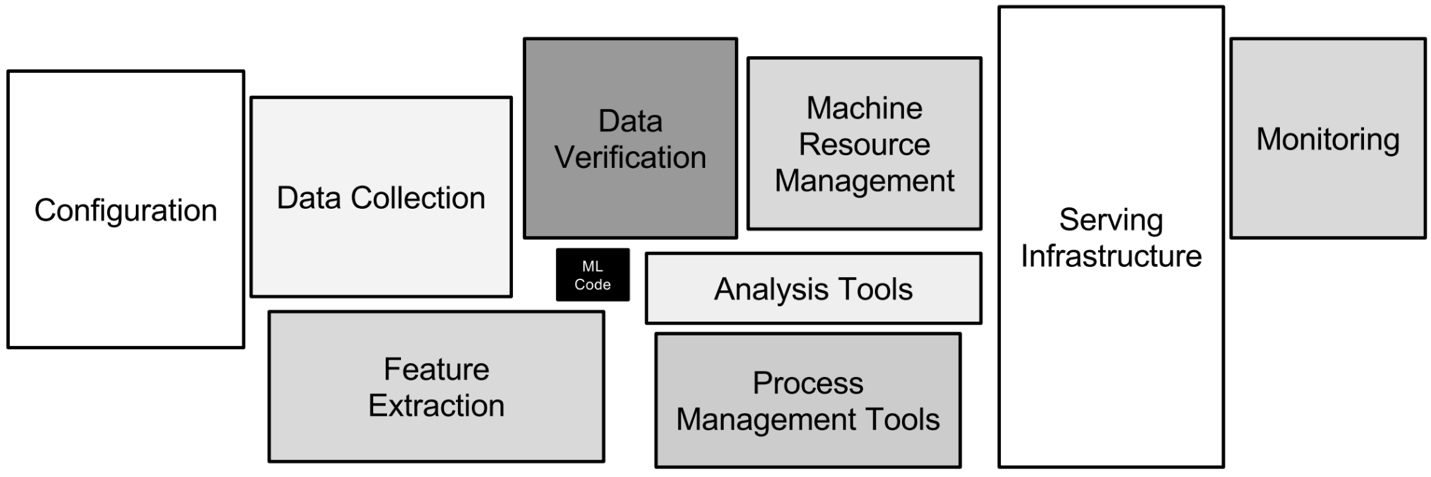
Các khía cạnh kỹ thuật khác nhau trong MLOps. Ảnh: tác giả
Vai trò này quan trọng vì nó giúp các nhóm dữ liệu triển khai mô hình học máy trong môi trường sản xuất đồng thời đảm bảo khả năng mở rộng và bảo trì hiệu quả. Về cốt lõi, MLOps thúc đẩy đổi mới, nâng cao hiệu quả vận hành và giúp doanh nghiệp khai mở toàn bộ tiềm năng của các sáng kiến dựa trên dữ liệu.
Các kỹ năng cần có trong MLOps bao gồm:
Đúng vậy, kỹ sư MLOps giống như “kỳ lân”! Và đó chính là lý do họ có nhu cầu cao và mức lương ngày càng hấp dẫn.
Trong phần này, chúng ta sẽ khám phá các câu hỏi phỏng vấn MLOps nền tảng nhằm đánh giá hiểu biết của bạn về các khái niệm và nguyên tắc cốt lõi. Các câu hỏi này được thiết kế để kiểm tra kiến thức về trách nhiệm và thách thức cơ bản của MLOps, cũng như khả năng truyền đạt hiệu quả.
Làm quen với những câu hỏi này để xây dựng nền tảng vững chắc, chuẩn bị cho các chủ đề nâng cao hơn và chứng tỏ năng lực của bạn trong lĩnh vực này.
Mô tả: Câu hỏi này kiểm tra hiểu biết của bạn về những khác biệt nền tảng giữa MLOps và DevOps, vốn thường bị nhầm lẫn.
Trả lời: MLOps và DevOps đều tập trung vào hợp tác nhưng phục vụ các mục đích khác nhau. DevOps tập trung tự động hóa phát triển, kiểm thử và triển khai ứng dụng phần mềm, tiêu chuẩn hóa môi trường để tối ưu các quy trình này.
Ngược lại, MLOps được điều chỉnh cho quy trình học máy, nhấn mạnh quản lý và duy trì pipeline dữ liệu và mô hình. Trong khi DevOps hướng tới tự động hóa tác vụ thường nhật và chuẩn hóa triển khai ứng dụng, MLOps đối mặt với tính thử nghiệm của học máy, bao gồm xác thực dữ liệu, đánh giá chất lượng mô hình và xác thực mô hình liên tục.
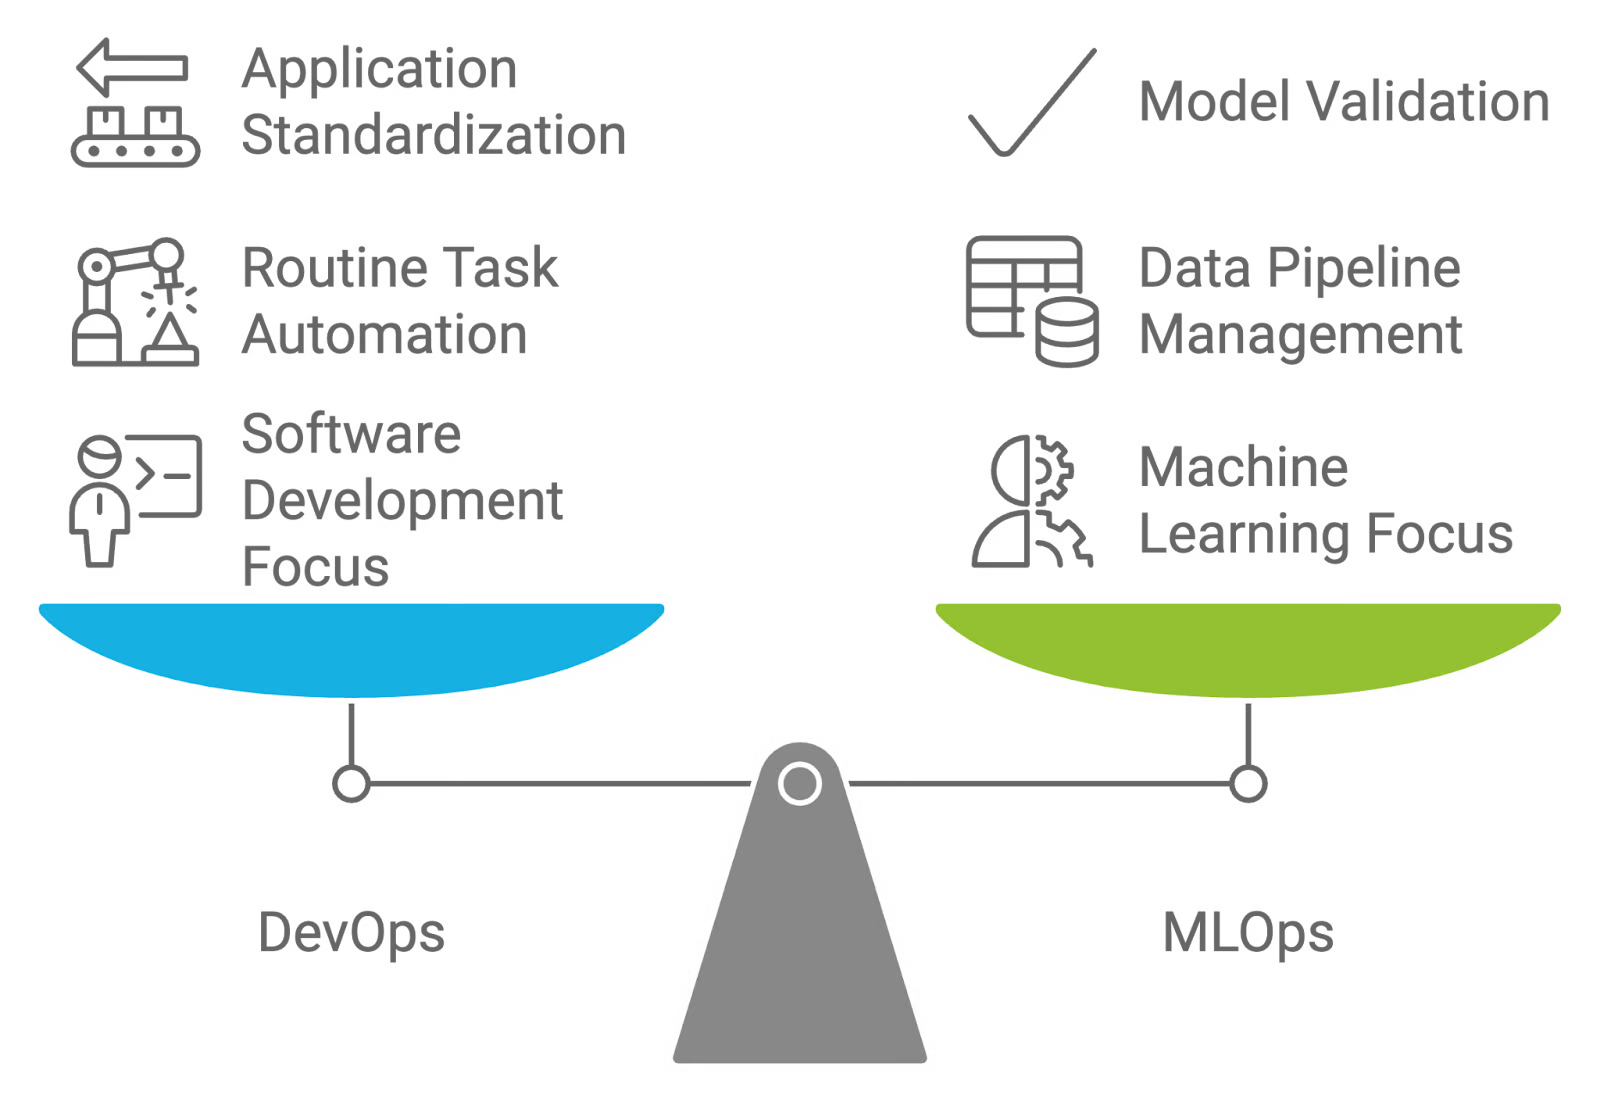
So sánh và đối chiếu DevOps và MLOps. Ảnh: tác giả, tạo với napkin.ai
Mô tả: Câu hỏi này đánh giá hiểu biết của bạn về tác động của dữ liệu biến đổi đến độ chính xác mô hình và tầm quan trọng của việc giám sát, cập nhật mô hình.
Trả lời: Model drift và concept drift đề cập đến thay đổi trong hiệu năng mô hình học máy theo thời gian do các mẫu dữ liệu và mối quan hệ nền tảng tiến hóa:
Mô tả: Câu hỏi này xem xét hiểu biết của bạn về thực hành kiểm thử để đảm bảo mô hình học máy đáng tin cậy và hoạt động tốt trước khi triển khai vào môi trường sản xuất.
Trả lời: Có nhiều bài kiểm thử cần thực hiện trước khi triển khai mô hình ML vào sản xuất. Bảng sau cung cấp cái nhìn toàn diện về từng loại kiểm thử, bao gồm mục tiêu, công cụ sử dụng và thời điểm áp dụng trong vòng đời phát triển học máy:
|
Loại kiểm thử |
Mục tiêu |
Công cụ sử dụng |
Khi nào dùng |
|
Unit testing |
Xác minh từng thành phần mô hình, như bước tiền xử lý và hàm trích xuất đặc trưng. |
PyTest, unittest, scikit-learn (cho các biến đổi) |
Trong phát triển, khi triển khai hoặc cập nhật thành phần mô hình. |
|
Integration testing |
Đảm bảo mô hình tương tác đúng với các thành phần hệ thống và nguồn dữ liệu khác trong môi trường sản xuất. |
Docker, Kubernetes, Jenkins, Apache Kafka |
Sau unit testing, khi triển khai mô hình vào môi trường giống sản xuất. |
|
Performance testing |
Đánh giá độ chính xác, precision, recall và các chỉ số liên quan bằng bộ dữ liệu validation. |
Scikit-learn, TensorFlow, PyTorch, MLflow |
Sau integration testing, để đảm bảo mô hình đạt chuẩn hiệu năng kỳ vọng. |
|
Stress testing |
Đánh giá khả năng xử lý tải cao và khối lượng dữ liệu lớn, đảm bảo khả năng mở rộng. |
Apache JMeter, Locust, Dask |
Trước khi triển khai trong môi trường có khối lượng dữ liệu lớn hoặc khi lo ngại khả năng mở rộng. |
|
A/B testing |
So sánh hiệu năng mô hình với mô hình hiện có hoặc các chỉ số baseline trong môi trường thực. |
Optimizely, SciPy, Google Optimize |
Sau triển khai, khi xác thực hiệu năng mô hình trong sản xuất và tối ưu các phiên bản. |
|
Robustness testing |
Đảm bảo mô hình bền bỉ trước dữ liệu bất thường và các trường hợp biên. |
Thư viện kiểm thử đối kháng (ví dụ CleverHans), script tùy chỉnh |
Sau performance testing, để xác nhận độ tin cậy trong điều kiện bất thường hoặc ngoài dự kiến. |
Mô tả: Câu hỏi này đánh giá hiểu biết của bạn về vai trò và ý nghĩa của kiểm soát phiên bản trong thực hành MLOps. Trọng tâm là cách quản lý các phiên bản mô hình, dữ liệu và mã giúp triển khai, bảo trì mô hình hiệu quả.
Trả lời: Kiểm soát phiên bản rất quan trọng trong MLOps vì giúp quản lý và theo dõi thay đổi đối với mô hình, bộ dữ liệu và mã trong suốt vòng đời. Dùng hệ thống như Git cho mã và công cụ như DVC (Data Version Control) cho dữ liệu và mô hình đảm bảo mọi thay đổi đều được ghi nhận và có thể hoàn nguyên.
Thực hành này hỗ trợ tái lập kết quả, tạo điều kiện cộng tác giữa các thành viên, và cho phép dễ dàng quay về phiên bản trước nếu có sự cố. Nó đảm bảo tính nhất quán và độ tin cậy về hiệu năng mô hình, điều quan trọng để duy trì triển khai chất lượng cao.
Để tìm hiểu thêm, hãy xem Hướng dẫn đầy đủ về Data Version Control (DVC). Tài liệu này sẽ giúp bạn sẵn sàng cho những câu hỏi kiểu này trong buổi phỏng vấn!
Mô tả: Câu hỏi này nhằm đánh giá hiểu biết của bạn về các phương pháp đóng gói mô hình học máy để triển khai. Nó kiểm tra khả năng chuẩn bị mô hình để tích hợp vào nhiều môi trường và ứng dụng khác nhau.
Trả lời: Có một số cách hiệu quả để đóng gói mô hình học máy:
Một cách tuyệt vời để hiểu rõ hơn về đóng gói mô hình là làm quen với containerization. Docker là công cụ nền tảng mà mọi kỹ sư MLOps nên biết. Để ôn lại kiến thức, hãy truy cập khóa học Introduction to Docker.
Mô tả: Câu hỏi này đánh giá kiến thức của bạn về giám sát mô hình trong sản xuất và hiểu biết về các chỉ số quan trọng để đảm bảo hiệu năng và độ tin cậy lâu dài.
Trả lời: Giám sát là điều cốt yếu trong MLOps để đảm bảo mô hình tiếp tục hoạt động như kỳ vọng trong sản xuất. Các chỉ số cần theo dõi gồm độ chính xác, precision, recall và các chỉ báo hiệu năng khác để phát hiện suy giảm chất lượng mô hình.
Giám sát drift dữ liệu cũng rất quan trọng vì thay đổi mẫu dữ liệu có thể ảnh hưởng đến dự đoán. Ngoài ra, các chỉ số hạ tầng như độ trễ và mức sử dụng tài nguyên (ví dụ CPU, bộ nhớ) giúp đảm bảo hệ thống luôn mở rộng tốt và phản hồi nhanh.
Mô tả: Câu hỏi này đánh giá hiểu biết của bạn về những trở ngại tiềm ẩn và cách xử lý để đảm bảo triển khai thành công.
Trả lời: Các vấn đề thường gặp khi triển khai mô hình ML gồm:
Mọi nhà tuyển dụng đều tìm kiếm kỹ năng giải quyết vấn đề, đặc biệt khi xử lý dữ liệu trong vai trò như MLOps. Để bắt kịp hai chủ đề rất quan trọng trong kỷ nguyên ML, hãy xem các khóa Introduction to Data Quality và Introduction to Data Security.
Mô tả: Câu hỏi này kiểm tra khả năng phân biệt giữa phương pháp triển khai Canary và Blue-Green cùng lợi ích của chúng khi phát hành thay đổi mới.
Trả lời: Canary và Blue-Green đều được dùng để quản lý việc phát hành bản cập nhật, nhưng khác nhau về cách tiếp cận:
Cả hai đều nhằm giảm rủi ro và downtime khi triển khai, nhưng Canary tập trung phát hành tăng dần và phơi lộ từng bước, còn Blue-Green đảm bảo chuyển đổi liền mạch giữa môi trường.
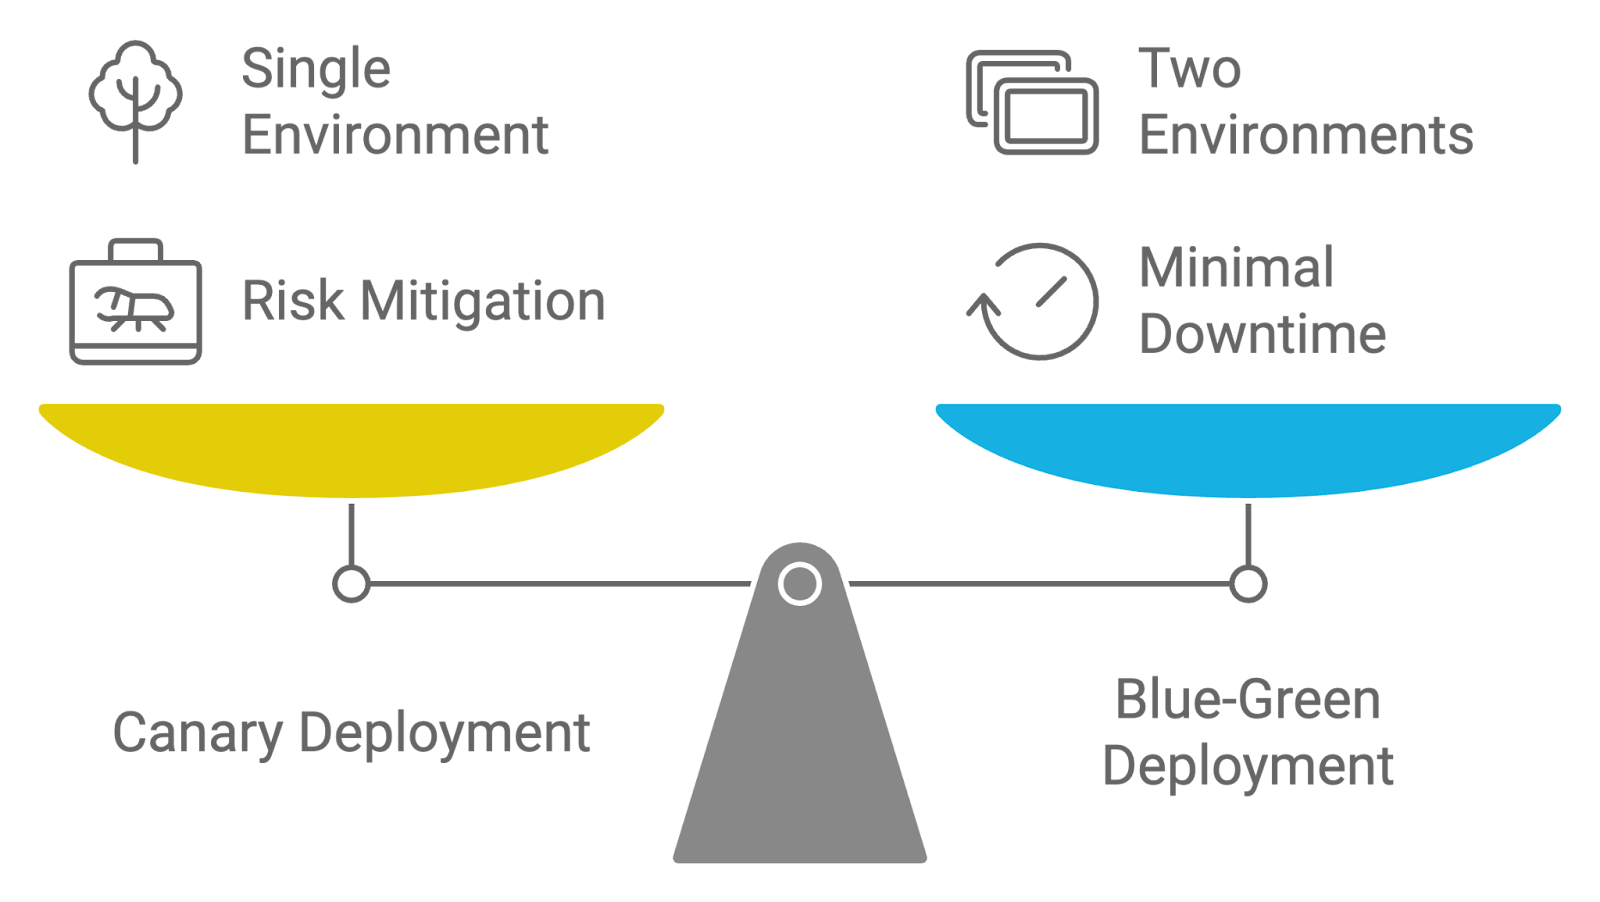
So sánh chiến lược triển khai: Canary so với Blue-Green. Ảnh: tác giả, tạo với napkin.ai
Mô tả: Câu hỏi này kiểm tra kiến thức của bạn về chiến lược và công cụ dùng để tự động hóa việc huấn luyện lại mô hình khi có dữ liệu mới.
Trả lời: Tự động hóa huấn luyện lại trong MLOps liên quan đến việc thiết lập pipeline kích hoạt huấn luyện lại khi đáp ứng điều kiện nhất định, như hiệu năng suy giảm hoặc có dữ liệu mới.
Các công cụ như Airflow hoặc Kubeflow có thể điều phối những workflow này, tự động hóa các tác vụ như nạp dữ liệu, kỹ thuật đặc trưng, huấn luyện và đánh giá. Giám sát liên tục là điều thiết yếu để đảm bảo mô hình đạt ngưỡng hiệu năng trước khi triển khai, và các công cụ versioning như DVC giúp theo dõi các phiên bản mô hình trong suốt quá trình huấn luyện lại.
Trong phần này, chúng ta sẽ đi vào các câu hỏi phỏng vấn MLOps kỹ thuật nhằm đánh giá kỹ năng thực hành và hiểu biết về các khái niệm nâng cao.
Những câu hỏi này tập trung vào các khía cạnh kỹ thuật của triển khai, quản lý và tối ưu mô hình học máy, được thiết kế để đánh giá mức độ thành thạo công cụ, kỹ thuật và thực hành tốt nhất trong lĩnh vực.
Mô tả: Câu hỏi này kiểm tra kiến thức của bạn về thiết lập pipeline CI/CD dành riêng cho quy trình học máy. Nó đánh giá khả năng tự động hóa quá trình triển khai và quản lý cập nhật mô hình hiệu quả.
Trả lời: Triển khai CI/CD cho mô hình học máy liên quan đến thiết lập các pipeline tự động hóa từ thay đổi mã đến triển khai.
Ví dụ, bạn có thể dùng Jenkins hoặc GitHub Actions để kích hoạt build và test bất cứ khi nào có thay đổi trong mã mô hình hoặc dữ liệu. Pipeline gồm các giai đoạn như:
Bằng cách tự động hóa các giai đoạn này, bạn đảm bảo mô hình được cập nhật nhất quán và đáng tin cậy với can thiệp thủ công tối thiểu.
Nếu bạn cần cải thiện kiến thức CI/CD, hãy học khóa CI/CD for Machine Learning. Khóa này sẽ giúp bạn tỏa sáng trong buổi phỏng vấn!
Mô tả: Câu hỏi này tập trung vào hiểu biết của bạn về quản lý dữ liệu hiệu quả trong MLOps. Nó đánh giá khả năng xử lý chất lượng dữ liệu, kiểm soát phiên bản và tổ chức dữ liệu để hỗ trợ quy trình học máy vững chắc, đáng tin cậy.
Trả lời: Các thực hành tốt nhất trong quản lý dữ liệu MLOps gồm:
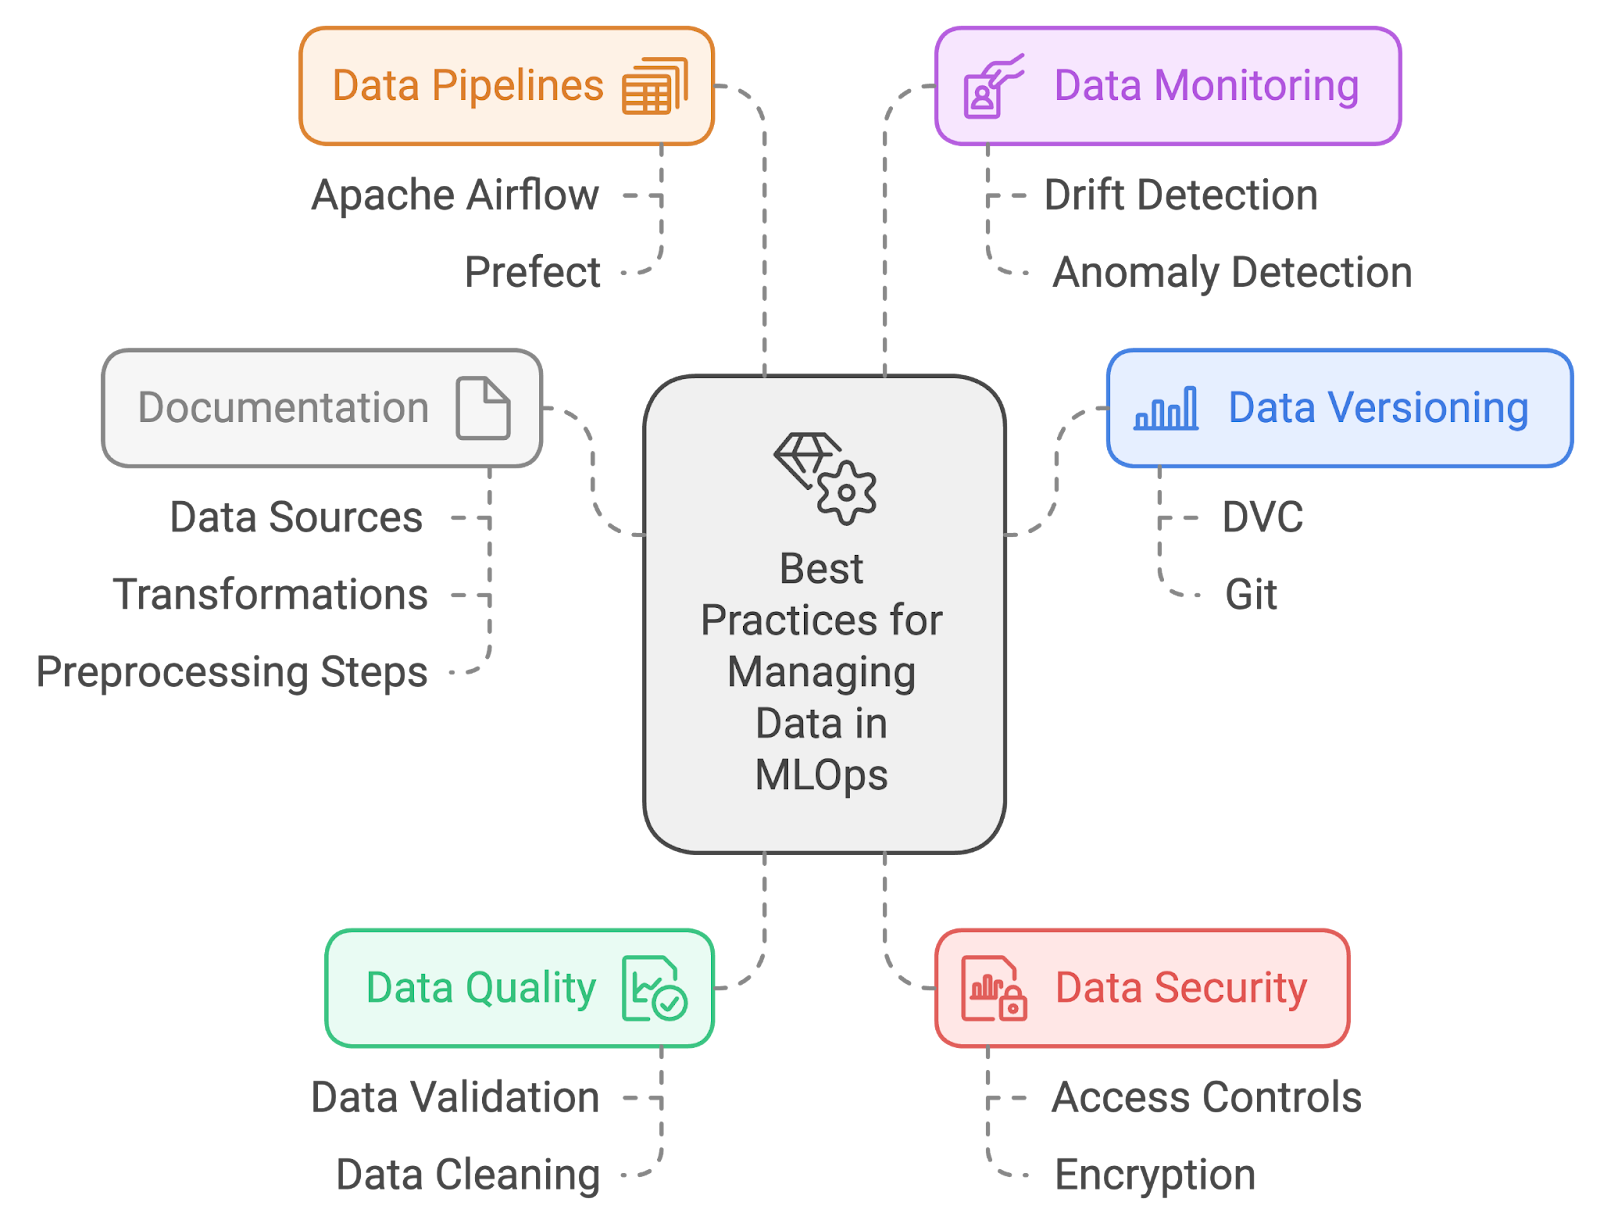
Các thực hành tốt nhất trong quản lý dữ liệu. Ảnh: tác giả, tạo với napkin.ai
Mô tả: Câu hỏi này đánh giá cách bạn tích hợp các quy trình này vào workflow tự động.
Trả lời: Xử lý kỹ thuật đặc trưng và tiền xử lý trong pipeline MLOps bao gồm tự động hóa các bước này để đảm bảo tính nhất quán và tái lập. Bạn có thể dùng Apache Airflow hoặc Prefect để tạo pipeline dữ liệu thực hiện các tác vụ như:
Mô tả: Câu hỏi này đánh giá hiểu biết của bạn về cách theo dõi và đảm bảo hiệu năng, độ tin cậy liên tục của mô hình, bao gồm công cụ và chiến lược dùng để giám sát hiệu quả.
Trả lời: Triển khai giám sát mô hình trong sản xuất bao gồm một số thực hành để đảm bảo mô hình hoạt động như kỳ vọng và duy trì độ tin cậy theo thời gian:
Khóa học Machine Learning Monitoring sẽ giúp bạn nắm vững để trả lời chi tiết hơn những câu hỏi như thế này!
Mô tả: Câu hỏi này khám phá cách tiếp cận của bạn để đảm bảo các thí nghiệm học máy có thể được lặp lại nhất quán. Nó đánh giá hiểu biết về các thực hành hỗ trợ tái lập.
Trả lời: Đảm bảo tái lập thí nghiệm học máy bao gồm:
Mô tả: Câu hỏi này đánh giá hiểu biết của bạn về các thách thức riêng khi đưa mô hình từ giai đoạn phát triển sang môi trường sản xuất.
Trả lời: Vận hành hóa mô hình học máy có nhiều thách thức. Một khó khăn lớn là đảm bảo tính nhất quán giữa môi trường phát triển và sản xuất, có thể dẫn đến vấn đề tái lập.
Drift dữ liệu là mối lo khác, vì dữ liệu trong sản xuất có thể thay đổi theo thời gian, làm giảm độ chính xác của mô hình.
Ngoài ra, tích hợp mô hình vào hệ thống hiện có, giám sát hiệu năng và tự động hóa chu trình huấn luyện lại thường là các nhiệm vụ phức tạp, đòi hỏi hợp tác hiệu quả giữa đội khoa học dữ liệu và kỹ thuật.
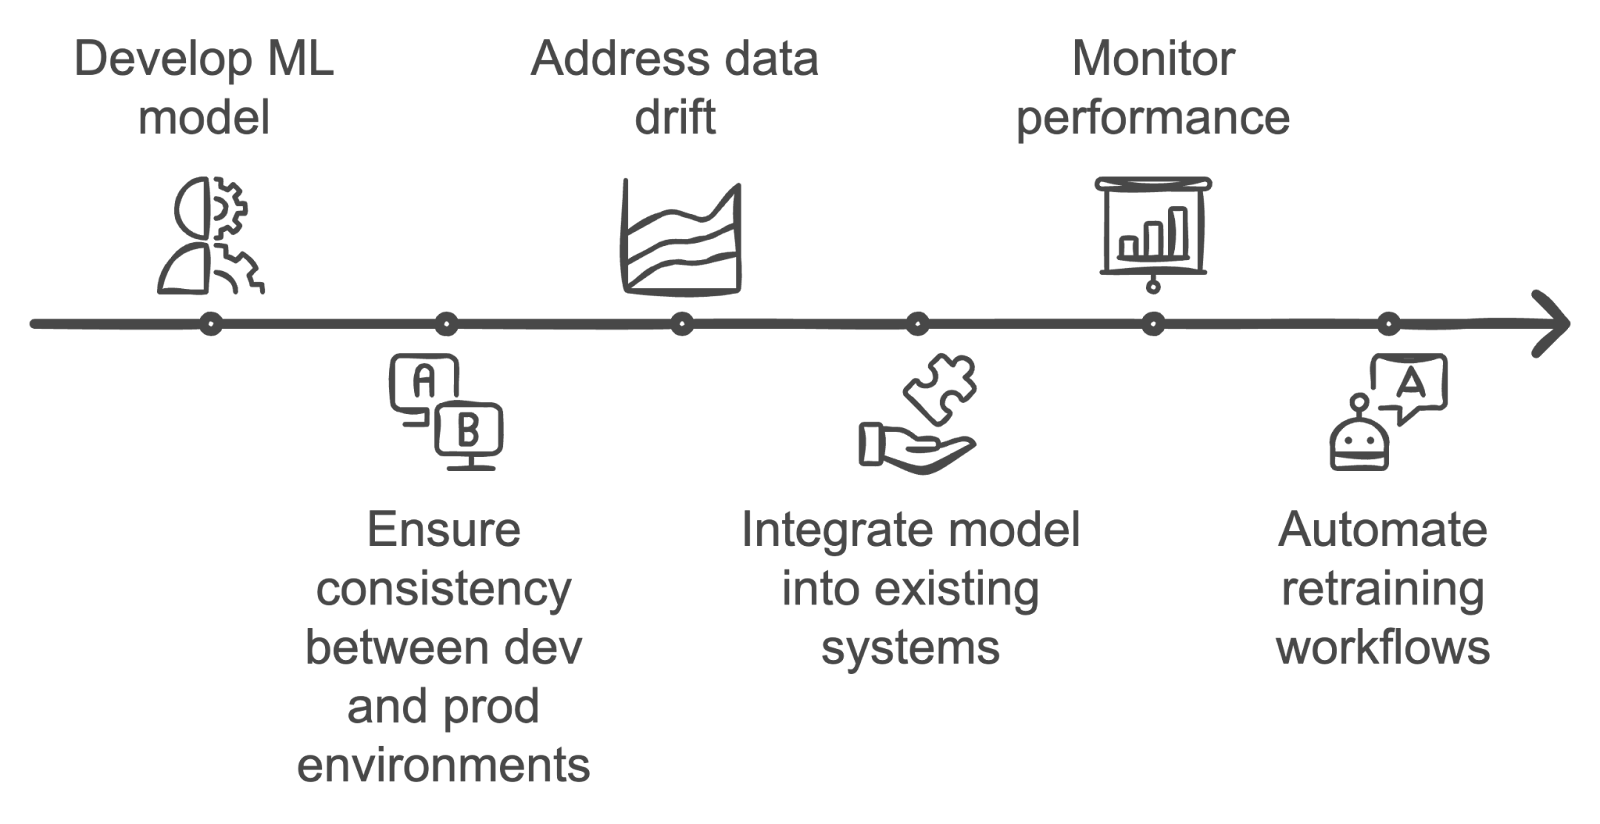
Vượt qua thách thức khi vận hành hóa mô hình ML. Ảnh: tác giả, tạo với napkin.ai
Mô tả: Câu hỏi này đánh giá hiểu biết của bạn về tự động hóa huấn luyện lại mô hình khi có dữ liệu mới hoặc hiệu năng mô hình suy giảm.
Trả lời: Triển khai huấn luyện lại tự động bao gồm thiết lập pipeline giám sát hiệu năng mô hình và drift dữ liệu. Khi độ chính xác giảm dưới ngưỡng hoặc có dữ liệu mới, các công cụ như Apache Airflow hoặc Kubeflow có thể kích hoạt huấn luyện lại.
Huấn luyện lại gồm lấy dữ liệu mới, tiền xử lý, huấn luyện mô hình với cùng hoặc siêu tham số cập nhật, và xác thực mô hình mới. Sau đó, mô hình cập nhật sẽ tự động triển khai vào sản xuất.
Mô tả: Câu hỏi này kiểm tra kiến thức của bạn về khả năng diễn giải mô hình và cách bạn đảm bảo tính minh bạch trong dự đoán.
Trả lời: Các công cụ như SHAP (SHapley Additive exPlanations) hoặc LIME (Local Interpretable Model-agnostic Explanations) thường được dùng cho khả năng giải thích mô hình.
Chúng giúp phân tích dự đoán của mô hình bằng cách hiển thị đóng góp của từng đặc trưng. Khả năng giải thích là chìa khóa trong MLOps vì xây dựng niềm tin với các bên liên quan và đảm bảo tuân thủ quy định, đặc biệt trong tài chính và y tế. Nó cũng giúp phát hiện thiên lệch hoặc vấn đề liên quan đến dữ liệu trong mô hình.
Phần này đề cập các câu hỏi phỏng vấn tập trung vào khía cạnh đám mây và hạ tầng của MLOps. Các câu hỏi đánh giá chuyên môn của bạn trong triển khai, quản lý và mở rộng mô hình học máy trong môi trường đám mây.
Mô tả: Câu hỏi này xem xét kiến thức của bạn về triển khai mô hình học máy trong môi trường đám mây. Nó đánh giá hiểu biết về nền tảng đám mây, quy trình triển khai và công cụ quản lý mô hình trên đám mây.
Trả lời: Triển khai mô hình ML trên đám mây bao gồm các bước sau:
Mô tả: Câu hỏi này khám phá hiểu biết về điện toán serverless và ứng dụng của nó trong triển khai mô hình ML, đánh giá khả năng cân nhắc lợi ích và thách thức.
Trả lời: Kiến trúc serverless mang lại nhiều lợi ích, gồm giảm chi phí vận hành do không cần quản lý máy chủ và tự động mở rộng theo nhu cầu thời gian thực, có thể tiết kiệm chi phí vì tính phí theo mức sử dụng tính toán thực tế.
Tuy nhiên, cũng có thách thức: giới hạn thời gian thực thi và phân bổ tài nguyên có thể không phù hợp cho mọi loại mô hình ML, nhất là mô hình đòi hỏi tính toán cao.
Độ trễ khởi động lạnh (cold start) cũng có thể là vấn đề, khi các yêu cầu đầu tiên sau thời gian không hoạt động có thể bị trễ. Dù vậy, nếu quản lý tốt các yếu tố này, kiến trúc serverless vẫn rất hiệu quả cho một số khối lượng công việc.
Một cách khác để nhìn nhận là qua bảng sau tóm tắt ưu và nhược điểm của kiến trúc serverless theo từng khía cạnh cụ thể:
|
Khía cạnh |
Ưu điểm serverless |
Nhược điểm serverless |
|
Chi phí vận hành |
Không cần quản lý máy chủ; giảm độ phức tạp hạ tầng. |
Cần hiểu biết nền tảng đám mây để quản trị môi trường serverless. |
|
Khả năng mở rộng |
Tự động mở rộng theo nhu cầu thời gian thực, hiệu quả chi phí. |
Khó dự trù ngân sách nếu mở rộng diễn ra thường xuyên. |
|
Hiệu quả chi phí |
Chỉ trả cho tài nguyên sử dụng, có thể giảm chi phí. |
Có thể tốn kém nếu nhiều hàm được gọi thường xuyên hoặc kéo dài. |
|
Giới hạn thực thi |
Phù hợp cho tác vụ nhẹ hoặc ngắn hạn. |
Bị giới hạn thời gian và tài nguyên, có thể không xử lý được mô hình ML nặng. |
|
Khởi động lạnh |
Giảm chi phí vận hành bằng cách mở rộng theo nhu cầu. |
Độ trễ khởi động lạnh có thể xảy ra sau thời gian rảnh, ảnh hưởng ứng dụng nhạy cảm độ trễ. |
|
Tính phù hợp với mô hình ML |
Hoạt động tốt cho tác vụ ML quy mô nhỏ, suy luận hoặc xử lý theo lô. |
Mô hình ML tính toán nặng với tác vụ kéo dài không phù hợp. |
Mô tả: Câu hỏi này đánh giá chiến lược tối ưu và quản lý tài nguyên tính toán trong quá trình huấn luyện mô hình ML trên đám mây. Nó đánh giá khả năng sử dụng tài nguyên hiệu quả.
Trả lời: Quản lý tài nguyên tính toán gồm:
Mô tả: Câu hỏi này xem xét cách tiếp cận duy trì bảo mật dữ liệu và tuân thủ trong quá trình triển khai mô hình ML trên đám mây, tập trung vào thực hành tốt và yêu cầu quy định.
Trả lời: Đảm bảo bảo mật và tuân thủ bao gồm:
Bảo mật và tuân thủ có thể không phải điều kỹ sư muốn nghĩ đến, nhưng ngày càng quan trọng. Khóa học Understanding GDPR, cùng những khóa được gợi ý trong bài, sẽ giúp bạn bắt kịp.
Mô tả: Câu hỏi này khám phá các chiến lược quản lý, tối ưu chi phí đám mây liên quan đến huấn luyện và triển khai mô hình ML, đánh giá kiến thức về kỹ thuật quản lý chi phí.
Trả lời: Các chiến lược quản lý chi phí đám mây gồm:
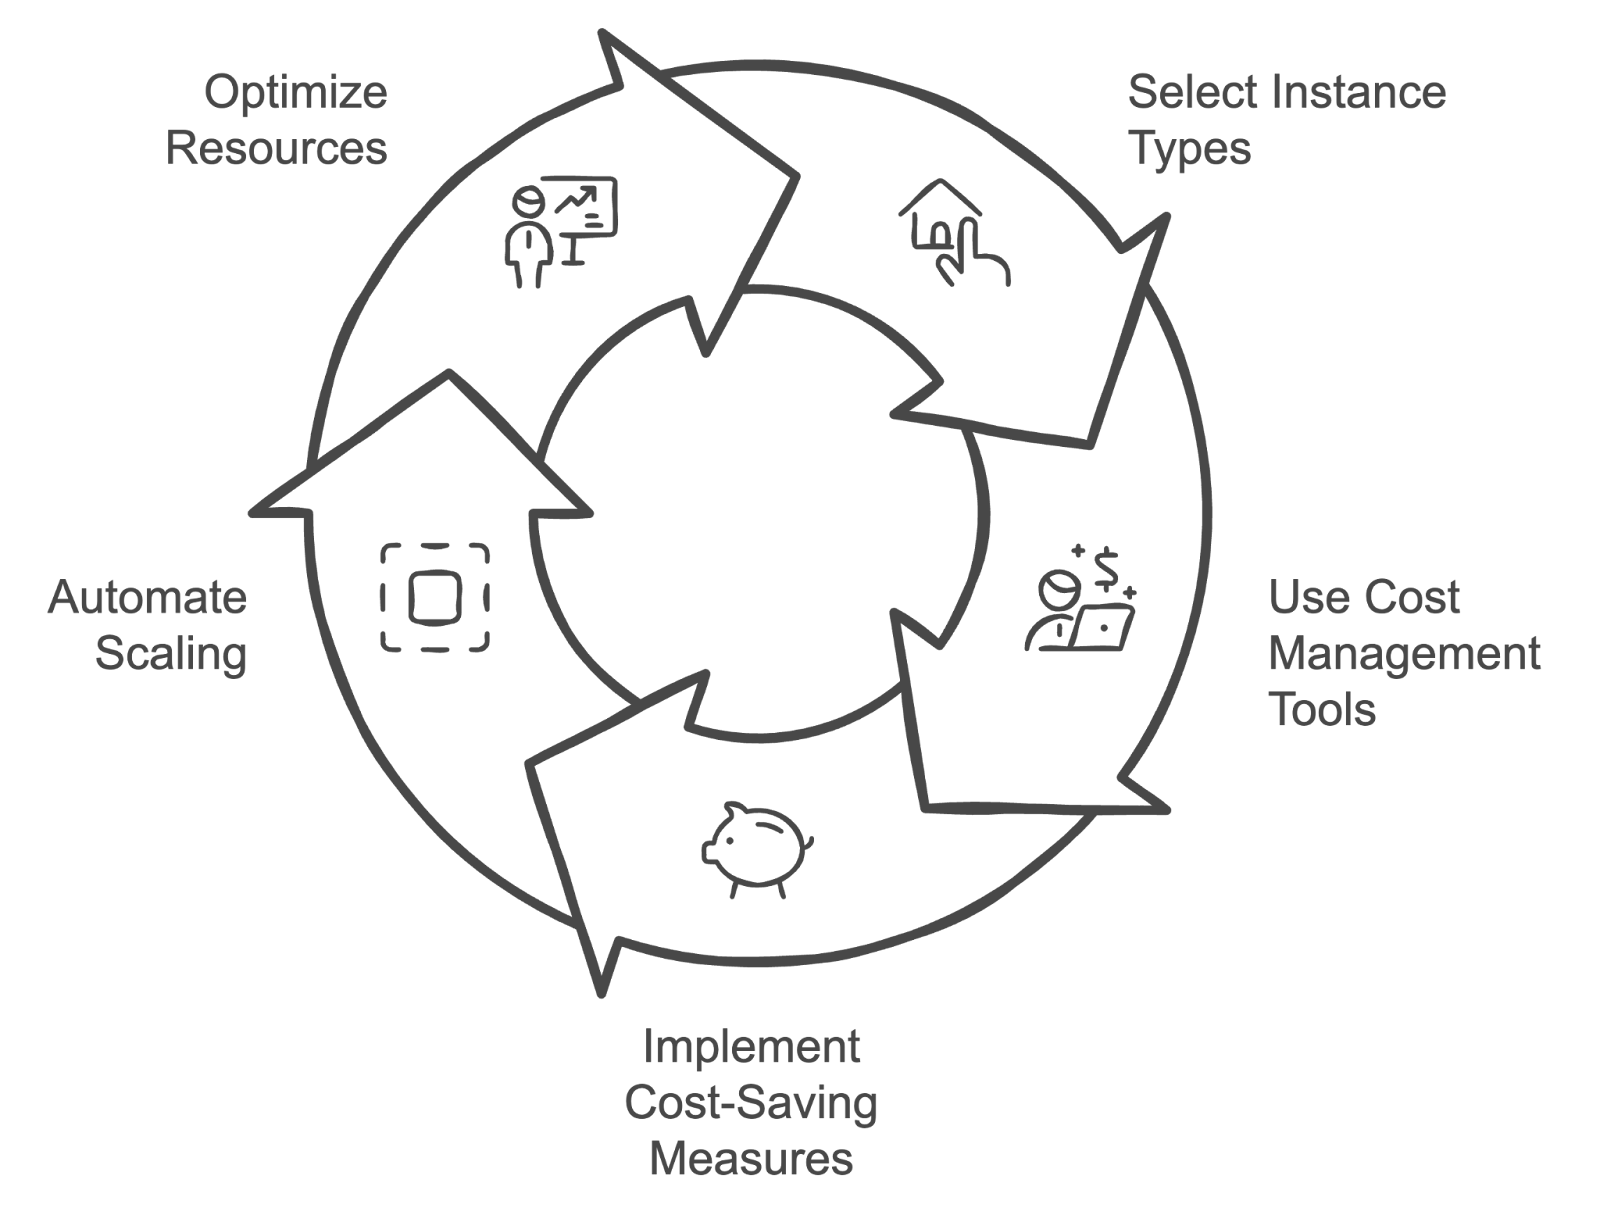
Chu trình quản lý chi phí đám mây. Ảnh: tác giả, tạo với napkin.ai
Mô tả: Câu hỏi này khám phá hiểu biết của bạn về đánh đổi khi triển khai mô hình trên thiết bị biên so với đám mây.
Trả lời: Triển khai đám mây chạy mô hình trên máy chủ tập trung, mang lại khả năng mở rộng và dễ bảo trì nhưng có thể gặp độ trễ.
Triển khai biên chạy mô hình trực tiếp trên thiết bị như smartphone hoặc IoT, giúp giảm độ trễ và cải thiện quyền riêng tư dữ liệu nhưng bị giới hạn tài nguyên tính toán. Triển khai biên phù hợp ứng dụng xử lý thời gian thực, còn đám mây phù hợp mô hình cần sức mạnh tính toán lớn và tính linh hoạt.
Mô tả: Câu hỏi này đánh giá kiến thức của bạn về xây dựng hệ thống bền bỉ cho triển khai mô hình học máy.
Trả lời: Đảm bảo sẵn sàng cao bao gồm triển khai mô hình trên nhiều vùng khả dụng hoặc khu vực và thiết lập cơ chế failover tự động.
Bộ cân bằng tải có thể phân phối lưu lượng để tránh nút thắt. Với chịu lỗi, sao lưu định kỳ, dự phòng và kiểm tra sức khỏe giúp ngăn sự cố hệ thống. Tận dụng dịch vụ đám mây như AWS Elastic Load Balancing và tính năng autoscaling cũng đảm bảo nếu một instance lỗi, instance khác có thể tiếp quản mà không downtime.
Phần này đi sâu vào khía cạnh hành vi và giải quyết vấn đề của MLOps, đánh giá cách ứng viên tiếp cận thách thức thực tế, hợp tác với đội ngũ và xử lý các vấn đề trong triển khai, quản lý mô hình học máy.
Mô tả: Câu hỏi này đánh giá kỹ năng giải quyết vấn đề trong kịch bản thực tế.
Ví dụ trả lời: "Có lần một mô hình triển khai trong sản xuất giảm hiệu năng đáng kể. Bước đầu tiên là kiểm tra log và chỉ số của mô hình để tìm bất thường. Hóa ra pipeline dữ liệu đang nạp dữ liệu bị thay đổi cấu trúc do cập nhật gần đây ở hệ thống nguồn.
Tiếp theo, tôi xác thực dữ liệu so với đầu vào kỳ vọng của mô hình và kiểm tra sai lệch. Sau khi xác nhận vấn đề dữ liệu, tôi phối hợp với đội kỹ thuật dữ liệu để sửa pipeline. Sau đó triển khai hotfix để cập nhật xử lý đầu vào đã chỉnh.
Cuối cùng, tôi theo dõi sát mô hình sau triển khai để đảm bảo hiệu năng trở lại mức mong đợi và báo cáo phát hiện, cách khắc phục cho các bên liên quan."
Mô tả: Câu hỏi này đánh giá cách bạn quản lý các phiên bản khác nhau của mô hình khi làm việc nhóm.
Ví dụ trả lời: “Tôi dùng hệ thống kiểm soát phiên bản như MLflow hoặc DVC để quản lý và theo dõi các phiên bản mô hình. Mỗi phiên bản có định danh duy nhất và kèm tài liệu chi tiết cho mỗi cập nhật để các thành viên hiểu rõ thay đổi.
Ngoài ra, tôi đảm bảo mô hình mới được kiểm thử kỹ trong môi trường staging trước khi triển khai sản xuất, giúp tránh gián đoạn và duy trì hiệu năng.”
Mô tả: Câu hỏi này đánh giá khả năng làm việc hiệu quả với các đội như nhà khoa học dữ liệu, kỹ sư và quản lý sản phẩm, cũng như cách bạn điều hướng, giải quyết thách thức trong bối cảnh đa chức năng.
Ví dụ trả lời: "Một tình huống thách thức là phối hợp giữa nhà khoa học dữ liệu, kỹ sư và quản lý sản phẩm để triển khai mô hình mới với nhiều phụ thuộc phức tạp. Chìa khóa hợp tác hiệu quả là thiết lập kênh giao tiếp rõ ràng ngay từ đầu.
Các cuộc họp định kỳ được lên lịch để thống nhất mục tiêu, theo dõi tiến độ và xử lý vướng mắc. Để thu hẹp khoảng cách kiến thức, tôi tổ chức các buổi chia sẻ để mọi người trao đổi chuyên môn.
Ngoài ra, dùng công cụ quản lý dự án để theo dõi nhiệm vụ và cột mốc giúp mọi người cập nhật tình trạng. Cách tiếp cận này đảm bảo ý kiến của từng thành viên được cân nhắc và chúng tôi cùng hướng tới triển khai thành công."
Mô tả: Câu hỏi này khám phá chiến lược mở rộng mô hình học máy để đáp ứng nhu cầu gia tăng, đánh giá hiểu biết về khía cạnh kỹ thuật và vận hành của khả năng mở rộng.
Ví dụ trả lời: "Mở rộng mô hình ML để xử lý tải tăng bao gồm vài bước then chốt.
Trước tiên, tôi phân tích các chỉ số hiệu năng hiện tại để xác định nút thắt tiềm ẩn. Để xử lý nhu cầu tăng, tôi tận dụng giải pháp auto-scaling trên đám mây để điều chỉnh tài nguyên động theo lưu lượng.
Ngoài ra, tối ưu chính mô hình bằng các kỹ thuật như lượng tử hóa (quantization) hoặc cắt tỉa (pruning) giúp giảm tiêu thụ tài nguyên mà không đánh đổi hiệu năng.
Tôi cũng triển khai kiểm thử tải để mô phỏng lưu lượng cao và đảm bảo độ bền hệ thống.
Và cuối cùng, tôi triển khai giám sát liên tục để cập nhật tình trạng hiệu năng mô hình, từ đó điều chỉnh phân bổ tài nguyên khi cần và duy trì hiệu năng dưới tải biến động.”
Mô tả: Câu hỏi này đánh giá khả năng quản lý truyền thông và kỳ vọng khi mô hình không mang lại kết quả như mong đợi.
Ví dụ trả lời: "Khi hiệu năng mô hình không đạt kỳ vọng, tôi tập trung vào giao tiếp minh bạch với các bên liên quan. Tôi giải thích giới hạn của mô hình và nguyên nhân hiệu năng, dù là do chất lượng dữ liệu, overfitting hay kỳ vọng ban đầu thiếu thực tế.
Sau đó, tôi làm việc cùng họ để đặt mục tiêu thực tế hơn, cung cấp insight dựa trên dữ liệu và đề xuất cải tiến, như thu thập thêm dữ liệu huấn luyện hoặc điều chỉnh kiến trúc mô hình."
Mô tả: Câu hỏi này đánh giá khả năng ưu tiên giữa việc duy trì chất lượng mã lâu dài và đáp ứng thời hạn dự án ngắn hạn.
Ví dụ trả lời: "Có lần chúng tôi có thời hạn gấp để triển khai mô hình cho tính năng sản phẩm mới. Chúng tôi ưu tiên giao nhanh bằng cách lược bỏ một số phần không trọng yếu của codebase, như tài liệu toàn diện và kiểm thử không thiết yếu.
Sau khi phát hành, chúng tôi dành thời gian quay lại codebase để xử lý các vấn đề này, giảm thiểu nợ kỹ thuật sau ra mắt. Cách này giúp đáp ứng thời hạn mà vẫn duy trì ổn định lâu dài cho dự án."
Chuẩn bị cho phỏng vấn MLOps đòi hỏi kết hợp kiến thức kỹ thuật, hiểu biết về môi trường công ty và truyền đạt rõ ràng kinh nghiệm quá khứ. Dưới đây là một số mẹo cần thiết để bạn sẵn sàng:
Đảm bảo bạn nắm vững các khái niệm MLOps cốt lõi. Làm quen với công cụ và nền tảng phổ biến dùng trong MLOps, như MLflow, Kubernetes và các dịch vụ đám mây như AWS SageMaker hoặc Google AI Platform.
Lộ trình MLOps skill track là tài nguyên hoàn hảo vì bao gồm bốn khóa học liên quan giúp bạn luôn cập nhật khái niệm và thực hành MLOps.
Nghiên cứu các công nghệ và công cụ cụ thể mà công ty bạn đang phỏng vấn sử dụng. Hiểu tech stack của họ sẽ giúp bạn điều chỉnh câu trả lời phù hợp với môi trường của họ và cho thấy bạn phù hợp. Tìm hiểu về dịch vụ đám mây, hệ thống kiểm soát phiên bản và thực hành quản lý mô hình ưa dùng của họ để thể hiện rằng bạn sẵn sàng hòa nhập liền mạch vào quy trình làm việc.
Hãy sẵn sàng thảo luận các dự án hoặc trải nghiệm cụ thể nơi bạn áp dụng thực hành MLOps. Chuẩn bị ví dụ làm nổi bật kỹ năng giải quyết vấn đề, khả năng làm việc đa chức năng, và kinh nghiệm triển khai, mở rộng mô hình (nếu có). Dùng các ví dụ để minh họa kiến thức thực tế và cách bạn xử lý thách thức trong vai trò trước đó.
Thường xuyên luyện tập các bài tập mã hóa liên quan đến MLOps, như viết script triển khai mô hình, tự động hóa workflow hoặc phát triển pipeline dữ liệu.
MLOps đang phát triển nhanh, nên việc cập nhật xu hướng, công cụ và thực hành mới rất quan trọng. Theo dõi blog ngành, tham gia diễn đàn hoặc hội thảo, và kết nối cộng đồng MLOps để giữ kiến thức luôn mới và phù hợp.
MLOps là lĩnh vực thu hẹp khoảng cách giữa khoa học dữ liệu và vận hành, đảm bảo mô hình học máy được triển khai, bảo trì và mở rộng hiệu quả.
Xuyên suốt bài, chúng ta đã đề cập loạt câu hỏi phỏng vấn bao trùm khái niệm chung về MLOps, khía cạnh kỹ thuật, cân nhắc về đám mây và hạ tầng, cũng như kỹ năng hành vi và giải quyết vấn đề. Luyện tập các câu hỏi này sẽ tăng đáng kể cơ hội thành công trong phỏng vấn và giúp bạn có cơ hội cao hơn để nhận việc!
Khám phá thêm các tài nguyên sau để tiếp tục học:
Tìm hiểu thêm về MLOps với các khóa học này!
Khóa học
Khóa học
Luyện tập và Lộ trình tiến trình của bạn.
Tiếp Tục Với Googleblog
Matt Crabtree
10 phút
