Cursus
Introductie tot R
4 uur
3.1M
Lineaire regressie is een van de meest belangrijke en fundamentele statistische technieken. Deze techniek beheersen is essentieel voor elke data-analist en data scientist, omdat het — zoals je zult zien — de basis vormt voor veel geavanceerdere methoden.
Deze tutorial leidt je door het uitvoeren van lineaire regressie in R, een belangrijke programmeertaal. Aan het einde begrijp je hoe je lineaire regressiemodellen implementeert en interpreteert, zodat je deze kennis makkelijker kunt toepassen in je data-analysewerk.
Ben je nog niet vertrouwd met de programmeertaal R? Bekijk dan onze tutorials om te starten: Exploratory Data Analysis in R for Absolute Beginners en Mastering Data Structures in the R Programming Language.
Een lineaire regressie is een statistisch model dat de relatie analyseert tussen een responsvariabele (vaak y genoemd) en een of meer variabelen en hun interacties (vaak x of verklarende variabelen genoemd). Zo’n relatie maak je in je hoofd voortdurend: als je bijvoorbeeld de leeftijd van een kind inschat op basis van de lengte, ga je ervan uit dat een ouder kind doorgaans langer is.
Lineaire regressie is een van de meest basale statistische modellen die er zijn. De resultaten zijn voor bijna iedereen te interpreteren en het model bestaat al sinds het begin van de 19e eeuw. Precies dat maakt lineaire regressie zo populair. Het is simpel en het heeft honderden jaren overleefd. Hoewel het niet zo geavanceerd is als andere algoritmen zoals kunstmatige neurale netwerken of random forests, was regressie volgens een enquête van KD Nuggets het meest gebruikte algoritme door data scientists in 2016 en 2017. Er wordt zelfs voorspeld dat het in het jaar 2118 nog steeds gebruikt zal worden!
In deze tutorial over lineaire regressie bekijken we hoe je in R een lineaire regressie maakt, met de stappen die je moet nemen aan de hand van een voorbeeld dat je zelf kunt doorlopen.
Wil je alle voorbeeldcode in deze tutorial eenvoudig zelf draaien, dan kun je gratis een DataLab-werkboek aanmaken met vooraf geïnstalleerde R en alle codevoorbeelden. Voor meer oefening met lineaire regressie, bekijk onze praktische DataCamp-oefening.
Niet elk probleem is met hetzelfde algoritme op te lossen. Lineaire regressie werkt goed wanneer er een lineair verband is tussen de respons en de uitkomst. Met andere woorden: lineaire regressie gaat ervan uit dat er een lineair verband bestaat tussen de responsvariabele en de verklarende variabelen. In het geval van twee variabelen betekent dit dat je een rechte lijn tussen de twee variabelen kunt passen. Teruggrijpend op ons eerdere voorbeeld van de leeftijd van een kind is het duidelijk dat er een relatie is tussen leeftijd en lengte.
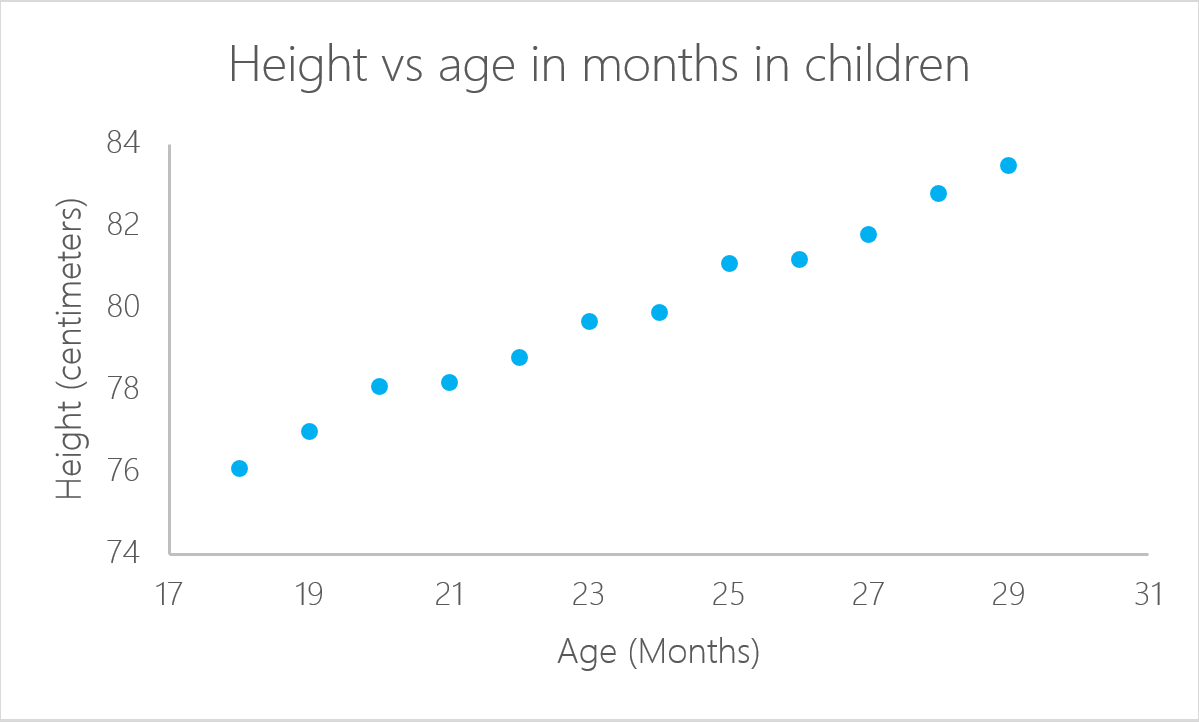
In dit specifieke voorbeeld kun je de lengte van een kind berekenen als je haar leeftijd kent:
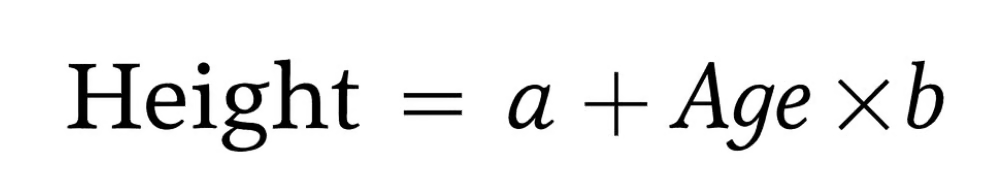
In dit geval heten a en b respectievelijk het intercept en de helling. In hetzelfde voorbeeld is a, of het intercept, de waarde vanaf waar je begint te meten. Pasgeboren baby’s van nul maanden zijn niet nul centimeter lang. Dat is de functie van het intercept. De helling meet de verandering in lengte ten opzichte van de leeftijd in maanden. In het algemeen: voor elke maand ouder wordt het kind b centimeter langer.
Een lineaire regressie kun je in R berekenen met het commando lm(). In het volgende voorbeeld gebruiken we dit commando om de geschatte lengte te berekenen op basis van de leeftijd van het kind.
Importeer eerst de bibliotheek readxl om Microsoft Excel-bestanden te lezen. Onze cursus Introduction to Importing Data in R is een geweldige bron als je nog niet bekend bent met het importeren van Excel- of CSV-bestanden in een R-omgeving zoals RStudio.
Je kunt de data voor deze tutorial downloaden voordat je begint. Download de data naar een object met de naam ageandheight en maak vervolgens in de derde regel de lineaire regressie. De functie lm() neemt de variabelen in de vorm:
lm([target] ~ [predictor], data = [data source])In de volgende code gebruiken we de functie lm() om een lineair modelobject te maken, dat we lmHeight noemen. Vervolgens gebruiken we de functie summary() op lmHeight om gedetailleerde informatie over de prestaties en coëfficiënten van het model te bekijken.
library(readxl)

ageandheight <- read_excel("ageandheight.xls", sheet = "Hoja2") #Upload the data

lmHeight = lm(height~age, data = ageandheight) #Create the linear regression

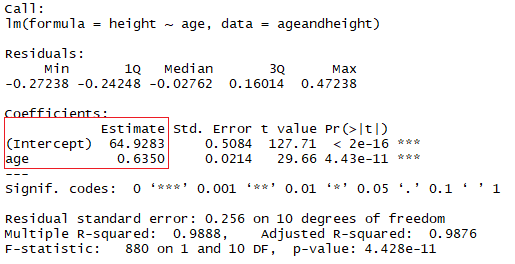
summary(lmHeight) #Review the resultsIn het rode vierkant zie je de waarden van het intercept (“a”-waarde) en de helling (“b”-waarde) voor de leeftijd. Deze “a”- en “b”-waarden tekenen een lijn tussen alle punten van de data. Dus als er in dit geval een kind is van 20,5 maanden oud, a is 64,92 en b is 0,635, dan voorspelt het model (gemiddeld) dat de lengte in centimeters ongeveer 64,92 + (0,635 * 20,5) = 77,93 cm is.
Wanneer een regressie twee of meer voorspellers meeneemt om de lineaire regressie te maken, heet dat multiple lineaire regressie. Met dezelfde logica als in het eenvoudige voorbeeld hiervoor, wordt de lengte van het kind gemeten door:
Lengte = a + Leeftijd × b1 + (Aantal broers/zussen} × b2
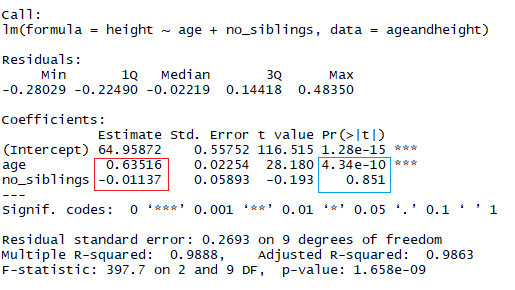
Je bekijkt de lengte nu als een functie van de leeftijd in maanden en het aantal broers en zussen dat het kind heeft. In de afbeelding hierboven geeft de rode rechthoek de coëfficiënten aan (b1 en b2). Je kunt deze coëfficiënten als volgt interpreteren:
Wanneer je kinderen met hetzelfde aantal broers/zussen vergelijkt, neemt de gemiddeld voorspelde lengte toe met 0,63 cm voor elke maand die het kind ouder is. Op dezelfde manier, wanneer je kinderen met dezelfde leeftijd vergelijkt, neemt de lengte af (omdat de coëfficiënt negatief is) met -0,01 cm voor elke toename in het aantal broers/zussen.
In R voeg je voor elke extra variabele die je aan het model wilt toevoegen een "+"-symbool toe om nog een coëfficiënt op te nemen.
lmHeight2 = lm(height~age + no_siblings, data = ageandheight) #Create a linear regression with two variables
summary(lmHeight2) #Review the results
Zoals je misschien al merkt, is naar het aantal broers/zussen kijken een onhandige manier om de lengte van een kind te voorspellen. Een ander punt om op te letten in je lineaire modellen is de p-waarde van de coëfficiënten. In het vorige voorbeeld geeft de blauwe rechthoek de p-waarden aan voor de coëfficiënten leeftijd en aantal broers/zussen. Simpel gezegd geeft een p-waarde aan of je een hypothese kunt verwerpen of accepteren. De hypothese is in dit geval dat de voorspeller niet betekenisvol is voor je model.
Een gebruikelijke manier om te testen of voorspellers niet betekenisvol zijn, is kijken of de p-waarden kleiner zijn dan 0,05.
Een goede manier om de kwaliteit van de fit van het model te testen, is kijken naar de residuals ofwel de verschillen tussen de werkelijke waarden en de voorspelde waarden. De rechte lijn in de afbeelding hierboven stelt de voorspelde waarden voor. De rode verticale lijn van de rechte lijn naar de geobserveerde datapunten is de residual.
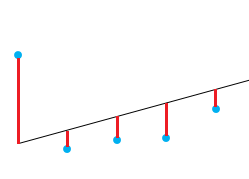
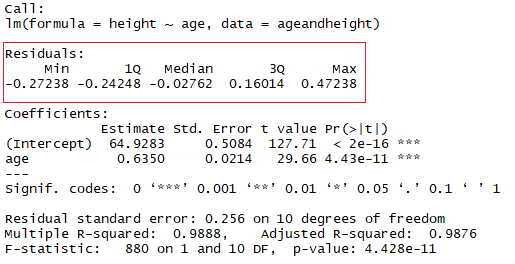
Het idee is dat de som van de residuals ongeveer nul is, of in ieder geval zo klein mogelijk. In de praktijk zullen de meeste gevallen geen perfecte rechte lijn volgen, dus residuals zijn te verwachten. In de R-summary van de functie lm() zie je beschrijvende statistieken over de residuals van het model; in hetzelfde voorbeeld laat het rode vierkant zien dat de residuals ongeveer nul zijn.
Een veelgebruikte maat om te testen hoe goed je model is, is de determinatiecoëfficiënt of R². Deze maat wordt gedefinieerd als het aandeel van de totale variabiliteit dat door het regressiemodel wordt verklaard.
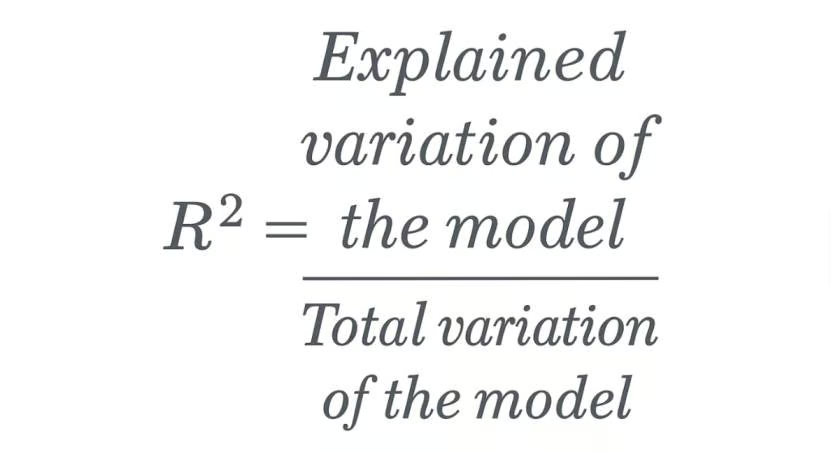
Dit kan wat ingewikkeld lijken, maar in het algemeen geldt: voor modellen die de data goed passen, ligt R² dicht bij 1. Modellen die de data slecht passen, hebben een R² dicht bij 0. In de onderstaande voorbeelden heeft de eerste een R² van 0,02; dit betekent dat het model slechts 2% van de datavariabiliteit verklaart. De tweede heeft een R² van 0,99 en kan 99% van de totale variabiliteit verklaren.**
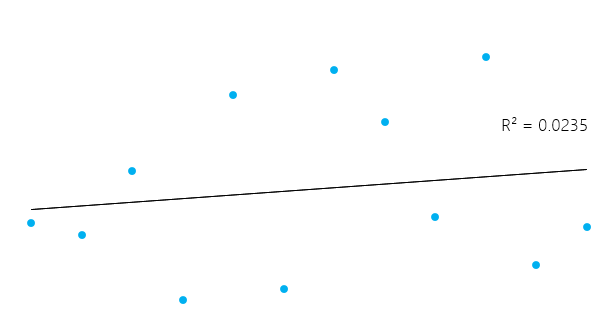
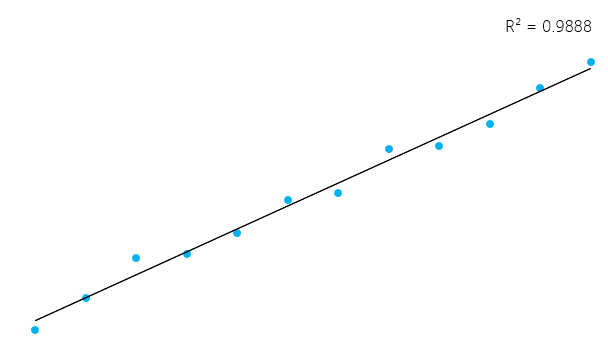
Het is echter belangrijk om in gedachten te houden dat een hoge R² niet per se altijd goed is (zie hieronder de residualplots) en een lage R² niet per se altijd slecht. In de echte wereld passen gebeurtenissen niet altijd perfect op een rechte lijn. Je kunt bijvoorbeeld in je data langere of kleinere kinderen met dezelfde leeftijd hebben. In sommige vakgebieden wordt een R² van 0,5 als goed beschouwd.
Met hetzelfde voorbeeld als hierboven: bekijk de summary van het lineaire model om de R² te zien.
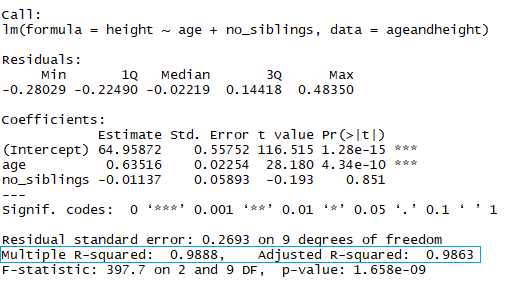
In de blauwe rechthoek zie je dat er twee verschillende R² zijn: een multiple en een aangepaste. De multiple is de R² die je eerder zag. Een probleem met deze R² is dat hij niet kan afnemen wanneer je meer onafhankelijke variabelen aan je model toevoegt; hij blijft stijgen naarmate je het model complexer maakt, zelfs als deze variabelen niets toevoegen aan je voorspellingen (zoals in het voorbeeld van het aantal broers/zussen). Om die reden is de aangepaste R² waarschijnlijk beter om naar te kijken als je meer dan één variabele aan het model toevoegt, omdat die alleen toeneemt als de totale voorspellingsfout afneemt.
Je kunt een prima R² in je model hebben, maar trek nog geen overhaaste conclusies. Laten we een voorbeeld bekijken. Je gaat de druk van een materiaal in een laboratorium voorspellen op basis van de temperatuur.
Laten we de data plotten (in een eenvoudige scatterplot) en de lijn toevoegen die je met je lineaire model hebt gebouwd. Laat in dit voorbeeld R eerst de data inlezen, opnieuw met het commando read_excel, om een dataframe met de data te maken, en maak vervolgens een lineaire regressie met je nieuwe data. Het commando plot() neemt een dataframe en plot de variabelen erin. In dit geval plot het de druk tegen de temperatuur van het materiaal. Voeg daarna de lijn toe die door de lineaire regressie is gemaakt met het commando abline.
pressure <- read_excel("pressure.xlsx") #Upload the data
lmTemp = lm(Pressure~Temperature, data = pressure) #Create the linear regression
plot(pressure, pch = 16, col = "blue") #Plot the results
abline(lmTemp) #Add a regression line
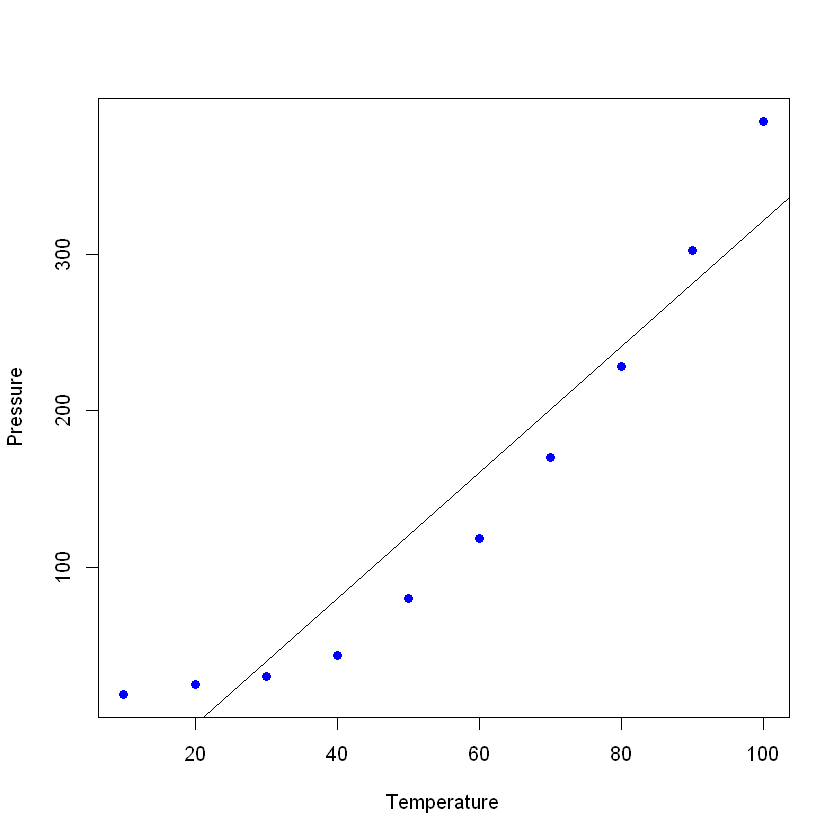
Als je de summary van je nieuwe model bekijkt, zie je dat de resultaten best goed zijn (kijk naar de R² en de aangepaste R²)
summary(lmTemp)
Call:
lm(formula = Pressure ~ Temperature, data = pressure)

Residuals:
   Min     1Q Median     3Q    Max
-41.85 -34.72 -10.90  24.69  63.51

Coefficients:
            Estimate Std. Error t value Pr(>|t|)
(Intercept) -81.5000    29.1395  -2.797   0.0233 *
Temperature   4.0309     0.4696   8.583 2.62e-05 ***
---
Signif. codes:  0 '***' 0.001 '**' 0.01 '*' 0.05 '.' 0.1 ' ' 1

Residual standard error: 42.66 on 8 degrees of freedom
Multiple R-squared:  0.902,    Adjusted R-squared:  0.8898
F-statistic: 73.67 on 1 and 8 DF,  p-value: 2.622e-05
Idealiter zien de residuals er willekeurig uit wanneer je ze plot. Is dat niet zo, dan kan er een verborgen patroon zijn dat het lineaire model niet meeneemt. Om de residuals te plotten, gebruik je het commando plot(lmTemp$residuals).
plot(lmTemp$residuals, pch = 16, col = "red")
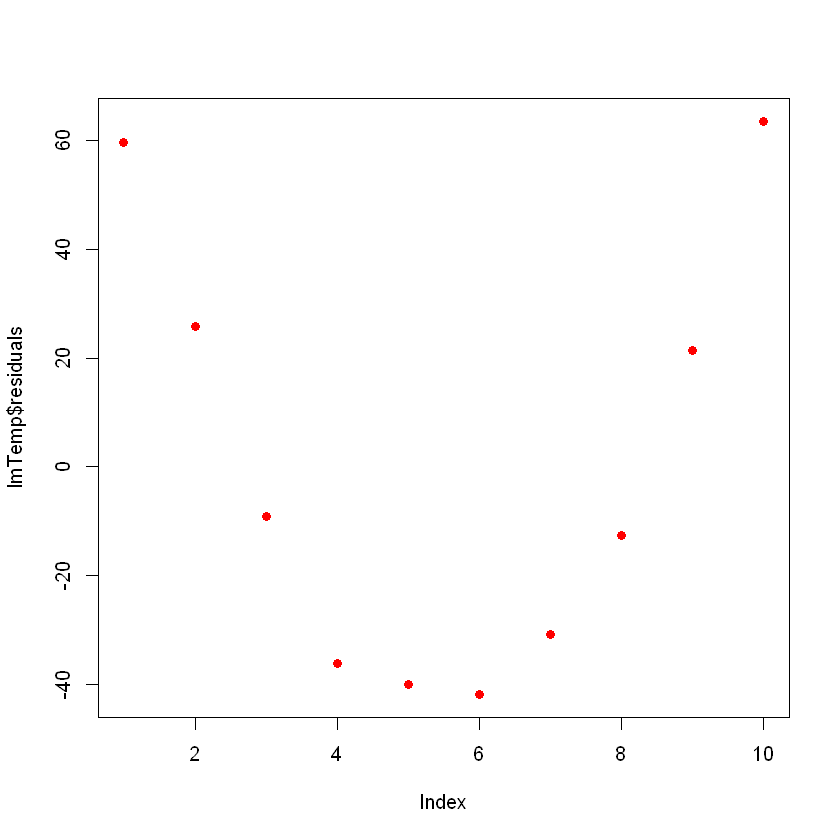
Dit kan problematisch zijn. Als je meer data hebt, zal je eenvoudige lineaire model mogelijk niet goed generaliseren. In de vorige afbeelding zie je dat er een patroon is (zoals een curve in de residuals). Dit is helemaal niet willekeurig.
Wat je kunt doen is een transformatie van de variabele. Er zijn veel mogelijke transformaties die je op je data kunt uitvoeren, zoals het toevoegen van een kwadratische term (x2), een derdegraadsterm (x3), of zelfs complexere zoals ln(X), ln(X+1), sqrt(X), 1/x, Exp(X). De keuze voor de juiste transformatie komt met kennis van algebraïsche functies, oefening en trial-and-error.
Proberen we het eens met een kwadratische term. Voeg hiervoor de term “I” (hoofdletter "I") toe vóór je transformatie; bijvoorbeeld, dit is de normale formule voor lineaire regressie:
lmTemp2 = lm(Pressure~Temperature + I(Temperature^2), data = pressure) #Create a linear regression with a quadratic coefficient
summary(lmTemp2) #Review the results
Call:
lm(formula = Pressure ~ Temperature + I(Temperature^2), data = pressure)

Residuals:
    Min      1Q  Median      3Q     Max
-4.6045 -1.6330  0.5545  1.1795  4.8273

Coefficients:
                  Estimate Std. Error t value Pr(>|t|)
(Intercept)      33.750000   3.615591   9.335 3.36e-05 ***
Temperature      -1.731591   0.151002 -11.467 8.62e-06 ***
I(Temperature^2)  0.052386   0.001338  39.158 1.84e-09 ***
---
Signif. codes:  0 '***' 0.001 '**' 0.01 '*' 0.05 '.' 0.1 ' ' 1

Residual standard error: 3.074 on 7 degrees of freedom
Multiple R-squared:  0.9996,    Adjusted R-squared:  0.9994
F-statistic:  7859 on 2 and 7 DF,  p-value: 1.861e-12
Merk op dat het model aanzienlijk is verbeterd. Als je de residuals van het nieuwe model plot, zien ze er zo uit:
plot(lmTemp2$residuals, pch = 16, col = "red")
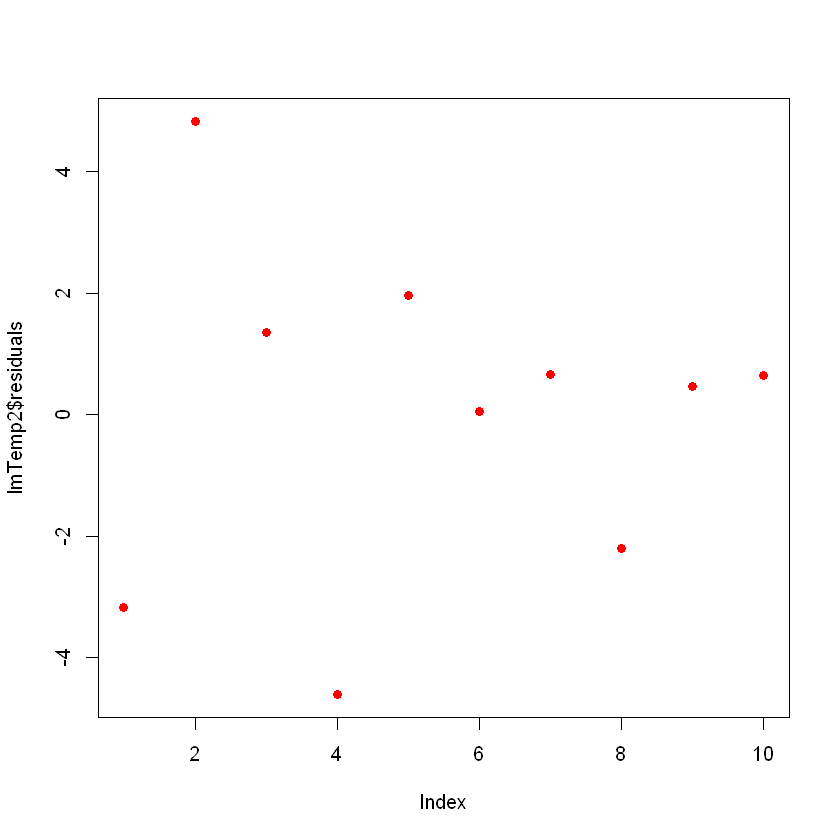
Nu zie je geen duidelijke patronen meer in je residuals, en dat is goed!
In je data kunnen invloedrijke punten zitten die je model scheef kunnen trekken, soms onnodig. Denk aan een fout bij het invoeren van data: in plaats van “2,3” is “23” ingevoerd. Het meest voorkomende type invloedrijk punt zijn uitbijters: datapunten waarbij de geobserveerde respons het patroon van de rest van de data niet lijkt te volgen.
Je kunt invloedrijke punten detecteren door te kijken naar het object met het lineaire model, met de functie cooks.distance() en vervolgens deze afstanden te plotten. Verander een waarde expres om te zien hoe die eruitziet in de Cook’s Distance-plot. Om een specifieke waarde te veranderen, kun je er direct naar verwijzen met ageandheight[rijnummer, kolomnummer] = [nieuwe waarde]. In dit geval is de lengte aangepast naar 7,7 bij het tweede voorbeeld:
ageandheight[2, 2] = 7.7
head(ageandheight)
| age | height | no_siblings |
|---|---|---|
| 18 | 76.1 | 0 |
| 19 | 7.7 | 2 |
| 20 | 78.1 | 0 |
| 21 | 78.2 | 3 |
| 22 | 78.8 | 4 |
| 23 | 79.7 | 1 |
Je maakt het model opnieuw en ziet dat de summary een slechte fit geeft, en vervolgens plot je de Cook’s Distances. Gebruik hiervoor, nadat je de lineaire regressie hebt gemaakt, het commando cooks.distance([lineair model] en als je wilt, kun je deze afstanden plotten met het commando plot().
lmHeight3 = lm(height~age, data = ageandheight)#Create the linear regression
summary(lmHeight3)#Review the results
plot(cooks.distance(lmHeight3), pch = 16, col = "blue") #Plot the Cooks Distances.
Call:
lm(formula = height ~ age, data = ageandheight)

Residuals:
    Min      1Q  Median      3Q     Max
-53.704  -2.584   3.609   9.503  17.512

Coefficients:
            Estimate Std. Error t value Pr(>|t|)
(Intercept)    7.905     38.319   0.206    0.841
age            2.816      1.613   1.745    0.112

Residual standard error: 19.29 on 10 degrees of freedom
Multiple R-squared:  0.2335,    Adjusted R-squared:  0.1568
F-statistic: 3.046 on 1 and 10 DF,  p-value: 0.1115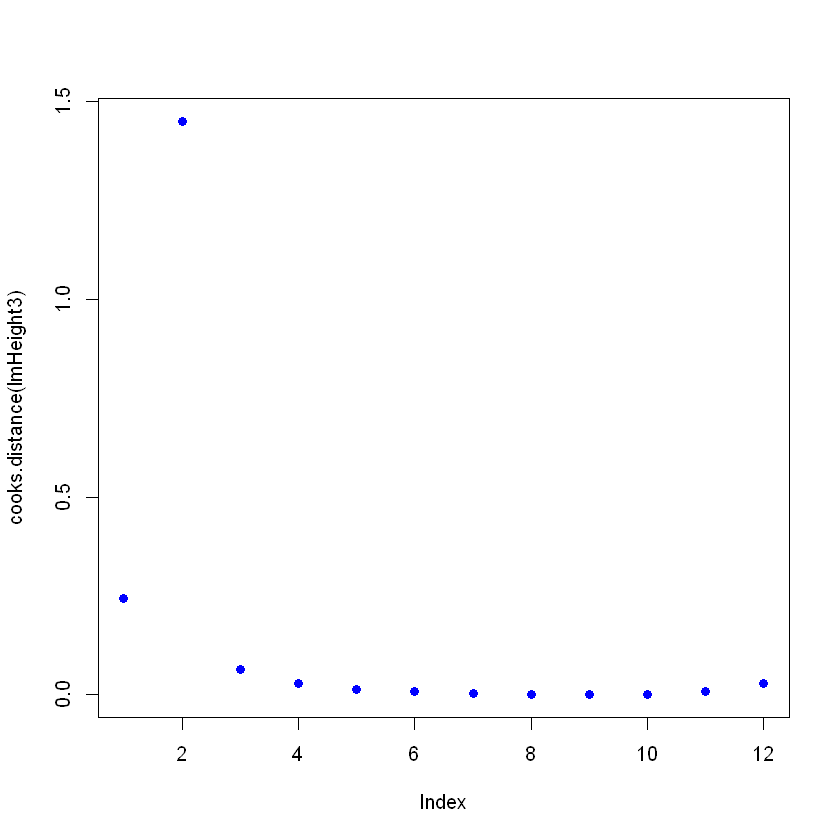
Let op dat er een punt is dat het patroon niet volgt en het model kan beïnvloeden. Hier kun je beslissingen nemen over dit punt; in het algemeen zijn er drie redenen waarom een punt zo invloedrijk is:
Als het om 1 of 2 gaat, kun je het punt verwijderen (of corrigeren). Gaat het om 3, dan is het niet zinvol een geldig punt te verwijderen; je kunt dan beter een niet-lineair model proberen in plaats van een lineair model zoals lineaire regressie.
Wees je ervan bewust dat een invloedrijk punt een geldig punt kan zijn; controleer de data en de bron voordat je het verwijdert. In statistiekboeken zie je vaak dit citaat: “Soms gooien we prima data weg terwijl we twijfelachtige modellen zouden moeten weggooien.”
Je bent tot het einde gekomen! Lineaire regressie is een groot onderwerp en het blijft relevant. We hebben hier een paar trucs laten zien die helpen om zo’n krachtig maar eenvoudig algoritme te finetunen en er het maximale uit te halen. Je leerde ook wat er achter dit eenvoudige statistische model schuilgaat en hoe je het kunt aanpassen aan jouw behoeften. Je kunt ook andere opties verkennen door ?lm in de R-console te typen en de verschillende parameters te bekijken die hier niet zijn behandeld. Bekijk ook onze Regularization Tutorial: Ridge, Lasso and Elastic Net. Wil je dieper duiken in statistische modellen, bekijk dan de cursus Statistical Modeling in R.
Omdat lineaire regressie de basis vormt van veel geavanceerde analysetechnieken, is het essentieel dat je team dit en andere kernvaardigheden goed beheerst voor langdurig succes.
DataCamp for Business biedt een oplossing op maat voor organisaties die hun teams willen bijscholen in data science en analytics. Met aangepaste leerroutes en praktische, hands-on cursussen over een breed scala aan statistische methoden, waaronder regressie en voorspellend modelleren, kan je team complexe data-uitdagingen met vertrouwen aangaan.
Vraag vandaag een demo aan en investeer in de toekomst van je organisatie door je team up-to-date te houden met de nieuwste tools en technieken in data-analyse.
R-cursussen
Cursus
Cursus
Cursus
blog
Adel Nehme
15 min

