
Cursus
Introductie tot Deep Learning in Python
4 uur
264.8K
Oefen en volg je voortgang.
Ga Verder Met GoogleDe massale adoptie van tools zoals ChatGPT en andere generatieve AI-tools heeft geleid tot een grote discussie over de voordelen en uitdagingen van AI en hoe die onze samenleving zal hervormen. Om deze vragen beter te kunnen beoordelen, is het belangrijk te weten hoe de zogeheten Large Language Models (LLM’s) achter next-gen AI-tools werken.
Dit artikel biedt een introductie tot Reinforcement Learning from Human Feedback (RLHF), een innovatieve techniek die reinforcement learning combineert met menselijke sturing om LLM’s zoals ChatGPT tot indrukwekkende resultaten te laten komen. We behandelen wat RLHF is, de voordelen, beperkingen en de relevantie voor de toekomstige ontwikkeling van het snel evoluerende domein van generatieve AI. Lees verder!
Om de rol van RLHF te begrijpen, moeten we eerst praten over het trainingsproces van LLM’s.
De onderliggende technologie van de populairste LLM’s is een transformer. Sinds de ontwikkeling door onderzoekers van Google zijn transformers het state-of-the-art model in AI en deep learning geworden, omdat ze een effectievere methode bieden om sequentiële data te verwerken, zoals de woorden in een zin.
Voor een uitgebreidere introductie tot LLM’s en transformers kun je onze Large Language Models (LLMs) Concepts Course bekijken.
Transformers worden voorgetraind met een enorme hoeveelheid tekst van het internet met behulp van self-supervised learning, een innovatieve trainingsvorm die geen menselijke actie vereist om data te labelen. Voorgetrainde transformers kunnen een breed scala aan natural language processing (NLP)-problemen oplossen.
Maar om een AI-tool zoals ChatGPT aansprekende, nauwkeurige en mensachtige antwoorden te laten geven, is een voorgetrainde LLM alleen niet genoeg. Menselijke communicatie is uiteindelijk een creatief en subjectief proces. Wat een tekst “goed” maakt, wordt sterk beïnvloed door menselijke waarden en voorkeuren, wat het erg lastig maakt om dit te meten of vast te leggen met een heldere, algoritmische oplossing.
Het idee achter RLHF is om menselijke feedback te gebruiken om de prestaties van het model te meten en te verbeteren. Wat RLHF uniek maakt ten opzichte van andere reinforcement learning-technieken is de inzet van menselijke inbreng om het model te optimaliseren, in plaats van een statistisch vooraf gedefinieerde functie om de beloning van de agent te maximaliseren.
Deze strategie maakt een meer aanpasbare en gepersonaliseerde leerervaring mogelijk, waardoor LLM’s geschikt zijn voor allerlei sectorspecifieke toepassingen, zoals code-assistentie, juridisch onderzoek, essay‑schrijven en gedichtgeneratie.
RLHF is een uitdagend proces dat een trainingsproces met meerdere modellen en verschillende implementatiefasen omvat. In essentie kun je het opdelen in drie stappen.
De eerste fase houdt in dat je een voorgetrainde LLM selecteert die later met RLHF wordt fijn-afgesteld.
Je kunt je LLM ook vanaf nul voortrainen, maar dat is kostbaar en tijdrovend. Daarom raden we aan een van de vele publiek beschikbare voorgetrainde LLM’s te kiezen.
Wil je meer weten over het trainen van LLM’s, bekijk dan onze tutorial How to Train a LLM with PyTorch met een illustratief voorbeeld.
Let op: om aan de specifieke behoeften van je model te voldoen, kun je je model, voordat je begint met de fine-tuningfase met menselijke feedback, nog verder fine-tunen op extra teksten of condities.
Als je bijvoorbeeld een juridische AI-assistent wilt ontwikkelen, kun je je model fine-tunen met een corpus van juridische teksten, zodat je LLM bijzonder vertrouwd raakt met juridische terminologie en concepten.
In plaats van een statistisch vooraf gedefinieerd beloningsmodel te gebruiken (dat heel beperkend zou zijn om menselijke voorkeuren te kalibreren), gebruikt RLHF menselijke feedback om het model te helpen een subtieler beloningsmodel te ontwikkelen. Het proces verloopt als volgt:
De volgende afbeelding illustreert het hele proces:
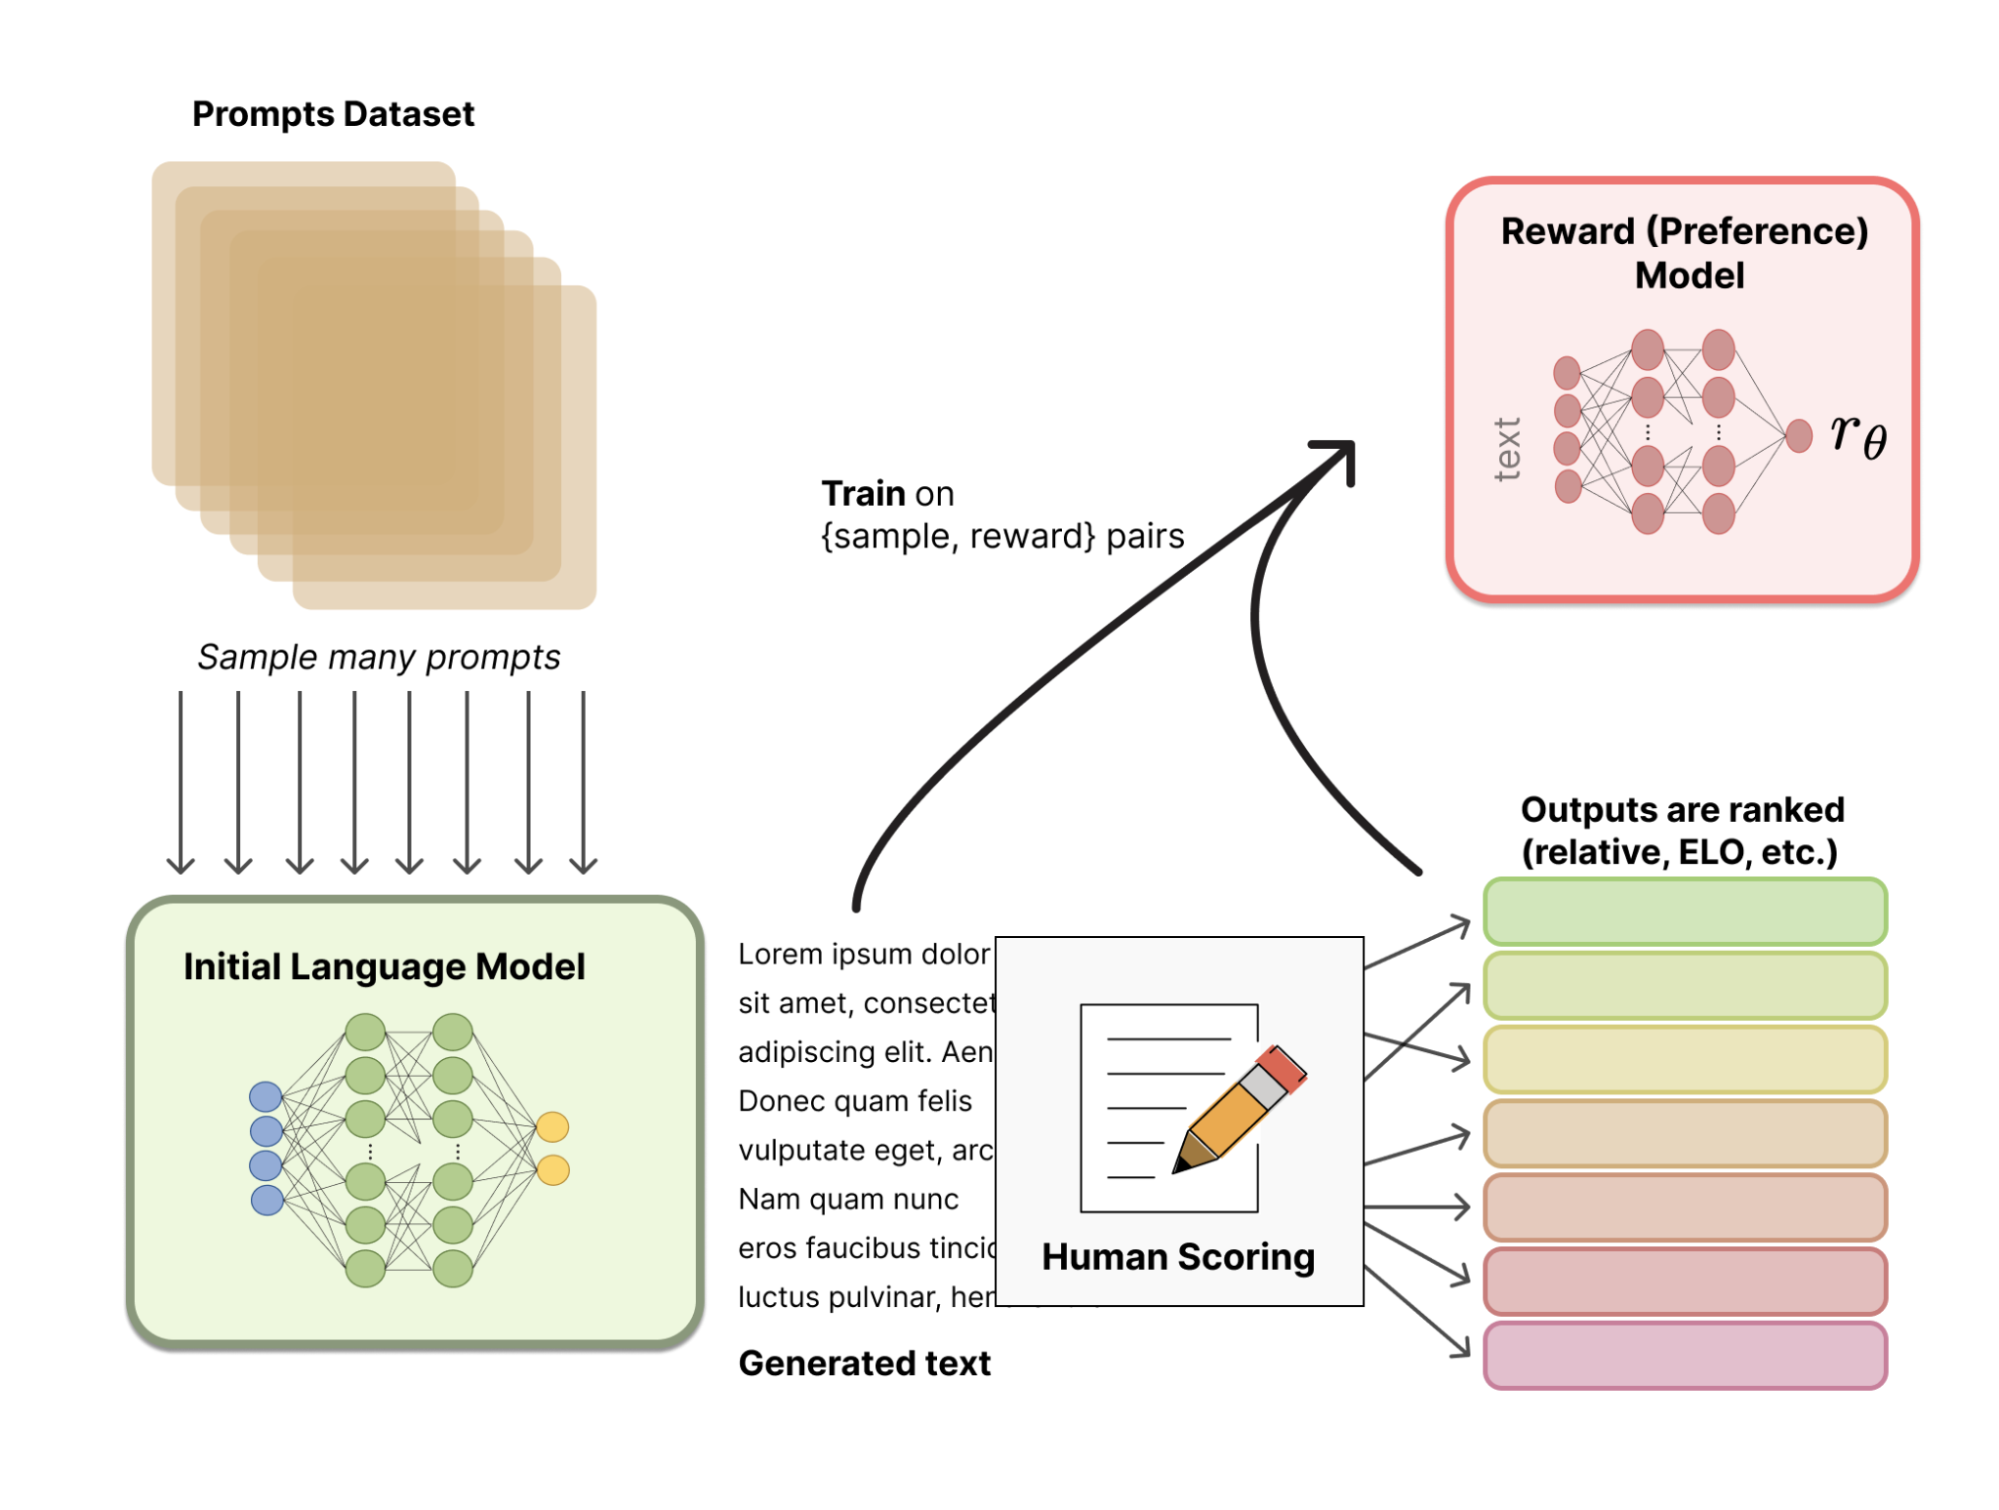
Bron: Hugging Face
In de laatste fase produceert de LLM nieuwe teksten en gebruikt die zijn op menselijke feedback gebaseerde beloningsmodel om een kwaliteitsscore te genereren. Die score wordt vervolgens door het model gebruikt om de prestaties op volgende prompts te verbeteren.
Menselijke feedback en fine-tuning met reinforcement learning-technieken worden zo gecombineerd in een iteratief proces dat doorgaat totdat een bepaalde mate van nauwkeurigheid is bereikt.
RLHF is een state-of-the-art techniek om LLM’s, zoals ChatGPT, te fine-tunen. RLHF is echter een populair onderwerp, met een groeiende literatuur die ook andere mogelijkheden buiten NLP-problemen verkent. Hieronder vind je een lijst met andere gebieden waar RLHF met succes is toegepast:
RLHF is een krachtige en veelbelovende techniek, zonder welke next-gen AI-tools niet mogelijk zouden zijn. Enkele voordelen van RLHF:
Toch is RLHF niet waterdicht. Deze techniek brengt ook bepaalde risico’s en beperkingen met zich mee. Hieronder staan enkele van de meest relevante:
RLHF is een van de pijlers van moderne generatieve AI-tools, zoals ChatGPT en GPT-4. Ondanks de indrukwekkende resultaten is RLHF een relatief nieuwe techniek en is er nog veel ruimte voor verbetering. Toekomstig onderzoek naar RLHF-technieken is cruciaal om LLM’s efficiënter te maken, hun ecologische voetafdruk te verkleinen en enkele risico’s en beperkingen van LLM’s aan te pakken.
Wil je op de hoogte blijven van de laatste ontwikkelingen in generatieve AI, machine learning en LLM’s, bekijk dan zeker onze zorgvuldig samengestelde leermaterialen:
Leer de onderwerpen uit dit artikel!
Cursus
Cursus
Oefen en volg je voortgang.
Ga Verder Met Googleblog
Adel Nehme
15 min

