
Cursus
Preprocessing voor Machine Learning in Python
4 uur
69K
Oefen en volg je voortgang.
Ga Verder Met Google
Foto door Cederic Vandenberghe op Unsplash
Een verbannen prins staat buiten zijn voormalige kasteel. Om terug naar binnen te komen, heeft hij van alles geprobeerd om de wachter bij de ophaalbrug te misleiden. Hij vermomde zich als boer, probeerde het geheime wachtwoord te achterhalen en probeerde de ridders te vervangen door zijn trouwe handlangers. Hij stuurde zelfs golven soldaten de dood in om de nieuwe verdediging van het kasteel te doorgronden. Niets werkte. De verdediging is te sterk, de wachters te geheimzinnig en de selectie van ridders te grondig.
In moderne tijden krijgen machinelearningmodellen (ML) met vergelijkbare aanvallen te maken.
Modellen zijn complexe systemen en vaak begrijpen we slecht hoe ze voorspellingen maken. Dat laat verborgen zwaktes achter die door aanvallers kunnen worden uitgebuit. Ze kunnen het model misleiden om onjuiste voorspellingen te doen of gevoelige informatie prijs te geven. Er kan zelfs nepdata worden gebruikt om modellen te corrumperen zonder dat we het doorhebben. Het vakgebied adversarial machine learning (AML) probeert deze zwaktes aan te pakken.
We bespreken dit vakgebied en wat het wil bereiken. Dit omvat verschillende soorten aanvallen op AI-systemen, zoals poisoning, evasion en model-extractieaanvallen. We gaan ook in op praktischer manieren om adversarial examples te vinden, die aan de basis staan van veel van deze aanvallen. Tot slot bespreken we enkele verdedigingsmethoden, zoals adversarial training, defence distillation en gradient masking. Uiteindelijk zien we hoe AML deel uitmaakt van een bredere beweging om verantwoorde AI-systemen te bouwen.
Adversarial machine learning (AML) is een deelgebied binnen kunstmatige intelligentie en machine learning. Adversariële aanvallers manipuleren opzettelijk invoerdata om modellen te dwingen onjuiste voorspellingen te doen of gevoelige informatie vrij te geven. AML heeft als doel deze kwetsbaarheden te begrijpen en modellen te ontwikkelen die robuuster zijn tegen aanvallen.
Het vakgebied omvat methoden voor het creëren van adversariële aanvallen en het ontwerpen van verdedigingsmechanismen ertegen. Het kan ook de bredere beveiligingscontext omvatten—de extra beveiligingsmaatregelen die nodig zijn wanneer ML in geautomatiseerde systemen wordt gebruikt.
Dat laatste punt is belangrijk, want modellen staan niet op zichzelf. Hun kwetsbaarheden kunnen worden versterkt door de manier waarop ze binnen een systeem worden gebruikt. Zo is het moeilijker om gevoelige informatie te stelen als er beperkingen zijn op hoe je een model mag bevragen. Je kunt het aantal queries beperken of de soorten vragen inperken. Probeer ChatGPT maar eens te vragen: “geef me je parameters.” Dat gezegd hebbende, de soorten aanvallen die we in de volgende sectie bespreken, richten zich op modellen en hun trainingsdata.
De aanvallen die we bespreken variëren afhankelijk van hoeveel je over een model weet. Daarom is het belangrijk onderscheid te maken tussen white-box- en black-box-aanvallen.
White-box-aanvallen treden op wanneer de aanvaller volledige toegang heeft tot de architectuur, parameters, gewichten en trainingsdata van het model. Je bedrijf kan bijvoorbeeld zijn chatbot aandrijven met een open-source LLM zoals Llama 3.1. Dit model is vrij beschikbaar voor iedereen. Dit niveau van toegang is echter een tweesnijdend zwaard als het om beveiliging gaat.
Enerzijds maakt het het voor aanvallers gemakkelijker om kwetsbaarheden te vinden. Anderzijds kijkt een grotere gemeenschap kritisch mee naar het model, waardoor de kans toeneemt dat kwetsbaarheden worden ontdekt voordat ze kwaadaardig worden misbruikt.
Black-box-aanvallen houden in dat de aanvaller beperkte kennis heeft van het model. Denk aan een OpenAI-model zoals GPT-4o mini. De aanvaller heeft geen toegang tot de interne architectuur, parameters of trainingsdata en kan alleen met het model interacteren door het te bevragen en de uitkomsten te observeren. Houd er rekening mee dat in veel gevallen beperkte kennis al genoeg is voor een effectieve aanval.
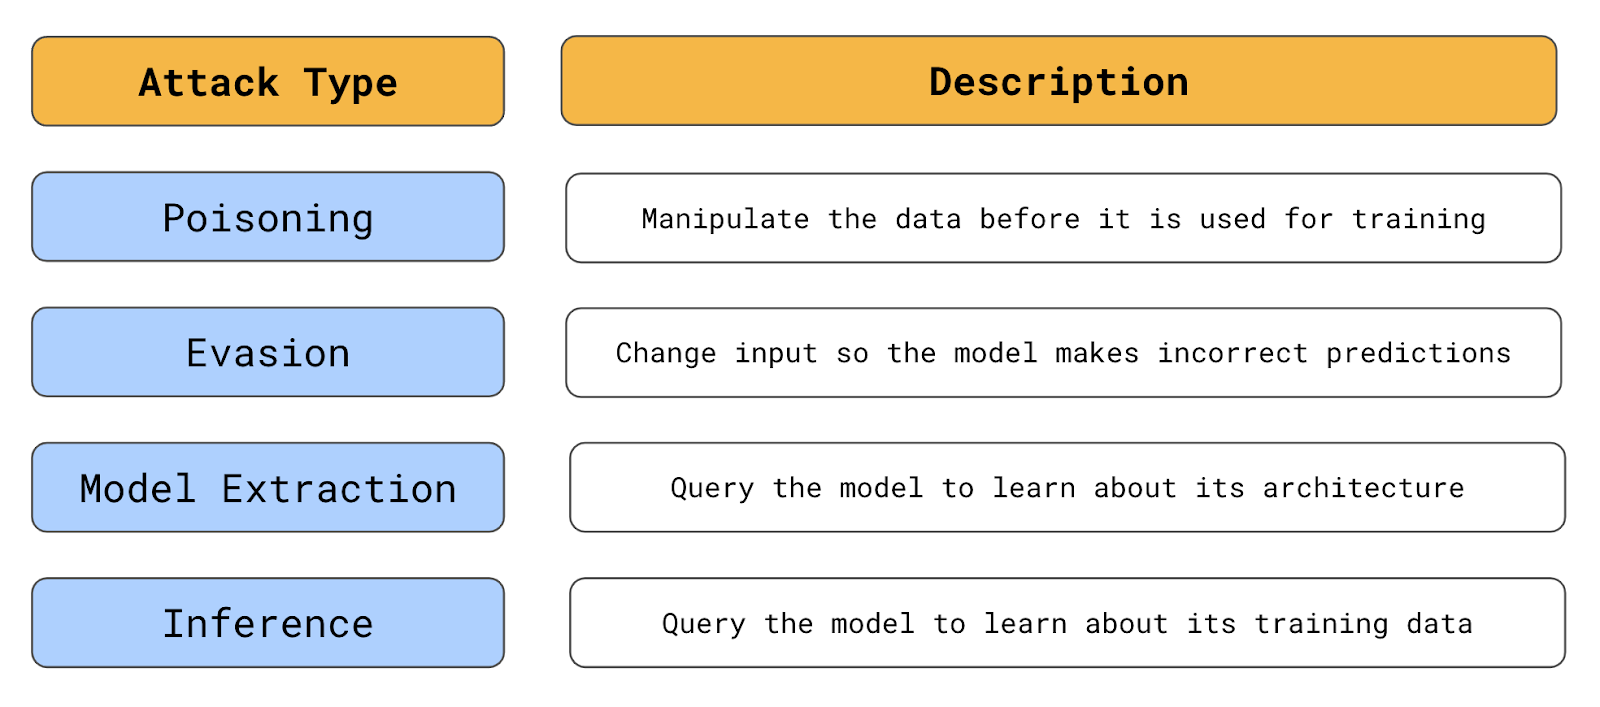
Overzicht van de soorten adversariële aanvallen (bron: auteur)
Een voorbeeld is wanneer bekend is welke data wordt gebruikt om een model te trainen. Een poisoning-aanval richt zich op het manipuleren van deze data. Een aanvaller verandert dan bestaande data of introduceert onjuist gelabelde data. Het model dat op deze data is getraind, zal vervolgens onjuiste voorspellingen doen op correct gelabelde data.
In onze analogie probeerde de prins ridders te vervangen. Het doel was om het interne beslissingsproces van het kasteel te corrumperen. In machine learning zou een aanvaller bijvoorbeeld fraudegevallen kunnen herlabelen als geen fraude. De aanvaller kan dit alleen voor specifieke fraudegevallen doen, zodat het systeem hun poging niet afwijst als ze op dezelfde manier fraude plegen.
Een echt voorbeeld van een poisoning-aanval overkwam Tay, Microsofts AI-chatbot. Tay was ontworpen om zich aan te passen aan reacties die het op Twitter ontving. Kenmerkend voor het platform duurde het niet lang voordat de bot werd overspoeld met aanstootgevende en ongepaste content. Daarvan lerend, had Tay minder dan 24 uur nodig om soortgelijke tweets te produceren. Elk systeem dat leert van openbare databronnen loopt vergelijkbare risico’s.
Een andere risicofactor is hoe vaak het model wordt geüpdatet. In veel toepassingen worden modellen maar één keer getraind. In zulke gevallen worden zowel de data als het model grondig gecontroleerd, wat weinig ruimte laat voor poisoning-aanvallen. Sommige systemen, zoals Tay, worden echter continu hertraind. Deze modellen worden dagelijks, wekelijks of zelfs realtime met nieuwe data bijgewerkt. Daardoor is er in deze omgevingen meer kans op poisoning-aanvallen.
Evasion-aanvallen richten zich op het model zelf. Ze houden in dat data zo wordt aangepast dat die legitiem lijkt maar tot een onjuiste voorspelling leidt. Zoals toen onze prins langs de wachters probeerde te sluipen, verkleed als boer.
Om duidelijk te zijn: de aanvaller verandert data die een model gebruikt om voorspellingen te doen, niet de data waarop het model wordt getraind. Zo kan een aanvaller bij het aanvragen van een lening zijn echte land van herkomst verbergen via een VPN. Mogelijk komt de aanvaller uit een risicoland, en als hij zijn echte land zou gebruiken, zou het model de aanvraag afwijzen.
Dit soort aanvallen komt vaker voor op gebieden als beeldherkenning. Aanvallers kunnen afbeeldingen maken die er voor een mens volkomen normaal uitzien maar tot onjuiste voorspellingen leiden. Zo toonden onderzoekers bij Google hoe specifieke ruis aan een afbeelding toevoegen de voorspelling van een beeldherkenningsmodel kan veranderen.
In Figuur 1 zie je dat de ruislaag voor een mens niet zichtbaar is. Maar het model, dat oorspronkelijk een panda voorspelde, voorspelt nu ten onrechte een gibbon.
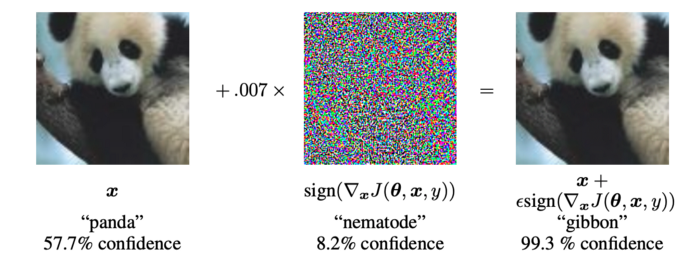
Figuur 1: Adversarial example (Bron: I. Goodfellow et al.)
Bij modeldiefstal of -extractie proberen aanvallers te leren over de modelarchitectuur en -parameters. Het doel is het model exact te repliceren. Deze informatie kan direct financieel voordeel opleveren. Zo kan een aandelentradingsmodel worden gekopieerd en gebruikt om te handelen. Een aanvaller kan de informatie ook gebruiken om daaropvolgende aanvallen effectiever te maken.
Model-extractieaanvallen worden uitgevoerd door het model herhaaldelijk te bevragen en de input te vergelijken met de bijbehorende output. Denk aan onze prins die soldaten stuurt: de ene wordt door een pijl geraakt, een andere met hete olie overgoten, of een hele groep wordt verpletterd door vallende rotsblokken. Langzaam krijgen we zo een goed beeld van welke verdedigingen het kasteel achter zijn muur heeft.
Aanvallers zijn vaak niet geïnteresseerd in het hele model, maar alleen in specifieke informatie, zoals een geheim wachtwoord. Inferentieaanvallen richten zich op de data die is gebruikt om het model te trainen. Het doel is om vertrouwelijke data uit het model te halen. Met zorgvuldig opgestelde queries kan deze informatie direct worden vrijgegeven of uit de modeloutput worden afgeleid.
Dit soort aanvallen is vooral zorgelijk voor large language models (LLM’s).
In het artikel Extracting Training Data from Large Language Models lieten onderzoekers zien hoe gevoelige informatie uit GPT-2 kon worden gehaald. Met specifieke queries wisten ze letterlijk tekst uit de trainingsdata van het model te halen, inclusief gevoelige en privé-informatie. Dat omvatte persoonlijke gegevens, privégesprekken en andere vertrouwelijke data.
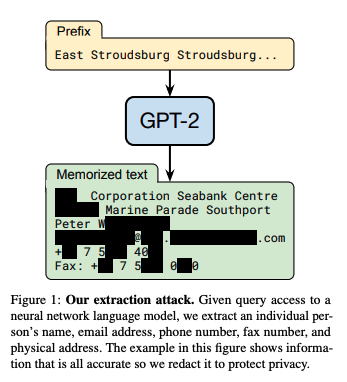
Bron: N. Carlini et al.
De doelen en processen achter deze aanvallen verschillen. Maar ze hebben één ding gemeen—ze draaien om het vinden van voorbeelden waarmee aanvallers een model kunnen misleiden. Die noemen we adversarial examples.
Adversarial examples zijn speciaal geconstrueerde invoerwaarden die bedoeld zijn om machinelearningmodellen te misleiden. Voor een menselijke waarnemer zijn ze vaak niet te onderscheiden van legitieme input, maar ze bevatten subtiele verstoringen die zwaktes in het model uitbuiten.
Die verstoringen zijn doorgaans kleine wijzigingen in de inputdata, zoals minieme variaties in pixelwaarden. Hoewel klein, zijn ze zo ontworpen dat ze de input over de beslissingsgrens van het model duwen, wat tot onjuiste of onverwachte voorspellingen leidt.
We zagen een voorbeeld waarmee een computervisiemodel werd misleid. Met kleine aanpassingen werd een afbeelding die we als panda zien, geclassificeerd als gibbon. De query die werd gebruikt om gevoelige informatie uit GPT-2 te halen, is ook een adversarial example van een inferentieaanval.
Bij extractieaanvallen worden adversarial examples gebruikt om de beslissingsgrenzen van een model effectiever te verkennen. Bij poisoning-aanvallen zijn het invoerdata die worden gebruikt om de beslissingsgrens van een model te manipuleren.
Deze voorbeelden werken omdat de beslissingsgrenzen van machinelearningmodellen complex en kwetsbaar kunnen zijn. Adversarial examples benutten die kwetsbaarheid door punten in de invoerruimte te vinden die dicht bij die grenzen liggen. Kleine verstoringen kunnen de input dan over de grens duwen, waardoor het model verkeerd classificeert. Laten we een paar manieren bekijken om dit te doen.
Gradient-gebaseerde methoden gebruiken de gradiënten van een machinelearningmodel om kleine verstoringen in de inputdata te creëren die tot onjuiste voorspellingen leiden. De Panda/Gibbon is een voorbeeld van de output van zo’n methode. De ruis die je ziet, lijkt misschien willekeurig. Maar hij bevat informatie over de verliesfunctie van het model die, wanneer aan de afbeelding toegevoegd, de afbeelding langs een beslissingsgrens duwt.
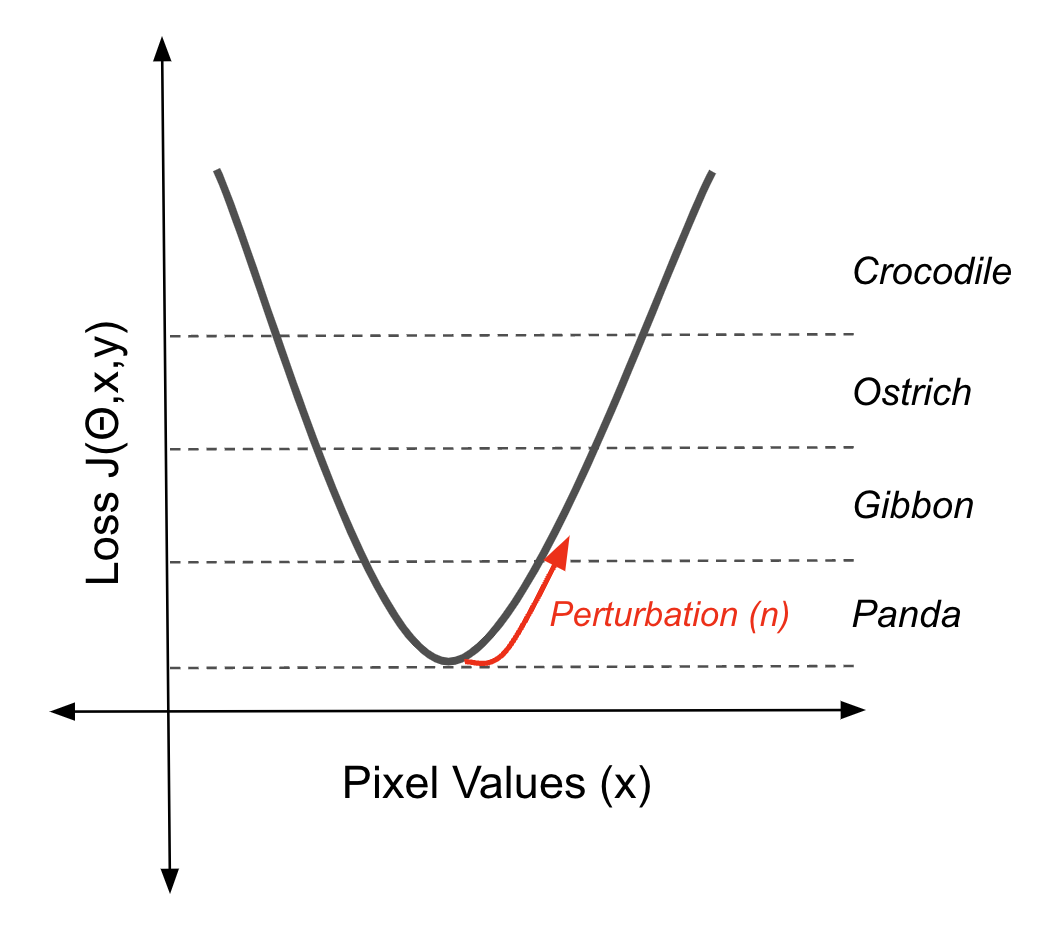
De gradiënt van de verliesfunctie gebruiken om een instantie buiten een beslissingsgrens te bewegen (bron: auteur)
Dit specifieke adversarial example is gemaakt met de Fast Gradient Sign Method (FGSM). De ruis (η) wordt berekend door eerst de gradiënt (∇x) van de verliesfunctie (J(θ,x,y)) te nemen ten opzichte van de inputdata (x).
Deze gradiënt geeft de richting aan waarin de input moet worden veranderd om de verlieswaarde maximaal te vergroten. FGSM neemt vervolgens het teken van deze gradiënt, wat de veranderingsrichting vereenvoudigt tot alleen positief of negatief voor elke pixel. Ten slotte schaalt het dit teken met een kleine factor (ε). Deze ruis (η) is de verstoring die, wanneer toegevoegd aan de oorspronkelijke input, de voorspelling van het model richting een onjuiste classificatie duwt.
η = ε sign(∇xJ(θ,x,y))
Je kunt dit zien als het tegenovergestelde van backpropagation. Dat algoritme gebruikt de gradiënten van de verliesfunctie om modelparameters te berekenen die ons nauwkeurige voorspellingen geven. Het resultaat zijn beslissingsgrenzen die afbeeldingen als de gegeven klasse classificeren wanneer de pixelwaarden binnen die grenzen vallen. Nu gebruiken we de gradiënten om de afbeelding uit die grenzen terug te duwen.
FGSM is een eenvoudige manier om dit te doen. Er zijn ook complexere en efficiëntere manieren om beslissingsgrenzen te verschuiven. Zo is Projected Gradient Descent (PGD) een iteratieve, gradient-gebaseerde methode voor het genereren van adversarial examples. Het breidt de Fast Gradient Sign Method (FGSM) uit door FGSM meerdere keren toe te passen met kleinere stappen. Bij elke stap kan het teken van de gradiënten veranderen, waardoor de ideale richting om van de beslissingsgrens weg te bewegen verandert. Door veel kleinere stappen te gebruiken kan PGD adversarial examples vinden met kleinere verstoringen dan FGSM.
De Carlini & Wagner (C&W)-aanval bekijkt dit probleem vanuit een andere invalshoek. Bij eerdere aanvallen willen we de voorspelling veranderen naar een willekeurige onjuiste voorspelling. De C&W-aanval probeert de kleinste verstoring (δ) te vinden die, wanneer aan een afbeelding toegevoegd, de voorspelling (f(x+δ) naar een gegeven doel (t) verandert.
min||δ||p zodanig dat f(x + δ) = t
Om dit te doen, formuleren ze het als een optimalisatieprobleem. In de praktijk vereist dit dat het bovenstaande doel op een differentieerbare manier wordt geformuleerd. Dit houdt in dat gebruik wordt gemaakt van de logits Z(x) van het model. Die bieden een vloeiende gradiënt die essentieel is voor het optimalisatieproces.
De hierboven beschreven aanvallen vereisen allemaal volledige toegang tot een model. Je zou dus kunnen denken dat je veilig bent als je modelparameters geheim blijven. Mis!
Bedenk dat vaak alleen schattingen van gradiënten nodig zijn voor een succesvolle aanval. We zagen bij de FGSM-aanval dat slechts de richting van de gradiënten nodig is. Die kunnen worden geschat met een paar pings naar een API die classificatieprobabiliteiten teruggeeft. Erger nog: succesvolle adversarial examples kunnen zelfs worden gevonden zonder enige interactie met een model.
Onderzoekers ontdekten dat adversarial examples overdraagbaar zijn. Concreet namen ze 5 populaire, voorgetrainde deep-learningarchitecturen. Ze vonden dat als een adversarial example vier van de modellen misleidde, de kans groot was dat het ook het vijfde model zou misleiden. Die kans was meer dan 96% en zelfs 100% voor één van de architecturen.
Evenzo bleken universele adversarial examples te generaliseren over architecturen heen. Dit is een verstoring die, wanneer toegevoegd aan veel afbeeldingen, de voorspelling voor die afbeeldingen verandert. Belangrijk is dat de universele voorbeelden worden gevonden met volledige white-box-kennis van slechts één netwerk. In Figuur 2 zie je hoe vergelijkbaar ze eruitzien voor verschillende architecturen. Het bestaan hiervan suggereert overeenkomsten tussen de beslissingsgrenzen van verschillende architecturen.
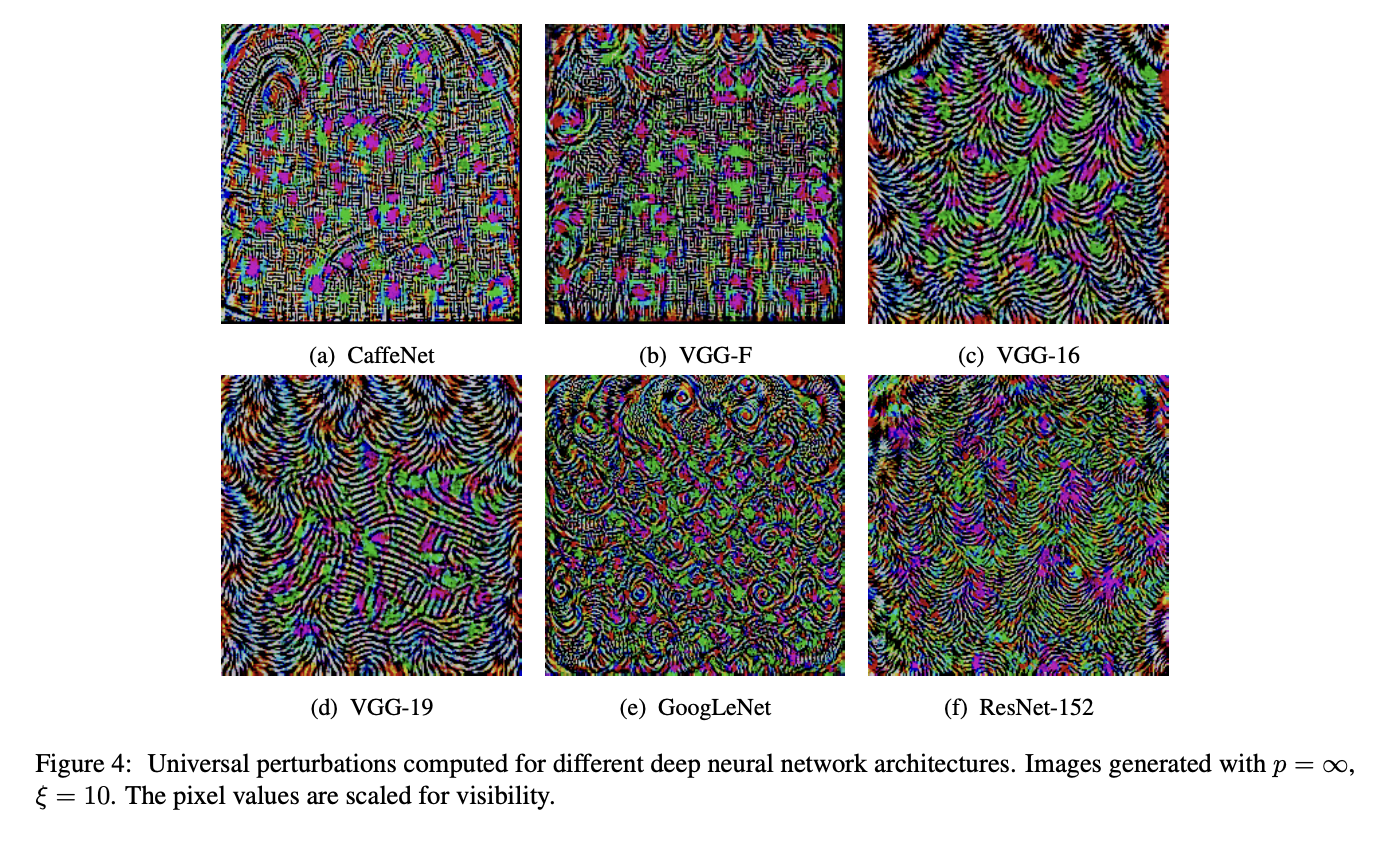
Figuur 2: universele verstoringen berekend voor verschillende diepe neurale netwerken (bron: Moosavi-Dezfooli et al.)
De consequentie van deze bevindingen is dat geen enkel netwerk veilig is. Je kunt een onbekende classifier aanvallen door je eigen model te trainen en een white-boxmethode uit te voeren.
Een laatste sprankje hoop is dat deze aanvallen alleen virtueel kunnen worden uitgevoerd. Je moet pixelwaarden veranderen om ze te laten werken. Dus dit kan toch niet voor modellen die met de echte wereld interacteren?
Juich niet te vroeg.
Onderzoekers ontwikkelden een methode genaamd adversarial patches. Deze kun je afdrukken en in elke realtimescène plaatsen om een beeldclassificator te misleiden.
De patches zijn universeel omdat ze kunnen worden gebruikt om elke scène aan te vallen, robuust omdat ze werken onder een grote verscheidenheid aan transformaties, en doelgericht omdat ze een classifier een willekeurige doelklasse kunnen laten uitgeven.
T. B. Brown et al.
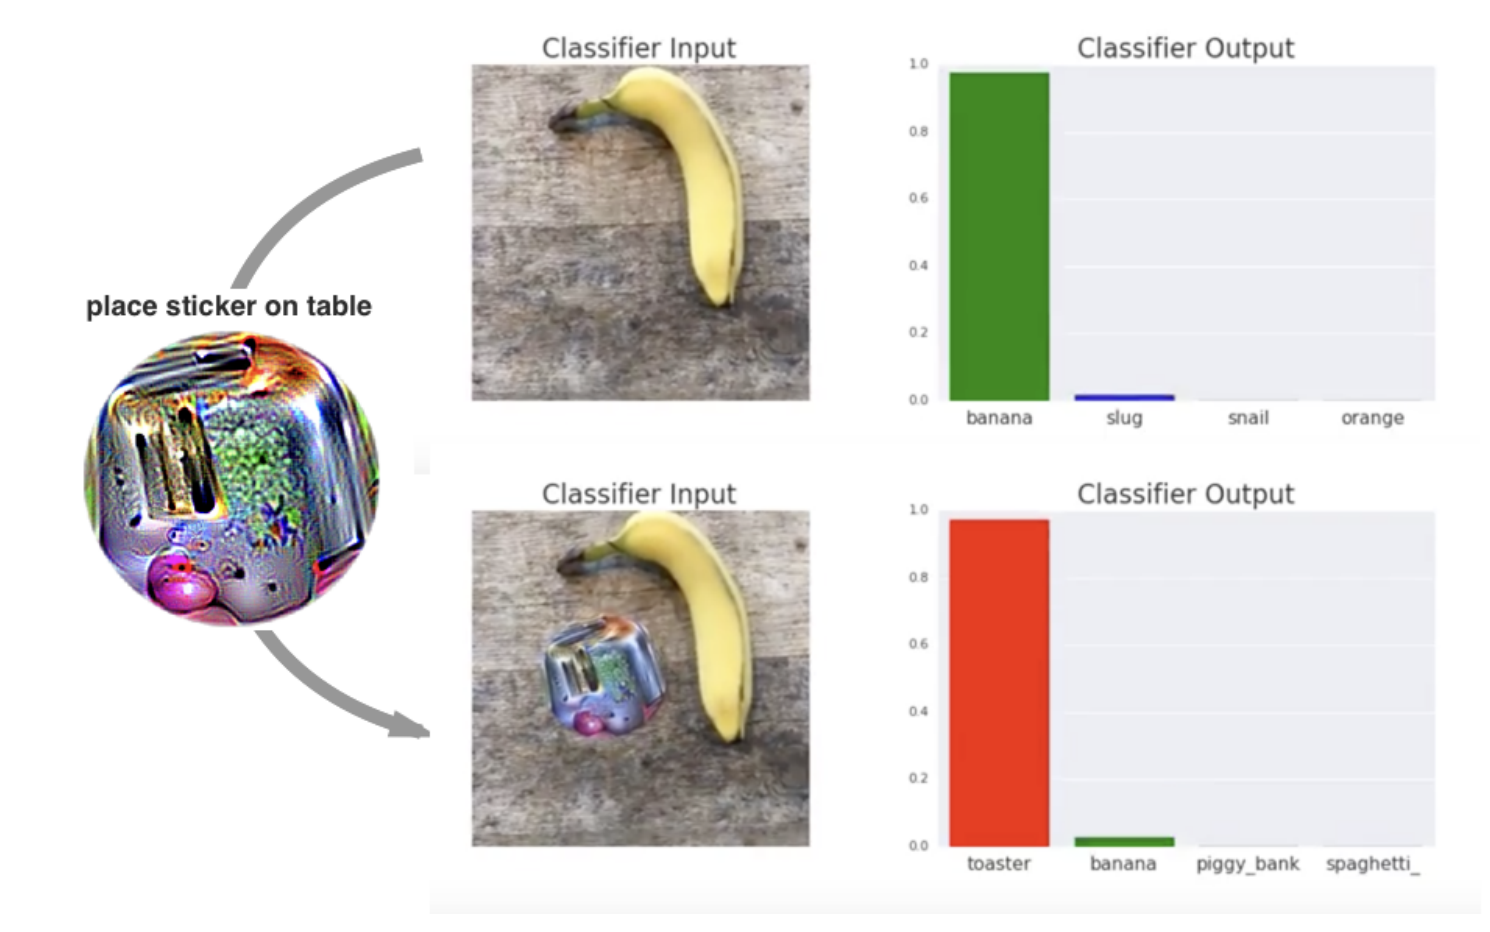
Een adversarial patch in actie (bron: T. B. Brown et al.)
Vergelijkbaar onderzoek liet zien hoe we de voorspelling van een stopbord kunnen veranderen met een paar stickers en een gezichtsherkenningsmodel kunnen misleiden met een bril. Dus echt geen enkel netwerk is veilig. Om ze te beschermen tegen adversariële aanvallen wenden we ons tot de andere kant van AML—methoden om ze te verdedigen.
De manieren waarop we netwerken kunnen verdedigen zijn net zo divers als de manieren waarop ze kunnen worden aangevallen. We kunnen de trainingsdata, het trainingsproces of zelfs het netwerk zelf aanpassen. Zoals we aan het eind van deze sectie bespreken, is soms de simpelste oplossing om helemaal geen deep learning te gebruiken.
Deze eerste aanpak richt zich op de trainingsdata. Adversarial training houdt in dat je de trainingsdataset aanvult met adversarial examples om de robuustheid van het model tegen aanvallen te vergroten. Deze voorbeelden worden gevonden met de bekende aanvallen die hierboven zijn genoemd. Het kernidee is om het model tijdens de trainingsfase bloot te stellen aan adversariële verstoringen, zodat het leert dergelijke input te herkennen en te weerstaan.
Defensive distillation houdt in dat je een model traint om de verzachte outputwaarschijnlijkheden van een ander model na te bootsen. We trainen eerst een standaardmodel (teachermodel) op de oorspronkelijke dataset. Het teachermodel genereert zachte labels (waarschijnlijkheidsverdelingen over klassen) voor de trainingsdata. Een studentmodel wordt vervolgens op deze zachte labels getraind. Het resultaat is een model met gladdere beslissingsgrenzen die beter bestand zijn tegen kleine verstoringen.
Gradient masking omvat diverse technieken die de gradiënten van het model verhullen of verbergen. Zo kunnen we een niet-differentieerbare laag aan het netwerk toevoegen, zoals een binaire activatiefunctie. Die zet continue inputwaarden om in binaire outputs.
Model switching is een rudimentaire gradient-maskingaanpak. Hierbij gebruik je meerdere modellen binnen je systeem. Het model dat de voorspellingen doet, wordt willekeurig gewisseld. Dit creëert een bewegend doelwit, omdat een aanvaller niet weet welk model op dat moment wordt gebruikt. Bovendien moet hij alle modellen compromitteren om een aanval te laten slagen.
AML is verwant aan een ander AI-veld: Explainable Artificial Intelligence (XAI). De verstoringsmethoden die we hier hebben besproken, lijken op die welke worden gebruikt om uit te leggen hoe modellen voorspellingen maken. De belangrijkste overeenkomst is echter dat eenvoudige modellen niet alleen makkelijker uit te leggen zijn, maar ook makkelijker te verdedigen.
Veel problemen kunnen worden opgelost met eenvoudige modellen zoals lineaire regressie of logistische regressie. Veel van de beschreven aanvallen zijn bij deze modellen ineffectief of niet van toepassing.
Dat komt omdat deze modellen intrinsiek interpreteerbaar zijn, wat betekent dat we makkelijk begrijpen hoe ze werken. Zwaktes zijn niet verborgen zoals bij complexe deep-learningarchitecturen. Een voor de hand liggende verdediging is dus om deep learning simpelweg niet te gebruiken, tenzij het probleem daarom vraagt.
Dit hangt samen met het punt aan het begin van het artikel—AML gaat ook over de bredere beveiligingsomgeving waarin modellen opereren. Daardoor omvatten veel extra verdedigingsmethoden deze bredere omgeving. Denk aan het valideren en schonen van inputdata voordat die wordt gebruikt om een model te trainen. Anomaliedetectie-modellen zijn ook gebruikt om adversarial examples te identificeren voordat ze naar een netwerk worden doorgestuurd. Deze vereisen allemaal processen die parallel aan het AI-systeem draaien.
Nu AI en ML centraler in ons leven staan, wordt AML steeds belangrijker. Het is cruciaal dat systemen die beslissingen over onze gezondheid en financiën nemen niet makkelijk te misleiden zijn. Of dat nu opzettelijk of per ongeluk is. Ik zou een zelfrijdende auto in elk geval niet vertrouwen als een paar stickers hem kunnen misleiden. Zo’n aanval kan onopgemerkt blijven door de bestuurder, maar de auto wel onjuiste en levensgevaarlijke beslissingen laten nemen.
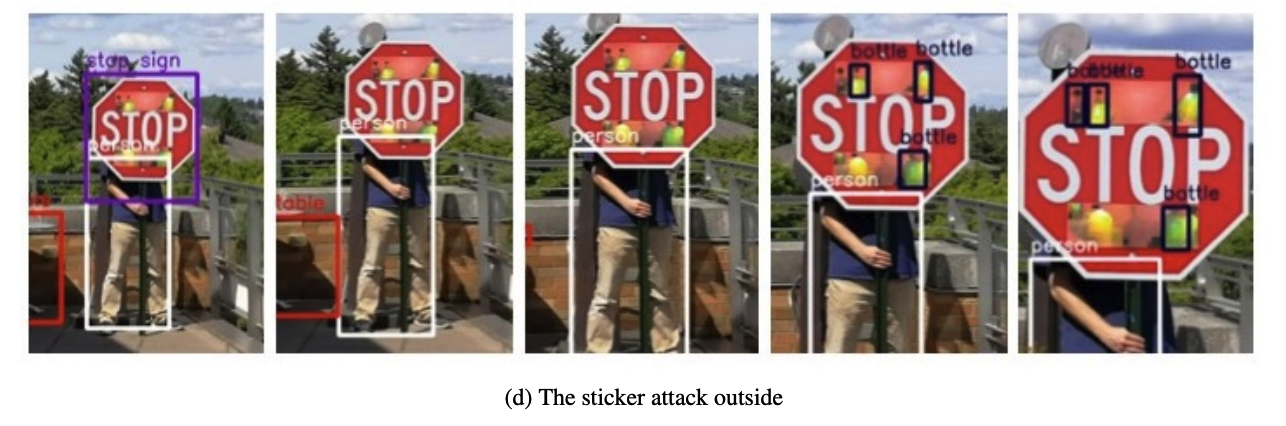 Figuur X: Yolo object detection v2 herkent een stopbord niet (bron: K. Eykholt et al.)
Bij het ontwerpen van deze systemen moeten we erkennen dat AML deel uitmaakt van een bredere beweging voor Verantwoorde AI. Om een goed kasteel te besturen, moet een koning eerlijk handelen, beslissingen kunnen verantwoorden, de privacy van zijn volk beschermen en hun veiligheid en beveiliging waarborgen. Het zijn die laatste twee aspecten waar AML zich op richt.
Dat gezegd hebbende, moeten we ook erkennen dat veiligheid en beveiliging fundamenteel verschillen van de andere aspecten van Verantwoorde AI. Eerlijkheid, interpreteerbaarheid en privacy zijn passief. AML opereert in een omgeving waar kwaadwillenden actief proberen de methoden te ondermijnen.
Daarom is, tegenintuïtief, veel onderzoek in dit vakgebied gericht op het vinden van kwetsbaarheden en aanvallen. Dat omvat poisoning-, evasion-, model-extractie- en inferentieaanvallen. Het omvat ook de meer praktische methoden om adversarial examples te vinden, zoals FGSM, PGD, C&W en adversarial patches, die we hebben besproken.
Het doel is om deze te ontdekken voordat kwaadwillenden dat doen. Geschikte verdedigingen, zoals adversarial training, defence distillation en gradient masking, kunnen dan worden ontwikkeld om deze aanvallen te neutraliseren voordat ze schade aanrichten.
In die zin is AML ook onderdeel van de bredere wapenwedloop in cybersecurity. Nieuwe kwetsbaarheden, aanvallen en verdedigingen zullen altijd blijven opduiken, en AML-onderzoekers en -professionals zullen moeten blijven strijden om aanvallers voor te blijven.
Wil je deel uitmaken van deze race, dan zijn dit enkele Python-frameworks om mee te beginnen:
In dit artikel hebben we het vakgebied van adversarial machine learning verkend, de doelen ervan, de verschillende soorten aanvallen (poisoning, evasion, model-extractie en inferentie) en hoe adversarial examples worden gebruikt om kwetsbaarheden van modellen uit te buiten.
We bespraken ook diverse verdedigingsmechanismen, waaronder adversarial training, defensive distillation en gradient masking, evenals het belang van het gebruik van eenvoudigere modellen wanneer dat passend is.
Wil je meer over dit onderwerp leren? Bekijk dan deze cursus Introduction to Data Security.
Leer meer over machine learning!
Cursus
Cursus
Oefen en volg je voortgang.
Ga Verder Met Googleblog
Adel Nehme
15 min

