Chuyển đến nội dung chính
Kỹ thuật Dữ liệu

Cơ sở dữ liệu chuỗi thời gian (TSDB): Hướng dẫn kèm ví dụ

Tìm hiểu về cơ sở dữ liệu chuỗi thời gian và cách chúng khác với cơ sở dữ liệu truyền thống, cùng các tính năng chính, trường hợp sử dụng và các lựa chọn phổ biến.
Marie Fayard's photo
Marie Fayard
Đã cập nhật · 8 phút đọc

Khám phá cùng AI

ChatGPTClaudePerplexity

Tạo tài khoản miễn phí của bạn

Luyện tập và Lộ trình tiến trình của bạn.

Tiếp Tục Với Google
Bằng cách tiếp tục, bạn chấp nhận Điều khoản sử dụng, Chính sách bảo mật và việc dữ liệu của bạn được lưu trữ tại Hoa Kỳ.

Vài năm trước, trong tuần đầu tiên ở vai trò kỹ sư phần mềm mới, tôi được yêu cầu nghiên cứu cơ sở dữ liệu chuỗi thời gian (TSDB) để thay thế giải pháp Postgres của chúng tôi.

Lúc đó tôi hoàn toàn không biết gì về chủ đề này và có rất nhiều câu hỏi. Rốt cuộc thì cơ sở dữ liệu chuỗi thời gian là gì? Nó hoạt động như thế nào? Nó khác gì với cơ sở dữ liệu truyền thống? Tại sao chúng ta nên dùng? Tôi có cần kỹ năng chuyên biệt không?

Kể từ đó, tôi đã học được rất nhiều về TSDB và áp dụng kiến thức này tại nhiều công ty để giải quyết nhiều vấn đề khác nhau.

Trong bài viết này, tôi sẽ tổng hợp những gì mình đã học trong vài năm qua để giúp bạn có cái nhìn rõ ràng về TSDB, cách chúng hoạt động và những trường hợp sử dụng phù hợp nhất. Tôi cũng sẽ giới thiệu một số TSDB hiện có trên thị trường và đưa ra mẹo để bạn chọn ra giải pháp phù hợp nhất với nhu cầu.

Cơ sở dữ liệu chuỗi thời gian là gì?

Hãy hình dung một bộ điều nhiệt thông minh do công ty X bán ra, ghi nhận nhiệt độ mỗi 30 giây. Trong một ngày, chỉ riêng thiết bị này đã tạo ra hàng nghìn điểm dữ liệu. Giờ hãy nhân con số đó với hàng trăm hoặc hàng nghìn thiết bị trên khắp một thành phố, khối lượng dữ liệu có đóng dấu thời gian mà công ty X thu thập sẽ trở nên khổng lồ.

Để lưu trữ hiệu quả dữ liệu này và phân tích xu hướng (như biến động nhiệt độ theo thời gian hoặc các đột biến bất thường), công ty X cần một cơ sở dữ liệu có thể xử lý tốc độ ghi cực lớn và thực thi truy vấn theo thời gian một cách hiệu quả.

Các cơ sở dữ liệu truyền thống thường gặp khó với loại tải này vì chúng không được thiết kế để xử lý ghi dữ liệu tần suất cao hoặc truy vấn hiệu quả trên các khoảng thời gian cụ thể. Đây chính là lúc cơ sở dữ liệu chuỗi thời gian phát huy tác dụng.

Cơ sở dữ liệu chuỗi thời gian là các cơ sở dữ liệu chuyên dụng được thiết kế để quản lý dữ liệu được tổ chức và lập chỉ mục theo thời gian. Khác với cơ sở dữ liệu truyền thống tối ưu cho lưu trữ dữ liệu đa mục đích, TSDB tập trung vào việc lưu trữ, truy vấn và phân tích hiệu quả các chuỗi điểm dữ liệu có đóng dấu thời gian.
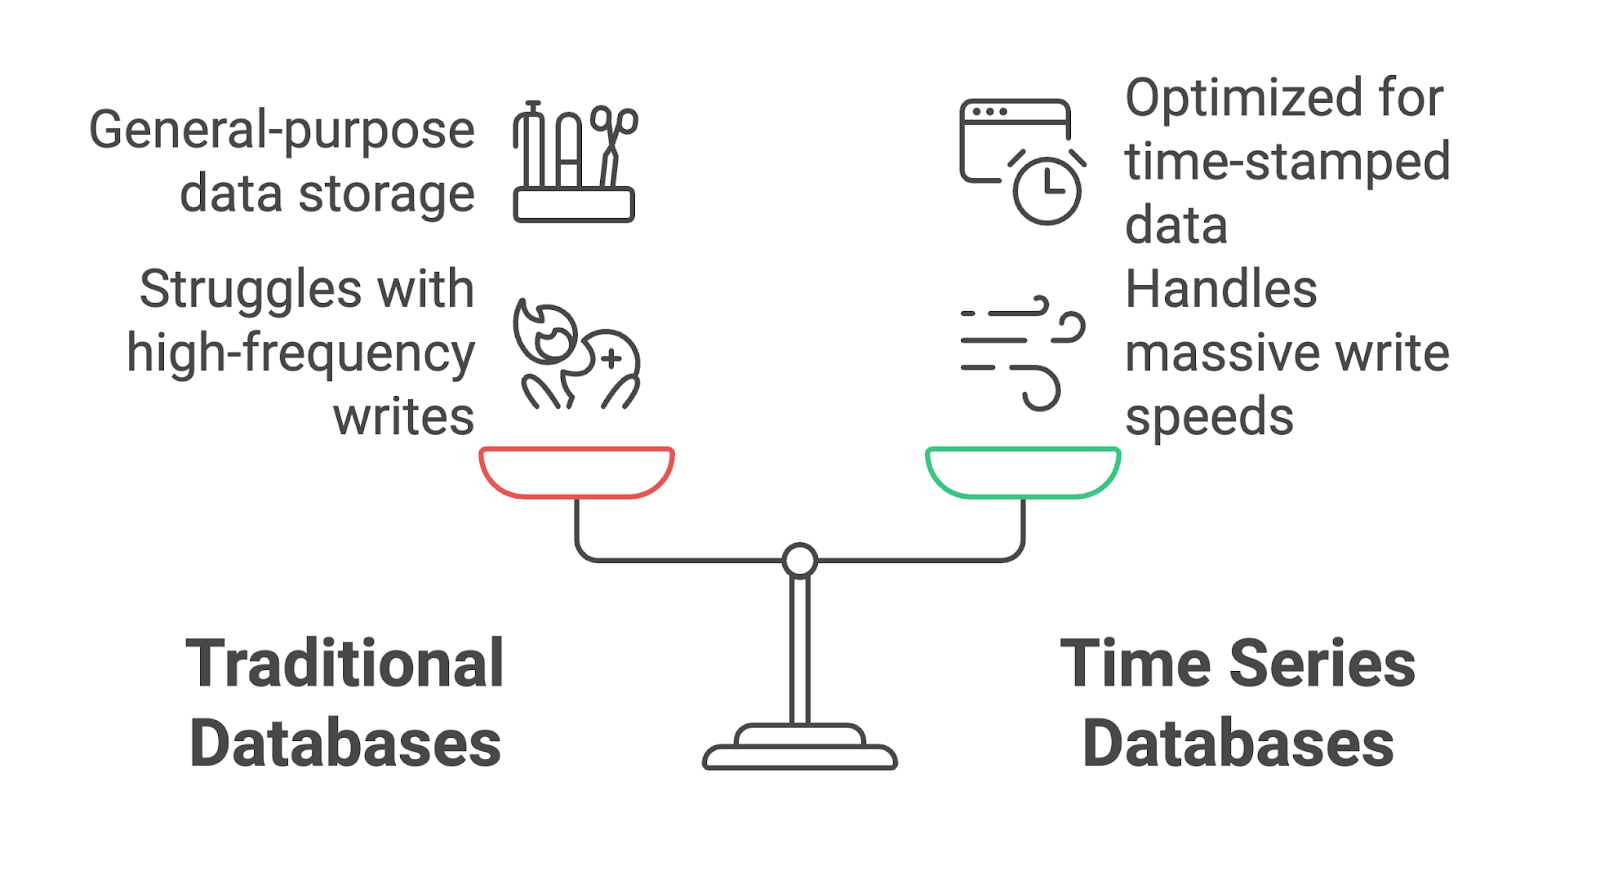
cơ sở dữ liệu truyền thống so với cơ sở dữ liệu chuỗi thời gian

TSDB đặc biệt phù hợp với các ứng dụng xử lý luồng dữ liệu liên tục, như IoT, giám sát DevOps và phân tích tài chính.

Đặc điểm của cơ sở dữ liệu chuỗi thời gian

Có một vài điểm TSDB làm khác so với cơ sở dữ liệu truyền thống.

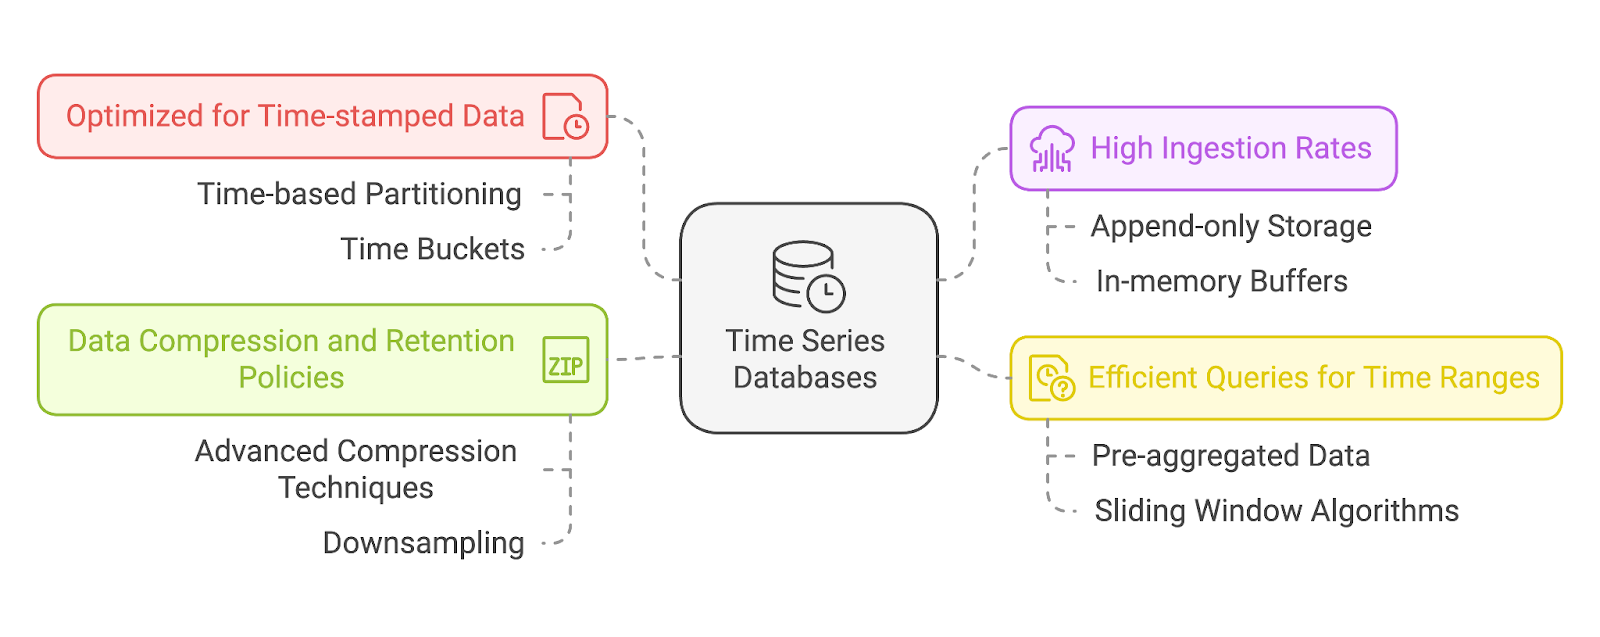
Tối ưu cho dữ liệu có đóng dấu thời gian

Cốt lõi của TSDB là xử lý dữ liệu mà dấu thời gian là thuộc tính nền tảng. Mỗi điểm dữ liệu trong TSDB đều có một dấu thời gian, đóng vai trò chỉ mục chính. Điều này cho phép các cơ sở dữ liệu này lưu trữ và truy xuất hiệu quả các chuỗi theo thứ tự thời gian, đồng thời cung cấp khả năng truy cập nhanh vào xu hướng lịch sử hoặc các sự kiện gần đây.

Hầu hết TSDB sử dụng phân vùng theo thời gian, nghĩa là dữ liệu được lưu trong các phân vùng dựa trên khoảng thời gian (ví dụ: theo giờ, theo ngày). Điều này cho phép cắt tỉa hiệu quả, khi truy vấn có thể bỏ qua hoàn toàn các phân vùng không liên quan. 

Chúng cũng có thể triển khai time buckets, nhóm dữ liệu theo các cửa sổ thời gian định sẵn (ví dụ: 1 phút, 1 giờ) để tổng hợp nhanh hơn.

Tốc độ nạp dữ liệu cao

Dữ liệu chuỗi thời gian thường được tạo ra với tốc độ nhanh — hãy nghĩ đến thiết bị IoT gửi hàng nghìn điểm dữ liệu mỗi giây hoặc công cụ giám sát máy chủ ghi nhận chỉ số hệ thống theo thời gian thực. TSDB được tối ưu cho tốc độ ghi cao này và có thể nạp lượng dữ liệu khổng lồ mà không bị chậm hoặc mất mát thông tin.

Điều này thường đạt được nhờ mô hình lưu trữ chỉ ghi nối tiếp (append-only) và bộ đệm trong bộ nhớ để tránh khóa hoặc điểm nghẽn giao dịch.

Truy vấn hiệu quả theo khoảng thời gian

Phân tích dữ liệu chuỗi thời gian thường liên quan đến truy vấn các khoảng hoặc cửa sổ thời gian cụ thể, như “24 giờ qua” hoặc “năm nay so với năm trước”. TSDB được xây dựng với tư duy này, cung cấp các khả năng truy vấn chuyên biệt giúp người dùng nhanh chóng lấy dữ liệu trong các khoảng thời gian xác định. Chúng cũng hỗ trợ các phép tổng hợp như trung bình, tổng hoặc xu hướng để đem lại phân tích giá trị mà không cần logic truy vấn phức tạp.

Các kỹ thuật tối ưu hóa truy vấn bao gồm:

  • Dữ liệu tiền tổng hợp: TSDB thường tính sẵn các bản tóm tắt cho những khoảng thời gian phổ biến (ví dụ: trung bình theo giờ hoặc theo ngày).
  • Thuật toán cửa sổ trượt: Giúp tính hiệu quả các chỉ số trên các cửa sổ thời gian di động, như trung bình trượt.

Nén dữ liệu và chính sách lưu giữ

Để quản lý lượng dữ liệu chuỗi thời gian khổng lồ theo thời gian, TSDB sử dụng các kỹ thuật nén dữ liệu nâng cao. Những phương pháp này giúp giảm yêu cầu lưu trữ đồng thời vẫn bảo toàn hiệu năng truy vấn.

TSDB thường bao gồm các chính sách lưu giữ để người dùng có thể xác định thời gian lưu trữ dữ liệu. Ví dụ, một hệ thống có thể giữ dữ liệu chi tiết cho tháng gần nhất trong khi downsampling cho dữ liệu cũ hơn. Downsampling là quá trình giảm độ chi tiết của dữ liệu theo thời gian. Ví dụ:

  • Các giá trị nhiệt độ thô có thể được ghi nhận mỗi 10 giây trong 7 ngày gần nhất.
  • Với dữ liệu cũ hơn, hệ thống có thể giảm lấy mẫu thành trung bình theo giờ để tiết kiệm dung lượng nhưng vẫn giữ được xu hướng lịch sử.

Ví dụ về các kỹ thuật nén nâng cao gồm có:
  • Mã hóa delta: Lưu trữ chênh lệch giữa các giá trị liên tiếp thay vì toàn bộ giá trị.
  • Nén Gorilla: Phương pháp nén hiệu quả dữ liệu số thực dạng chuỗi thời gian bằng cách lưu trữ thay đổi ở dạng nhị phân.

các tính năng của cơ sở dữ liệu chuỗi thời gian

Trường hợp sử dụng của cơ sở dữ liệu chuỗi thời gian

Cơ sở dữ liệu chuỗi thời gian được sử dụng trong nhiều ứng dụng hiện đại định hướng dữ liệu và trên nhiều ngành khác nhau. Hãy cùng xem các trường hợp sử dụng chính.

1. Internet vạn vật (IoT)

Thiết bị IoT như bộ điều nhiệt thông minh, cảm biến công nghiệp và thiết bị giám sát môi trường tạo ra các luồng dữ liệu có đóng dấu thời gian liên tục. TSDB được dùng để lưu trữ và phân tích dữ liệu này, cung cấp sức mạnh cho các ứng dụng như:

  • Nhà thông minh: Giám sát và điều khiển thiết bị gia dụng dựa trên dữ liệu nhạy theo thời gian.
  • Tự động hóa công nghiệp: Theo dõi hiệu suất máy móc và phát hiện bất thường theo thời gian thực để giảm thời gian ngừng hoạt động.
  • Giám sát môi trường: Thu thập dữ liệu từ cảm biến để theo dõi chất lượng không khí, thời tiết hoặc mực nước theo thời gian.

2. DevOps và giám sát hệ thống

Trong DevOps, TSDB được dùng rộng rãi để giám sát hạ tầng CNTT và ứng dụng bằng cách thu thập các chỉ số như mức sử dụng CPU, bộ nhớ và băng thông mạng. Chúng cho phép:

  • Giám sát hiệu năng: Trực quan hóa tình trạng hệ thống và các chỉ số hiệu năng theo thời gian thực.
  • Phát hiện bất thường: Nhận diện các mẫu bất thường, như tăng đột biến tải máy chủ hoặc độ trễ mạng.
  • Lập kế hoạch dung lượng: Dùng xu hướng lịch sử để dự đoán và phân bổ nhu cầu tài nguyên tương lai.

Các công cụ như Prometheus và Grafana thường tích hợp với TSDB để cung cấp khả năng trực quan hóa và cảnh báo cho các nhóm DevOps.

3. Thị trường tài chính

TSDB rất quan trọng trong việc xử lý và phân tích khối lượng dữ liệu tần suất cao khổng lồ được tạo ra trên thị trường tài chính. Chúng được dùng cho:

  • Giao dịch thuật toán: Lưu trữ và phân tích dữ liệu thị trường theo mili giây để thực thi giao dịch dựa trên xu hướng thời gian thực.
  • Quản trị rủi ro: Theo dõi các chỉ số tài chính theo thời gian để đánh giá và giảm thiểu rủi ro.
  • Phân tích thị trường: Phân tích dữ liệu lịch sử để xác định các mẫu, xu hướng và bất thường trong hành vi thị trường.

4. Ứng dụng khác

Dù ba trường hợp trên rất phổ biến, cơ sở dữ liệu chuỗi thời gian cũng có thể ứng dụng trong nhiều lĩnh vực khác:
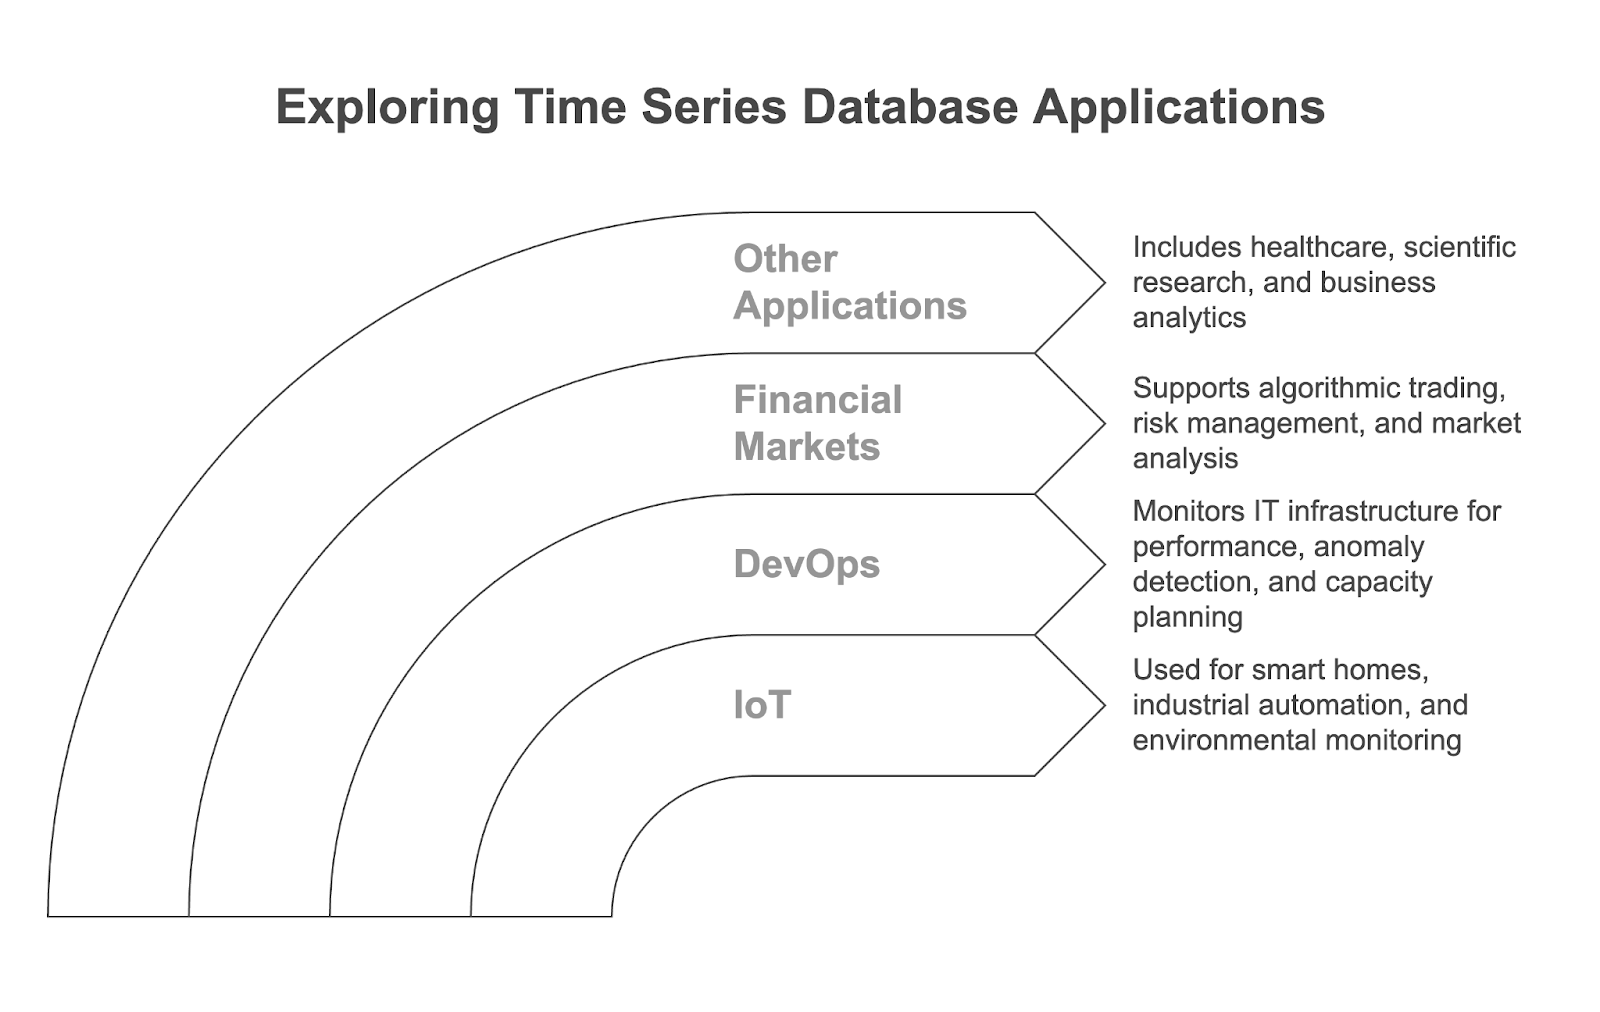
  • Y tế: Giám sát chỉ số sinh tồn của bệnh nhân theo thời gian thực và phân tích dữ liệu từ thiết bị y tế.
  • Nghiên cứu khoa học: Thu thập và phân tích dữ liệu cho mô hình khí hậu, quan sát thiên văn và các hiện tượng phụ thuộc thời gian khác.
  • Phân tích kinh doanh: Theo dõi hành vi khách hàng, phân tích xu hướng doanh số và giám sát các chỉ số hiệu quả theo thời gian.

các trường hợp sử dụng của cơ sở dữ liệu chuỗi thời gian

Những cơ sở dữ liệu chuỗi thời gian tốt nhất: So sánh tổng quan

Cơ sở dữ liệu chuỗi thời gian có nhiều hình thái và mục đích, mỗi loại được điều chỉnh cho những trường hợp sử dụng cụ thể.

InfluxDB

InfluxDB là cơ sở dữ liệu chuỗi thời gian mã nguồn mở phổ biến do InfluxData phát triển. Nó được thiết kế riêng cho tốc độ nạp cao và truy vấn hiệu quả dữ liệu có đóng dấu thời gian, khiến nó trở thành giải pháp phổ biến cho giám sát IoT, chỉ số DevOps và phân tích thời gian thực.

Ưu điểm

Nhược điểm

Tốc độ nạp cao cho khối lượng dữ liệu lớn.

Cần quản lý thủ công chính sách lưu giữ để tối ưu lưu trữ.

InfluxQL giống SQL giúp truy vấn dễ dàng cho nhà phân tích quen với cơ sở dữ liệu quan hệ.

Thách thức về khả năng mở rộng với bộ dữ liệu rất lớn nếu không có tính năng doanh nghiệp.

Dễ tích hợp với các công cụ như Grafana để trực quan hóa.

Khả năng truy vấn nâng cao còn hạn chế so với các cơ sở dữ liệu dựa trên SQL.

TimescaleDB

TimescaleDB là tiện ích mở rộng mã nguồn mở cho PostgreSQL, được thiết kế để kết hợp sức mạnh của cơ sở dữ liệu quan hệ với chức năng chuỗi thời gian. Nó cho phép bạn tận dụng SQL đồng thời xử lý hiệu quả dữ liệu có đóng dấu thời gian. Điều này đặc biệt phù hợp khi cần tích hợp dữ liệu chuỗi thời gian với dữ liệu quan hệ, như phân tích kinh doanh hoặc đo đạc IoT.

Ưu điểm

Nhược điểm

Hỗ trợ đầy đủ SQL giúp dễ tích hợp với công cụ và quy trình PostgreSQL hiện có.

Cần kiến thức PostgreSQL để thiết lập và vận hành.

Hypertable: Tự động phân vùng dữ liệu chuỗi thời gian để lưu trữ và truy vấn hiệu quả.

Có thể chưa đạt tốc độ nạp của TSDB chuyên dụng như InfluxDB.

Kết hợp dữ liệu quan hệ và chuỗi thời gian trong một cơ sở dữ liệu.


Prometheus

Prometheus là hệ thống giám sát và cảnh báo với TSDB tích hợp, được áp dụng rộng rãi trong DevOps để theo dõi chỉ số hệ thống theo thời gian thực, theo dõi hiệu năng và quản lý cảnh báo.

Ưu điểm

Nhược điểm

Gọn nhẹ và dễ triển khai, đặc biệt với Kubernetes.

Lưu trữ dài hạn hạn chế nếu không dùng giải pháp bên ngoài.

Cơ chế kéo (pull) thu thập chỉ số đảm bảo chỉ thu thập dữ liệu liên quan.

Khả năng mở rộng phụ thuộc vào các công cụ bổ trợ như Thanos hoặc Cortex.

PromQL cung cấp khả năng truy vấn mạnh mẽ.

Tập trung vào chỉ số (metrics) và có thể không phù hợp mọi nhu cầu TSDB tổng quát.

Clickhouse

ClickHouse là cơ sở dữ liệu dạng cột mã nguồn mở, được thiết kế cho truy vấn phân tích hiệu năng cao. Dù không phải TSDB truyền thống, kiến trúc của nó rất phù hợp với dữ liệu chuỗi thời gian, đặc biệt khi hiệu năng truy vấn nhanh là yếu tố then chốt.

Ưu điểm

Nhược điểm

Hiệu năng truy vấn cao cho khối lượng công việc phân tích.

Thiết lập và vận hành phức tạp đối với người mới bắt đầu.

Lưu trữ dạng cột giúp giảm độ trễ truy vấn.

Không được thiết kế chuyên biệt như TSDB (có thể cần giải pháp bổ trợ).

Apache Cassandra

Apache Cassandra là cơ sở dữ liệu NoSQL phân tán được xây dựng cho khả năng mở rộng ngang và tính sẵn sàng cao. Dù không phải TSDB thuần túy, nó có thể được dùng hiệu quả cho khối lượng công việc chuỗi thời gian, đặc biệt khi độ bền và khả năng chịu lỗi là quan trọng.

Ưu điểm

Nhược điểm

Khả năng mở rộng ngang xuất sắc.

Truy vấn dữ liệu chuỗi thời gian có thể rườm rà nếu không có tối ưu bổ sung, do cơ sở dữ liệu thiếu tính năng truy vấn và tổng hợp chuỗi thời gian gốc.

Chịu lỗi và có tính sẵn sàng cao.


Amazon Timestream

Amazon Timestream là dịch vụ cơ sở dữ liệu chuỗi thời gian được quản lý hoàn toàn do AWS cung cấp. Được xây dựng cho khả năng mở rộng và sự đơn giản, nó lý tưởng cho các tổ chức đã tận dụng hạ tầng AWS cho IoT và giám sát ứng dụng.

Ưu điểm

Nhược điểm

Kiến trúc serverless giúp đơn giản hóa quản trị.

Chức năng bị giới hạn ngoài hệ sinh thái AWS.

Tự động mở rộng để xử lý khối lượng dữ liệu lớn.

Chi phí có thể tăng nhanh với tốc độ nạp dữ liệu cao.

Hãy cùng điểm nhanh với bảng sau:

Cơ sở dữ liệu

Trường hợp sử dụng chính

Mô hình lưu trữ

Tương thích hệ sinh thái

InfluxDB

Giám sát IoT, chỉ số DevOps, phân tích thời gian thực

Tối ưu cho chuỗi thời gian, lưu trữ trên đĩa

Tích hợp với Grafana, Telegraf và Kapacitor

TimescaleDB

Phân tích kinh doanh, đo đạc IoT, ứng dụng dựa trên SQL

Quan hệ (tiện ích mở rộng PostgreSQL)

Hoạt động với các công cụ PostgreSQL như pgAdmin, Grafana

Prometheus

Giám sát DevOps, theo dõi hiệu năng, cảnh báo

Lưu trữ chuỗi thời gian nhúng

Thiết kế cho Kubernetes, tích hợp với Thanos, Grafana

ClickHouse

Khối lượng công việc phân tích hiệu năng cao, phân tích chuỗi thời gian

Lưu trữ dạng cột

Hỗ trợ phân tích dựa trên SQL, tích hợp với công cụ BI

Apache Cassandra

Lưu trữ chuỗi thời gian phân tán, ghi log quy mô lớn

NoSQL cột rộng

Tương thích với Spark, Kafka và các hệ thống phân tán có khả năng mở rộng

Amazon Timestream

Giám sát IoT trên AWS, đo đạc ứng dụng

Serverless, TSDB được quản lý

Tích hợp chặt chẽ với dịch vụ AWS (Lambda, IoT Core, QuickSight)

Chọn cơ sở dữ liệu chuỗi thời gian phù hợp: Những điểm cần cân nhắc

Các cơ sở dữ liệu chuỗi thời gian cung cấp nhiều tính năng khác nhau để đáp ứng các nhu cầu khác nhau. Vậy làm thế nào để chọn được loại phù hợp nhất với vấn đề của bạn?

Đánh giá khối lượng dữ liệu và tốc độ nạp

Khối lượng công việc chuỗi thời gian có thể khác nhau đáng kể về khối lượng dữ liệu (tạo ra bao nhiêu dữ liệu) và tốc độ nạp (ghi dữ liệu nhanh đến mức nào). Một số hệ thống tạo dữ liệu lẻ tẻ, số khác lại tạo ra lượng dữ liệu khổng lồ mỗi giây.

Ví dụ:

  • Một triển khai IoT với hàng nghìn thiết bị có thể cần nạp hàng triệu điểm dữ liệu mỗi phút.
  • Một công cụ giám sát DevOps có thể thu thập chỉ số máy chủ thời gian thực mỗi vài giây trên hàng nghìn máy chủ.

Không phải mọi TSDB đều được tối ưu cho tốc độ ghi cực cao. Hệ thống không theo kịp tốc độ nạp sẽ làm rơi dữ liệu, dẫn đến lỗ hổng phân tích và kết quả không đầy đủ.

Nếu hệ thống của bạn tạo ra lượng dữ liệu rất lớn, hãy tìm kiếm:

  • TSDB hỗ trợ tốc độ nạp cao mà không suy giảm hiệu năng.
  • Giải pháp có mô hình lưu trữ chỉ ghi nối tiếp và đệm trong bộ nhớ để tối ưu ghi (ví dụ: InfluxDB, TimescaleDB, Prometheus).

Tôi rất khuyến nghị bạn đánh giá thông lượng ghi của một TSDB bằng cách kiểm thử với khối lượng công việc thực tế. Bộ đo hiệu năng như Time Series Benchmark Suite có thể giúp mô phỏng kịch bản nạp dữ liệu.

Ngoài ra, bạn có thể kết nối hệ thống của mình với TSDB đã chọn theo gói dùng thử miễn phí và đánh giá kết quả. Theo trải nghiệm của tôi, nhận ra pipeline của bạn tạo ra 30GB dữ liệu mỗi 30 phút không phải là một bất ngờ dễ chịu.

Xem xét mẫu truy vấn và độ phức tạp

Loại truy vấn bạn sẽ chạy thường xuyên là yếu tố quan trọng khác khi chọn TSDB. Các cơ sở dữ liệu khác nhau được tối ưu cho khối lượng công việc truy vấn khác nhau.

Ví dụ về mẫu truy vấn:

  • Truy vấn khoảng thời gian đơn giản: Lấy các điểm dữ liệu trong một khoảng thời gian cụ thể (ví dụ: “7 ngày qua”).
  • Truy vấn tổng hợp: Tính trung bình, tổng hoặc bách phân vị (ví dụ: “mức dùng CPU trung bình theo giờ”).
  • Downsampling: Tóm tắt dữ liệu thô thành độ chi tiết thấp hơn (ví dụ: trung bình theo giờ từ số đo theo giây).
  • Phân tích phức tạp: Tương quan nhiều luồng dữ liệu, phát hiện bất thường hoặc chạy phân tích dự đoán.

Một số TSDB vượt trội với truy vấn theo thời gian đơn giản, số khác phù hợp hơn cho tổng hợp hoặc phân tích phức tạp. Chọn sai cơ sở dữ liệu có thể dẫn đến truy vấn chậm và pipeline phân tích kém hiệu quả.

Bạn có thể muốn tìm:

  • TSDB có hỗ trợ sẵn cho các loại truy vấn phổ biến nhất của bạn.
  • Hệ thống có ngôn ngữ truy vấn giống SQL (ví dụ: TimescaleDB tương thích PostgreSQL) cho các truy vấn phức tạp hơn.
  • Khả năng truy vấn liên tục cho phép bạn tính sẵn tổng hợp cho dữ liệu truy cập thường xuyên và giảm tải truy vấn khi chạy.

Kiểm tra khả năng mở rộng và tính sẵn sàng

Khi khối lượng dữ liệu tăng, TSDB của bạn phải mở rộng liền mạch đồng thời duy trì hiệu năng. Ngoài ra, với các ứng dụng quan trọng, cơ sở dữ liệu phải có tính sẵn sàng cao để đảm bảo không gián đoạn.

Nếu TSDB của bạn không thể mở rộng ngang (bằng cách thêm máy chủ) hoặc dọc (tăng tài nguyên máy chủ), bạn sẽ đối mặt điểm nghẽn khi dữ liệu tăng.

Bạn nên tìm:

  • Mở rộng ngang: Các cơ sở dữ liệu có thể phân phối dữ liệu trên nhiều nút (ví dụ với chiến lược sharding)
  • Tính sẵn sàng cao: Cụm, sao chép và cơ chế chuyển đổi dự phòng tích hợp để đảm bảo thời gian hoạt động.

Tích hợp và hệ sinh thái thực sự quan trọng

Khả năng tích hợp của TSDB với công cụ và quy trình hiện có là cực kỳ quan trọng để đảm bảo đội ngũ của bạn sẽ tiếp nhận và sử dụng hiệu quả.

Hãy tìm:

  • Tích hợp với công cụ của bạn (nền tảng giám sát, khung xử lý dữ liệu, công cụ BI, v.v.)
  • Hỗ trợ pipeline nạp: Tìm TSDB tích hợp với nguồn dữ liệu của bạn, như thiết bị IoT, API hoặc bộ gom log.
  • API và ngôn ngữ truy vấn: TSDB cung cấp REST API, hỗ trợ SQL hoặc SDK ngôn ngữ giúp nhà phát triển tích hợp dễ dàng hơn.

Chi phí

TSDB có thể tốn kém, đặc biệt khi khối lượng dữ liệu của bạn tăng. Chi phí có thể khác nhau tùy theo giấy phép, yêu cầu hạ tầng và công sức bảo trì.

Một số TSDB là mã nguồn mở và miễn phí sử dụng nhưng có thể đòi hỏi chi phí hạ tầng và vận hành đáng kể. Số khác là thương mại với phí bản quyền nhưng đi kèm tính năng nâng cao và hỗ trợ.

Hãy chắc chắn bạn xem xét:

  • Phí bản quyền: Mã nguồn mở (ví dụ: Prometheus, VictoriaMetrics) so với thương mại (ví dụ: InfluxDB Enterprise).
  • Chi phí hạ tầng: TSDB trên đám mây so với tự triển khai.
  • Chi phí vận hành: Chi phí cho mở rộng, sao lưu và khắc phục thảm họa.

Với khối lượng công việc nhỏ hơn, bạn có thể cân nhắc các dịch vụ được quản lý trên đám mây để giảm gánh nặng vận hành, nhưng hãy tính đến chi phí dài hạn khi dữ liệu mở rộng. Tôi cũng rất khuyến nghị triển khai chính sách lưu giữ dữ liệu và giảm lấy mẫu ngay từ đầu để quản lý chi phí lưu trữ hiệu quả.

Kết luận

Hy vọng bạn thích đọc hướng dẫn này như cách tôi thích viết nó!

Giờ bạn đã hiểu những điều cơ bản về cơ sở dữ liệu chuỗi thời gian, hãy chọn một cơ sở dữ liệu phù hợp, dùng thử miễn phí và bắt đầu đưa kỹ năng của bạn vào thực hành!

Câu hỏi thường gặp

Làm thế nào để xử lý dữ liệu chuỗi thời gian có khoảng thời gian không đều hoặc khác múi giờ?

Với các khoảng thời gian không đều, việc lấy mẫu lại dữ liệu theo các khoảng thời gian đều đặn có thể hữu ích, trong khi khác biệt múi giờ có thể được quản lý bằng cách chuyển đổi tất cả dữ liệu về một múi giờ duy nhất hoặc dùng UTC để duy trì tính nhất quán.

Tôi có thể lưu dữ liệu chuỗi thời gian trong cơ sở dữ liệu phi quan hệ không?

Có, dữ liệu chuỗi thời gian có thể lưu trong các cơ sở dữ liệu phi quan hệ như MongoDB hoặc Cassandra, nhưng các cơ sở dữ liệu chuỗi thời gian chuyên dụng hoặc cơ sở dữ liệu quan hệ với tối ưu phù hợp (như phân vùng) có thể mang lại hiệu năng tốt hơn cho khối lượng công việc chuỗi thời gian quy mô lớn.

Tôi nên chọn cơ sở dữ liệu quan hệ hay cơ sở dữ liệu chuỗi thời gian chuyên dụng cho dự án của mình?

Nếu dữ liệu của bạn chủ yếu có đóng dấu thời gian và bạn cần truy vấn, lưu trữ hiệu quả cho khối lượng dữ liệu lớn, một cơ sở dữ liệu chuỗi thời gian chuyên dụng như InfluxDB hoặc TimescaleDB có thể phù hợp hơn. Tuy nhiên, nếu dữ liệu mang tính đa mục đích và chuỗi thời gian chỉ là một phần của ứng dụng, một cơ sở dữ liệu quan hệ với lập chỉ mục và phân vùng phù hợp có thể là đủ!


Marie Fayard's photo
Author
Marie Fayard

Tôi là một trưởng nhóm kỹ thuật định hướng sản phẩm, chuyên giúp các startup giai đoạn đầu phát triển từ nguyên mẫu đầu tiên đến khi đạt được sự phù hợp sản phẩm - thị trường và xa hơn nữa. Tôi luôn tò mò về cách con người sử dụng công nghệ, và tôi thích làm việc sát sao với nhà sáng lập và các nhóm liên chức năng để biến những ý tưởng táo bạo thành hiện thực. Khi không xây dựng sản phẩm, tôi tìm cảm hứng ở những miền đất mới hoặc xả căng thẳng tại phòng tập yoga.

Chủ đề
Kỹ thuật Dữ liệu

Học kỹ thuật dữ liệu với những khóa học này!

Lộ trình

Kỹ sư Dữ liệu Hỗ trợ trong SQL

30 giờ
Học các kiến thức cơ bản về kỹ thuật dữ liệu: thiết kế cơ sở dữ liệu và kho dữ liệu, làm việc với các công nghệ bao gồm PostgreSQL và Snowflake!
Xem chi tiếtBắt Đầu Khóa Học

Tạo tài khoản miễn phí của bạn

Luyện tập và Lộ trình tiến trình của bạn.

Tiếp Tục Với Google
Bằng cách tiếp tục, bạn chấp nhận Điều khoản sử dụng, Chính sách bảo mật và việc dữ liệu của bạn được lưu trữ tại Hoa Kỳ.
Xem thêm
Liên quan

blog

Claude Opus 4.6: Tính năng, Điểm chuẩn, Bài kiểm tra thực hành và hơn thế nữa

Mô hình mới nhất của Anthropic dẫn đầu ở mã hóa tác tử và lập luận phức tạp. Thêm vào đó, nó có cửa sổ ngữ cảnh 1M.
Matt Crabtree's photo

Matt Crabtree

10 phút

Xem thêm