
Wat is zero-shot learning?
Zero-shot learning (ZSL) is een machinelearningtechniek waarmee modellen taken kunnen uitvoeren of dingen kunnen herkennen die ze niet eerder zijn tegengekomen. Dat doet het door bestaande kennis te gebruiken en te koppelen aan nieuwe situaties, zelfs zonder specifieke training daarvoor.
Stel dat een model getraind is om dieren te herkennen, maar tijdens de trainingsfase niets over zebra’s heeft geleerd. Met ZSL kan het model toch achterhalen wat een zebra is aan de hand van een beschrijving. Maar hoe? Ik maak het even simpel (straks gaan we dieper in op de techniek) en leg het uit:
- Het model kent dieren en hun kenmerken, zoals "heeft vier poten", "leeft in de savanne" of "heeft strepen".
- Het krijgt een nieuwe beschrijving: "Een paardachtig dier met zwarte en witte strepen dat op Afrikaanse graslanden leeft."
- Met zijn begrip van dierlijke eigenschappen en de gegeven beschrijving kan het model afleiden dat de afbeelding waarschijnlijk een zebra voorstelt, ook al heeft het die nooit eerder gezien.
- Het model maakt deze gevolgtrekking door bekende dierkenmerken te verbinden met de nieuwe beschrijving.
Hoe werkt zero-shot learning?
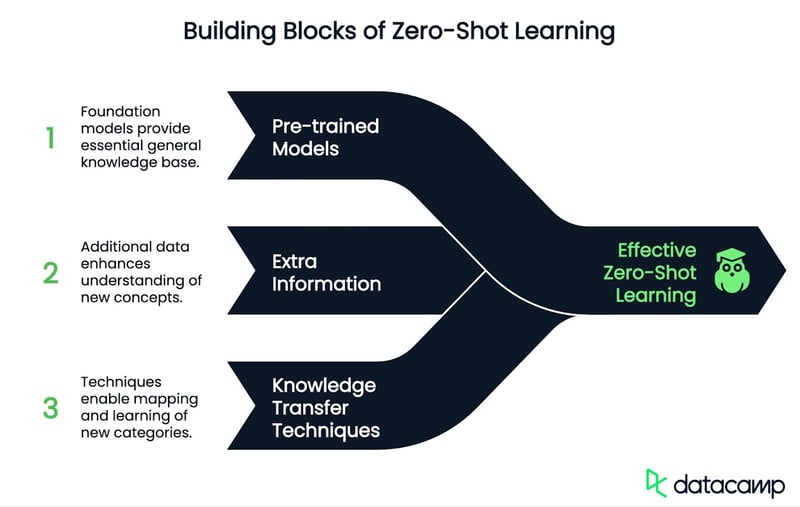
Zero-shot learning bestaat uit twee fasen (training en inferentie) en gebruikt drie kernelementen: voorgetrainde modellen, extra informatie en kennistransfer.
Voorgetrainde modellen
ZSL steunt op voorgetrainde modellen die op veel data zijn getraind. Bijvoorbeeld de GPT-familie (voor taal) of CLIP (voor verbindingen tussen beeld en tekst). Deze modellen vormen een solide basis van algemene kennis.
Extra informatie
Extra informatie helpt het model nieuwe dingen te begrijpen. Dit kan omvatten:
- Tekstbeschrijvingen.
- Attributen of kenmerken.
- Woordassociaties of -vectoren.
Kennistransfer
ZSL projecteert zowel bekende als nieuwe klassen in een gedeelde "semantische ruimte" waarin ze vergeleken kunnen worden. Het gebruikt vaak technieken zoals:
- Semantische embeddings: een gedeelde representatie voor zowel bekende als onbekende categorieën.
- Transfer learning: kennis uit vergelijkbare taken hergebruiken om nieuwe taken aan te pakken.
- Generatieve modellen: kunstmatige voorbeelden creëren van ongeziene klassen om het model te helpen leren.
Training en inferentie
ZSL kun je zien als een proces in twee fasen:
- Training: het model verwerft kennis over gelabelde datapunten en hun attributen.
- Inferentie: de verworven kennis wordt uitgebreid naar nieuwe klassen met behulp van de meegeleverde aanvullende informatie. Dit gebeurt in drie stappen:
- Het model zet nieuwe input (zoals een afbeelding) om in een semantische representatie.
- Het vergelijkt deze representatie met die van bekende klassen of beschrijvingen.
- Het kiest de dichtstbijzijnde match op basis van gelijkenis.
Met deze aanpak kunnen ZSL-modellen in de loop van de tijd dynamisch een open einde aan nieuwe concepten herkennen, uitsluitend op basis van beschrijvingen of semantische informatie, zonder extra gelabelde trainingsdata.
Laten we teruggaan naar ons voorbeeld van dierenclassificatie.
Voorbeeld: dieren classificeren
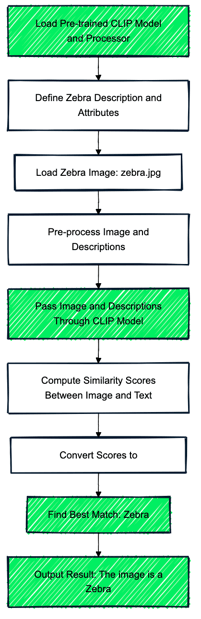
Stel, we gebruiken het model CLIP, dat voorgetraind is op een enorme dataset met beeld-tekstparen. Dit voorgetrainde model biedt een basis van algemene kennis over dieren, ook al is het niet expliciet getraind op zebra’s.
In ons zebra-voorbeeld omvatten aanvullende gegevens (extra informatie) tekstbeschrijvingen zoals: “Een paardachtig dier met zwarte en witte strepen dat op Afrikaanse graslanden leeft." en attributen als "heeft vier poten", "heeft strepen", "leeft in de savanne". Deze beschrijvingen en attributen slaan een brug tussen wat het model weet (algemene dierkenmerken) en de ongeziene klasse (zebra).
Vervolgens projecteert het model zowel geziene klassen (bijv. paard, tijger) als de ongeziene klasse (zebra) in een gedeelde semantische ruimte. Het model codeert de zebrabeschrijving ("zwarte en witte strepen, paardachtig") in dezelfde ruimte als bekende dieren en gebruikt zijn begrip van dieren zoals paarden en tijgers om over zebra’s te redeneren.
Het model vergelijkt de embedding van de zebra met embeddings van bekende dieren en beschrijvingen (bijv. paard, tijger, "zwarte en witte strepen"). Met behulp van similariteitsscores identificeert het model de zebra als de beste match met de beschrijving: "Een paardachtig dier met zwarte en witte strepen dat op Afrikaanse graslanden leeft."
Zero-shot learning vs. few-shot learning
Zero-shot learning (ZSL) en few-shot learning (FSL) zijn twee methoden die modellen helpen omgaan met nieuwe taken of objecten, zelfs wanneer er weinig of geen data beschikbaar is. Ze verschillen echter op een aantal punten. Hieronder een overzicht van beide technieken en hun belangrijkste verschillen:
|
Aspect |
Zero-shot learning (ZSL) |
Few-shot learning (FSL) |
|
Wat het doet |
Gaat om met nieuwe taken zonder gelabelde trainingsdata. |
Leert nieuwe taken op basis van enkele gelabelde voorbeelden. |
|
Hoe het werkt |
Leidt nieuwe categorieën af door beschrijvingen te koppelen aan bekende kennis. |
Leert patronen uit enkele voorbeelden om nieuwe instanties te classificeren. |
|
Benodigde data |
Vereist nul gelabelde voorbeelden voor nieuwe taken. |
Vereist 1–5 gelabelde voorbeelden voor nieuwe taken. |
|
Voorkennis |
Steunt op geleerde relaties tussen concepten en beschrijvingen. |
Gebruikt voorkennis maar past zich ook aan op basis van de aangeleverde voorbeelden. |
|
Aanpasbaarheid |
Kan generaliseren naar volledig nieuwe taken, maar is mogelijk minder precies. |
Past zich snel aan specifieke nieuwe taken aan en is doorgaans nauwkeuriger. |
|
Voorbeeld 1 |
Spamdetectie: identificeert spam met definities (bijv. “e-mails met verdachte links”) zonder vooraf gelabelde spamdata. |
Detectie van klantintenties: leert een nieuwe intentie (bijv. “abonnement opzeggen”) na het zien van enkele gelabelde gesprekken. |
|
Voorbeeld 2 |
Tekstclassificatie bij sentimentanalyse: bepaalt sentiment (bijv. “tevreden”, “boos”) uitsluitend op basis van definities. |
Documenttypeherkenning: leert nieuwe documenttypes (bijv. “inkooporders”) classificeren na enkele voorbeelden. |
Welke kies je?
ZSL is ideaal wanneer je geen gelabelde data hebt om mee te werken. Het is nuttig in situaties waar nieuwe categorieën of taken opduiken waarvoor het model niet is getraind, en er geen tijd of middelen zijn om gelabelde voorbeelden te verzamelen.
Een online winkel kan bijvoorbeeld nieuwe productcategorieën toevoegen, en het model kan deze items ordenen op basis van beschrijvingen zonder gelabelde voorbeelden nodig te hebben.
ZSL is perfect wanneer je flexibiliteit nodig hebt en het verzamelen van gelabelde data te duur, te traag of onmogelijk is.
FSL werkt daarentegen goed wanneer je een klein aantal gelabelde voorbeelden (meestal 1-5) kunt aanleveren en het model snel en nauwkeuriger moet leren.
Als een chatbot bijvoorbeeld een nieuw soort vraag krijgt, zoals "Hoe zeg ik mijn abonnement op?", kan het tonen van slechts enkele voorbeelden van dit type vraag helpen om vergelijkbare vragen nauwkeurig te classificeren.
FSL is ideaal wanneer je een paar gelabelde voorbeelden kunt aanleveren en goede prestaties nodig zijn, vooral bij taken waar nauwkeurigheid belangrijk is, zoals klantenondersteuning of medische beeldvorming.
Toepassingen van zero-shot learning
Er zijn talloze domeinen waar ZSL nuttig is. We bekijken er een paar.
Tekst en taalverwerking
ZSL wordt veel gebruikt bij tekstclassificatie, zodat modellen tekst kunnen indelen in nieuwe labels zonder voorafgaande training.
Zo kan het e-mails als spam of geen spam sorteren op basis van beschrijvingen van die categorieën, zonder gelabelde voorbeelden. Deze mogelijkheid helpt ook chatbots om gebruikersverzoeken te begrijpen zonder op elke mogelijke vraag getraind te zijn.
Bij sentimentanalyse kan ZSL bepalen of een review positief of negatief is puur door de betekenis van labels te interpreteren. Het speelt ook een rol bij moderatie op sociale media, waar het schadelijke of misleidende inhoud identificeert op basis van tekstbeschrijvingen, zoals het detecteren van desinformatie gelabeld als “verspreidt valse medische claims”, zelfs als het model zulke gevallen nog niet eerder heeft gezien.
Beeld- en visuele herkenning
Bij beeldclassificatie kunnen ZSL-modellen objecten herkennen die ze nog nooit hebben gezien door beelden te koppelen aan tekstbeschrijvingen. Tools zoals CLIP kunnen onbekende objecten identificeren, zoals een “rode panda”, en beelden afstemmen op tekst, waardoor visuele zoekmachines effectiever afbeeldingen kunnen ophalen op basis van gebruikersbeschrijvingen.
ZSL is ook waardevol bij milieumonitoring, waar het veranderingen in satellietbeelden detecteert zonder gelabelde trainingsdata. Zo kan het illegale houtkap herkennen door gebieden te identificeren die zijn beschreven als “aanzienlijk bladerdakverlies in beboste regio’s”, zelfs als het model niet expliciet is getraind op ontbossingspatronen.
Retail en aanbevelingen
In retail helpt ZSL nieuwe producten te classificeren in voorraadcategorieën op basis van alleen tekstuele beschrijvingen. Een model kan automatisch nieuwe items toewijzen aan labels zoals “milieuvriendelijke materialen”, zelfs als die categorie niet in de training zat.
Het lost ook het cold-startprobleem in aanbevelingssystemen op door producten of content te suggereren zonder voorafgaande gebruikersdata. Algoritmen zoals ZESRec kunnen items aanbevelen uit een volledig nieuwe dataset zonder overlap met eerder geziene data.
Uitdagingen van zero-shot learning
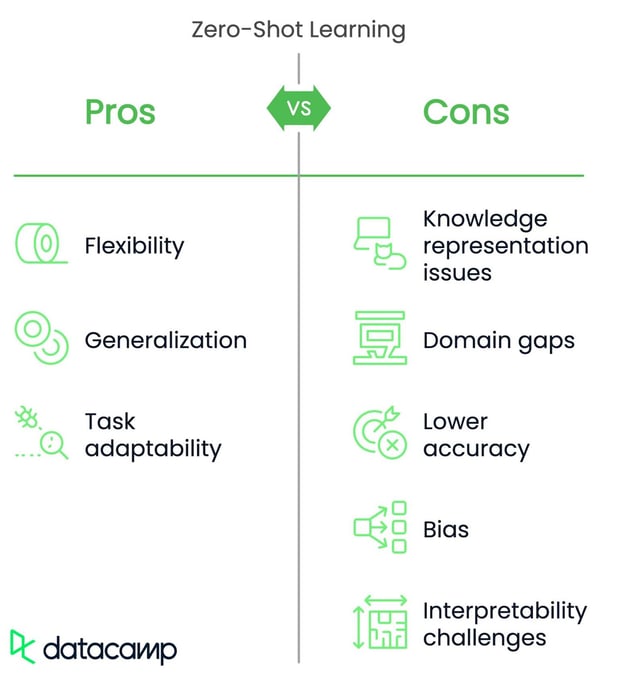
Hoewel ZSL flexibel is en kan generaliseren naar nieuwe taken, kent het verschillende uitdagingen.
Kennisrepresentatie
ZSL-modellen hebben moeite met het representeren van gedetailleerde of subtiele verschillen. Zo kan een model een luipaard en een cheeta verwarren omdat beide worden beschreven als "gevlekte grote katten", terwijl de beschrijvingen de fijnere verschillen niet vangen.
Domeinkloof
ZSL-modellen kunnen falen wanneer de nieuwe taak of data sterk afwijkt van waarop ze zijn getraind. Een model dat is getraind op het herkennen van huishoudelijke objecten kan bijvoorbeeld medische instrumenten niet identificeren omdat die te verschillend zijn.
Prestaties
ZSL is vaak minder nauwkeurig dan supervised learning (waarbij het model is getraind op gelabelde data) voor specifieke taken. Een oplossing is ZSL combineren met wat fine-tuning op specifieke data om de nauwkeurigheid te verbeteren, terwijl de flexibiliteit behouden blijft.
Bias
ZSL is afhankelijk van voorgetrainde data, die vooringenomenheden kan bevatten. Dit kan leiden tot oneerlijke voorspellingen. Stel je een wervingsmodel voor dat ZSL gebruikt. Het zou bepaalde demografieën kunnen bevoordelen als de voorgetrainde data gender- of raciale bias bevat. Een mogelijke mitigatie is om vooroordelen in de data vooraf te detecteren en te verminderen of methoden zoals adversarial debiasing te gebruiken om het model eerlijker te maken.
Interpretability
Het kan lastig zijn te begrijpen hoe een ZSL-model beslissingen neemt, zeker wanneer het complexe redeneringen hanteert. Bij het diagnosticeren van een zeldzame ziekte kan bijvoorbeeld onduidelijk zijn waarom het model die diagnose kiest zonder trainingsvoorbeelden.
Schaalbaarheid
Naarmate het aantal nieuwe taken of categorieën toeneemt, kunnen ZSL-modellen traag en inefficiënt worden. Een aanbevelingssysteem op basis van ZSL kan moeite hebben om miljoenen nieuwe producten in verschillende categorieën te verwerken. Het gebruik van betere methoden voor het organiseren en ophalen van data, zoals efficiënte indexering of het groeperen van vergelijkbare taken, kan dit probleem in sommige gevallen oplossen.
Conclusie
Zero-shot learning voorkomt de noodzaak van grote, gelabelde datasets, bespaart tijd en geld en werkt goed in veel domeinen, zoals het sorteren van tekst, het herkennen van beelden, het diagnosticeren van gezondheidsproblemen en het doen van persoonlijke aanbevelingen.
Hoewel ZSL niet perfect is—het worstelt soms met complexe concepten of nauwkeurigheid—is het zeer geschikt wanneer flexibiliteit cruciaal is en data te duur of schaars is.

Ana Rojo Echeburúa is een AI- en dataspecialist met een PhD in Toegepaste Wiskunde. Ze houdt ervan om data om te zetten in bruikbare inzichten en heeft ruime ervaring in het aansturen van technische teams. Ana werkt graag nauw samen met klanten om hun bedrijfsproblemen op te lossen en innovatieve AI-oplossingen te creëren. Ze staat bekend om haar probleemoplossend vermogen en heldere communicatie, en is gepassioneerd door AI, vooral generatieve AI. Ana zet zich in voor continue ontwikkeling en ethische AI, en voor het vereenvoudigen van complexe vraagstukken en het op een toegankelijke manier uitleggen van technologie.


Wat als een AI-model succesvol zou kunnen werken zonder duizenden gelabelde voorbeelden?
Zero-shot learning (ZSL) is een techniek die dit mogelijk maakt: modellen kunnen nieuwe concepten identificeren en classificeren zonder gelabelde voorbeelden tijdens de training en taken uitvoeren waarvoor ze niet specifiek zijn getraind.
Dat is gunstig, omdat AI-systemen zo nieuwe taken, producten of markten kunnen oppakken zonder voortdurend opnieuw te hoeven trainen. Het verlaagt de kosten voor dataverzameling en -annotatie en verbetert het vermogen van een model om geleerde kennis toe te passen op situaties die het niet eerder heeft gezien.
In dit artikel leg ik uit hoe ZSL werkt, welke uitdagingen erbij komen kijken, en de belangrijkste toepassingen met enkele voorbeelden. Laten we erin duiken!