
Che cos'è il Zero-Shot Learning?
Lo zero-shot learning (ZSL) è una tecnica di machine learning che permette ai modelli di affrontare compiti o riconoscere elementi che non hanno mai incontrato prima. Lo fa utilizzando ciò che già conosce e collegandolo a nuove situazioni, anche senza addestramento specifico per esse.
Supponiamo che un modello sia addestrato a riconoscere animali ma non abbia mai imparato nulla sulle zebre nella fase di training. Con lo ZSL, il modello potrebbe comunque capire cos'è una zebra usando una descrizione. Ma come? Permettimi di semplificare un po' le cose (più avanti entreremo nei dettagli tecnici) e di spiegare:
- Il modello conosce gli animali e le loro caratteristiche, come "ha quattro zampe", "vive nella savana" o "ha strisce".
- Riceve una nuova descrizione: "Un animale simile a un cavallo con strisce bianche e nere che vive nelle praterie africane".
- Usando la sua comprensione degli attributi degli animali e la descrizione fornita, il modello può dedurre che l'immagine rappresenta probabilmente una zebra, anche se non ne ha mai vista una prima.
- Il modello giunge a questa inferenza collegando i punti tra caratteristiche animali note e la nuova descrizione.
Come funziona lo Zero-Shot Learning?
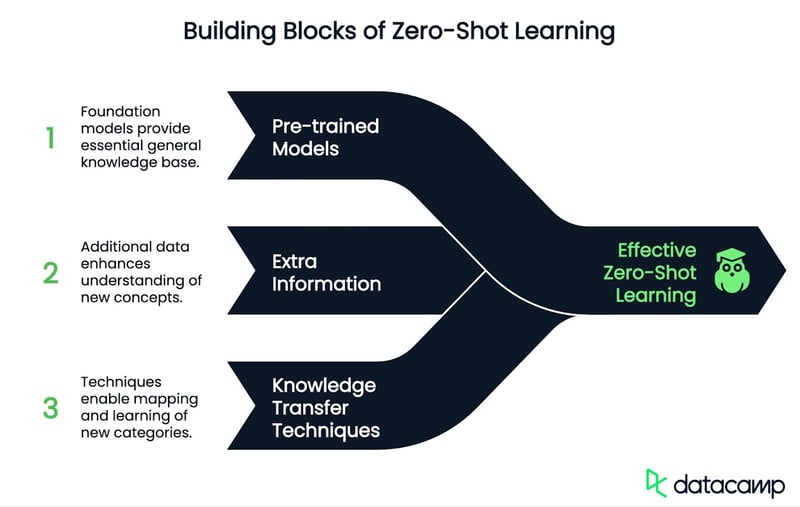
Lo zero-shot learning è un processo in due fasi (training e inferenza) e impiega tre componenti chiave: modelli pre-addestrati, informazioni aggiuntive e trasferimento di conoscenza.
Modelli pre-addestrati
Lo ZSL si basa su modelli pre-addestrati che sono stati addestrati su grandi quantità di dati. Per esempio, la famiglia dei GPT (per il linguaggio) o CLIP (per le connessioni immagine-testo). Questi modelli forniscono una solida base di conoscenza generale.
Informazioni aggiuntive
Le informazioni aggiuntive aiutano il modello a comprendere nuovi elementi. Possono includere:
- Descrizioni testuali.
- Attributi o caratteristiche.
- Associazioni tra parole o vettori.
Trasferimento di conoscenza
Lo ZSL mappa sia le classi note sia quelle nuove in uno "spazio semantico" condiviso in cui possono essere confrontate. Spesso utilizza tecniche come:
- Embedding semantici : un modo condiviso per rappresentare sia le categorie note sia quelle sconosciute.
- Transfer learning: riutilizzare la conoscenza da compiti simili per affrontarne di nuovi.
- Modelli generativi: creare esempi sintetici di classi non viste per aiutare il modello a imparare.
Training e inferenza
Lo ZSL può essere concettualizzato come un processo in due fasi:
- Training: il modello acquisisce conoscenza su campioni di dati etichettati e i loro attributi.
- Inferenza: la conoscenza acquisita viene estesa a nuove classi usando le informazioni ausiliarie fornite. Avviene in tre passaggi:
- Il modello converte un nuovo input (come un'immagine) in una rappresentazione semantica.
- Confronta questa rappresentazione con quelle di classi note o descrizioni.
- Sceglie la corrispondenza più vicina in base alla similarità.
Questo approccio consente ai modelli ZSL di riconoscere dinamicamente, nel tempo, un insieme aperto di nuovi concetti utilizzando solo descrizioni o informazioni semantiche, senza bisogno di ulteriori dati etichettati per l'addestramento.
Torniamo al nostro esempio di classificazione degli animali.
Esempio: classificare gli animali
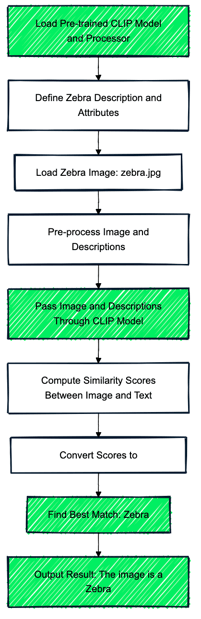
Immagina di usare il modello CLIP, pre-addestrato su un enorme dataset di coppie immagine-testo. Questo modello pre-addestrato fornisce una base di conoscenza generale sugli animali, anche se non è stato addestrato esplicitamente sulle zebre.
Nel nostro esempio della zebra, i dati ausiliari (informazioni extra) includono descrizioni testuali come: “Un animale simile a un cavallo con strisce bianche e nere che vive nelle praterie africane” e attributi come "ha quattro zampe", "ha strisce", "vive nella savana". Queste descrizioni e attributi collegano ciò che il modello conosce (tratti generali degli animali) e la classe non vista (zebra).
Quindi, il modello mappa sia le classi viste (ad es. cavallo, tigre) sia la classe non vista (zebra) in uno spazio semantico condiviso. Il modello codifica la descrizione della zebra ("strisce bianche e nere, simile a un cavallo") nello stesso spazio degli animali noti e usa la sua comprensione di animali come cavalli e tigri per ragionare sulle zebre.
Il modello confronta l'embedding della zebra con gli embedding di animali noti e descrizioni (ad es. cavallo, tigre, "strisce bianche e nere"). Usando punteggi di similarità, il modello identifica la zebra come corrispondente più stretta alla descrizione: "Un animale simile a un cavallo con strisce bianche e nere che vive nelle praterie africane".
Zero-Shot Learning vs. Few-Shot Learning
Lo zero-shot learning (ZSL) e il few-shot learning (FSL) sono due metodi che aiutano i modelli ad affrontare nuovi compiti o oggetti anche quando ci sono pochi o nessun dato disponibile. Tuttavia, presentano alcune differenze. Ecco una panoramica di entrambe le tecniche e delle loro differenze chiave:
|
Aspetto |
Zero-Shot Learning (ZSL) |
Few-Shot Learning (FSL) |
|
Cosa fa |
Gestisce nuovi compiti senza dati di training etichettati. |
Impara nuovi compiti da pochi esempi etichettati. |
|
Come funziona |
Deduce nuove categorie mappando le descrizioni alla conoscenza acquisita. |
Impara schemi da pochi esempi per classificare nuove istanze. |
|
Dati necessari |
Non richiede esempi etichettati per nuovi compiti. |
Richiede 1–5 esempi etichettati per nuovi compiti. |
|
Conoscenza pregressa |
Si basa su relazioni apprese tra concetti e descrizioni. |
Usa la conoscenza pregressa ma si aggiorna anche in base agli esempi forniti. |
|
Adattabilità |
Può generalizzare a compiti completamente nuovi ma può essere meno preciso. |
Si adatta rapidamente a compiti nuovi specifici ed è di solito più accurato. |
|
Esempio 1 |
Rilevamento spam: identifica lo spam usando definizioni (ad es. “email con link sospetti”) senza dati di spam etichettati in precedenza. |
Rilevamento dell'intento nel supporto clienti: impara a rilevare un nuovo intento (ad es. “annullare l'abbonamento”) dopo aver visto pochi dialoghi etichettati. |
|
Esempio 2 |
Classificazione del testo nell'analisi del sentiment: determina il sentiment (ad es. “soddisfatto”, “arrabbiato”) usando solo le definizioni. |
Identificazione del tipo di documento: impara a classificare nuovi tipi di documenti (ad es. “ordini d'acquisto”) dopo aver visto pochi esempi. |
Quale scegliere?
Lo ZSL è ideale quando non hai alcun dato etichettato con cui lavorare. È utile in situazioni in cui compaiono nuove categorie o compiti per cui il modello non è stato addestrato, e non ci sono tempo o risorse per raccogliere esempi etichettati.
Per esempio, un negozio online potrebbe aggiungere nuove categorie di prodotti e il modello può organizzare questi articoli in base alle descrizioni senza bisogno di esempi etichettati.
Lo ZSL è perfetto quando serve flessibilità e raccogliere dati etichettati è troppo costoso, lento o impossibile.
D'altra parte, l'FSL funziona bene quando puoi fornire un piccolo numero di esempi etichettati (di solito 1-5) e hai bisogno che il modello impari velocemente con migliore accuratezza.
Per esempio, se un chatbot riceve un nuovo tipo di domanda come "Come posso annullare il mio abbonamento?", mostrargli solo pochi esempi di questo tipo di richiesta può aiutarlo a classificare accuratamente quelle simili.
L'FSL è ottimo per situazioni in cui puoi permetterti di fornire alcuni esempi etichettati e hai bisogno che il modello renda bene, soprattutto in compiti in cui l'accuratezza è importante, come il supporto clienti o l'imaging medico.
Applicazioni dello Zero-Shot Learning
Ci sono tantissime aree in cui lo ZSL è utile. Vediamone alcune.
Elaborazione di testo e linguaggio
Lo ZSL è ampiamente usato nella classificazione del testo, permettendo ai modelli di categorizzare testi in nuove etichette senza training precedente.
Per esempio, può smistare le email in spam o non spam basandosi sulle descrizioni di tali categorie, senza bisogno di esempi etichettati. Questa capacità aiuta anche i chatbot a comprendere le richieste degli utenti senza addestramento su ogni possibile query.
Nell'analisi del sentiment, lo ZSL consente ai modelli di determinare se una recensione è positiva o negativa interpretando semplicemente il significato delle etichette. Gioca anche un ruolo nella moderazione dei social media, identificando contenuti dannosi o fuorvianti basandosi su descrizioni testuali, come rilevare disinformazione etichettata come “diffusione di false affermazioni mediche”, anche se il modello non ha mai incontrato tali casi prima.
Immagini e riconoscimento visivo
Nella classificazione delle immagini, lo ZSL consente ai modelli di riconoscere oggetti mai visti collegando le immagini alle descrizioni testuali. Strumenti come CLIP possono identificare oggetti non familiari, come un “panda rosso”, e allineare immagini e testo, rendendo i motori di ricerca visivi più efficaci nel recuperare immagini in base alle descrizioni degli utenti.
Lo ZSL è utile anche nel monitoraggio ambientale, dove rileva cambiamenti nelle immagini satellitari senza dati di training etichettati. Per esempio, può identificare il disboscamento illegale riconoscendo aree descritte come “perdita significativa di copertura arborea in regioni boschive”, anche se il modello non è stato esplicitamente addestrato su schemi di deforestazione.
Retail e raccomandazioni
Nel retail, lo ZSL aiuta a classificare nuovi prodotti nelle categorie d'inventario usando solo descrizioni testuali. Un modello può assegnare automaticamente nuovi articoli a etichette come “materiali ecosostenibili” anche se quella categoria non era inclusa durante il training.
Risolve anche il problema del cold start nei sistemi di raccomandazione suggerendo prodotti o contenuti senza dati utente pregressi. Algoritmi come ZESRec possono raccomandare elementi da un dataset completamente nuovo senza alcuna sovrapposizione con i dati visti in precedenza.
Sfide dello Zero-Shot Learning
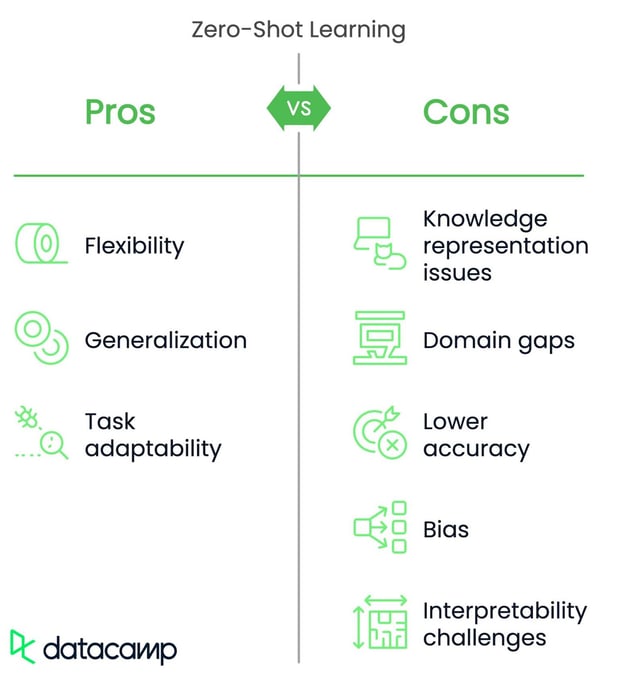
Sebbene lo ZSL sia flessibile e possa generalizzare a nuovi compiti, deve affrontare diverse sfide.
Rappresentazione della conoscenza
I modelli ZSL faticano a rappresentare differenze dettagliate o sottili tra elementi. Per esempio, un modello potrebbe confondere un leopardo e un ghepardo perché entrambi sono descritti come "grandi felini maculati" e le descrizioni non colgono le differenze più fini.
Gap di dominio
I modelli ZSL possono fallire quando il nuovo compito o i nuovi dati sono molto diversi da quelli su cui sono stati addestrati. Ad esempio, un modello addestrato a riconoscere oggetti domestici potrebbe non riuscire a identificare strumenti medici perché troppo diversi.
Prestazioni
Lo ZSL è spesso meno accurato del supervised learning (dove il modello è addestrato su dati etichettati) per compiti specifici. Una soluzione a questa sfida è combinare lo ZSL con un po' di fine-tuning su dati specifici per migliorare l'accuratezza mantenendo la flessibilità.
Bias
Lo ZSL si basa su dati pre-addestrati, che potrebbero contenere bias. Questo può spesso portare a previsioni scorrette. Immagina un modello per l'assunzione di personale che utilizza ZSL. Potrebbe favorire determinate demografie se i dati pre-addestrati presentano bias di genere o razziali. Una strategia di mitigazione è rilevare e ridurre i bias nei dati in anticipo o usare metodi come l'adversarial debiasing per rendere il modello più equo.
Interpretabilità
Può essere difficile capire come un modello ZSL prenda decisioni, specialmente quando utilizza un ragionamento complesso. Nella diagnosi di una malattia rara, ad esempio, potrebbe non essere chiaro perché il modello abbia scelto quella diagnosi senza esempi di training.
Scalabilità
Con l'aumentare del numero di nuovi compiti o categorie, i modelli ZSL possono diventare lenti e inefficienti. Un sistema di raccomandazione basato su ZSL potrebbe faticare a gestire milioni di nuovi prodotti in categorie diverse. Usare metodi migliori per organizzare e recuperare i dati, come l'indicizzazione efficiente o il raggruppamento di compiti simili, può risolvere il problema in alcuni casi.
Conclusione
Lo zero-shot learning evita la necessità di grandi dataset etichettati, fa risparmiare tempo e denaro e funziona bene in molte aree, come la classificazione del testo, il riconoscimento di immagini, la diagnosi di problemi di salute e le raccomandazioni personalizzate.
Sebbene lo ZSL non sia perfetto — a volte fatica con concetti complessi o con l'accuratezza — è ottimo negli scenari in cui la flessibilità è fondamentale e i dati sono troppo costosi o scarsi.

Ana Rojo Echeburúa è una specialista di AI e dati con un dottorato in Matematica Applicata. Le piace trasformare i dati in insight azionabili e ha una vasta esperienza nella guida di team tecnici. Ana ama collaborare da vicino con i clienti per risolvere le loro sfide di business e creare soluzioni di AI innovative. Nota per le sue capacità di problem solving e la comunicazione chiara, è appassionata di AI, in particolare di AI generativa. Ana è dedita all’apprendimento continuo e allo sviluppo etico dell’AI, oltre a semplificare problemi complessi e spiegare la tecnologia in modo accessibile.





E se un modello di IA potesse funzionare con successo senza aver bisogno di migliaia di esempi etichettati?
Zero-shot learning (ZSL) è una tecnica che permette ai modelli di farlo: possono identificare e classificare nuovi concetti senza alcun esempio etichettato durante l'addestramento e gestire compiti per cui non sono stati specificamente addestrati.
Questo è fantastico perché consente ai sistemi di IA di affrontare nuovi compiti, prodotti o mercati senza la necessità continua di riaddestramento. Riduce i costi di raccolta e annotazione dei dati e migliora la capacità di un modello di applicare ciò che ha imparato a situazioni che non ha mai visto prima.
In questo articolo spiegherò come funziona lo ZSL, le sfide che affronta, le sue principali applicazioni con alcuni esempi. Andiamo al sodo!