
50% off DataCamp Premium. 700+ courses, half price. Start learning today.
Transfer learning is een techniek waarmee machines de kennis die ze bij een eerdere taak hebben opgedaan, kunnen benutten om beter te generaliseren naar een andere taak. Het is een fundamenteel concept achter de ontwikkeling van modellen zoals ChatGPT en Google Gemini, en het helpt bij veel belangrijke en nuttige taken, zoals het samenvatten van lange documenten, het schrijven van complexe essays, het plannen van reizen of zelfs het schrijven van gedichten en liedjes.
In deze gids duiken we diep in transfer learning. We bespreken de definitie, waarom het relevant is voor deep learning en moderne generatieve AI-modellen, en de uitdagingen en beperkingen van deze techniek. We reiken ook bronnen aan zodat je verder kunt leren. Klaar? Laten we beginnen.
Transfer learning is een techniek waarbij een model dat voor een bepaalde taak is ontwikkeld, opnieuw wordt gebruikt als startpunt voor een model op een tweede taak. Met andere woorden: je past onderdelen van een vooraf getraind machinelearningmodel opnieuw toe op nieuwe modellen die bedoeld zijn voor iets anders, maar wel gerelateerd.
Het concept is vergelijkbaar met hoe mensen nieuwe vaardigheden leren. Neem dit voorbeeld: stel, je bent een ervaren gitarist en besluit de ukelele te leren. Je eerdere ervaring met de gitaar zal je leerproces versnellen. Dit komt doordat veel van de vaardigheden en kennis die nodig zijn voor het spelen van gitaar—zoals vingerposities, tokkeltechnieken, het begrijpen van de toets, muziektheorie en ritme—ook van toepassing zijn op het spelen van de ukelele.
In AI stelt transfer learning je in staat om eerdere training te benutten om nieuwe, gerelateerde problemen efficiënter op te lossen, waardoor tijd en rekenmiddelen worden bespaard.
Er zijn verschillende overtuigende redenen om transfer learning-technieken toe te passen bij het ontwikkelen van neurale netwerken, waaronder:
Laten we drie concepten verkennen die gerelateerd zijn aan transfer learning: multi-task learning, feature-extractie en fine-tuning.
Bij multi-task learning wordt één model getraind om meerdere taken tegelijk uit te voeren. Het model heeft een gedeelde set vroege lagen die de data op een gemeenschappelijke manier verwerken, gevolgd door afzonderlijke lagen voor elke specifieke taak. Hierdoor leert het model algemene kenmerken die voor alle taken nuttig zijn, én taakspecifieke kenmerken die unieker zijn.
Dit paradigma wordt veel gebruikt in moderne LLM’s. Bekijk onze Introductiecursus LLM’s om alle details te leren.
Feature-extractie houdt in dat je een vooraf getraind model gebruikt om betekenisvolle kenmerken of representaties uit data te halen. Deze features gebruik je vervolgens als input voor een nieuw model dat zich op iets specifieks richt.
Feature-based transfer learning benut de unieke capaciteiten van neurale netwerken om kenmerken uit data te halen. Met feature-extractie ‘bedenkt’ het model als het ware welk deel van de input belangrijk is om bijvoorbeeld een afbeelding te classificeren. In de praktijk betekent dit dat, wanneer een model op een nieuwe taak wordt toegepast, alleen de vooraf getrainde eerste en middelste lagen van het model—die de meer generaliseerbare kennis bevatten—worden gebruikt.
Fine-tuning gaat verder dan feature-extractie en wordt vaak gebruikt wanneer de twee taken niet nauw verwant zijn. Het houdt in dat je een vooraf getraind model neemt en dit verder traint op een domeinspecifieke dataset.
De meeste LLM-modellen presteren tegenwoordig globaal zeer goed, maar schieten vaak tekort bij specifieke, taakgerichte problemen. Fine-tuning stemt het model af om beter te presteren op specifieke taken, waardoor het effectiever en veelzijdiger wordt in realistische toepassingen. Wil je meer weten over fine-tuning, bekijk dan onze Introductiegids voor het fine-tunen van LLM’s.
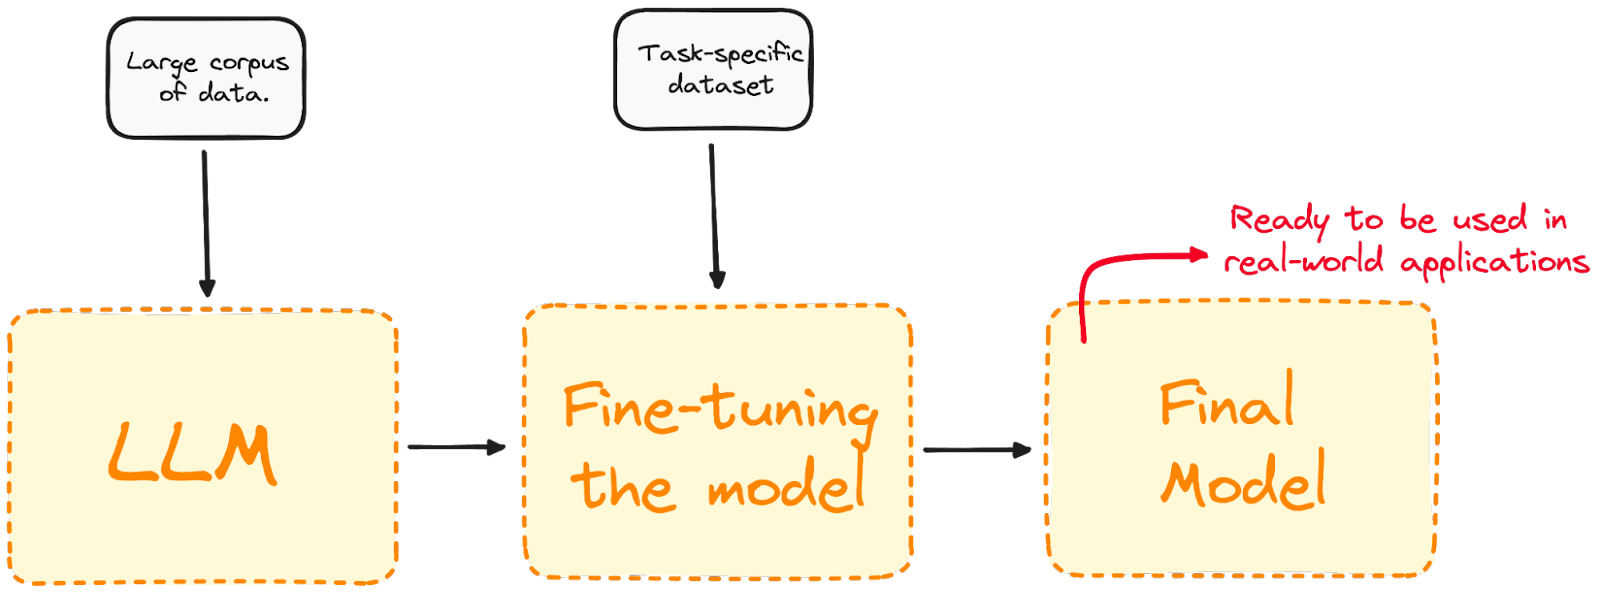 Het fine-tuningproces in beeld. [DataCamp]
Transfer learning is een veelgebruikte techniek voor uiteenlopende datawetenschapstaken, waaronder die in computervisie en natural language processing.
Computervisie is een van de domeinen waar transfer learning bijzonder vruchtbaar is gebleken. Neurale netwerken in dit veld hebben enorme hoeveelheden data nodig voor taken zoals objectdetectie en beeldclassificatie.
In computervisie detecteren de eerste lagen van neurale netwerken randen in afbeeldingen, terwijl de middelste lagen vormen en contouren herkennen. De laatste lagen worden afgestemd op specifieke taken. Transfer learning maakt het mogelijk om nieuwe modellen te creëren door alleen de laatste lagen opnieuw te trainen, terwijl de gewichten en biases van de eerste en middelste lagen ongewijzigd blijven. Dankzij transfer learning is het mogelijk om nieuwe modellen te maken die slechts de laatste lagen van het netwerk hertrainen, terwijl de gewichten en biases van de eerste en middelste lagen behouden blijven.
Tegenwoordig zijn er behoorlijk wat vooraf getrainde, openbare neurale netwerken voor computervisie, bijvoorbeeld:
NLP is een tak van AI die zich richt op de interactie tussen computers en mensen via natuurlijke taal. Het doel is om computers zo te programmeren dat ze grote hoeveelheden natuurlijke taaldata, in tekst- of audioformaat, kunnen verwerken en analyseren.
Transfer learning speelt een cruciale rol bij het ontwikkelen van NLP-modellen. Het maakt gebruik van vooraf getrainde taalmodellen die zijn ingezet voor algemene taalbegripstaken of vertaling, en deze worden vervolgens gefine-tuned voor specifieke NLP-problemen, zoals sentimentanalyse of taalvertaling. De toepassingen van NLP zijn vrijwel eindeloos en omvatten spraakassistenten en spraakherkenning.
Transfer learning ligt ten grondslag aan enkele van de meest populaire NLP-modellen, waaronder:
In de kern is transfer learning vooral een ontwerkaanpak om de efficiëntie te verhogen. In plaats van modellen vanaf nul te trainen—wat in het geval van geavanceerde generatieve AI-modellen enorme hoeveelheden middelen, geld en tijd vergt—maakt transfer learning het mogelijk om sneller en effectiever te leren bij nieuwe taken door de eerder verworven kennis te benutten.
Transfer learning komt vooral tot zijn recht wanneer er weinig data beschikbaar is om een model voor een tweede taak te trainen. Door de kennis van een vooraf getraind model te gebruiken, kan transfer learning overfitting helpen voorkomen en de algehele nauwkeurigheid vergroten. Toch is transfer learning niet waterdicht en zijn er beperkingen en valkuilen die zorgvuldig moeten worden aangepakt. Enkele veelvoorkomende uitdagingen bij transfer learning zijn:
Transfer learning is een cruciale ontwerpmethode om de efficiëntie en het potentieel van neurale netwerken te vergroten. Het is niet overdreven om te zeggen dat de huidige AI-revolutie niet mogelijk was geweest zonder de vele beschikbare transfer learning-technieken.
Wil je meer weten over de specificaties van transfer learning, dan helpt DataCamp je graag op weg. Bekijk onze gerichte materialen over LLM’s en neurale netwerken en ga vandaag nog aan de slag.
Leer met DataCamp
{count, plural, one {Cursus} other {Cursussen}}
{count, plural, one {Cursus} other {Cursussen}}
{count, plural, one {Cursus} other {Cursussen}}
{count, plural, one {blog} other {blogs}}
Adel Nehme
15 min


