
ज़ीरो-शॉट लर्निंग क्या है?
ज़ीरो-शॉट लर्निंग (ZSL) मशीन लर्निंग की एक तकनीक है जो मॉडलों को ऐसे कार्यों को संभालने या चीज़ों को पहचानने देती है जिनका उन्होंने पहले सामना नहीं किया। यह ऐसा उस ज्ञान का उपयोग करके करती है जो मॉडल को पहले से है, और उसे नई परिस्थितियों से जोड़ती है—भले ही उनके लिए विशेष प्रशिक्षण न मिला हो।
मान लीजिए कि किसी मॉडल को जानवरों को पहचानने के लिए प्रशिक्षित किया गया, लेकिन प्रशिक्षण चरण में उसे ज़ेब्रा के बारे में नहीं सिखाया गया। ZSL के साथ, मॉडल फिर भी किसी विवरण का उपयोग करके यह समझ सकता है कि ज़ेब्रा क्या है। लेकिन कैसे? मैं इसे थोड़ा सरल करके बताता हूँ (हम आगे कुछ तकनीकी विवरणों में जाएँगे):
- मॉडल जानवरों और उनकी विशेषताओं के बारे में जानता है, जैसे "चार पैर होते हैं," "सवाना में रहता है," या "धारियाँ होती हैं।"
- उसे एक नया विवरण दिया गया: "अफ्रीकी घास के मैदानों में रहने वाला काले और सफेद धारीदार, घोड़े जैसा जानवर।"
- जानवरों के गुणों की अपनी समझ और दिए गए विवरण का उपयोग करते हुए, मॉडल यह निष्कर्ष निकाल सकता है कि तस्वीर संभवतः ज़ेब्रा को दर्शाती है, भले ही उसने पहले कभी उसे न देखा हो।
- मॉडल यह निष्कर्ष ज्ञात पशु-विशेषताओं और नए विवरण के बीच संबंध जोड़कर निकालता है।
ज़ीरो-शॉट लर्निंग कैसे काम करती है?
ज़ीरो-शॉट लर्निंग दो चरणों (ट्रेनिंग और इंफेरेंस) में होती है और तीन प्रमुख घटकों का उपयोग करती है: प्री-ट्रेन किए गए मॉडल, अतिरिक्त जानकारी, और नॉलेज ट्रांसफ़र।
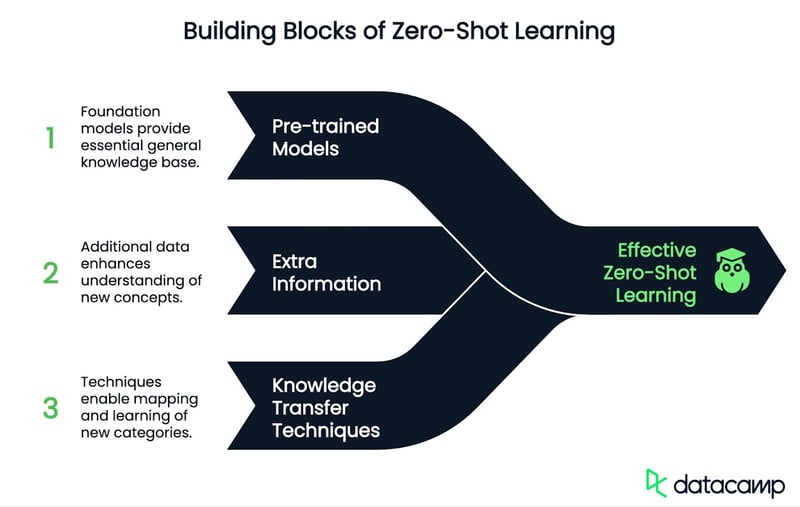
प्री-ट्रेन किए गए मॉडल
ZSL उन प्री-ट्रेन मॉडलों पर निर्भर करती है जिन्हें बहुत सारे डेटा पर प्रशिक्षित किया गया हो। उदाहरण के लिए, GPTs का परिवार (भाषा के लिए) या CLIP (इमेज-टेक्स्ट कनेक्शनों के लिए)। ये मॉडल सामान्य ज्ञान का एक मजबूत आधार प्रदान करते हैं।
अतिरिक्त जानकारी
अतिरिक्त जानकारी मॉडल को नई चीज़ें समझने में मदद करती है। इसमें शामिल हो सकता है:
- पाठ्य विवरण।
- एट्रिब्यूट्स या फीचर्स।
- शब्द-सहसंबंध या वेक्टर।
नॉलेज ट्रांसफ़र
ZSL ज्ञात और नई दोनों श्रेणियों को एक साझा "सामांतीय स्पेस" में मैप करती है, जहाँ उनकी तुलना की जा सके। यह अक्सर निम्न तकनीकों का उपयोग करती है:
- सामांतीय एम्बेडिंग्स: ज्ञात और अज्ञात दोनों श्रेणियों को प्रदर्शित करने का साझा तरीका।
- ट्रांसफ़र लर्निंग: समान कार्यों से प्राप्त ज्ञान का पुनः उपयोग करके नए कार्यों को हल करना।
- जेनरेटिव मॉडल: अनदेखी श्रेणियों के नकली उदाहरण बनाना ताकि मॉडल सीख सके।
ट्रेनिंग और इंफेरेंस
ZSL को दो-चरणीय प्रक्रिया के रूप में समझा जा सकता है:
- ट्रेनिंग: मॉडल लेबल किए गए डाटा सैंपल्स और उनके एट्रिब्यूट्स के बारे में ज्ञान अर्जित करता है।
- इंफेरेंस: प्राप्त ज्ञान को दी गई सहायक जानकारी का उपयोग करके नई श्रेणियों तक बढ़ाया जाता है। यह तीन चरणों में होता है:
- मॉडल नए इनपुट (जैसे, कोई छवि) को एक सामांतीय अभिविन्यास में बदलता है।
- यह इस अभिविन्यास की तुलना ज्ञात श्रेणियों या विवरणों से करता है।
- यह समानता के आधार पर सबसे नज़दीकी मेल चुनता है।
यह दृष्टिकोण ZSL मॉडलों को समय के साथ केवल विवरणों या सामांतीय जानकारी के आधार पर नए कॉन्सेप्ट्स के खुले-अंत सेट को गतिशील रूप से पहचानने देता है, और इसके लिए अतिरिक्त लेबल किए गए प्रशिक्षण डेटा की आवश्यकता नहीं होती।
चलिए अपने जानवर-वर्गीकरण के उदाहरण पर वापस आते हैं।
उदाहरण: जानवरों का वर्गीकरण
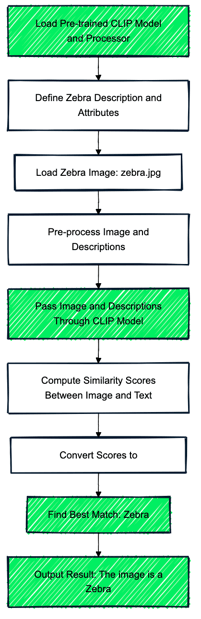
मान लीजिए हम CLIP मॉडल का उपयोग कर रहे हैं, जिसे इमेज-टेक्स्ट पेयर्स के विशाल डेटासेट पर प्री-ट्रेन किया गया है। यह प्री-ट्रेन मॉडल जानवरों के बारे में सामान्य ज्ञान की बुनियाद देता है, भले ही इसे ज़ेब्रा पर स्पष्ट रूप से प्रशिक्षित न किया गया हो।
हमारे ज़ेब्रा उदाहरण में, सहायक डेटा (अतिरिक्त जानकारी) में ऐसे टेक्स्ट विवरण शामिल हैं: “अफ्रीकी घास के मैदानों में रहने वाला काले और सफेद धारीदार, घोड़े जैसा जानवर।” और ऐसे एट्रिब्यूट्स जैसे "चार पैर होते हैं," "धारियाँ होती हैं," "सवाना में रहता है।" ये विवरण और एट्रिब्यूट्स मॉडल के ज्ञात ज्ञान (सामान्य पशु-गुण) और अनदेखी श्रेणी (ज़ेब्रा) को जोड़ते हैं।
इसके बाद, मॉडल देखी गई श्रेणियों (जैसे, घोड़ा, बाघ) और अनदेखी श्रेणी (ज़ेब्रा)—दोनों को एक साझा सामांतीय स्पेस में मैप करता है। मॉडल ज़ेब्रा के विवरण ("काले और सफेद धारियाँ, घोड़े जैसा") को उन्हीं स्पेस में एन्कोड करता है जहाँ ज्ञात जानवर हैं, और घोड़े व बाघ जैसे जानवरों की अपनी समझ का उपयोग करके ज़ेब्रा के बारे में तर्क करता है।
मॉडल ज़ेब्रा के एम्बेडिंग की तुलना ज्ञात जानवरों और विवरणों (जैसे, घोड़ा, बाघ, "काली और सफेद धारियाँ") के एम्बेडिंग्स से करता है। समानता स्कोर का उपयोग करके, मॉडल उस विवरण से सबसे अधिक मेल खाने वाली श्रेणी के रूप में ज़ेब्रा की पहचान करता है: "अफ्रीकी घास के मैदानों में रहने वाला काले और सफेद धारीदार, घोड़े जैसा जानवर।"
ज़ीरो-शॉट लर्निंग बनाम फ्यू-शॉट लर्निंग
ज़ीरो-शॉट लर्निंग (ZSL) और फ्यू-शॉट लर्निंग (FSL)—दोनों तरीके मॉडलों को तब भी नए कार्यों या वस्तुओं से निपटने में मदद करते हैं जब बहुत कम या कोई डेटा उपलब्ध न हो। हालाँकि, इनमें कुछ अंतर हैं। आइए दोनों तकनीकों का एक अवलोकन और उनके प्रमुख अंतर देखें:
|
पहलू |
ज़ीरो-शॉट लर्निंग (ZSL) |
फ्यू-शॉट लर्निंग (FSL) |
|
क्या करता है |
लेबल किए गए प्रशिक्षण डेटा के बिना नए कार्यों को संभालता है। |
कुछ लेबल किए गए उदाहरणों से नए कार्य सीखता है। |
|
कैसे काम करता है |
विवरणों को ज्ञात ज्ञान से मैप करके नई श्रेणियाँ निकालता है। |
कुछ उदाहरणों से पैटर्न सीखकर नए इंस्टैंसेज़ का वर्गीकरण करता है। |
|
डेटा की ज़रूरत |
नए कार्यों के लिए शून्य लेबल किए गए उदाहरणों की आवश्यकता। |
नए कार्यों के लिए 1–5 लेबल किए गए उदाहरणों की आवश्यकता। |
|
पूर्व ज्ञान |
कॉन्सेप्ट्स और विवरणों के बीच सीखे गए संबंधों पर निर्भर। |
पूर्व ज्ञान का उपयोग करता है और दिए गए उदाहरणों के आधार पर अद्यतन भी करता है। |
|
अनुकूलन क्षमता |
पूरी तरह नए कार्यों तक सामान्यीकरण कर सकता है, पर सटीकता कम हो सकती है। |
विशिष्ट नए कार्यों के लिए तेज़ी से अनुकूल होता है और आमतौर पर अधिक सटीक होता है। |
|
उदाहरण 1 |
स्पैम डिटेक्शन: परिभाषाओं (जैसे, “संदिग्ध लिंक्स वाले ईमेल”) के आधार पर, बिना पूर्व लेबल किए स्पैम डेटा के, स्पैम की पहचान। |
कस्टमर सपोर्ट इंटेंट डिटेक्शन: कुछ लेबल की गई बातचीतें देखने के बाद एक नया इरादा (जैसे, “सब्सक्रिप्शन रद्द करना”) पहचानना सीखता है। |
|
उदाहरण 2 |
सेंटिमेंट एनालिसिस में टेक्स्ट वर्गीकरण: केवल परिभाषाओं के आधार पर भावना तय करना (जैसे, “संतुष्ट,” “क्रोधित”). |
दस्तावेज़ प्रकार पहचान: कुछ उदाहरण देखने के बाद नए दस्तावेज़ प्रकार (जैसे, “परचेज़ ऑर्डर्स”) का वर्गीकरण सीखना। |
कौन-सा चुनें?
जब आपके पास काम करने के लिए कोई लेबल किया हुआ डेटा न हो, तब ZSL सबसे अच्छा है। यह उन स्थितियों में उपयोगी है जहाँ नई श्रेणियाँ या कार्य सामने आते हैं जिनके लिए मॉडल प्रशिक्षित नहीं था, और लेबल किए गए उदाहरण जुटाने का समय या संसाधन उपलब्ध नहीं हैं।
उदाहरण के लिए, किसी ऑनलाइन स्टोर में नए उत्पाद-श्रेणियाँ जोड़ दी जाएँ, तो मॉडल बिना लेबल किए उदाहरणों की ज़रूरत के, केवल विवरणों के आधार पर इन वस्तुओं को व्यवस्थित कर सकता है।
जब आपको लचीलापन चाहिए और लेबल किए गए डेटा इकट्ठा करना महँगा, धीमा, या असंभव हो, तब ZSL उपयुक्त है।
दूसरी ओर, FSL तब अच्छी तरह काम करता है जब आप थोड़े (आमतौर पर 1-5) लेबल किए हुए उदाहरण दे सकते हैं और चाहते हैं कि मॉडल बेहतर सटीकता के साथ जल्दी सीखे।
उदाहरण के लिए, यदि किसी चैटबॉट को एक नए प्रकार का प्रश्न मिलता है, जैसे "मैं अपनी सब्सक्रिप्शन कैसे रद्द करूँ?", तो इस तरह की क्वेरी के कुछ उदाहरण दिखाने से वह समान प्रश्नों को सटीकता से वर्गीकृत कर सकेगा।
FSL उन स्थितियों के लिए बढ़िया है जहाँ आप कुछ लेबल किए हुए उदाहरण दे सकते हैं और मॉडल से अच्छा प्रदर्शन चाहिए—खासकर जहाँ सटीकता महत्वपूर्ण हो, जैसे कस्टमर सपोर्ट या मेडिकल इमेजिंग।
ज़ीरो-शॉट लर्निंग के अनुप्रयोग
ZSL कई क्षेत्रों में उपयोगी है। आइए कुछ उदाहरण देखें।
टेक्स्ट और भाषा संसाधन
ZSL का व्यापक उपयोग टेक्स्ट वर्गीकरण में होता है, जिससे मॉडल बिना पूर्व प्रशिक्षण के नए लेबल्स में टेक्स्ट को वर्गीकृत कर सकते हैं।
उदाहरण के लिए, यह ईमेल्स को श्रेणियों के विवरण के आधार पर स्पैम या नॉन-स्पैम के रूप में छाँट सकता है, बिना लेबल किए उदाहरणों की ज़रूरत के। यह क्षमता चैटबॉट्स के लिए भी फ़ायदेमंद है, क्योंकि इससे वे हर संभावित क्वेरी पर प्रशिक्षित हुए बिना उपयोगकर्ता अनुरोधों को समझ पाते हैं।
सेंटिमेंट एनालिसिस में, ZSL केवल लेबल के अर्थों की व्याख्या करके तय कर सकता है कि कोई समीक्षा सकारात्मक है या नकारात्मक। यह सोशल मीडिया मॉडरेशन में भी भूमिका निभाता है, जहाँ यह टेक्स्ट विवरणों के आधार पर हानिकारक या भ्रामक सामग्री की पहचान करता है—जैसे “झूठे चिकित्सकीय दावे फैलाना” लेबल की गई गलत सूचना का पता लगाना—भले ही मॉडल ने ऐसी मिसालें पहले न देखी हों।
इमेज और दृश्य पहचान
इमेज क्लासिफिकेशन में, ZSL छवियों को टेक्स्ट विवरणों से जोड़कर ऐसे ऑब्जेक्ट्स को पहचानने देता है जिन्हें मॉडल ने पहले कभी न देखा हो। CLIP जैसे टूल्स “रेड पांडा” जैसे अपरिचित ऑब्जेक्ट्स की पहचान कर सकते हैं और इमेजेज़ को टेक्स्ट के साथ संरेखित कर सकते हैं, जिससे विज़ुअल सर्च इंजन उपयोगकर्ता के विवरणों के आधार पर इमेज प्राप्त करने में अधिक प्रभावी बनते हैं।
ZSL पर्यावरणीय मॉनिटरिंग में भी मूल्यवान है, जहाँ यह बिना लेबल किए प्रशिक्षण डेटा के सैटेलाइट इमेजरी में होने वाले परिवर्तनों का पता लगाता है। उदाहरण के लिए, यह “वन क्षेत्रों में महत्वपूर्ण कैनोपी लॉस” जैसा वर्णित क्षेत्रों को पहचानकर अवैध कटाई की पहचान कर सकता है—भले ही मॉडल को वनों की कटाई के पैटर्न पर स्पष्ट रूप से प्रशिक्षित न किया गया हो।
रिटेल और सिफारिशें
रिटेल में, ZSL केवल पाठ्य विवरणों के आधार पर नए उत्पादों को इन्वेंट्री कैटेगरी में वर्गीकृत करने में मदद करता है। कोई मॉडल स्वतः नए आइटम्स को “पर्यावरण-अनुकूल सामग्री” जैसे लेबल्स दे सकता है—चाहे वह श्रेणी प्रशिक्षण के दौरान शामिल न रही हो।
यह रिकमेन्डेशन सिस्टम्स में कोल्ड-स्टार्ट समस्या भी हल करता है, जहाँ बिना पूर्व उपयोगकर्ता डेटा के उत्पादों या कंटेंट की सिफारिश करनी होती है। ZESRec जैसे एल्गोरिदम ऐसे डेटासेट से भी आइटम सुझा सकते हैं जिसका पहले देखे गए डेटा से कोई ओवरलैप न हो।
ज़ीरो-शॉट लर्निंग की चुनौतियाँ
हालाँकि ZSL लचीली है और नए कार्यों तक सामान्यीकरण कर सकती है, फिर भी इसे कई चुनौतियों का सामना करना पड़ता है।
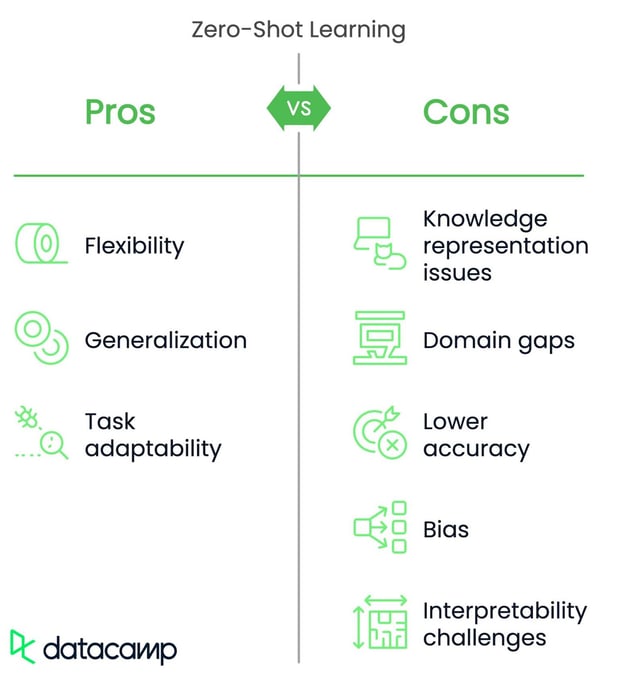
ज्ञान का प्रतिरूपण
ZSL मॉडल्स में सूक्ष्म या बारीक अंतरों को दर्शाने की सीमाएँ हो सकती हैं। उदाहरण के लिए, कोई मॉडल तेंदुए और चीते में भ्रमित हो सकता है क्योंकि दोनों का विवरण "धब्बों वाले बड़े बिल्ली प्रजाति के जानवर" जैसा हो सकता है, और विवरण उन सूक्ष्म अंतरों को नहीं पकड़ पाते।
डोमेन गैप्स
जब नया कार्य या डेटा उस सामग्री से बहुत अलग हो जिस पर मॉडल प्रशिक्षित हुआ है, तो ZSL मॉडल विफल हो सकते हैं। उदाहरण के लिए, घरेलू वस्तुएँ पहचानने के लिए प्रशिक्षित मॉडल चिकित्सकीय औज़ारों की पहचान करने में असफल हो सकता है क्योंकि वे बहुत अलग हैं।
प्रदर्शन
विशिष्ट कार्यों के लिए ZSL अक्सर सुपरवाइज़्ड लर्निंग (जहाँ मॉडल लेबल किए डेटा पर प्रशिक्षित होता है) से कम सटीक होती है। इस चुनौती का एक समाधान यह है कि ZSL को विशिष्ट डेटा पर थोड़े फाइन-ट्यूनिंग के साथ जोड़ा जाए—जिससे लचीलेपन को बनाए रखते हुए सटीकता में सुधार हो।
पक्षपात
ZSL प्री-ट्रेन डेटा पर निर्भर करता है, जिसमें पक्षपात हो सकता है। इससे अक्सर अनुचित प्रेडिक्शन्स हो सकते हैं। कल्पना कीजिए कि कोई हायरिंग मॉडल ZSL का उपयोग कर रहा है—अगर प्री-ट्रेन डेटा में जेंडर या नस्लीय पक्षपात है, तो वह कुछ जनसांख्यिकीय समूहों का पक्ष ले सकता है। एक शमन रणनीति यह है कि पहले से डेटा में मौजूद पक्षपात का पता लगाकर उन्हें कम किया जाए, या मॉडल को अधिक निष्पक्ष बनाने के लिए एडवर्सेरियल डीबायसिंग जैसी विधियाँ अपनाई जाएँ।
व्याख्येयता
यह समझना कठिन हो सकता है कि ZSL मॉडल निर्णय कैसे लेता है—खासकर जब वह जटिल तर्क का उपयोग करता है। उदाहरण के लिए, किसी दुर्लभ रोग के निदान में, बिना प्रशिक्षण डेटा के उदाहरणों के, यह स्पष्ट नहीं हो सकता कि मॉडल ने वह निदान क्यों चुना।
स्केलेबिलिटी
जैसे-जैसे नए कार्यों या श्रेणियों की संख्या बढ़ती है, ZSL मॉडल धीमे और अक्षम हो सकते हैं। ZSL-आधारित रिकमेन्डेशन सिस्टम अलग-अलग श्रेणियों में लाखों नए उत्पादों को संभालने में संघर्ष कर सकता है। डेटा को व्यवस्थित और पुनर्प्राप्त करने के बेहतर तरीकों—जैसे कुशल इंडेक्सिंग या समान कार्यों को समूहित करना—का उपयोग कुछ मामलों में इस समस्या का समाधान कर सकता है।
निष्कर्ष
ज़ीरो-शॉट लर्निंग बड़े, लेबल किए गए डेटासेट्स की ज़रूरत से बचाती है, समय और धन की बचत करती है, और कई क्षेत्रों में अच्छी तरह काम करती है—जैसे टेक्स्ट की छँटाई, इमेज पहचान, स्वास्थ्य समस्याओं का निदान, और व्यक्तिगत सिफारिशें देना।
हालाँकि ZSL पूर्ण नहीं है—यह कभी-कभी जटिल विचारों या सटीकता के साथ संघर्ष करती है—लेकिन जब लचीलापन अहम हो और डेटा महँगा या अल्प हो, तब यह बेहतरीन विकल्प है।

एना रोजो एचेबुरúa एप्लाइड मैथमेटिक्स में पीएचडी के साथ एआई और डेटा विशेषज्ञ हैं। वह डेटा को उपयोगी अंतर्दृष्टि में बदलना पसंद करती हैं और तकनीकी टीमों का नेतृत्व करने का व्यापक अनुभव रखती हैं। एना क्लाइंट्स के साथ निकटता से काम करके उनके व्यावसायिक समस्याओं को हल करने और नवीन एआई समाधान बनाने का आनंद लेती हैं। समस्या-समाधान कौशल और स्पष्ट संचार के लिए जानी जाने वाली, वह एआई—विशेषकर जेनरेटिव एआई—के प्रति उत्साही हैं। एना निरंतर सीखने और नैतिक एआई विकास के लिए समर्पित हैं, साथ ही जटिल समस्याओं को सरल बनाने और तकनीक को सहज तरीके से समझाने पर भी ध्यान देती हैं।
क्या हो अगर कोई AI मॉडल बिना हज़ारों लेबल किए गए उदाहरणों के भी सफलतापूर्वक काम कर सके?
ज़ीरो-शॉट लर्निंग (ZSL) एक तकनीक है जो मॉडलों को ऐसा करने देती है—ताकि वे प्रशिक्षण के दौरान किसी भी लेबल किए गए उदाहरण के बिना नए कॉन्सेप्ट्स की पहचान और वर्गीकरण कर सकें और उन कार्यों को संभाल सकें जिनके लिए उन्हें विशेष रूप से प्रशिक्षित नहीं किया गया था।
यह बेहतरीन है क्योंकि इससे AI सिस्टम्स को नए कार्य, उत्पाद, या बाज़ार अपनाने के लिए लगातार रीट्रेनिंग की ज़रूरत नहीं पड़ती। यह डेटा संग्रह और एनोटेशन लागत को घटाता है और मॉडल की उस क्षमता को बेहतर बनाता है जिसमें वह सीखी हुई बातों को अनदेखी परिस्थितियों में भी लागू कर सके।
इस लेख में, मैं समझाऊँगा कि ZSL कैसे काम करती है, इसे किन चुनौतियों का सामना करना पड़ता है, इसके प्रमुख अनुप्रयोग क्या हैं, साथ ही कुछ उदाहरण भी दूँगा। आइए शुरू करें!