Leerpad
Data-engineer in Python
40 uur
Oefen en volg je voortgang.
Ga Verder Met GoogleWelkom in de wereld van ETL-pijplijnen met Apache Airflow. In deze tutorial focussen we op het ophalen van beursdata via de Polygon API, het transformeren van deze data en het vervolgens laden in een SQLite-database voor eenvoudige toegang en bewerking. Laten we beginnen!
Apache Airflow geldt als een industriestandaard voor data-orkestratie en het beheren van pijplijnen. Het is populair onder data scientists, machine learning engineers en AI-ontwikkelaars vanwege het vermogen om complexe workflows te orkestreren, afhankelijkheden tussen taken te beheren, mislukte taken te herproberen en uitgebreide logging te bieden.
Airflow ETL verwijst naar het gebruik van Apache Airflow om ETL-processen te beheren. Ter herinnering: ETL is een type dataintegratie waarbij data uit verschillende bronnen wordt geëxtraheerd, getransformeerd naar een formaat dat geschikt is voor analyse, en geladen naar een eindbestemming zoals een datawarehouse.
We moeten eerst onze ontwikkelomgeving inrichten voordat we een ETL-pijplijn met Airflow kunnen bouwen. Voor uitgebreide informatie over het configureren van de ontwikkelomgeving, bekijk onze tutorial Aan de slag met Apache Airflow.
We moeten ook de Astro CLI installeren. Bekijk Astronomer, de beheerder van de Astro CLI, voor instructies en gedetailleerde documentatie.
Na het configureren van onze omgeving en het installeren van de Astro CLI maken we een Airflow-project. Dit doen we door een terminal te openen en een nieuwe map aan te maken op het gekozen pad.
~/Documents/data-engineering/ETL-pipeline/ Vanaf de root van deze map voeren we de volgende opdracht uit om de vereiste resources te creëren:
astro dev initDe inhoud van de map ziet er ongeveer zo uit. De exacte output kan variëren.
├── dags/
├── include/
├── plugins/
├── tests/
├── airflow_settings.yaml
├── Dockerfile
├── packages.txt
└── requirements.txt
Om je project te starten, voer je de volgende opdracht uit:
astro dev startHet opstarten van je Airflow-omgeving duurt ongeveer een minuut. Ga daarna in je browser naar localhost: 8080, waar je wordt begroet door de Airflow-UI.
Je bent nu klaar om je eigen ETL-pijplijn met Airflow te ontwikkelen!
Het is belangrijk om de tijd te nemen en elk onderdeel van je pijplijn te plannen voordat je ook maar één regel code schrijft. Het is vooral een goede gewoonte om eerst je databron te identificeren en de bestemming waar je data naartoe wordt geladen. Door hier even bij stil te staan, leer je ook hoe de data onderweg getransformeerd zal worden.
Voor ons voorbeeld ontwerpen we een datapijplijn die beursdata ophaalt via de Polygon API, deze data transformeert en vervolgens laadt in een SQLite-database. In dit geval is het bronsysteem de Polygon API, en de bestemming is een SQLite-database. Laten we dit illustreren met een afbeelding:
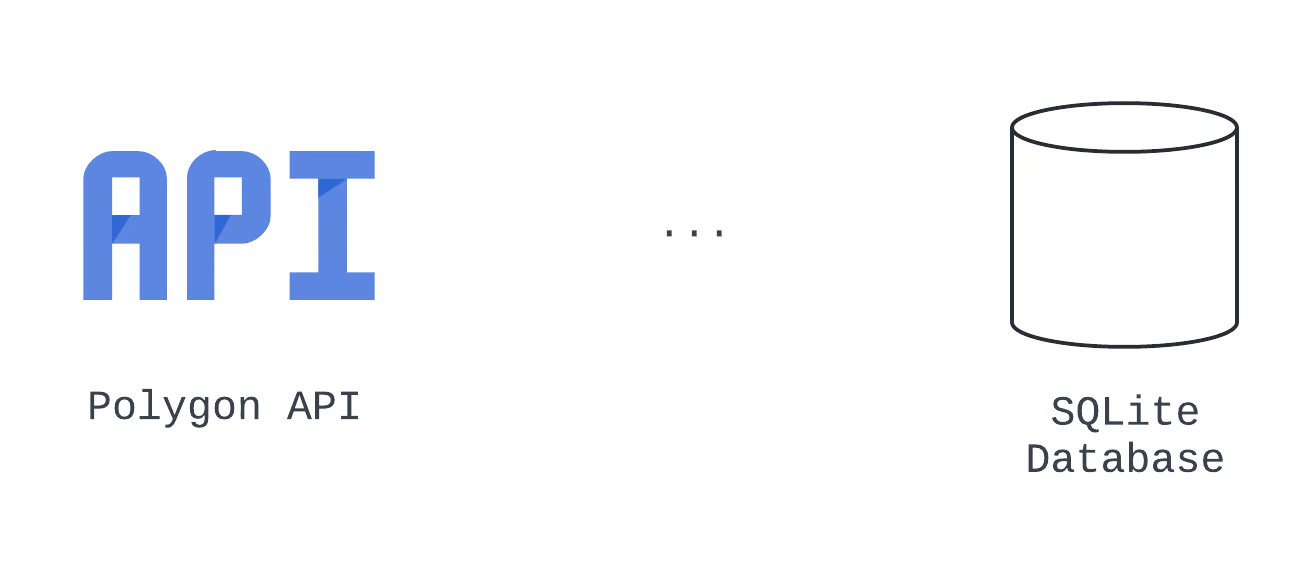 Bron- en bestemmingsdiagram
Uit onze ervaring als data engineers weten we dat data, om te kunnen worden geladen in een SQLite-database, getransformeerd moet worden van JSON naar een tabelvorm. We maken een plan om onze data te transformeren nadat deze is opgehaald via de Polygon API, met native Python en de pandas-bibliotheek. Laten we onze visual bijwerken om deze wijziging te tonen:
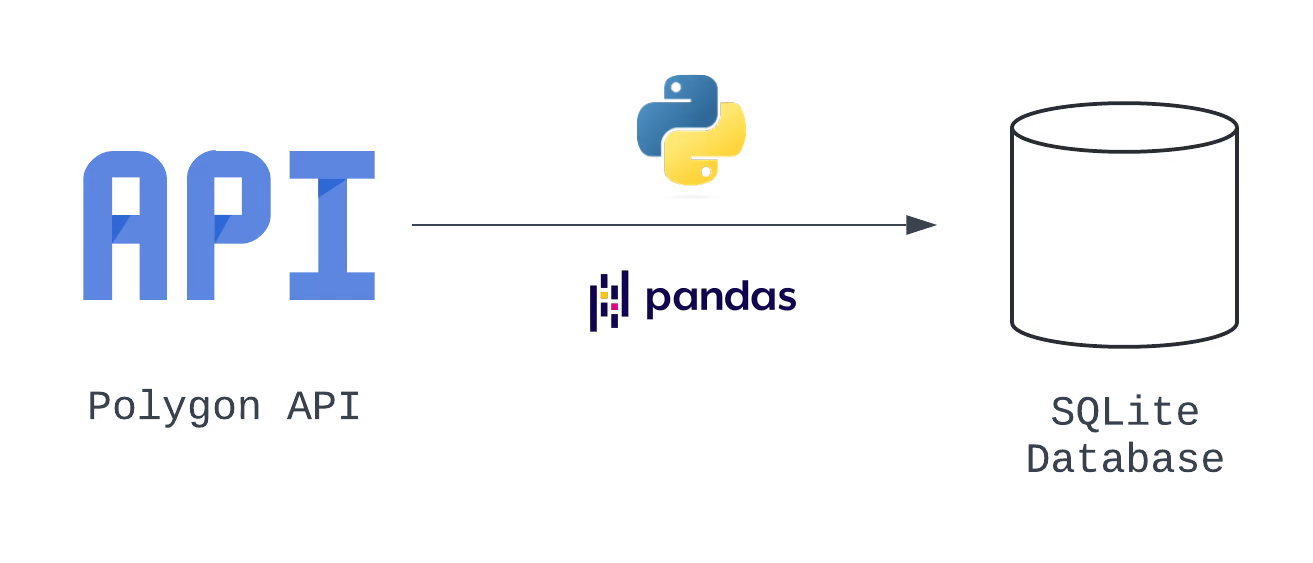 Architectuurdiagram
Door deze extra info toe te voegen, hebben we een architectuurdiagram gemaakt: een brede visuele weergave van ons systeem. We zien de drie logische stappen in deze pijplijn, die overeenkomen met de E, T en L van ons proces.
We kunnen elk van deze taken ook vertalen naar een directed acyclic graph, of DAG: een specifieke configuratie die de volledige set uit te voeren taken in Airflow definieert, de volgorde en de onderlinge afhankelijkheden. Leer meer over directed acyclic graphs in onze Introduction to Data Engineering-cursus, waarin Airflow-DAGs uitgebreid worden behandeld.
In een enterprise-omgeving gebruiken veel teams andere soorten documenten, technische specificaties of tech specs, om ontwerpskeuzes vast te leggen en op af te stemmen. Voor ons is het voldoende om een tabel te maken waarin we de ontwerpkeuzes voor onze datapijplijn documenteren.
|
Operatortype |
Task ID |
Notities |
|---|---|---|
|
Extract |
hit_polygon_api |
Gebruik de TaskFlow API en bouw een Python-functie om te authenticeren en de Polygon API aan te roepen, en retourneer vervolgens de response |
|
Transform |
flatten_market_data |
Maak de data uit de taak hit_polygon_api plat en bereid deze voor om in SQLite te laden |
|
Load |
load_market_data |
Laad de platte data in SQLite |
Keuzes voor de datapijplijn
Houd er rekening mee dat onze DAG zich richt op taakspecifieke details en mogelijk niet alle informatie bevat. We kunnen een tweede tabel gebruiken om aanvullende details vast te leggen. Onze vragen zijn onder meer:
|
Parameter |
Waarde |
|---|---|
|
DAG ID |
market_etl |
|
Startdatum |
1 januari 2024 (9:00 AM UTC) |
|
Interval |
Dagelijks |
|
Inhalen (catchup)? |
True (alle data laden sinds 1 januari 2024) |
|
Gelijktijdigheid |
1 DAG tegelijk actief |
|
Taak-hertries, retry-wachttijd |
3 hertries, 5 minuten wachttijd per retry |
|
Meerdere tickers? |
Dynamisch gegenereerde DAGs |
Vragen om uit te werken
Laten we kort samenvatten wat we hebben gedaan: we hebben een architectuurdiagram gemaakt, vastgelegd hoe de pijplijn kan worden opgedeeld in Airflow-taken en de high-level informatie geïdentificeerd die nodig is om de DAG te configureren.
Wil je meer leren over het ontwerpen, ontwikkelen en testen van datapijplijnen? Bekijk dan DataCamps Introduction to Data Pipelines. Hier leer je de basis van het bouwen van ETL-pijplijnen met Python, plus best practices om je oplossing robuust, veerkrachtig en herbruikbaar te maken.
We pakken de bouw van onze ETL-pijplijn gestructureerd aan door de stappen in volgorde te doorlopen. Zo zorg je dat elke fase nauwkeurig wordt uitgevoerd.
Voordat we data ophalen via de Polygon API, moeten we een API-token aanmaken via Polygon door op de knop Create API Key te klikken. Let op: voor deze tutorial hoef je geen betaald abonnement te nemen — met de gratis laag krijg je een API-sleutel en alle functionaliteit die we nodig hebben. Vergeet niet je API-sleutel te kopiëren en op te slaan.
Nadat we een API-sleutel hebben aangemaakt, kunnen we beginnen met het extraheren van data uit de Polygon API met Airflow. We gebruiken de tech-specstabel die we hebben gemaakt, met de details voor onze DAG-configuratie, als leidraad voor het coderen.
from airflow import DAG
from datetime import datetime, timedelta

with DAG(
    dag_id="market_etl",
    start_date=datetime(2024, 1, 1, 9),
    schedule="@daily",
    catchup=True,
    max_active_runs=1,
    default_args={
        "retries": 3,
        "retry_delay": timedelta(minutes=5)
    }
) as dag:
Laten we onze eerste taak toevoegen. We gebruiken de TaskFlow API en de requests-module om open-close-beursdata op te halen via de Polygon API.
import requests
...
@task()

def hit_polygon_api(**context):
    # Instantiate a list of tickers that will be pulled and looped over
    stock_ticker = "AMZN"
    # Set variables
    polygon_api_key= "<your-api-key>"
  ds = context.get("ds")

  # Create the URL
    url= f"<https://api.polygon.io/v1/open-close/{stock_ticker}/{ds}?adjusted=true&apiKey={polygon_api_key}>"
    response = requests.get(url)
    # Return the raw data
    return response.json()
Er vallen een paar dingen op aan deze code.
hit_polygon_api is gedecoreerd met @task. Deze decorator zet de functie om in een Airflow-taak die als onderdeel van een DAG kan worden uitgevoerd.context is gedefinieerd in de signatuur van hit_polygon_api. Deze wordt later gebruikt om de waarde op te halen die is opgeslagen onder de sleutel ds.context is een dictionary met metadata over de taak en de DAG.ds uit de context-dictionary halen, krijgen we de datum van het data_interaval_end in de notatie YYYY-mm-dd. hit_polygon_api aanroepen.Alles bij elkaar ziet de code voor het eerste deel van onze ETL-pijplijn er zo uit.
from airflow import DAG
from airflow.decorators import task
from datetime import datetime, timedelta import requests

with DAG(
    dag_id="market_etl",
    start_date=datetime(2024, 1, 1, 9),
    schedule="@daily",
    catchup=False,
    max_active_runs=1,
    default_args={
        "retries": 3,
        "retry_delay": timedelta(minutes=5)
    }
) as dag:
    # Create a task using the TaskFlow API
    @task()
    def hit_polygon_api(**context):
        # Instantiate a list of tickers that will be pulled and looped over
        stock_ticker = "AMZN"
        # Set variables
        polygon_api_key = "<your-api-key>"
        ds = context.get("ds")
        # Create the URL
        url = f"<https://api.polygon.io/v1/open-close/{stock_ticker}/{ds}?adjusted=true&apiKey={polygon_api_key}>"
        response = requests.get(url)
        # Return the raw data
        return response.json()
    hit_polygon_api()
Je zult merken dat de response een fout bevat wanneer dit wordt uitgevoerd voor 1 januari 2024. Omdat de markt die dag gesloten is, geeft Polygon een response die de uitzondering aangeeft. Dat pakken we in de volgende stap aan.
Nadat data is geëxtraheerd via de Polygon API, zijn we klaar om te transformeren.
We maken hiervoor een tweede taak met de TaskFlow API. Deze taak heet flatten_market_data en heeft de parameters polygon_response (de ruwe data die is geretourneerd door de functie hit_polygon_api) en **context. Zo meteen kijken we nader naar polygon_response.
De daadwerkelijke transformatie is vrij eenvoudig. We maken de JSON die door de Polygon API is geretourneerd plat naar een lijst. De crux is dat we unieke standaardwaarden per sleutel opgeven als die niet in de response voorkomt.
Als bijvoorbeeld de sleutel from niet voorkomt in de response, geven we een standaardwaarde op met behulp van Airflows context. Dit lost het probleem op dat we eerder zagen, waarbij een response een beperkt aantal sleutels bevatte (omdat de markt gesloten was). Vervolgens zetten we de lijst om naar een pandas DataFrame en retourneren die. De resulterende taak ziet er zo uit:
@task
def flatten_market_data(polygon_response, **context):
    # Create a list of headers and a list to store the normalized data in
    columns = {
        "status": "closed",
        "from": context.get("ds"),
        "symbol": "AMZN",
        "open": None,
        "high": None,
        "low": None,
        "close": None,
        "volume": None
    }
    # Create a list to append the data to
    flattened_record = []
    for header_name, default_value in columns.items():
        # Append the data
        flattened_record.append(polygon_response.get(header_name, default_value))
    # Convert to a pandas DataFrame
    flattened_dataframe = pd.DataFrame([flattened_record], columns=columns.keys())
    return flattened_dataframe
We moeten een afhankelijkheid toevoegen tussen de taken hit_polygon_api en flatten_market_data. Hiervoor werken we de code in onze DAG bij zoals hieronder:
import pandas as pd
with DAG(
    dag_id="market_etl",
    start_date=datetime(2024, 1, 1, 9),
    schedule="@daily",
    catchup=True,
    max_active_runs=1,
    default_args={
        "retries": 3,
        "retry_delay": timedelta(minutes=5)
    }
) as dag:
    @task()
    def hit_polygon_api(**context):
        ...
    @task
    def flatten_market_data(polygon_response, **context):
        # Create a list of headers and a list to store the normalized data in
        columns = {
            "status": None,
            "from": context.get("ds"),
            "symbol": "AMZN",
            "open": None,
            "high": None,
            "low": None,
            "close": None,
            "volume": None
        }
        # Create a list to append the data to
        flattened_record = []
        for header_name, default_value in columns.items():
            # Append the data
            flattened_record.append(polygon_response.get(header_name, default_value))
        # Convert to a pandas DataFrame
        flattened_dataframe = pd.DataFrame([flattened_record], columns=columns.keys())
        return flattened_dataframe
# Set dependencies
    raw_market_data = hit_polygon_api()
    flatten_market_data(raw_market_data)
Hier wordt de returnwaarde van de taak hit_polygon_api opgeslagen in raw_market_data. Vervolgens wordt raw_market_data doorgegeven als argument aan de taak flatten_market_data via de parameter polygon_response. Deze code legt niet alleen een afhankelijkheid vast tussen de taken hit_polygon_api en flatten_market_data, maar maakt ook datadeling tussen deze twee taken mogelijk.
Hoewel de transformatie hier relatief eenvoudig was, biedt Airflow de mogelijkheid om een breed scala aan complexere datamanipulaties uit te voeren. Naast native taken kun je eenvoudig gebruikmaken van Airflows uitgebreide collectie provider-hooks en operators om transformaties te orkestreren met tools zoals AWS Lambda en DBT.
We zijn bij de laatste stap van onze ETL-pijplijn. We doen dit met een SQLite-database en een laatste taak gedefinieerd met de TaskFlow API.
Net als eerder definiëren we één parameter wanneer we onze taak maken. We noemen deze flattened_dataframe. Zo kan de data die wordt geretourneerd door de taak flatten_market_data worden doorgegeven aan onze nieuwe taak.
Voordat we code schrijven om onze data naar een SQLite-database te laden, moeten we eerst een verbinding aanmaken in de Airflow-UI. Volg deze stappen om de pagina Connections te openen:
Je komt op een scherm dat er zo uitziet:
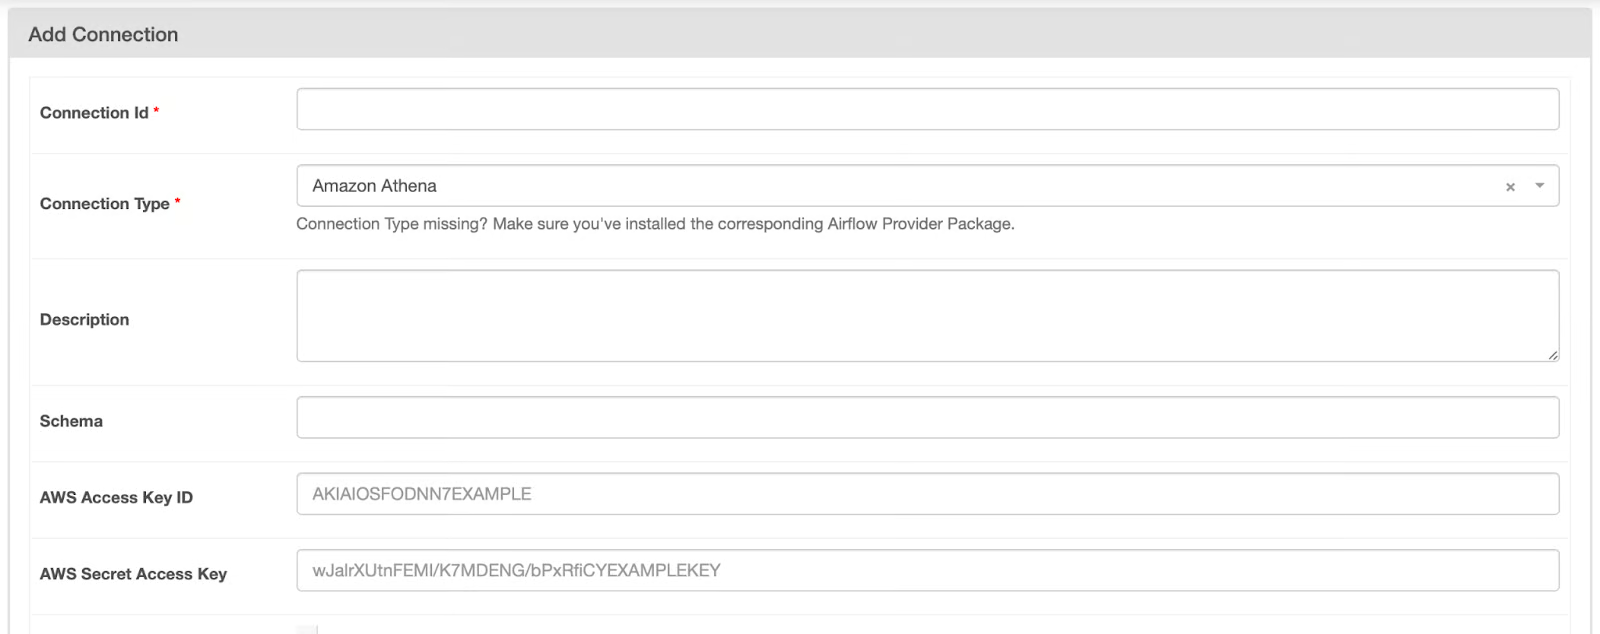 Airflow-pagina voor connections
Volg deze stappen om de pagina in te vullen:
De configuratie van deze verbinding moet eruitzien zoals in de afbeelding hieronder. Klik daarna op Save.
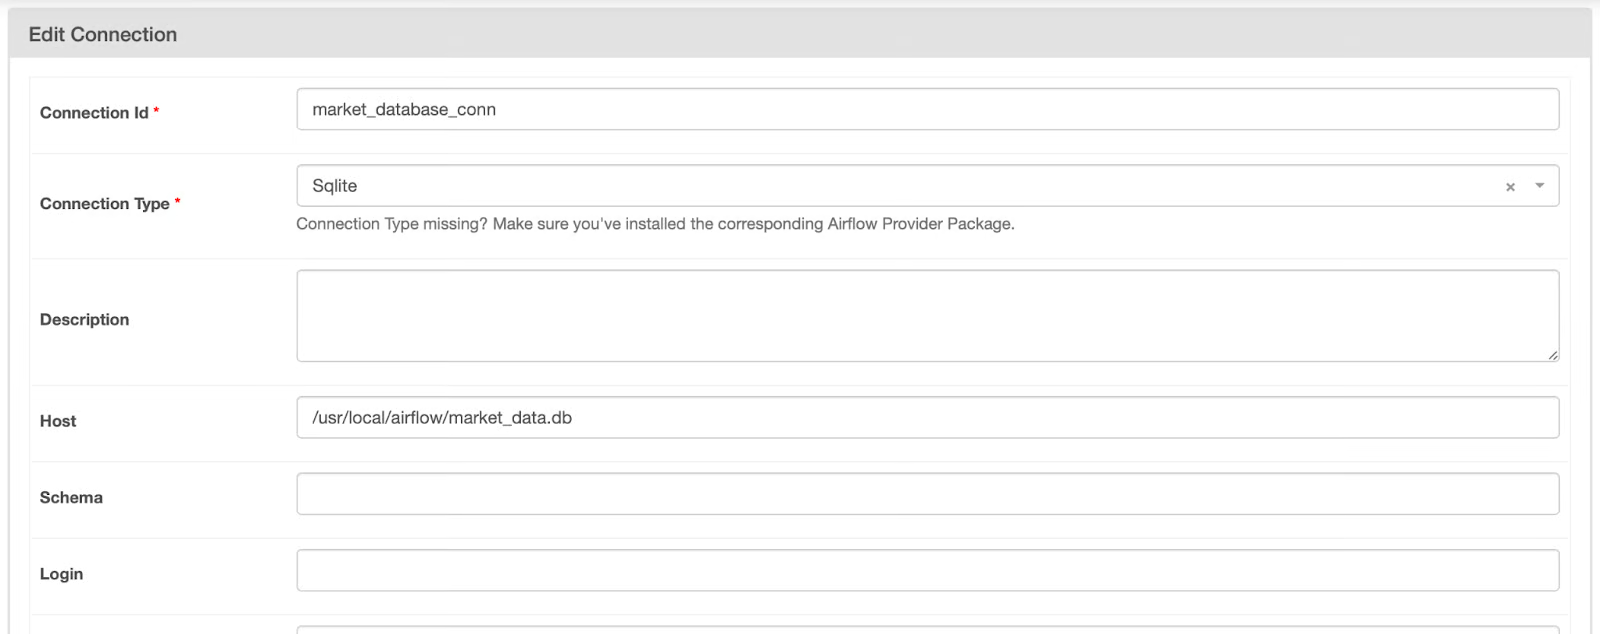 Niet-opgeslagen Airflow-verbinding met SQLite-database
Nu we een verbinding hebben aangemaakt, kunnen we deze informatie in onze taak ophalen met de SqliteHook. Bekijk de onderstaande code.
from airflow.providers.sqlite.hooks.sqlite import SqliteHook@task
def load_market_data(flattened_dataframe):
# Pull the connection
market_database_hook = SqliteHook("market_database_conn")
market_database_conn = market_database_hook.get_sqlalchemy_engine()
# Load the table to Postgres, replace if it exists
flattened_dataframe.to_sql(
name="market_data",
con=market_database_conn,
if_exists="append",
index=False
)
# print(market_database_hook.get_records("SELECT * FROM market_data;"))Met deze code maken we een verbinding met de SQLite-database die we in de vorige stap hebben opgegeven. Vervolgens wordt de connection engine opgehaald uit de hook met de methode .get_sqlalchemy_engine(). Deze wordt doorgegeven als argument aan de parameter con wanneer de methode .to_sql() wordt aangeroepen op het flattened_dataframe.
Let op dat de tabelnaam waarnaar wordt geschreven market_data is, en dat er wordt toegevoegd als de tabel al bestaat. Tijdens het testen controleer ik graag of er data wordt weggeschreven door deze records op te halen en te printen. Je kunt dit doen door de laatste regel van deze taak te decommentariëren.
Alles bij elkaar zou onze code er ongeveer zo uit moeten zien:
from airflow import DAG
from airflow.decorators import task
from airflow.providers.sqlite.hooks.sqlite import SqliteHook
from datetime import datetime, timedelta
import requests
import pandas as pd

with DAG(
    dag_id="market_etl",
    start_date=datetime(2024, 1, 1, 9),
    schedule="@daily",
    catchup=True,
    max_active_runs=1,
    default_args={
        "retries": 3,
        "retry_delay": timedelta(minutes=5)
    }
) as dag:
    # Create a task using the TaskFlow API
    @task()
    def hit_polygon_api(**context):
        # Instantiate a list of tickers that will be pulled and looped over
        stock_ticker = "AMZN"
        # Set variables
        polygon_api_key = "<your-api-key>"
        ds = context.get("ds")
        # Create the URL
        url = f"<https://api.polygon.io/v1/open-close/{stock_ticker}/{ds}?adjusted=true&apiKey={polygon_api_key}>"
        response = requests.get(url)
        # Return the raw data
        return response.json()
    @task
    def flatten_market_data(polygon_response, **context):
        # Create a list of headers and a list to store the normalized data in
        columns = {
            "status": None,
            "from": context.get("ds"),
            "symbol": "AMZN",
            "open": None,
            "high": None,
            "low": None,
            "close": None,
            "volume": None
        }
        # Create a list to append the data to
        flattened_record = []
        for header_name, default_value in columns.items():
            # Append the data
            flattened_record.append(polygon_response.get(header_name, default_value))
        # Convert to a pandas DataFrame
        flattened_dataframe = pd.DataFrame([flattened_record], columns=columns.keys())
        return flattened_dataframe
    @task
    def load_market_data(flattened_dataframe):
        # Pull the connection
        market_database_hook = SqliteHook("market_database_conn")
        market_database_conn = market_database_hook.get_sqlalchemy_engine()
        # Load the table to SQLite, append if it exists
        flattened_dataframe.to_sql(
            name="market_data",
            con=market_database_conn,
            if_exists="append",
            index=False
        )
    # Set dependencies between tasks
    raw_market_data = hit_polygon_api()
    transformed_market_data = flatten_market_data(raw_market_data)
    load_market_data(transformed_market_data)
Opnieuw hebben we de afhankelijkheden bijgewerkt zodat de data die wordt geretourneerd door de taak flatten_market_data kan worden doorgegeven aan de taak load_market_data. De resulterende grafiekweergave van onze DAG ziet er ongeveer zo uit:
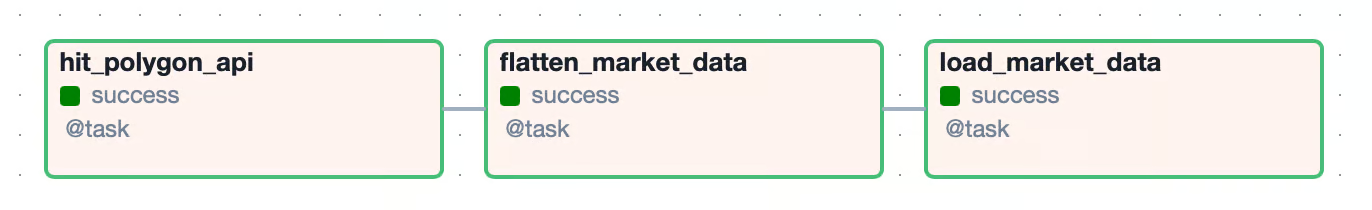 Grafiekweergave van ETL-pijplijn
Nu je je eerste Airflow-DAG hebt gebouwd, is het tijd om te controleren of deze werkt. Er zijn verschillende manieren om dit te doen, maar een veelgebruikte is de DAG end-to-end uitvoeren.
Om dit in de Airflow-UI te doen, navigeer je naar je DAG en zet je de schakelaar van blauw naar actief. Omdat catchup is ingesteld op True, zou een DAG-run in de wachtrij moeten komen en starten. Als een taak succesvol wordt uitgevoerd, kleurt het betreffende vakje in de UI groen. Als alle taken in de DAG slagen, wordt de DAG gemarkeerd als success en wordt de volgende DAG-run getriggerd.
Als een taak faalt, is de status up for retry en kleurt deze geel. In dat geval bekijk je het best de logs voor die taak. Dit doe je door in de gridweergave op het gele vakje te klikken en Logs te selecteren. Hier vind je het exceptiebericht en kun je beginnen met triage. Als een taak vaker faalt dan het gespecificeerde aantal hertries, wordt de status van die taak en van de DAG ingesteld op failed.
Naast end-to-end testen maakt Airflow het eenvoudig om unittests te schrijven. Wanneer je je omgeving initieel opzet met astro dev start, wordt er een map tests/ voor je aangemaakt. Hier kun je unittests toevoegen voor zowel je DAG als de componenten ervan.
Hieronder staat een unittest voor de configuratie van onze DAG. Deze test valideert een aantal parameters die bij de definitie zijn ingesteld, zoals start_date, schedule en catchup. Nadat je je test hebt geschreven, ga je naar de root van je project en voer je uit:
from airflow.models.dagbag import DagBag
from datetime import datetime
import pytz

def test_market_etl_config():
    # Pull the DAG
    market_etl_dag = DagBag().get_dag("market_etl")
    # Assert start date, schedule, and catchup
    assert market_etl_dag.start_date == datetime(2024, 3, 25, 9, tzinfo=pytz.UTC)
    assert market_etl_dag.schedule_interval == "@daily"
    assert market_etl_dag.catchup
astro dev pytestDeze opdracht voert alle unittests in je map tests/ uit. Als je slechts één test wilt uitvoeren, kun je het pad naar het bestand als argument meegeven. Naast het gebruiken van de Astro CLI voor het uitvoeren van tests, kun je elke Python-testrunner gebruiken om unittests te schrijven en uit te voeren.
Voor persoonlijke projecten helpen unittests je om te borgen dat je code doet wat je verwacht. In een enterprise-omgeving zijn unittests bijna altijd verplicht. De meeste datateams gebruiken een of andere CI/CD-tool om hun Airflow-project te deployen. Dit proces omvat doorgaans het draaien van unittests en het valideren van de output om te zorgen dat de door jou geschreven DAG productie klaar is. Voor meer informatie over unittests, bekijk onze tutorial How to Use Pytest for Unit Testing en de cursus Introduction to Testing in Python.
We hebben een eenvoudige datapijplijn gebouwd die werkt, en we hebben zelfs transformatie- en persistentietechnieken gebruikt. In andere gevallen kan Airflow complexe workflows orkestreren met provider-build en custom operators, en terabytes aan data verwerken.
Voorbeelden hiervan zijn de S3ToSnowflakeOperator en de DatabricksRunNowOperator, die beide eenvoudig integratie met een grotere datastack mogelijk maken. Werken met dit soort operators is lastig in een hobbycontext. Om de S3ToSnowflakeOperator te gebruiken, heb je bijvoorbeeld zowel AWS- als Snowflake-accounts en configuraties nodig voor de resources waar je data tussen overdraagt.
Naast ETL-workflows ondersteunt Airflow ook ELT-workflows, die steeds vaker de industriestandaard zijn voor teams die cloud datawarehouses gebruiken. Houd dit in gedachten bij het ontwerpen van datapijplijnen.
In het onderdeel load van onze pijplijn maakten we een verbinding met een SQLite-database, die later werd opgehaald en gebruikt om data op te slaan. Verbindingen, soms Secrets genoemd, zijn een functie in Airflow die interacties met bron- en doelsystemen vereenvoudigt. Door deze connections te gebruiken om gevoelige informatie, zoals je Polygon API-sleutel, op te slaan, verhoog je de veiligheid van je code. Zo kun je ook inloggegevens los van je codebase beheren. Gebruik waar mogelijk Connections om je workflow veilig en georganiseerd te houden.
Je hebt misschien gemerkt dat de "AMZN"-ticker hardcoded stond in onze taken hit_polygon_api en flatten_market_data. Daardoor konden we data voor deze ene ticker extraheren, transformeren en laden. Maar wat als je dezelfde code voor meerdere tickers wilt gebruiken? Gelukkig is het eenvoudig om DAGs dynamisch te genereren. Met minimale refactoring in onze code kunnen we over een lijst met tickers loopen en de tickers parametriseren. Dit helpt om je DAGs modulair en draagbaar te maken. Voor informatie over het dynamisch genereren van DAGs, bekijk de documentatie van Astronomer: Dynamically Generate DAGs in Airflow.
Gefeliciteerd! Je hebt een Airflow-DAG gebouwd om beursdata van de Polygon API te extraheren, transformeren en laden met Python, pandas en SQLite. Onderweg heb je je vaardigheden aangescherpt in het maken van architectuurdiagrammen en tech specs, het opzetten van Airflow-connections en het testen van je DAGs. Gaandeweg je Airflow-reis kun je experimenteren met meer geavanceerde technieken om je pijplijnen robuust, veerkrachtig en herbruikbaar te maken.
Bekijk deze extra resources om meer te leren:
Leer Data Engineering met Datacamp
Leerpad
Cursus
Oefen en volg je voortgang.
Ga Verder Met Googleblog
Adel Nehme
15 min

