Cursus
Ingénieur de données en Python
40 h
Bienvenue dans le monde des pipelines ETL avec Apache Airflow. Dans ce tutoriel, nous allons récupérer des données boursières via l’API Polygon, transformer ces données, puis les charger dans une base SQLite pour un accès et une manipulation facilités. C’est parti !
Apache Airflow est considéré comme la référence du secteur pour l’orchestration de données et la gestion de pipelines. Il est plébiscité par les data scientists, ingénieurs en apprentissage automatique et praticiens de l’IA pour sa capacité à orchestrer des workflows complexes, gérer les dépendances entre tâches, relancer celles qui échouent et fournir des logs détaillés.
ETL avec Airflow désigne l’usage d’Apache Airflow pour piloter des processus ETL. Pour rappel, l’ETL est un type d’intégration de données qui consiste à extraire des données depuis différentes sources, les transformer dans un format adapté à l’analyse, puis les charger dans une destination finale telle qu’un entrepôt de données.
Avant de pouvoir créer un pipeline ETL avec Airflow, nous devons d’abord configurer notre environnement de développement. Pour des instructions détaillées, consultez notre tutoriel Premiers pas avec Apache Airflow.
Nous devrons aussi installer l’outil en ligne de commande Astro (Astro CLI). Rendez-vous chez Astronomer, qui maintient l’Astro CLI et propose une documentation détaillée, pour suivre les instructions.
Après avoir configuré l’environnement et installé l’Astro CLI, créons un projet Airflow. Ouvrez un terminal et créez un nouveau répertoire à l’emplacement de votre choix.
~/Documents/data-engineering/ETL-pipeline/ Depuis la racine de ce répertoire, exécutez la commande suivante pour générer les ressources nécessaires :
astro dev initLe contenu du répertoire ressemblera à ceci. La sortie exacte peut varier.
├── dags/
├── include/
├── plugins/
├── tests/
├── airflow_settings.yaml
├── Dockerfile
├── packages.txt
└── requirements.txt
Pour lancer votre projet, exécutez la commande suivante :
astro dev startVotre environnement Airflow mettra environ une minute à démarrer. Une fois prêt, allez sur localhost: 8080 dans votre navigateur : l’interface d’Airflow s’affichera.
Vous êtes désormais prêt à développer votre propre pipeline ETL avec Airflow !
Avant d’écrire la moindre ligne de code, prenez le temps de planifier chaque composant de votre pipeline. En particulier, commencez par identifier votre source de données et la destination vers laquelle elles seront chargées. En clarifiant la source et la destination, vous comprendrez mieux les transformations à appliquer en cours de route.
Dans notre exemple, nous allons concevoir un pipeline pour récupérer des données boursières depuis l’API Polygon, puis les transformer et les charger dans une base SQLite. Ici, la source est l’API Polygon et la destination, une base SQLite. Illustrons cela avec un schéma :
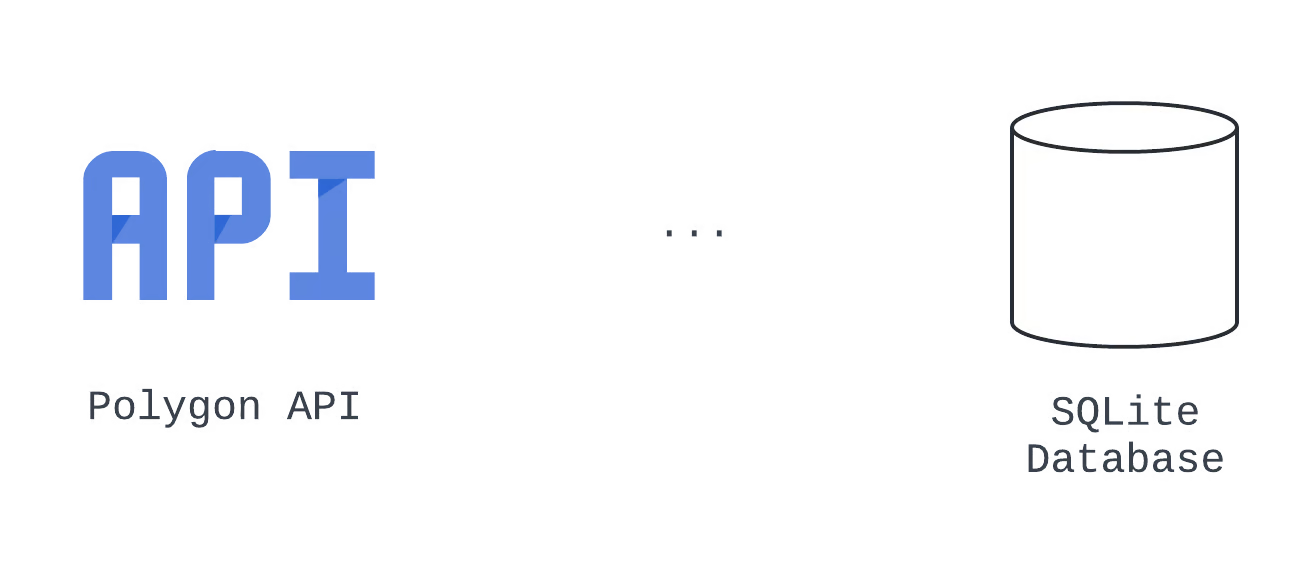 Schéma source et destination
D’expérience, en ingénierie des données, nous savons que pour charger des données dans SQLite, il faut passer du JSON à un format tabulaire. Nous prévoyons donc de transformer les données après leur extraction depuis l’API Polygon, à l’aide de Python natif et de la bibliothèque pandas. Mettons à jour notre visuel pour refléter cela :
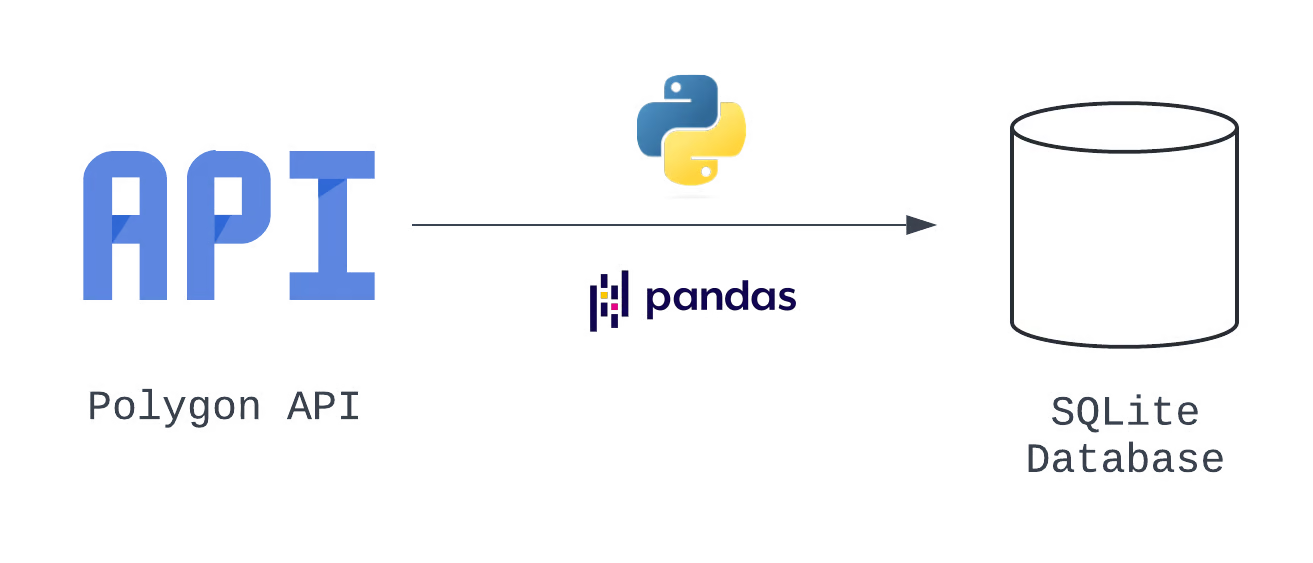 Schéma d’architecture
En ajoutant ces informations, nous avons créé un schéma d’architecture, une représentation globale de notre système. On y voit les trois étapes logiques du pipeline, qui correspondent au E, T et L de notre processus.
Nous pouvons aussi traduire chacune de ces étapes en graphe orienté acyclique (DAG), une configuration qui définit l’ensemble des tâches à exécuter par Airflow, leur ordre et leurs dépendances. Pour en savoir plus sur les graphes orientés acycliques, suivez notre cours Introduction to Data Engineering qui détaille les DAG Airflow.
En entreprise, de nombreuses équipes utilisent des documents appelés spécifications techniques (tech specs) pour documenter et valider les choix de conception. Dans notre cas, une table suffit pour consigner les décisions de conception de notre pipeline.
|
Type d’opérateur |
ID de tâche |
Notes |
|---|---|---|
|
Extract |
hit_polygon_api |
Utiliser la TaskFlow API et créer une fonction Python pour s’authentifier, interroger l’API Polygon et retourner la réponse |
|
Transform |
flatten_market_data |
Aplatir les données renvoyées par la tâche hit_polygon_api et les préparer pour un chargement dans SQLite |
|
Load |
load_market_data |
Charger les données aplaties dans SQLite |
Choix de conception du pipeline de données
Gardez à l’esprit que notre DAG se concentre sur les détails au niveau des tâches et ne couvre pas nécessairement tous les aspects. Nous pouvons utiliser une seconde table pour documenter des éléments complémentaires à préciser. Nos questions sont notamment :
|
Paramètre |
Valeur |
|---|---|
|
ID du DAG |
market_etl |
|
Date de début |
1er janvier 2024 (9:00 UTC) |
|
Intervalle |
Quotidien |
|
Rattrapage ? |
True (charger toutes les données depuis le 1er janvier 2024) |
|
Concurrence |
1 DAG exécuté à la fois |
|
Relances de tâches, délai |
3 relances, délai de 5 minutes entre chaque tentative |
|
Multiples tickers ? |
DAGs générés dynamiquement |
Questions à trancher
Récapitulons : nous avons créé un schéma d’architecture, détaillé la décomposition du pipeline en tâches Airflow et identifié les informations clés pour configurer le DAG.
Pour aller plus loin sur la conception, le développement et les tests de pipelines de données, consultez le cours de DataCamp Introduction to Data Pipelines. Vous y maîtriserez les bases de la création de pipelines ETL en Python ainsi que les bonnes pratiques pour rendre votre solution robuste, résiliente et réutilisable.
Nous allons structurer la construction de notre pipeline ETL en suivant les étapes dans l’ordre. Cette approche méthodique garantit une exécution précise à chaque phase.
Avant de récupérer des données depuis l’API Polygon, il faut créer un jeton d’API en se rendant sur Polygon et en cliquant sur le bouton Create API Key. Pour ce tutoriel, nul besoin d’un abonnement payant : l’offre gratuite fournit une clé API et toutes les fonctionnalités nécessaires. Pensez simplement à copier et conserver votre clé.
Une fois la clé API créée, nous pouvons commencer à extraire des données de l’API Polygon avec Airflow. Appuyons-nous sur notre tableau de spécifications techniques (tech specs), qui inclut les détails de configuration du DAG, pour coder.
from airflow import DAG
from datetime import datetime, timedelta

with DAG(
    dag_id="market_etl",
    start_date=datetime(2024, 1, 1, 9),
    schedule="@daily",
    catchup=True,
    max_active_runs=1,
    default_args={
        "retries": 3,
        "retry_delay": timedelta(minutes=5)
    }
) as dag:
Ajoutons notre première tâche. Nous allons utiliser la TaskFlow API et le module requests pour récupérer les cours d’ouverture/fermeture d’une action via l’API Polygon.
import requests
...
@task()

def hit_polygon_api(**context):
    # Instancier une liste de tickers à récupérer et à itérer
    stock_ticker = "AMZN"
    # Définir les variables
    polygon_api_key= "<your-api-key>"
  ds = context.get("ds")

  # Créer l’URL
    url= f"<https://api.polygon.io/v1/open-close/{stock_ticker}/{ds}?adjusted=true&apiKey={polygon_api_key}>"
    response = requests.get(url)
    # Retourner les données brutes
    return response.json()
Quelques points à noter concernant ce code :
hit_polygon_api est décorée avec @task. Ce décorateur transforme la fonction en tâche Airflow exécutable dans un DAG.context est défini dans la signature de hit_polygon_api. Il sert ensuite à extraire la valeur associée à la clé ds.context est un dictionnaire qui contient des métadonnées sur la tâche et le DAG.ds depuis context, on obtient la date de data_interaval_end au format YYYY-mm-dd. hit_polygon_api.En combinant tout cela, le code de la première partie de notre pipeline ETL ressemble à ceci.
from airflow import DAG
from airflow.decorators import task
from datetime import datetime, timedelta import requests

with DAG(
    dag_id="market_etl",
    start_date=datetime(2024, 1, 1, 9),
    schedule="@daily",
    catchup=False,
    max_active_runs=1,
    default_args={
        "retries": 3,
        "retry_delay": timedelta(minutes=5)
    }
) as dag:
    # Créer une tâche avec la TaskFlow API
    @task()
    def hit_polygon_api(**context):
        # Instancier une liste de tickers à récupérer et à itérer
        stock_ticker = "AMZN"
        # Définir les variables
        polygon_api_key = "<your-api-key>"
        ds = context.get("ds")
        # Créer l’URL
        url = f"<https://api.polygon.io/v1/open-close/{stock_ticker}/{ds}?adjusted=true&apiKey={polygon_api_key}>"
        response = requests.get(url)
        # Retourner les données brutes
        return response.json()
    hit_polygon_api()
Vous remarquerez qu’une erreur survient pour le 1er janvier 2024. Le marché étant fermé ce jour-là, Polygon renvoie une réponse signalant l’exception. Nous corrigerons cela à l’étape suivante.
Après l’extraction depuis l’API Polygon, nous sommes prêts à transformer les données.
Pour ce faire, créons une autre tâche avec la TaskFlow API. Elle s’appelle flatten_market_data et prend en paramètres polygon_response (les données brutes renvoyées par hit_polygon_api) et **context. Nous allons examiner polygon_response de plus près dans un instant.
La transformation est assez simple. Nous allons aplatir le JSON renvoyé par l’API Polygon en une liste. Particularité : nous fournirons des valeurs par défaut spécifiques pour chaque clé manquante dans la réponse.
Par exemple, si la clé from n’existe pas, nous utiliserons une valeur par défaut issue du contexte Airflow. Cela résout le problème observé précédemment, lorsque la réponse contenait un nombre limité de clés (marché fermé). Ensuite, nous convertirons la liste en DataFrame pandas et la retournerons. La tâche obtenue ressemble à ceci :
@task
def flatten_market_data(polygon_response, **context):
    # Créer une liste d’en-têtes et une structure pour stocker les données normalisées
    columns = {
        "status": "closed",
        "from": context.get("ds"),
        "symbol": "AMZN",
        "open": None,
        "high": None,
        "low": None,
        "close": None,
        "volume": None
    }
    # Créer une liste pour y ajouter les données
    flattened_record = []
    for header_name, default_value in columns.items():
        # Ajouter les données
        flattened_record.append(polygon_response.get(header_name, default_value))
    # Convertir en DataFrame pandas
    flattened_dataframe = pd.DataFrame([flattened_record], columns=columns.keys())
    return flattened_dataframe
Nous devons ajouter une dépendance entre les tâches hit_polygon_api et flatten_market_data. Pour cela, mettons à jour le code de notre DAG comme suit :
import pandas as pd
with DAG(
    dag_id="market_etl",
    start_date=datetime(2024, 1, 1, 9),
    schedule="@daily",
    catchup=True,
    max_active_runs=1,
    default_args={
        "retries": 3,
        "retry_delay": timedelta(minutes=5)
    }
) as dag:
    @task()
    def hit_polygon_api(**context):
        ...
    @task
    def flatten_market_data(polygon_response, **context):
        # Créer une liste d’en-têtes et une structure pour stocker les données normalisées
        columns = {
            "status": None,
            "from": context.get("ds"),
            "symbol": "AMZN",
            "open": None,
            "high": None,
            "low": None,
            "close": None,
            "volume": None
        }
        # Créer une liste pour y ajouter les données
        flattened_record = []
        for header_name, default_value in columns.items():
            # Ajouter les données
            flattened_record.append(polygon_response.get(header_name, default_value))
        # Convertir en DataFrame pandas
        flattened_dataframe = pd.DataFrame([flattened_record], columns=columns.keys())
        return flattened_dataframe
# Définir les dépendances
    raw_market_data = hit_polygon_api()
    flatten_market_data(raw_market_data)
Ici, la valeur retournée par la tâche hit_polygon_api est stockée dans raw_market_data. Puis raw_market_data est passée en argument à flatten_market_data via le paramètre polygon_response. Ce code définit non seulement la dépendance entre les deux tâches, mais permet aussi de partager des données entre elles.
Même si notre transformation est simple, Airflow permet d’orchestrer des manipulations bien plus avancées. Au-delà des tâches natives, vous pouvez tirer parti de la large collection de hooks et d’opérateurs fournis par des providers pour orchestrer des transformations avec des outils comme AWS Lambda ou DBT.
Nous arrivons à la dernière étape du pipeline ETL. Comme prévu, nous allons utiliser une base SQLite et une dernière tâche définie avec la TaskFlow API.
Comme auparavant, nous définirons un unique paramètre lors de la création de la tâche, nommé flattened_dataframe. Cela permettra de transmettre à notre nouvelle tâche les données renvoyées par flatten_market_data.
Avant d’écrire le code de chargement dans SQLite, nous devons créer une connexion dans l’interface Airflow. Pour ouvrir la page des connexions, suivez ces étapes :
Vous arriverez sur un écran similaire à ceci :
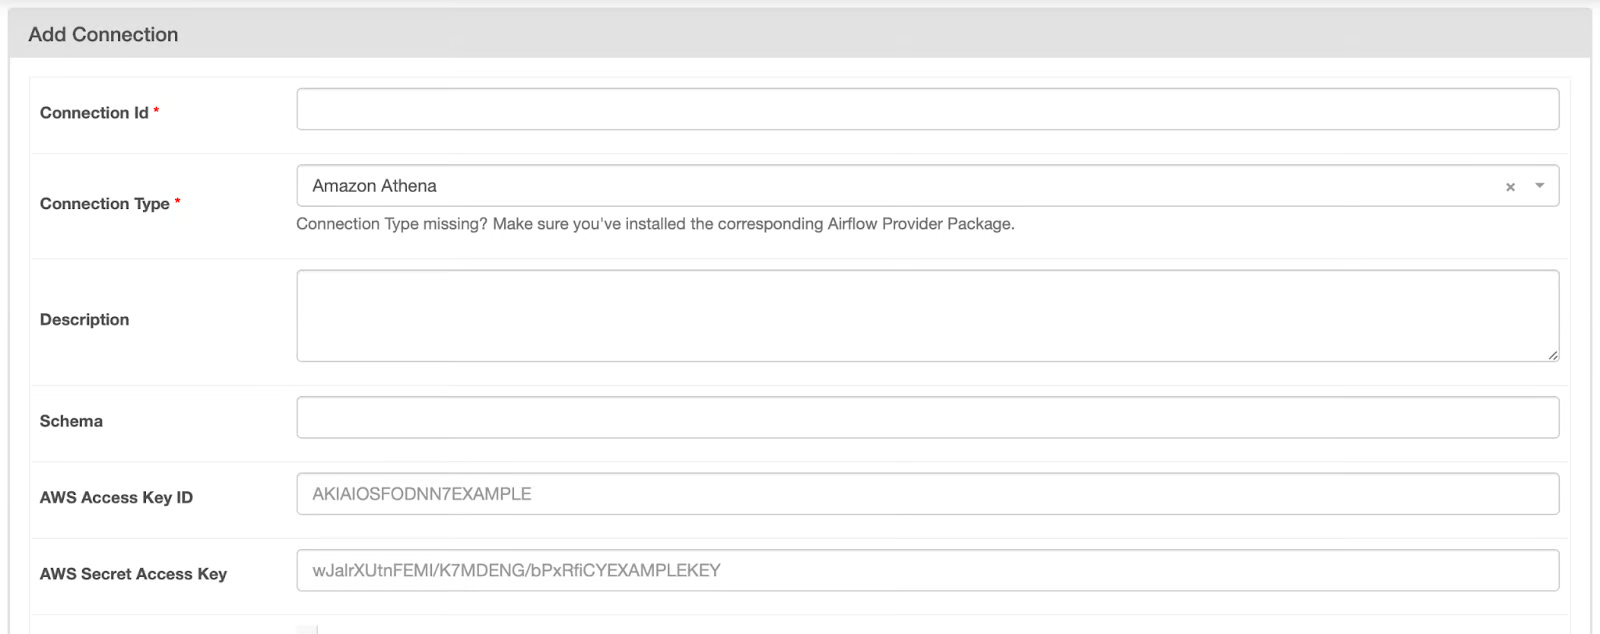 Page des connexions Airflow
Pour renseigner la page des connexions, procédez comme suit :
La configuration de cette connexion devrait ressembler à l’image ci-dessous. Une fois prêt, cliquez sur Save.
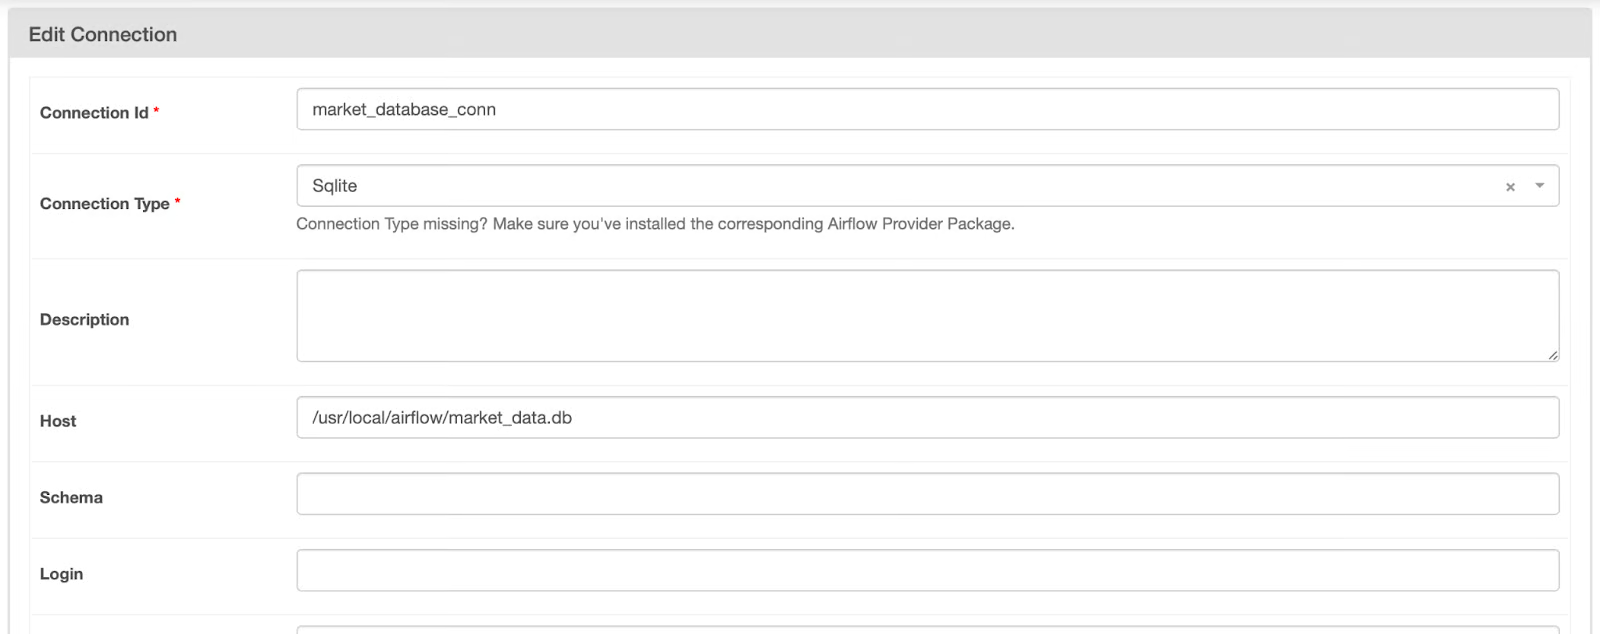 Connexion Airflow vers une base SQLite (avant enregistrement)
Maintenant que la connexion est créée, nous pouvons la récupérer dans notre tâche à l’aide de SqliteHook. Voyez ci-dessous.
from airflow.providers.sqlite.hooks.sqlite import SqliteHook@task
def load_market_data(flattened_dataframe):
# Récupérer la connexion
market_database_hook = SqliteHook("market_database_conn")
market_database_conn = market_database_hook.get_sqlalchemy_engine()
# Charger la table dans Postgres, remplacer si elle existe
flattened_dataframe.to_sql(
name="market_data",
con=market_database_conn,
if_exists="append",
index=False
)
# print(market_database_hook.get_records("SELECT * FROM market_data;"))Avec ce code, nous créons une connexion à la base SQLite définie à l’étape précédente. Ensuite, nous récupérons l’engine depuis le hook via .get_sqlalchemy_engine(). Il est passé au paramètre con lors de l’appel à .to_sql() sur le flattened_dataframe.
Notez que le nom de la table cible est market_data, et qu’en cas d’existence, les données sont ajoutées (append). En test, j’aime vérifier l’écriture en récupérant et affichant des enregistrements : il suffit de décommenter la dernière ligne de cette tâche.
En réunissant le tout, notre code devrait ressembler à ceci :
from airflow import DAG
from airflow.decorators import task
from airflow.providers.sqlite.hooks.sqlite import SqliteHook
from datetime import datetime, timedelta
import requests
import pandas as pd

with DAG(
    dag_id="market_etl",
    start_date=datetime(2024, 1, 1, 9),
    schedule="@daily",
    catchup=True,
    max_active_runs=1,
    default_args={
        "retries": 3,
        "retry_delay": timedelta(minutes=5)
    }
) as dag:
    # Créer une tâche avec la TaskFlow API
    @task()
    def hit_polygon_api(**context):
        # Instancier une liste de tickers à récupérer et à itérer
        stock_ticker = "AMZN"
        # Définir les variables
        polygon_api_key = "<your-api-key>"
        ds = context.get("ds")
        # Créer l’URL
        url = f"<https://api.polygon.io/v1/open-close/{stock_ticker}/{ds}?adjusted=true&apiKey={polygon_api_key}>"
        response = requests.get(url)
        # Retourner les données brutes
        return response.json()
    @task
    def flatten_market_data(polygon_response, **context):
        # Créer une liste d’en-têtes et une structure pour stocker les données normalisées
        columns = {
            "status": None,
            "from": context.get("ds"),
            "symbol": "AMZN",
            "open": None,
            "high": None,
            "low": None,
            "close": None,
            "volume": None
        }
        # Créer une liste pour y ajouter les données
        flattened_record = []
        for header_name, default_value in columns.items():
            # Ajouter les données
            flattened_record.append(polygon_response.get(header_name, default_value))
        # Convertir en DataFrame pandas
        flattened_dataframe = pd.DataFrame([flattened_record], columns=columns.keys())
        return flattened_dataframe
    @task
    def load_market_data(flattened_dataframe):
        # Récupérer la connexion
        market_database_hook = SqliteHook("market_database_conn")
        market_database_conn = market_database_hook.get_sqlalchemy_engine()
        # Charger la table dans SQLite, ajouter si elle existe
        flattened_dataframe.to_sql(
            name="market_data",
            con=market_database_conn,
            if_exists="append",
            index=False
        )
    # Définir les dépendances entre tâches
    raw_market_data = hit_polygon_api()
    transformed_market_data = flatten_market_data(raw_market_data)
    load_market_data(transformed_market_data)
Là encore, nous avons mis à jour les dépendances pour transmettre les données renvoyées par flatten_market_data à la tâche load_market_data. Le graphe résultant pour notre DAG ressemble à ceci :
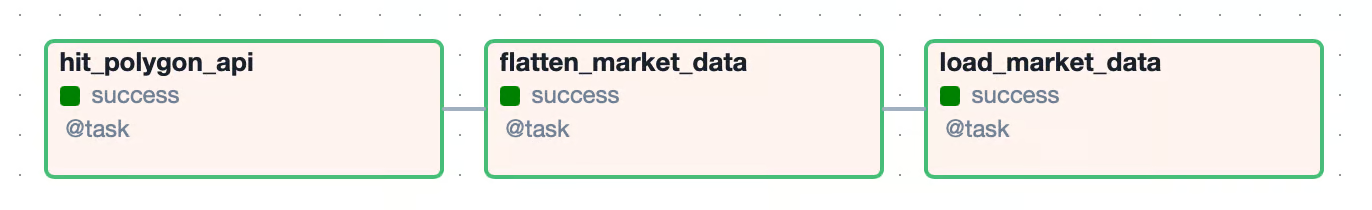 Vue graphe du pipeline ETL
Maintenant que vous avez construit votre premier DAG Airflow, il est temps de vérifier qu’il fonctionne. Plusieurs méthodes existent, la plus courante étant d’exécuter le DAG de bout en bout.
Dans l’interface Airflow, accédez à votre DAG et basculez l’interrupteur du bleu vers active. Comme catchup est défini sur True, un run sera mis en file d’attente et démarrera. Si une tâche s’exécute avec succès, sa case passe au vert dans l’interface. Si toutes les tâches réussissent, le DAG est marqué success et le run suivant est déclenché.
Si une tâche échoue, son état passe à up for retry et elle apparaît en jaune. Dans ce cas, consultez les logs de la tâche en cliquant sur la case jaune en vue grille puis sur Logs. Vous y trouverez le message d’exception pour commencer le diagnostic. Si une tâche échoue plus de fois que le nombre de relances autorisées, l’état de la tâche et du DAG passe à failed.
Outre les tests de bout en bout, Airflow facilite l’écriture de tests unitaires. Lors de la création initiale de l’environnement avec astro dev start, un répertoire tests/ est généré. Vous pouvez y ajouter des tests unitaires pour votre DAG et ses composants.
Ci-dessous, un test unitaire de la configuration de notre DAG. Il valide plusieurs paramètres définis, comme start_date, schedule et catchup. Une fois le test écrit, rendez-vous à la racine du projet et exécutez :
from airflow.models.dagbag import DagBag
from datetime import datetime
import pytz

def test_market_etl_config():
    # Récupérer le DAG
    market_etl_dag = DagBag().get_dag("market_etl")
    # Vérifier start_date, schedule et catchup
    assert market_etl_dag.start_date == datetime(2024, 3, 25, 9, tzinfo=pytz.UTC)
    assert market_etl_dag.schedule_interval == "@daily"
    assert market_etl_dag.catchup
astro dev pytestCette commande exécute tous les tests unitaires du répertoire tests/. Pour n’exécuter qu’un seul test, fournissez le chemin du fichier en argument. En plus de l’Astro CLI, vous pouvez utiliser tout outil de test Python pour écrire et exécuter vos tests.
Pour des projets personnels, écrire des tests unitaires vous aide à garantir le comportement attendu du code. En entreprise, ils sont presque toujours requis. La plupart des équipes data utilisent un outil CI/CD pour déployer leur projet Airflow. Ce processus inclut généralement l’exécution de tests unitaires et la validation de leurs résultats afin d’assurer que le DAG que vous avez écrit est prêt pour la production. Pour en savoir plus, consultez notre tutoriel How to Use Pytest for Unit Testing ainsi que le cours Introduction to Testing in Python.
Nous avons construit un pipeline de données simple et fonctionnel, avec transformation et persistance. Dans d’autres cas, Airflow peut orchestrer des workflows complexes grâce à des opérateurs fournis par des providers ou personnalisés, pour traiter des téraoctets de données.
Par exemple, les opérateurs S3ToSnowflakeOperator et DatabricksRunNowOperator facilitent l’intégration à un stack data plus large. Les utiliser dans un cadre personnel peut toutefois être contraignant : pour S3ToSnowflakeOperator, il vous faut des comptes et configurations AWS et Snowflake pour les ressources entre lesquelles vous transférez des données.
En plus des workflows ETL, Airflow prend en charge les workflows ELT, qui deviennent la norme pour les équipes exploitant des entrepôts de données cloud. Gardez cela à l’esprit lors de la conception de vos pipelines.
Dans la partie load de notre pipeline, nous avons créé une connexion vers une base SQLite, ensuite utilisée pour la persistance. Les connexions, parfois appelées Secrets, sont une fonctionnalité d’Airflow pensée pour simplifier les interactions avec les systèmes sources et cibles. En y stockant des informations sensibles, comme votre clé API Polygon, vous renforcez la sécurité de votre code. Vous pouvez ainsi gérer les identifiants séparément de la base de code. Dans la mesure du possible, utilisez largement les Connections pour garder vos workflows sécurisés et organisés.
Vous avez peut-être remarqué que le ticker « AMZN » est codé en dur dans nos tâches hit_polygon_api et flatten_market_data. Cela nous a permis d’extraire, transformer et charger les données pour un seul ticker. Mais si vous souhaitez réutiliser ce code pour plusieurs tickers ? Heureusement, il est simple de générer des DAGs dynamiquement. Avec un léger refactoring, nous pourrions itérer sur une liste de tickers et paramétrer leurs valeurs. Vos DAGs gagnent ainsi en modularité et en portabilité. Pour en savoir plus sur la génération dynamique de DAGs, consultez la documentation d’Astronomer Dynamically Generate DAGs in Airflow.
Félicitations ! Vous avez construit un DAG Airflow pour extraire, transformer et charger des données de marché depuis l’API Polygon à l’aide de Python, pandas et SQLite. Au passage, vous avez renforcé vos compétences en création de schémas d’architecture et de tech specs, en configuration de connexions Airflow et en test de vos DAGs. Pour la suite, expérimentez des techniques plus avancées afin de rendre vos pipelines robustes, résilients et réutilisables.
Découvrez d’autres ressources pour approfondir :
Apprenez l’ingénierie des données avec Datacamp
Cursus
Cours
Cours