Lộ trình
Kỹ sư dữ liệu trong Python
40 giờ
Luyện tập và Lộ trình tiến trình của bạn.
Tiếp Tục Với GoogleChào mừng bạn đến với thế giới đường ống ETL sử dụng Apache Airflow. Trong hướng dẫn này, chúng ta sẽ tập trung vào việc lấy dữ liệu thị trường chứng khoán bằng Polygon API, biến đổi dữ liệu này, rồi nạp vào cơ sở dữ liệu SQLite để truy cập và thao tác dễ dàng. Bắt đầu thôi!
Apache Airflow được xem là tiêu chuẩn trong ngành cho việc điều phối dữ liệu và quản lý đường ống. Công cụ này trở nên phổ biến với các nhà khoa học dữ liệu, kỹ sư machine learning và chuyên gia AI nhờ khả năng điều phối quy trình công việc phức tạp, quản lý phụ thuộc giữa các tác vụ, thử lại các tác vụ thất bại và cung cấp nhật ký phong phú.
Airflow ETL đề cập đến việc sử dụng Apache Airflow để quản lý các quy trình ETL. Nhắc lại, ETL là một dạng tích hợp dữ liệu gồm các bước trích xuất dữ liệu từ nhiều nguồn, biến đổi dữ liệu thành định dạng phù hợp cho phân tích, và nạp vào đích cuối như kho dữ liệu.
Trước khi bắt đầu xây dựng một đường ống ETL với Airflow, chúng ta cần cấu hình môi trường phát triển. Để biết thông tin chi tiết về cách cấu hình môi trường, hãy xem hướng dẫn Bắt đầu với Apache Airflow.
Chúng ta cũng cần cài đặt Astro CLI. Vui lòng xem Astronomer, đơn vị duy trì Astro CLI và cung cấp tài liệu chi tiết, để làm theo hướng dẫn.
Sau khi cấu hình môi trường và cài đặt Astro CLI, chúng ta tạo một dự án Airflow. Thực hiện bằng cách mở cửa sổ terminal và tạo một thư mục mới tại đường dẫn đã chọn.
~/Documents/data-engineering/ETL-pipeline/ Từ thư mục gốc này, chạy lệnh sau để tạo các tài nguyên cần thiết:
astro dev initNội dung thư mục sẽ trông như bên dưới. Kết quả chính xác có thể khác nhau.
├── dags/
├── include/
├── plugins/
├── tests/
├── airflow_settings.yaml
├── Dockerfile
├── packages.txt
└── requirements.txt
Để khởi động dự án, hãy thực thi lệnh sau:
astro dev startMôi trường Airflow của bạn sẽ mất khoảng một phút để khởi chạy. Khi xong, truy cập localhost: 8080 trong trình duyệt, bạn sẽ thấy giao diện Airflow.
Giờ bạn đã sẵn sàng bắt đầu phát triển đường ống ETL với Airflow!
Bạn nên dành thời gian lập kế hoạch cho từng thành phần của đường ống trước khi viết một dòng mã. Đặc biệt, hãy tập thói quen xác định nguồn dữ liệu và đích đến nơi dữ liệu sẽ được nạp. Bằng cách này, chúng ta cũng hiểu dữ liệu sẽ được biến đổi ra sao trên đường đi.
Trong ví dụ này, chúng ta sẽ thiết kế một đường ống dữ liệu để lấy dữ liệu thị trường chứng khoán từ Polygon API, sau đó biến đổi và nạp vào cơ sở dữ liệu SQLite. Trong trường hợp này, hệ thống nguồn là Polygon API và đích đến là cơ sở dữ liệu SQLite. Hãy minh họa bằng một hình ảnh:
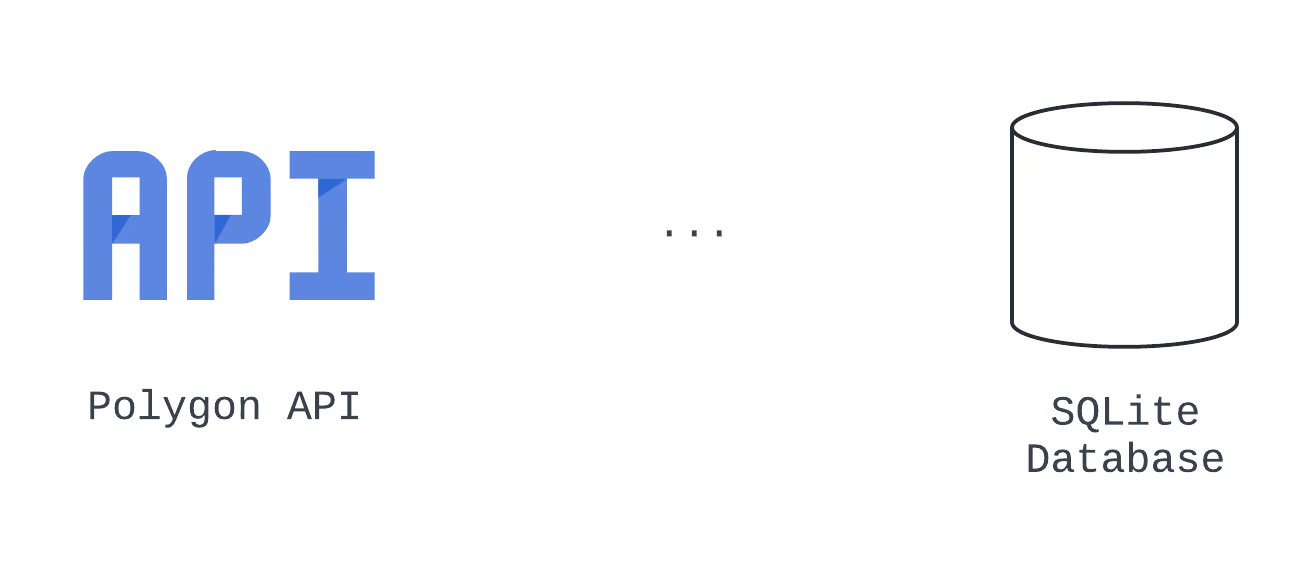 Sơ đồ nguồn và đích đến
Với kinh nghiệm kỹ sư dữ liệu, chúng ta biết để chuẩn bị dữ liệu nạp vào SQLite, dữ liệu cần được chuyển từ JSON sang dạng bảng. Chúng ta lập kế hoạch biến đổi dữ liệu sau khi lấy từ Polygon API, dùng Python thuần và thư viện pandas. Hãy cập nhật hình minh họa để phản ánh thay đổi này:
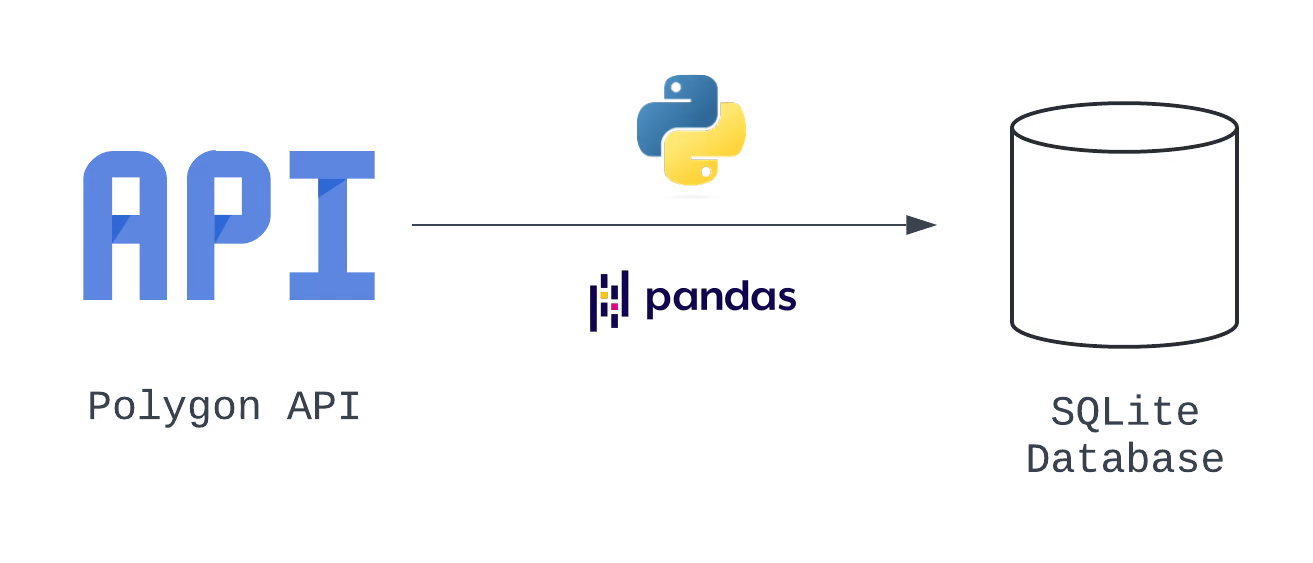 Sơ đồ kiến trúc
Bổ sung thông tin này, chúng ta đã tạo một sơ đồ kiến trúc, là biểu diễn tổng quát hệ thống. Ta thấy ba bước logic trong đường ống, tương ứng với E, T và L trong quy trình.
Ta cũng có thể chuyển các tác vụ này thành đồ thị có hướng không chu trình (DAG), là cấu hình xác định toàn bộ tập tác vụ mà Airflow sẽ thực thi, trình tự và phụ thuộc giữa chúng. Tìm hiểu thêm về DAG bằng cách học Khóa Nhập môn Kỹ thuật Dữ liệu của chúng tôi, trong đó xem xét chi tiết các DAG của Airflow.
Trong môi trường doanh nghiệp, nhiều nhóm dùng các tài liệu gọi là đặc tả kỹ thuật (tech spec) để thống nhất và ghi lại quyết định thiết kế. Với trường hợp của chúng ta, tạo một bảng để ghi lại các lựa chọn thiết kế cho đường ống dữ liệu là đủ.
|
Loại Operator |
ID Tác vụ |
Ghi chú |
|---|---|---|
|
Extract |
hit_polygon_api |
Dùng TaskFlow API và xây dựng hàm Python để xác thực và gọi Polygon API, rồi trả về phản hồi |
|
Transform |
flatten_market_data |
Phẳng hóa dữ liệu trả về từ tác vụ hit_polygon_api, chuẩn bị để nạp vào SQLite |
|
Load |
load_market_data |
Nạp dữ liệu đã phẳng hóa vào SQLite |
Các lựa chọn cho đường ống dữ liệu
Lưu ý rằng DAG của chúng ta tập trung vào chi tiết cấp tác vụ và có thể không bao quát hết mọi thông tin. Ta có thể dùng bảng thứ hai để ghi lại các chi tiết bổ sung cần làm rõ. Câu hỏi gồm:
|
Tham số |
Giá trị |
|---|---|
|
DAG ID |
market_etl |
|
Ngày bắt đầu |
Ngày 1 tháng 1, 2024 (9:00 AM UTC) |
|
Khoảng thời gian |
Hàng ngày |
|
Bù chạy (Catchup)? |
True (nạp toàn bộ dữ liệu kể từ ngày 1 tháng 1, 2024) |
|
Đồng thời |
1 DAG chạy tại một thời điểm |
|
Số lần thử lại tác vụ, độ trễ thử lại |
3 lần thử lại, mỗi lần cách nhau 5 phút |
|
Nhiều mã cổ phiếu? |
DAG sinh động (dynamically-spawning) |
Những câu hỏi cần làm rõ
Tổng kết lại những gì đã làm: Chúng ta đã tạo sơ đồ kiến trúc, ghi lại cách chia nhỏ đường ống thành các tác vụ Airflow, và xác định thông tin cấp cao cần thiết để cấu hình DAG.
Nếu bạn muốn tìm hiểu thêm về thiết kế, phát triển và kiểm thử đường ống dữ liệu, hãy xem Nhập môn Data Pipelines của DataCamp. Tại đây, bạn sẽ nắm vững nền tảng xây dựng đường ống ETL bằng Python, cũng như các thực tiễn tốt nhất để đảm bảo giải pháp vững chắc, bền bỉ và tái sử dụng được.
Chúng ta sẽ tổ chức cách xây dựng đường ống ETL bằng cách đi theo từng bước tuần tự. Cách tiếp cận có cấu trúc giúp mỗi giai đoạn được thực hiện chính xác.
Trước khi lấy dữ liệu từ Polygon API, chúng ta cần tạo mã thông báo API bằng cách truy cập Polygon và chọn nút Create API Key. Lưu ý rằng trong hướng dẫn này, bạn không cần đăng ký gói trả phí - gói miễn phí sẽ tạo khóa API và cung cấp đầy đủ chức năng cần thiết. Nhớ sao chép và lưu khóa API của bạn.
Sau khi tạo khóa API, chúng ta đã sẵn sàng bắt đầu trích xuất dữ liệu từ Polygon API với Airflow. Hãy dùng bảng đặc tả kỹ thuật đã tạo, bao gồm chi tiết cấu hình DAG, để hỗ trợ việc viết mã.
from airflow import DAG
from datetime import datetime, timedelta

with DAG(
    dag_id="market_etl",
    start_date=datetime(2024, 1, 1, 9),
    schedule="@daily",
    catchup=True,
    max_active_runs=1,
    default_args={
        "retries": 3,
        "retry_delay": timedelta(minutes=5)
    }
) as dag:
Hãy thêm tác vụ đầu tiên. Chúng ta sẽ dùng TaskFlow API và mô-đun requests để lấy dữ liệu giá mở-đóng cổ phiếu từ Polygon API.
import requests
...
@task()

def hit_polygon_api(**context):
    # Instantiate a list of tickers that will be pulled and looped over
    stock_ticker = "AMZN"
    # Set variables
    polygon_api_key= "<your-api-key>"
  ds = context.get("ds")

  # Create the URL
    url= f"<https://api.polygon.io/v1/open-close/{stock_ticker}/{ds}?adjusted=true&apiKey={polygon_api_key}>"
    response = requests.get(url)
    # Return the raw data
    return response.json()
Có vài điểm bạn sẽ nhận thấy trong đoạn mã này.
hit_polygon_api được trang trí bằng @task. Trình trang trí này chuyển hàm thành một tác vụ Airflow có thể được thực thi trong DAG.context được định nghĩa trong chữ ký hit_polygon_api. Sau đó được dùng để lấy giá trị tại khóa ds.context là một từ điển chứa siêu dữ liệu về tác vụ và DAG.ds từ từ điển context, ta nhận được ngày của data_interaval_end theo định dạng YYYY-mm-dd. hit_polygon_api.Kết hợp tất cả lại, mã để tạo phần đầu của đường ống ETL như sau.
from airflow import DAG
from airflow.decorators import task
from datetime import datetime, timedelta import requests

with DAG(
    dag_id="market_etl",
    start_date=datetime(2024, 1, 1, 9),
    schedule="@daily",
    catchup=False,
    max_active_runs=1,
    default_args={
        "retries": 3,
        "retry_delay": timedelta(minutes=5)
    }
) as dag:
    # Create a task using the TaskFlow API
    @task()
    def hit_polygon_api(**context):
        # Instantiate a list of tickers that will be pulled and looped over
        stock_ticker = "AMZN"
        # Set variables
        polygon_api_key = "<your-api-key>"
        ds = context.get("ds")
        # Create the URL
        url = f"<https://api.polygon.io/v1/open-close/{stock_ticker}/{ds}?adjusted=true&apiKey={polygon_api_key}>"
        response = requests.get(url)
        # Return the raw data
        return response.json()
    hit_polygon_api()
Bạn sẽ thấy phản hồi chứa lỗi khi chạy cho ngày 1 tháng 1, 2024. Vì thị trường đóng cửa ngày này, Polygon trả phản hồi nêu ngoại lệ. Chúng ta sẽ xử lý ở bước tiếp theo.
Sau khi dữ liệu được trích xuất từ Polygon API, chúng ta sẵn sàng biến đổi nó.
Để làm điều này, chúng ta sẽ tạo thêm một tác vụ bằng TaskFlow API. Tác vụ này có tên flatten_market_data và có tham số polygon_response (dữ liệu thô do hit_polygon_api trả về) và **context. Chúng ta sẽ xem kỹ hơn polygon_response ngay sau đây.
Việc biến đổi thực tế khá đơn giản. Chúng ta sẽ phẳng hóa JSON do Polygon API trả về thành một danh sách. Điểm mấu chốt là chúng ta cung cấp giá trị mặc định riêng cho mỗi khóa nếu khóa đó không tồn tại trong phản hồi.
Ví dụ, nếu khóa from không tồn tại trong phản hồi, ta sẽ cung cấp giá trị mặc định dùng context của Airflow. Điều này giải quyết vấn đề đã thấy trước đó, khi phản hồi chỉ chứa một tập khóa hạn chế (do thị trường đóng cửa). Tiếp theo, chúng ta chuyển danh sách thành DataFrame của pandas và trả về. Tác vụ thu được như sau:
@task
def flatten_market_data(polygon_response, **context):
    # Create a list of headers and a list to store the normalized data in
    columns = {
        "status": "closed",
        "from": context.get("ds"),
        "symbol": "AMZN",
        "open": None,
        "high": None,
        "low": None,
        "close": None,
        "volume": None
    }
    # Create a list to append the data to
    flattened_record = []
    for header_name, default_value in columns.items():
        # Append the data
        flattened_record.append(polygon_response.get(header_name, default_value))
    # Convert to a pandas DataFrame
    flattened_dataframe = pd.DataFrame([flattened_record], columns=columns.keys())
    return flattened_dataframe
Chúng ta sẽ phải thêm phụ thuộc giữa các tác vụ hit_polygon_api và flatten_market_data. Để làm vậy, hãy cập nhật mã trong DAG như dưới đây:
import pandas as pd
with DAG(
    dag_id="market_etl",
    start_date=datetime(2024, 1, 1, 9),
    schedule="@daily",
    catchup=True,
    max_active_runs=1,
    default_args={
        "retries": 3,
        "retry_delay": timedelta(minutes=5)
    }
) as dag:
    @task()
    def hit_polygon_api(**context):
        ...
    @task
    def flatten_market_data(polygon_response, **context):
        # Create a list of headers and a list to store the normalized data in
        columns = {
            "status": None,
            "from": context.get("ds"),
            "symbol": "AMZN",
            "open": None,
            "high": None,
            "low": None,
            "close": None,
            "volume": None
        }
        # Create a list to append the data to
        flattened_record = []
        for header_name, default_value in columns.items():
            # Append the data
            flattened_record.append(polygon_response.get(header_name, default_value))
        # Convert to a pandas DataFrame
        flattened_dataframe = pd.DataFrame([flattened_record], columns=columns.keys())
        return flattened_dataframe
# Set dependencies
    raw_market_data = hit_polygon_api()
    flatten_market_data(raw_market_data)
Ở đây, giá trị trả về của tác vụ hit_polygon_api được lưu trong raw_market_data. Sau đó, raw_market_data được truyền làm đối số cho tác vụ flatten_market_data thông qua tham số polygon_response. Đoạn mã này không chỉ thiết lập phụ thuộc giữa hai tác vụ mà còn cho phép chia sẻ dữ liệu giữa chúng.
Dù phép biến đổi khá đơn giản, Airflow cung cấp khả năng thực thi nhiều thao tác dữ liệu phức tạp hơn. Bên cạnh việc dùng các tác vụ thuần, bạn có thể tận dụng bộ sưu tập hook và operator do nhà cung cấp xây dựng để điều phối biến đổi bằng các công cụ như AWS Lambda và DBT.
Chúng ta đã đến bước cuối của đường ống ETL. Ta dự kiến dùng cơ sở dữ liệu SQLite và một tác vụ cuối cùng được định nghĩa bằng TaskFlow API.
Như trước, chúng ta sẽ định nghĩa một tham số khi tạo tác vụ, đặt tên là flattened_dataframe. Nhờ đó, dữ liệu trả về từ tác vụ flatten_market_data có thể được truyền vào tác vụ mới.
Trước khi viết mã để nạp dữ liệu vào cơ sở dữ liệu SQLite, chúng ta cần tạo một kết nối trong giao diện Airflow. Để mở trang kết nối, làm theo các bước:
Bạn sẽ được đưa đến màn hình như sau:
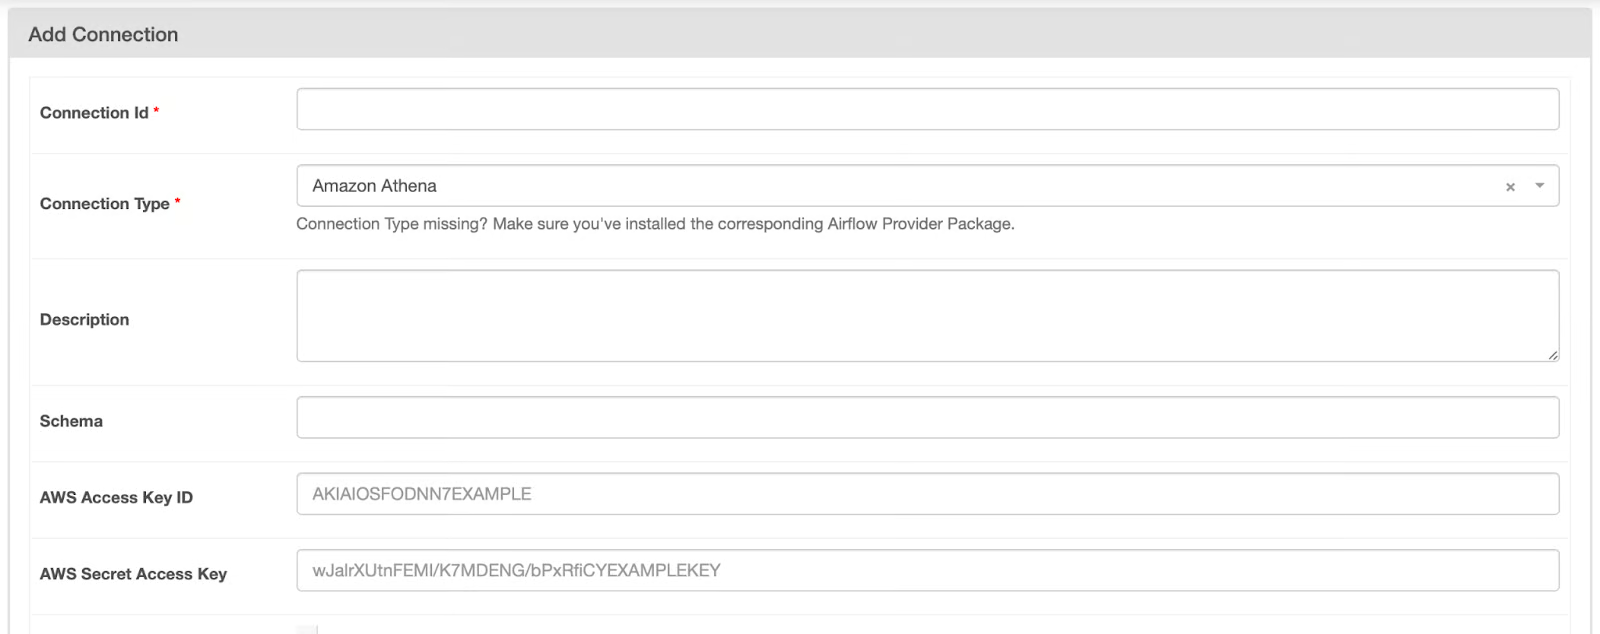 Trang kết nối của Airflow
Để điền trang kết nối, làm theo các bước:
Cấu hình cho kết nối này sẽ trông như hình dưới. Khi hoàn tất, nhấp Save.
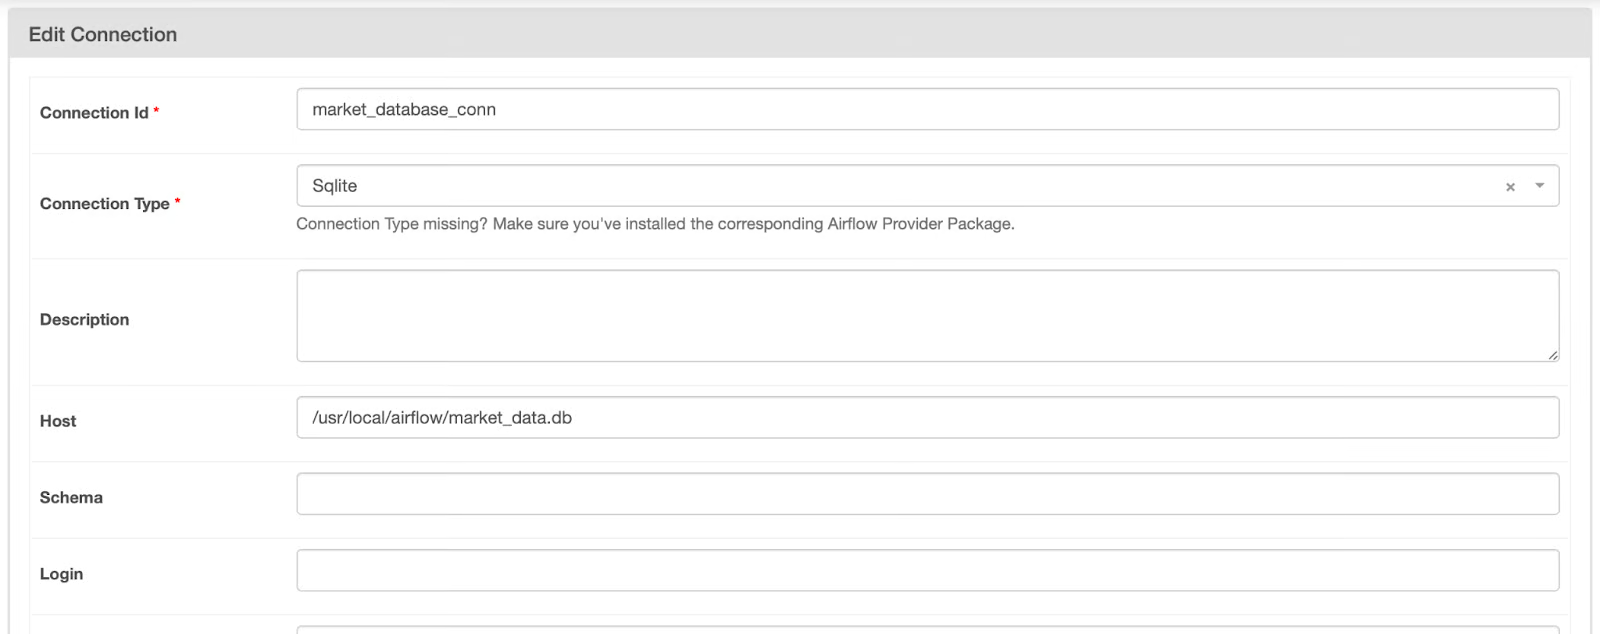 Kết nối Airflow tới cơ sở dữ liệu SQLite chưa được lưu
Giờ chúng ta đã tạo kết nối, có thể truy xuất thông tin này trong tác vụ bằng SqliteHook. Xem đoạn mã bên dưới.
from airflow.providers.sqlite.hooks.sqlite import SqliteHook@task
def load_market_data(flattened_dataframe):
# Pull the connection
market_database_hook = SqliteHook("market_database_conn")
market_database_conn = market_database_hook.get_sqlalchemy_engine()
# Load the table to Postgres, replace if it exists
flattened_dataframe.to_sql(
name="market_data",
con=market_database_conn,
if_exists="append",
index=False
)
# print(market_database_hook.get_records("SELECT * FROM market_data;"))Với đoạn mã này, chúng ta tạo kết nối đến cơ sở dữ liệu SQLite đã chỉ định ở bước trước. Sau đó, engine kết nối được lấy từ hook bằng phương thức .get_sqlalchemy_engine(). Engine này được truyền vào tham số con khi gọi phương thức .to_sql() trên flattened_dataframe.
Lưu ý tên bảng được ghi dữ liệu vào là market_data, và nếu bảng đã tồn tại thì sẽ được nối thêm. Khi thử nghiệm, tôi thường kiểm tra dữ liệu được ghi bằng cách truy xuất và in các bản ghi. Bạn có thể làm điều này bằng cách bỏ chú thích dòng cuối của tác vụ.
Kết hợp tất cả lại, mã của chúng ta sẽ trông như sau:
from airflow import DAG
from airflow.decorators import task
from airflow.providers.sqlite.hooks.sqlite import SqliteHook
from datetime import datetime, timedelta
import requests
import pandas as pd

with DAG(
    dag_id="market_etl",
    start_date=datetime(2024, 1, 1, 9),
    schedule="@daily",
    catchup=True,
    max_active_runs=1,
    default_args={
        "retries": 3,
        "retry_delay": timedelta(minutes=5)
    }
) as dag:
    # Create a task using the TaskFlow API
    @task()
    def hit_polygon_api(**context):
        # Instantiate a list of tickers that will be pulled and looped over
        stock_ticker = "AMZN"
        # Set variables
        polygon_api_key = "<your-api-key>"
        ds = context.get("ds")
        # Create the URL
        url = f"<https://api.polygon.io/v1/open-close/{stock_ticker}/{ds}?adjusted=true&apiKey={polygon_api_key}>"
        response = requests.get(url)
        # Return the raw data
        return response.json()
    @task
    def flatten_market_data(polygon_response, **context):
        # Create a list of headers and a list to store the normalized data in
        columns = {
            "status": None,
            "from": context.get("ds"),
            "symbol": "AMZN",
            "open": None,
            "high": None,
            "low": None,
            "close": None,
            "volume": None
        }
        # Create a list to append the data to
        flattened_record = []
        for header_name, default_value in columns.items():
            # Append the data
            flattened_record.append(polygon_response.get(header_name, default_value))
        # Convert to a pandas DataFrame
        flattened_dataframe = pd.DataFrame([flattened_record], columns=columns.keys())
        return flattened_dataframe
    @task
    def load_market_data(flattened_dataframe):
        # Pull the connection
        market_database_hook = SqliteHook("market_database_conn")
        market_database_conn = market_database_hook.get_sqlalchemy_engine()
        # Load the table to SQLite, append if it exists
        flattened_dataframe.to_sql(
            name="market_data",
            con=market_database_conn,
            if_exists="append",
            index=False
        )
    # Set dependencies between tasks
    raw_market_data = hit_polygon_api()
    transformed_market_data = flatten_market_data(raw_market_data)
    load_market_data(transformed_market_data)
Một lần nữa, chúng ta cập nhật phụ thuộc để dữ liệu trả về từ tác vụ flatten_market_data được truyền vào tác vụ load_market_data. Chế độ xem đồ thị cho DAG của chúng ta sẽ trông như sau:
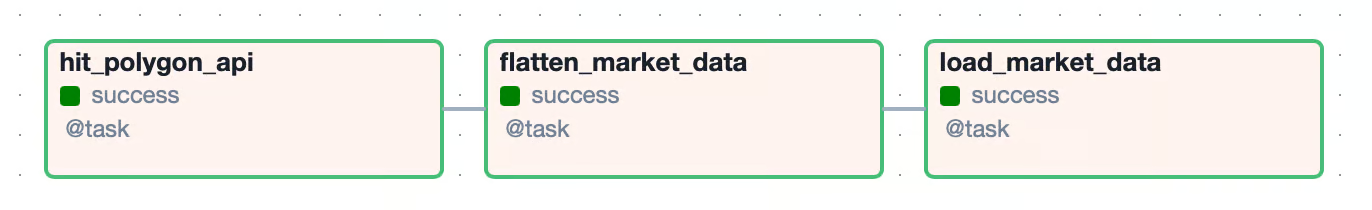 Chế độ xem đồ thị cho đường ống ETL
Giờ bạn đã xây dựng DAG đầu tiên với Airflow, đã đến lúc đảm bảo nó hoạt động. Có vài cách để làm điều này, nhưng phổ biến nhất là chạy DAG end-to-end.
Để thực hiện trong giao diện Airflow, hãy điều hướng đến DAG của bạn và bật công tắc từ màu xanh sang active. Vì catchup được đặt True, một lượt chạy DAG sẽ được xếp hàng và bắt đầu. Nếu một tác vụ chạy thành công, ô tương ứng trong UI sẽ chuyển sang màu xanh lá. Nếu tất cả tác vụ trong DAG đều thành công, DAG sẽ được đánh dấu success, và lượt chạy DAG kế tiếp sẽ được kích hoạt.
Nếu một tác vụ thất bại, trạng thái sẽ là up for retry và được đánh dấu vàng. Khi đó, tốt nhất là xem nhật ký của tác vụ. Bạn có thể làm điều này bằng cách nhấp vào ô màu vàng trong chế độ xem lưới và chọn Logs. Tại đây, bạn sẽ thấy thông điệp ngoại lệ và bắt đầu xử lý. Nếu một tác vụ thất bại quá số lần thử lại được chỉ định, trạng thái của tác vụ và DAG sẽ chuyển thành failed.
Ngoài việc kiểm thử DAG end-to-end, Airflow giúp dễ dàng viết unit test. Khi bạn khởi tạo môi trường bằng astro dev start, một thư mục tests/ được tạo sẵn. Tại đây, bạn có thể thêm unit test cho cả DAG và các thành phần của DAG.
Dưới đây là unit test cho cấu hình DAG của chúng ta. Bài test này xác thực một số tham số được đặt khi định nghĩa như start_date, schedule và catchup. Khi viết xong test, điều hướng đến thư mục gốc dự án và chạy:
from airflow.models.dagbag import DagBag
from datetime import datetime
import pytz

def test_market_etl_config():
    # Pull the DAG
    market_etl_dag = DagBag().get_dag("market_etl")
    # Assert start date, schedule, and catchup
    assert market_etl_dag.start_date == datetime(2024, 3, 25, 9, tzinfo=pytz.UTC)
    assert market_etl_dag.schedule_interval == "@daily"
    assert market_etl_dag.catchup
astro dev pytestLệnh này sẽ chạy tất cả unit test trong thư mục tests/. Nếu bạn chỉ muốn chạy một test cụ thể, có thể cung cấp đường dẫn tới tệp làm đối số cho lệnh trên. Bên cạnh việc dùng Astro CLI để chạy test, bạn có thể dùng bất kỳ test runner Python nào để viết và thực thi unit test.
Với dự án cá nhân, viết unit test giúp đảm bảo mã hoạt động như mong đợi. Trong môi trường doanh nghiệp, unit test gần như luôn bắt buộc. Hầu hết các nhóm dữ liệu sẽ dùng một công cụ CI/CD để triển khai dự án Airflow. Quy trình này thường gồm chạy unit test và xác thực kết quả để đảm bảo DAG bạn viết đã sẵn sàng cho môi trường sản xuất. Để biết thêm về unit test, hãy xem Hướng dẫn dùng Pytest cho Unit Testing và Nhập môn Kiểm thử trong Python.
Chúng ta đã xây dựng một đường ống dữ liệu đơn giản hoạt động tốt, và thậm chí đã dùng kỹ thuật biến đổi và lưu trữ. Ở những trường hợp khác, Airflow có thể điều phối các quy trình phức tạp bằng các operator do nhà cung cấp hoặc tự xây dựng, xử lý hàng terabyte dữ liệu.
Một vài ví dụ là S3ToSnowflakeOperator và DatabricksRunNowOperator, cả hai đều cho phép tích hợp dễ dàng với một ngăn xếp dữ liệu lớn hơn. Làm việc với các operator kiểu này khá khó trong bối cảnh dự án cá nhân. Ví dụ, để dùng S3ToSnowflakeOperator, bạn cần có cả tài khoản AWS và Snowflake cùng cấu hình cho tài nguyên chuyển dữ liệu giữa chúng.
Ngoài các quy trình ETL, Airflow còn hỗ trợ quy trình ELT, đang dần trở thành tiêu chuẩn ngành cho các đội ngũ tận dụng kho dữ liệu đám mây. Hãy ghi nhớ điều này khi thiết kế đường ống dữ liệu.
Trong thành phần load của đường ống, chúng ta đã tạo kết nối đến cơ sở dữ liệu SQLite, sau đó truy xuất và dùng để lưu dữ liệu. Các kết nối, đôi khi gọi là Secrets, là tính năng trong Airflow được thiết kế để đơn giản hóa tương tác với hệ thống nguồn và đích. Bằng cách dùng các kết nối này để lưu thông tin nhạy cảm, như khóa API Polygon của bạn, bạn tăng cường bảo mật cho mã. Cách này cũng cho phép quản lý thông tin xác thực tách biệt khỏi mã nguồn. Bất cứ khi nào có thể, nên tận dụng Connections để giữ quy trình làm việc vừa an toàn vừa gọn gàng.
Bạn có thể nhận thấy mã cổ phiếu “AMZN” được mã hóa cứng trong các tác vụ hit_polygon_api và flatten_market_data. Điều này cho phép chúng ta trích xuất, biến đổi và nạp dữ liệu cho một mã cổ phiếu duy nhất. Nhưng nếu bạn muốn dùng cùng mã này cho nhiều mã cổ phiếu thì sao? May mắn là việc sinh DAG động khá dễ. Với chút tái cấu trúc, chúng ta có thể lặp qua danh sách mã cổ phiếu và tham số hóa giá trị mã. Cách này giúp DAG linh hoạt và có thể tái sử dụng hơn. Để biết thêm về việc sinh DAG động, hãy xem tài liệu Dynamically Generate DAGs in Airflow từ Astronomer.
Chúc mừng bạn! Bạn đã xây dựng một DAG Airflow để trích xuất, biến đổi và nạp dữ liệu thị trường chứng khoán từ Polygon API bằng Python, pandas và SQLite. Trong quá trình đó, bạn đã rèn luyện kỹ năng xây dựng sơ đồ kiến trúc và tech spec, tạo kết nối Airflow, và kiểm thử DAG. Khi tiếp tục hành trình với Airflow, hãy thử nghiệm các kỹ thuật nâng cao để giúp đường ống của bạn vững chắc, bền bỉ và tái sử dụng được.
Xem thêm một số tài nguyên để tìm hiểu sâu hơn:
Học Kỹ thuật Dữ liệu với Datacamp
Lộ trình
Khóa học
Luyện tập và Lộ trình tiến trình của bạn.
Tiếp Tục Với Google