Lernpfad
Dateningenieur in Python
40 Std.
Willkommen in der Welt der ETL-Pipelines mit Apache Airflow. In diesem Tutorial holen wir Börsendaten über die Polygon API, transformieren sie und laden sie anschließend in eine SQLite-Datenbank, um sie leicht zugänglich und bearbeitbar zu machen. Los geht’s!
Apache Airflow gilt als Branchenstandard für Datenorchestrierung und Pipeline-Management. Es ist bei Data Scientists, Machine-Learning-Engineers und KI-Profis beliebt, weil es komplexe Workflows orchestriert, Abhängigkeiten zwischen Tasks verwaltet, fehlgeschlagene Tasks erneut ausführt und umfangreiches Logging bietet.
Airflow-ETL bezeichnet die Nutzung von Apache Airflow zur Steuerung von ETL-Prozessen. Zur Auffrischung: ETL ist eine Form der Datenintegration, bei der Daten aus verschiedenen Quellen extrahiert, in ein für Analysen geeignetes Format transformiert und in ein Zielsystem wie ein Data Warehouse geladen werden.
Bevor wir mit dem Aufbau einer ETL-Pipeline in Airflow starten, müssen wir die Entwicklungsumgebung konfigurieren. Ausführliche Infos zur Einrichtung findest du im Tutorial Getting Started with Apache Airflow.
Außerdem installieren wir die Astro CLI. Schau dir die Anleitung bei Astronomer an, die die Astro CLI pflegen und ausführlich dokumentieren.
Nachdem die Umgebung steht und die Astro CLI installiert ist, legen wir ein Airflow-Projekt an. Öffne dazu ein Terminal und erstelle ein neues Verzeichnis am gewünschten Pfad.
~/Documents/data-engineering/ETL-pipeline/ Vom Root dieses Verzeichnisses aus führen wir folgenden Befehl aus, um die nötigen Ressourcen zu erzeugen:
astro dev initDer Inhalt des Verzeichnisses sieht in etwa so aus. Die genaue Ausgabe kann variieren.
├── dags/
├── include/
├── plugins/
├── tests/
├── airflow_settings.yaml
├── Dockerfile
├── packages.txt
└── requirements.txt
Starte dein Projekt mit folgendem Befehl:
astro dev startDas Airflow-Umfeld braucht etwa eine Minute zum Hochfahren. Rufe anschließend localhost: 8080 im Browser auf, und du wirst von der Airflow-UI begrüßt.
Jetzt bist du bereit, deine eigene ETL-Pipeline mit Airflow zu entwickeln!
Nimm dir vor dem ersten Code-Zeile Zeit, die Komponenten deiner Pipeline zu planen. Besonders wichtig ist, Quelle und Ziel deiner Daten vorab festzulegen. Dadurch wird auch klar, wie die Daten auf dem Weg transformiert werden müssen.
In unserem Beispiel entwerfen wir eine Pipeline, die Börsendaten von der Polygon API bezieht, diese transformiert und in eine SQLite-Datenbank lädt. Die Quelle ist also die Polygon API, das Ziel die SQLite-Datenbank. So sieht das als Visualisierung aus:
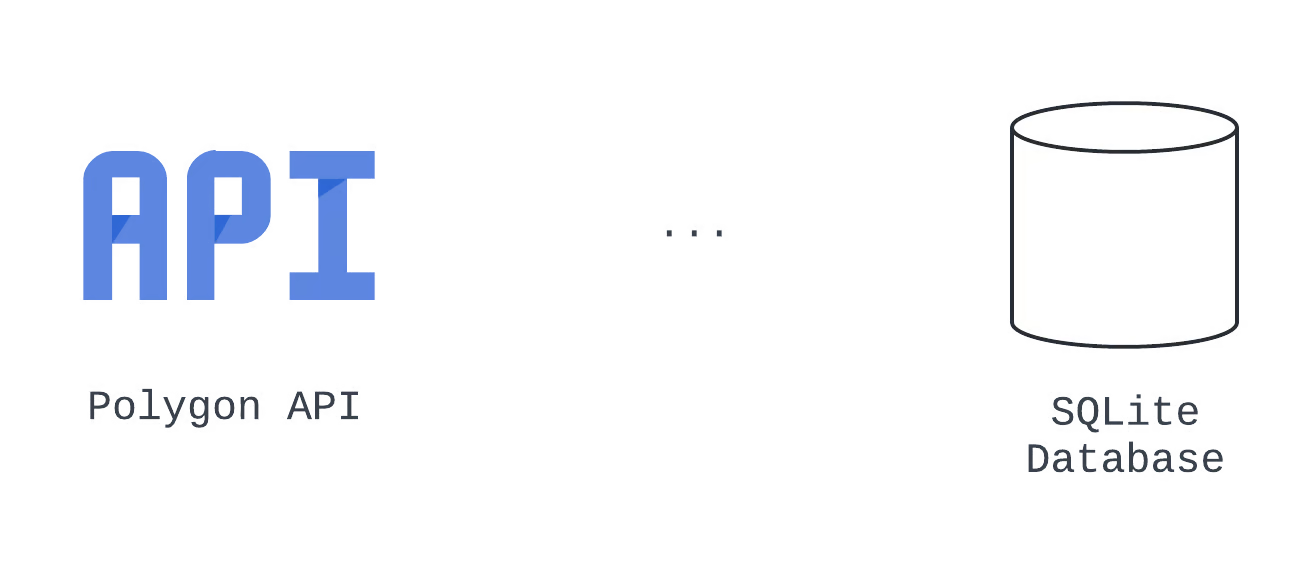 Diagramm zu Quelle und Ziel
Aus Erfahrung als Data Engineers wissen wir: Damit Daten in SQLite geladen werden können, müssen sie von JSON in ein tabellarisches Format transformiert werden. Wir planen daher, die Daten nach dem Abruf aus der Polygon API mit nativem Python und der Bibliothek pandas aufzubereiten. Aktualisieren wir unser Schaubild entsprechend:
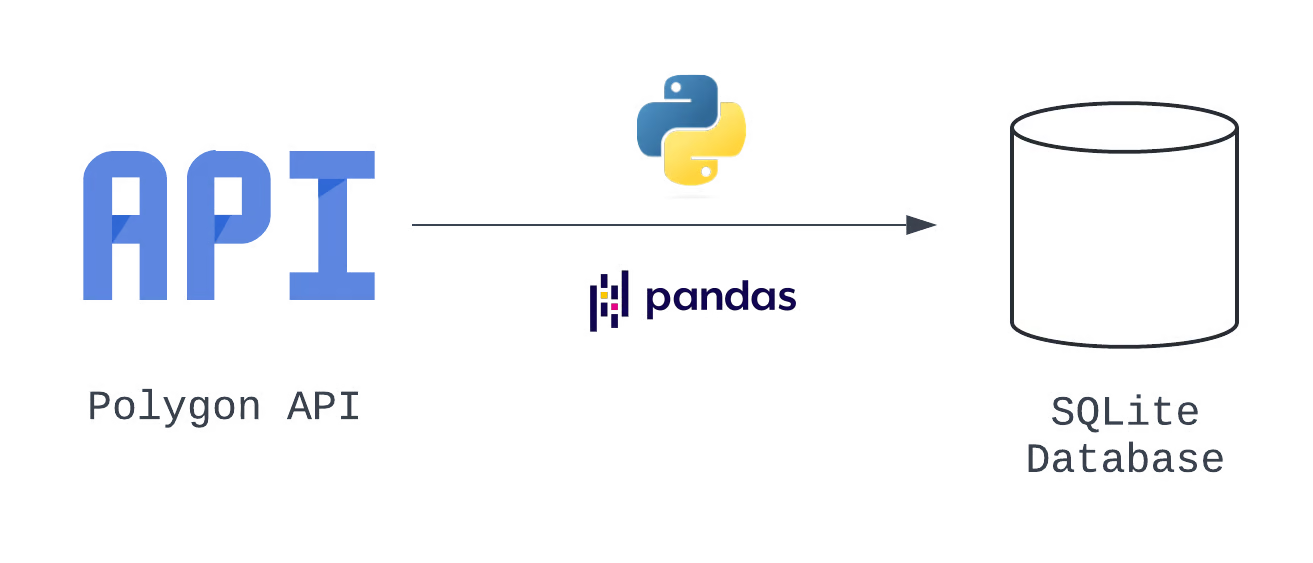 Architekturdiagramm
Mit diesen Zusatzinfos haben wir ein Architekturdiagramm erstellt, also eine grobe visuelle Darstellung unseres Systems. Man sieht drei logische Schritte, die dem E, T und L unseres Prozesses entsprechen.
Diese Aufgaben lassen sich auch als gerichteter azyklischer Graph, kurz DAG, abbilden. Ein DAG definiert in Airflow die Gesamtheit der auszuführenden Tasks, ihre Reihenfolge und Abhängigkeiten. Mehr über DAGs erfährst du im Introduction to Data Engineering Course, der Airflow-DAGs im Detail behandelt.
In Unternehmen werden dafür oft sogenannte Technical Specifications (Tech Specs) genutzt, um Designentscheidungen festzuhalten. Für unseren Zweck reicht eine Tabelle, die die Designentscheidungen für unsere Pipeline dokumentiert.
|
Operator-Typ |
Task-ID |
Notizen |
|---|---|---|
|
Extract |
hit_polygon_api |
TaskFlow API nutzen und eine Python-Funktion erstellen, die authentifiziert, die Polygon API aufruft und die Antwort zurückgibt |
|
Transform |
flatten_market_data |
Die von hit_polygon_api zurückgegebenen Daten flatten und für das Laden nach SQLite vorbereiten |
|
Load |
load_market_data |
Die geflatteten Daten nach SQLite laden |
Entscheidungen zur Datenpipeline
Beachte, dass unser DAG sich auf Tasks im Detail konzentriert und nicht jede Information abdeckt. Mit einer zweiten Tabelle halten wir zusätzliche Punkte fest. Unsere Fragen sind unter anderem:
|
Parameter |
Wert |
|---|---|
|
DAG-ID |
market_etl |
|
Startdatum |
1. Januar 2024 (9:00 Uhr UTC) |
|
Intervall |
Täglich |
|
Catchup? |
True (alle Daten seit dem 1. Januar 2024 laden) |
|
Parallelität |
1 DAG zur gleichen Zeit |
|
Task-Retries, Retry-Verzögerung |
3 Retries, jeweils 5 Minuten Verzögerung |
|
Mehrere Stock Ticker? |
Dynamisch erzeugte DAGs |
Offene Fragen klären
Fassen wir zusammen: Wir haben ein Architekturdiagramm erstellt, die Pipeline in Airflow-Tasks heruntergebrochen und die wichtigsten Informationen zur DAG-Konfiguration identifiziert.
Wenn du mehr über das Design, die Entwicklung und das Testen von Datenpipelines lernen möchtest, schau dir DataCamps Introduction to Data Pipelines an. Dort lernst du die Grundlagen zum Aufbau von ETL-Pipelines mit Python sowie Best Practices, um Lösungen robust, fehlertolerant und wiederverwendbar zu machen.
Wir gehen die Schritte der ETL-Pipeline nacheinander durch. Diese Struktur stellt sicher, dass jede Phase sauber umgesetzt wird.
Bevor wir Daten über die Polygon API abrufen, brauchen wir ein API-Token. Besuche dazu Polygon und klicke auf Create API Key. Für dieses Tutorial ist kein kostenpflichtiges Abo nötig – der Free-Tarif liefert einen API Key und alle benötigten Funktionen. Vergiss nicht, deinen API Key zu kopieren und sicher zu speichern.
Mit dem API Key können wir nun beginnen, mit Airflow Daten aus der Polygon API zu extrahieren. Dabei hilft uns die Tech-Specs-Tabelle mit den Details zur DAG-Konfiguration.
from airflow import DAG
from datetime import datetime, timedelta

with DAG(
    dag_id="market_etl",
    start_date=datetime(2024, 1, 1, 9),
    schedule="@daily",
    catchup=True,
    max_active_runs=1,
    default_args={
        "retries": 3,
        "retry_delay": timedelta(minutes=5)
    }
) as dag:
Fügen wir die erste Task hinzu. Wir nutzen die TaskFlow API und das Modul requests, um Open-Close-Daten für Aktien aus der Polygon API zu ziehen.
import requests
...
@task()

def hit_polygon_api(**context):
    # Instantiate a list of tickers that will be pulled and looped over
    stock_ticker = "AMZN"
    # Set variables
    polygon_api_key= "<your-api-key>"
  ds = context.get("ds")

  # Create the URL
    url= f"<https://api.polygon.io/v1/open-close/{stock_ticker}/{ds}?adjusted=true&apiKey={polygon_api_key}>"
    response = requests.get(url)
    # Return the raw data
    return response.json()
Ein paar Hinweise zum Code:
hit_polygon_api ist mit @task dekoriert. Der Decorator macht daraus eine Airflow-Task, die als Teil eines DAGs ausgeführt werden kann.context ist in der Signatur von hit_polygon_api definiert und wird genutzt, um den Wert am Schlüssel ds zu holen.context ist ein Dictionary mit Metadaten zur Task und zum DAG.ds aus dem context-Dictionary erhalten wir das Datum des data_interaval_end im Format YYYY-mm-dd. hit_polygon_api aufrufen.In Summe sieht der Code für den ersten Teil unserer ETL-Pipeline so aus:
from airflow import DAG
from airflow.decorators import task
from datetime import datetime, timedelta import requests

with DAG(
    dag_id="market_etl",
    start_date=datetime(2024, 1, 1, 9),
    schedule="@daily",
    catchup=False,
    max_active_runs=1,
    default_args={
        "retries": 3,
        "retry_delay": timedelta(minutes=5)
    }
) as dag:
    # Create a task using the TaskFlow API
    @task()
    def hit_polygon_api(**context):
        # Instantiate a list of tickers that will be pulled and looped over
        stock_ticker = "AMZN"
        # Set variables
        polygon_api_key = "<your-api-key>"
        ds = context.get("ds")
        # Create the URL
        url = f"<https://api.polygon.io/v1/open-close/{stock_ticker}/{ds}?adjusted=true&apiKey={polygon_api_key}>"
        response = requests.get(url)
        # Return the raw data
        return response.json()
    hit_polygon_api()
Du wirst feststellen, dass die Antwort für den 1. Januar 2024 einen Fehler enthält. Da der Markt an diesem Tag geschlossen war, meldet Polygon eine Ausnahme. Darum kümmern wir uns im nächsten Schritt.
Nachdem die Daten aus der Polygon API extrahiert sind, transformieren wir sie.
Dazu erstellen wir eine weitere Task mit der TaskFlow API. Diese Task heißt flatten_market_data und hat die Parameter polygon_response (die Rohdaten von hit_polygon_api) und **context. Den Parameter polygon_response schauen wir uns gleich genauer an.
Die eigentliche Transformation ist unkompliziert: Wir flatten das JSON der Polygon API in eine Liste. Der Clou: Für jeden Schlüssel vergeben wir einen sinnvollen Defaultwert, falls er in der Antwort fehlt.
Fehlt zum Beispiel der Schlüssel from, verwenden wir einen Defaultwert aus dem Airflow-Context. So beheben wir das zuvor gesehene Problem, wenn der Markt geschlossen ist und nur wenige Schlüssel zurückgegeben werden. Anschließend wandeln wir die Liste in ein pandas-DataFrame um und geben es zurück. Die Task sieht so aus:
@task
def flatten_market_data(polygon_response, **context):
    # Create a list of headers and a list to store the normalized data in
    columns = {
        "status": "closed",
        "from": context.get("ds"),
        "symbol": "AMZN",
        "open": None,
        "high": None,
        "low": None,
        "close": None,
        "volume": None
    }
    # Create a list to append the data to
    flattened_record = []
    for header_name, default_value in columns.items():
        # Append the data
        flattened_record.append(polygon_response.get(header_name, default_value))
    # Convert to a pandas DataFrame
    flattened_dataframe = pd.DataFrame([flattened_record], columns=columns.keys())
    return flattened_dataframe
Wir müssen nun eine Abhängigkeit zwischen den Tasks hit_polygon_api und flatten_market_data herstellen. Dazu aktualisieren wir den DAG-Code wie folgt:
import pandas as pd
with DAG(
    dag_id="market_etl",
    start_date=datetime(2024, 1, 1, 9),
    schedule="@daily",
    catchup=True,
    max_active_runs=1,
    default_args={
        "retries": 3,
        "retry_delay": timedelta(minutes=5)
    }
) as dag:
    @task()
    def hit_polygon_api(**context):
        ...
    @task
    def flatten_market_data(polygon_response, **context):
        # Create a list of headers and a list to store the normalized data in
        columns = {
            "status": None,
            "from": context.get("ds"),
            "symbol": "AMZN",
            "open": None,
            "high": None,
            "low": None,
            "close": None,
            "volume": None
        }
        # Create a list to append the data to
        flattened_record = []
        for header_name, default_value in columns.items():
            # Append the data
            flattened_record.append(polygon_response.get(header_name, default_value))
        # Convert to a pandas DataFrame
        flattened_dataframe = pd.DataFrame([flattened_record], columns=columns.keys())
        return flattened_dataframe
# Set dependencies
    raw_market_data = hit_polygon_api()
    flatten_market_data(raw_market_data)
Hier wird der Rückgabewert der Task hit_polygon_api in raw_market_data gespeichert. Danach wird raw_market_data als Argument polygon_response an flatten_market_data übergeben. So setzen wir nicht nur die Abhängigkeit zwischen den Tasks, sondern ermöglichen auch den Datenaustausch.
Auch wenn unsere Transformation simpel war: Airflow kann deutlich komplexere Manipulationen orchestrieren. Neben nativen Tasks lassen sich über zahlreiche Provider-Hooks und -Operatoren Tools wie AWS Lambda und DBT nahtlos einbinden.
Jetzt folgt der letzte Schritt unserer ETL-Pipeline. Geplant ist, eine SQLite-Datenbank zu verwenden und eine letzte Task mit der TaskFlow API zu definieren.
Wie zuvor definieren wir einen einzelnen Parameter für die Task: flattened_dataframe. Damit können die von flatten_market_data zurückgegebenen Daten in die neue Task übergeben werden.
Bevor wir den Code zum Laden in die SQLite-Datenbank schreiben, legen wir zuerst eine Verbindung in der Airflow-UI an. So öffnest du die Verbindungsseite:
Du landest auf einer Seite, die so aussieht:
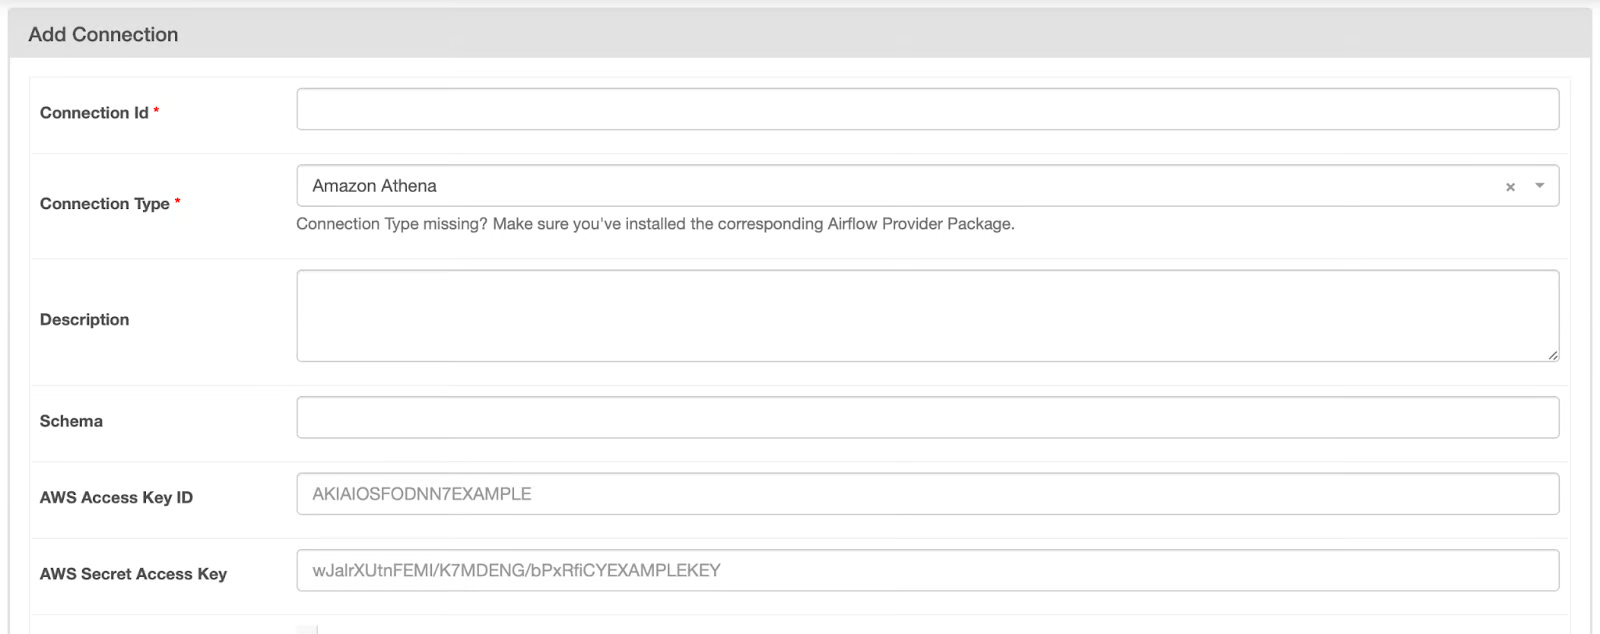 Airflow Connections-Seite
So füllst du die Verbindung aus:
Die Konfiguration sollte wie im folgenden Bild aussehen. Klicke anschließend auf Save.
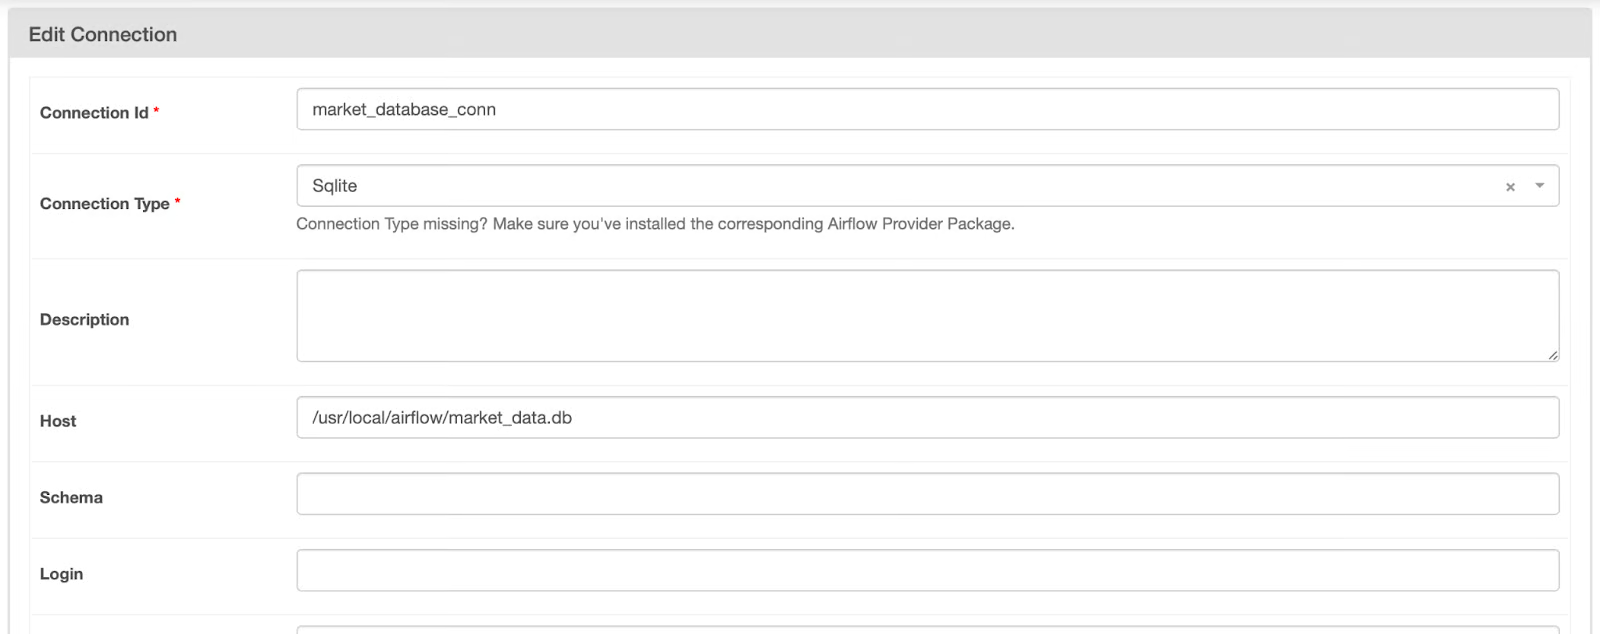 Ungespeicherte Airflow-Verbindung zu SQLite
Jetzt können wir die Verbindung in unserer Task über den SqliteHook abrufen. Sieh dir den folgenden Code an.
from airflow.providers.sqlite.hooks.sqlite import SqliteHook@task
def load_market_data(flattened_dataframe):
# Pull the connection
market_database_hook = SqliteHook("market_database_conn")
market_database_conn = market_database_hook.get_sqlalchemy_engine()
# Load the table to Postgres, replace if it exists
flattened_dataframe.to_sql(
name="market_data",
con=market_database_conn,
if_exists="append",
index=False
)
# print(market_database_hook.get_records("SELECT * FROM market_data;"))Damit stellen wir die Verbindung zur zuvor konfigurierten SQLite-Datenbank her. Über .get_sqlalchemy_engine() holen wir uns die Engine aus dem Hook und übergeben sie als Argument an den Parameter con, wenn wir auf flattened_dataframe die Methode .to_sql() aufrufen.
Die Daten werden in die Tabelle market_data geschrieben und an bestehende Einträge angehängt. Beim Testen prüfe ich gern, ob Daten geschrieben wurden, indem ich die Datensätze abfrage und ausgebe. Kommentiere dazu die letzte Zeile dieser Task ein.
Alles zusammengefügt, sieht unser Code so aus:
from airflow import DAG
from airflow.decorators import task
from airflow.providers.sqlite.hooks.sqlite import SqliteHook
from datetime import datetime, timedelta
import requests
import pandas as pd

with DAG(
    dag_id="market_etl",
    start_date=datetime(2024, 1, 1, 9),
    schedule="@daily",
    catchup=True,
    max_active_runs=1,
    default_args={
        "retries": 3,
        "retry_delay": timedelta(minutes=5)
    }
) as dag:
    # Create a task using the TaskFlow API
    @task()
    def hit_polygon_api(**context):
        # Instantiate a list of tickers that will be pulled and looped over
        stock_ticker = "AMZN"
        # Set variables
        polygon_api_key = "<your-api-key>"
        ds = context.get("ds")
        # Create the URL
        url = f"<https://api.polygon.io/v1/open-close/{stock_ticker}/{ds}?adjusted=true&apiKey={polygon_api_key}>"
        response = requests.get(url)
        # Return the raw data
        return response.json()
    @task
    def flatten_market_data(polygon_response, **context):
        # Create a list of headers and a list to store the normalized data in
        columns = {
            "status": None,
            "from": context.get("ds"),
            "symbol": "AMZN",
            "open": None,
            "high": None,
            "low": None,
            "close": None,
            "volume": None
        }
        # Create a list to append the data to
        flattened_record = []
        for header_name, default_value in columns.items():
            # Append the data
            flattened_record.append(polygon_response.get(header_name, default_value))
        # Convert to a pandas DataFrame
        flattened_dataframe = pd.DataFrame([flattened_record], columns=columns.keys())
        return flattened_dataframe
    @task
    def load_market_data(flattened_dataframe):
        # Pull the connection
        market_database_hook = SqliteHook("market_database_conn")
        market_database_conn = market_database_hook.get_sqlalchemy_engine()
        # Load the table to SQLite, append if it exists
        flattened_dataframe.to_sql(
            name="market_data",
            con=market_database_conn,
            if_exists="append",
            index=False
        )
    # Set dependencies between tasks
    raw_market_data = hit_polygon_api()
    transformed_market_data = flatten_market_data(raw_market_data)
    load_market_data(transformed_market_data)
Erneut haben wir die Abhängigkeiten so gesetzt, dass die Daten aus flatten_market_data an load_market_data übergeben werden. Die Graph-Ansicht unseres DAGs sieht dann so aus:
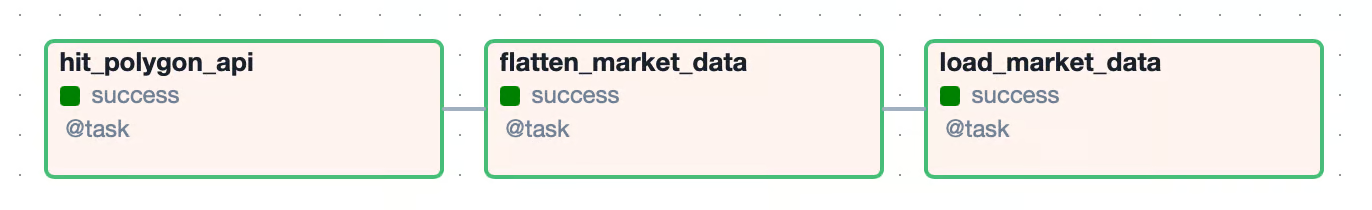 Graph-Ansicht der ETL-Pipeline
Jetzt, wo du deinen ersten Airflow-DAG gebaut hast, wird es Zeit zu prüfen, ob alles funktioniert. Eine gängige Methode ist der End-to-End-Lauf des DAGs.
Dafür wechselst du in der Airflow-UI zu deinem DAG und stellst den Schalter von blau auf active. Da catchup auf True steht, wird ein DAG-Run in die Queue gestellt und gestartet. Wenn eine Task erfolgreich war, wird ihr Kasten in der UI grün. Sind alle Tasks erfolgreich, wird der DAG als success markiert und der nächste Lauf ausgelöst.
Schlägt eine Task fehl, ist der Status up for retry und gelb markiert. In dem Fall schaust du dir am besten die Logs der Task an: Klicke im Grid auf das gelbe Feld und wähle Logs. Dort findest du die Exception-Meldung und kannst mit der Analyse beginnen. Überschreitet eine Task die definierte Anzahl an Retries, werden Task und DAG als failed markiert.
Neben End-to-End-Tests erleichtert Airflow auch das Schreiben von Unit-Tests. Beim Anlegen der Umgebung mit astro dev start wird ein Verzeichnis tests/ erstellt. Dort kannst du Unit-Tests für deinen DAG und seine Komponenten hinzufügen.
Unten siehst du einen Unit-Test für die Konfiguration unseres DAGs. Der Test prüft Parameter wie start_date, schedule und catchup. Nachdem du den Test geschrieben hast, gehe ins Projekt-Root und führe aus:
from airflow.models.dagbag import DagBag
from datetime import datetime
import pytz

def test_market_etl_config():
    # Pull the DAG
    market_etl_dag = DagBag().get_dag("market_etl")
    # Assert start date, schedule, and catchup
    assert market_etl_dag.start_date == datetime(2024, 3, 25, 9, tzinfo=pytz.UTC)
    assert market_etl_dag.schedule_interval == "@daily"
    assert market_etl_dag.catchup
astro dev pytestDieser Befehl führt alle Unit-Tests im Verzeichnis tests/ aus. Wenn du nur einen bestimmten Test starten möchtest, übergib den Dateipfad als Argument. Neben der Astro CLI kannst du auch jeden anderen Python-Test-Runner für Unit-Tests verwenden.
Für private Projekte helfen Unit-Tests, die erwartete Funktion sicherzustellen. In Unternehmen sind sie fast immer Pflicht. Die meisten Datenteams nutzen ein CI/CD-Tool für das Deployment ihres Airflow-Projekts. Dabei werden typischerweise Unit-Tests ausgeführt und deren Ergebnisse geprüft, um sicherzustellen, dass der DAG produktionsreif ist. Mehr zu Unit-Tests findest du in unserem Tutorial How to Use Pytest for Unit Testing und im Kurs Introduction to Testing in Python.
Wir haben eine einfache, funktionierende Datenpipeline gebaut – inklusive Transformation und Persistenz. In anderen Szenarien orchestriert Airflow mithilfe von Provider- und Custom-Operatoren komplexe Workflows und verarbeitet Terabytes an Daten.
Beispiele sind der S3ToSnowflakeOperator und der DatabricksRunNowOperator, die die Integration in einen größeren Datenstack erleichtern. Solche Operatoren sind in Hobby-Umgebungen allerdings schwer zu testen. Um etwa den S3ToSnowflakeOperator zu nutzen, brauchst du AWS- und Snowflake-Accounts und entsprechende Ressourcen-Konfigurationen.
Neben ETL-Workflows unterstützt Airflow auch ELT-Workflows, die sich bei Teams mit Cloud-Data-Warehouses zunehmend durchsetzen. Behalte das bei der Pipeline-Gestaltung im Hinterkopf.
Im Load-Schritt unserer Pipeline haben wir eine Verbindung zu SQLite erstellt und darüber Daten persistiert. Connections, teils auch Secrets genannt, sind ein Airflow-Feature, das Interaktionen mit Quellen und Zielen vereinfacht. Wenn du dort sensible Infos wie deinen Polygon API Key ablegst, erhöhst du die Sicherheit deines Codes und trennst Zugangsdaten sauber vom Code. Nutze Connections, wo immer möglich, um Workflows sicher und übersichtlich zu halten.
Vielleicht ist dir aufgefallen, dass der Stock Ticker „AMZN“ in unseren Tasks hit_polygon_api und flatten_market_data hartkodiert war. So konnten wir ETL für genau diesen Ticker durchführen. Was aber, wenn du mehrere Ticker verarbeiten willst? Zum Glück lassen sich DAGs leicht dynamisch generieren. Mit wenig Refactoring kannst du über eine Liste von Tickern iterieren und die Werte parameterisieren. Dadurch werden DAGs modularer und portabler. Mehr dazu findest du in der Astronomer-Dokumentation Dynamically Generate DAGs in Airflow.
Glückwunsch! Du hast mit Python, pandas und SQLite einen Airflow-DAG gebaut, der Börsendaten über die Polygon API extrahiert, transformiert und lädt. Unterwegs hast du deine Fähigkeiten beim Erstellen von Architekturdiagrammen und Tech Specs, beim Anlegen von Airflow-Connections und beim Testen von DAGs ausgebaut. Vertiefe dein Airflow-Wissen mit fortgeschrittenen Techniken, um deine Pipelines robust, fehlertolerant und wiederverwendbar zu machen.
Hier findest du weitere Ressourcen:
Lerne Data Engineering mit Datacamp
Lernpfad
Kurs
Kurs