Cursus
Introductie tot Python
4 uur
7.1M
Voer de code van deze tutorial online uit en bewerk deze
Code uitvoerenEen Markovketen is een wiskundig systeem, meestal gedefinieerd als een verzameling willekeurige variabelen, dat volgens bepaalde probabilistische regels van de ene naar de andere toestand overgaat. Deze set van overgangen voldoet aan de Markov-eigenschap, die stelt dat de kans om naar een bepaalde toestand over te gaan uitsluitend afhangt van de huidige toestand en de verstreken tijd, en niet van de reeks toestanden die eraan voorafging. Deze unieke eigenschap maakt Markovprocessen geheugenloos.
Meer statistiek in Python aanpakken? Bekijk de DataCamp-cursus Statistical Thinking in Python!
Laten we overstappen…
Markovketens worden veel gebruikt in de wiskunde. Ze worden breed ingezet in economie, speltheorie, communicatietheorie, genetica en financiën. Ze komen veel voor in statistische, met name Bayesiaanse, en informatie-theoretische contexten. Voor realistische problemen worden ze gebruikt om oplossingen te formuleren voor onder meer cruisecontrols in auto’s, rijen of wachtrijen van klanten op een luchthaven, wisselkoersen van valuta’s, enzovoort. Het algoritme bekend als PageRank, oorspronkelijk voorgesteld voor de zoekmachine Google, is gebaseerd op een Markovproces. Reddits Subreddit Simulator is een volledig geautomatiseerde subreddit die willekeurige posts en reacties genereert met Markovketens — zo cool!
Een Markovketen is een willekeurig proces met de Markov-eigenschap. Een willekeurig (stochastisch) proces is een wiskundig object gedefinieerd als een verzameling willekeurige variabelen. Een Markovketen heeft ofwel een discrete toestandsruimte (de set mogelijke waarden van de willekeurige variabelen) of een discrete indexset (vaak tijd) — gegeven dit feit bestaan er vele varianten van een Markovketen. Meestal wordt de term “Markovketen” gereserveerd voor een proces met een discrete set tijdstippen, oftewel een Discrete-tijd Markovketen (DTMC).
Een discrete-tijd Markovketen beschrijft een systeem dat zich bij elke stap in een bepaalde toestand bevindt, waarbij de toestand willekeurig tussen stappen verandert. De stappen worden vaak gezien als momenten in de tijd (maar je kunt net zo goed verwijzen naar fysieke afstand of een andere discrete maat). Een discrete-tijd Markovketen is een rij willekeurige variabelen X1, X2, X3, … met de Markov-eigenschap, zó dat de kans om naar de volgende toestand te gaan alleen afhangt van de huidige toestand en niet van de voorgaande toestanden. In probabilistische notatie:
Pr( Xn+1 = x | X1 = x1, X2 = x2, …, Xn = xn) = Pr( Xn+1 = x | Xn = xn)
Zoals je ziet, hangt de kans op Xn+1 alleen af van de kans op de eraan voorafgaande Xn. Dat betekent dat kennis van de vorige toestand voldoende is om de kansverdeling van de huidige toestand te bepalen, wat voldoet aan de regel van conditionele onafhankelijkheid (of anders gezegd: je hoeft alleen de huidige toestand te kennen om de volgende te bepalen).
De mogelijke waarden van Xi vormen een aftelbare verzameling S, de toestandsruimte van de keten. De toestandsruimte kan van alles zijn: letters, cijfers, basketbaluitslagen of weersomstandigheden. Hoewel de tijdsparameter meestal discreet is, heeft de toestandsruimte van een discrete-tijd Markovketen geen algemeen aanvaarde beperkingen en verwijst ze eerder naar een proces op een willekeurige toestandsruimte. Toch gebruiken veel toepassingen eindige of aftelbaar oneindige toestandsruimten, omdat die statistisch eenvoudiger te analyseren zijn.
Een Markovketen wordt weergegeven met een probabilistische automaat (klinkt lastiger dan het is!). De veranderingen van toestand in het systeem heten transities. De kansen die horen bij verschillende toestandsovergangen heten transitiekansen. Een probabilistische automaat verwerkt de kans van een gegeven overgang in de transitiefunctie, die zo een transitiematrix wordt.
Je kunt het zien als een reeks gerichte grafen, waarbij de randen van graaf n gelabeld zijn met de kansen om van een toestand op tijd n naar toestanden op tijd n+1 te gaan, Pr(Xn+1 = x | Xn = xn). Je kunt dit lezen als: de kans om naar toestand Xn+1 te gaan, gegeven de waarde van toestand Xn. Dezelfde informatie wordt weergegeven door de transitiematrix van tijd n naar tijd n+1. Elke toestand in de toestandsruimte komt één keer voor als rij en nog eens als kolom, en elke cel in de matrix geeft de kans aan om van de toestand van de rij naar de toestand van de kolom over te gaan.
Als de Markovketen N mogelijke toestanden heeft, is de matrix een N x N-matrix, waarbij element (I, J) de kans is om van toestand I naar toestand J over te gaan. Daarnaast moet de transitiematrix een stochastische matrix zijn: de elementen in elke rij moeten exact tot 1 optellen. Waarom? Omdat elke rij zijn eigen kansverdeling representeert.
Het model wordt dus gekarakteriseerd door een toestandsruimte, een transitiematrix die de kansen van specifieke overgangen beschrijft, en een initiële toestand over de toestandsruimte, gegeven in de beginverdeling.
Een heleboel woorden, hè?
Laten we een eenvoudig voorbeeld bekijken om de concepten te snappen:
Als Cj verdrietig is, wat niet vaak voorkomt: dan gaat ze of hardlopen, werkt een bak ijs naar binnen of doet een dutje.
Uit historische data: als ze een verdrietige dag slapend doorbracht, is de volgende dag de kans 60% dat ze gaat hardlopen, 20% dat ze in bed blijft en 20% dat ze zich te buiten gaat aan ijs.
Als ze verdrietig is en gaat hardlopen, is er 60% kans dat ze de volgende dag weer gaat hardlopen, 30% dat ze zich vergrijpt aan ijs en slechts 10% kans dat ze de volgende dag gaat slapen.
Tot slot, als ze zich op een verdrietige dag tegoed doet aan ijs, is er slechts 10% kans dat ze de volgende dag weer ijs eet, 70% kans dat ze gaat hardlopen en 20% kans dat ze de volgende dag gaat slapen.
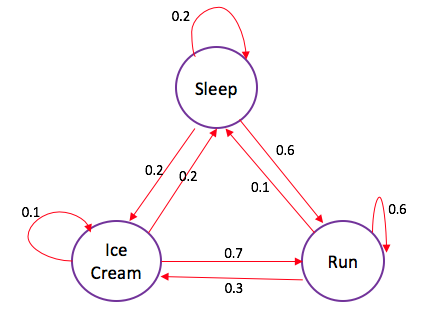
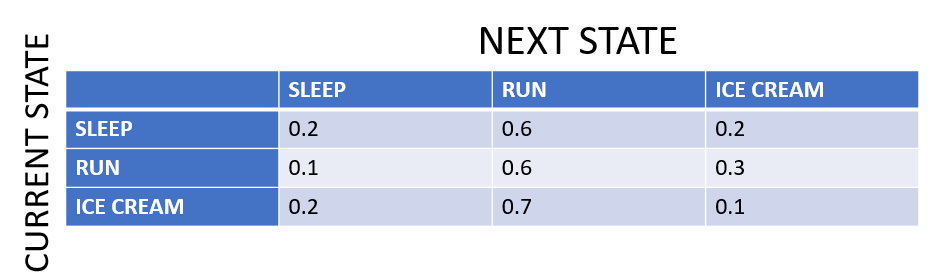
De Markovketen in het toestandsdiagram heeft 3 mogelijke toestanden: slapen, hardlopen, ijs. De transitiematrix is dus een 3 x 3-matrix. Merk op dat de pijlen die uit een toestand vertrekken altijd exact tot 1 optellen; op dezelfde manier moeten de elementen in elke rij van de transitiematrix exact tot 1 optellen — dit representeert een kansverdeling. In de transitiematrix doen de cellen hetzelfde als de pijlen in het toestandsdiagram.
Nu je het voorbeeld hebt gezien, heb je een idee van de verschillende concepten rond een Markovketen. Maar hoe en waar kun je deze theorie in het echt gebruiken?
Met het voorbeeld dat je zag, kun je nu vragen beantwoorden als: "Als je start in de toestand: slapen, wat is dan de kans dat Cj aan het einde van een verdrietige periode van 2 dagen aan het hardlopen is (toestand: hardlopen)?"
Laten we dit uitwerken: Om van toestand: slapen naar toestand: hardlopen te gaan, moet Cj ofwel de eerste zet (of dag) in toestand: slapen blijven en dan de volgende (tweede) zet naar toestand: hardlopen gaan (0,2 $\cdot$ 0,6); of de eerste dag naar toestand: hardlopen gaan en daar de tweede dag blijven (0,6 $\cdot$ 0,6); of ze kan bij de eerste zet naar toestand: ijs gaan en bij de tweede naar toestand: hardlopen (0,2 $\cdot$ 0,7). Dus de kans: ((0,2 $\cdot$ 0,6) + (0,6 $\cdot$ 0,6) + (0,2 $\cdot$ 0,7)) = 0,62. We kunnen dus zeggen dat er 62% kans is dat Cj na twee dagen verdrietig te zijn geweest in toestand: hardlopen is, als ze begon in toestand: slapen.
Hopelijk geeft dit je een idee van de verschillende vragen die je met een Markovketennetwerk kunt beantwoorden.
Met dit helder voor ogen wordt het ook makkelijker om enkele belangrijke eigenschappen van Markovketens te begrijpen:
Tip: wil je ook een visuele uitleg van Markovketens zien, bezoek dan deze pagina.
Laten we het bovenstaande voorbeeld in Python coderen. En hoewel je in de praktijk waarschijnlijk een bibliotheek zou gebruiken die Markovketens veel efficiënter codeert, helpt de code je op weg…
Laten we eerst een paar bibliotheken importeren die je gaat gebruiken.
import numpy as np
import random as rm
Definieer nu de toestanden en hun kansen: de transitiematrix. Onthoud: de matrix wordt een 3 x 3-matrix omdat je drie toestanden hebt. Ook moet je de transitiepaden definiëren; dat kan ook met matrices.
# The statespace
states = ["Sleep","Icecream","Run"]

# Possible sequences of events
transitionName = [["SS","SR","SI"],["RS","RR","RI"],["IS","IR","II"]]

# Probabilities matrix (transition matrix)
transitionMatrix = [[0.2,0.6,0.2],[0.1,0.6,0.3],[0.2,0.7,0.1]]
Oh, zorg er altijd voor dat de kansen optellen tot 1. En het kan geen kwaad om foutmeldingen achter te laten, in elk geval tijdens het coderen!
if sum(transitionMatrix[0])+sum(transitionMatrix[1])+sum(transitionMatrix[1]) != 3:
    print("Somewhere, something went wrong. Transition matrix, perhaps?")
else: print("All is gonna be okay, you should move on!! ;)")
All is gonna be okay, you should move on!! ;)
Nu de echte code. Je gebruikt numpy.random.choice om een willekeurige steekproef te trekken uit de set mogelijke transities. De meeste argumenten spreken voor zich, maar p mogelijk niet. Dat is een optioneel argument waarmee je de kansverdeling voor de steekproefset kunt opgeven; in dit geval is dat de transitiematrix.
# A function that implements the Markov model to forecast the state/mood.
def activity_forecast(days):
    # Choose the starting state
    activityToday = "Sleep"
    print("Start state: " + activityToday)
    # Shall store the sequence of states taken. So, this only has the starting state for now.
    activityList = [activityToday]
    i = 0
    # To calculate the probability of the activityList
    prob = 1
    while i != days:
        if activityToday == "Sleep":
            change = np.random.choice(transitionName[0],replace=True,p=transitionMatrix[0])
            if change == "SS":
                prob = prob * 0.2
                activityList.append("Sleep")
                pass
            elif change == "SR":
                prob = prob * 0.6
                activityToday = "Run"
                activityList.append("Run")
            else:
                prob = prob * 0.2
                activityToday = "Icecream"
                activityList.append("Icecream")
        elif activityToday == "Run":
            change = np.random.choice(transitionName[1],replace=True,p=transitionMatrix[1])
            if change == "RR":
                prob = prob * 0.5
                activityList.append("Run")
                pass
            elif change == "RS":
                prob = prob * 0.2
                activityToday = "Sleep"
                activityList.append("Sleep")
            else:
                prob = prob * 0.3
                activityToday = "Icecream"
                activityList.append("Icecream")
        elif activityToday == "Icecream":
            change = np.random.choice(transitionName[2],replace=True,p=transitionMatrix[2])
            if change == "II":
                prob = prob * 0.1
                activityList.append("Icecream")
                pass
            elif change == "IS":
                prob = prob * 0.2
                activityToday = "Sleep"
                activityList.append("Sleep")
            else:
                prob = prob * 0.7
                activityToday = "Run"
                activityList.append("Run")
        i += 1
    print("Possible states: " + str(activityList))
    print("End state after "+ str(days) + " days: " + activityToday)
    print("Probability of the possible sequence of states: " + str(prob))

# Function that forecasts the possible state for the next 2 days
activity_forecast(2)
Start state: Sleep
Possible states: ['Sleep', 'Sleep', 'Run']
End state after 2 days: Run
Probability of the possible sequence of states: 0.12
Je krijgt een willekeurige set mogelijke transities met de kans daarop, beginnend in toestand: Sleep. Breid het programma uit om het bijvoorbeeld een paar honderd keer te herhalen met dezelfde begintoestand; dan kun je de verwachte kans zien om in een bepaalde toestand te eindigen, met de bijbehorende kans. Laten we de functie activity_forecast herschrijven en er nieuwe lussen aan toevoegen om dit te doen…
def activity_forecast(days):
    # Choose the starting state
    activityToday = "Sleep"
    activityList = [activityToday]
    i = 0
    prob = 1
    while i != days:
        if activityToday == "Sleep":
            change = np.random.choice(transitionName[0],replace=True,p=transitionMatrix[0])
            if change == "SS":
                prob = prob * 0.2
                activityList.append("Sleep")
                pass
            elif change == "SR":
                prob = prob * 0.6
                activityToday = "Run"
                activityList.append("Run")
            else:
                prob = prob * 0.2
                activityToday = "Icecream"
                activityList.append("Icecream")
        elif activityToday == "Run":
            change = np.random.choice(transitionName[1],replace=True,p=transitionMatrix[1])
            if change == "RR":
                prob = prob * 0.5
                activityList.append("Run")
                pass
            elif change == "RS":
                prob = prob * 0.2
                activityToday = "Sleep"
                activityList.append("Sleep")
            else:
                prob = prob * 0.3
                activityToday = "Icecream"
                activityList.append("Icecream")
        elif activityToday == "Icecream":
            change = np.random.choice(transitionName[2],replace=True,p=transitionMatrix[2])
            if change == "II":
                prob = prob * 0.1
                activityList.append("Icecream")
                pass
            elif change == "IS":
                prob = prob * 0.2
                activityToday = "Sleep"
                activityList.append("Sleep")
            else:
                prob = prob * 0.7
                activityToday = "Run"
                activityList.append("Run")
        i += 1
    return activityList

# To save every activityList
list_activity = []
count = 0

# `Range` starts from the first count up until but excluding the last count
for iterations in range(1,10000):
        list_activity.append(activity_forecast(2))

# Check out all the `activityList` we collected
#print(list_activity)

# Iterate through the list to get a count of all activities ending in state:'Run'
for smaller_list in list_activity:
    if(smaller_list[2] == "Run"):
        count += 1

# Calculate the probability of starting from state:'Sleep' and ending at state:'Run'
percentage = (count/10000) * 100
print("The probability of starting at state:'Sleep' and ending at state:'Run'= " + str(percentage) + "%")
The probability of starting at state:'Sleep' and ending at state:'Run'= 62.419999999999995%
Hoe benaderen we de gewenste 62%?
Opmerking Dit is eigenlijk de “wet van de grote aantallen”, een probabilistisch principe dat stelt dat de frequenties van gebeurtenissen met gelijke waarschijnlijkheid uitmiddelen, maar alleen als er genoeg proeven of instanties zijn. Met andere woorden: naarmate het aantal experimenten toeneemt, zal de werkelijke verhouding van uitkomsten convergeren naar de theoretische of verwachte verhouding van uitkomsten.
Hiermee is de tutorial over Markovketens afgerond. Je hebt kennisgemaakt met Markovketens en enkele van hun eigenschappen gezien. Eenvoudige Markovketens zijn een van de basisonderwerpen om te beginnen met data science in Python. Wil je meer bronnen om met statistiek in Python aan de slag te gaan, bekijk dan zeker deze pagina.
Wil je meer praktische casestudy’s verkennen met statistiek in Python? Bekijk dan DataCamp’s cursussen Case Studies in Statistical Thinking of Network Analysis in Python.
Python-cursussen
Cursus
Cursus
Cursus
blog
Adel Nehme
15 min

