Cours
Introduction à Python
4 h
7M
Exécutez et modifiez le code de ce tutoriel en ligne
Exécuter le codeUne chaîne de Markov est un système mathématique généralement défini comme un ensemble de variables aléatoires qui passent d’un état à un autre selon certaines règles probabilistes. Cet ensemble de transitions satisfait la propriété de Markov, qui stipule que la probabilité de passer à un état donné ne dépend que de l’état actuel et du temps écoulé, et non de la suite des états précédents. Cette caractéristique rend les processus de Markov sans mémoire.
Vous voulez aller plus loin en statistiques avec Python ? Découvrez le cours Statistical Thinking in Python de DataCamp !
Passons à la suite…
Les chaînes de Markov sont largement utilisées en mathématiques. On les retrouve en économie, théorie des jeux, théorie de la communication, génétique et finance. Elles apparaissent fréquemment en statistiques, notamment en statistiques bayésiennes, ainsi que dans des contextes liés à la théorie de l’information. Côté applications, elles servent à modéliser des solutions pour l’étude des systèmes de régulation de vitesse dans les véhicules, des files d’attente d’un aéroport, des taux de change, etc. L’algorithme PageRank, proposé initialement pour le moteur de recherche Google, repose sur un processus de Markov. Le Subreddit Simulator de Reddit est un subreddit entièrement automatisé qui génère des publications et commentaires aléatoires à l’aide de chaînes de Markov — plutôt cool !
Une chaîne de Markov est un processus aléatoire doté de la propriété de Markov. Un processus aléatoire (ou stochastique) est un objet mathématique défini comme un ensemble de variables aléatoires. Une chaîne de Markov possède soit un espace d’états discret (ensemble des valeurs possibles des variables aléatoires), soit un indice discret (souvent le temps) — d’où l’existence de nombreuses variantes. En général, le terme « chaîne de Markov » est réservé aux processus indexés par des instants discrets : on parle alors de chaîne de Markov en temps discret (DTMC).
Une chaîne de Markov en temps discret modélise un système qui, à chaque étape, se trouve dans un certain état, l’état changeant aléatoirement entre les étapes. Les étapes sont souvent vues comme des instants (mais il peut aussi s’agir d’une distance physique ou de toute autre mesure discrète). Une chaîne de Markov en temps discret est une suite de variables aléatoires X1, X2, X3, … avec la propriété de Markov, telle que la probabilité de passer à l’état suivant ne dépend que de l’état présent et pas des états passés. Formellement :
Pr( Xn+1 = x | X1 = x1, X2 = x2, …, Xn = xn) = Pr( Xn+1 = x | Xn = xn)
Comme vous le voyez, la probabilité de Xn+1 ne dépend que de Xn, l’état qui le précède. Autrement dit, la connaissance de l’état immédiatement précédent suffit pour déterminer la loi de probabilité de l’état courant, ce qui satisfait la règle d’indépendance conditionnelle (ou, dit autrement : il suffit de connaître l’état actuel pour déterminer le suivant).
Les valeurs possibles des Xi forment un ensemble dénombrable S appelé espace d’états de la chaîne. L’espace d’états peut être n’importe quoi : des lettres, des nombres, des scores de basket ou des conditions météo. Si le temps est généralement discret, l’espace d’états d’une chaîne de Markov en temps discret n’est pas soumis à des contraintes universelles, et renvoie plutôt à un processus sur un espace d’états arbitraire. Cependant, beaucoup d’applications emploient des espaces d’états finis ou dénombrablement infinis, car leur analyse statistique est plus directe.
Une chaîne de Markov se représente à l’aide d’un automate probabiliste (le terme paraît plus compliqué qu’il ne l’est !). Les changements d’état du système sont appelés transitions. Les probabilités associées à ces changements sont les probabilités de transition. Un automate probabiliste intègre la probabilité d’une transition donnée dans la fonction de transition, ce qui donne une matrice de transition.
Vous pouvez l’imaginer comme une suite de graphes orientés, où les arêtes du graphe n portent les probabilités de passer d’un état au temps n aux autres états au temps n+1, Pr(Xn+1 = x | Xn = xn). Cela se lit : probabilité d’aller à l’état Xn+1 sachant la valeur de l’état Xn. La même information est donnée par la matrice de transition du temps n au temps n+1. Chaque état de l’espace d’états apparaît une fois en ligne et une fois en colonne, et chaque cellule de la matrice indique la probabilité de passer de l’état de la ligne à l’état de la colonne.
Si la chaîne de Markov a N états possibles, la matrice est de taille N x N, l’entrée (I, J) étant la probabilité de passer de l’état I à l’état J. De plus, la matrice de transition doit être stochastique, c’est-à-dire que les éléments de chaque ligne doivent sommer exactement à 1. Pourquoi ? Parce que chaque ligne représente une distribution de probabilité.
Le modèle est donc caractérisé par un espace d’états, une matrice de transition décrivant les probabilités de transitions, et un état initial sur l’espace d’états, défini par la distribution initiale.
Beaucoup de mots, n’est-ce pas ?
Voyons un exemple simple pour ancrer les concepts :
Quand Cj est triste, ce qui n’est pas très fréquent, elle va soit courir, soit dévorer une glace, soit faire une sieste.
D’après les données historiques, si elle a passé une journée de tristesse à dormir, il y a 60 % de chances qu’elle aille courir le lendemain, 20 % qu’elle reste au lit et 20 % qu’elle se rue sur la glace.
Quand elle est triste et part courir, il y a 60 % de chances qu’elle recoure le lendemain, 30 % qu’elle se jette sur la glace et seulement 10 % qu’elle passe la journée suivante à dormir.
Enfin, lorsqu’elle se laisse tenter par une glace un jour de tristesse, il n’y a que 10 % de chances qu’elle en reprenne le lendemain, 70 % de chances qu’elle aille courir et 20 % qu’elle dorme le jour suivant.
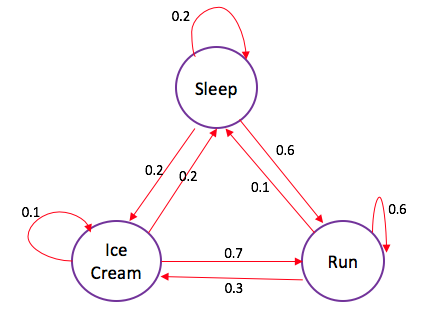
La chaîne de Markov représentée sur le diagramme d’états comporte 3 états possibles : sleep, run, icecream. La matrice de transition est donc une matrice 3 x 3. Remarquez que la somme des probabilités sortant d’un état vaut toujours 1 ; de même, la somme des entrées de chaque ligne de la matrice de transition doit être exactement 1 — car il s’agit d’une distribution de probabilité. Dans la matrice, les cellules jouent le même rôle que les flèches dans le diagramme d’états.
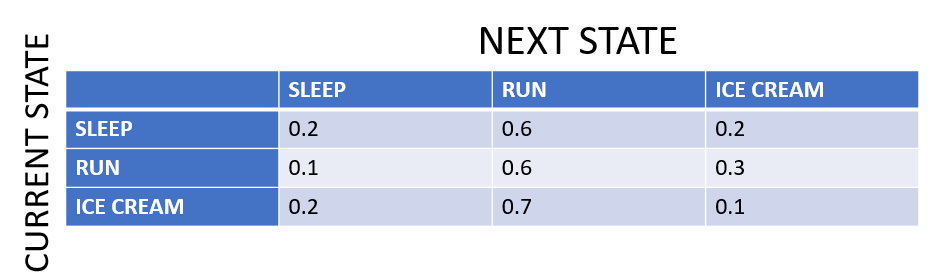
Après cet exemple, vous avez une idée des différents concepts liés aux chaînes de Markov. Mais comment et où les utiliser concrètement ?
Avec cet exemple, vous pouvez répondre à des questions comme : « En partant de l’état : sleep, quelle est la probabilité que Cj soit en train de courir (état : run) au bout de 2 jours tristes ? »
Calculons : pour passer de l’état : sleep à l’état : run, Cj peut soit rester en sleep au premier pas (ou jour), puis passer à run au second (0,2 $\cdot$ 0,6) ; soit passer à run dès le premier jour et y rester le second (0,6 $\cdot$ 0,6) ; soit aller à icecream au premier pas puis à run au second (0,2 $\cdot$ 0,7). La probabilité vaut donc : ((0,2 $\cdot$ 0,6) + (0,6 $\cdot$ 0,6) + (0,2 $\cdot$ 0,7)) = 0,62. Autrement dit, il y a 62 % de chances que Cj soit en état : run après deux jours de tristesse, si elle a commencé en état : sleep.
Vous voyez ainsi le type de questions auxquelles une chaîne de Markov permet de répondre.
Avec ces bases, il est plus simple de comprendre quelques propriétés importantes des chaînes de Markov :
Astuce : pour une explication visuelle des chaînes de Markov, consultez cette page.
Essayons de coder l’exemple ci-dessus en Python. En pratique, vous utiliseriez sans doute une bibliothèque dédiée, plus efficace, mais ce code vous mettra le pied à l’étrier…
Commençons par importer quelques bibliothèques.
import numpy as np
import random as rm
Définissons maintenant les états et leurs probabilités : la matrice de transition. Rappelez-vous, la matrice sera 3 X 3 car vous avez trois états. Vous devez aussi définir les chemins de transition, ce que vous pouvez faire avec des matrices également.
# The statespace
states = ["Sleep","Icecream","Run"]

# Possible sequences of events
transitionName = [["SS","SR","SI"],["RS","RR","RI"],["IS","IR","II"]]

# Probabilities matrix (transition matrix)
transitionMatrix = [[0.2,0.6,0.2],[0.1,0.6,0.3],[0.2,0.7,0.1]]
Assurez-vous toujours que les probabilités somment à 1. Et n’hésitez pas à prévoir des messages d’erreur — surtout en codant !
if sum(transitionMatrix[0])+sum(transitionMatrix[1])+sum(transitionMatrix[1]) != 3:
    print("Somewhere, something went wrong. Transition matrix, perhaps?")
else: print("All is gonna be okay, you should move on!! ;)")
All is gonna be okay, you should move on!! ;)
Passons au cœur du sujet. Vous utiliserez numpy.random.choice pour générer un échantillon aléatoire parmi l’ensemble des transitions possibles. La plupart des arguments sont explicites, mais le paramètre p l’est moins : il s’agit d’un argument optionnel permettant de fournir la distribution de probabilité de l’ensemble d’échantillonnage, ici la matrice de transition.
# A function that implements the Markov model to forecast the state/mood.
def activity_forecast(days):
    # Choose the starting state
    activityToday = "Sleep"
    print("Start state: " + activityToday)
    # Shall store the sequence of states taken. So, this only has the starting state for now.
    activityList = [activityToday]
    i = 0
    # To calculate the probability of the activityList
    prob = 1
    while i != days:
        if activityToday == "Sleep":
            change = np.random.choice(transitionName[0],replace=True,p=transitionMatrix[0])
            if change == "SS":
                prob = prob * 0.2
                activityList.append("Sleep")
                pass
            elif change == "SR":
                prob = prob * 0.6
                activityToday = "Run"
                activityList.append("Run")
            else:
                prob = prob * 0.2
                activityToday = "Icecream"
                activityList.append("Icecream")
        elif activityToday == "Run":
            change = np.random.choice(transitionName[1],replace=True,p=transitionMatrix[1])
            if change == "RR":
                prob = prob * 0.5
                activityList.append("Run")
                pass
            elif change == "RS":
                prob = prob * 0.2
                activityToday = "Sleep"
                activityList.append("Sleep")
            else:
                prob = prob * 0.3
                activityToday = "Icecream"
                activityList.append("Icecream")
        elif activityToday == "Icecream":
            change = np.random.choice(transitionName[2],replace=True,p=transitionMatrix[2])
            if change == "II":
                prob = prob * 0.1
                activityList.append("Icecream")
                pass
            elif change == "IS":
                prob = prob * 0.2
                activityToday = "Sleep"
                activityList.append("Sleep")
            else:
                prob = prob * 0.7
                activityToday = "Run"
                activityList.append("Run")
        i += 1
    print("Possible states: " + str(activityList))
    print("End state after "+ str(days) + " days: " + activityToday)
    print("Probability of the possible sequence of states: " + str(prob))

# Function that forecasts the possible state for the next 2 days
activity_forecast(2)
Start state: Sleep
Possible states: ['Sleep', 'Sleep', 'Run']
End state after 2 days: Run
Probability of the possible sequence of states: 0.12
Vous obtenez un ensemble aléatoire de transitions possibles, avec la probabilité associée, en partant de l’état : Sleep. Étendez le programme pour l’itérer quelques centaines de fois avec le même état initial : vous observerez alors la probabilité attendue de terminer dans un état particulier. Réécrivons la fonction activity_forecast et ajoutons quelques boucles pour le faire…
def activity_forecast(days):
    # Choose the starting state
    activityToday = "Sleep"
    activityList = [activityToday]
    i = 0
    prob = 1
    while i != days:
        if activityToday == "Sleep":
            change = np.random.choice(transitionName[0],replace=True,p=transitionMatrix[0])
            if change == "SS":
                prob = prob * 0.2
                activityList.append("Sleep")
                pass
            elif change == "SR":
                prob = prob * 0.6
                activityToday = "Run"
                activityList.append("Run")
            else:
                prob = prob * 0.2
                activityToday = "Icecream"
                activityList.append("Icecream")
        elif activityToday == "Run":
            change = np.random.choice(transitionName[1],replace=True,p=transitionMatrix[1])
            if change == "RR":
                prob = prob * 0.5
                activityList.append("Run")
                pass
            elif change == "RS":
                prob = prob * 0.2
                activityToday = "Sleep"
                activityList.append("Sleep")
            else:
                prob = prob * 0.3
                activityToday = "Icecream"
                activityList.append("Icecream")
        elif activityToday == "Icecream":
            change = np.random.choice(transitionName[2],replace=True,p=transitionMatrix[2])
            if change == "II":
                prob = prob * 0.1
                activityList.append("Icecream")
                pass
            elif change == "IS":
                prob = prob * 0.2
                activityToday = "Sleep"
                activityList.append("Sleep")
            else:
                prob = prob * 0.7
                activityToday = "Run"
                activityList.append("Run")
        i += 1
    return activityList

# To save every activityList
list_activity = []
count = 0

# `Range` starts from the first count up until but excluding the last count
for iterations in range(1,10000):
        list_activity.append(activity_forecast(2))

# Check out all the `activityList` we collected
#print(list_activity)

# Iterate through the list to get a count of all activities ending in state:'Run'
for smaller_list in list_activity:
    if(smaller_list[2] == "Run"):
        count += 1

# Calculate the probability of starting from state:'Sleep' and ending at state:'Run'
percentage = (count/10000) * 100
print("The probability of starting at state:'Sleep' and ending at state:'Run'= " + str(percentage) + "%")
The probability of starting at state:'Sleep' and ending at state:'Run'= 62.419999999999995%
Comment avons-nous approché la valeur de 62 % attendue ?
Remarque : c’est la « loi des grands nombres », un principe probabiliste selon lequel les fréquences d’événements de même probabilité tendent à s’égaliser, mais seulement si le nombre d’essais est suffisamment grand. En d’autres termes, à mesure que le nombre d’expériences augmente, le ratio observé des issues converge vers le ratio théorique attendu.
Ce tutoriel sur les chaînes de Markov touche à sa fin. Vous avez découvert les chaînes de Markov et certaines de leurs propriétés. Les chaînes de Markov simples font partie des fondamentaux pour démarrer en data science avec Python. Pour d’autres ressources afin de débuter en statistiques avec Python, n’hésitez pas à consulter cette page.
Envie d’explorer des études de cas plus pratiques en statistiques avec Python ? Découvrez les cours Case Studies in Statistical Thinking ou Network Analysis in Python de DataCamp.
Cours Python
Cours
Cours
Cours