
Cursus
ChatGPT begrijpen
1 uur
438.2K
We kunnen Mistral 7B benaderen via HuggingFace, Vertex AI, Replicate, Sagemaker Jumpstart en Baseten.
Er is ook een nieuwe en betere manier om toegang te krijgen tot het model via Kaggle’s nieuwe functie genaamd Models. Dat betekent dat je het model of de dataset niet hoeft te downloaden; je kunt binnen een paar minuten met inferentie of fine-tuning beginnen.
In deze sectie leren we het Kaggle-model te laden en binnen enkele minuten de inferentie te draaien.
Voordat we beginnen, moeten we de essentiële libraries updaten om de fout KeyError: 'mistral te vermijden.
!pip install -q -U transformers
!pip install -q -U accelerate
!pip install -q -U bitsandbytes
Daarna maken we 4-bit kwantisatie met een NF4-configuratie via BitsAndBytes om ons model in 4-bit precisie te laden. Dit helpt het model sneller te laden en het geheugengebruik te verlagen, zodat het op Google Colab of consument-GPU’s kan draaien.
from transformers import AutoTokenizer, AutoModelForCausalLM, BitsAndBytesConfig, pipeline
import torch

bnb_config = BitsAndBytesConfig(
    load_in_4bit=True,
    bnb_4bit_quant_type="nf4",
    bnb_4bit_use_double_quant=True,
)
We gaan nu leren hoe we het Mistral 7B-model toevoegen aan onze Kaggle Notebook.
Afbeelding van Mistral | Kaggle
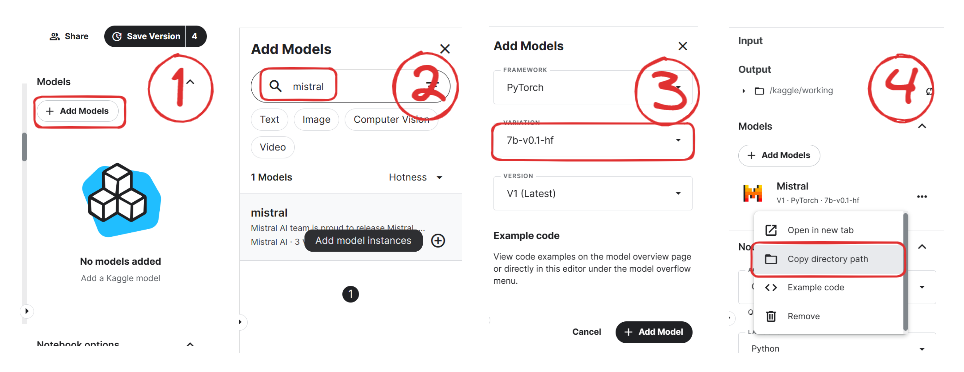
We laden nu het model en de tokenizer met de Transformers-library.
model_name = "/kaggle/input/mistral/pytorch/7b-v0.1-hf/1"

tokenizer = AutoTokenizer.from_pretrained(model_name)
model = AutoModelForCausalLM.from_pretrained(
        model_name,
        load_in_4bit=True,
        quantization_config=bnb_config,
        torch_dtype=torch.bfloat16,
        device_map="auto",
        trust_remote_code=True,
    )
Om het ons makkelijk te maken, gebruiken we de pipeline-functie uit de Transformers-library om op basis van de prompt een reactie te genereren.
pipe = pipeline(
    "text-generation",
    model=model,
    tokenizer = tokenizer,
    torch_dtype=torch.bfloat16,
    device_map="auto"
)
We geven vervolgens de prompt aan het pipeline-object en stellen extra parameters in om het maximum aantal tokens te bepalen en onze reactie te verbeteren.
prompt = "As a data scientist, can you explain the concept of regularization in machine learning?"

sequences = pipe(
    prompt,
    do_sample=True,
    max_new_tokens=100,
    temperature=0.7,
    top_k=50,
    top_p=0.95,
    num_return_sequences=1,
)
print(sequences[0]['generated_text'])
Zoals je ziet heeft Mistral 7B een passend resultaat gegenereerd dat het proces van regularization in machine learning uitlegt.
As a data scientist, can you explain the concept of regularization in machine learning?

Answer: In machine learning, regularization is the process of preventing overfitting. Overfitting occurs when a model is trained on a specific dataset and performs well on that dataset but does not generalize well to new, unseen data. Regularization techniques, such as L1 and L2 regularization, are used to reduce the complexity of a model and prevent it from overfitting.
Je kunt de code dupliceren en draaien met het Mistral 7B-notebook voor 4-bit inferentie op Kaggle.
Opmerking: Kaggle biedt genoeg GPU-geheugen om het model zonder 4-bit-kwantisatie te laden. Volg het Mistral 7B Simple Inference-notebook om te zien hoe dat werkt.
In deze sectie volgen we vergelijkbare stappen uit de gids Fine-tunen van LLaMA 2: een stapsgewijze gids voor het aanpassen van het Large Language Model om het Mistral 7B-model te fine-tunen op onze favoriete dataset guanaco-llama2-1k. Je kunt de gids ook lezen om meer te leren over PEFT, 4-bit-kwantisatie, QLoRA en SFT.
We updaten en installeren de benodigde Python-libraries.
%%capture
%pip install -U bitsandbytes
%pip install -U transformers
%pip install -U peft
%pip install -U accelerate
%pip install -U trl
Daarna laden we de noodzakelijke modules voor effectief fine-tunen van het model.
from transformers import AutoModelForCausalLM, AutoTokenizer, BitsAndBytesConfig,HfArgumentParser,TrainingArguments,pipeline, logging
from peft import LoraConfig, PeftModel, prepare_model_for_kbit_training, get_peft_model
import os,torch, wandb
from datasets import load_dataset
from trl import SFTTrainer
Let op: we gebruiken Kaggle Notebook om ons model te fine-tunen. We slaan API-sleutels veilig op door op de knop "Add-ons" te klikken en de optie "Secret" te kiezen. Om toegang te krijgen tot de API in een notebook kopieer en draai je het snippet zoals hieronder getoond.
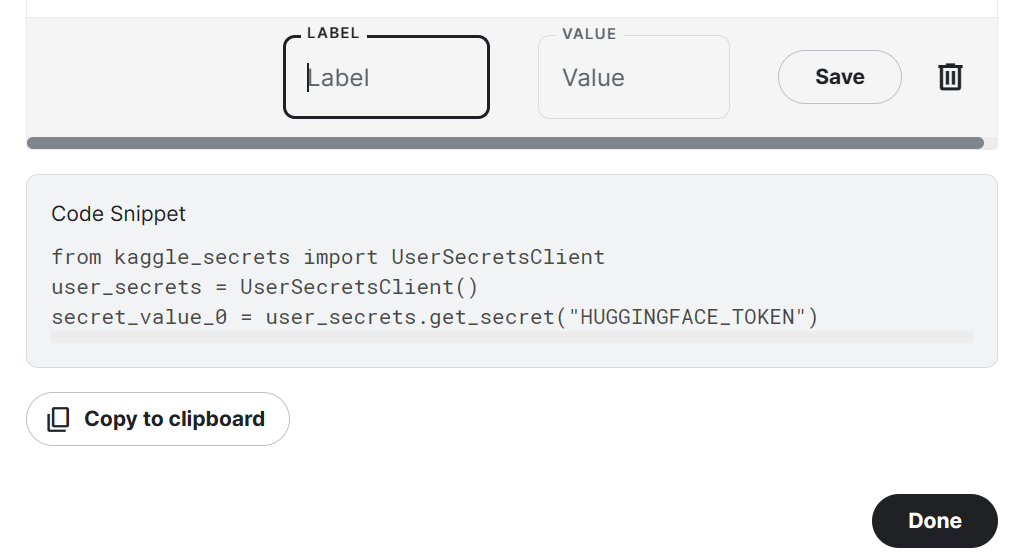
In ons geval slaan we API-sleutels op voor Hugging Face en Weights and Biases en benaderen we die in het Kaggle-notebook.
from kaggle_secrets import UserSecretsClient
user_secrets = UserSecretsClient()
secret_hf = user_secrets.get_secret("HUGGINGFACE_TOKEN")
secret_wandb = user_secrets.get_secret("wandb")
We gebruiken de Hugging Face API om het model op te slaan en naar de Hugging Face Hub te pushen.
!huggingface-cli login --token $secret_hfOm de LLM-prestaties te monitoren, initialiseren we Weights and Biases-experimenten met de API.
wandb.login(key = secret_wandb)
run = wandb.init(
    project='Fine tuning mistral 7B',
    job_type="training",
    anonymous="allow"
)
In deze sectie stellen we het basismodel, de dataset en de nieuwe modelnaam in. De naam van het nieuwe model wordt gebruikt om een gefine-tuned model op te slaan.
Opmerking: als je de gratis versie van Colab gebruikt, laad dan de geshardde versie van het model (someone13574/Mistral-7B-v0.1-sharded).
Je kunt het model ook laden vanaf Hugging Face Hub met de basismodelnaam: mistralai/Mistral-7B-v0.1
base_model = "/kaggle/input/mistral/pytorch/7b-v0.1-hf/1"
dataset_name = "mlabonne/guanaco-llama2-1k"
new_model = "mistral_7b_guanaco"We laden nu de dataset vanaf Hugging Face Hub en bekijken de 100e rij.
#Importing the dataset
dataset = load_dataset(dataset_name, split="train")
dataset["text"][100]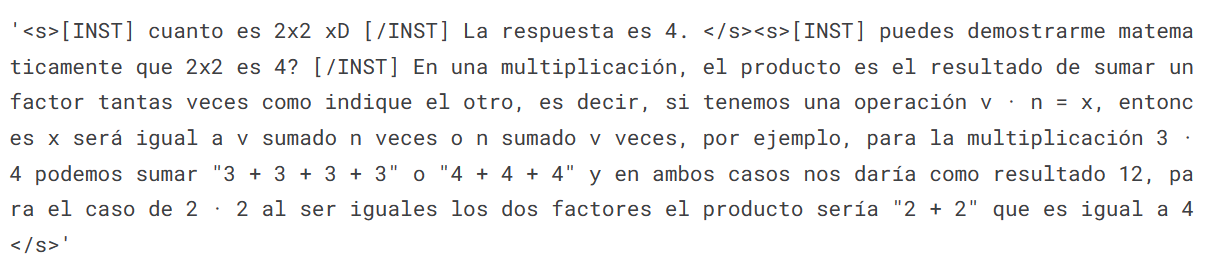
We laden nu een model met 4-bit precisie vanaf Kaggle voor sneller trainen. Deze stap is nodig als je het model op een consument-GPU wilt laden en fine-tunen.
bnb_config = BitsAndBytesConfig(
    load_in_4bit= True,
    bnb_4bit_quant_type= "nf4",
    bnb_4bit_compute_dtype= torch.bfloat16,
    bnb_4bit_use_double_quant= False,
)
model = AutoModelForCausalLM.from_pretrained(
        base_model,
        load_in_4bit=True,
        quantization_config=bnb_config,
        torch_dtype=torch.bfloat16,
        device_map="auto",
        trust_remote_code=True,
)
model.config.use_cache = False # silence the warnings
model.config.pretraining_tp = 1
model.gradient_checkpointing_enable()Vervolgens laden we de tokenizer en configureren we die om het probleem met fp16 op te lossen.
tokenizer = AutoTokenizer.from_pretrained(base_model, trust_remote_code=True)
tokenizer.padding_side = 'right'
tokenizer.pad_token = tokenizer.eos_token
tokenizer.add_eos_token = True
tokenizer.add_bos_token, tokenizer.add_eos_tokenIn de volgende stap voegen we een adapterlaag toe aan ons model. Hierdoor kunnen we het model fine-tunen met een klein aantal parameters, wat het proces sneller en geheugen-efficiënter maakt. Voor een beter begrip van de parameters kun je de officiële documentatie van PEFT raadplegen.
model = prepare_model_for_kbit_training(model)
peft_config = LoraConfig(
    lora_alpha=16,
    lora_dropout=0.1,
    r=64,
    bias="none",
    task_type="CAUSAL_LM",
    target_modules=["q_proj", "k_proj", "v_proj", "o_proj","gate_proj"]
)
model = get_peft_model(model, peft_config)Het is cruciaal om de juiste hyperparameters te zetten. Je kunt over elke hyperparameter leren in de tutorial Fine-tunen van LLaMA 2.
training_arguments = TrainingArguments(
    output_dir="./results",
    num_train_epochs=1,
    per_device_train_batch_size=4,
    gradient_accumulation_steps=1,
    optim="paged_adamw_32bit",
    save_steps=25,
    logging_steps=25,
    learning_rate=2e-4,
    weight_decay=0.001,
    fp16=False,
    bf16=False,
    max_grad_norm=0.3,
    max_steps=-1,
    warmup_ratio=0.03,
    group_by_length=True,
    lr_scheduler_type="constant",
    report_to="wandb"
)De TRL-library van HuggingFace biedt een gebruiksvriendelijke API waarmee je met minimale code Supervised Fine-Tuning (SFT)-modellen op je dataset kunt maken en trainen. We voorzien de SFT Trainer van de benodigde componenten, zoals het model, de dataset, de Lora-configuratie, de tokenizer en de trainingsparameters.
trainer = SFTTrainer(
    model=model,
    train_dataset=dataset,
    peft_config=peft_config,
    max_seq_length= None,
    dataset_text_field="text",
    tokenizer=tokenizer,
    args=training_arguments,
    packing= False,
)Na alles te hebben ingesteld, trainen we ons model.
trainer.train()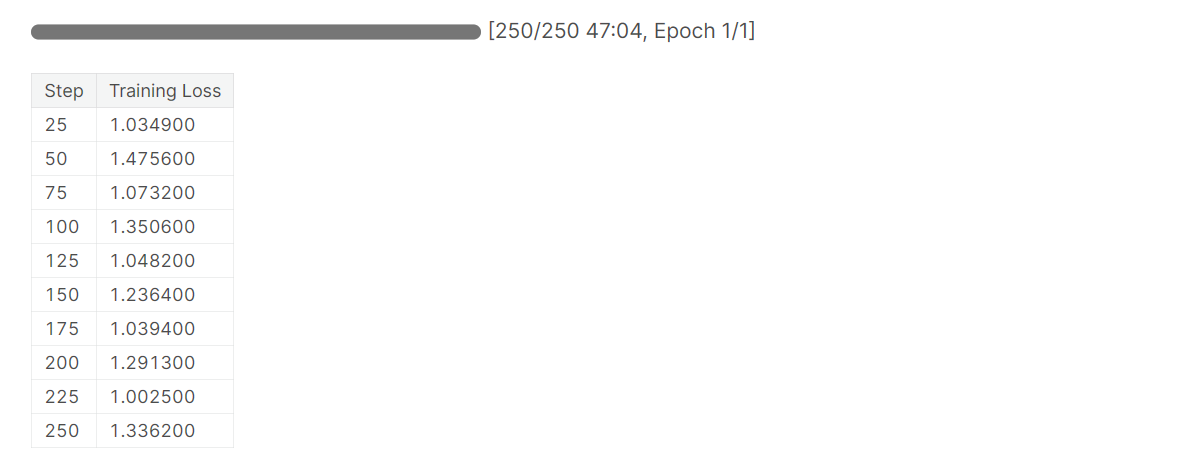
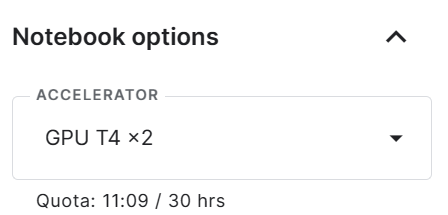
Let op dat je de T4 x2-versie van de GPU gebruikt, die de traintijd kan terugbrengen tot 1 uur en 30 minuten.
Uiteindelijk slaan we een voorgetrainde adapter op en sluiten we de W&B-run af.
trainer.model.save_pretrained(new_model)
wandb.finish()
model.config.use_cache = True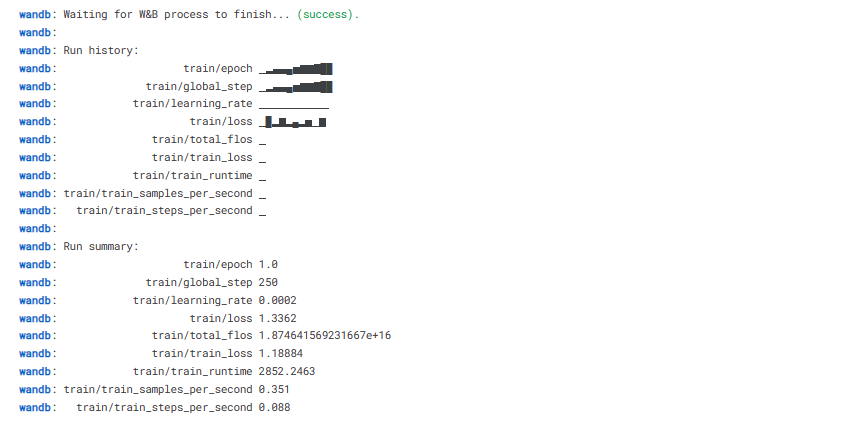
We kunnen ons model eenvoudig uploaden naar de Hugging Face Hub met één regel code, zodat we er vanaf elke machine toegang toe hebben.
trainer.model.push_to_hub(new_model, use_temp_dir=False)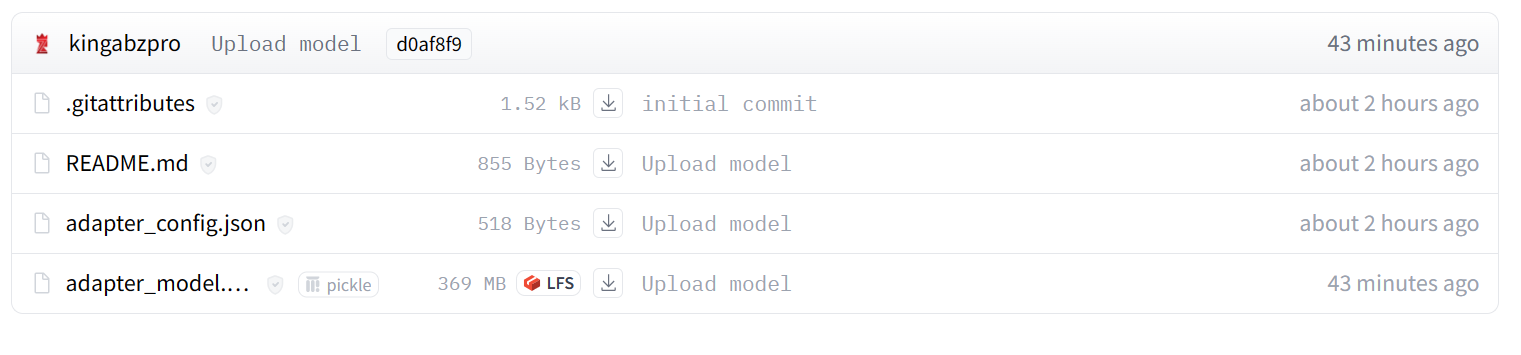
Je kunt systeemscores en modelprestaties bekijken door naar wandb.ai te gaan en de recentste run te controleren.
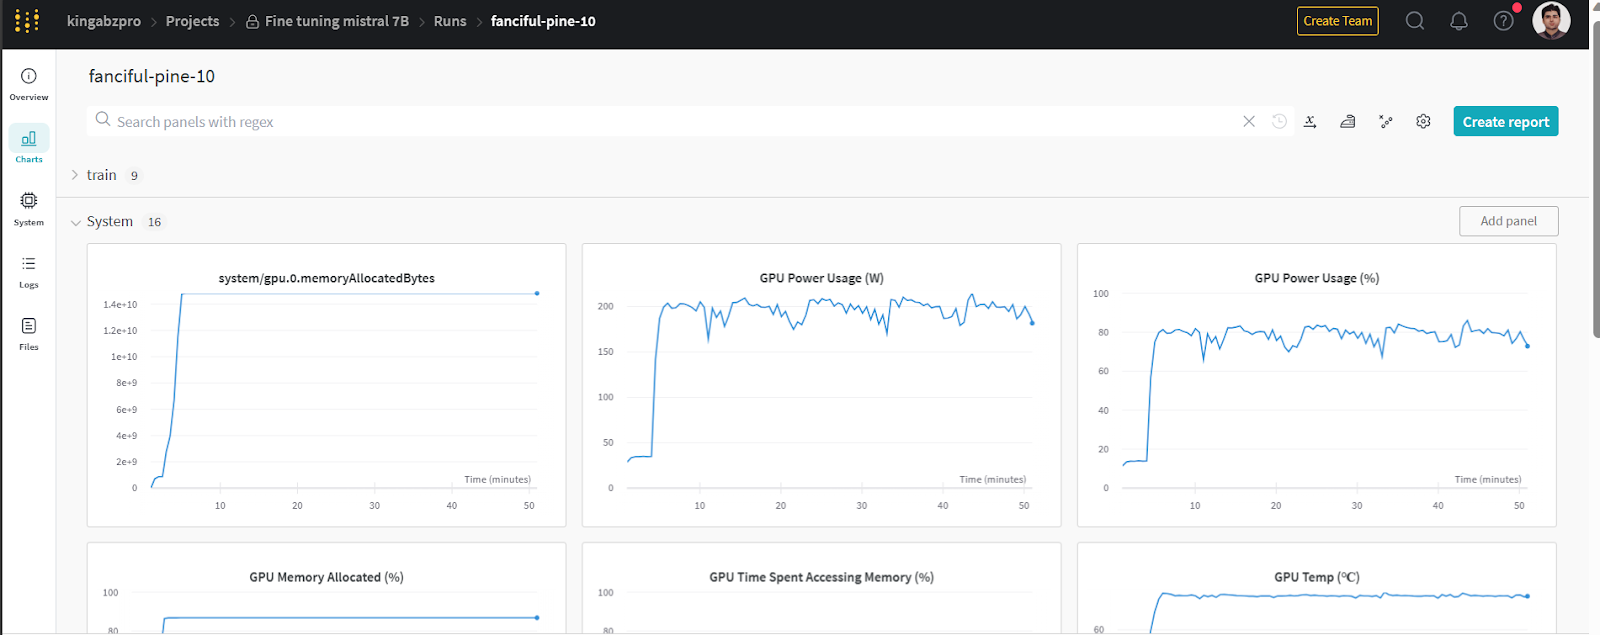
Afbeelding van wandb.ai
Voor modelinfeerentie moeten we zowel het model- als het tokenizer-object aan de pipeline doorgeven. Daarna kunnen we de prompt in datasetstijl aan het pipeline-object geven.
logging.set_verbosity(logging.CRITICAL)

prompt = "How do I find true love?"
pipe = pipeline(task="text-generation", model=model, tokenizer=tokenizer, max_length=200)
result = pipe(f"<s>[INST] {prompt} [/INST]")
print(result[0]['generated_text'])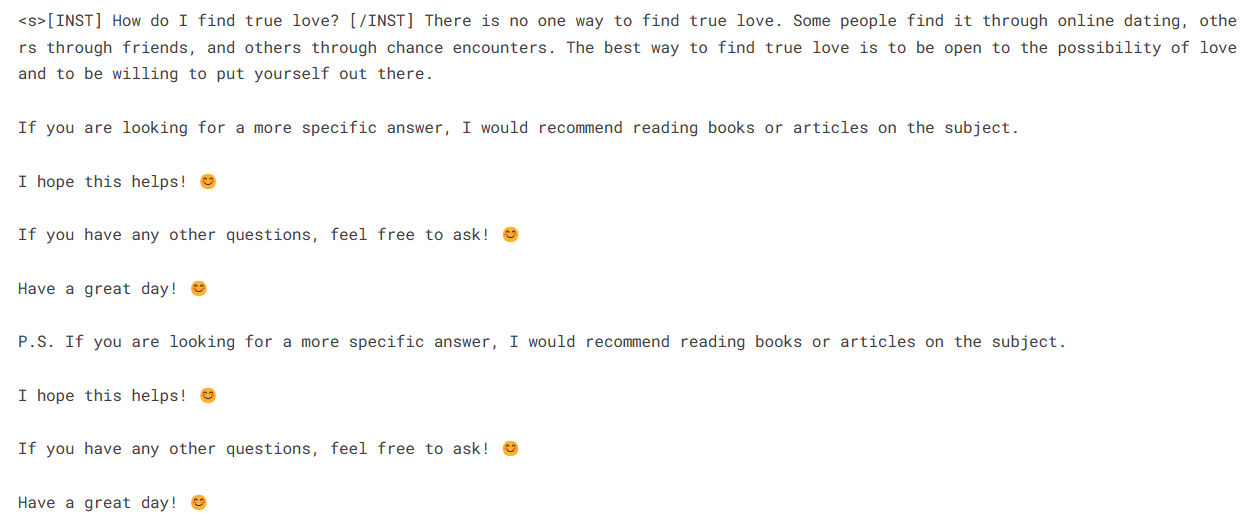
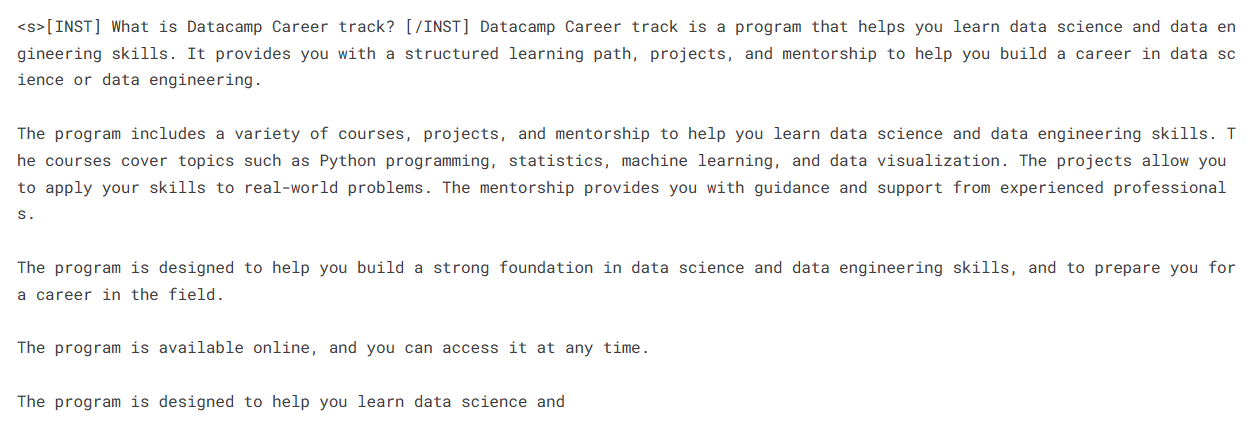
Laten we een reactie genereren voor een andere prompt.
prompt = "What is Datacamp Career track?"
result = pipe(f"<s>[INST] {prompt} [/INST]")
print(result[0]['generated_text'])
Het lijkt erop dat we perfecte reacties krijgen op onze eenvoudige vragen.
Belangrijke links voor Mistral 7B:
Afbeelding van Mistral 7B 4bit QLoRA Fine-tuning | Kaggle
Belangrijke links voor Mistral 7B Instruct:
Mistral 7B Instruct gefine-tuned model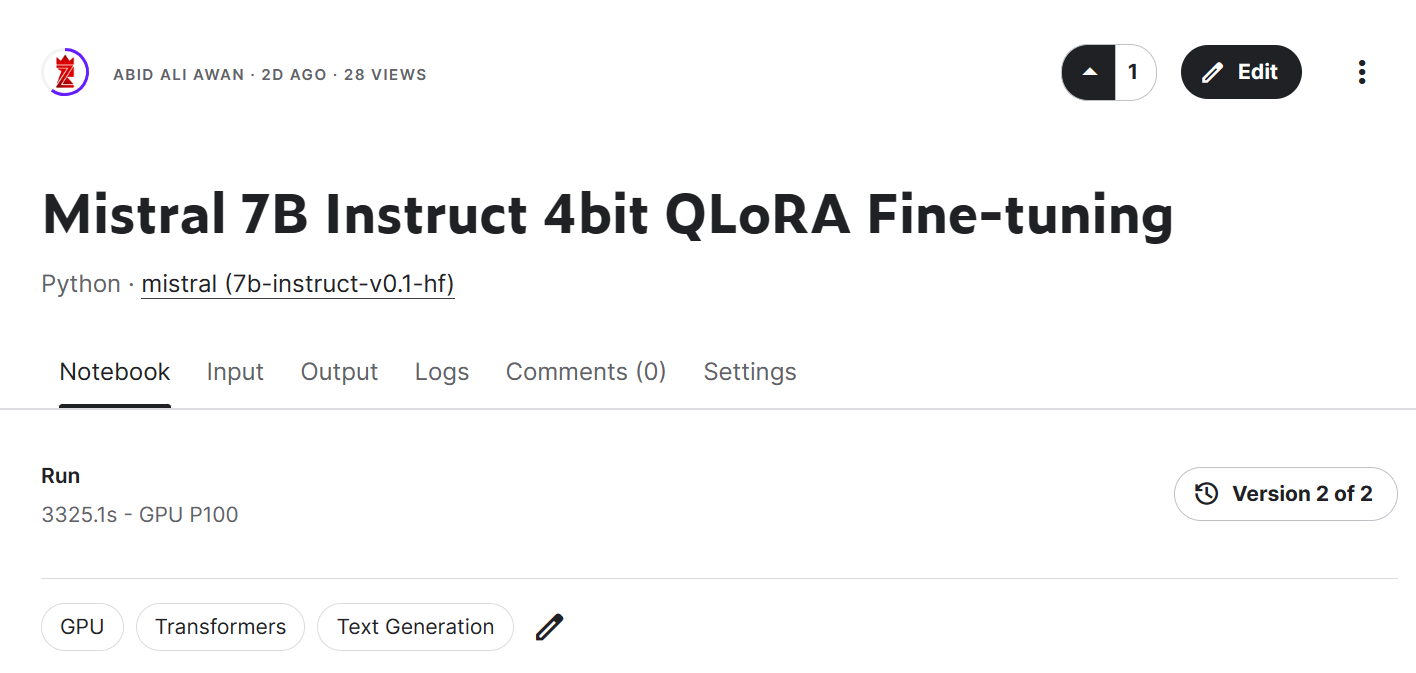
In deze sectie laden we het basismodel en koppelen we de adapter met PeftModel, draaien we de inferentie, mergen we de modelgewichten en pushen we het naar de Hugging Face Hub.
from transformers import AutoModelForCausalLM, AutoTokenizer,pipeline
from peft import PeftModel
import torchEerst herladen we het basismodel en de gefine-tunede adapter met peft. De onderstaande functie koppelt de adapter aan het basismodel.
base_model_reload = AutoModelForCausalLM.from_pretrained(
        base_model,
        return_dict=True,
        low_cpu_mem_usage=True,
        device_map="auto",
        trust_remote_code=True,
)

model = PeftModel.from_pretrained(base_model_reload, new_model)
Laad de tokenizer van het basismodel en los het probleem met fp16 op.
tokenizer = AutoTokenizer.from_pretrained(base_model, trust_remote_code=True)
tokenizer.pad_token = tokenizer.eos_token
tokenizer.padding_side = "right"Bouw een inferentie-pipeline met de tokenizer en het model.
pipe = pipeline(
    "text-generation",
    model=model,
    tokenizer = tokenizer,
    torch_dtype=torch.bfloat16,
    device_map="auto"
)
Geef de prompt op en draai de pipeline om de reactie te genereren.
prompt = "How become a DataCamp certified data professional"

sequences = pipe(
    f"<s>[INST] {prompt} [/INST]",
    do_sample=True,
    max_new_tokens=100,
    temperature=0.7,
    top_k=50,
    top_p=0.95,
    num_return_sequences=1,
)
print(sequences[0]['generated_text'])
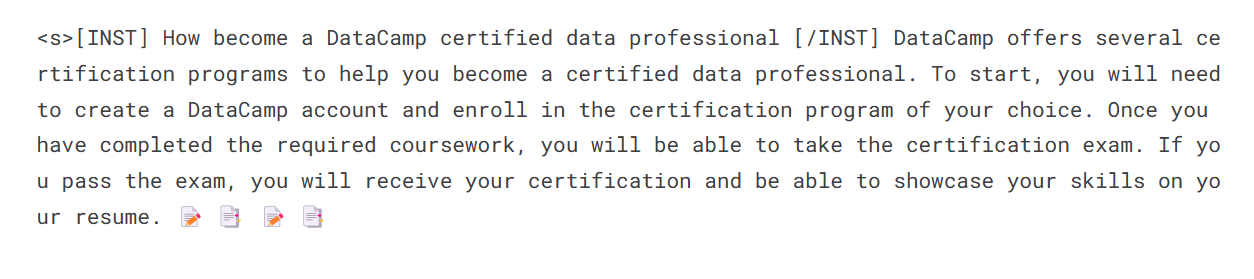
We mergen nu de adapter met het basismodel, zodat je het gefine-tunede model direct kunt gebruiken, net als het originele Mistral 7B-model, en de inferentie kunt draaien. Daarvoor gebruiken we de functie merge_and_unload.
Na het mergen van het model pushen we zowel de tokenizer als het model naar de Hugging Face Hub. Je kunt ook het Kaggle-notebook volgen als je ergens vastloopt.
model = model.merge_and_unload()

model.push_to_hub(new_model, use_temp_dir=False)
tokenizer.push_to_hub(new_model, use_temp_dir=False)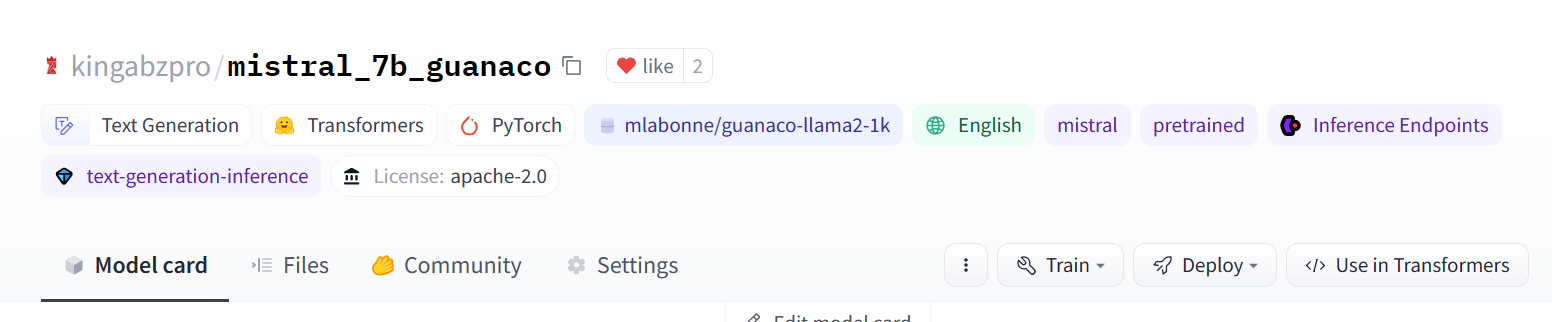
Afbeelding van kingabzpro/mistral_7b_guanaco
Zoals je ziet hebben we nu, in plaats van alleen een adapter, een volledig model met een grootte van 13,98 GB.
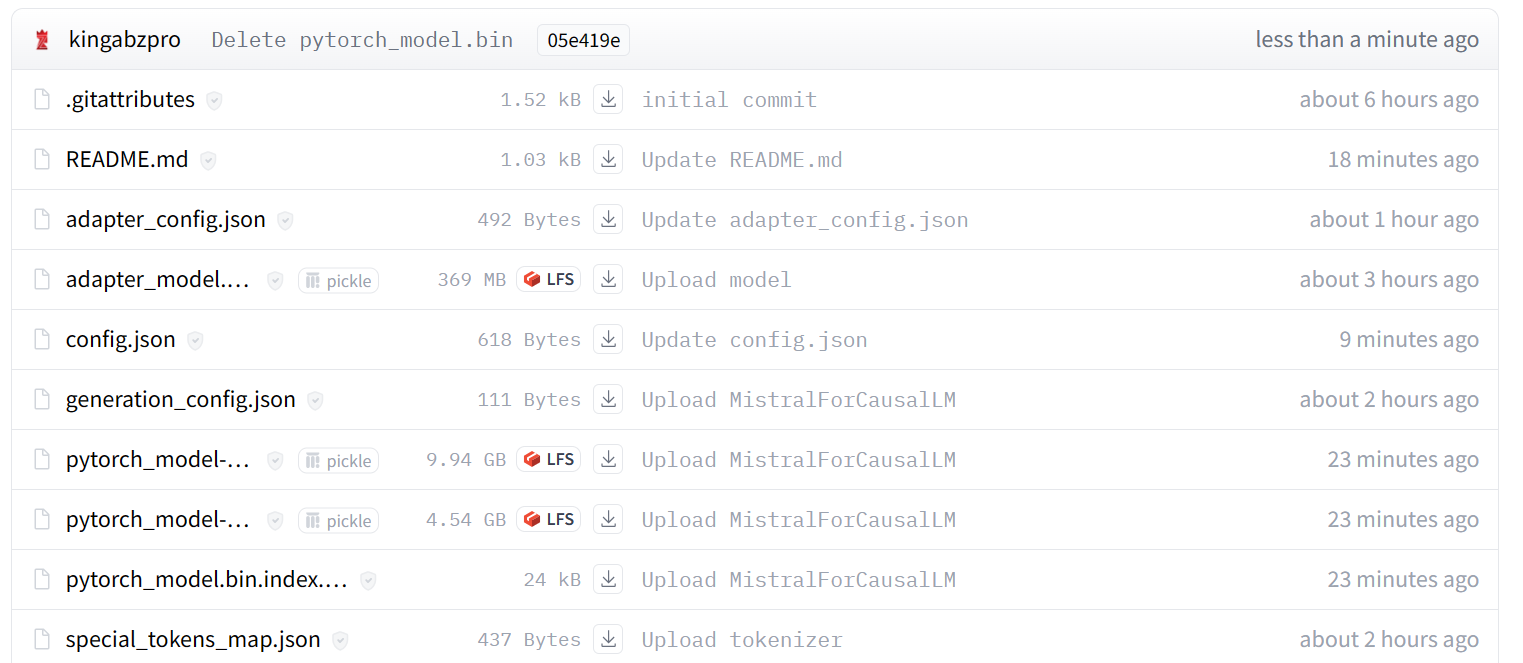
Afbeelding van kingabzpro/mistral_7b_guanaco
Om te laten zien dat we kunnen laden en inferentie kunnen draaien zonder het basismodel, laden we het gefine-tunede model vanaf Hugging Face Hub en draaien we de inferentie.
from transformers import pipeline


pipe = pipeline(
    "text-generation",
    model = "kingabzpro/mistral_7b_guanaco",
    device_map="auto"
)

prompt = "How do I become a data engineer in 6 months?"

sequences = pipe(
    f"<s>[INST] {prompt} [/INST]",
    do_sample=True,
    max_new_tokens=200,
    temperature=0.7,
    top_k=50,
    top_p=0.95,
    num_return_sequences=1,)

print(sequences[0]['generated_text'])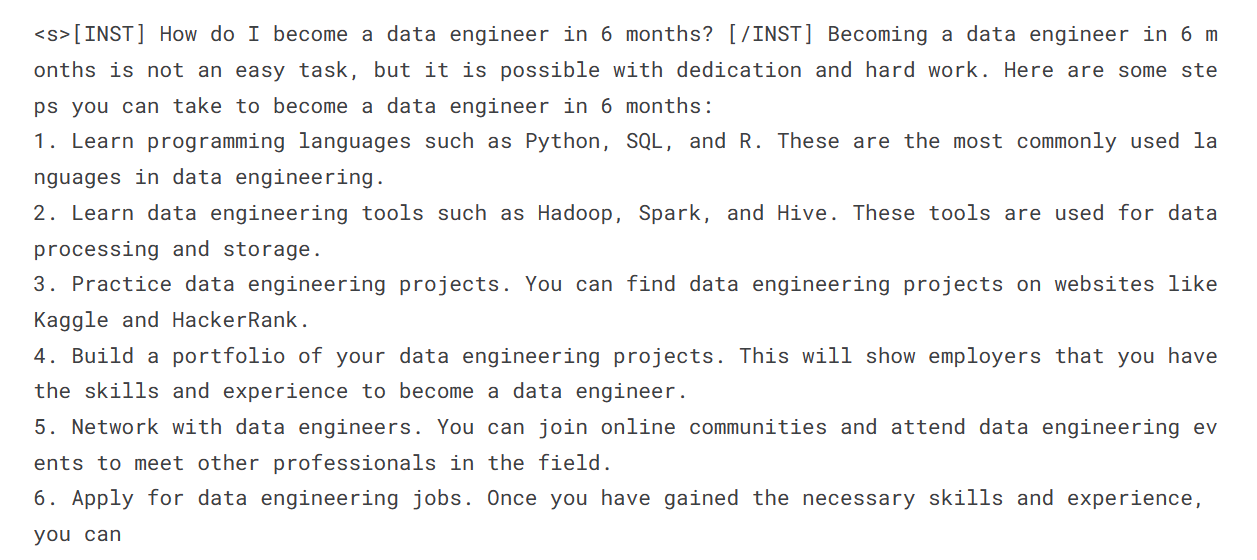
Mistral 7B is een spannende vooruitgang in de capaciteiten van large language models. Dankzij innovaties zoals Grouped-query Attention en Sliding Window Attention behaalt het state-of-the-art prestaties en blijft het toch efficiënt genoeg om in te zetten.
In deze tutorial hebben we geleerd hoe je het Mistral 7B-model op Kaggle benadert. Daarnaast hebben we geleerd hoe je het model op een kleine dataset fine-tunet en de adapter met het basismodel merge-t.
Deze gids is een uitgebreide resource voor zowel machine learning-liefhebbers als beginners die willen experimenteren met en grote taalmodellen willen trainen op consument-GPU’s.
Als je nieuw bent met large language models, raden we de cursus Master LLMs Concepts aan. Voor wie een carrière in artificial intelligence wil starten, is inschrijven voor de AI Fundamentals-skill track een uitstekende eerste stap.
Begin vandaag nog met je LLM-leertraject!
Cursus
Cursus
Cursus
blog
Adel Nehme
15 min

