
{count, plural, one {Leerpad} other {Leerpaden}}
AI-basisprincipes
{hours} uur
Na de lancering van de eerste versie van LLaMA door Meta ontstond er een nieuwe wapenwedloop om betere Large Language Models (LLM’s) te bouwen die konden concurreren met modellen als GPT-3.5 (ChatGPT). De open-sourcegemeenschap bracht in rap tempo steeds krachtigere modellen uit. Het voelde als Kerstmis voor AI-liefhebbers, met regelmatig nieuwe aankondigingen.
Toch hadden deze ontwikkelingen ook keerzijden. De meeste open-sourcemodellen hebben beperkende licenties, waardoor ze alleen voor onderzoeksdoeleinden gebruikt mogen worden. Daarnaast konden alleen grote bedrijven of onderzoeksinstellingen met ruime budgetten het zich veroorloven om modellen te trainen of fijn te stemmen. Tot slot was het uitrollen en onderhouden van state-of-the-art grote modellen duur.
De nieuwe versie van de LLaMA-modellen wil deze problemen aanpakken. Ze komt met een commerciële licentie, waardoor ze toegankelijker is voor meer organisaties. Bovendien maken nieuwe methoden het mogelijk om te fijnstemmen op consumentengpu’s met beperkte geheugenruimte.
Die democratisering van AI is cruciaal voor brede adoptie. Door de instapdrempels te verlagen, kunnen zelfs kleine bedrijven aangepaste modellen bouwen die passen bij hun behoeften en budget.
In deze tutorial verkennen we Llama-2 en laten we zien hoe je het fijnstemt op een nieuwe dataset met Google Colab. Daarnaast behandelen we nieuwe methodes en fine-tuningtechnieken die het geheugenverbruik kunnen verminderen en het trainingsproces versnellen.
Afbeelding gegenereerd door auteur met DALL-E 3
transformers, peft, trl, bitsandbytes)Llama 2 is een verzameling open-source LLM’s van de tweede generatie van Meta met een commerciële licentie. Het is ontworpen voor een breed scala aan NLP-taken, met modellen variërend van 7 miljard tot 70 miljard parameters. Lees meer over LLaMA-modellen in ons artikel Introduction to Meta AI's LLaMA: Empowering AI Innovation.
Llama-2-Chat, geoptimaliseerd voor dialoog, laat vergelijkbare prestaties zien als populaire gesloten modellen zoals ChatGPT en PaLM. We kunnen de prestaties zelfs verbeteren door het model fijn te stemmen op een hoogwaardige conversatiedataset.
Fijnstemmen in machine learning is het proces waarbij de gewichten en parameters van een voorgetraind model worden aangepast op nieuwe data om de prestaties op een specifieke taak te verbeteren. Het houdt in dat je het model traint op een nieuwe, taakspecifieke dataset en de gewichten bijwerkt om zich aan te passen aan die data. Lees meer over fijnstemmen in onze gids voor het fijnstemmen van GPT 3.5.
Het fijnstemmen van LLM’s op consumentenhardeware is lastig door beperkte VRAM en rekenkracht. In deze tutorial overwinnen we die geheugen- en rekeneisen en trainen we ons model met de gratis versie van Google Colab Notebook.
In dit deel leren we alle stappen die nodig zijn om het Llama 2-model met 7 miljard parameters fijn te stemmen op een T4-GPU. Je kunt een gratis GPU op Google Colab of Kaggle gebruiken. De code draait op beide platforms.
De Colab T4-GPU heeft slechts 16 GB VRAM. Dat is net genoeg om de gewichten van Llama 2–7b op te slaan, wat volledige fine-tuning onmogelijk maakt en ons dwingt om parameter-efficiënte technieken zoals LoRA of QLoRA te gebruiken.
We gebruiken de QLoRA-techniek om het model met 4-bit precisie fijn te stemmen en VRAM-gebruik te optimaliseren. Daarvoor gebruiken we het Hugging Face-ecosysteem van LLM-bibliotheken: transformers, accelerate, peft, trl en bitsandbytes.
We beginnen met het installeren van de vereiste bibliotheken.
%%capture
%pip install accelerate peft bitsandbytes transformers trl
Daarna laden we de benodigde modules uit deze bibliotheken.
import os
import torch
from datasets import load_dataset
from transformers import (
    AutoModelForCausalLM,
    AutoTokenizer,
    BitsAndBytesConfig,
    TrainingArguments,
    pipeline,
    logging,
)
from peft import LoraConfig
from trl import SFTTrainerJe kunt het officiële Llama-2-model van Meta openen via Hugging Face, maar je moet een aanvraag indienen en een paar dagen wachten op bevestiging. In plaats van te wachten gebruiken we NousResearch’ Llama-2-7b-chat-hf als ons basismodel. Het is hetzelfde als het origineel maar eenvoudig toegankelijk.
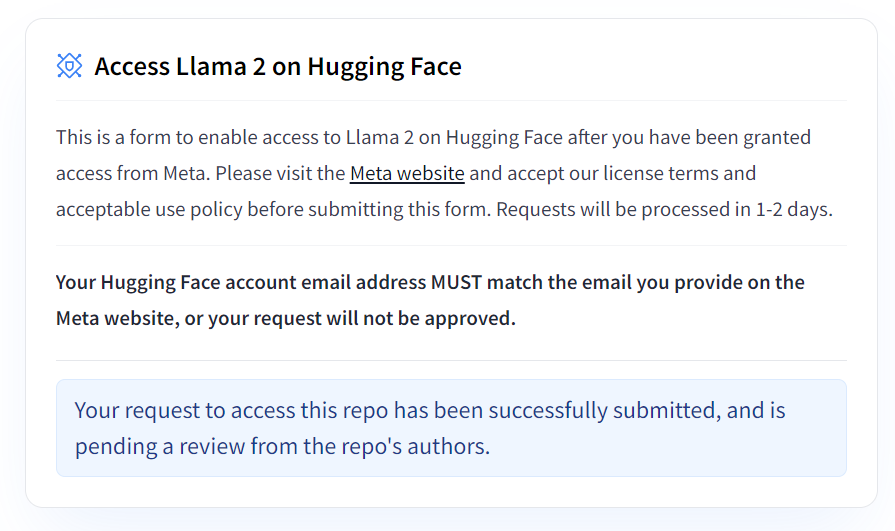
Afbeelding van Hugging Face
We stemmen ons basismodel fijn met een kleinere dataset genaamd mlabonne/guanaco-llama2-1k en geven alvast een naam aan het fijn-afgestemde model.
# Model from Hugging Face hub
base_model = "NousResearch/Llama-2-7b-chat-hf"

# New instruction dataset
guanaco_dataset = "mlabonne/guanaco-llama2-1k"

# Fine-tuned model
new_model = "llama-2-7b-chat-guanaco"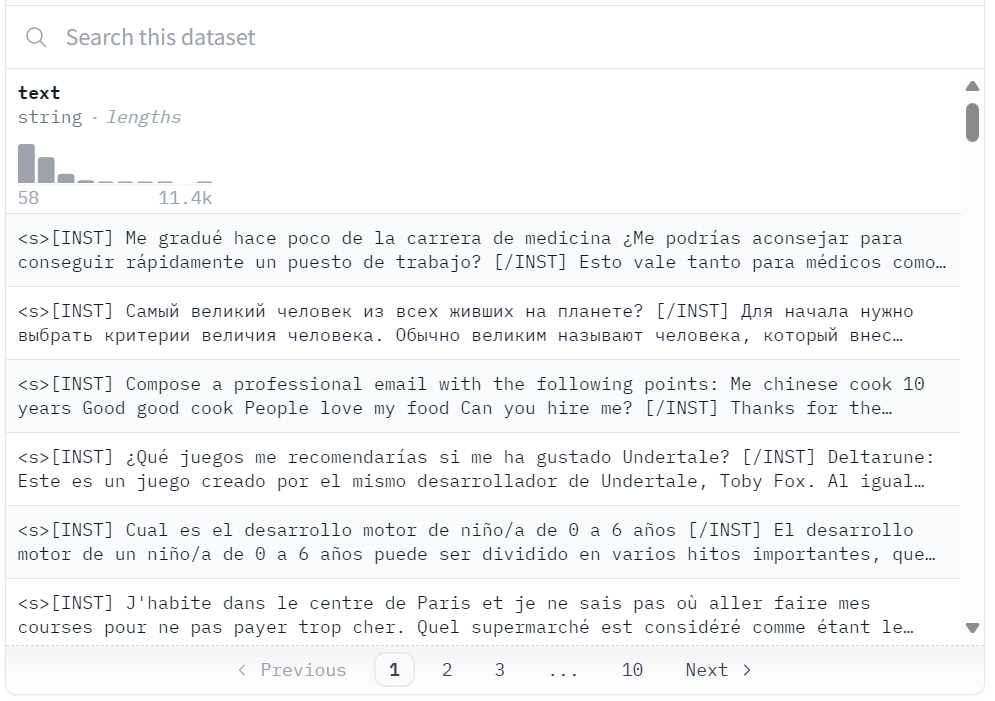
Dataset op Hugging Face
We laden de “guanaco-llama2-1k”-dataset van de Hugging Face-hub. De dataset bevat 1000 samples, is voorbewerkt om te matchen met het Llama 2-promptformaat en is een subset van de uitstekende timdettmers/openassistant-guanaco-dataset.
dataset = load_dataset(guanaco_dataset, split="train")Dataset parquet downloaded and prepared to /root/.cache/huggingface/datasets/parquet/mlabonne--guanaco-llama2-1k-f1f1134768f90029/0.0.0/0b6d5799bb726b24ad7fc7be720c170d8e497f575d02d47537de9a5bac074901. Subsequent calls will reuse this data.4-bit kwantisatie via QLoRA maakt efficiënt fijnstemmen van grote LLM’s op consumentenhardeware mogelijk, met behoud van hoge prestaties. Dit verbetert de toegankelijkheid en bruikbaarheid voor toepassingen in de praktijk aanzienlijk.
QLoRA kwantiseert een voorgetraind taalmodel naar 4 bits en bevriest de parameters. Vervolgens worden er een klein aantal trainbare Low-Rank Adapter-lagen aan het model toegevoegd.
Tijdens het fijnstemmen worden de gradiënten teruggepropageerd door het bevroren 4-bit gekwantiseerde model, maar alleen de Low-Rank Adapter-lagen worden geüpdatet. Het volledige voorgetrainde model blijft dus vast op 4 bits terwijl alleen de adapters veranderen. De 4-bit kwantisatie schaadt de modelprestaties bovendien niet.
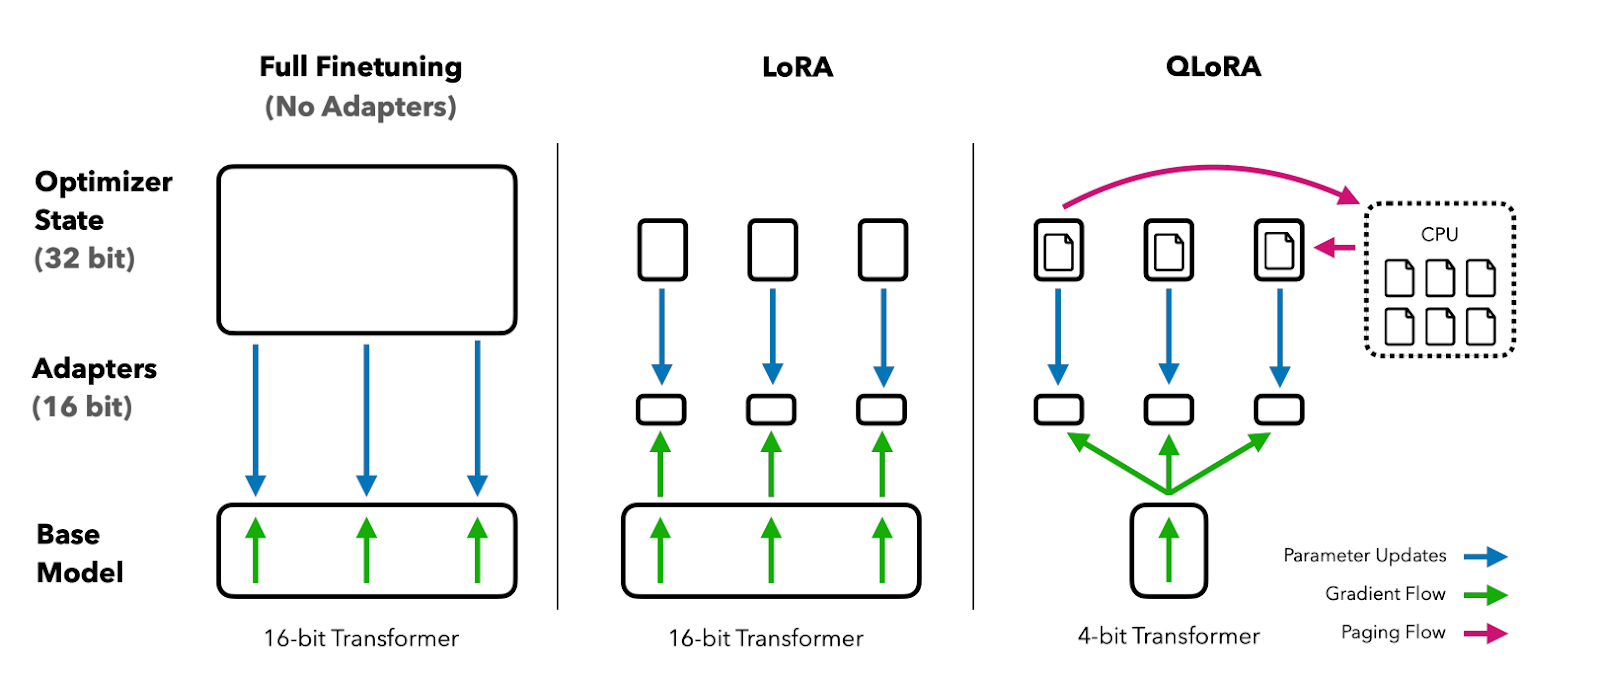
Afbeelding uit QLoRA-paper
Je kunt de paper lezen voor een diepere uitleg.
| Feature | Volledige fine-tuning | LoRA | QLoRA |
|---|---|---|---|
| Aantal geüpdatete parameters | Alle modelparameters | Kleine adaptermatrices (~0,1-1%) | Kleine adaptermatrices (~0,1-1%) |
| Precisie basismodel | FP16 / BF16 | FP16 / BF16 | 4-bit (NF4) |
| VRAM voor 7B-model | ~60+ GB | ~16 GB | ~6-8 GB |
| Compatibel met consumentengpu | Nee | Beperkt | Ja (T4, RTX 3060+) |
| Kwaliteit t.o.v. volledige fine-tuning | Baseline | ~98-99% | ~96-98% |
| Trainingssnelheid | Langzaamst | Snel | Snel |
In ons geval maken we 4-bit kwantisatie met NF4-typeconfiguratie met BitsAndBytes.
compute_dtype = getattr(torch, "float16")

quant_config = BitsAndBytesConfig(
    load_in_4bit=True,
    bnb_4bit_quant_type="nf4",
    bnb_4bit_compute_dtype=compute_dtype,
    bnb_4bit_use_double_quant=False,
)We laden nu een model met 4-bit precisie en de compute dtype "float16" van Hugging Face voor sneller trainen.
model = AutoModelForCausalLM.from_pretrained(
    base_model,
    quantization_config=quant_config,
    device_map={"": 0}
)
model.config.use_cache = False
model.config.pretraining_tp = 1Vervolgens laden we de tokenizer van Hugging Face en zetten we padding_side op “right” om het probleem met fp16 te verhelpen.
tokenizer = AutoTokenizer.from_pretrained(base_model, trust_remote_code=True)
tokenizer.pad_token = tokenizer.eos_token
tokenizer.padding_side = "right"Traditioneel fijnstemmen van voorgetrainde taalmodellen (PLM’s) vereist het updaten van alle parameters van het model, wat veel rekenkracht en enorme hoeveelheden data vraagt.
Parameter-Efficient Fine-Tuning (PEFT) werkt door slechts een kleine subset van de meest invloedrijke parameters te updaten, waardoor het veel efficiënter is. Leer meer over parameters in de officiële PEFT-documentatie.
peft_params = LoraConfig(
    lora_alpha=16,
    lora_dropout=0.1,
    r=64,
    bias="none",
    task_type="CAUSAL_LM",
)Hieronder staat een lijst met hyperparameters die je kunt gebruiken om het trainingsproces te optimaliseren:
training_params = TrainingArguments(
    output_dir="./results",
    num_train_epochs=1,
    per_device_train_batch_size=4,
    gradient_accumulation_steps=1,
    optim="paged_adamw_32bit",
    save_steps=25,
    logging_steps=25,
    learning_rate=2e-4,
    weight_decay=0.001,
    fp16=False,
    bf16=False,
    max_grad_norm=0.3,
    max_steps=-1,
    warmup_ratio=0.03,
    group_by_length=True,
    lr_scheduler_type="constant",
    report_to="tensorboard"
)Supervised fine-tuning (SFT) is een sleutelstap in reinforcement learning from human feedback (RLHF). De TRL-bibliotheek van Hugging Face biedt een eenvoudige API om SFT-modellen te maken en ze met slechts een paar regels code op je dataset te trainen. De library bevat tools om taalmodellen te trainen met reinforcement learning, te beginnen met supervised fine-tuning, daarna reward modeling en tot slot proximal policy optimization (PPO).
We geven de SFT Trainer het model, de dataset, de Lora-configuratie, de tokenizer en de trainingsparameters mee.
trainer = SFTTrainer(
    model=model,
    train_dataset=dataset,
    peft_config=peft_params,
    dataset_text_field="text",
    max_seq_length=None,
    tokenizer=tokenizer,
    args=training_params,
    packing=False,
)
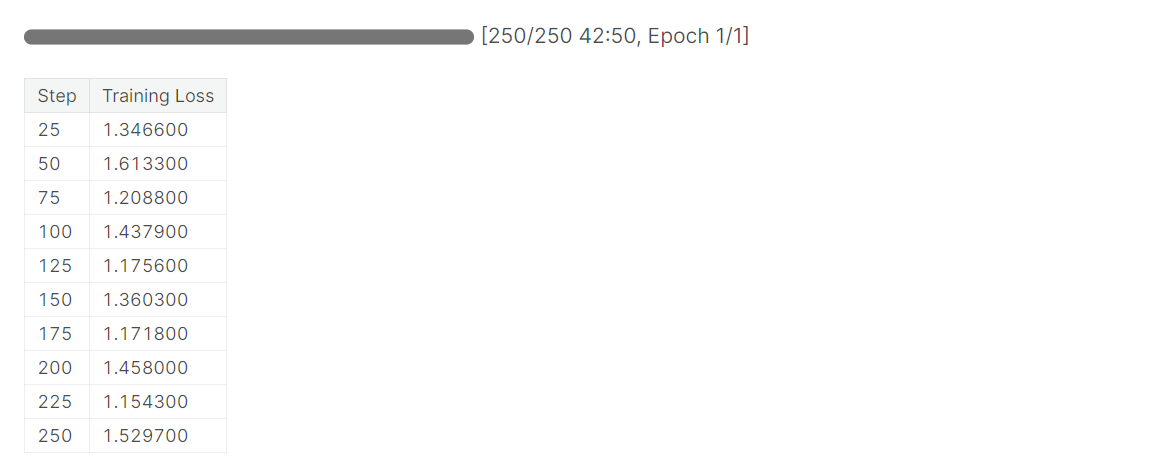
We gebruiken .train() om het Llama 2-model op een nieuwe dataset fijn te stemmen. Het duurde anderhalf uur om 1 epoch te voltooien.
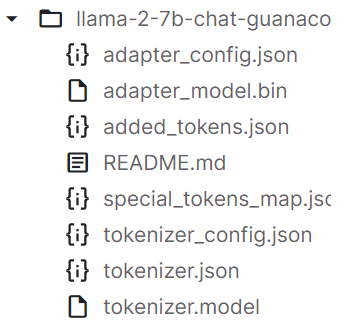
Na het trainen slaan we de modeladapter en tokenizer op. Je kunt het model ook uploaden naar Hugging Face met een vergelijkbare API.
trainer.model.save_pretrained(new_model)
trainer.tokenizer.save_pretrained(new_model)
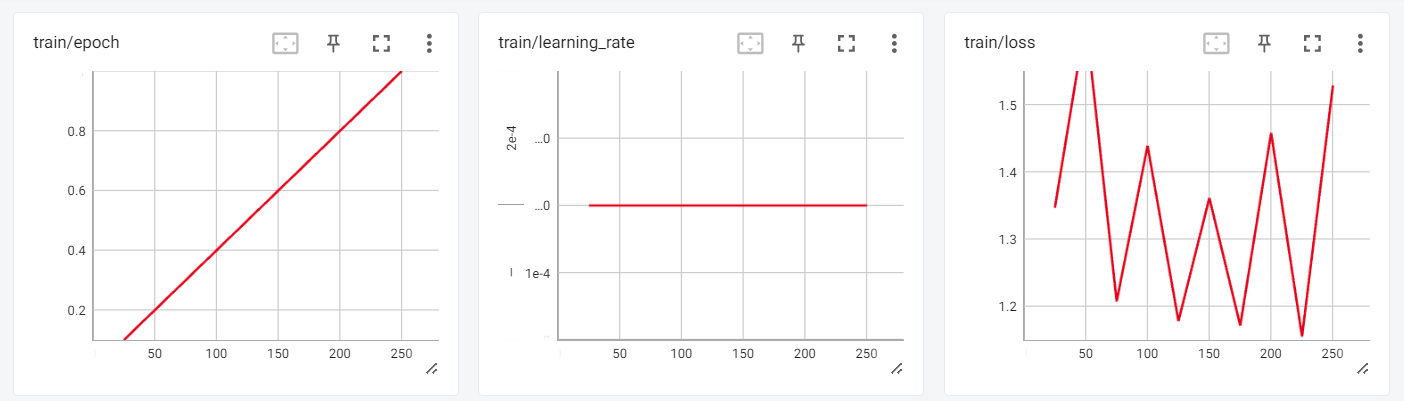
We kunnen de trainingsresultaten nu bekijken in de interactieve sessie van TensorBoard.
from tensorboard import notebook
log_dir = "results/runs"
notebook.start("--logdir {} --port 4000".format(log_dir))
Om ons fijn-afgestemde model te testen, gebruiken we de transformers text-generation pipeline en stellen we eenvoudige vragen zoals “Who is Leonardo Da Vinci?”.
logging.set_verbosity(logging.CRITICAL)

prompt = "Who is Leonardo Da Vinci?"
pipe = pipeline(task="text-generation", model=model, tokenizer=tokenizer, max_length=200)
result = pipe(f"<s>[INST] {prompt} [/INST]")
print(result[0]['generated_text'])
Output:
Het model genereert een samenhangend en gedetailleerd antwoord.
<s>[INST] Who is Leonardo Da Vinci? [/INST] Leonardo da Vinci (1452-1519) was an Italian polymath, artist, inventor, and engineer.

Da Vinci is widely considered one of the greatest painters of all time, and his works include the famous Mona Lisa. He was also an accomplished engineer, inventor, and anatomist, and his designs for machines and flight were centuries ahead of his time.

Da Vinci was born in the town of Vinci, Italy, and he was the illegitimate son of a local notary. Despite his humble origins, he was able to study art and engineering in Florence, and he became a renowned artist and inventor.

Da Vinci's work had a profound impact on the Renaissance, and his legacy continues to inspire artists, engineers, and inventors to this day. He
Laten we nog een vraag stellen.
prompt = "What is DataCamp Career track?"
result = pipe(f"<s>[INST] {prompt} [/INST]")
print(result[0]['generated_text'])
Output:
Guanaco is een hoogwaardige dataset die in het verleden is gebruikt om state-of-the-art LLM’s fijn te stemmen. De volledige Guanaco-dataset is beschikbaar op Hugging Face en heeft het potentieel om nog betere prestaties te behalen op diverse NLP-taken.
<s>[INST] What is Datacamp Career track? [/INST] DataCamp Career Track is a program that offers a comprehensive learning experience to help you build your skills and prepare for a career in data science.

The program includes a range of courses, projects, and assessments that are designed to help you build your skills in data science. You will learn how to work with data, create visualizations, and build predictive models.

In addition to the technical skills, you will also learn how to communicate your findings to stakeholders and how to work with a team to solve complex problems.

The program is designed to be flexible, so you can learn at your own pace and on your own schedule. You will also have access to a community of learners and mentors who can provide support and guidance throughout the program.

Overall, DataCamp Career Track is a great way to build your skills and prepare for a career in
Hier is de Colab Notebook met de code en de outputs om je op weg te helpen.
Vervolgens kun je LlamaIndex gebruiken en je eigen AI-toepassing bouwen met je nieuw getrainde model via de tutorial LlamaIndex: Adding Personal Data to LLMs. Doe inspiratie op voor je project met 5 Projects Built with Generative Models and Open Source Tools.
Sinds de release van Llama 2 in juli 2023 heeft Meta meerdere nieuwere modellen uitgebracht met grote verbeteringen. Llama 3 (april 2024) introduceerde een grotere woordenschat van 128K tokens en grouped query attention (GQA) voor alle modelgroottes. Llama 3.1 (juli 2024) vergrootte de contextlengte naar 128K tokens en voegde een variant met 405B parameters toe. Llama 3.2 (september 2024) bracht multimodale mogelijkheden en lichte 1B/3B-modellen die zijn geoptimaliseerd voor edge-devices.
Ook het fine-tuning-ecosysteem is sterk doorontwikkeld. Tools zoals Unsloth bieden 2x snellere training en 60% minder geheugenverbruik vergeleken met standaard Hugging Face PEFT, en GUI-tools zoals LLaMA-Factory maken fijnstemmen toegankelijk zonder code te schrijven. De kernconcepten QLoRA en PEFT uit deze tutorial blijven fundamenteel — bekijk onze tutorials over fijnstemmen van Llama 3.1 en fijnstemmen van Llama 3.2 voor de nieuwste aanpakken.
In deze tutorial hebben we behandeld hoe je het LLaMA 2-model fijnstemt met technieken als QLoRA, PEFT en SFT om geheugen- en rekeneisen te omzeilen. Met Hugging Face-bibliotheken zoals transformers, accelerate, peft, trl en bitsandbytes konden we het LLaMA 2-model met 7B parameters succesvol fijnstemmen op een consumentengpu.
Al met al laat deze tutorial zien hoe recente doorbraken de democratisering en toegankelijkheid van grote taalmodellen mogelijk maken, zodat zelfs hobbyisten met beperkte middelen state-of-the-art AI kunnen bouwen.
Wil je verder leren? Volg de cursus Fine-Tuning with Llama 3 voor hands-on oefening met nieuwere modellen, of verdiep je in het ecosysteem uit deze tutorial met de cursus Working with Hugging Face. Voor basiskennis begin je met Introduction to LLMs in Python of de cursus Large Language Models (LLMs) Concepts, en bekijk de skill track AI Fundamentals.
Begin vandaag nog met je AI-reis!
{count, plural, one {Leerpad} other {Leerpaden}}
{count, plural, one {Cursus} other {Cursussen}}
{count, plural, one {Cursus} other {Cursussen}}
{count, plural, one {blog} other {blogs}}
Adel Nehme
15 min

