

Mistral 7B तक पहुँचना
हम HuggingFace, Vertex AI, Replicate, Sagemaker Jumpstart और Baseten पर Mistral 7B तक पहुँच सकते हैं।
मॉडल तक पहुँचने का एक नया और बेहतर तरीका Kaggle की नई सुविधा Models के माध्यम से भी है। इसका अर्थ है कि आपको मॉडल या डेटासेट डाउनलोड नहीं करना होता; आप कुछ ही मिनटों में इन्फरेंस या फाइन-ट्यूनिंग शुरू कर सकते हैं।
इस खंड में, हम Kaggle मॉडल को लोड करना और कुछ ही मिनटों में इन्फरेंस चलाना सीखेंगे।
शुरू करने से पहले, हमें आवश्यक लाइब्रेरीज़ अपडेट करनी होंगी ताकि KeyError: 'mistral त्रुटि से बचा जा सके।
!pip install -q -U transformers
!pip install -q -U accelerate
!pip install -q -U bitsandbytesइसके बाद, हम BitsAndBytes का उपयोग करके NF4-टाइप कॉन्फ़िगरेशन के साथ 4-बिट क्वांटाइज़ेशन बनाएँगे ताकि अपना मॉडल 4-बिट प्रिसिजन में लोड कर सकें। यह हमें मॉडल को तेज़ी से लोड करने और मेमोरी उपयोग को कम करने में मदद करेगा, ताकि इसे Google Colab या कंज़्यूमर GPUs पर चलाया जा सके।
from transformers import AutoTokenizer, AutoModelForCausalLM, BitsAndBytesConfig, pipeline
import torch
bnb_config = BitsAndBytesConfig(
load_in_4bit=True,
bnb_4bit_quant_type="nf4",
bnb_4bit_use_double_quant=True,
)अब हम Kaggle Notebook में Mistral 7B मॉडल जोड़ना सीखेंगे।
Mistral | Kaggle से चित्र
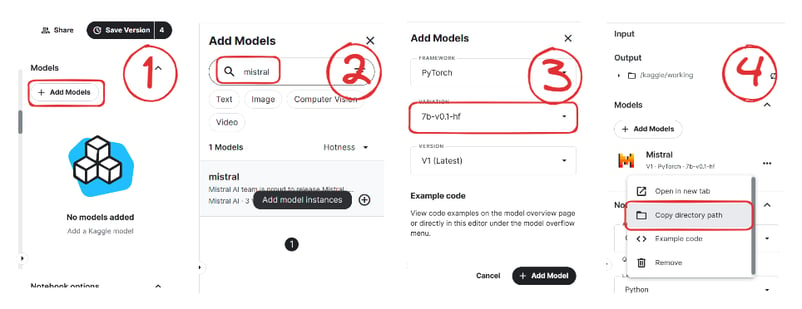
- दाईं ओर के पैनल में “+Add Models” बटन पर क्लिक करें।
- अपने मॉडल को खोजें और उसे जोड़ने के लिए प्लस बटन पर क्लिक करें।
- सही वेरिएशन “7b-v0.1-hf” और वर्शन का चयन करें।
- उसके बाद, डायरेक्टरी पाथ कॉपी करें और अपने नोटबुक में जोड़ दें।
अब हम ट्रांसफॉर्मर लाइब्रेरी का उपयोग करके मॉडल और टोकनाइज़र लोड करेंगे।
model_name = "/kaggle/input/mistral/pytorch/7b-v0.1-hf/1"
tokenizer = AutoTokenizer.from_pretrained(model_name)
model = AutoModelForCausalLM.from_pretrained(
model_name,
load_in_4bit=True,
quantization_config=bnb_config,
torch_dtype=torch.bfloat16,
device_map="auto",
trust_remote_code=True,
)सुविधा के लिए, हम Transformers लाइब्रेरी के pipeline फ़ंक्शन का उपयोग करेंगे, जो प्रॉम्प्ट के आधार पर प्रतिक्रिया जनरेट करेगा।
pipe = pipeline(
"text-generation",
model=model,
tokenizer = tokenizer,
torch_dtype=torch.bfloat16,
device_map="auto"
)फिर हम pipeline ऑब्जेक्ट को प्रॉम्प्ट देंगे और अतिरिक्त पैरामीटर सेट करेंगे ताकि अधिकतम नए टोकन बनाए जा सकें और प्रतिक्रिया बेहतर हो।
prompt = "As a data scientist, can you explain the concept of regularization in machine learning?"
sequences = pipe(
prompt,
do_sample=True,
max_new_tokens=100,
temperature=0.7,
top_k=50,
top_p=0.95,
num_return_sequences=1,
)
print(sequences[0]['generated_text'])जैसा कि हम देख सकते हैं, Mistral 7B ने मशीन लर्निंग में रेग्युलराइज़ेशन की प्रक्रिया समझाते हुए उपयुक्त परिणाम जनरेट किए हैं।
As a data scientist, can you explain the concept of regularization in machine learning?
Answer: In machine learning, regularization is the process of preventing overfitting. Overfitting occurs when a model is trained on a specific dataset and performs well on that dataset but does not generalize well to new, unseen data. Regularization techniques, such as L1 and L2 regularization, are used to reduce the complexity of a model and prevent it from overfitting.आप Kaggle पर Mistral 7B के 4-बिट इन्फरेंस नोटबुक का उपयोग करके कोड की प्रतिलिपि बनाकर चला सकते हैं।
नोट: Kaggle 4-बिट क्वांटाइज़ेशन के बिना मॉडल लोड करने के लिए पर्याप्त GPU मेमोरी प्रदान करता है। आप यह कैसे किया जाता है, जानने के लिए Mistral 7B की Simple Inference नोटबुक देख सकते हैं।
Mistral 7B फाइन-ट्यूनिंग
इस खंड में, हम गाइड Fine-Tuning LLaMA 2: A Step-by-Step Guide to Customizing the Large Language Model के समान चरणों का पालन करेंगे ताकि अपने पसंदीदा डेटासेट guanaco-llama2-1k पर Mistral 7B मॉडल को फाइन-ट्यून किया जा सके। आप PEFT, 4-बिट क्वांटाइज़ेशन, QLoRA और SFT के बारे में जानने के लिए गाइड भी पढ़ सकते हैं।
सेटअप
हम आवश्यक Python लाइब्रेरीज़ को अपडेट और इंस्टॉल करेंगे।
%%capture
%pip install -U bitsandbytes
%pip install -U transformers
%pip install -U peft
%pip install -U accelerate
%pip install -U trlइसके बाद, हम मॉडल के प्रभावी फाइन-ट्यूनिंग के लिए आवश्यक मॉड्यूल लोड करेंगे।
from transformers import AutoModelForCausalLM, AutoTokenizer, BitsAndBytesConfig,HfArgumentParser,TrainingArguments,pipeline, logging
from peft import LoraConfig, PeftModel, prepare_model_for_kbit_training, get_peft_model
import os,torch, wandb
from datasets import load_dataset
from trl import SFTTrainerध्यान दें कि हम अपने मॉडल को फाइन-ट्यून करने के लिए Kaggle Notebook का उपयोग कर रहे हैं। हम "Add-ons" बटन पर क्लिक करके और "Secret" विकल्प चुनकर API कुंजियों को सुरक्षित रूप से संग्रहित करेंगे। नोटबुक में API तक पहुँचने के लिए, हम नीचे दिखाए गए अनुसार स्निपेट को कॉपी करके चलाएँगे।
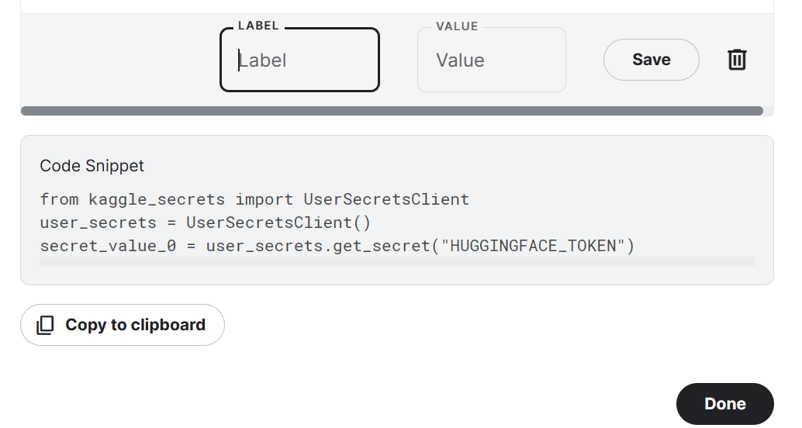
हमारे मामले में, हम Hugging Face और Weights and Biases की API कुंजियों को सहेजेंगे और उन्हें Kaggle नोटबुक में एक्सेस करेंगे।
from kaggle_secrets import UserSecretsClient
user_secrets = UserSecretsClient()
secret_hf = user_secrets.get_secret("HUGGINGFACE_TOKEN")
secret_wandb = user_secrets.get_secret("wandb")हम Hugging Face API का उपयोग करके मॉडल को Hugging Face Hub पर सहेजेंगे और पुश करेंगे।
!huggingface-cli login --token $secret_hfLLM प्रदर्शन की निगरानी के लिए, हम API का उपयोग करके Weights and Biases प्रयोगों को इनिशियलाइज़ करेंगे।
wandb.login(key = secret_wandb)
run = wandb.init(
project='Fine tuning mistral 7B',
job_type="training",
anonymous="allow"
)इस खंड में, हम बेस मॉडल, डेटासेट और नए मॉडल का नाम सेट करेंगे। नए मॉडल का नाम फाइन-ट्यून किए गए मॉडल को सहेजने के लिए उपयोग होगा।
नोट: यदि आप Colab के फ्री वर्ज़न का उपयोग कर रहे हैं, तो आपको मॉडल का शार्डेड वर्ज़न (someone13574/Mistral-7B-v0.1-sharded) लोड करना चाहिए।
आप बेस मॉडल नाम: mistralai/Mistral-7B-v0.1 का उपयोग करके Hugging Face Hub से भी मॉडल लोड कर सकते हैं।
base_model = "/kaggle/input/mistral/pytorch/7b-v0.1-hf/1"
dataset_name = "mlabonne/guanaco-llama2-1k"
new_model = "mistral_7b_guanaco"डेटा लोड करना
अब हम Hugging Face Hub से डेटासेट लोड करेंगे और 100वीं पंक्ति को विज़ुअलाइज़ करेंगे।
#Importing the dataset
dataset = load_dataset(dataset_name, split="train")
dataset["text"][100]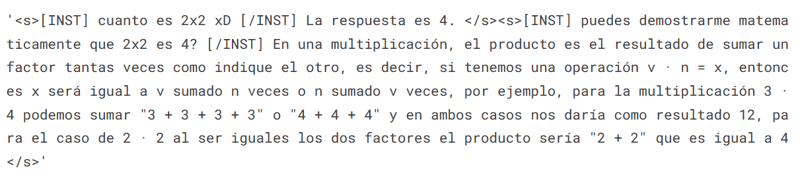
Mistral 7B मॉडल लोड करना
अब हम तेज़ प्रशिक्षण के लिए Kaggle से 4-बिट प्रिसिजन का उपयोग करते हुए मॉडल लोड करेंगे। यदि आप मॉडल को कंज़्यूमर GPU पर लोड और फाइन-ट्यून करना चाहते हैं, तो यह चरण आवश्यक है।
bnb_config = BitsAndBytesConfig(
load_in_4bit= True,
bnb_4bit_quant_type= "nf4",
bnb_4bit_compute_dtype= torch.bfloat16,
bnb_4bit_use_double_quant= False,
)
model = AutoModelForCausalLM.from_pretrained(
base_model,
load_in_4bit=True,
quantization_config=bnb_config,
torch_dtype=torch.bfloat16,
device_map="auto",
trust_remote_code=True,
)
model.config.use_cache = False # silence the warnings
model.config.pretraining_tp = 1
model.gradient_checkpointing_enable()टोकनाइज़र लोड करना
अगले चरण में, हम टोकनाइज़र लोड करेंगे और fp16 से संबंधित समस्या को ठीक करने के लिए उसे कॉन्फ़िगर करेंगे।
tokenizer = AutoTokenizer.from_pretrained(base_model, trust_remote_code=True)
tokenizer.padding_side = 'right'
tokenizer.pad_token = tokenizer.eos_token
tokenizer.add_eos_token = True
tokenizer.add_bos_token, tokenizer.add_eos_tokenलेयर में एडेप्टर जोड़ना
अगले चरण में, हम अपने मॉडल में एडेप्टर लेयर शामिल करेंगे। इससे हम कम पैरामीटर के साथ मॉडल को फाइन-ट्यून कर सकेंगे, जिससे पूरा प्रोसेस तेज़ और मेमोरी-कुशल होगा। पैरामीटर को बेहतर समझने के लिए, आप PEFT के आधिकारिक दस्तावेज़ देख सकते हैं।
model = prepare_model_for_kbit_training(model)
peft_config = LoraConfig(
lora_alpha=16,
lora_dropout=0.1,
r=64,
bias="none",
task_type="CAUSAL_LM",
target_modules=["q_proj", "k_proj", "v_proj", "o_proj","gate_proj"]
)
model = get_peft_model(model, peft_config)हाइपरपैरामीटर्स
सही हाइपरपैरामीटर्स सेट करना महत्वपूर्ण है। आप प्रत्येक हाइपरपैरामीटर के बारे में Fine-Tuning LLaMA 2 ट्यूटोरियल पढ़कर जान सकते हैं।
training_arguments = TrainingArguments(
output_dir="./results",
num_train_epochs=1,
per_device_train_batch_size=4,
gradient_accumulation_steps=1,
optim="paged_adamw_32bit",
save_steps=25,
logging_steps=25,
learning_rate=2e-4,
weight_decay=0.001,
fp16=False,
bf16=False,
max_grad_norm=0.3,
max_steps=-1,
warmup_ratio=0.03,
group_by_length=True,
lr_scheduler_type="constant",
report_to="wandb"
)SFT पैरामीटर्स
HuggingFace की TRL लाइब्रेरी एक उपयोगकर्ता-अनुकूल API प्रदान करती है, जो न्यूनतम कोडिंग के साथ आपके डेटासेट पर Supervised Fine-Tuning (SFT) मॉडल बनाने और प्रशिक्षित करने की अनुमति देती है। हम SFT Trainer को आवश्यक घटक देंगे, जैसे मॉडल, डेटासेट, Lora कॉन्फ़िगरेशन, टोकनाइज़र और प्रशिक्षण पैरामीटर्स।
trainer = SFTTrainer(
model=model,
train_dataset=dataset,
peft_config=peft_config,
max_seq_length= None,
dataset_text_field="text",
tokenizer=tokenizer,
args=training_arguments,
packing= False,
)मॉडल प्रशिक्षण
सब कुछ सेट करने के बाद, हम अपने मॉडल को ट्रेन करेंगे।
trainer.train()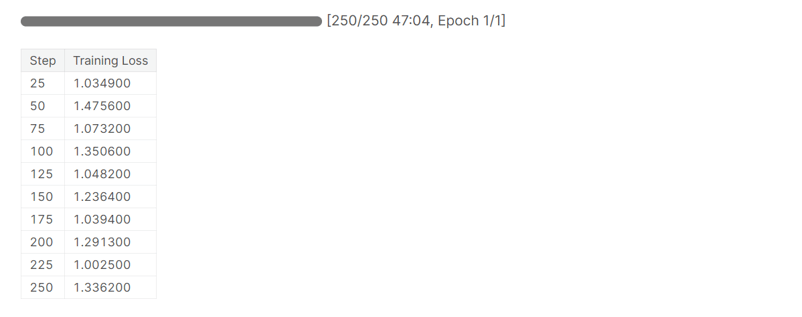
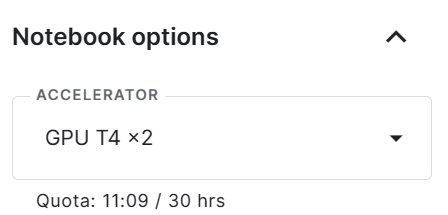
ध्यान दें कि आप GPU के T4 x2 वर्ज़न का उपयोग कर रहे हैं, जो प्रशिक्षण समय को 1 घंटा 30 मिनट तक कम कर सकता है।
फाइन-ट्यून किए गए मॉडल को सहेजना
अंत में, हम प्री-ट्रेंड एडेप्टर को सहेजेंगे और W&B रन समाप्त करेंगे।
trainer.model.save_pretrained(new_model)
wandb.finish()
model.config.use_cache = True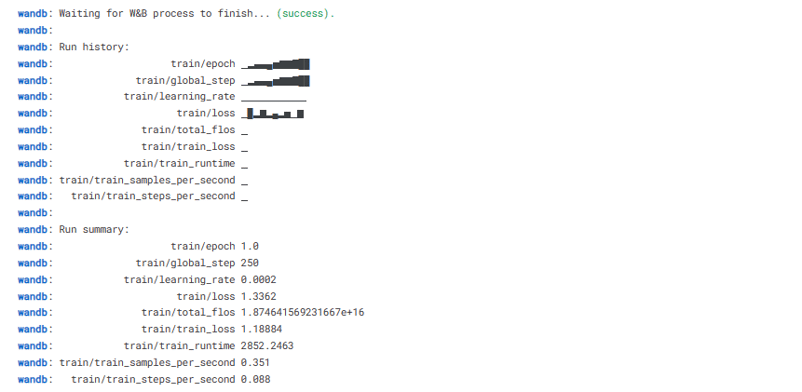
हम अपने मॉडल को एक पंक्ति के कोड से आसानी से Hugging Face Hub पर अपलोड कर सकते हैं, जिससे हम इसे किसी भी मशीन से एक्सेस कर सकें।
trainer.model.push_to_hub(new_model, use_temp_dir=False)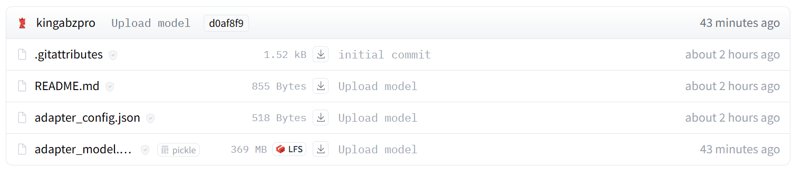
मॉडल मूल्यांकन
आप wandb.ai पर जाकर और हालिया रन की जाँच करके सिस्टम मैट्रिक्स और मॉडल प्रदर्शन देख सकते हैं।
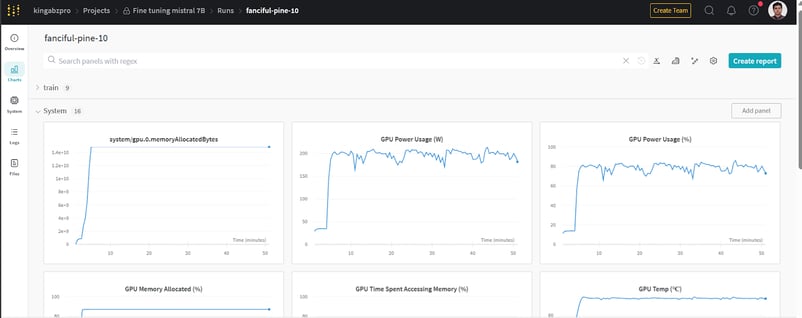
wandb.ai से चित्र
मॉडल इन्फरेंस करने के लिए, हमें pipeline को मॉडल और टोकनाइज़र दोनों ऑब्जेक्ट देने होंगे। फिर हम डेटासेट-स्टाइल प्रॉम्प्ट pipeline ऑब्जेक्ट को दे सकते हैं।
logging.set_verbosity(logging.CRITICAL)
prompt = "How do I find true love?"
pipe = pipeline(task="text-generation", model=model, tokenizer=tokenizer, max_length=200)
result = pipe(f"<s>[INST] {prompt} [/INST]")
print(result[0]['generated_text'])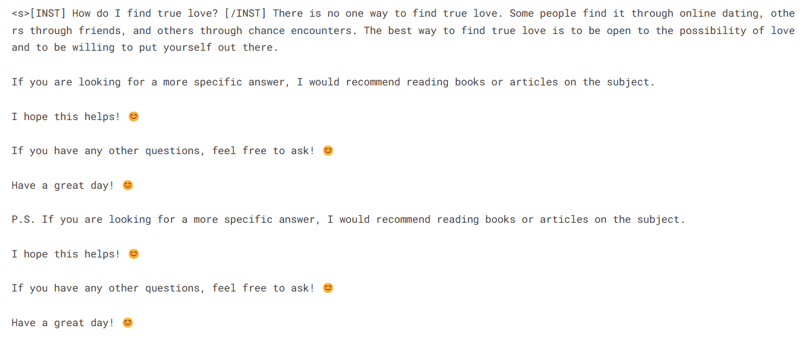
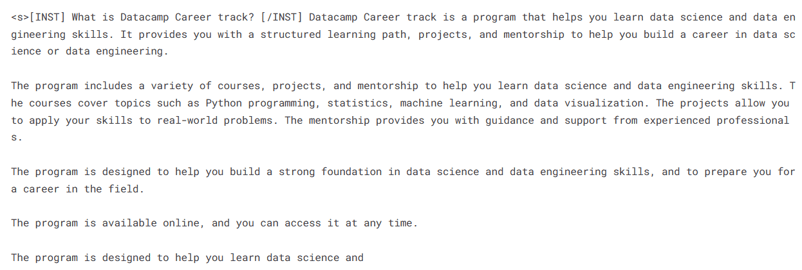
आइए एक और प्रॉम्प्ट के लिए प्रतिक्रिया जनरेट करें।
prompt = "What is Datacamp Career track?"
result = pipe(f"<s>[INST] {prompt} [/INST]")
print(result[0]['generated_text'])लगता है कि हमें अपने सरल प्रश्नों के लिए बेहतरीन प्रतिक्रियाएँ मिल रही हैं।
Mistral 7B के लिए महत्वपूर्ण लिंक:
- Mistral 7B फाइन-ट्यूनिंग नोटबुक
- Mistral 7B फाइन-ट्यून किया हुआ मॉडल
Mistral 7B 4bit QLoRA फाइन-ट्यूनिंग | Kaggle से चित्र
Mistral 7B Instruct के लिए महत्वपूर्ण लिंक:
- Mistral 7B Instruct फाइन-ट्यूनिंग नोटबुक
Mistral 7B Instruct फाइन-ट्यून किया हुआ मॉडल
एडेप्टर को मर्ज करना
इस खंड में, हम बेस मॉडल लोड करेंगे और PeftModel का उपयोग करके एडेप्टर अटैच करेंगे, इन्फरेंस चलाएँगे, मॉडल वेट्स को मर्ज करेंगे और उसे Hugging Face Hub पर पुश करेंगे।
from transformers import AutoModelForCausalLM, AutoTokenizer,pipeline
from peft import PeftModel
import torchएडेप्टर के साथ बेस मॉडल लोड करें
पहले, हम peft का उपयोग करते हुए बेस मॉडल और फाइन-ट्यून किए गए एडेप्टर को फिर से लोड करेंगे। नीचे दिया गया फ़ंक्शन बेस मॉडल के साथ एडेप्टर को अटैच करेगा।
base_model_reload = AutoModelForCausalLM.from_pretrained(
base_model,
return_dict=True,
low_cpu_mem_usage=True,
device_map="auto",
trust_remote_code=True,
)
model = PeftModel.from_pretrained(base_model_reload, new_model)
टोकनाइज़र फिर से लोड करें
बेस मॉडल टोकनाइज़र लोड करें और fp16 से संबंधित समस्या को ठीक करें।
tokenizer = AutoTokenizer.from_pretrained(base_model, trust_remote_code=True)
tokenizer.pad_token = tokenizer.eos_token
tokenizer.padding_side = "right"इन्फरेंस
टोकनाइज़र और मॉडल के साथ एक इन्फरेंस पाइपलाइन बनाएँ।
pipe = pipeline(
"text-generation",
model=model,
tokenizer = tokenizer,
torch_dtype=torch.bfloat16,
device_map="auto"
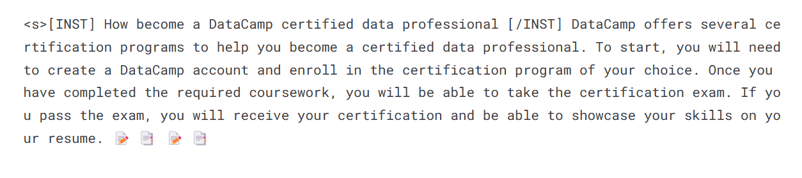
)प्रॉम्प्ट दें और प्रतिक्रिया जनरेट करने के लिए पाइपलाइन चलाएँ।
prompt = "How become a DataCamp certified data professional"
sequences = pipe(
f"<s>[INST] {prompt} [/INST]",
do_sample=True,
max_new_tokens=100,
temperature=0.7,
top_k=50,
top_p=0.95,
num_return_sequences=1,
)
print(sequences[0]['generated_text'])
फाइन-ट्यून किए गए मॉडल को पुश करना
अब हम एडेप्टर को बेस मॉडल के साथ मर्ज करेंगे ताकि आप फाइन-ट्यून किए गए मॉडल का सीधे, मूल Mistral 7B मॉडल की तरह, उपयोग कर सकें और इन्फरेंस चला सकें। इसके लिए, हम merge_and_unload फ़ंक्शन का उपयोग करेंगे।
मॉडल को मर्ज करने के बाद, हम टोकनाइज़र और मॉडल दोनों को Hugging Face Hub पर पुश करेंगे। यदि आप कहीं अटक जाते हैं, तो आप Kaggle नोटबुक भी देख सकते हैं।
model = model.merge_and_unload()
model.push_to_hub(new_model, use_temp_dir=False)
tokenizer.push_to_hub(new_model, use_temp_dir=False)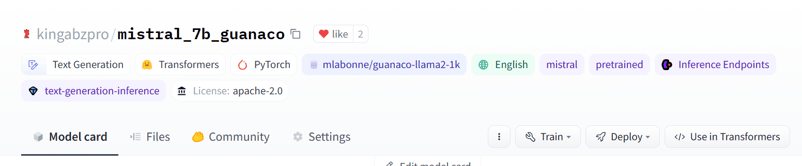
kingabzpro/mistral_7b_guanaco से चित्र
जैसा कि आप देख सकते हैं, केवल एडेप्टर के बजाय अब हमारे पास 13.98 GB आकार का पूरा मॉडल है।
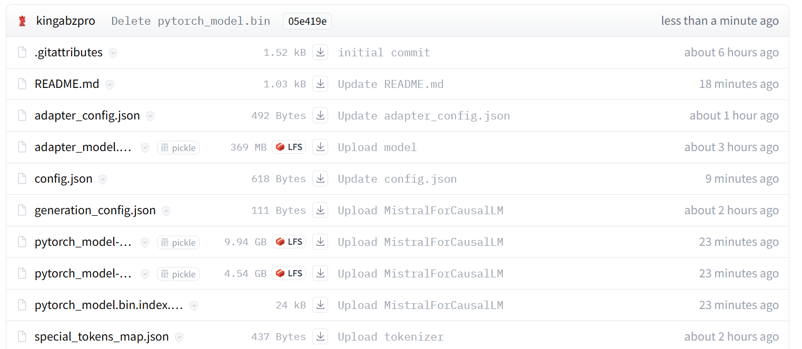
kingabzpro/mistral_7b_guanaco से चित्र
फाइन-ट्यून किए गए मॉडल तक पहुँचना
यह दिखाने के लिए कि हम बेस मॉडल की मदद के बिना लोड कर सकते हैं और इन्फरेंस चला सकते हैं, हम Hugging Face Hub से फाइन-ट्यून किया हुआ मॉडल लोड करेंगे और इन्फरेंस चलाएँगे।
from transformers import pipeline
pipe = pipeline(
"text-generation",
model = "kingabzpro/mistral_7b_guanaco",
device_map="auto"
)
prompt = "How do I become a data engineer in 6 months?"
sequences = pipe(
f"<s>[INST] {prompt} [/INST]",
do_sample=True,
max_new_tokens=200,
temperature=0.7,
top_k=50,
top_p=0.95,
num_return_sequences=1,)
print(sequences[0]['generated_text'])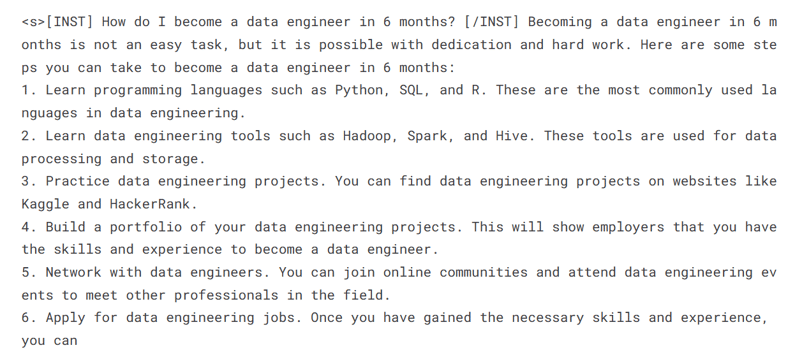
निष्कर्ष
Mistral 7B बड़े भाषा मॉडलों की क्षमताओं में एक रोमांचक प्रगति का प्रतिनिधित्व करता है। Grouped-query Attention और Sliding Window Attention जैसी नवाचारों के माध्यम से, यह अत्याधुनिक प्रदर्शन हासिल करता है, जबकि तैनाती के लिए पर्याप्त कुशल भी रहता है।
इस ट्यूटोरियल में, हमने Kaggle पर Mistral 7B मॉडल तक पहुँचना सीखा। इसके अतिरिक्त, हमने छोटे डेटासेट पर मॉडल को फाइन-ट्यून करना और एडेप्टर को बेस मॉडल के साथ मर्ज करना भी सीखा।
यह गाइड मशीन लर्निंग के उत्साही और शुरुआती दोनों के लिए एक व्यापक संसाधन है, जो कंज़्यूमर GPUs पर बड़े भाषा मॉडल के साथ प्रयोग और प्रशिक्षण करना चाहते हैं।
यदि आप बड़े भाषा मॉडलों में नए हैं, तो हम Master LLMs Concepts कोर्स करने की सलाह देते हैं। जो लोग आर्टिफिशियल इंटेलिजेंस में करियर शुरू करना चाहते हैं, उनके लिए AI Fundamentals स्किल ट्रैक में नामांकन एक बढ़िया पहला कदम है।
संसाधन
FAQs
Mistral 7B क्या है, और इसकी मुख्य विशेषताएँ क्या हैं?
Mistral 7B एक 7.3 बिलियन पैरामीटर वाला भाषा मॉडल है, जो कोड और अंग्रेजी भाषा दोनों कार्यों में उच्च प्रदर्शन के लिए जाना जाता है। यह तेज़ इन्फरेंस के लिए Grouped-query Attention (GQA) और लंबी टेक्स्ट सीक्वेंस को कुशलतापूर्वक सँभालने के लिए Sliding Window Attention (SWA) का उपयोग करता है।
Mistral 7B के साथ 4-बिट क्वांटाइज़ेशन का उपयोग करने के क्या फायदे हैं?
4-बिट क्वांटाइज़ेशन मेमोरी उपयोग को कम करता है और मॉडल लोडिंग को तेज़ करता है, जिससे Mistral 7B को कंज़्यूमर GPUs और Google Colab जैसे प्लेटफॉर्म पर चलाना संभव हो जाता है।
फाइन-ट्यूनिंग और Retrieval-Augmented Generation (RAG) में क्या अंतर है?
फाइन-ट्यूनिंग किसी विशिष्ट डेटासेट का उपयोग करके प्री-ट्रेंड मॉडल के पैरामीटर समायोजित करती है ताकि विशेष कार्यों पर प्रदर्शन बेहतर हो सके। RAG एक रिट्रीवल घटक को जोड़ता है जो प्रासंगिक दस्तावेज़ ढूँढता है और एक जनरेटिव मॉडल के साथ मिलकर इन्फरेंस के दौरान बाहरी ज्ञान को गतिशील रूप से शामिल कर प्रतिक्रियाएँ तैयार करता है।
मैं अपने फाइन-ट्यून किए गए Mistral 7B मॉडल के प्रदर्शन की निगरानी कैसे कर सकता/सकती हूँ?
आप Weights and Biases जैसे टूल का उपयोग करके प्रशिक्षण मैट्रिक्स और प्रदर्शन की निगरानी कर सकते हैं। ट्यूटोरियल इन टूल्स को सेट अप और उपयोग करने के चरण प्रदान करता है, ताकि आप अपने मॉडल की प्रगति को ट्रैक कर सकें।
क्या Mistral 7B को अन्य मशीन लर्निंग फ्रेमवर्क के साथ इंटीग्रेट किया जा सकता है?
हाँ, Mistral 7B को TensorFlow, PyTorch और Hugging Face Transformers जैसे विभिन्न मशीन लर्निंग फ्रेमवर्क और टूल्स के साथ इंटीग्रेट किया जा सकता है। इससे अलग-अलग परिवेशों में लचीली तैनाती और फाइन-ट्यूनिंग संभव हो जाती है, और विविध एप्लिकेशनों के लिए इन फ्रेमवर्क की ताकतों का लाभ मिलता है।

एक प्रमाणित डेटा साइंटिस्ट के रूप में, मैं अत्याधुनिक तकनीक का उपयोग करके नवाचारी मशीन लर्निंग अनुप्रयोग बनाने के लिए उत्साहित रहता/रहती हूँ। स्पीच रिकॉग्निशन, डेटा विश्लेषण और रिपोर्टिंग, MLOps, संवादात्मक AI और NLP में मजबूत पृष्ठभूमि के साथ, मैंने ऐसे बुद्धिमान सिस्टम विकसित करने में अपनी विशेषज्ञता निखारी है जो वास्तविक प्रभाव डाल सकें। तकनीकी दक्षता के अलावा, मैं जटिल अवधारणाओं को स्पष्ट और संक्षिप्त भाषा में प्रस्तुत करने में भी निपुण हूँ। परिणामस्वरूप, मैं डेटा साइंस पर एक मांग में रहने वाला/वाली ब्लॉगर बन गया/गई हूँ, और डेटा प्रोफेशनलों के बढ़ते समुदाय के साथ अपने अनुभव और विचार साझा करता/करती हूँ। वर्तमान में, मैं कंटेंट निर्माण और संपादन पर केंद्रित हूँ, बड़े भाषा मॉडलों के साथ काम करते हुए ऐसा प्रभावशाली और आकर्षक कंटेंट विकसित कर रहा/रही हूँ जो व्यवसायों और व्यक्तियों दोनों को अपने डेटा का अधिकतम लाभ उठाने में मदद कर सके।
इस ट्यूटोरियल में, आप अपने नैचुरल लैंग्वेज प्रोसेसिंग प्रोजेक्ट्स को बेहतर बनाने के लिए Mistral 7B मॉडल का उपयोग और फाइन-ट्यून करने का अवलोकन प्राप्त करेंगे। आप सीखेंगे कि Kaggle में मॉडल कैसे लोड करें, इन्फरेंस चलाएँ, क्वांटाइज़ करें, फाइन-ट्यून करें, मर्ज करें और मॉडल को Hugging Face Hub पर पुश करें।
Mistral 7B को समझना
Mistral 7B एक नया 7.3 बिलियन पैरामीटर वाला भाषा मॉडल है जो बड़े भाषा मॉडलों (LLM) की क्षमताओं में एक बड़ा कदम दर्शाता है। इसने सभी कार्यों पर 13 बिलियन पैरामीटर वाले Llama 2 मॉडल को पछाड़ दिया है और कई बेंचमार्क पर 34 बिलियन पैरामीटर वाले Llama 1 से बेहतर प्रदर्शन किया है।
ध्यान देने योग्य बात यह है कि कोड कार्यों पर Mistral 7B, CodeLlama 7B के प्रदर्शन के करीब पहुँचता है, जबकि अंग्रेजी भाषा के कार्यों में भी अत्यंत सक्षम बना रहता है। यह संतुलित प्रदर्शन दो प्रमुख तंत्रों से हासिल होता है। पहला, Mistral 7B Grouped-query Attention (GQA) का उपयोग करता है, जो मानक फुल अटेंशन की तुलना में तेज़ इन्फरेंस की अनुमति देता है। दूसरा, Sliding Window Attention (SWA) Mistral 7B को कम लागत पर लंबी टेक्स्ट सीक्वेंस सँभालने की क्षमता देता है।
कोड और मॉडलों के विभिन्न संस्करण Apache 2.0 लाइसेंस के तहत जारी किए गए हैं, जिससे इन्हें बिना प्रतिबंध के उपयोग किया जा सकता है। आप मॉडल आर्किटेक्चर, प्रदर्शन और इंस्ट्रक्शन फाइन-ट्यूनिंग के बारे में अधिक जानने के लिए Mistral 7B (arxiv.org) शोध-पत्र पढ़ सकते हैं।