Cursus
Introductie tot Data Science in Python
4 uur
504.2K
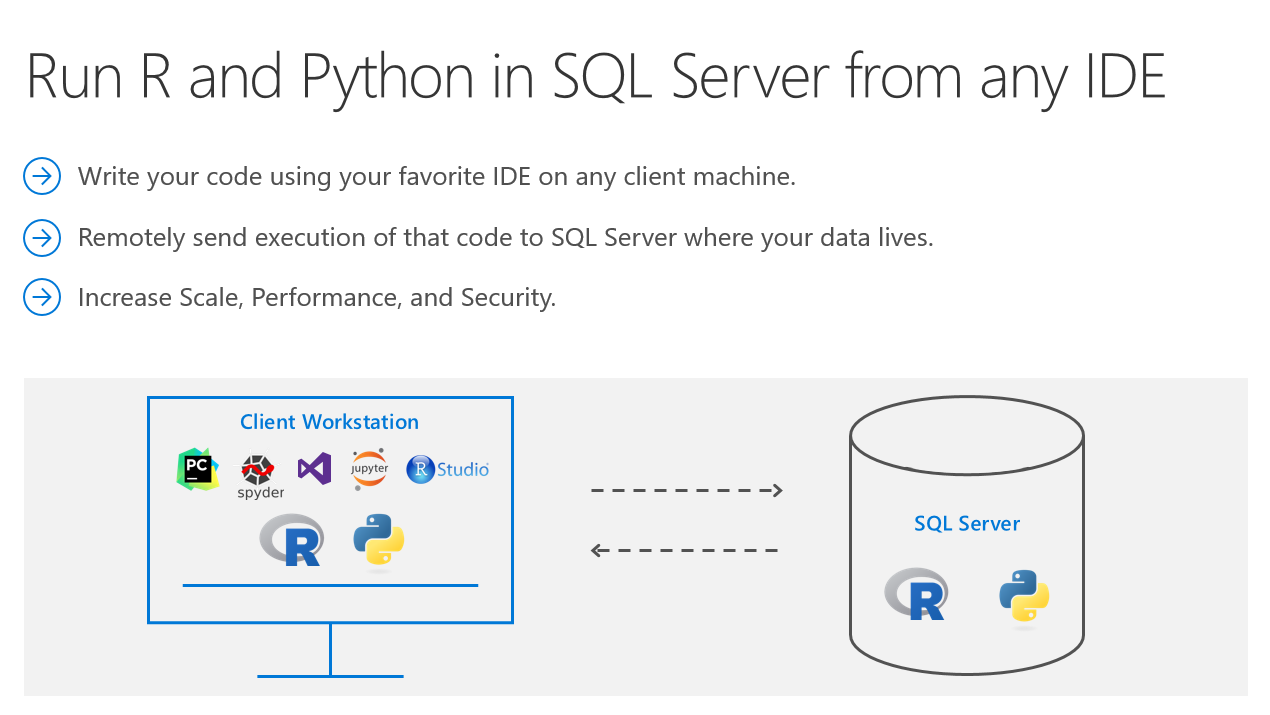
Wist je dat je R- en Python-code op afstand kunt uitvoeren in SQL Server vanuit Jupyter Notebooks of elke IDE? Machine Learning Services in SQL Server maakt het overbodig om data te verplaatsen. In plaats van grote en gevoelige data over het netwerk te sturen of nauwkeurigheid te verliezen bij ML-training met voorbeeld-csv-bestanden, kun je je R/Python-code binnen je database laten draaien. Je kunt werken in Jupyter Notebooks, RStudio, PyCharm, VSCode, Visual Studio, waar je maar wilt, en vervolgens functieverwerking naar SQL Server sturen zodat de intelligentie komt te staan waar je data zich bevindt.
Deze tutorial laat zien hoe je je pythoncode vanuit Jupyter Notebooks naar SQL Server stuurt om daar uit te voeren. Dezelfde principes gelden ook voor R en elke andere IDE. Leer je liever via video? Deze tutorial staat ook op YouTube:
Om R of Python binnen SQL uit te voeren, moet je eerst de functie Machine Learning Services installeren en configureren. Zie deze how-to.
Om Python-uitvoering vanuit Jupyter Notebooks naar SQL te sturen, heb je Microsofts RevoscalePy-pakket nodig. Download en installeer daarvoor Microsofts ML Services Python Client. Documentatiepagina of rechtstreekse downloadlink (voor Windows).
Open na het downloaden PowerShell als administrator en ga naar de downloadmap. Start de installatie met dit commando (pas de installatiemap gerust aan): .\Install-PyForMLS.ps1 -InstallFolder "C:\Program Files\MicrosoftPythonClient"
Wees geduldig: de installatie kan even duren. Ga na de installatie naar het nieuwe pad dat je hebt gekozen. Laten we een lege map maken en Jupyter Notebooks openen: mkdir JupyterNotebooks; cd JupyterNotebooks; ..\Scripts\jupyter-notebook
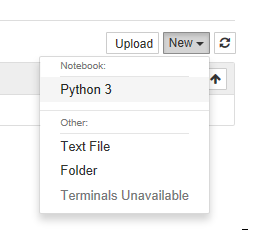
Maak een nieuw notebook met de Python 3-interpreter:
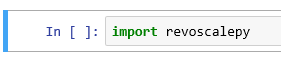
Om te testen of alles goed is ingesteld, importeer je revoscalepy in de eerste cel en voer je die uit. Als er geen foutmeldingen zijn, kun je verder.
Voor de rest van de tutorial kun je dit Jupyter Notebook van Github klonen als je niet alle code wilt kopiëren en plakken. Deze database-inrichting is een eenmalige stap om te zorgen dat je dezelfde data hebt als in deze tutorial. Je hoeft geen van deze stappen te doen als je je eigen data gebruikt.
Pas de connection string voor je server aan en gebruik pyodbc om een nieuwe database te maken.
 import pyodbc

# creating a new db to load Iris sample in
new_db_name = "MLRemoteExec"
connection_string = "Driver=SQL Server;Server=localhost\MSSQLSERVER2017;Database={0};Trusted_Connection=Yes;"
cnxn = pyodbc.connect(connection_string.format("master"), autocommit=True)
cnxn.cursor().execute("IF EXISTS(SELECT * FROM sys.databases WHERE [name] = '{0}') DROP DATABASE {0}".format(new_db_name))
cnxn.cursor().execute("CREATE DATABASE " + new_db_name)
cnxn.close()

print("Database created")Iris is een populair dataset voor tutorials voor beginnende data scientists. Het zit standaard in het sklearn-pakket.
from sklearn import datasets
import pandas as pd

# SkLearn has the Iris sample dataset built into the package
iris = datasets.load_iris()
df = pd.DataFrame(iris.data, columns=iris.feature_names)(Dit kan ook met pyodbc, sqlalchemy of andere pakketten)
 from revoscalepy import RxSqlServerData, rx_data_step

# Example of using RX APIs to load data into SQL table. You can also do this with pyodbc
table_ref = RxSqlServerData(connection_string=connection_string.format(new_db_name), table="Iris")
rx_data_step(input_data = df, output_file = table_ref, overwrite = True)

print("New Table Created: Iris")
print("Sklearn Iris sample loaded into Iris table")Schrijf willekeurige pythoncode die je in SQL wilt uitvoeren. In dit voorbeeld maken we een scatter matrix op de iris-dataset en geven we alleen de bytestream van de .png terug aan Jupyter Notebooks om die aan de client te tonen.
def send_this_func_to_sql():from revoscalepy import RxSqlServerData, rx_import
    from pandas.tools.plotting import scatter_matrix
    import matplotlib.pyplot as plt
    import io

    # remember the scope of the variables in this func are within our SQL Server Python Runtime
    connection_string = "Driver=SQL Server;Server=localhost\MSSQLSERVER2017;Database=MLRemoteExec;Trusted_Connection=Yes;"# specify a query and load into pandas dataframe df
    sql_query = RxSqlServerData(connection_string=connection_string, sql_query = "select * from Iris")
    df = rx_import(sql_query)

    scatter_matrix(df)

    # return bytestream of image created by scatter_matrix
    buf = io.BytesIO()
    plt.savefig(buf, format="png")
    buf.seek(0)

return buf.getvalue()Nu we eindelijk alles hebben ingericht, zie je hoe eenvoudig het echt is om uitvoering op afstand te sturen! Importeer eerst revoscalepy. Maak een sql_compute_context en stuur vervolgens de uitvoering van elke functie naadloos naar SQL Server met RxExec. Er hoefden geen ruwe gegevens van SQL naar het Jupyter Notebook te worden overgezet. Alle berekeningen vonden plaats binnen de database en alleen het afbeeldingsbestand werd teruggestuurd om weer te geven.
from IPython import display
import matplotlib.pyplot as plt
from revoscalepy import RxInSqlServer, rx_exec

# create a remote compute context with connection to SQL Server
sql_compute_context = RxInSqlServer(connection_string=connection_string.format(new_db_name))

# use rx_exec to send the function execution to SQL Server
image = rx_exec(send_this_func_to_sql, compute_context=sql_compute_context)[0]

# only an image was returned to my jupyter client. All data remained secure and was manipulated in my db.
display.Image(data=image)
Hoewel dit voorbeeld met de Iris-dataset eenvoudig is, kun je je de extra schaalbaarheid, prestaties en beveiligingsmogelijkheden voorstellen die je nu hebt ontgrendeld. Je kunt de nieuwste open-source R/Python-pakketten gebruiken om deep learning- en AI-toepassingen te bouwen op grote hoeveelheden data in SQL Server. We bieden ook state-of-the-art, hoogwaardige algoritmen in Microsofts RevoScaleR en RevoScalePy-API's. Door deze te combineren met de nieuwste innovaties uit de open source-wereld, breng je ongeëvenaarde keuze, prestaties en schaal naar je toepassingen.
Bekijk DataCamp's tutorial over How to Execute Python/R in SQL.
Bekijk de documentatie van SQL Machine Learning Services om te leren hoe je je R/Python-code eenvoudig inzet met SQL-stored procedures, zodat ze beschikbaar zijn in je ETL-processen of voor elke applicatie. Train en sla machinelearningmodellen op in je database, zodat intelligentie komt te staan waar je data leeft.
Basis R- en Python-uitvoering in SQL Server: https://aka.ms/BasicMLServicesExecution
Machine Learning Services instellen in SQL Server: https://aka.ms/SetupMLServices
End-to-end tutorialoplossingen op Github: https://microsoft.github.io/sql-ml-tutorials/
Andere YouTube-tutorials:
Als je meer wilt leren, bekijk dan de introductiecursussen van DataCamp.
Leer meer over Python, R en SQL
Cursus
Cursus
Cursus
blog
Adel Nehme
15 min

