Kurs
Einführung in Data Science mit Python
4 Std.
502.2K
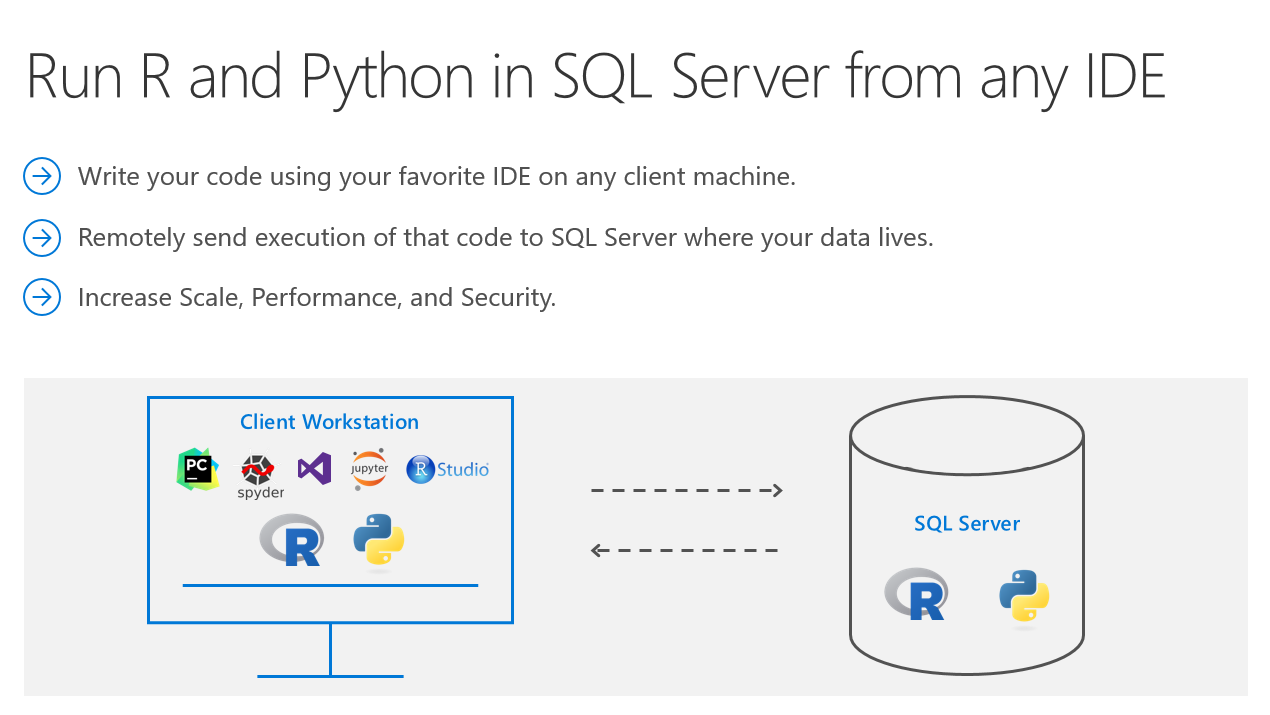
Wusstest du, dass du R- und Python-Code aus Jupyter Notebooks oder jeder IDE remote in SQL Server ausführen kannst? Machine Learning Services in SQL Server ersparen dir das Hin- und Herkopieren von Daten. Anstatt große und sensible Daten über das Netzwerk zu übertragen oder bei ML-Trainings mit CSV-Beispieldateien an Genauigkeit zu verlieren, lässt du deinen R-/Python-Code direkt in deiner Datenbank laufen. Du arbeitest in Jupyter Notebooks, RStudio, PyCharm, VSCode, Visual Studio – wo du willst – und schickst dann die Funktionsausführung an SQL Server, sodass die Intelligenz dorthin kommt, wo deine Daten liegen.
Dieses Tutorial zeigt dir beispielhaft, wie du Python-Code aus Jupyter Notebooks zur Ausführung in SQL Server sendest. Die gleichen Prinzipien gelten auch für R und jede andere IDE. Wenn du lieber per Video lernst, findest du dieses Tutorial auch auf YouTube:
Damit R oder Python innerhalb von SQL ausgeführt werden kann, musst du zuerst das Feature Machine Learning Services installieren und konfigurieren. Sieh dir diese Anleitung an.
Um die Python-Ausführung aus Jupyter Notebooks an SQL zu senden, benötigst du Microsofts RevoscalePy-Paket. Lade dafür Microsofts ML Services Python Client herunter und installiere ihn. Dokumentationsseite oder direkter Download-Link (für Windows).
Öffne nach dem Download PowerShell als Administrator und wechsle in den Download-Ordner. Starte die Installation mit diesem Befehl (du kannst den Installationsordner anpassen): .\Install-PyForMLS.ps1 -InstallFolder "C:\Program Files\MicrosoftPythonClient"
Hab etwas Geduld, die Installation kann einen Moment dauern. Gehe nach der Installation in den neuen Pfad. Lass uns einen leeren Ordner anlegen und Jupyter Notebooks öffnen: mkdir JupyterNotebooks; cd JupyterNotebooks; ..\Scripts\jupyter-notebook
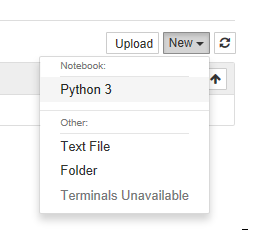
Erstelle ein neues Notebook mit dem Python-3-Interpreter:
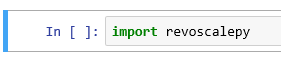
Um zu testen, ob alles korrekt eingerichtet ist, importiere revoscalepy in der ersten Zelle und führe sie aus. Wenn keine Fehlermeldung erscheint, kannst du weitermachen.
Für den Rest des Tutorials kannst du dieses Jupyter Notebook von GitHub klonen, wenn du nicht den gesamten Code kopieren möchtest. Diese Datenbankeinrichtung ist ein einmaliger Schritt, damit du die gleichen Daten wie in diesem Tutorial hast. Für eigene Daten brauchst du diese Einrichtungsschritte nicht.
Pass die Verbindungszeichenfolge für deinen Server an und nutze pyodbc, um eine neue Datenbank zu erstellen.
 import pyodbc

# creating a new db to load Iris sample in
new_db_name = "MLRemoteExec"
connection_string = "Driver=SQL Server;Server=localhost\MSSQLSERVER2017;Database={0};Trusted_Connection=Yes;"
cnxn = pyodbc.connect(connection_string.format("master"), autocommit=True)
cnxn.cursor().execute("IF EXISTS(SELECT * FROM sys.databases WHERE [name] = '{0}') DROP DATABASE {0}".format(new_db_name))
cnxn.cursor().execute("CREATE DATABASE " + new_db_name)
cnxn.close()

print("Database created")Iris ist ein beliebter Datensatz für Einsteiger-Tutorials in Data Science. Er ist standardmäßig im sklearn-Paket enthalten.
from sklearn import datasets
import pandas as pd

# SkLearn has the Iris sample dataset built into the package
iris = datasets.load_iris()
df = pd.DataFrame(iris.data, columns=iris.feature_names)(Das geht auch mit pyodbc, sqlalchemy oder anderen Paketen.)
 from revoscalepy import RxSqlServerData, rx_data_step

# Example of using RX APIs to load data into SQL table. You can also do this with pyodbc
table_ref = RxSqlServerData(connection_string=connection_string.format(new_db_name), table="Iris")
rx_data_step(input_data = df, output_file = table_ref, overwrite = True)

print("New Table Created: Iris")
print("Sklearn Iris sample loaded into Iris table")Schreibe beliebigen Python-Code, den du in SQL ausführen möchtest. In diesem Beispiel erstellen wir eine Scatter-Matrix für den Iris-Datensatz und senden nur den Bytestream der .png-Datei zurück an Jupyter Notebooks, um das Bild clientseitig zu rendern.
def send_this_func_to_sql():from revoscalepy import RxSqlServerData, rx_import
    from pandas.tools.plotting import scatter_matrix
    import matplotlib.pyplot as plt
    import io

    # remember the scope of the variables in this func are within our SQL Server Python Runtime
    connection_string = "Driver=SQL Server;Server=localhost\MSSQLSERVER2017;Database=MLRemoteExec;Trusted_Connection=Yes;"# specify a query and load into pandas dataframe df
    sql_query = RxSqlServerData(connection_string=connection_string, sql_query = "select * from Iris")
    df = rx_import(sql_query)

    scatter_matrix(df)

    # return bytestream of image created by scatter_matrix
    buf = io.BytesIO()
    plt.savefig(buf, format="png")
    buf.seek(0)

return buf.getvalue()Jetzt, wo alles eingerichtet ist, siehst du, wie einfach Remote-Ausführung ist. Zuerst revoscalepy importieren. Erstelle einen sql_compute_context und sende dann die Ausführung beliebiger Funktionen nahtlos mit RxExec an SQL Server. Es mussten keine Rohdaten von SQL ins Jupyter Notebook übertragen werden. Die gesamte Berechnung fand in der Datenbank statt, und nur die Bilddatei wurde zur Anzeige zurückgegeben.
from IPython import display
import matplotlib.pyplot as plt
from revoscalepy import RxInSqlServer, rx_exec

# create a remote compute context with connection to SQL Server
sql_compute_context = RxInSqlServer(connection_string=connection_string.format(new_db_name))

# use rx_exec to send the function execution to SQL Server
image = rx_exec(send_this_func_to_sql, compute_context=sql_compute_context)[0]

# only an image was returned to my jupyter client. All data remained secure and was manipulated in my db.
display.Image(data=image)
Auch wenn dieses Beispiel mit dem Iris-Datensatz simpel ist, eröffnet es dir enorme Möglichkeiten bei Skalierung, Performance und Sicherheit. Du kannst beliebige aktuelle Open-Source-Pakete für R/Python nutzen, um Deep-Learning- und KI-Anwendungen auf großen Datenmengen in SQL Server zu bauen. Außerdem bieten wir führende, leistungsstarke Algorithmen in Microsofts RevoScaleR- und RevoScalePy-APIs. In Kombination mit den neuesten Innovationen aus der Open-Source-Welt bringst du eine unerreichte Auswahl, Performance und Skalierung in deine Anwendungen.
Sieh dir DataCamps Tutorial zu How to Execute Python/R in SQL an.
Wirf einen Blick in die SQL Machine Learning Services-Dokumentation, um zu lernen, wie du R-/Python-Code bequem mit SQL Stored Procedures bereitstellst und so in ETL-Prozessen oder aus beliebigen Anwendungen nutzbar machst. Trainiere und speichere Machine-Learning-Modelle in deiner Datenbank und bringe Intelligenz dorthin, wo deine Daten liegen.
Basic R and Python Execution in SQL Server: https://aka.ms/BasicMLServicesExecution
Set up Machine Learning Services in SQL Server: https://aka.ms/SetupMLServices
End-to-End-Tutoriallösungen auf GitHub: https://microsoft.github.io/sql-ml-tutorials/
Weitere YouTube-Tutorials:
Wenn du mehr lernen möchtest, schau dir DataCamps Einstiegskurse an.
Erfahre mehr über Python, R und SQL
Kurs
Kurs
Kurs