
50% off DataCamp Premium. 700+ courses, half price. Start learning today.
Python en R zijn veelgebruikte programmeertalen die populair zijn bij data scientists, data engineers en machinelearning-engineers. Python-code kunnen draaien als een SQL-script opent eindeloze mogelijkheden voor dataoperaties, waaronder in-database machinelearningfunctionaliteit wanneer je met grote hoeveelheden data werkt. De favoriete tools voor machinelearningexperimenten zijn geïntegreerde ontwikkelomgevingen (IDE’s) zoals VS Code of Notebooks, die van nature interactief zijn. Deze tools kunnen echter beperkingen opleveren wanneer de dataset erg groot wordt, of wanneer het ML-model in productie moet. Er is daarom een grote behoefte om te kunnen programmeren en modellen te trainen op de plek waar de data zich bevindt; in deze tutorial leer je verschillende manieren om dat te doen.
Veel databases worden tegenwoordig geleverd met ingebouwde machinelearningservices (zie de volgende sectie). Dat betekent dat je geen apart data science-platform hoeft aan te schaffen, omdat je met in-database machine learning je modellen in de database kunt trainen en uitrollen. Een typische machinelearningworkflow ziet er zo uit:
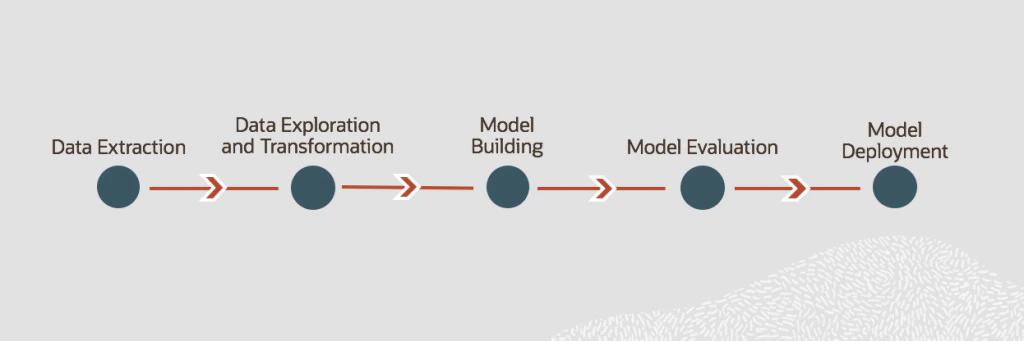
Als je een machinelearningmodel in de database traint, heb je geen aparte ETL-procedure nodig, omdat je data al in de database staat. Dat scheelt veel tijd. Voor de vervolgstappen zoals Modelopbouw en Uitrol hoef je ook niet over te stappen naar een extern machinelearningplatform, omdat je de in-database mogelijkheden gebruikt om een ML-oplossing te trainen en te deployen. Volgens de Oracle Big Data Blog zijn daar drie voordelen van:
Het kan vaak uren of dagen kosten om data naar een ander platform te verplaatsen waar de algoritmes staan. Ondanks dat dit complicaties kan introduceren, zoals mogelijk dataverlies, is dit bij de meeste bedrijven nog steeds gangbaar.
Het is logischer om de algoritmes naar de database te brengen in plaats van data naar de algoritmes te verplaatsen. Machine learning koppelen aan de database is dus praktischer, niet alleen qua eenvoud maar ook qua snelheid. Je bespaart tijd en veel moeite, wat uiteindelijk de kosten drukt.
Hoewel het veel tijd en moeite kan kosten om een machinelearningmodel te bouwen, te trainen, resultaten te verkrijgen en te analyseren, zijn bedrijven meestal pas geïnteresseerd in machine learning wanneer het model in productie staat zodat de verantwoordelijke afdelingen (Finance, HR, Supply Chain, Marketing, Sales, enz.) de resultaten kunnen benutten.
Omdat uitrol en integratie in applicaties zoals business intelligence (BI)-dashboards, callcenters, geldautomaten, websites en mobiele apparaten een grote uitdaging voor IT kunnen zijn, kan de operationalisering eenvoudig of juist heel complex zijn.
Als je model al die tijd in de database heeft gestaan, wordt de hoeveelheid complex uitrolwerk sterk verminderd. Dat maakt het proces een stuk eenvoudiger en levert sneller resultaten op.
Microsoft SQL Server Machine Learning Services ondersteunt R, Python, Java, het PREDICT T-SQL-commando en de opgeslagen procedure rx_Predict in de SQL Server RDBMS, en SparkML in SQL Server Big Data Clusters. In de talen R en Python levert Microsoft verschillende pakketten en libraries voor machine learning mee. Je kunt je getrainde modellen in de database of extern opslaan. Azure SQL Managed Instance ondersteunt Machine Learning Services voor Python en R als preview. Meer informatie.
Amazon Redshift is een beheerde datawarehouse-service op petabyteschaal die het eenvoudig en kostenefficiënt maakt om al je data te analyseren met je bestaande business intelligence-tools. Het is geoptimaliseerd voor datasets van enkele honderden gigabytes tot een petabyte of meer en kost minder dan $1.000 per terabyte per jaar. Meer informatie.
Oracle Cloud Infrastructure (OCI) Data Science is een beheerd en serverloos platform voor datascienseteams om machinelearningmodellen te bouwen, trainen en beheren met Oracle Cloud Infrastructure, waaronder Oracle Autonomous Database en Oracle Autonomous Data Warehouse. Het bevat Python-gerichte tools, libraries en pakketten ontwikkeld door de open community en de Oracle Accelerated Data Science (ADS) Library, die de end-to-end levenscyclus van voorspellende modellen ondersteunt. Meer informatie.
BigQuery is Google Cloud’s beheerde datawarehouse op petabyteschaal waarmee je bijna realtime analyses kunt draaien over enorme hoeveelheden data. Met BigQuery ML kun je machinelearningmodellen maken en uitvoeren in BigQuery met SQL-queries. BigQuery ML ondersteunt lineaire regressie voor forecasting; binaire en multiclass logistische regressie voor classificatie; K-means-clustering voor datasegmentatie; matrixfactorisatie voor het bouwen van productaanbevelingssystemen en time series voor tijdreeksvoorspellingen. Meer informatie.
IBM Db2 Warehouse on Cloud is een beheerde publieke cloudservice. Je kunt IBM Db2 Warehouse ook on-premises op je eigen hardware of in een private cloud opzetten. Als datawarehouse biedt het functies zoals in-memory dataverwerking en kolomgebaseerde tabellen voor online analytische verwerking. De Netezza-technologie levert een robuuste set analyses die ontworpen zijn om de query efficiënt naar de data te brengen. Meer informatie.
BlazingSQL is een GPU-versnelde SQL-engine gebouwd bovenop het RAPIDS-ecosysteem; het bestaat als open-sourceproject en als betaalde dienst. RAPIDS, dat CUDA gebruikt en is gebaseerd op het Apache Arrow-kolomgeheugenformaat, is een suite van open-sourcelibraries en API’s, geïncubeerd door Nvidia. CuDF, onderdeel van RAPIDS, is een Pandas-achtige GPU DataFrame-bibliotheek voor het laden, joinen, aggregeren, filteren en verder manipuleren van data. Meer informatie.
Machine Learning Services is een functie in SQL Server waarmee je Python- en R-scripts met relationele data kunt draaien. Je kunt open-sourcepakketten en -frameworks gebruiken, en de Python- en R-pakketten van Microsoft, voor voorspellende analyse en machine learning. De scripts worden in de database uitgevoerd zonder data buiten SQL Server of over het netwerk te verplaatsen. Dit artikel legt de basis van SQL Server Machine Learning Services uit en hoe je aan de slag gaat.
Met SQL Server Machine Learning Services kun je Python- en R-scripts in de database uitvoeren. Je kunt het gebruiken om data voor te bereiden en schoon te maken, feature engineering te doen, en machinelearningmodellen te trainen, evalueren en deployen binnen een database. De functie draait je scripts waar de data zich bevindt en voorkomt dat je data over het netwerk naar een andere server moet verplaatsen.
Op dit moment worden de volgende Python- en R-versies ondersteund in SQL Machine Learning Services.
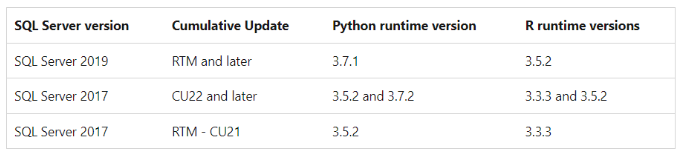
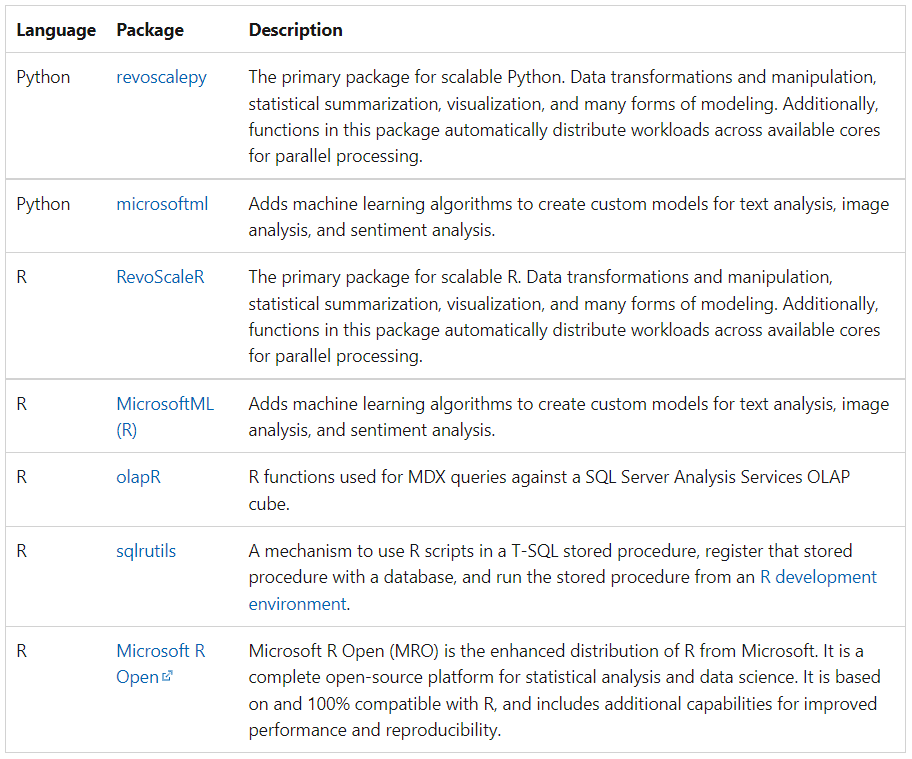
Je kunt alle open-sourcepakketten en -frameworks gebruiken die je wilt, maar de volgende Python- en R-pakketten zijn standaard geïnstalleerd:
PyCaret is een open-source, low-code machinelearningbibliotheek in Python die machinelearningworkflows automatiseert. Het is een end-to-end tool voor machine learning en modelbeheer die de experimentcyclus exponentieel versnelt en de productiviteit verhoogt.
Vergeleken met andere open-source machinelearningbibliotheken is PyCaret een alternatief low-code library waarmee je honderden regels code kunt vervangen door slechts een paar regels. Dat maakt experimenten exponentieel sneller en efficiënter. PyCaret is in essentie een Python-wrapper rond verschillende machinelearningbibliotheken en -frameworks zoals scikit-learn, XGBoost, LightGBM, CatBoost, spaCy, Optuna, Hyperopt, Ray en nog een paar.
Het ontwerp en de eenvoud van PyCaret zijn geïnspireerd door de opkomende rol van de citizen data scientist, een term die voor het eerst door Gartner is gebruikt. Citizen data scientists zijn power users die zowel eenvoudige als redelijk geavanceerde analytische taken kunnen uitvoeren die eerder meer technische expertise vereisten. Bekijk deze link om meer te weten te komen over PyCaret.
In de volgende sectie installeren we Microsoft SQL Server en schakelen we SQL Machine Learning Services in. Vervolgens activeren we de Python-omgeving, installeren we PyCaret (ML-bibliotheek) en gaan we modellen trainen. Zo doe je dat.
Microsoft SQL Server is een relationeel databasebeheersysteem van Microsoft. Als databaseserver vervult het de primaire functie van het opslaan en ophalen van data op verzoek van verschillende applicaties. In deze tutorial gebruiken we SQL Server 2019 Developer om via PyCaret een onbewaakt machinelearningmodel te trainen.
Als je SQL Server eerder hebt gebruikt, is de kans groot dat deze al is geïnstalleerd en je toegang hebt tot de database. Zo niet, klik dan hier om de SQL Server 2019 Developer-edities te downloaden.
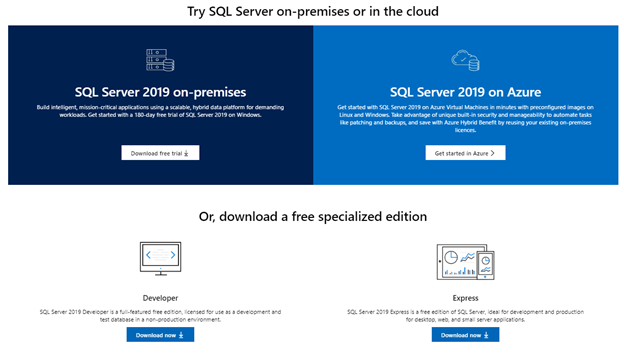
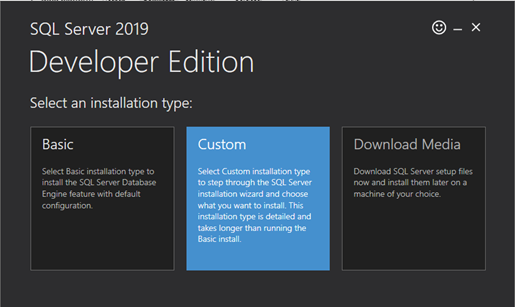
Klik op de knop “Download now” onder de Developer-editie en open het installatiebestand. Kies het installatietype “Custom”.
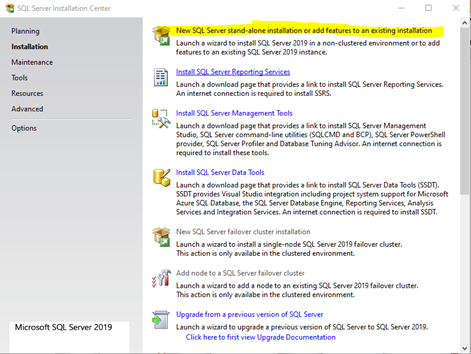
Kies New SQL Server stand-alone installation.
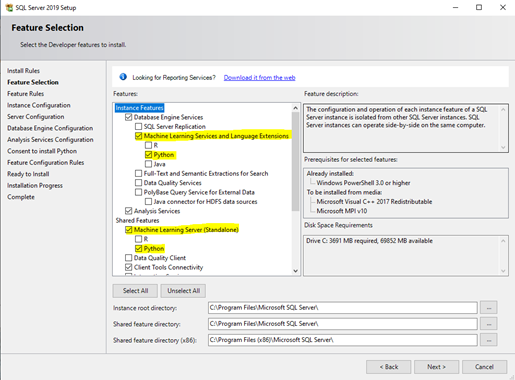
Selecteer bij Instance Features de opties, waaronder “Python” onder Machine Learning Services and Language Extensions en Machine Learning Server.
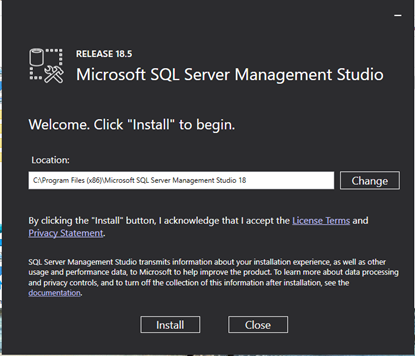
Zodra SQL Server succesvol is geïnstalleerd, hebben we een Integrated Development Environment (IDE) nodig. Er zijn veel opties beschikbaar; in deze tutorial gebruik ik echter Microsoft SQL Server Management Studio. Download de installer en volg de instructies. Het installeren van SSMS is eenvoudig.
Nadat SQL Server en SSMS zijn geïnstalleerd, maken we een nieuwe database en importeren we een CSV-bestand om mee te werken. Klik in het Object Explorer-paneel met de rechtermuisknop op Databases en kies “New Database”. Voer de databasenaam en andere informatie in. Dit kan een paar minuten duren.
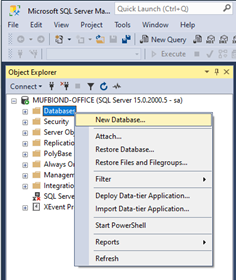
Als de database is aangemaakt, importeren we een CSV-bestand waar we in de volgende stappen mee gaan werken. Je kunt het voorbeeldbestand downloaden op je computer en vervolgens de instructies volgen.
Rechtsklik op “Tables” → New → Table. Je kunt de tabel noemen zoals je wilt. In dit voorbeeld noem ik de tabel “jewelry”.
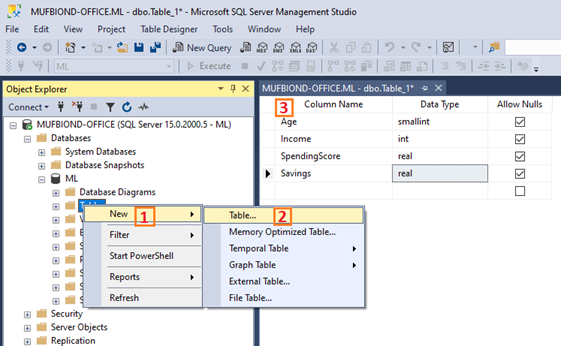
Nu de tabel is aangemaakt, kunnen we er inhoud aan toevoegen. Laten we het CSV-bestand in deze tabel importeren. Klik met de rechtermuisknop op de database en selecteer Tasks -> Import Data
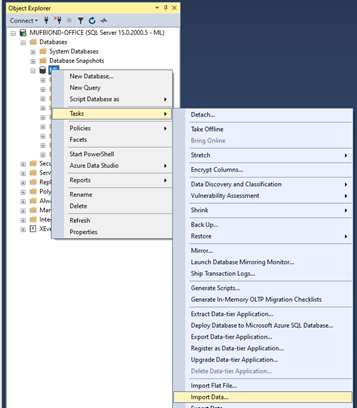
Kies bij Data Source “Flat File Source” en gebruik vervolgens de knop Browse om het CSV-bestand te selecteren. Neem even de tijd om de data-import te configureren voordat je op de knop Next klikt.
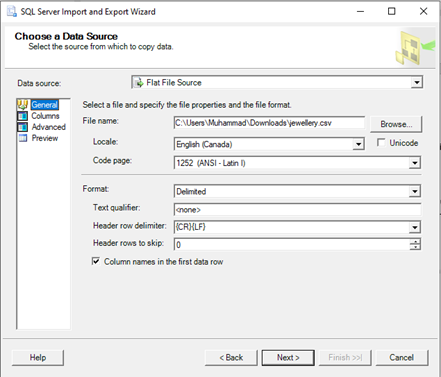
Klik op Next en voer de databasegegevens in (servernaam, gebruikersnaam en wachtwoord) en volg de instructies op de volgende schermen. Klik tot slot op de knop Finish om de import te voltooien.
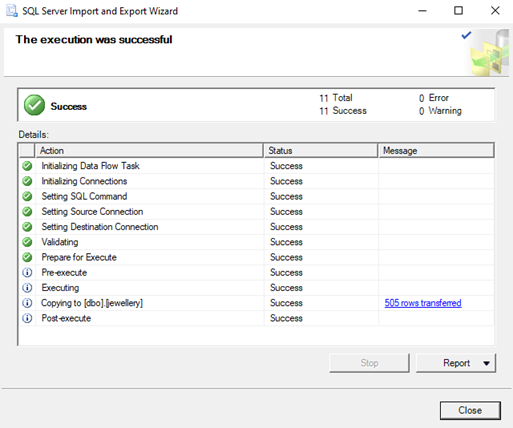
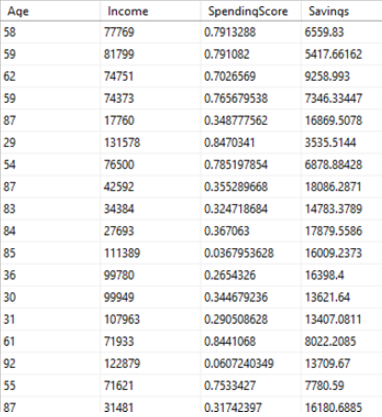
We hebben nu een tabel “jewelry” met geïmporteerde data.
Voordat we machinelearningmodellen in SQL gaan trainen, moeten we Python-scripts in SQL configureren. We draaien Python “binnen” de SQL Server met behulp van de systeemprocedure sp_execute_external_script. Klik om te beginnen op “New Query” en voer de volgende code uit om het gebruik van de procedure voor externe scriptexecutie in te schakelen:
EXEC sp_configure ‘external scripts enabled’, 1

RECONFIGURE WITH OVERRIDE
Herstart de SQL Server voordat je verdergaat.
Stel nu de taal in en controleer het pad van de installatie. Met Microsoft SQL Machine Learning Service heb je twee opties: R of Python. In dit voorbeeld gebruiken we Python, of specifieker PyCaret (een Python-bibliotheek voor machine learning), om een onbewaakt clustermodel te trainen op de dataset “jewelry”.
EXECUTE sp_execute_external_script

@language =N’Python’,

@script=N’import sys; print(“\n”.join(sys.path))’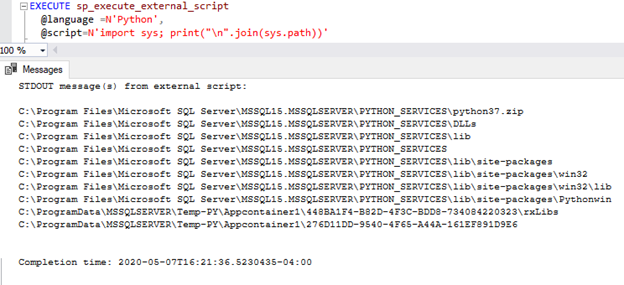
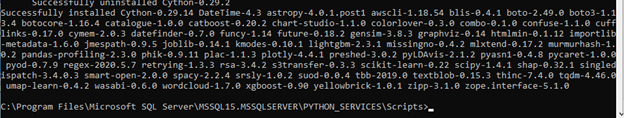
De laatste stap voordat we het model gaan trainen is het installeren van de PyCaret-bibliotheek. Om het PyCaret-pakket te installeren, open je een opdrachtprompt en navigeer je naar de locatie van de Python-pakketten waar SQL Server is geïnstalleerd (zie het pad hierboven). Voer de volgende code uit in de opdrachtprompt.
pip.exe install pycaret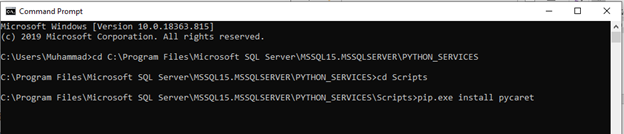
De installatie kan 10-15 minuten duren. Als het klaar is, ziet het er zo uit:
Ga nu terug naar Microsoft SSMS.
Clustering is een machinelearningtechniek die datapunten met vergelijkbare kenmerken groepeert. Deze groeperingen zijn handig voor het verkennen van data, het identificeren van patronen en het analyseren van een subset van data. Enkele veelvoorkomende zakelijke use-cases voor clustering zijn:
We hebben vier datapunten per klant, die er zo uitzien:
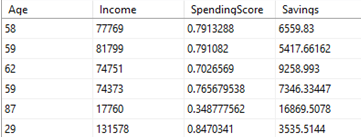
Ons doel is om een KMeans-clustermodel op deze dataset te trainen en een nieuwe kolom “Cluster” te creëren die de groep klanten vertegenwoordigt die bij elkaar horen.
EXECUTE sp_execute_external_script

@language = N’Python’,

@script = N’dataset = InputDataSet

import pycaret.clustering as pc

dataset = pc.get_clusters(data = dataset, num_clusters=4)

OutputDataSet = dataset’,

@input_data_1 = N’SELECT [Age], [Income], [SpendingScore], [Savings] FROM [jewellery]’

WITH RESULT SETS(([Age] INT, [Income] INT, [SpendingScore] FLOAT, [Savings] FLOAT, [Cluster] varchar(15)));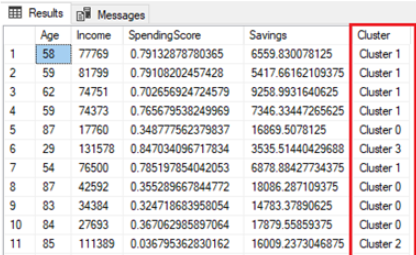
Zie je hoe eenvoudig dat was? Met slechts één regel `pc.get_clusters(...)` hebben we de data gepreprocessed, een onbewaakt KMeans-model getraind en het getrainde model gebruikt om clusterlabels te genereren – allemaal zonder de SQL Server-omgeving te verlaten. Net als voor clustering ondersteunt PyCaret ook onbewaakte anomaliedetectie met het `pc.get_anomaly`-commando. Je kunt ook bewaakte machinelearningmodellen (Classificatie of Regressie) trainen, het model opslaan in een SQL-procedure en het later gebruiken om inferenties te genereren. Dit kan allemaal rechtstreeks vanuit je database.
Wat betekent machine learning in de database voor jouw bedrijf? Het betekent dat je het aantal benodigde stappen kunt minimaliseren voor efficiëntere, snellere en eenvoudiger te operationaliseren machine learning. Het trainen van machinelearningmodellen in de database minimaliseert dataverplaatsing, wat tijd en kosten bespaart. Het is echter geen wondermiddel. Of je het toepast hangt altijd af van de use-case. Hopelijk heeft deze tutorial je een nieuw perspectief gegeven op de mogelijkheden van machine learning in enterprise-omgevingen.
Wil je meer leren over hoe Python en SQL samen kunnen worden gebruikt om je data-analyse en efficiëntie te verbeteren? Dan raad ik de cursus Introduction to Databases in Python aan. In deze cursus leer je de basis van het gebruik van SQL met Python. Dat is nuttig, omdat databases overal zijn en data scientists, analisten en engineers er voortdurend mee moeten werken. De Python SQL-toolkit SQLAlchemy biedt een toegankelijke en intuïtieve manier om essentiële databases te bevragen, op te bouwen en naar te schrijven, waaronder SQLite, MySQL en PostgreSQL.
{count, plural, one {blog} other {blogs}}
Adel Nehme
15 min

