Curso
Introducción a la ciencia de datos con Python
4 h
502.4K
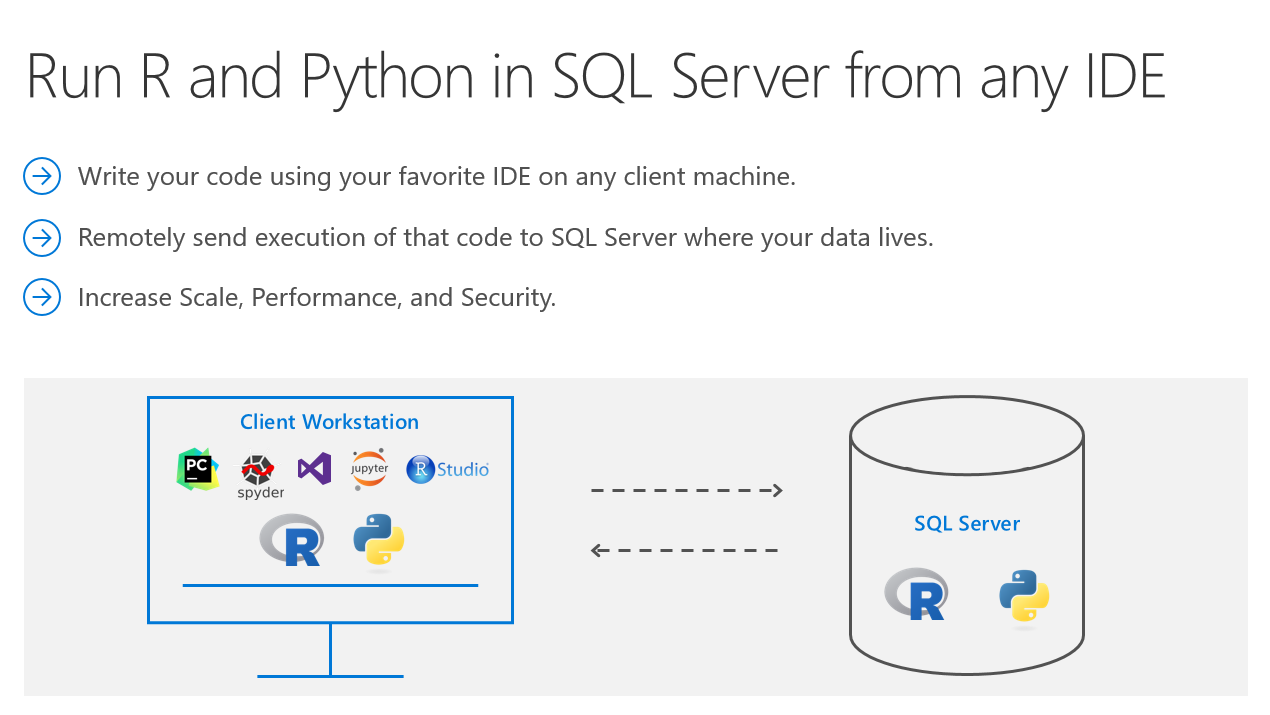
¿Sabías que puedes ejecutar código de R y Python de forma remota en SQL Server desde Jupyter Notebooks o cualquier IDE? Machine Learning Services en SQL Server elimina la necesidad de mover datos. En lugar de transferir por la red datos voluminosos y sensibles o perder precisión al entrenar modelos con archivos CSV de muestra, puedes ejecutar tu código de R/Python dentro de la base de datos. Trabaja en Jupyter Notebooks, RStudio, PyCharm, VSCode, Visual Studio, donde prefieras, y envía la ejecución de funciones a SQL Server para llevar la inteligencia allí donde viven tus datos.
En este tutorial verás un ejemplo de cómo enviar tu código de Python desde Jupyter Notebooks para que se ejecute dentro de SQL Server. Los mismos principios se aplican a R y a cualquier otro IDE. Si prefieres aprender con vídeos, este tutorial también está publicado en YouTube aquí:
Para que R o Python se ejecuten dentro de SQL, primero necesitas instalar y configurar la característica Machine Learning Services. Consulta esta guía paso a paso.
Para enviar la ejecución de Python a SQL desde Jupyter Notebooks, necesitas usar el paquete RevoscalePy de Microsoft. Para obtener RevoscalePy, descarga e instala el cliente de Python de ML Services de Microsoft. Página de documentación o enlace de descarga directa (para Windows).
Después de descargar, abre PowerShell como administrador y navega a la carpeta de descarga. Inicia la instalación con este comando (puedes personalizar la carpeta de destino): .\\Install-PyForMLS.ps1 -InstallFolder "C:\\Program Files\\MicrosoftPythonClient"
Ten paciencia: la instalación puede tardar un poco. Una vez instalada, navega a la nueva ruta donde la instalaste. Crea una carpeta vacía y abre Jupyter Notebooks: mkdir JupyterNotebooks; cd JupyterNotebooks; ..\\Scripts\\jupyter-notebook
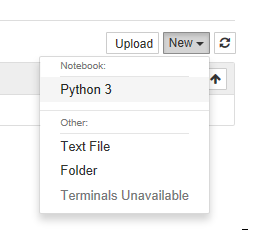
Crea un notebook nuevo con el intérprete de Python 3:
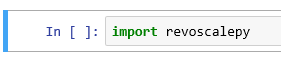
Para comprobar que todo está listo, importa revoscalepy en la primera celda y ejecútala. Si no aparecen errores, puedes continuar.
Para el resto del tutorial, puedes clonar este Jupyter Notebook de Github si no quieres copiar y pegar todo el código. Esta configuración de base de datos es un paso único para asegurarte de que tienes los mismos datos que en este tutorial. No necesitas realizar ninguno de estos pasos para usar tus propios datos.
Modifica la cadena de conexión para tu servidor y usa pyodbc para crear una base de datos nueva.
 import pyodbc

# creating a new db to load Iris sample in
new_db_name = "MLRemoteExec"
connection_string = "Driver=SQL Server;Server=localhost\MSSQLSERVER2017;Database={0};Trusted_Connection=Yes;"
cnxn = pyodbc.connect(connection_string.format("master"), autocommit=True)
cnxn.cursor().execute("IF EXISTS(SELECT * FROM sys.databases WHERE [name] = '{0}') DROP DATABASE {0}".format(new_db_name))
cnxn.cursor().execute("CREATE DATABASE " + new_db_name)
cnxn.close()

print("Database created")Iris es un conjunto de datos muy usado en tutoriales de ciencia de datos para principiantes. Viene incluido por defecto en el paquete sklearn.
from sklearn import datasets
import pandas as pd

# SkLearn has the Iris sample dataset built into the package
iris = datasets.load_iris()
df = pd.DataFrame(iris.data, columns=iris.feature_names)(También puedes hacerlo con pyodbc, sqlalchemy u otros paquetes)
 from revoscalepy import RxSqlServerData, rx_data_step

# Example of using RX APIs to load data into SQL table. You can also do this with pyodbc
table_ref = RxSqlServerData(connection_string=connection_string.format(new_db_name), table="Iris")
rx_data_step(input_data = df, output_file = table_ref, overwrite = True)

print("New Table Created: Iris")
print("Sklearn Iris sample loaded into Iris table")Escribe el código de Python que quieras ejecutar en SQL. En este ejemplo, creamos una matriz de dispersión del conjunto de datos Iris y solo devolvemos a Jupyter Notebooks el flujo de bytes del .png para renderizarlo en el cliente.
def send_this_func_to_sql():from revoscalepy import RxSqlServerData, rx_import
    from pandas.tools.plotting import scatter_matrix
    import matplotlib.pyplot as plt
    import io

    # remember the scope of the variables in this func are within our SQL Server Python Runtime
    connection_string = "Driver=SQL Server;Server=localhost\MSSQLSERVER2017;Database=MLRemoteExec;Trusted_Connection=Yes;"# specify a query and load into pandas dataframe df
    sql_query = RxSqlServerData(connection_string=connection_string, sql_query = "select * from Iris")
    df = rx_import(sql_query)

    scatter_matrix(df)

    # return bytestream of image created by scatter_matrix
    buf = io.BytesIO()
    plt.savefig(buf, format="png")
    buf.seek(0)

return buf.getvalue()Ahora que ya está todo listo, verás lo sencillo que es enviar ejecución remota. Primero, import revoscalepy. Crea un sql_compute_context y envía sin fricciones la ejecución de cualquier función a SQL Server con RxExec. No se transfirieron datos en crudo de SQL al Jupyter Notebook. Todo el cálculo ocurrió dentro de la base de datos y solo se devolvió la imagen para mostrarla.
from IPython import display
import matplotlib.pyplot as plt
from revoscalepy import RxInSqlServer, rx_exec

# create a remote compute context with connection to SQL Server
sql_compute_context = RxInSqlServer(connection_string=connection_string.format(new_db_name))

# use rx_exec to send the function execution to SQL Server
image = rx_exec(send_this_func_to_sql, compute_context=sql_compute_context)[0]

# only an image was returned to my jupyter client. All data remained secure and was manipulated in my db.
display.Image(data=image)
Aunque este ejemplo con Iris es sencillo, imagina la escala, el rendimiento y la seguridad adicionales que acabas de desbloquear. Puedes usar cualquiera de los paquetes open source más recientes de R/Python para crear aplicaciones de deep learning e IA sobre grandes volúmenes de datos en SQL Server. También ofrecemos algoritmos de vanguardia y alto rendimiento en las API RevoScaleR y RevoScalePy de Microsoft. Usarlas junto con las últimas innovaciones del mundo open source te permite dotar a tus aplicaciones de una selección, un rendimiento y una escala sin precedentes.
Echa un vistazo al tutorial de DataCamp sobre cómo ejecutar Python/R en SQL.
Consulta la documentación de SQL Machine Learning Services para aprender a implementar fácilmente tu código de R/Python con procedimientos almacenados de SQL y hacerlo accesible desde tus procesos ETL o desde cualquier aplicación. Entrena y guarda modelos de machine learning en tu base de datos y lleva la inteligencia allí donde viven tus datos.
Ejecución básica de R y Python en SQL Server: https://aka.ms/BasicMLServicesExecution
Configura Machine Learning Services en SQL Server: https://aka.ms/SetupMLServices
Soluciones de tutoriales de extremo a extremo en Github: https://microsoft.github.io/sql-ml-tutorials/
Otros tutoriales en YouTube:
Si te interesa seguir aprendiendo, echa un vistazo a los cursos introductorios de DataCamp.
Sigue aprendiendo sobre Python, R y SQL
Curso
Curso
Curso
blog
Javier Canales Luna
10 min
Tutorial
Abid Ali Awan
13 min
Tutorial
Abid Ali Awan
13 min
Tutorial
Abid Ali Awan
10 min
Tutorial
Elena Kosourova
12 min
Tutorial
Francisco Javier Carrera Arias
6 min