Cours
Introduction à la Data Science en Python
4 h
502.3K
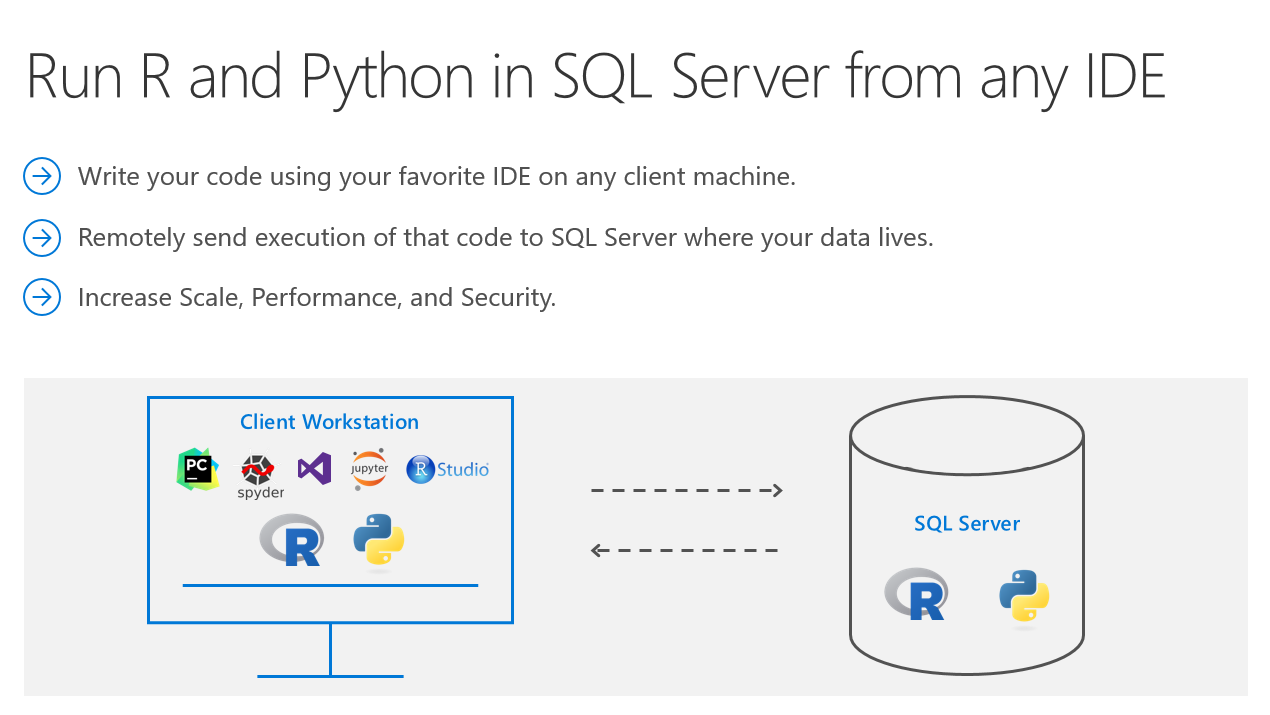
Saviez-vous que vous pouvez exécuter du code R et Python à distance dans SQL Server depuis Jupyter Notebooks ou n’importe quel IDE ? Les Machine Learning Services de SQL Server évitent d’avoir à déplacer les données. Plutôt que de transférer des volumes de données sensibles sur le réseau ou de perdre en précision en entraînant des modèles sur des fichiers CSV d’échantillons, vous pouvez exécuter votre code R/Python directement au sein de votre base de données. Travaillez dans Jupyter Notebooks, RStudio, PyCharm, VSCode, Visual Studio — où vous voulez — puis envoyez l’exécution de vos fonctions vers SQL Server pour apporter l’intelligence là où résident vos données.
Ce tutoriel vous montre comment envoyer votre code Python depuis Jupyter Notebooks pour l’exécuter dans SQL Server. Les mêmes principes s’appliquent à R et à tout autre IDE. Si vous préférez apprendre en vidéo, ce tutoriel est aussi disponible sur YouTube :
Pour exécuter R ou Python dans SQL, vous devez d’abord installer et configurer la fonctionnalité Machine Learning Services. Consultez ce guide pas à pas.
Pour envoyer l’exécution Python à SQL depuis Jupyter Notebooks, utilisez le package RevoscalePy de Microsoft. Pour l’obtenir, téléchargez et installez le client Python de ML Services de Microsoft. Page de documentation ou lien de téléchargement direct (Windows).
Après téléchargement, ouvrez PowerShell en tant qu’administrateur et placez-vous dans le dossier de téléchargement. Lancez l’installation avec cette commande (vous pouvez personnaliser le dossier d’installation) : .\Install-PyForMLS.ps1 -InstallFolder "C:\Program Files\MicrosoftPythonClient"
Patientez, l’installation peut prendre un moment. Une fois terminée, accédez au nouveau chemin d’installation. Créons un dossier vide et ouvrons Jupyter Notebooks : mkdir JupyterNotebooks; cd JupyterNotebooks; ..\Scripts\jupyter-notebook
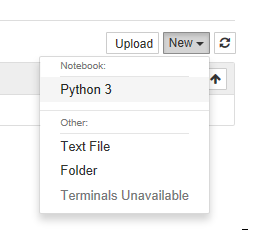
Créez un nouveau notebook avec l’interpréteur Python 3 :
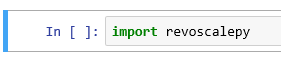
Pour vérifier que tout est prêt, importez revoscalepy dans la première cellule et exécutez-la. S’il n’y a pas de message d’erreur, vous pouvez continuer.
Pour la suite, vous pouvez cloner ce Jupyter Notebook depuis GitHub si vous ne souhaitez pas copier-coller tout le code. Cette configuration de base de données est une étape unique pour garantir que vous disposez des mêmes données que dans ce tutoriel. Vous n’avez pas besoin d’effectuer ces étapes si vous utilisez vos propres données.
Modifiez la chaîne de connexion pour votre serveur et utilisez pyodbc pour créer une nouvelle base.
 import pyodbc

# creating a new db to load Iris sample in
new_db_name = "MLRemoteExec"
connection_string = "Driver=SQL Server;Server=localhost\MSSQLSERVER2017;Database={0};Trusted_Connection=Yes;"
cnxn = pyodbc.connect(connection_string.format("master"), autocommit=True)
cnxn.cursor().execute("IF EXISTS(SELECT * FROM sys.databases WHERE [name] = '{0}') DROP DATABASE {0}".format(new_db_name))
cnxn.cursor().execute("CREATE DATABASE " + new_db_name)
cnxn.close()

print("Database created")Iris est un jeu de données très utilisé pour débuter en data science. Il est inclus par défaut dans le package sklearn.
from sklearn import datasets
import pandas as pd

# SkLearn has the Iris sample dataset built into the package
iris = datasets.load_iris()
df = pd.DataFrame(iris.data, columns=iris.feature_names)(Vous pouvez aussi le faire avec pyodbc, sqlalchemy ou d’autres packages)
 from revoscalepy import RxSqlServerData, rx_data_step

# Example of using RX APIs to load data into SQL table. You can also do this with pyodbc
table_ref = RxSqlServerData(connection_string=connection_string.format(new_db_name), table="Iris")
rx_data_step(input_data = df, output_file = table_ref, overwrite = True)

print("New Table Created: Iris")
print("Sklearn Iris sample loaded into Iris table")Écrivez le code Python que vous souhaitez exécuter dans SQL. Dans cet exemple, nous créons une matrice de nuages de points sur le jeu de données Iris et nous ne renvoyons à Jupyter Notebooks que le flux d’octets du fichier .png, qui sera affiché côté client.
def send_this_func_to_sql():from revoscalepy import RxSqlServerData, rx_import
    from pandas.tools.plotting import scatter_matrix
    import matplotlib.pyplot as plt
    import io

    # remember the scope of the variables in this func are within our SQL Server Python Runtime
    connection_string = "Driver=SQL Server;Server=localhost\MSSQLSERVER2017;Database=MLRemoteExec;Trusted_Connection=Yes;"# specify a query and load into pandas dataframe df
    sql_query = RxSqlServerData(connection_string=connection_string, sql_query = "select * from Iris")
    df = rx_import(sql_query)

    scatter_matrix(df)

    # return bytestream of image created by scatter_matrix
    buf = io.BytesIO()
    plt.savefig(buf, format="png")
    buf.seek(0)

return buf.getvalue()Maintenant que tout est en place, voyez comme il est simple d’envoyer une exécution distante ! D’abord, import revoscalepy. Créez un sql_compute_context, puis envoyez l’exécution de n’importe quelle fonction vers SQL Server avec RxExec. Aucune donnée brute n’a été transférée de SQL vers le Jupyter Notebook. Tous les calculs ont eu lieu dans la base, et seul le fichier image a été renvoyé pour affichage.
from IPython import display
import matplotlib.pyplot as plt
from revoscalepy import RxInSqlServer, rx_exec

# create a remote compute context with connection to SQL Server
sql_compute_context = RxInSqlServer(connection_string=connection_string.format(new_db_name))

# use rx_exec to send the function execution to SQL Server
image = rx_exec(send_this_func_to_sql, compute_context=sql_compute_context)[0]

# only an image was returned to my jupyter client. All data remained secure and was manipulated in my db.
display.Image(data=image)
Même si l’exemple avec Iris est simple, imaginez l’échelle, les performances et la sécurité supplémentaires auxquelles vous avez désormais accès. Vous pouvez utiliser les derniers packages open source R/Python pour créer des applications d’apprentissage profond et d’IA sur de grands volumes de données dans SQL Server. Nous proposons aussi des algorithmes de pointe et hautes performances dans les APIs RevoScaleR et RevoScalePy de Microsoft. En les combinant avec les dernières innovations open source, vous offrez à vos applications un choix, des performances et une mise à l’échelle inégalés.
Découvrez le tutoriel de DataCamp sur How to Execute Python/R in SQL.
Consultez la documentation de SQL Machine Learning Services pour apprendre à déployer facilement votre code R/Python via des procédures stockées SQL et l’intégrer à vos processus ETL ou à n’importe quelle application. Entraînez et stockez des modèles de machine learning dans votre base pour apporter l’intelligence au plus près de vos données.
Exécution R et Python de base dans SQL Server : https://aka.ms/BasicMLServicesExecution
Configurer Machine Learning Services dans SQL Server : https://aka.ms/SetupMLServices
Didacticiels de bout en bout sur GitHub : https://microsoft.github.io/sql-ml-tutorials/
Autres tutoriels YouTube :
Pour aller plus loin, découvrez les cours d’introduction de DataCamp.
Approfondissez Python, R et SQL
Cours
Cours
Cours