
Cursus
Tijdreeksanalyse in Python
4 uur
70.9K
Oefen en volg je voortgang.
Ga Verder Met GoogleIn de Facebook Live code-alongsessie op 4 januari bekeken we Google Trends-gegevens van de zoekwoorden 'diet', 'gym' en 'finance' om te zien hoe ze in de tijd variëren. We vroegen ons af of er in januari meer naar deze termen wordt gezocht, wanneer we allemaal proberen met een schone lei te beginnen?
In deze tutorial loop je stap voor stap door de code die we tijdens de sessie hebben opgebouwd. Je gaat niet veel wiskunde doen. De nadruk ligt volledig op een visuele verkenning van de dataset in kwestie.
Voor meer over pandas, bekijk DataCamps Data Manipulation with Python track. Voor meer over tijdreeksen met pandas, bekijk de cursus Manipulating Time Series Data in Python.
Dus de vraag blijft: zou er in januari meer naar deze termen worden gezocht, wanneer we allemaal proberen met een schone lei te beginnen?
Laten we het uitzoeken door hier naartoe te gaan en de data te bekijken. Let op dat deze tutorial is geïnspireerd op dit stuk van FiveThirtyEight.
Je kunt de data ook downloaden als .csv, opslaan en importeren in je eigen Python-omgeving om je eigen analyse uit te voeren. Dat ga je nu doen. Let’s go!
Om te beginnen importeer je enkele pakketten: in dit geval gebruik je numpy, pandas, matplotlib en seaborn.
Als je de afbeeldingen in de Jupyter Notebook wilt plotten, kun je IPython magic gebruiken door %matplotlib inline toe te voegen aan je code. Als alternatief kun je ook overschakelen naar de standaardinstellingen van Seaborn met sns.set():
# Import packages
import numpy as np
import pandas as pd
import matplotlib.pyplot as plt
import seaborn as sns
%matplotlib inline
sns.set()
Importeer de gedownloade data met .read_csv() en bekijk de eerste rijen met .head().
Let op dat je het argument skiprows toevoegt om de eerste rij aan het begin van het bestand over te slaan.
 df = pd.read_csv('data/multiTimeline.csv', skiprows=1)
df.head()| Month | diet: (Worldwide) | gym: (Worldwide) | finance: (Worldwide) | |
|---|---|---|---|---|
| 0 | 2004-01 | 100 | 31 | 48 |
| 1 | 2004-02 | 75 | 26 | 49 |
| 2 | 2004-03 | 67 | 24 | 47 |
| 3 | 2004-04 | 70 | 22 | 48 |
| 4 | 2004-05 | 72 | 22 | 43 |
Je kunt ook de methode .info() gebruiken om je datatypes, aantal rijen en meer te bekijken:
df.info()
<class 'pandas.core.frame.DataFrame'>
RangeIndex: 168 entries, 0 to 167
Data columns (total 4 columns):
Month                   168 non-null object
diet: (Worldwide)       168 non-null int64
gym: (Worldwide)        168 non-null int64
finance: (Worldwide)    168 non-null int64
dtypes: int64(3), object(1)
memory usage: 5.3+ KB
Nu je je data uit Google Trends hebt geïmporteerd en er kort naar hebt gekeken, is het tijd om je data op te schonen en in de gewenste vorm te brengen voor analyse.
Het eerste wat je wilt doen is de kolommen van je DataFrame df hernoemen zodat ze geen spaties bevatten. Er zijn meerdere manieren om dit te doen, maar voor nu wijs je aan df.columns een lijst toe met de gewenste kolomnamen.
Controleer het resultaat van je aanpassing door df.head() aan te roepen:
df.columns = ['month', 'diet', 'gym', 'finance']
df.head()
| month | diet | gym | finance | |
|---|---|---|---|---|
| 0 | 2004-01 | 100 | 31 | 48 |
| 1 | 2004-02 | 75 | 26 | 49 |
| 2 | 2004-03 | 67 | 24 | 47 |
| 3 | 2004-04 | 70 | 22 | 48 |
| 4 | 2004-05 | 72 | 22 | 43 |
Vervolgens zet je de kolom 'month' om naar een DateTime-datatype en maak je die tot de index van het DataFrame.
Let op dat je dit doet omdat je in het resultaat van de methode .info() zag dat de kolom 'Month' eigenlijk van datatype object was. Dat generieke datatype omvat alles van strings tot integers, enz. Dat is niet wat je wilt als je naar tijdreeksdata kijkt. Daarom gebruik je .to_datetime() om de kolom 'month' in je DataFrame om te zetten naar een DateTime.
Wees voorzichtig! Zorg ervoor dat je het argument inplace opneemt wanneer je de index van DataFrame df instelt, zodat je de oorspronkelijke index daadwerkelijk wijzigt en instelt op de kolom 'month'.
df.month = pd.to_datetime(df.month)
df.set_index('month', inplace=True)
df.head()
| diet | gym | finance | |
|---|---|---|---|
| month | |||
| 2004-01-01 | 100 | 31 | 48 |
| 2004-02-01 | 75 | 26 | 49 |
| 2004-03-01 | 67 | 24 | 47 |
| 2004-04-01 | 70 | 22 | 48 |
| 2004-05-01 | 72 | 22 | 43 |
Nu is het tijd om je DataFrame visueel te verkennen.
Je kunt een ingebouwde visualisatiemethode van pandas, .plot(), gebruiken om je data als 3 lijngrafieken in één figuur te plotten (één voor elke kolom, namelijk 'diet', 'gym' en 'finance').
Let op dat je ook enkele argumenten aan deze methode kunt meegeven, zoals figsize, linewidth en fontsize om respectievelijk de figuurgrootte, lijndikte en lettergrootte van de plot in te stellen.
Bovendien zie je dat wat je op de x-as ziet niet de maanden zijn, zoals het standaardlabel suggereert, maar de jaren. Om je plot wat nauwkeuriger te maken, specificeer je het label op de x-as als 'Year' en zet je de lettergrootte op 20.
Tip: als je de Matplotlib-uitvoer wilt onderdrukken, voeg dan gewoon een puntkomma ; toe aan je laatste coderegel!
df.plot(figsize=(20,10), linewidth=5, fontsize=20)
plt.xlabel('Year', fontsize=20);
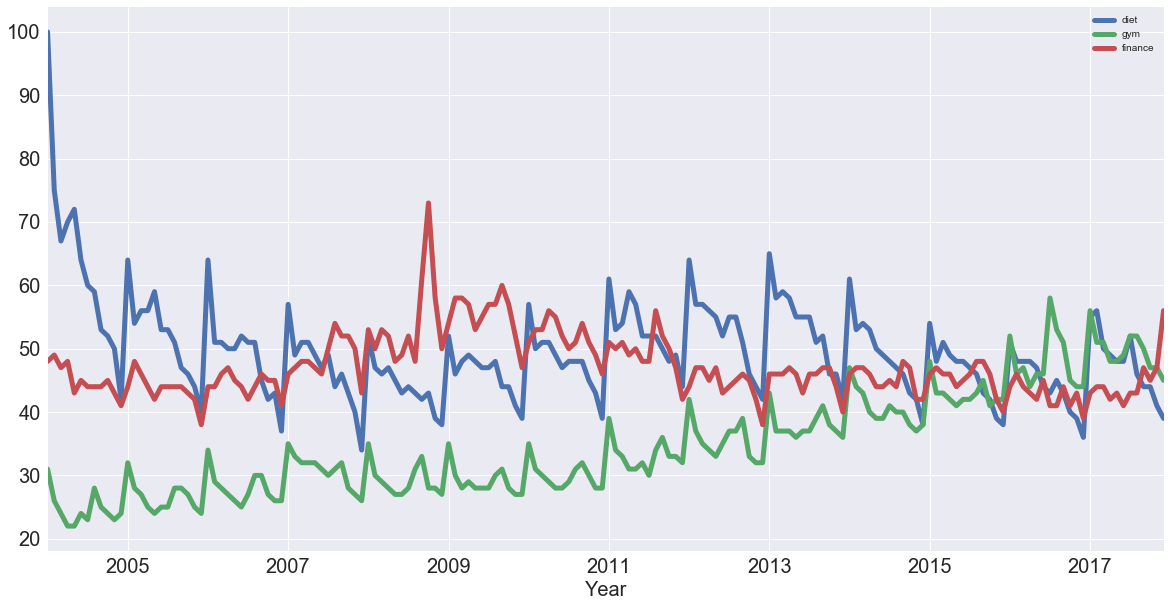
Let op dat deze data relatief is. Zoals je op Google Trends kunt lezen:
De cijfers geven de interesse in zoekopdrachten weer ten opzichte van het hoogste punt in de grafiek voor de betreffende regio en periode. Een waarde van 100 is de piekpopulariteit voor de term. Een waarde van 50 betekent dat de term half zo populair is. Evenzo betekent een score van 0 dat de term minder dan 1% zo populair was als de piek.
Als je wilt, kun je de kolom 'diet' ook afzonderlijk plotten als een tijdreeks:
df[['diet']].plot(figsize=(20,10), linewidth=5, fontsize=20)
plt.xlabel('Year', fontsize=20);
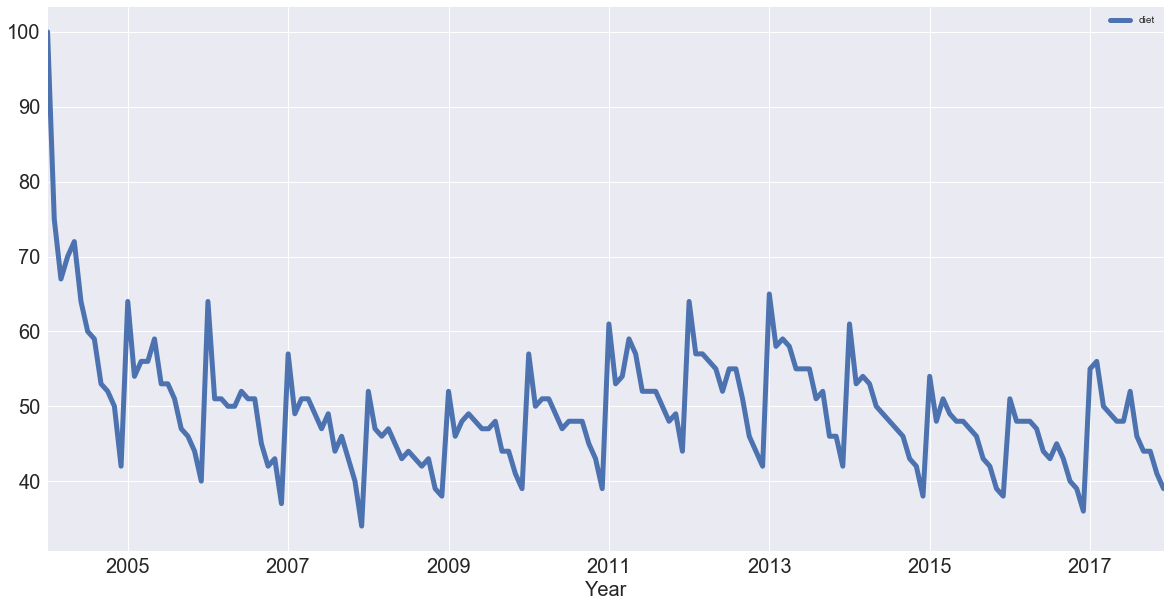
Let op: het eerste wat opvalt is dat er seizoenspatronen zijn: elke januari is er een flinke sprong. Ook lijkt er een trend te zijn: het gaat licht omhoog, dan omlaag, weer omhoog en dan weer omlaag. Met andere woorden, het lijkt erop dat er zowel trend- als seizoenscomponenten in deze tijdreeksen zitten.
Met dit in het achterhoofd leer je hoe je trends in je tijdreeks kunt identificeren!
Er zijn verschillende manieren om trends in tijdreeksen te identificeren. Een populaire manier is door een rollend gemiddelde te nemen, wat betekent dat je voor elk tijdstip het gemiddelde neemt van de punten aan weerszijden ervan. Merk op dat het aantal punten wordt bepaald door een venstergrootte, die je moet kiezen.
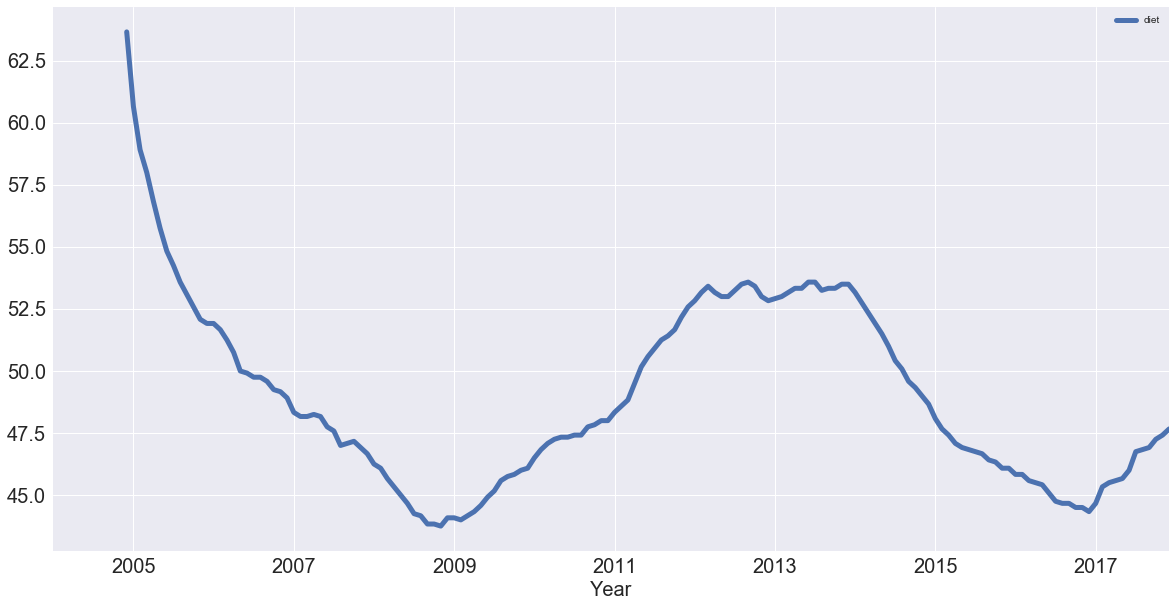
Doordat je het gemiddelde neemt, worden ruis en seizoensinvloeden geneigd uitgevlakt te worden. Je ziet daar nu een voorbeeld van. Bekijk dit rollend gemiddelde van 'diet' met behulp van de ingebouwde methoden van pandas.
Bij het bepalen van de venstergrootte is het logisch om eerst twaalf maanden te proberen, omdat je het hebt over jaarlijkse seizoensinvloeden.
diet = df[['diet']]
diet.rolling(12).mean().plot(figsize=(20,10), linewidth=5, fontsize=20)
plt.xlabel('Year', fontsize=20);
Let op dat je in het bovenstaande codeblok twee sets vierkante haken gebruikte om de kolom 'diet' als DataFrame te extraheren; Als je één set had gebruikt, zoals df['diet'], had je een pandas Series gemaakt.
In het bovenstaande codeblok heb je ook methoden gekoppeld: je riep methoden na elkaar aan op een object. Method chaining is behoorlijk populair en pandas is een van de pakketten die deze programmeerstijl maximaal ondersteunt!
Nu heb je de trend die je zocht! Je hebt vergeleken met de vorige plot het grootste deel van de seizoensinvloeden verwijderd.
Je kunt ook het rollend gemiddelde van 'gym' plotten met ingebouwde pandas-methoden met dezelfde venstergrootte als voor de 'diet'-data:
gym = df[['gym']]
gym.rolling(12).mean().plot(figsize=(20,10), linewidth=5, fontsize=20)
plt.xlabel('Year', fontsize=20);
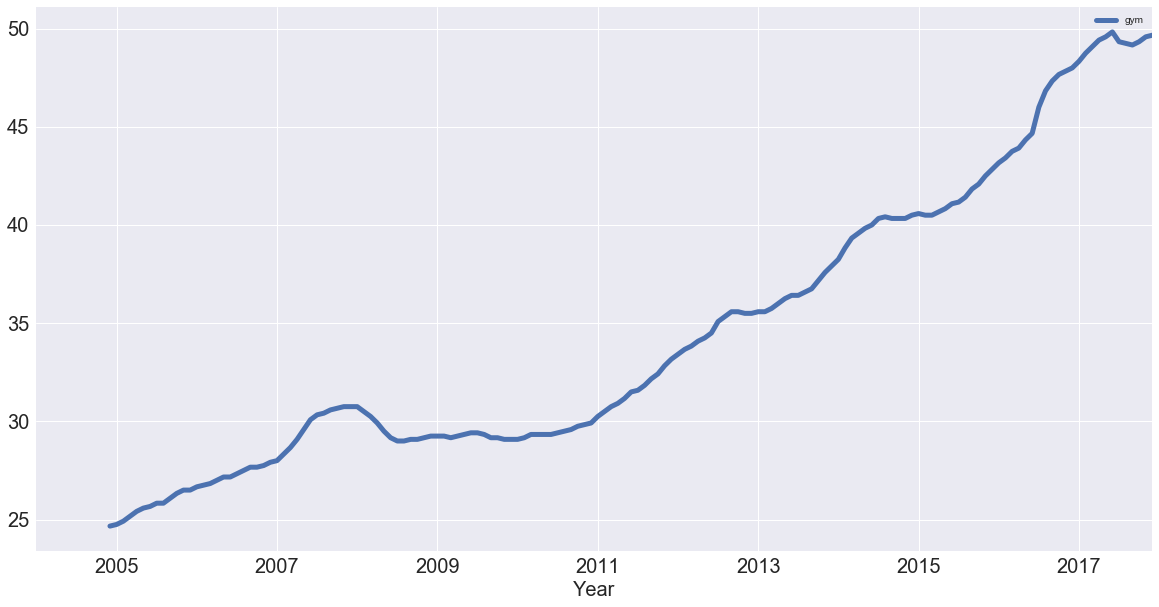
Je hebt de seizoensinvloeden succesvol verwijderd en je ziet een opwaartse trend voor "gym"! Maar hoe verhouden deze twee zoektermen zich tot elkaar?
Je kunt dit achterhalen door de trends van 'gym' en 'diet' in één figuur te plotten:
df_rm = pd.concat([diet.rolling(12).mean(), gym.rolling(12).mean()], axis=1)
df_rm.plot(figsize=(20,10), linewidth=5, fontsize=20)
plt.xlabel('Year', fontsize=20);
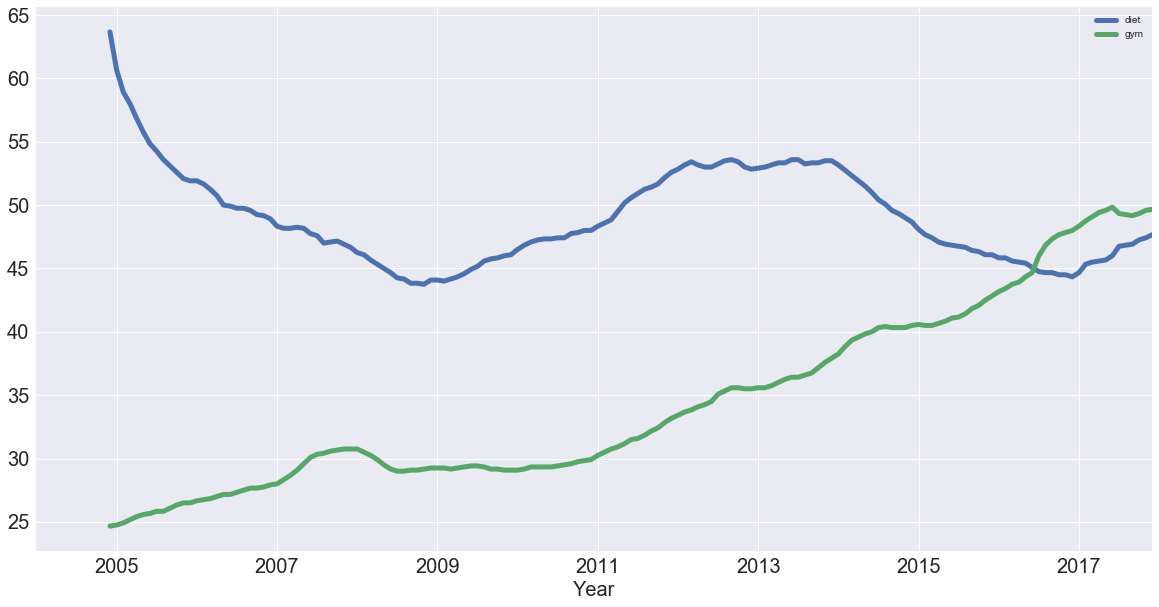
Je hebt een nieuw DataFrame df_rm gemaakt met twee kolommen met het rollend gemiddelde van 'diet' en 'gym'. Je gebruikte de functie pd.concat(), die een lijst met kolommen als eerste argument neemt en, omdat je ze als kolommen wilt samenvoegen, heb je ook het argument axis toegevoegd en ingesteld op 1.
Vervolgens heb je het DataFrame geplot met de methode plot(), net als eerder! Dus nu, na het verwijderen van de seizoensinvloeden, zie je dat diet mogelijk nog enige seizoenspatronen heeft, terwijl gym daadwerkelijk toeneemt!
Met de trends in de data geïdentificeerd, is het tijd om na te denken over seizoensinvloeden, de repetitieve aard van je tijdreeks. Zoals je aan het begin van deze tutorial zag, leken er trend- en seizoenscomponenten te zijn in de tijdreeksen van de data.
Een manier om over de seizoenscomponenten van je tijdreeks na te denken, is door de trend uit een tijdreeks te verwijderen, zodat je seizoensinvloeden gemakkelijker kunt onderzoeken. Om de trend te verwijderen kun je de hierboven berekende trend (rollend gemiddelde) aftrekken van het oorspronkelijke signaal. Dit hangt echter af van over hoeveel datapunten je het gemiddelde hebt genomen.
Een andere manier om de trend te verwijderen heet "differencing", waarbij je kijkt naar het verschil tussen opeenvolgende datapunten ("eerstegraads differencing", omdat je alleen kijkt naar het verschil tussen één datapunt en het voorgaande).
Je kunt pandas en de methoden diff() en plot() gebruiken om het eerstegraads verschil van de Series 'diet' te berekenen en te plotten:
diet.diff().plot(figsize=(20,10), linewidth=5, fontsize=20)
plt.xlabel('Year', fontsize=20);
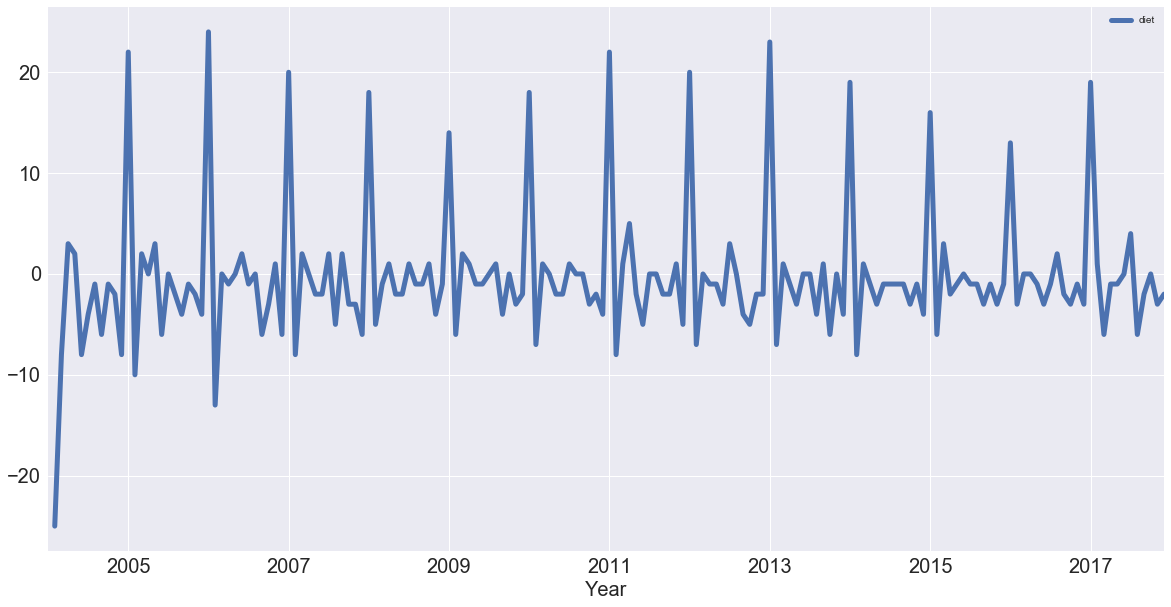
Je ziet dat je veel van de trend hebt verwijderd en je de pieken in januari elk jaar goed kunt zien. Elke januari is er een enorme piek van 20 procent of meer op het hoogste zoekitem dat je hebt gezien!
Let op: je kunt ook tweedegraads differencing uitvoeren, wat betekent dat je kijkt naar het verschil tussen één datapunt en de twee die eraan voorafgaan, als de trend nog niet volledig is verwijderd. Zie hier voor meer over differencing.
Differencing is superhandig om je tijdreeks stationair te maken. We gaan hier niet te diep op in, maar een stationaire tijdreeks is er een waarvan de statistische eigenschappen (zoals gemiddelde en variantie) in de tijd niet veranderen. Deze tijdreeksen zijn nuttig omdat veel voorspellingsmethoden voor tijdreeksen gebaseerd zijn op de aanname dat de tijdreeks ongeveer stationair is.
Met dit alles bij de hand ga je nu je periodiciteit in je tijdreeks analyseren door naar de autocorrelatiefunctie te kijken. Maar daarvoor maak je een korte zijsprong naar correlatie.
Een tijdreeks is periodiek als deze zich op gelijke intervallen herhaalt, bijvoorbeeld elke 12 maanden.
Een andere manier om hierover te denken is dat als de tijdreeks ergens een piek heeft, er 12 maanden later weer een piek zal zijn en als er ergens een dal is, er 12 maanden later ook een dal zal zijn.
Nog een manier om hierover te denken is dat de tijdreeks gecorreleerd is met zichzelf, verschoven met 12 maanden. Dat betekent dat, als je de tijdreeks 12 maanden naar achteren of naar voren zou schuiven, deze in zekere zin op zichzelf zou passen.
Het beschouwen van de correlatie van een tijdreeks met zo’n verschoven versie van zichzelf wordt vastgelegd door het concept autocorrelatie.
Daar kom je zo op terug.
Eerst frissen we je geheugen over correlatie op en nemen we een intuïtieve benadering van dit concept!
De correlatiecoëfficiënt van twee variabelen geeft aan hoe lineair ze met elkaar samenhangen. Om dit te begrijpen, bekijk je een praktisch voorbeeld met behulp van de dataset iris, die metingen van bloemen bevat.
Om dit verder te bestuderen importeer je de dataset iris uit scikit-learn, zet je die om in een DataFrame en bekijk je de eerste rijen met .head():
from sklearn import datasets
iris = datasets.load_iris()
df_iris = pd.DataFrame(data= np.c_[iris['data'], iris['target']],
                     columns= iris['feature_names'] + ['target'])
df_iris.head()
| sepal length (cm) | sepal width (cm) | petal length (cm) | petal width (cm) | target | |
|---|---|---|---|---|---|
| 0 | 5.1 | 3.5 | 1.4 | 0.2 | 0.0 |
| 1 | 4.9 | 3.0 | 1.4 | 0.2 | 0.0 |
| 2 | 4.7 | 3.2 | 1.3 | 0.2 | 0.0 |
| 3 | 4.6 | 3.1 | 1.5 | 0.2 | 0.0 |
| 4 | 5.0 | 3.6 | 1.4 | 0.2 | 0.0 |
Ter herinnering om deze dataset te begrijpen: alle bloemen hebben een kelkblad (sepal) en een kroonblad (petal). Het kelkblad omsluit de kroonbladen en is doorgaans groen en bladachtig, terwijl de kroonbladen meestal gekleurd zijn. De kolom 'target', de doelvariabele, is de soort van de irisbloemen: Versicolor, Virginica of Setosa. In de tabel hierboven zijn ze gecodeerd als 0, 1 en 2.
Om over correlatie na te denken, bekijk je nu hoe de kelkbladlengte van de irisbloemen correleert met de kelkbladbreedte. Hiervoor gebruik je pandas of seaborn om een scatterplot te maken van 'sepal length' tegen 'sepal width':
sns.lmplot(x='sepal length (cm)', y='sepal width (cm)', fit_reg=False, data=df_iris);
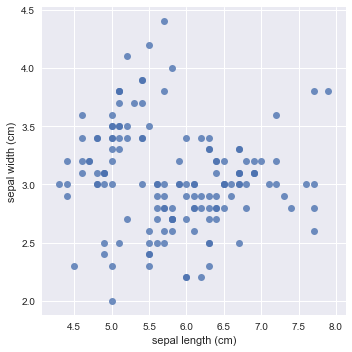
Let op dat je de lineaire regressie hebt uitgeschakeld door het argument fit_reg op False te zetten.
Zijn kelkbladlengte en -breedte positief of negatief gecorreleerd over alle bloemen? Zijn ze positief of negatief gecorreleerd binnen elke soort? Dit onderscheid is essentieel.
Onthoud dat het eerste betekent dat wanneer de kelkbladlengte toeneemt, de kelkbladbreedte ook lineair toeneemt. Het tweede betekent dat als de kelkbladlengte toeneemt, de kelkbladbreedte lineair zou afnemen.
Op het eerste gezicht lijkt er in bovenstaande plot een negatieve correlatie te zijn: naarmate de kelkbladlengte toeneemt, zie je dat de kelkbladbreedte licht afneemt.
Laten we nu een scatterplot maken van 'sepal length' tegen 'sepal width', ingekleurd naar de target (species):
sns.lmplot(x='sepal length (cm)', y='sepal width (cm)', fit_reg=False, data=df_iris, hue='target');
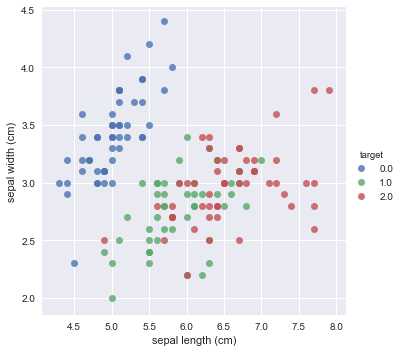
Op het eerste gezicht lijkt de bovenstaande plot een positieve correlatie te vertonen: voor elke soort irisbloem zie je dat wanneer de kelkbladlengte toeneemt, de kelkbladbreedte ook toeneemt.
Visualisaties zijn een geweldige manier om gevoel te krijgen voor correlatie, maar je kunt hier dieper op ingaan door daadwerkelijk een correlatiecoëfficiënt te berekenen.
Je kunt de correlatiecoëfficiënten van elk paar metingen berekenen met behulp van de methode .corr():
df_iris.corr()
| sepal length (cm) | sepal width (cm) | petal length (cm) | petal width (cm) | target | |
|---|---|---|---|---|---|
| sepal length (cm) | 1.000000 | -0.109369 | 0.871754 | 0.817954 | 0.782561 |
| sepal width (cm) | -0.109369 | 1.000000 | -0.420516 | -0.356544 | -0.419446 |
| petal length (cm) | 0.871754 | -0.420516 | 1.000000 | 0.962757 | 0.949043 |
| petal width (cm) | 0.817954 | -0.356544 | 0.962757 | 1.000000 | 0.956464 |
| target | 0.782561 | -0.419446 | 0.949043 | 0.956464 | 1.000000 |
Let op dat 'sepal length (cm)' en 'sepal width (cm)' negatief gecorreleerd lijken te zijn! En dat zijn ze ook, over de volledige populatie gemeten bloemen. Je ziet dat de correlatiecoëfficiënt -0,1 is. Binnen elke soort zijn ze echter niet negatief gecorreleerd, want de coëfficiënt is 0,78.
Voor de geïnteresseerden: dit staat bekend als de paradox van Simpson en is essentieel bij het nadenken over causale inferentie. Je kunt er hier meer over lezen.
Laten we dit verder verkennen. Laten we de correlatiecoëfficiënten van elk paar metingen binnen elke soort berekenen. Dit doe je door de methoden .groupby() en .corr() te koppelen, te groeperen op de target en de correlatiecoëfficiënt uit te schrijven:
df_iris.groupby(['target']).corr()
| petal length (cm) | petal width (cm) | sepal length (cm) | sepal width (cm) | ||
|---|---|---|---|---|---|
| target | |||||
| 0.0 | petal length (cm) | 1.000000 | 0.306308 | 0.263874 | 0.176695 |
| petal width (cm) | 0.306308 | 1.000000 | 0.279092 | 0.279973 | |
| sepal length (cm) | 0.263874 | 0.279092 | 1.000000 | 0.746780 | |
| sepal width (cm) | 0.176695 | 0.279973 | 0.746780 | 1.000000 | |
| 1.0 | petal length (cm) | 1.000000 | 0.786668 | 0.754049 | 0.560522 |
| petal width (cm) | 0.786668 | 1.000000 | 0.546461 | 0.663999 | |
| sepal length (cm) | 0.754049 | 0.546461 | 1.000000 | 0.525911 | |
| sepal width (cm) | 0.560522 | 0.663999 | 0.525911 | 1.000000 | |
| 2.0 | petal length (cm) | 1.000000 | 0.322108 | 0.864225 | 0.401045 |
| petal width (cm) | 0.322108 | 1.000000 | 0.281108 | 0.537728 | |
| sepal length (cm) | 0.864225 | 0.281108 | 1.000000 | 0.457228 | |
| sepal width (cm) | 0.401045 | 0.537728 | 0.457228 | 1.000000 |
In deze correlatiematrix zie je dat:
Dit zijn allemaal afnemende hoeveelheden positieve correlatie, maar ze zijn allemaal veel positiever gecorreleerd dan je oorspronkelijke negatieve correlatie was.
Dit zegt ontzettend veel en is een duidelijke herinnering aan het belang van grondige data-analyse.
Nu je nader naar correlatie hebt gekeken, ben je klaar om je periodiciteit in je tijdreeks te analyseren door naar de autocorrelatiefunctie te kijken!
Begin met het opnieuw plotten van al je tijdreeksen om jezelf eraan te herinneren hoe ze eruitzien:
df.plot(figsize=(20,10), linewidth=5, fontsize=20)
plt.xlabel('Year', fontsize=20);
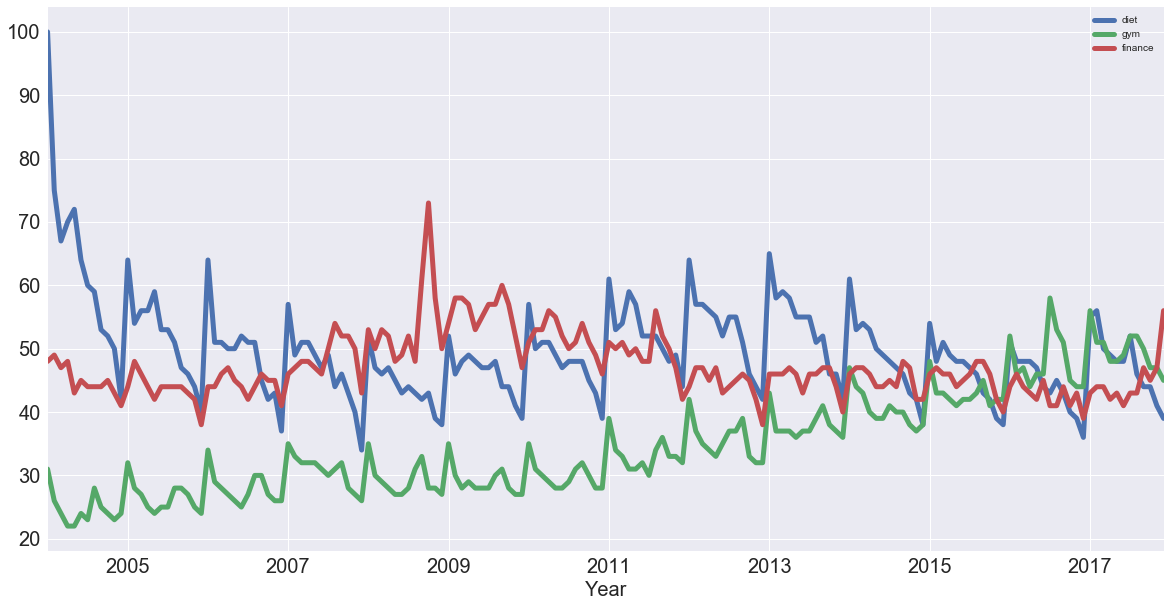
Bereken vervolgens de correlatiecoëfficiënten van al deze tijdreeksen met behulp van .corr():
df.corr()
| diet | gym | finance | |
|---|---|---|---|
| diet | 1.000000 | -0.100764 | -0.034639 |
| gym | -0.100764 | 1.000000 | -0.284279 |
| finance | -0.034639 | -0.284279 | 1.000000 |
Wat vertelt het bovenstaande je nu?
Laten we focussen op 'diet' en 'gym'; Ze zijn negatief gecorreleerd. Dat is erg interessant! Onthoud dat je een seizoens- en een trendcomponent hebt. Uit de correlatiecoëfficiënt blijkt dat 'diet' en 'gym' negatief gecorreleerd zijn. Maar als je naar de tijdreeksen kijkt, lijkt het alsof hun seizoenscomponenten positief gecorreleerd zijn en hun trends negatief.
De daadwerkelijke correlatiecoëfficiënt vangt beide effecten samen.
Wat je nu wilt doen is de eerstegraads verschillen van deze tijdreeksen plotten en vervolgens de correlatie daarvan berekenen, omdat dat ongeveer de correlatie van de seizoenscomponenten zal zijn. Onthoud dat het verwijderen van de trend correlatie in seizoensinvloeden kan blootleggen.
Begin met het plotten van de eerstegraads verschillen met behulp van .diff() en .plot():
df.diff().plot(figsize=(20,10), linewidth=5, fontsize=20)
plt.xlabel('Year', fontsize=20);
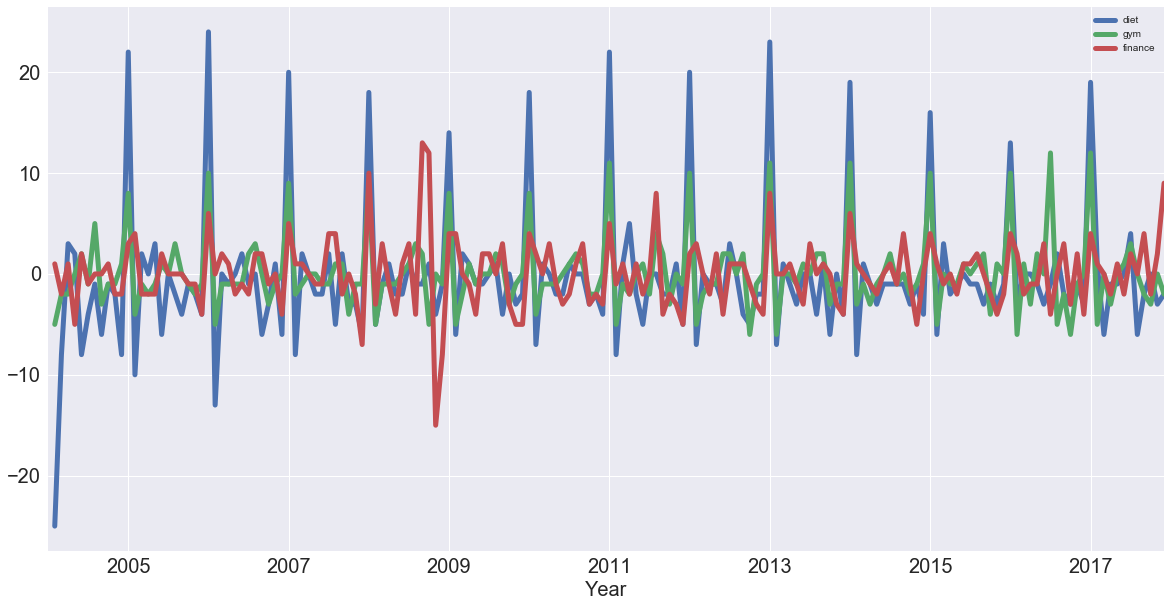
Je ziet dat 'diet' en 'gym' enorm gecorreleerd zijn zodra je de trend verwijdert. Nu bereken je de correlatiecoëfficiënten van de eerstegraads verschillen van deze tijdreeksen:
df.diff().corr()
| diet | gym | finance | |
|---|---|---|---|
| diet | 1.000000 | 0.758707 | 0.373828 |
| gym | 0.758707 | 1.000000 | 0.301111 |
| finance | 0.373828 | 0.301111 | 1.000000 |
Let op dat er eerder een lichte negatieve correlatie was wanneer je dacht aan de trend en de seizoenscomponent. Nu zie je dat bij de seizoenscomponent 'diet' en 'gym' sterk positief gecorreleerd zijn, met een coëfficiënt van 0,76.
Nu je in bent gedoken op de correlatie van variabelen en tijdreeksen, is het tijd om de autocorrelatie van de reeks 'diet' te plotten: op de x-as heb je de lag en op de y-as hoe sterk de tijdreeks met zichzelf gecorreleerd is bij die lag.
Dit betekent dus dat als de oorspronkelijke tijdreeks zich elke twee dagen herhaalt, je een piek in de autocorrelatiefunctie op 2 dagen zou verwachten.
Hier kijk je naar de plot en je zou een piek in de autocorrelatiefunctie op 12 maanden moeten verwachten: de tijdreeks is gecorreleerd met zichzelf, verschoven met twaalf maanden.
Gebruik de interface plotting van pandas, die de functie autocorrelation_plot() heeft. Je kunt deze functie gebruiken om de tijdreeks 'diet' te plotten:
pd.plotting.autocorrelation_plot(diet);
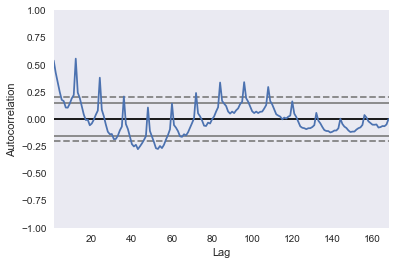
Als je meer lags op je assen zou opnemen, zou je zien dat er op 12 maanden een enorme piek in de correlatie is. Je hebt nog een piek op een interval van 24 maanden, waar de reeks ook met zichzelf correleert. Nog een piek bij 36, maar naarmate je verder weggaat, is er steeds minder correlatie.
Natuurlijk is er bij een lag van 0 een correlatie van de reeks met zichzelf.
De stippellijnen in de bovenstaande plot vertellen je iets over de statistische significantie van de correlatie. In dit geval kun je zeggen dat de reeks 'diet' daadwerkelijk autocorreleert met een lag van twaalf maanden.
Je hebt de seizoensinvloed van deze herhaling van 12 maanden geïdentificeerd!
In deze tutorial heb je veel behandeld! Je bekeek Google Trends-gegevens van de zoekwoorden 'diet', 'gym' en bekeek vluchtig 'finance' om te zien hoe ze variëren in de tijd. Je behandelde concepten zoals seizoensinvloeden, trends, correlatie, autocorrelatie, ...
Voor de fanatieke data scientists zijn er twee dingen die je meteen kunt doen:
Leer meer over Python
Cursus
Cursus
Oefen en volg je voortgang.
Ga Verder Met Googleblog
Adel Nehme
15 min

