course
Wprowadzenie do inżynierii danych
4 godz.
129.7K
Obraz autora.
Apache Airflow to popularne, otwartoźródłowe narzędzie do orkiestracji danych, zaprojektowane do budowania, harmonogramowania i monitorowania potoków danych. Zawiera pulpit do zarządzania stanem przepływów pracy, co czyni je doskonałym narzędziem dla większości potrzeb związanych z workflow.
Jednak Airflow nie ma kilku ważnych funkcji, które mogą być kluczowe przy złożonych, nowoczesnych wymaganiach orkiestracji danych.
W tym poradniku poznamy pięć alternatyw dla Airflow, które oferują rozszerzone możliwości i adresują niektóre z jego ograniczeń. Ponadto zbudujemy prosty potok ETL w każdym narzędziu, uruchomimy go i zwizualizujemy na ich pulpitach.
Airflow to potężne narzędzie dla różnych przepływów danych, ale ma kilka ograniczeń, przez które firmy mogą rozważać alternatywy.
Oto powody, dla których możesz wybrać inne rozwiązanie:
Zanim przejdziemy do części kodowej innych narzędzi do orkiestracji danych, warto nauczyć się, jak pisać potok danych w Apache Airflow, korzystając z poradnika Getting Started with Apache Airflow, aby móc uczciwie porównać alternatywy.
Jeśli dopiero zaczynasz przygodę z Airflow, rozważ krótki kurs Introduction to Airflow in Python, aby poznać podstawy budowania i harmonogramowania potoków danych.
Przejdźmy teraz do opisu 5 najlepszych alternatyw dla Airflow i pokażmy, jak z nich korzystać na praktycznych przykładach kodu.
Prefect to otwartoźródłowe narzędzie do orkiestracji workflow w Pythonie, stworzone dla nowoczesnych inżynierów danych i ML. Oferuje prosty interfejs API, który pozwala szybko zbudować potok danych i zarządzać nim przez interaktywny pulpit.
Prefect oferuje hybrydowy model wykonania, co oznacza, że możesz wdrożyć workflow w chmurze i tam go uruchamiać lub korzystać z lokalnego repozytorium.
W porównaniu z Airflow, Prefect ma zaawansowane funkcje, takie jak automatyczne zależności zadań, wyzwalacze zdarzeń, wbudowane powiadomienia, infrastruktura specyficzna dla workflow oraz współdzielenie danych między zadaniami. Dzięki temu świetnie sprawdza się przy efektywnym zarządzaniu złożonymi przepływami pracy.
Prefect jest prosty i ma potężne funkcje. Uruchomienie przykładowego kodu zajęło mi dosłownie 5 minut. Szczególnie podoba mi się projekt interfejsu pulpitu, możliwość ustawienia powiadomień, ponownego uruchamiania potoków oraz zarządzania i monitorowania wszystkiego przez Dashboard.
Abid Ali Awan, Author
Przeczytaj wpis Airflow vs Prefect: Deciding Which is Right For Your Data Workflow, aby poznać szczegółowe porównanie tych dwóch narzędzi do orkiestracji danych.
Zaczniemy projekt Prefect od instalacji pakietu Pythona. Uruchom poniższe polecenie w terminalu.
$ pip install -U prefectNastępnie utworzymy skrypt Pythona o nazwie prefect_etl.py i wpiszemy do niego poniższy kod.
from prefect import task, flow
import pandas as pd

# Extract data
@task
def extract_data():
    # Simulating data extraction
    data = {
        "name": ["Alice", "Bob", "Charlie"],
        "age": [25, 30, 35],
        "city": ["New York", "Los Angeles", "Chicago"]
    }
    df = pd.DataFrame(data)
    return df

# Transform data
@task
def transform_data(df: pd.DataFrame):
    # Example transformation: adding a new column
    df["age_plus_ten"] = df["age"] + 10
    return df

# Load data
@task
def load_data(df: pd.DataFrame):
    # Simulating data load
    print("Loading data to target destination:")
    print(df)

# Defining the flow
@flow(log_prints=True)
def etl():
    raw_data = extract_data()
    transformed_data = transform_data(raw_data)
    load_data(transformed_data)

# Running the flow
if __name__ == "__main__":
    etl()
Powyższy kod definiuje funkcje zadań extract_data(), transform_data(), i load_data() oraz wykonuje je sekwencyjnie wewnątrz funkcji flow o nazwie etl(). Funkcje te tworzymy, korzystając z dekoratorów Prefect dla Pythona.
W skrócie: tworzymy obiekt pandas DataFrame, przekształcamy go, a następnie wyświetlamy wynik za pomocą print. To prosty sposób na zasymulowanie potoku ETL.
Aby wykonać workflow, po prostu uruchom skrypt Pythona poniższym poleceniem.
$ python prefect_etl.py Jak widać, nasz przebieg workflow zakończył się powodzeniem.
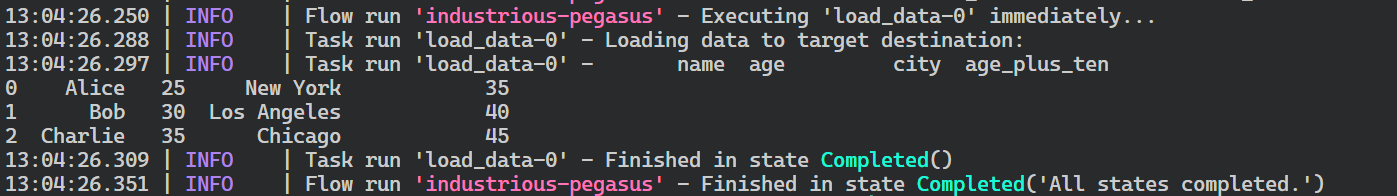
Logi przebiegu flow w Prefect.
Teraz wdrożymy nasz workflow, aby móc uruchamiać go zgodnie z harmonogramem lub wyzwalać zdarzeniami. Wdrożenie flow pozwala też centralnie monitorować i zarządzać wieloma workflow.
Do wdrożenia flow użyjemy Prefect CLI. Funkcja deploy wymaga nazwy pliku Pythona, nazwy funkcji flow w pliku oraz nazwy wdrożenia. W tym przypadku nazywamy to wdrożenie „simple_etl”.
$ prefect deploy prefect_etl.py:etl -n 'simple_etl'Po uruchomieniu powyższego polecenia w terminalu możesz otrzymać komunikat, że nie masz puli workerów do uruchomienia wdrożenia. Aby utworzyć pulę workerów, użyj poniższego polecenia.
$ prefect worker start --pool 'datacamp'Skoro mamy już pulę workerów, uruchomimy kolejne okno terminala i wykonamy wdrożenie. Polecenie prefect deployment run wymaga argumentu w formacie „<nazwa-funkcji-flow>/<nazwa-wdrożenia>”, jak w poleceniu poniżej.
$ prefect deployment run 'etl/simple_etlW wyniku uruchomienia wdrożenia otrzymasz komunikat, że workflow działa. Zwykle utworzony przebieg flow dostaje losową nazwę, w moim przypadku witty-lorikeet.
Creating flow run for deployment 'etl/simple_etl'...
Created flow run 'witty-lorikeet'.
└── UUID: 4e0495b0-9c7e-4ed8-b9ab-5160994dc7f0
└── Parameters: {}
└── Job Variables: {}
└── Scheduled start time: 2024-06-22 14:05:01 PKT (now)
└── URL: <no dashboard available>
Aby zobaczyć pełne logi, przełącz się do okna terminala, w którym uruchomiłeś pulę workerów.
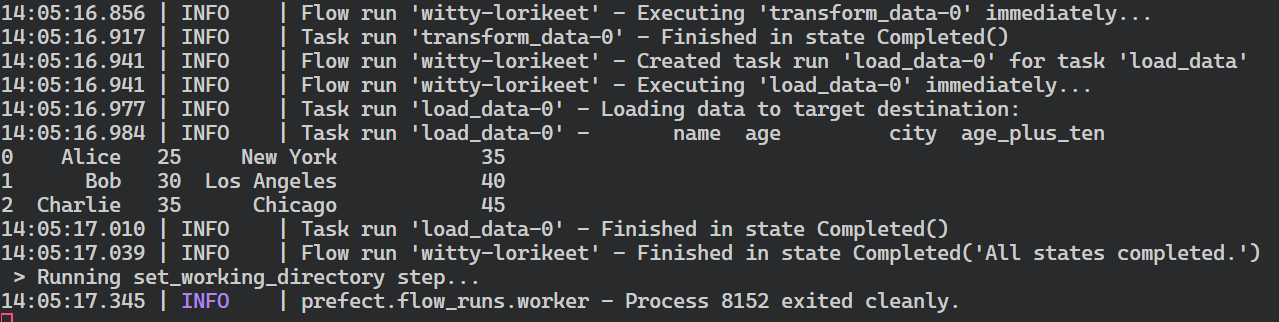
Podsumowanie przebiegu flow w Prefect.
Musisz uruchomić serwer WWW Prefect, aby wygodniej wizualizować przebieg flow i zarządzać innymi workflow.
$ prefect server start Po wykonaniu powyższego polecenia powinieneś zostać przekierowany na pulpit Prefect. Alternatywnie możesz przejść bezpośrednio pod adres http://127.0.0.1:4200 w przeglądarce.
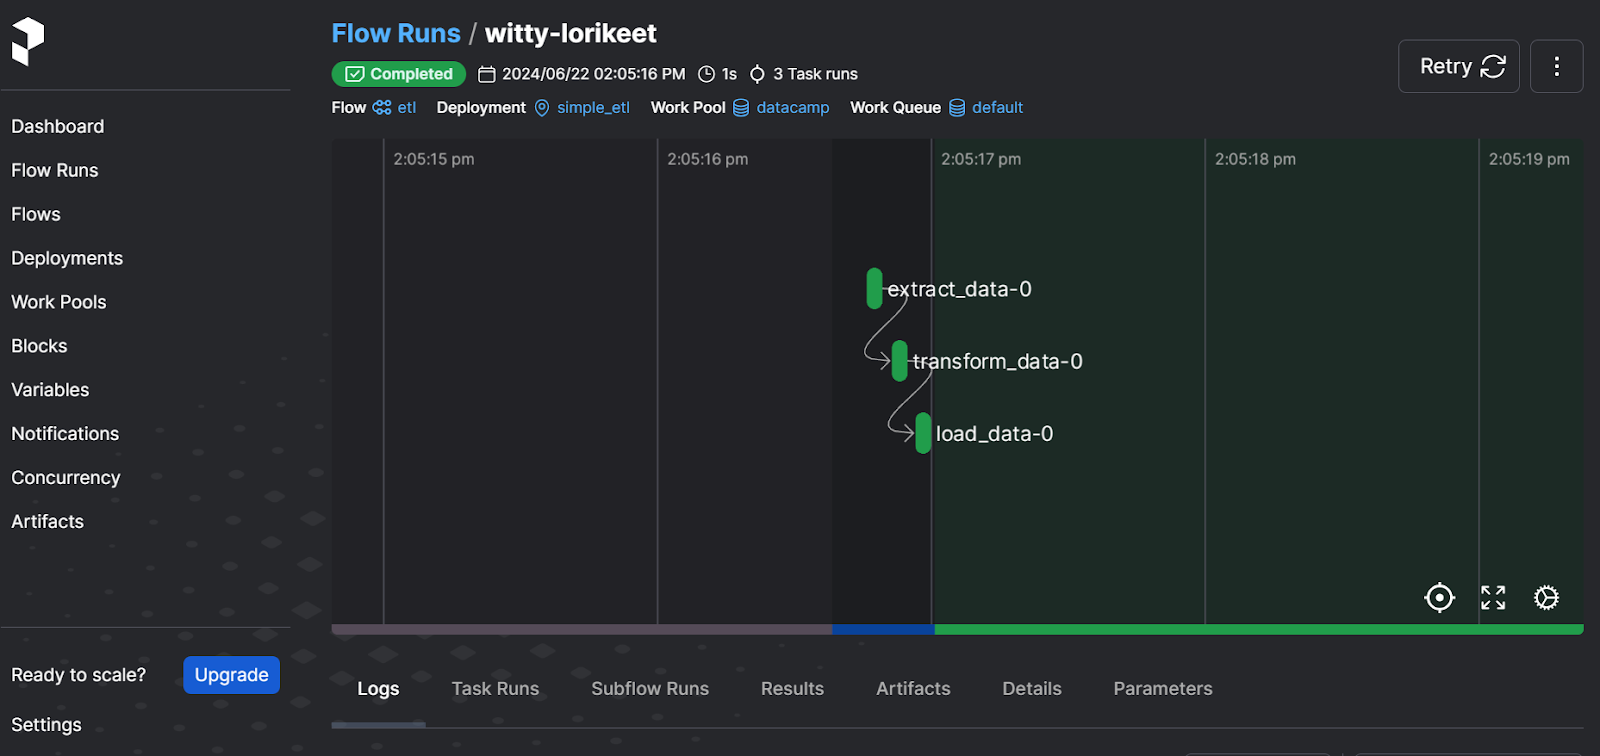
Interfejs serwera WWW Prefect
Pulpit pozwala ponownie uruchamiać workflow, przeglądać logi, sprawdzać pule robocze, ustawiać powiadomienia i wybierać inne zaawansowane opcje. To kompletne rozwiązanie dla nowoczesnych potrzeb orkiestracji danych.
Aby dowiedzieć się, jak budować i uruchamiać potoki uczenia maszynowego w Prefect, skorzystaj z poradnika Using Prefect for Machine Learning Workflows.
Dagster to otwartoźródłowy framework zaprojektowany dla inżynierów danych do definiowania, harmonogramowania i monitorowania potoków danych. Jest wysoce skalowalny i ułatwia współpracę między różnymi zespołami danych.
Dagster pozwala definiować zasoby danych jako funkcje Pythona za pomocą dekoratorów. Gdy zasoby zostaną zdefiniowane, można je bezproblemowo wykonywać poprzez harmonogram lub wyzwalacze zdarzeń.
W porównaniu z Airflow, Dagster umożliwia lokalne tworzenie, testowanie i przeglądanie potoku, oferuje podejście oparte na zasobach oraz jest natywny dla chmury i kontenerów.
Zamiast myśleć o workflow w kategoriach kroków i przepływów, musiałem zmienić podejście i zbudować potok w oparciu o zasoby danych. Poza tym stworzenie i uruchomienie prostego potoku ETL było dość proste. Serwer WWW jest raczej minimalistyczny, ale dostarcza wszystkich informacji do monitorowania zasobów, przebiegów i wdrożeń.
Abid Ali Awan, Author
Utworzymy prosty potok ETL, uruchomimy go i zwizualizujemy za pomocą serwera WWW Dagster. Podobnie jak pulpit Prefect, serwer WWW Dagster zapewnia scentralizowane sposoby monitorowania wielu workflow oraz harmonogramowania przebiegów i zasobów.
Zaczniemy od instalacji pakietu Pythona.
$ pip install dagster -qNastępnie utworzymy trzy funkcje Pythona do ekstrakcji, transformacji i ładowania danych. W kodzie noszą one nazwy create_dirty_data(), clean_data() oraz load_cleaned_data(). Za pomocą dekoratora @asset zadeklarujemy te funkcje jako zasoby danych w Dagster.
Następnie utworzymy zadanie dla zasobów (zmienna job) z wykorzystaniem wszystkich zasobów (zmienna all_assets), a następnie zdefiniujemy definicję zasobów (zmienna defs).
Możesz pominąć część z definicją zasobów, ale staje się ona ważna, jeśli chcesz harmonogramować przebiegi, uruchamiać wiele zadań i konfigurować sensory.
import pandas as pd
import numpy as np
from dagster import asset, Definitions, define_asset_job, materialize

@asset
def create_dirty_data():
    # Create a sample DataFrame with dirty data
    data = {
        'Name': [' John Doe ', 'Jane Smith', 'Bob Johnson ', '  Alice Brown'],
        'Age': [30, np.nan, 40, 35],
        'City': ['New York', 'los angeles', 'CHICAGO', 'Houston'],
        'Salary': ['50,000', '60000', '75,000', 'invalid']
    }
    df = pd.DataFrame(data)

    # Save the DataFrame to a CSV file
    dirty_file_path = 'dag_data/dirty_data.csv'
    df.to_csv(dirty_file_path, index=False)

    return dirty_file_path

@asset
def clean_data(create_dirty_data):
    # Read the dirty CSV file
    df = pd.read_csv(create_dirty_data)

    # Clean the data
    df['Name'] = df['Name'].str.strip()
    df['Age'] = pd.to_numeric(df['Age'], errors='coerce').fillna(df['Age'].mean())
    df['City'] = df['City'].str.upper()
    df['Salary'] = df['Salary'].replace('[\$,]', '', regex=True)
    df['Salary'] = pd.to_numeric(df['Salary'], errors='coerce').fillna(0)

    # Calculate average salary
    avg_salary = df['Salary'].mean()

    # Save the cleaned DataFrame to a new CSV file
    cleaned_file_path = 'dag_data/cleaned_data.csv'
    df.to_csv(cleaned_file_path, index=False)

    return {
        'cleaned_file_path': cleaned_file_path,
        'avg_salary': avg_salary
    }

@asset
def load_cleaned_data(clean_data):
    cleaned_file_path = clean_data['cleaned_file_path']
    avg_salary = clean_data['avg_salary']

    # Read the cleaned CSV file to verify
    df = pd.read_csv(cleaned_file_path)

    print({
        'num_rows': len(df),
        'num_columns': len(df.columns),
        'avg_salary': avg_salary
    })

# Define all assets
all_assets = [create_dirty_data, clean_data, load_cleaned_data]

# Create a job that will materialize all assets
job = define_asset_job("all_assets_job", selection=all_assets)

# Create Definitions object
defs = Definitions(
    assets=all_assets,
    jobs=[job]
)

if __name__ == "__main__":
    result = materialize(all_assets)
    print("Pipeline execution result:", result.success)
Powyższy kod możesz uruchomić w Jupyter Notebook lub utworzyć plik Pythona i go uruchomić.
W wyniku wykonania kodu otrzymamy pełny log przebiegu workflow.
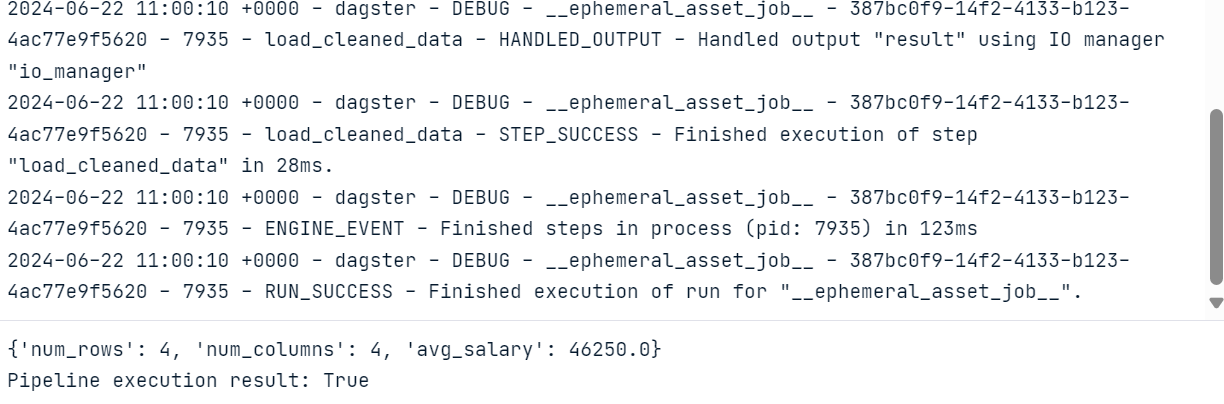
Aby wizualizować zasoby i przebiegi zadań, musimy zainstalować i uruchomić serwer WWW Dagster. Serwer pozwala uruchamiać zadania, materializować pojedyncze zasoby i monitorować wiele zadań jednocześnie.
$ pip install dagster-webserverAby zainicjować serwer Dagster, użyjemy CLI Dagster i podamy lokalizację pliku Pythona. W tym przypadku nazwałem plik dagster_pipe.py.
$ dagster dev -f dagster_pipe.py Powyższe polecenie automatycznie uruchomi serwer WWW w przeglądarce. Alternatywnie możesz przejść bezpośrednio pod adres http://127.0.0.1:3000 w przeglądarce.
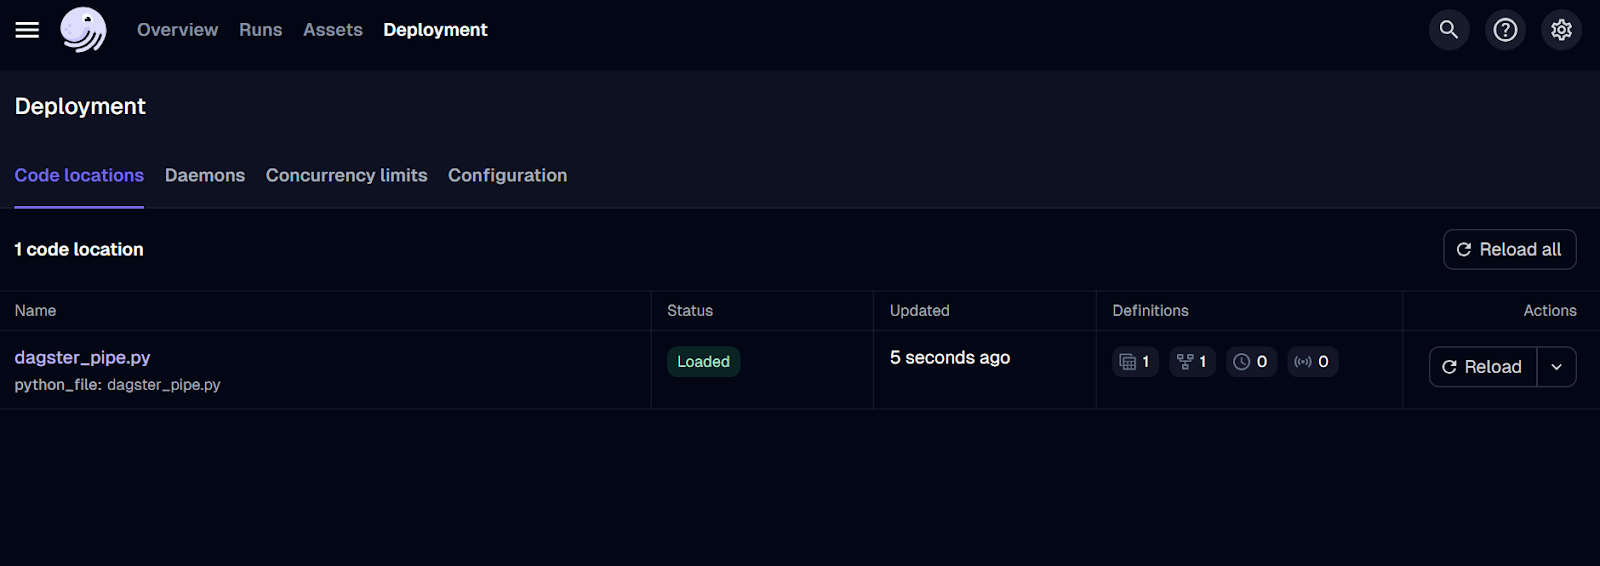
Interfejs serwera WWW Dagster.
Na razie wdrożyliśmy tylko zadanie. Aby uruchomić workflow, przejdź do zakładki „Runs” i kliknij przycisk „Launch a new run”.
Przebieg powinien zakończyć się powodzeniem! Aby zobaczyć logi, kliknij identyfikator interesującego cię przebiegu.
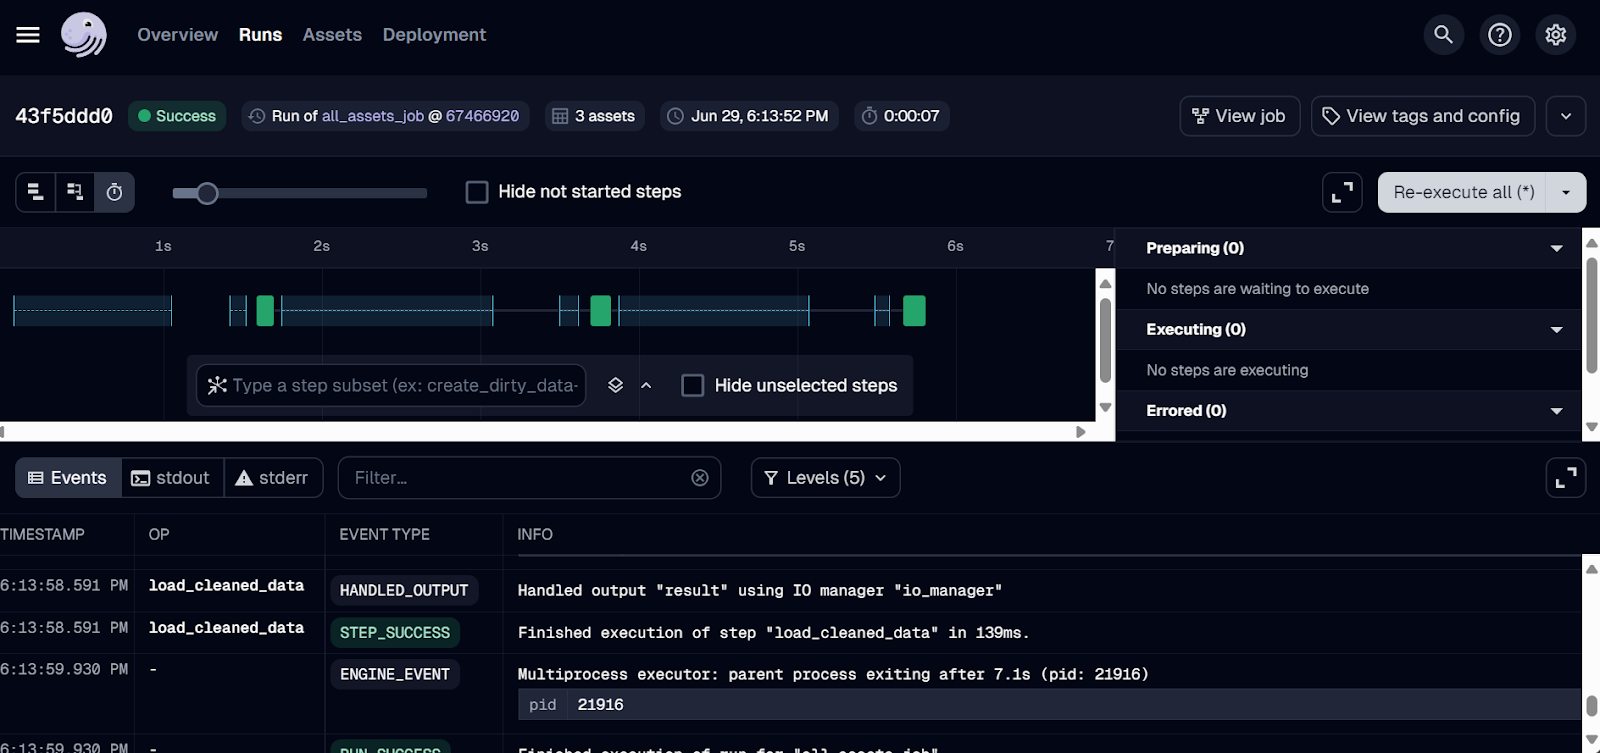
Logi przebiegu w Dagster.
Mage AI to otwartoźródłowy, hybrydowy framework do orkiestracji danych. Hybrydowy oznacza, że łączy elastyczność Jupyter Notebooka z kontrolą modularnego kodu.
Każdy, nawet z ograniczoną znajomością Pythona, może budować, uruchamiać i monitorować potoki danych. Zamiast pisać i uruchamiać plik Pythona bezpośrednio, utworzysz projekt Mage AI i uruchomisz go w panelu, gdzie zbudujesz, uruchomisz i będziesz zarządzać potokami danych.
W porównaniu z Airflow, Mage AI zapewnia przyjazny interfejs i łatwość użycia, co czyni go świetnym wyborem dla osób nowych w inżynierii danych. Zaprojektowano go z myślą o skalowalności, dzięki czemu sprawnie obsługuje duże wolumeny danych i złożone struktury potoków.
Czułem się dziwnie, bo to było zupełnie inne niż to, do czego jestem przyzwyczajony. Musiałem zainstalować i uruchomić interfejs webowy Mage AI. Miało być łatwo, ale trudno było mi zbudować i uruchomić potok ETL. Z drugiej strony widzę, dlaczego ten unikalny projekt może przyciągać osoby nowe w branży — to w zasadzie przeciągnij i upuść oraz klikanie przycisków.
Abid Ali Awan, Author
Uruchomienie Mage AI jest dość proste. Wystarczy zainstalować pakiet Mage AI dla Pythona.
$ pip install mage-aiI wystartować projekt Mage AI.
$ mage start mage_ai_etl Powyższe polecenie zainicjuje serwer WWW. Jak wspomniano, cały kod edytuje się, uruchamia zadania i monitoruje je przez interfejs Mage AI.
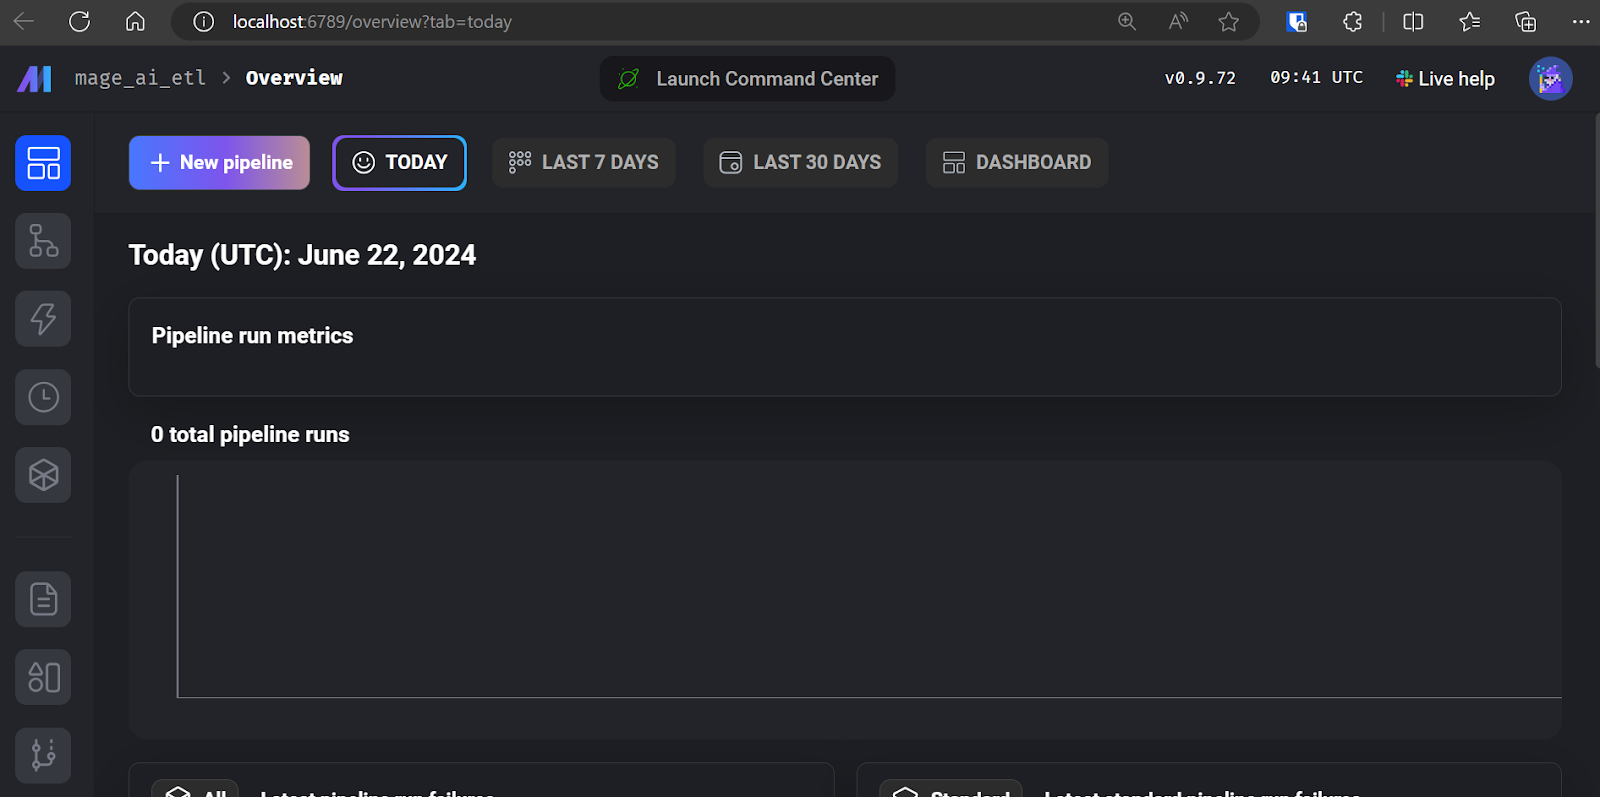
Interfejs Mage AI.
Kliknij „+ New pipeline”, aby utworzyć pierwszy potok ETL. Swój nazwałem „simple_etl”.
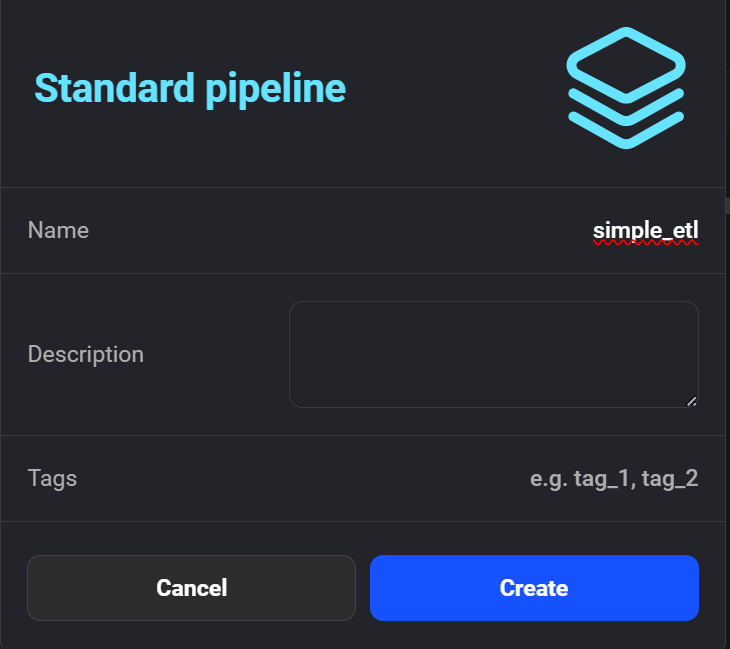
Tworzenie nowego potoku w Mage AI.
Następnie interfejs poprosi o dodanie modułu do rozpoczęcia kodowania. Wybierz moduł „Data Loader” i wpisz poniższy kod w Pythonie.
Tutaj deklarujemy funkcję create_sample_csv(), czyli pierwszy krok w naszym potoku. Używamy dekoratora Mage AI @data_loader. Definiujemy też funkcję test_output(), która sprawdza, czy wynik istnieje. Pomaga to w zarządzaniu zależnościami zadań.
import io
import pandas as pd

if 'data_loader' not in globals():
    from mage_ai.data_preparation.decorators import data_loader
if 'test' not in globals():
    from mage_ai.data_preparation.decorators import test

@data_loader
def create_sample_csv() -> pd.DataFrame:
    """
    Create a sample CSV file with duplicates and missing values
    """
    csv_data = """
category,product,quantity,price
Electronics,Laptop,5,1000
Electronics,Smartphone,10,500
Clothing,T-shirt,50,20
Clothing,Jeans,30,50
Books,Novel,100,15
Books,Textbook,20,80
Electronics,Laptop,5,1000
Clothing,T-shirt,,20
Electronics,Tablet,,300
Books,Magazine,25,
"""
    return pd.read_csv(io.StringIO(csv_data.strip()))

@test
def test_output(df) -> None:
    """
    Template code for testing the output of the block.
    """
    assert df is not None, 'The output is undefined'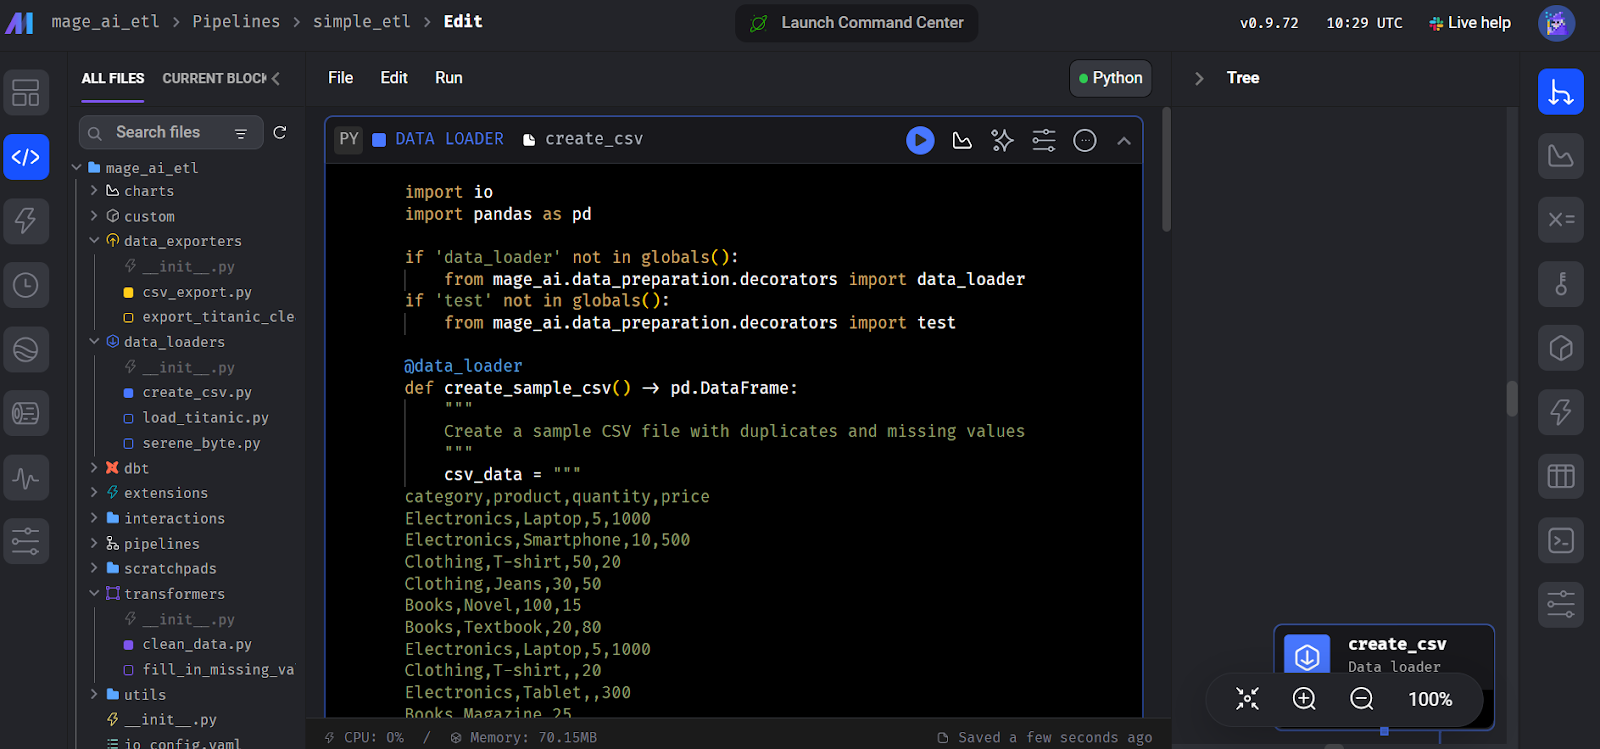
Tworzenie bloku data loader w Mage AI.
Podobnie, utwórz kolejny moduł „Transformer” i dodaj funkcję clean_data(), jak w kodzie poniżej.
Możesz zignorować funkcję test(); wystarczy dodać główną funkcję transformującą, clean_data().
import pandas as pd

if 'transformer' not in globals():
    from mage_ai.data_preparation.decorators import transformer
if 'test' not in globals():
    from mage_ai.data_preparation.decorators import test

@transformer
def clean_data(df: pd.DataFrame) -> pd.DataFrame:
    """
    Clean and transform the data
    """
    # Remove duplicates
    df = df.drop_duplicates()
    # Fill missing values with 0
    df = df.fillna(0)
    return df

@test
def test_output(df) -> None:
    """
    Template code for testing the output of the block.
    """
    assert df is not None, 'The output is undefined'
Analogicznie utwórz moduł „Data Exporter” i dodaj poniższy kod. Kod deklaruje funkcję ładującą dane, export_data_to_csv(), która zapisuje przekształcone dane do pliku CSV.
import pandas as pd

if 'data_exporter' not in globals():
    from mage_ai.data_preparation.decorators import data_exporter

@data_exporter
def export_data_to_csv(df: pd.DataFrame) -> None:
    """
    Export the processed data to a CSV file
    """
    df.to_csv('output_data.csv', index=False)
    print("Data exported successfully to output_data.csv")
Aby uruchomić potok, przejdź do zakładki „Trigger” i kliknij „Run@once”.
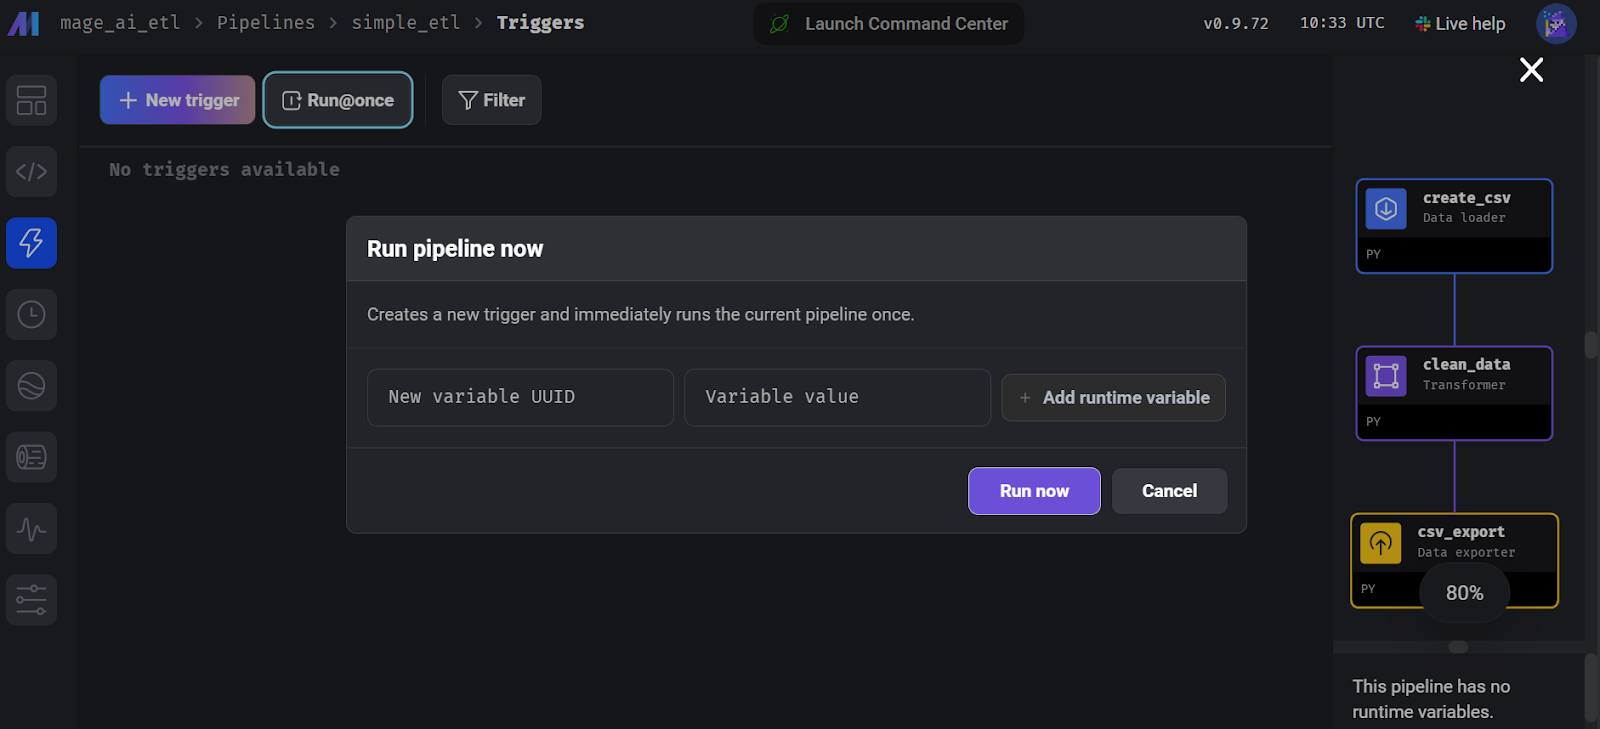
Uruchamianie potoku w Mage AI.
Aby zobaczyć logi przebiegu, przejdź do zakładki „Runs” i kliknij przycisk „Logs” przy ostatnio uruchomionym potoku.
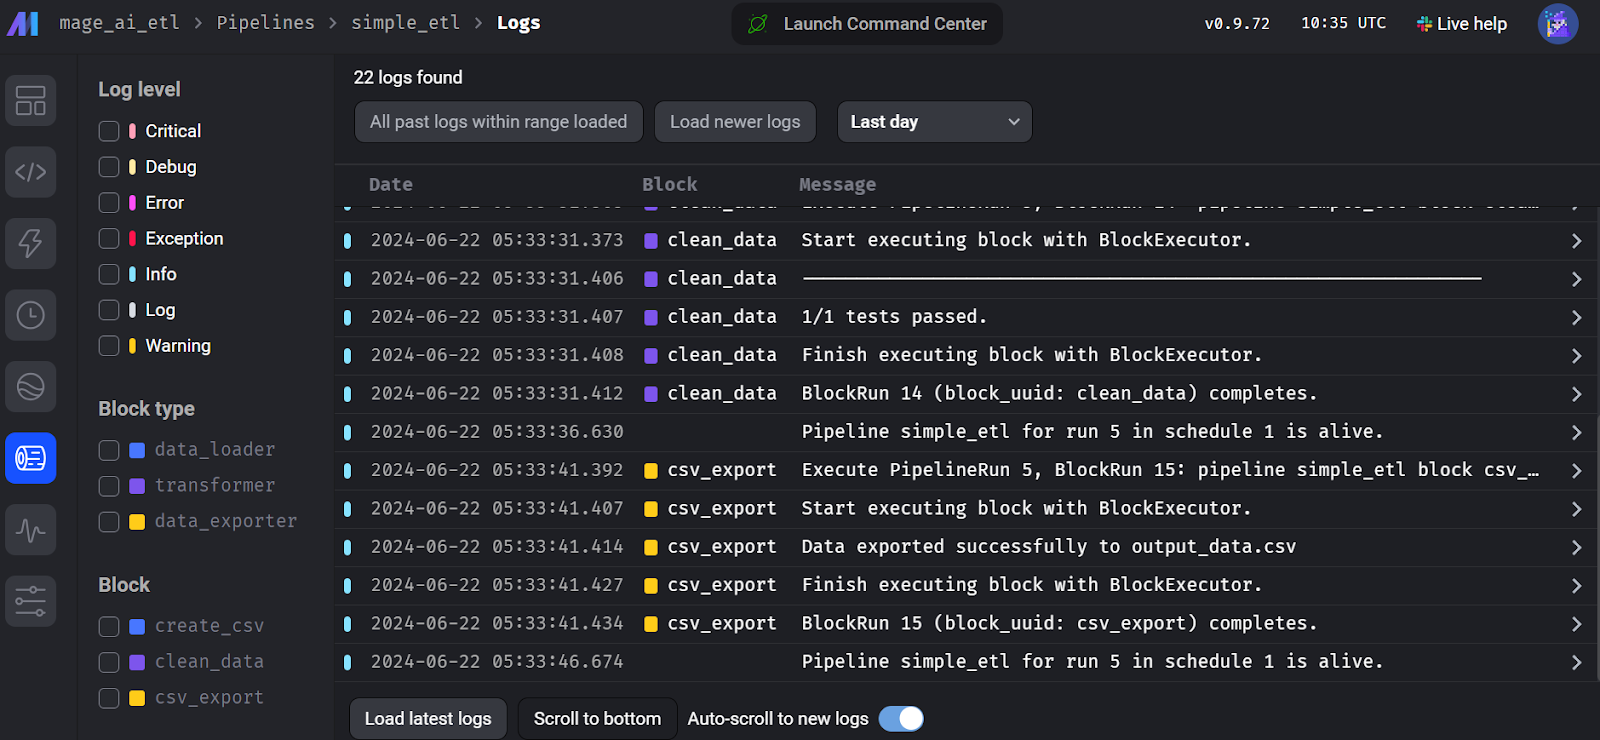
Logi przebiegu flow w Mage AI.
Kedro to kolejne popularne, otwartoźródłowe narzędzie do orkiestracji danych, nieco inne od pozostałych. Powstało z myślą o inżynierach uczenia maszynowego i zapożycza wiele koncepcji z inżynierii oprogramowania, stosując je w projektach ML.
Kedro jest wysoce modułowe, co oznacza, że nawet aby wyeksportować zbiór danych, musisz utworzyć katalog danych określający lokalizację i typ danych, zapewniając standaryzowane i wydajne zarządzanie danymi w całym potoku.
Aby zrozumieć, jak Kedro wpisuje się w ekosystem ML, możesz poznać różne narzędzia MLOps, czytając artykuł 25 Top MLOps Tools You Need to Know in 2024.
W porównaniu z Airflow, API Kedro jest prostsze do budowy potoku danych. Skupia się bardziej na inżynierii ML i oferuje kategoryzację oraz wersjonowanie danych.
Pisanie kodu jest dość proste, ale problemy zaczynają się przy uruchamianiu potoku. Musisz utworzyć katalog danych, zarejestrować potok i zrozumieć strukturę projektu Kedro. Powiedziałbym, że jest to trudniejsze niż w Dagster i Prefect. Rozumiem jednak, dlaczego zaprojektowano to w ten sposób: aby twój potok danych był niezawodny i wolny od błędów.
Abid Ali Awan, Author
Budowanie potoku danych w Kedro to inna bajka. Framework jest modułowy i musisz zrozumieć strukturę projektu oraz poszczególne kroki, aby pomyślnie wykonać workflow.
Zacznij od instalacji pakietu Kedro dla Pythona.
$ pip install kedroZainicjuj projekt Kedro.
$ kedro new --name=kedro_etl --tools=none --example=n Przejdź do katalogu projektu.
$ cd kedro-etl Utwórz folder w katalogu pipelines o nazwie data_processing.
$ mkdir -p src/kedro_etl/pipelines/data_processing Utwórz plik Pythona o nazwie kedro_pipe.py i otwórz go w ulubionym IDE, np. Visual Studio Code.
$ code src/kedro_etl/pipelines/data_processing/kedro_pipe.pySkrypt Pythona powinien zawierać funkcje extract, transform i load, które są węzłami w potoku. W tym przypadku są to funkcje create_sample_data()clean_data(), oraz load_and_process_data().
Następnie łączymy te węzły za pomocą klasy Kedro Pipeline wewnątrz funkcji create_pipeline(). W funkcji potoku definiujemy węzły, a każdy węzeł ma inputs, outputs i name.
import pandas as pd
import numpy as np
from kedro.pipeline import Pipeline, node

def create_sample_data():
    data = {
        'id': range(1, 101),
        'name': [f'Person_{i}' for i in range(1, 101)],
        'age': np.random.randint(18, 80, 100),
        'salary': np.random.randint(20000, 100000, 100),
        'missing_values': [np.nan if i % 10 == 0 else i for i in range(100)]
    }
    return pd.DataFrame(data)

def clean_data(df: pd.DataFrame):
    # Remove rows with missing values
    df_cleaned = df.dropna()

    # Convert salary to thousands
    df_cleaned['salary'] = df_cleaned['salary'] / 1000

    # Capitalize names
    df_cleaned['name'] = df_cleaned['name'].str.upper()

    return df_cleaned

def load_and_process_data(df: pd.DataFrame):
    # Calculate average salary
    avg_salary = df['salary'].mean()

    # Add a new column for salary category
    df['salary_category'] = df['salary'].apply(
        lambda x: 'High' if x > avg_salary else 'Low')

    # Calculate age groups
    df['age_group'] = pd.cut(df['age'], bins=[0, 30, 50, 100], labels=[
                             'Young', 'Middle', 'Senior'])

    print(df)
    return df

def create_pipeline(**kwargs):
    return Pipeline(
        [
            node(
                func=create_sample_data,
                inputs=None,
                outputs="raw_data",
                name="create_sample_data_node",
            ),
            node(
                func=clean_data,
                inputs="raw_data",
                outputs="cleaned_data",
                name="clean_data_node",
            ),
            node(
                func=load_and_process_data,
                inputs="cleaned_data",
                outputs="processed_data",
                name="load_and_process_data_node",
            ),
        ]
    )
Jeśli uruchomimy potok bez utworzenia katalogu danych, nie wyeksportuje on danych. Musimy więc przejść do pliku conf/base/catalog.yml i uzupełnić go konfiguracją zbiorów danych.
raw_data:
  type: pandas.CSVDataset
  filepath: ./data/kedro/sample_data.csv

cleaned_data:
  type: pandas.CSVDataset
  filepath: ./data/kedro/cleaned_data.csv

processed_data:
  type: pandas.CSVDataset
  filepath: ./data/kedro/processed_data.csv
Musimy także dodać nowo utworzony plik Pythona do rejestru potoków. W tym celu przejdź do pliku Pythona src/simple_etl/pipeline_registry.py i dodaj poniższy kod.
"""Project pipelines."""
from __future__ import annotations

from kedro.pipeline import Pipeline
from kedro_etl.pipelines.data_processing import kedro_pipe

def register_pipelines() -> Dict[str, Pipeline]:
    data_processing_pipeline = kedro_pipe.create_pipeline()

    return {
        "__default__": data_processing_pipeline,
        "data_processing": data_processing_pipeline,
    }
Uruchom potok i podglądaj logi na żywo w terminalu, uruchamiając poniższe polecenie.
$ kedro run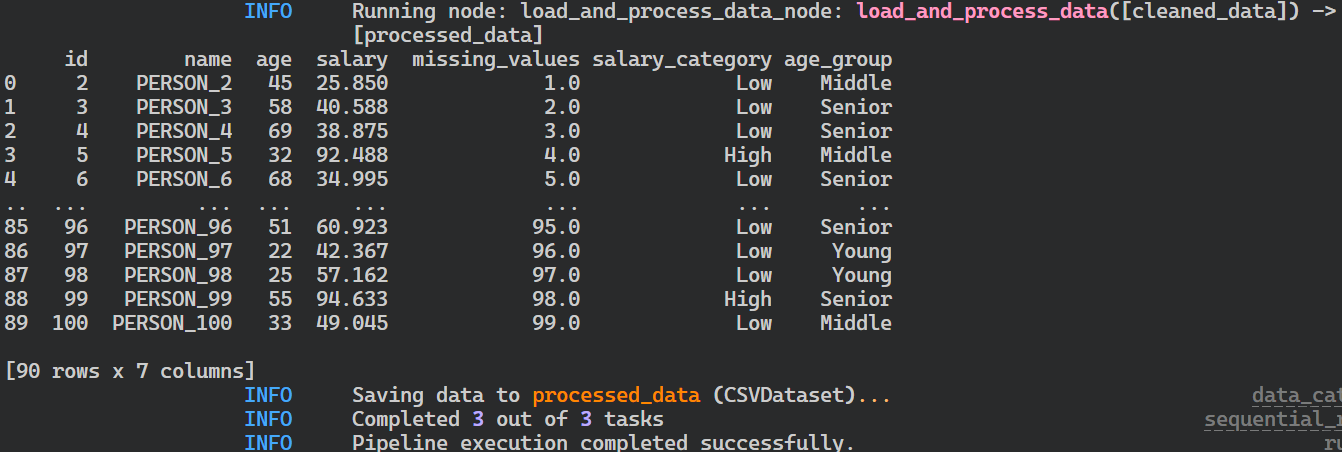
Logi uruchomienia potoku w Kedro.
Po uruchomieniu potoku twoje pliki zostaną zapisane w formacie CSV w lokalizacjach zdefiniowanych w katalogu danych.
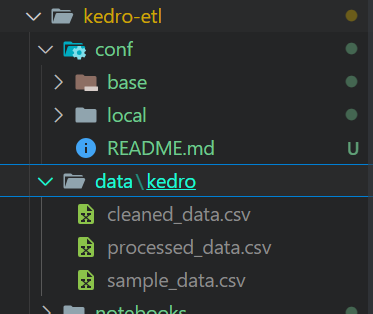
Pliki wyjściowe po uruchomieniu potoku w Kedro.
Jeśli napotkasz problemy z uruchomieniem potoku, rozważ instalację Kedro ze wszystkimi rozszerzeniami.
$ pip install "kedro[all]"Możemy wizualizować i udostępniać nasze potoki, instalując narzędzie kedro-viz.
$ pip install kedro-vizNastępnie wykonanie poniższego polecenia pozwoli zwizualizować wszystkie potoki i węzły danych. Dostępna jest też opcja śledzenia eksperymentów i udostępniania wizualizacji potoku.
$ kedro viz run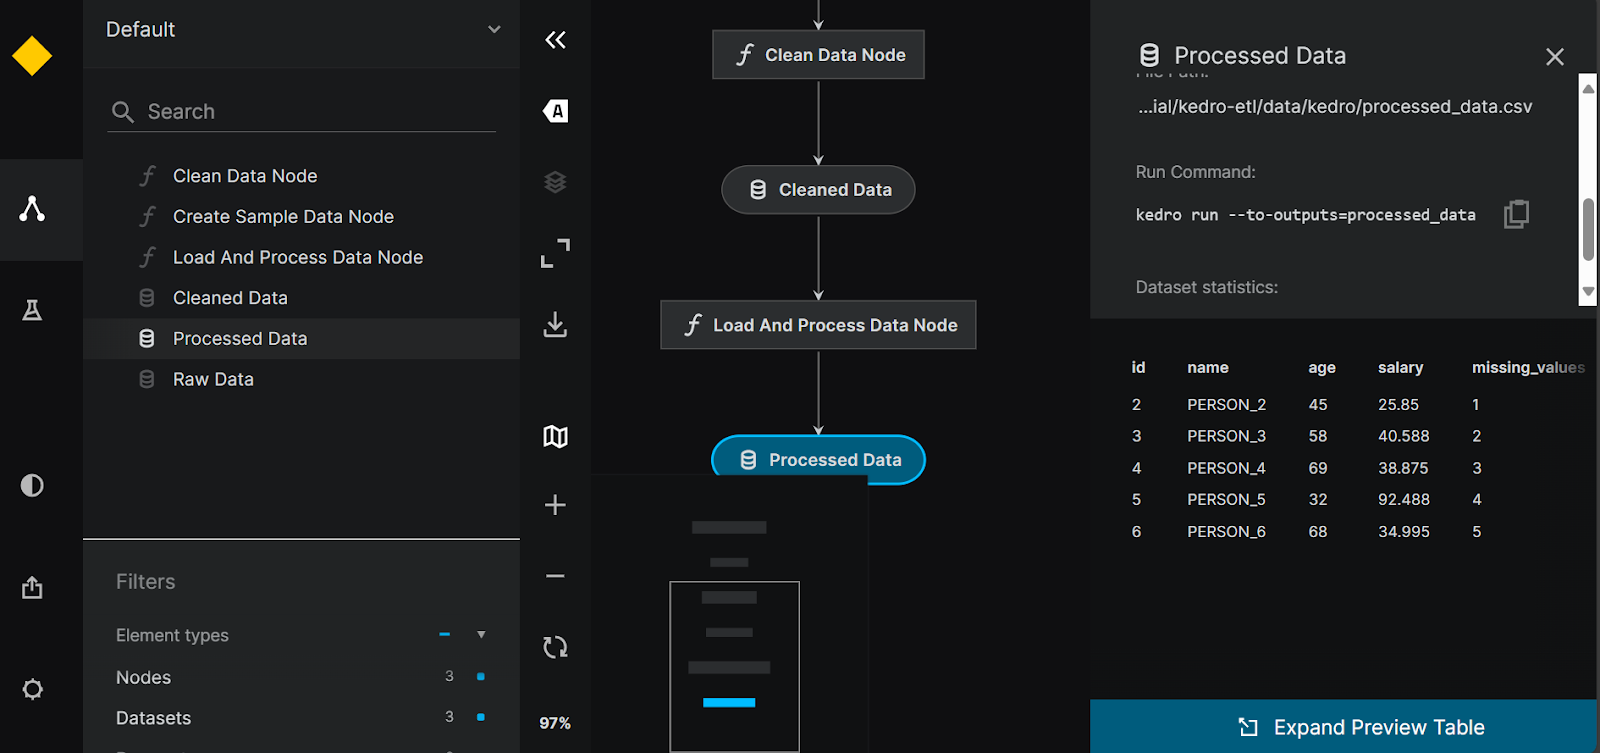
Wizualizacja potoku w Kedro.
Luigi to otwartoźródłowy framework oparty na Pythonie, opracowany przez Spotify, który świetnie radzi sobie z zarządzaniem długotrwałymi procesami wsadowymi i złożonymi potokami danych. Sprawdza się w rozwiązywaniu zależności, zarządzaniu workflow, wizualizacji i odzyskiwaniu po błędach, co czyni go potężnym narzędziem do orkiestracji przepływów danych.
W porównaniu z Airflow, Luigi ma minimalne API, harmonogram kalendarzowy oraz lojalną społeczność użytkowników, która pomoże ci w problemach związanych z potokiem orkiestracji danych.
Jeśli dopiero zaczynasz z Pythonem, możesz uznać budowanie i uruchamianie potoków za trudne. Jednak dokumentacja i przewodniki pomogą szybko wystartować. Logi dają ograniczone informacje, a pulpit to tylko narzędzie do wizualizacji DAG-ów i zależności.
Abid Ali Awan, Author
Tworzenie potoku danych w Luigi wymaga zrozumienia programowania obiektowego. Zacznijmy od instalacji pakietu Luigi dla Pythona.
$ pip install luigiAby opracować prosty potok ETL w Luigi, utworzymy połączone zadania. Zamiast definiować funkcje Pythona jako zadania, utworzymy klasę Pythona dla każdego kroku w potoku: FetchData, ProcessData i GenerateReport. Każda klasa będzie miała trzy funkcje: requires(), output() i run().
Funkcje requires() i output() połączą zadania, a funkcja run() wykona kod przetwarzający. Na końcu zbudujemy potok, używając ostatniego zadania w potoku.
import luigi
import pandas as pd
import numpy as np

class FetchData(luigi.Task):
    def output(self):
        return luigi.LocalTarget('data/fetch_data.csv')

    def run(self):
        # Simulate fetching data by creating a sample CSV file
        data = {
            'column1': [1, 2, np.nan, 4],
            'column2': ['A', 'B', 'C', np.nan]
        }
        df = pd.DataFrame(data)
        df.to_csv(self.output().path, index=False)

class ProcessData(luigi.Task):
    def requires(self):
        return FetchData()

    def output(self):
        return luigi.LocalTarget('data/process_data.csv')

    def run(self):
        df = pd.read_csv(self.input().path)
        # Fill missing values
        df['column1'].fillna(df['column1'].mean(), inplace=True)
        df['column2'].fillna('B', inplace=True)
        df.to_csv(self.output().path, index=False)

class GenerateReport(luigi.Task):
    def requires(self):
        return ProcessData()

    def output(self):
        return luigi.LocalTarget('data/generate_report.txt')

    def run(self):
        df = pd.read_csv(self.input().path)
        # Simple data analysis: calculate mean of column1 and value counts of column2
        mean_column1 = df['column1'].mean()
        value_counts_column2 = df['column2'].value_counts()

        with self.output().open('w') as out_file:
            out_file.write(f'Mean of column1: {mean_column1}\n')
            out_file.write('Value counts of column2:\n')
            out_file.write(value_counts_column2.to_string())

if __name__ == '__main__':
    luigi.build([GenerateReport()], local_scheduler=True)
Uruchom powyższy kod w Jupyter Notebook lub utwórz plik Pythona i uruchom go w terminalu.
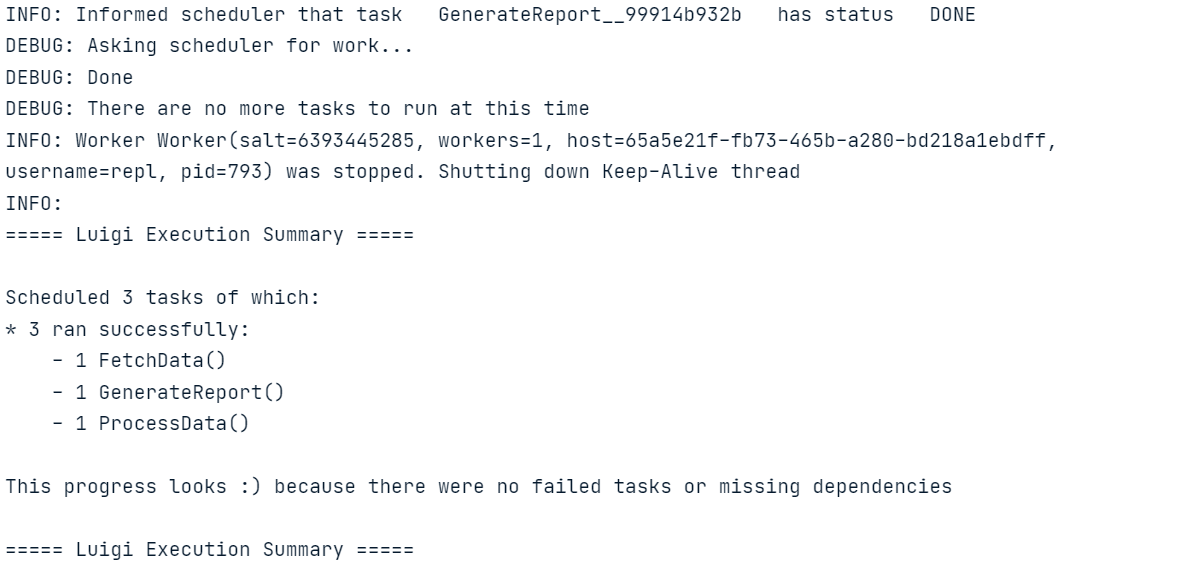
Podobnie jak w Luigi, możesz też nauczyć się, jak zbudować potok ETL w Apache Airflow. Ten poradnik omawia podstawy ekstrakcji, transformacji i ładowania danych w Apache Airflow.
Musimy zainicjować centralny planer Luigi, aby harmonogramować przebiegi potoków lub wyzwalać je zdarzeniami.
Uruchom scheduler, wpisując w terminalu poniższe polecenie.
$ luigid 2024-06-22 13:35:18,636 luigi[25056] INFO: logging configured by default settings
2024-06-22 13:35:18,636 luigi.scheduler[25056] INFO: No prior state file exists at /var/lib/luigi-server/state.pickle. Starting with empty state
2024-06-22 13:35:18,640 luigi.server[25056] INFO: Scheduler starting upAby uruchomić potok, otwórz nowy terminal i wpisz poniższe polecenie. Polecenie Luigi wymaga nazwy pliku Pythona oraz ostatniego zadania, które chcemy wykonać. W tym przypadku nazwa pliku to luigi_pipe.py, a naszym ostatnim zadaniem Luigi jest GenerateReport.
$ python -m luigi --module luigi_pipe GenerateReportJeśli chcesz zwizualizować przebieg potoku i status zadań, po prostu przejdź do http://localhost:8082 w przeglądarce.
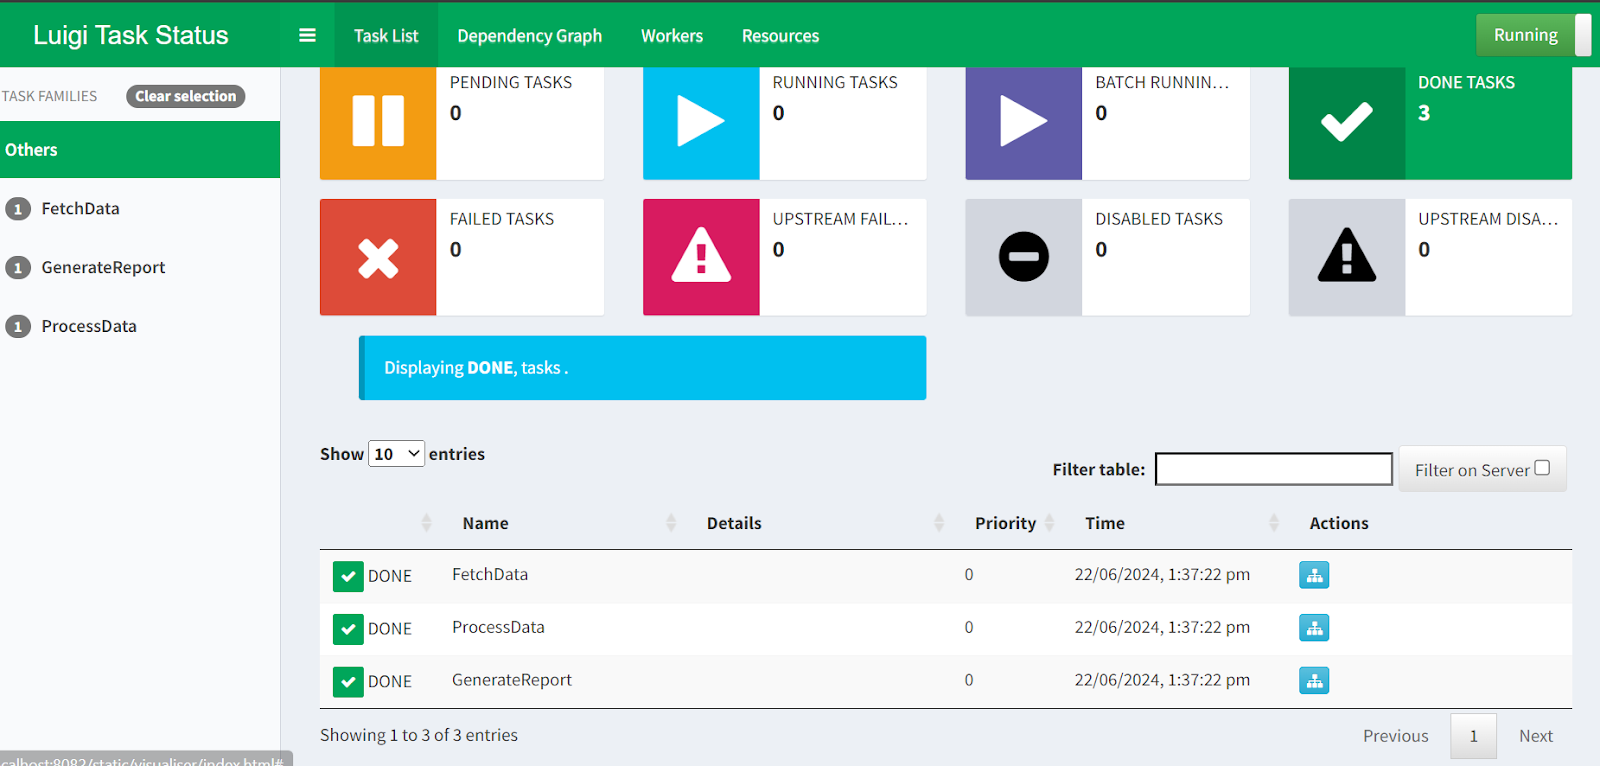
Interfejs webowy Luigi Central Planner.
To już wszystko w naszym przeglądzie 5 najlepszych alternatyw dla Airflow! Jeśli chcesz zagłębić się w któryś z przykładów przedstawionych w tym artykule, rozważ te zasoby:
W tym poradniku omówiliśmy najlepsze, otwartoźródłowe i darmowe alternatywy dla Airflow. Poznaliśmy każde narzędzie do orkiestracji danych oraz zbudowaliśmy i uruchomiliśmy prosty potok ETL. Zobaczenie przykładów kodu pomoże ci zdecydować, które rozwiązanie najlepiej pasuje do twojego przypadku użycia.
Jeśli jesteś początkujący, sugeruję zacząć od Prefect lub Mage AI — są przyjazne dla użytkownika i mają prostą konfigurację. Jeśli jednak szukasz bardziej zaawansowanych narzędzi, które trzymają się praktyk inżynierii oprogramowania, polecam Dagster, Kedro i Luigi.
Po lekturze tego artykułu naturalnym kolejnym krokiem w twojej ścieżce inżynierii danych jest zdobycie certyfikacji, np. Data Engineer in Python od DataCamp, aby poznać inne narzędzia i zbudować kompleksowy potok danych gotowy do wdrożenia na produkcję.
Poznaj data engineering z tymi kursami!
course
Track
course