Kurs
Data Engineering'e Giriş
4 sa
129.7K
Görsel: yazar.
Apache Airflow, veri hatları (pipeline) oluşturmak, zamanlamak ve izlemek için tasarlanmış, popüler bir açık kaynak veri orkestrasyon aracıdır. İş akışlarının durumunu yönetmeye yardımcı olan bir kontrol paneli sunar ve çoğu iş akışı ihtiyacı için ideal bir araçtır.
Ancak Airflow, modern ve karmaşık veri orkestrasyonu gereksinimleri için hayati öneme sahip bazı özelliklerden yoksundur.
Bu eğitimde, yeteneklerini geliştiren ve bazı sınırlamalarını gideren beş Airflow alternatifini inceleyeceğiz. Ayrıca, her araçla basit bir ETL hattı kurmayı, çalıştırmayı ve kontrol panellerinde görselleştirmeyi öğreneceğiz.
Airflow pek çok veri iş akışı için güçlü bir araç olsa da, bazı kısıtları şirketleri alternatifleri değerlendirmeye yöneltebilir.
Bir alternatifi tercih edebileceğiniz bazı nedenler şunlardır:
Diğer veri orkestrasyon araçlarının kodlama kısmına geçmeden önce, alternatifleri adil şekilde karşılaştırabilmeniz için Apache Airflow'a Giriş eğitimini izleyerek Airflow ile veri hattı yazmayı öğrenmek önemlidir.
Airflow'a tamamen yeniyseniz, veri hatlarını oluşturma ve zamanlamanın temellerini öğrenmek için kısa Python ile Airflow'a Giriş kursunu değerlendirin.
Şimdi, Airflow'a en iyi 5 alternatifi tanımlayalım ve bunları pratik kod örnekleriyle nasıl kullanacağımızı gösterelim.
Prefect, modern veri ve makine öğrenimi mühendisleri için geliştirilmiş, açık kaynaklı bir Python iş akışı orkestrasyon aracıdır. Basit bir API sunar; veri hattını hızla kurmanıza ve etkileşimli bir kontrol paneli üzerinden yönetmenize olanak tanır.
Perfect hibrit bir yürütme modeli sunar; yani iş akışını buluta dağıtıp orada çalıştırabilir veya yerel depoyu kullanabilirsiniz.
Airflow ile karşılaştırıldığında Prefect; otomatik görev bağımlılıkları, olay tabanlı tetikleyiciler, yerleşik bildirimler, iş akışına özel altyapı ve görevler arası veri paylaşımı gibi gelişmiş özelliklerle gelir. Bu yetenekler, karmaşık iş akışlarını verimli ve etkili şekilde yönetmek için güçlü bir çözüm sunar.
Prefect basit ve güçlü özelliklerle geliyor. Örnek kodu çalıştırmam esasen 5 dakikamı aldı. Özellikle kontrol paneli arayüzünün tasarımını, bildirimleri nasıl ayarlayabildiğinizi, hatları yeniden çalıştırmayı ve her şeyi Panel üzerinden yönetip izleyebilmeyi beğendim.
Abid Ali Awan, Author
Şu blog yazısını okuyun: Airflow ve Prefect: Veri İş Akışınız için Hangisi Doğru?. Bu iki veri orkestrasyon aracı arasındaki ayrıntılı karşılaştırmayı öğrenin.
Prefect projemize Python paketini kurarak başlayacağız. Aşağıdaki komutu bir terminalde çalıştırın.
$ pip install -U prefectArdından prefect_etl.py adlı bir Python betiği oluşturup aşağıdaki kodu yazacağız.
from prefect import task, flow
import pandas as pd

# Extract data
@task
def extract_data():
    # Simulating data extraction
    data = {
        "name": ["Alice", "Bob", "Charlie"],
        "age": [25, 30, 35],
        "city": ["New York", "Los Angeles", "Chicago"]
    }
    df = pd.DataFrame(data)
    return df

# Transform data
@task
def transform_data(df: pd.DataFrame):
    # Example transformation: adding a new column
    df["age_plus_ten"] = df["age"] + 10
    return df

# Load data
@task
def load_data(df: pd.DataFrame):
    # Simulating data load
    print("Loading data to target destination:")
    print(df)

# Defining the flow
@flow(log_prints=True)
def etl():
    raw_data = extract_data()
    transformed_data = transform_data(raw_data)
    load_data(transformed_data)

# Running the flow
if __name__ == "__main__":
    etl()
Yukarıdaki kod, extract_data(), transform_data(), ve load_data() görev (task) fonksiyonlarını tanımlar ve bunları etl() adlı bir akış (flow) fonksiyonunda ardışık olarak yürütür. Bu fonksiyonlar, Prefect Python dekoratörleri kullanılarak oluşturulmuştur.
Kısaca, bir pandas DataFrame oluşturuyor, onu dönüştürüyor ve ardından print ile nihai sonucu gösteriyoruz. Bu, bir ETL hattını simüle etmenin basit bir yoludur.
İş akışını yürütmek için, aşağıdaki komutla Python betiğini çalıştırmanız yeterlidir.
$ python prefect_etl.py Görüldüğü gibi, iş akışı çalıştırmamız başarıyla tamamlandı.
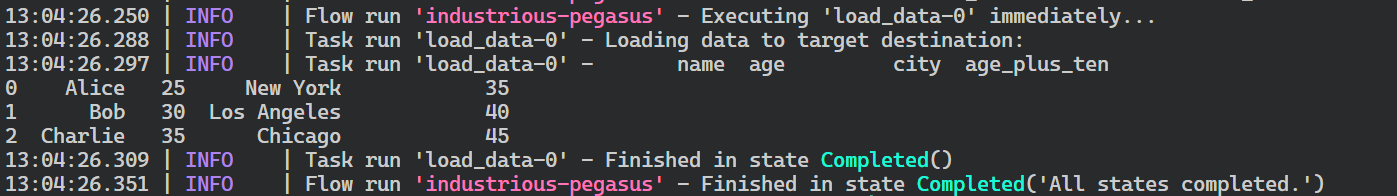
Prefect akış çalıştırma günlükleri.
Şimdi iş akışımızı dağıtacağız; böylece bir takvimle çalıştırabilir veya bir olaya göre tetikleyebiliriz. Akışı dağıtmak ayrıca birden fazla iş akışını merkezi şekilde izlememize ve yönetmemize olanak tanır.
Akışı dağıtmak için Prefect CLI'ı kullanacağız. deploy işlevi, Python dosya adını, dosyadaki akış fonksiyonunun adını ve dağıtım adını ister. Bu örnekte, dağıtıma “simple_etl” adını veriyoruz.
$ prefect deploy prefect_etl.py:etl -n 'simple_etl'Yukarıdaki komutu terminalde çalıştırdıktan sonra, dağıtımı çalıştırmak için bir worker pool'unuzun olmadığına dair bir mesaj alabilirsiniz. Worker pool oluşturmak için aşağıdaki komutu kullanın.
$ prefect worker start --pool 'datacamp'Artık bir worker pool olduğuna göre, başka bir terminal penceresi açıp dağıtımı çalıştıracağız. prefect deployment run komutu, argüman olarak “<flow-function-name>/<deployment-name>” ister; aşağıdaki komutta gösterildiği gibi.
$ prefect deployment run 'etl/simple_etlDağıtımı çalıştırmanın sonucu olarak, iş akışının çalıştığına dair bir mesaj alacaksınız. Genellikle oluşturulan akış çalıştırmasına rastgele bir ad atanır; benim durumumda witty-lorikeet.
Creating flow run for deployment 'etl/simple_etl'...
Created flow run 'witty-lorikeet'.
└── UUID: 4e0495b0-9c7e-4ed8-b9ab-5160994dc7f0
└── Parameters: {}
└── Job Variables: {}
└── Scheduled start time: 2024-06-22 14:05:01 PKT (now)
└── URL: <no dashboard available>
Tam günlüğü görmek için, worker havuzunu başlattığınız terminal penceresine geri dönün.
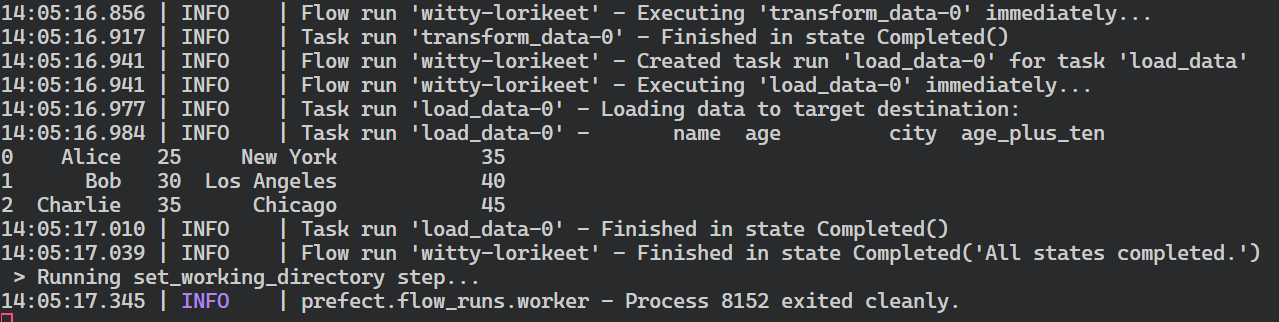
Prefect akış çalıştırma özeti.
Akış çalıştırmasını daha kullanıcı dostu şekilde görselleştirmek ve diğer iş akışlarını yönetmek için Prefect web sunucusunu başlatmalısınız.
$ prefect server start Yukarıdaki komutu çalıştırdıktan sonra Prefect kontrol paneline yönlendirilmelisiniz. Alternatif olarak, tarayıcınızda doğrudan http://127.0.0.1:4200 adresine gidebilirsiniz.
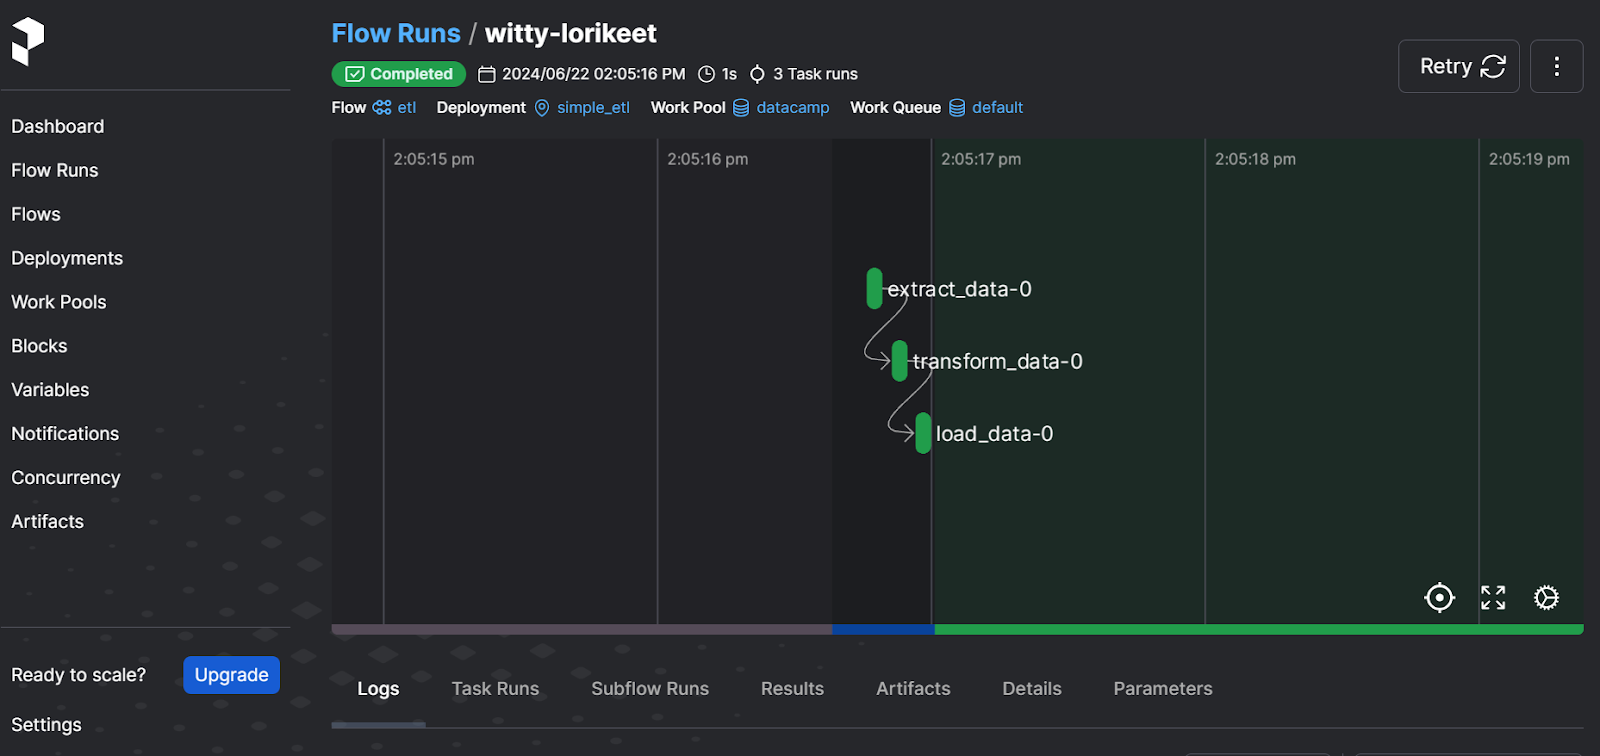
Prefect web sunucusu arayüzü
Kontrol paneli; iş akışını yeniden çalıştırmanıza, günlükleri görüntülemenize, çalışma havuzlarını kontrol etmenize, bildirimler ayarlamanıza ve diğer gelişmiş seçenekleri seçmenize olanak tanır. Modern veri orkestrasyonu ihtiyaçlarınız için eksiksiz bir çözümdür.
Prefect kullanarak makine öğrenimi hatları oluşturmayı ve çalıştırmayı öğrenmek için Makine Öğrenimi İş Akışları için Prefect Kullanımı eğitimini takip edebilirsiniz.
Dasgter, veri hatlarını tanımlamak, zamanlamak ve izlemek için tasarlanmış, veri mühendislerine yönelik açık kaynaklı bir çerçevedir. Son derece ölçeklenebilirdir ve çeşitli veri ekipleri arasında iş birliğini kolaylaştırır.
Dagster, kullanıcıların veri varlıklarını (asset) dekoratörlerle Python fonksiyonları olarak tanımlamasını sağlar. Bu varlıklar tanımlandıktan sonra, kullanıcılar bunları zamanlama veya olay tabanlı tetikleyicilerle sorunsuz şekilde çalıştırabilir.
Airflow ile karşılaştırıldığında Dagster; hattı yerelde geliştirmemize, test etmemize ve gözden geçirmemize izin verir, orkestrasyona varlık tabanlı bir yaklaşım sunar ve bulut ile konteyner yerelidir.
İş akışını adımlar ve akışlar olarak düşünmek yerine, düşüncemi değiştirip veri varlıklarıyla bir hat inşa etmem gerekti. Bunun dışında, basit bir ETL hattı kurmak ve çalıştırmak oldukça kolaydı. Ayrıca web sunucusu nispeten minimal ama varlıkları, çalışmaları ve dağıtımları izlemek için gereken tüm bilgileri sağlıyor.
Abid Ali Awan, Author
Basit bir ETL hattı oluşturacak, çalıştıracak ve Dagster web sunucusunu kullanarak görselleştireceğiz. Prefect kontrol paneline benzer şekilde, Dagster web sunucusu birden çok iş akışını merkezi olarak izleme, çalıştırma ve varlıkları zamanlama yolları sunar.
Python paketini kurarak başlayacağız.
$ pip install dagster -qArdından, veriyi çıkarma, dönüştürme ve yükleme için üç Python fonksiyonu oluşturacağız. Bu fonksiyonların koddaki adları create_dirty_data(), clean_data() ve load_cleaned_data() şeklindedir. @asset dekoratörünü kullanarak bu fonksiyonları Dagster'da veri varlıkları olarak bildireceğiz.
Sonra, tüm varlıkları (all_assets değişkeni) kullanarak varlık işini (job değişkeni) oluşturacak ve ardından varlık tanımını (defs değişkeni) yaratacağız.
Varlık tanımı bölümünü atlayabilirsiniz; ancak çalıştırmayı zamanlamak, birden fazla işi çalıştırmak ve sensörleri kurmak istiyorsanız önem kazanır.
import pandas as pd
import numpy as np
from dagster import asset, Definitions, define_asset_job, materialize

@asset
def create_dirty_data():
    # Create a sample DataFrame with dirty data
    data = {
        'Name': [' John Doe ', 'Jane Smith', 'Bob Johnson ', '  Alice Brown'],
        'Age': [30, np.nan, 40, 35],
        'City': ['New York', 'los angeles', 'CHICAGO', 'Houston'],
        'Salary': ['50,000', '60000', '75,000', 'invalid']
    }
    df = pd.DataFrame(data)

    # Save the DataFrame to a CSV file
    dirty_file_path = 'dag_data/dirty_data.csv'
    df.to_csv(dirty_file_path, index=False)

    return dirty_file_path

@asset
def clean_data(create_dirty_data):
    # Read the dirty CSV file
    df = pd.read_csv(create_dirty_data)

    # Clean the data
    df['Name'] = df['Name'].str.strip()
    df['Age'] = pd.to_numeric(df['Age'], errors='coerce').fillna(df['Age'].mean())
    df['City'] = df['City'].str.upper()
    df['Salary'] = df['Salary'].replace('[\$,]', '', regex=True)
    df['Salary'] = pd.to_numeric(df['Salary'], errors='coerce').fillna(0)

    # Calculate average salary
    avg_salary = df['Salary'].mean()

    # Save the cleaned DataFrame to a new CSV file
    cleaned_file_path = 'dag_data/cleaned_data.csv'
    df.to_csv(cleaned_file_path, index=False)

    return {
        'cleaned_file_path': cleaned_file_path,
        'avg_salary': avg_salary
    }

@asset
def load_cleaned_data(clean_data):
    cleaned_file_path = clean_data['cleaned_file_path']
    avg_salary = clean_data['avg_salary']

    # Read the cleaned CSV file to verify
    df = pd.read_csv(cleaned_file_path)

    print({
        'num_rows': len(df),
        'num_columns': len(df.columns),
        'avg_salary': avg_salary
    })

# Define all assets
all_assets = [create_dirty_data, clean_data, load_cleaned_data]

# Create a job that will materialize all assets
job = define_asset_job("all_assets_job", selection=all_assets)

# Create Definitions object
defs = Definitions(
    assets=all_assets,
    jobs=[job]
)

if __name__ == "__main__":
    result = materialize(all_assets)
    print("Pipeline execution result:", result.success)
Yukarıdaki kodu bir Jupyter Notebook'ta çalıştırabilir veya bir Python dosyası oluşturup çalıştırabilirsiniz.
Kodu çalıştırmanın sonucu olarak, iş akışı çalıştırmasına ait eksiksiz bir günlük alacağız.
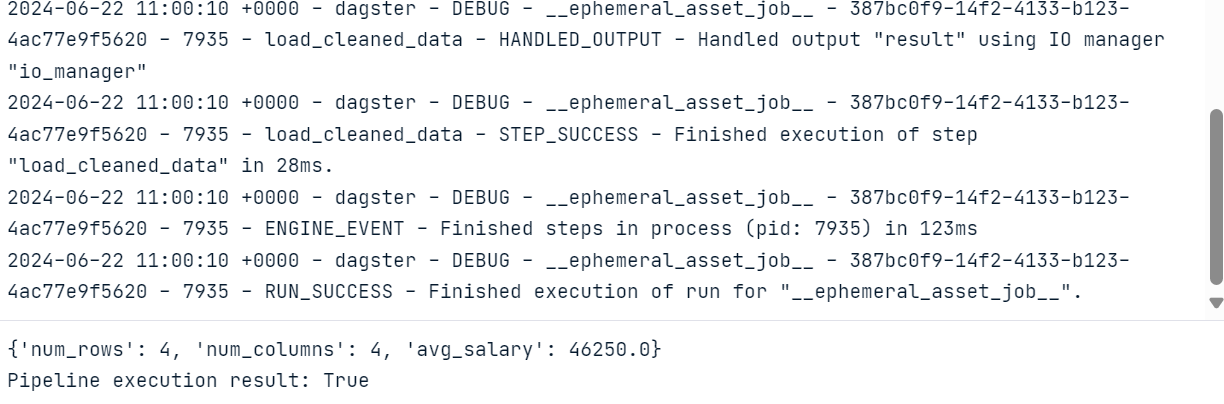
Varlıkları ve iş çalıştırmalarını görselleştirmek için Dagster web sunucusunu kurup çalıştırmalıyız. Web sunucusu, işleri çalıştırmanıza, tekil varlıkları malzeme haline getirmenize (materialize) ve aynı anda birden fazla işi izlemenize olanak tanır.
$ pip install dagster-webserverDagster sunucusunu başlatmak için Daster CLI'ı kullanacak ve ona Python dosya konumunu vereceğiz. Bu durumda dosyaya dagster_pipe.py adını verdim.
$ dagster dev -f dagster_pipe.py Yukarıdaki komut, web sunucusunu tarayıcınızda otomatik olarak başlatacaktır. Alternatif olarak, tarayıcınızda doğrudan http://127.0.0.1:3000 adresine gidebilirsiniz.
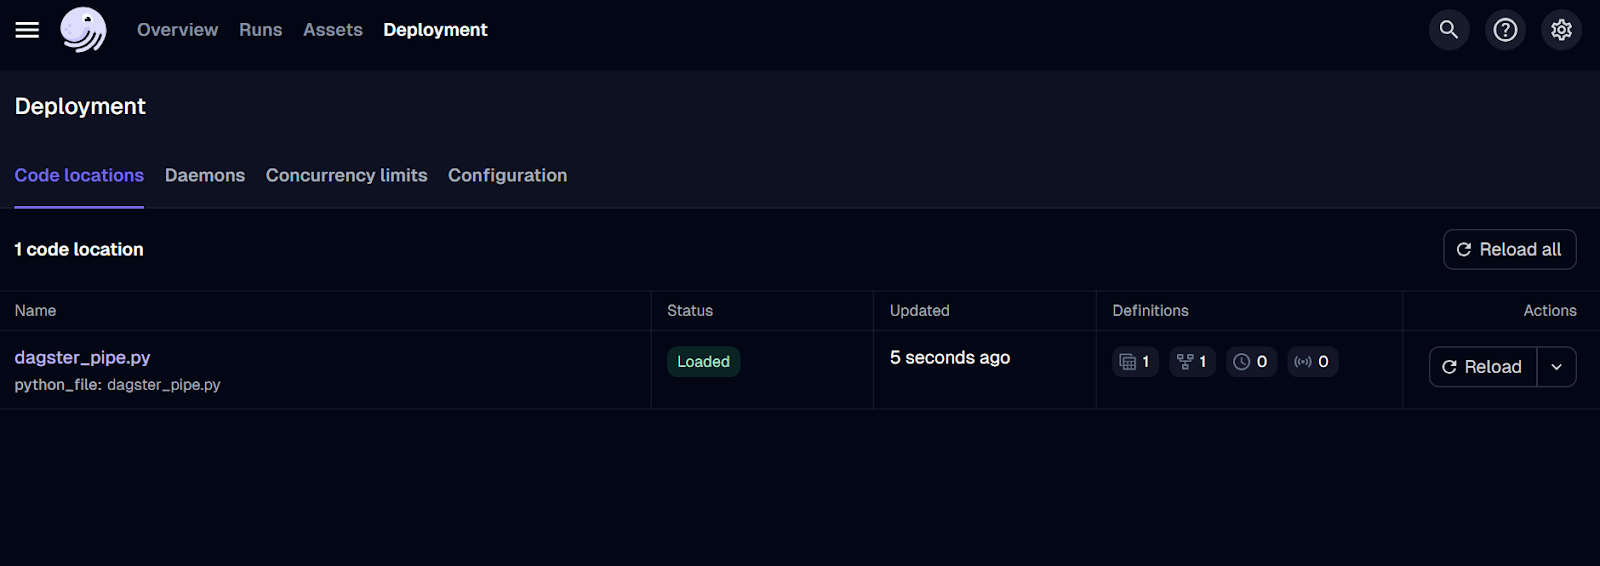
Dagster web sunucusu arayüzü.
Şimdiye kadar yalnızca işi dağıttık. İş akışını çalıştırmak için “Runs” sekmesine gidin ve “Launch a new run” düğmesine tıklayın.
Çalıştırma başarıyla tamamlanmış olmalı! Günlükleri görmek için, ilgilendiğiniz çalıştırmanın kimliğine tıklayın.
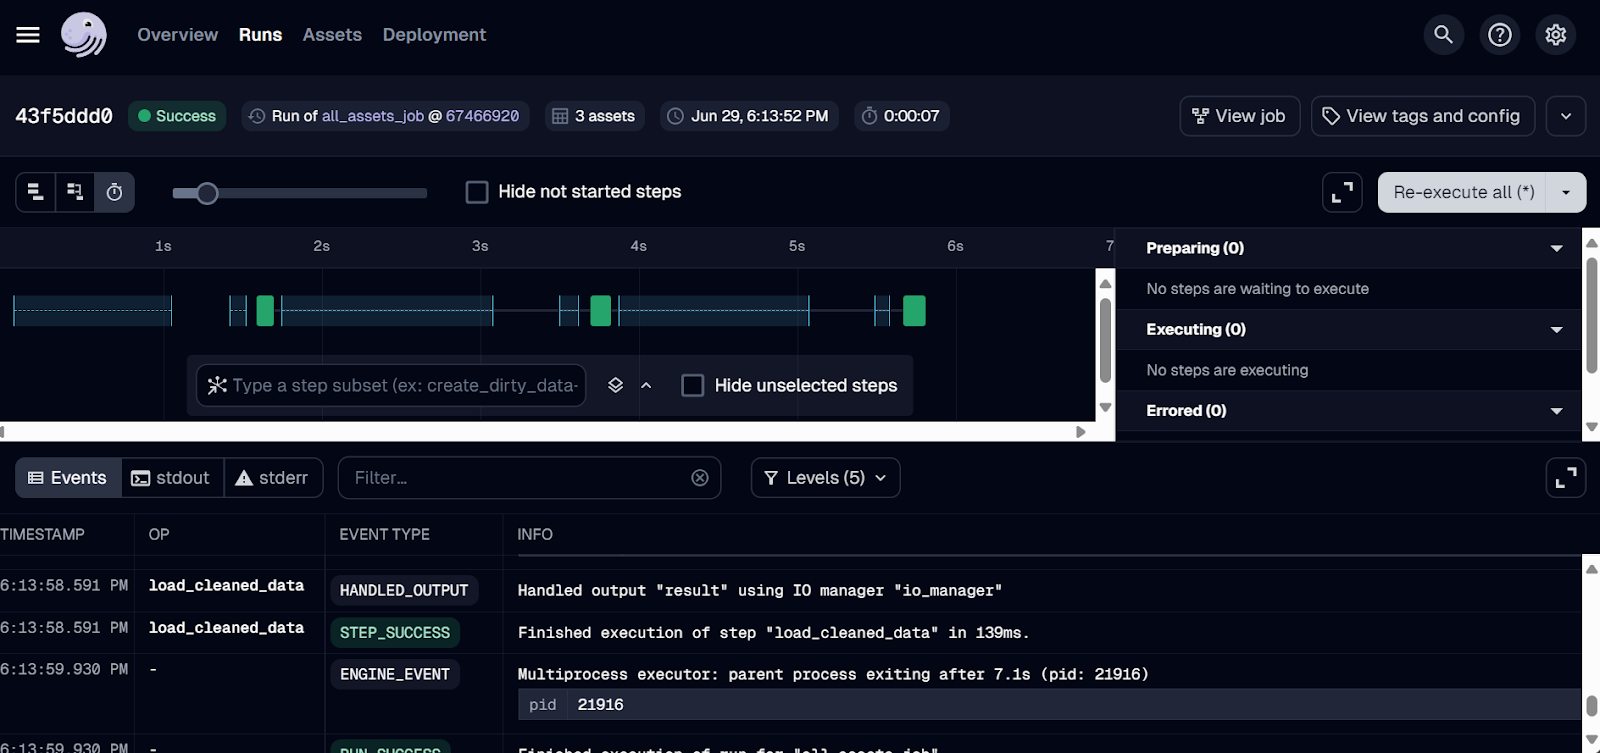
Dagster çalışma günlükleri.
Mage AI, hibrit bir açık kaynak veri orkestrasyon çerçevesidir. Hibrit, bir Jupyter Notebook'un esnekliği ile modüler kodun kontrolünü bir araya getirdiği anlamına gelir.
Python bilgisi sınırlı olanlar dahi veri hatları oluşturabilir, çalıştırabilir ve izleyebilir. Python dosyasını doğrudan yazıp çalıştırmak yerine, bir Mage AI projesi oluşturacak ve bunu kontrol panelinde başlatarak veri hatlarınızı orada kuracak, çalıştıracak ve yöneteceksiniz.
Airflow ile karşılaştırıldığında Mage AI, kullanıcı dostu bir arayüz ve kullanım kolaylığı sunar; bu da onu veri mühendisliğine yeni başlayanlar için mükemmel bir seçenek yapar. Ölçeklenebilirlik göz önünde bulundurularak tasarlanmıştır ve büyük veri hacimlerini ve karmaşık hat yapıları verimli şekilde işleyebilir.
Alışık olduğumdan tamamen farklı olduğu için garipsedim. Mage AI web arayüzünü kurup başlatmam gerekti. Kolay olması bekleniyordu ama ETL hattını kurup çalıştırmayı zor buldum. Öte yandan, bu benzersiz tasarımın alana yeni başlayanlar için neden cazip olabileceğini anlıyorum; temelde sürükle-bırak ve butonlara basmak gibi.
Abid Ali Awan, Author
Mage AI'i başlatmak oldukça basit. Sadece Mage AI Python paketini kurmamız yeterli.
$ pip install mage-aiVe Mage AI projesini başlatın.
$ mage start mage_ai_etl Yukarıdaki komut web sunucusunu başlatacaktır. Daha önce de belirtildiği gibi, tüm kod düzenleme, iş çalıştırma ve iş izleme Mage AI arayüzü üzerinden yapılır.
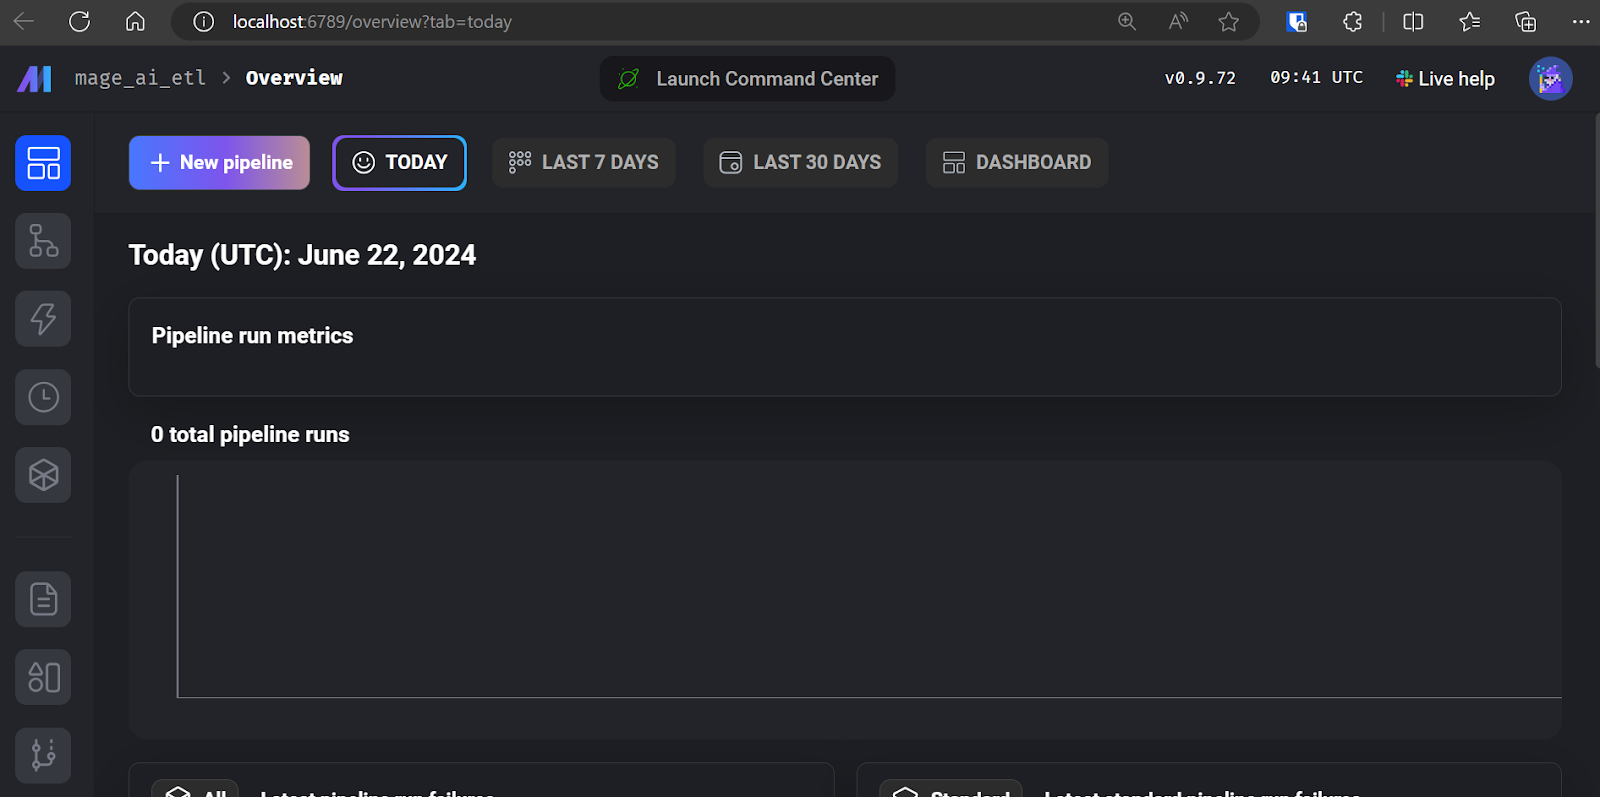
Mage AI arayüzü.
İlk ETL hattınızı oluşturmak için “+ New pipeline”a tıklayın. Benimkine “simple_etl” adını verdim.
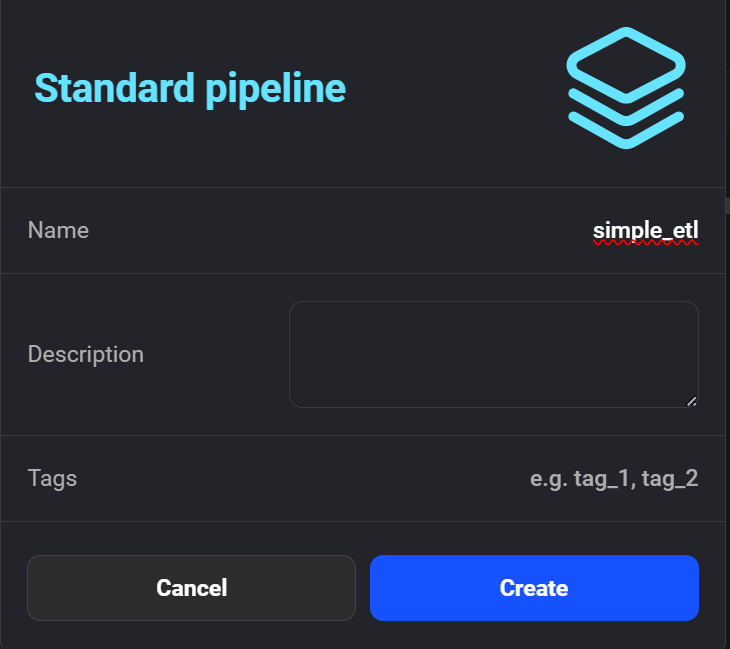
Mage AI'de yeni hat oluşturma.
Ardından, arayüz sizden kodlamaya başlamak için bir modül eklemenizi isteyecek. “Data Loader” modülünü seçin ve aşağıdaki Python kodunu yazın.
Burada, hattımızın ilk adımı olan create_sample_csv() fonksiyonunu tanımlıyoruz. Mage AI @data_loader dekoratörünü kullanıyoruz. Ayrıca çıktının var olup olmadığını doğrulayan bir test_output() fonksiyonu tanımlıyoruz. Bu, görev bağımlılığı yönetimine yardımcı olur.
import io
import pandas as pd

if 'data_loader' not in globals():
    from mage_ai.data_preparation.decorators import data_loader
if 'test' not in globals():
    from mage_ai.data_preparation.decorators import test

@data_loader
def create_sample_csv() -> pd.DataFrame:
    """
    Create a sample CSV file with duplicates and missing values
    """
    csv_data = """
category,product,quantity,price
Electronics,Laptop,5,1000
Electronics,Smartphone,10,500
Clothing,T-shirt,50,20
Clothing,Jeans,30,50
Books,Novel,100,15
Books,Textbook,20,80
Electronics,Laptop,5,1000
Clothing,T-shirt,,20
Electronics,Tablet,,300
Books,Magazine,25,
"""
    return pd.read_csv(io.StringIO(csv_data.strip()))

@test
def test_output(df) -> None:
    """
    Template code for testing the output of the block.
    """
    assert df is not None, 'The output is undefined'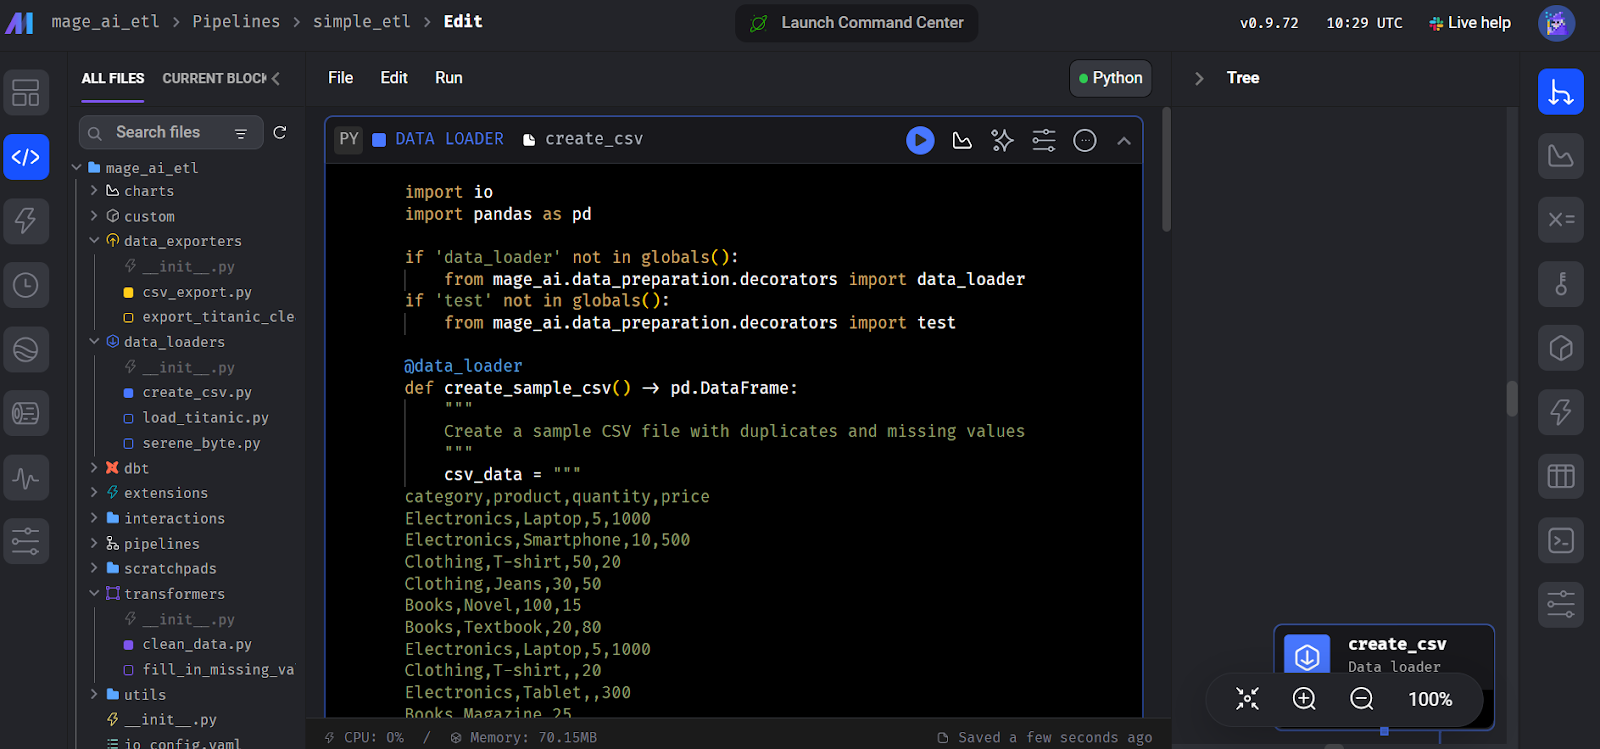
Mage AI'de data loader bloğu oluşturma.
Benzer şekilde bir “Transformer” modülü oluşturun ve aşağıdaki kodda gösterildiği gibi clean_data() fonksiyonunu ekleyin.
test() fonksiyonunu yok sayabilirsiniz; eklemeniz gereken ana dönüştürücü fonksiyon clean_data().
import pandas as pd

if 'transformer' not in globals():
    from mage_ai.data_preparation.decorators import transformer
if 'test' not in globals():
    from mage_ai.data_preparation.decorators import test

@transformer
def clean_data(df: pd.DataFrame) -> pd.DataFrame:
    """
    Clean and transform the data
    """
    # Remove duplicates
    df = df.drop_duplicates()
    # Fill missing values with 0
    df = df.fillna(0)
    return df

@test
def test_output(df) -> None:
    """
    Template code for testing the output of the block.
    """
    assert df is not None, 'The output is undefined'
Benzer şekilde bir “Data Exporter” modülü oluşturun ve aşağıdaki kodu ekleyin. Kod, dönüştürülmüş veriyi bir CSV dosyasına kaydeden export_data_to_csv() adlı bir veri yükleme fonksiyonu tanımlar.
import pandas as pd

if 'data_exporter' not in globals():
    from mage_ai.data_preparation.decorators import data_exporter

@data_exporter
def export_data_to_csv(df: pd.DataFrame) -> None:
    """
    Export the processed data to a CSV file
    """
    df.to_csv('output_data.csv', index=False)
    print("Data exported successfully to output_data.csv")
Hattı çalıştırmak için “Trigger” sekmesine gidin ve “Run@once”a tıklayın.
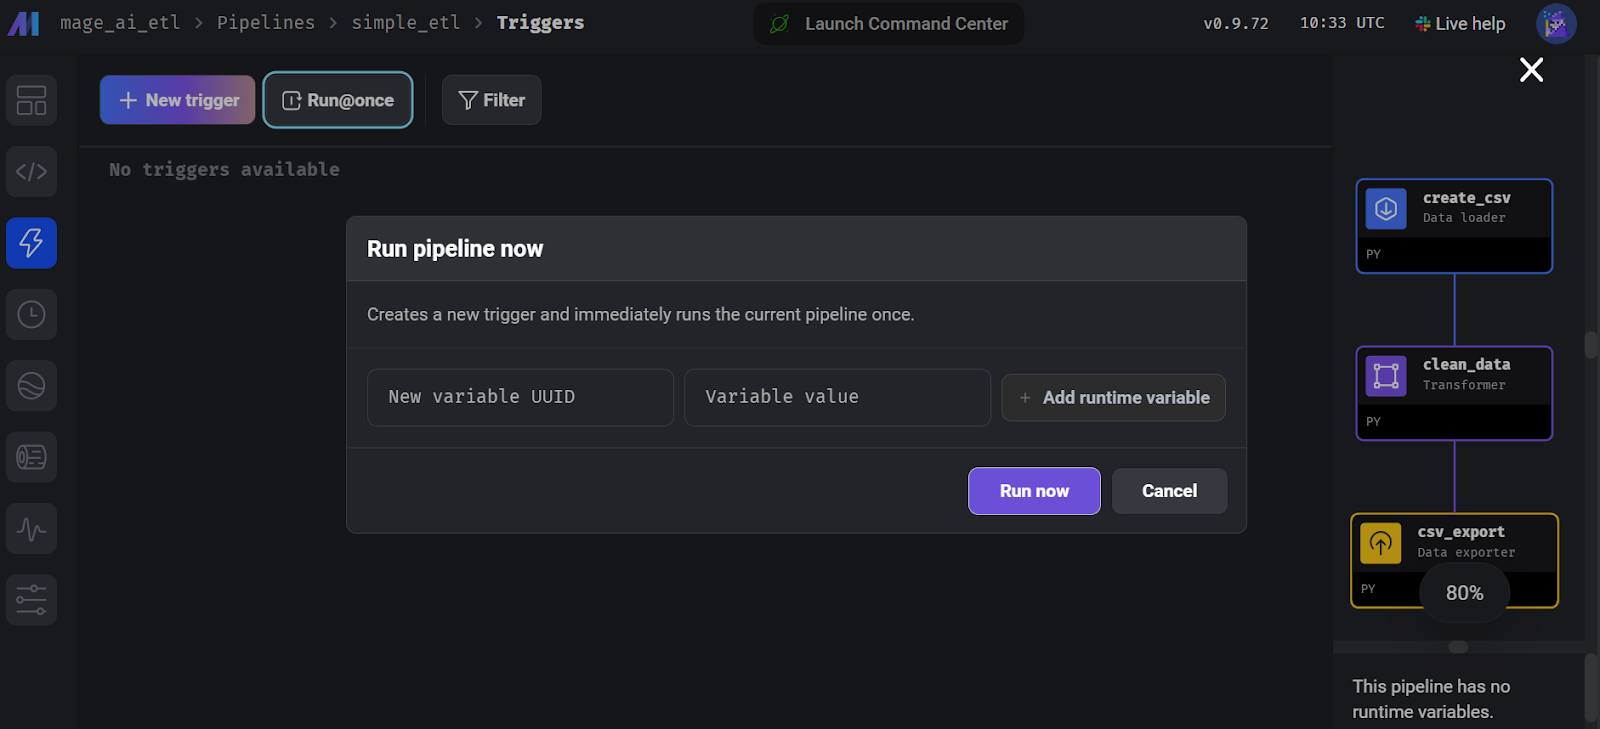
Mage AI'de hattı çalıştırma.
Çalıştırma günlüklerini görüntülemek için “Runs” sekmesine gidin ve yeni çalıştırılan hat üzerindeki “Logs” butonuna tıklayın.
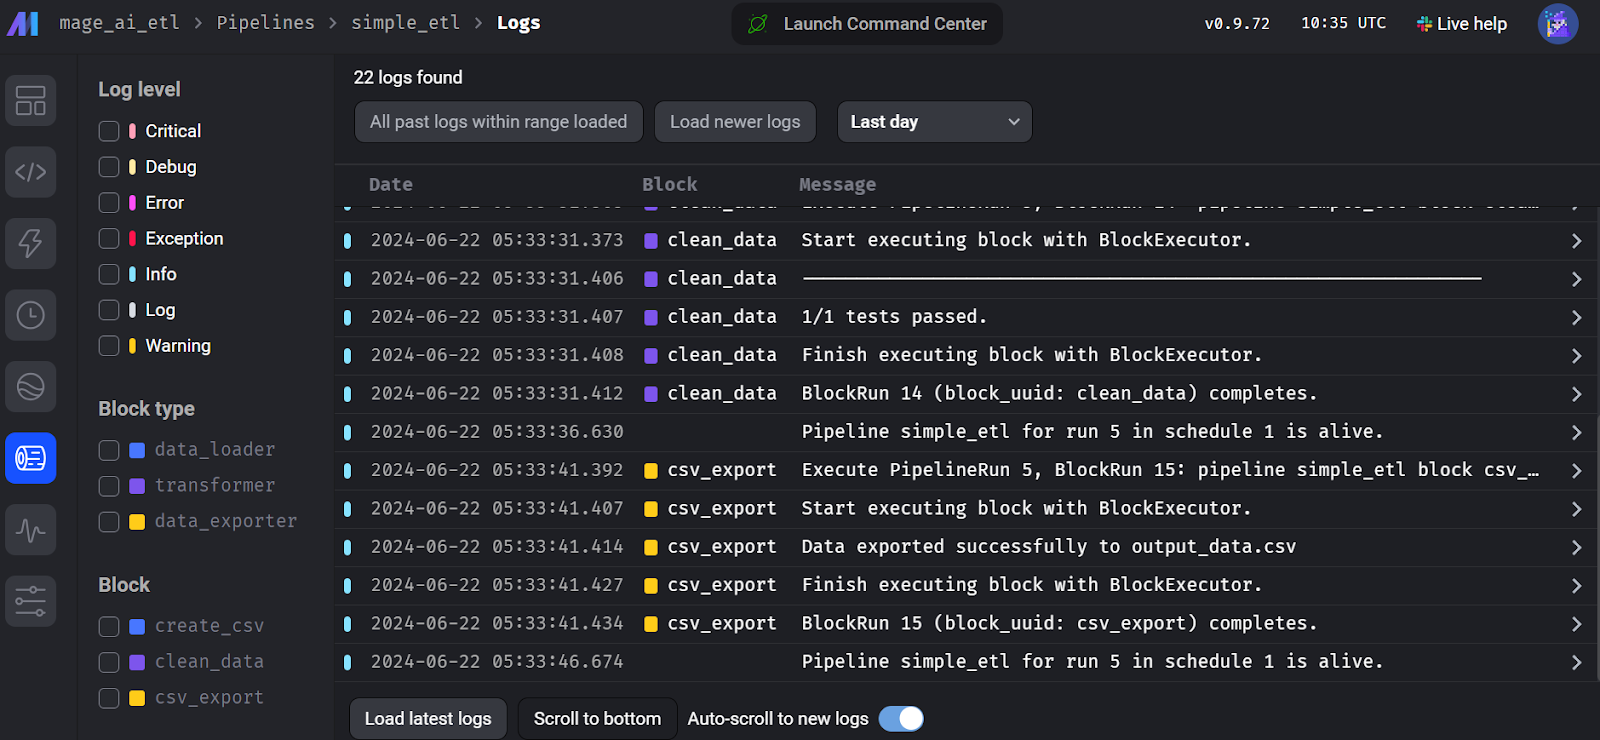
Mage AI akış çalıştırma günlükleri.
Kedro, diğer araçlardan biraz farklı olan, bir başka popüler açık kaynak veri orkestrasyon çerçevesidir. Makine öğrenimi mühendisleri için oluşturulmuştur ve yazılım mühendisliğinden birçok kavramı alıp makine öğrenimi projelerine uygular.
Kedro yüksek derecede modüler olacak şekilde tasarlanmıştır; bu da bir veri kümesini dışa aktarmak için bile, konumu ve veri türünü belirten bir veri kataloğu oluşturmanız gerektiği anlamına gelir; bu sayede hat boyunca standartlaştırılmış ve verimli veri yönetimi sağlanır.
Kedro'nun makine öğrenimi ekosistemine nasıl uyduğunu anlamak için, 2024'te Bilmeniz Gereken 25 MLOps Aracı makalesini okuyarak çeşitli MLOps araçlarını keşfedebilirsiniz.
Airflow ile karşılaştırıldığında Kedro API'si veri hattı kurmayı daha basit hale getirir. Daha çok makine öğrenimi mühendisliğine odaklanır ve veri sınıflandırma ile sürümleme sunar.
Kodlama kısmı oldukça yalın; fakat hattınızı çalıştırmak istediğinizde sorunlar ortaya çıkıyor. Bir veri kataloğu oluşturmanız, hattı kaydetmeniz ve Kedro proje yapısını kavramanız gerekiyor. Dagster ve Prefect’e kıyasla daha zor diyebilirim. Yine de bunun neden böyle tasarlandığını anlıyorum: veri hattınızı güvenilir ve hatasız kılmak için.
Abid Ali Awan, Author
Bir Kedro veri hattı kurmak farklı bir uğraş. Çerçeve modülerdir ve iş akışını başarıyla yürütmek için proje yapısını ve çeşitli adımları anlamanız gerekir.
Kedro Python paketini kurarak başlayın.
$ pip install kedroKedro projesini başlatın.
$ kedro new --name=kedro_etl --tools=none --example=n Proje dizinine geçin.
$ cd kedro-etl pipelines klasörü içinde data_processing adlı bir klasör oluşturun.
$ mkdir -p src/kedro_etl/pipelines/data_processing kedro_pipe.py adlı bir Python dosyası oluşturun ve en sevdiğiniz IDE ile açın; örneğin Visual Studio Code kullanabilirsiniz.
$ code src/kedro_etl/pipelines/data_processing/kedro_pipe.pyPython betiği, hat içindeki düğümler (node) olan çıkarma, dönüştürme ve yükleme fonksiyonlarını içermelidir. Bu örnekte bunlar create_sample_data(), clean_data(), ve load_and_process_data() fonksiyonlarıdır.
Ardından bu düğümleri, create_pipeline() fonksiyonu içinde Kedro Pipeline sınıfını kullanarak birbirine bağlıyoruz. Hat fonksiyonunda düğümleri tanımlarız ve her düğümün inputs, outputs ve bir düğüm name alanı vardır.
import pandas as pd
import numpy as np
from kedro.pipeline import Pipeline, node

def create_sample_data():
    data = {
        'id': range(1, 101),
        'name': [f'Person_{i}' for i in range(1, 101)],
        'age': np.random.randint(18, 80, 100),
        'salary': np.random.randint(20000, 100000, 100),
        'missing_values': [np.nan if i % 10 == 0 else i for i in range(100)]
    }
    return pd.DataFrame(data)

def clean_data(df: pd.DataFrame):
    # Remove rows with missing values
    df_cleaned = df.dropna()

    # Convert salary to thousands
    df_cleaned['salary'] = df_cleaned['salary'] / 1000

    # Capitalize names
    df_cleaned['name'] = df_cleaned['name'].str.upper()

    return df_cleaned

def load_and_process_data(df: pd.DataFrame):
    # Calculate average salary
    avg_salary = df['salary'].mean()

    # Add a new column for salary category
    df['salary_category'] = df['salary'].apply(
        lambda x: 'High' if x > avg_salary else 'Low')

    # Calculate age groups
    df['age_group'] = pd.cut(df['age'], bins=[0, 30, 50, 100], labels=[
                             'Young', 'Middle', 'Senior'])

    print(df)
    return df

def create_pipeline(**kwargs):
    return Pipeline(
        [
            node(
                func=create_sample_data,
                inputs=None,
                outputs="raw_data",
                name="create_sample_data_node",
            ),
            node(
                func=clean_data,
                inputs="raw_data",
                outputs="cleaned_data",
                name="clean_data_node",
            ),
            node(
                func=load_and_process_data,
                inputs="cleaned_data",
                outputs="processed_data",
                name="load_and_process_data_node",
            ),
        ]
    )
Hattı, veri kataloğu oluşturmadan çalıştırırsak verimizi dışa aktarmayacaktır. Bu nedenle conf/base/catalog.yml dosyasına gidip veri kümesi yapılandırmasını sağlayarak düzenlememiz gerekir.
raw_data:
  type: pandas.CSVDataset
  filepath: ./data/kedro/sample_data.csv

cleaned_data:
  type: pandas.CSVDataset
  filepath: ./data/kedro/cleaned_data.csv

processed_data:
  type: pandas.CSVDataset
  filepath: ./data/kedro/processed_data.csv
Yeni oluşturduğumuz Python dosyasını hat kayıt defterine de dahil etmeliyiz. Bunun için src/simple_etl/pipeline_registry.py Python dosyasına gidin ve aşağıdaki kodu ekleyin.
"""Project pipelines."""
from __future__ import annotations

from kedro.pipeline import Pipeline
from kedro_etl.pipelines.data_processing import kedro_pipe

def register_pipelines() -> Dict[str, Pipeline]:
    data_processing_pipeline = kedro_pipe.create_pipeline()

    return {
        "__default__": data_processing_pipeline,
        "data_processing": data_processing_pipeline,
    }
Aşağıdaki komutu çalıştırarak hattı çalıştırın ve canlı günlükleri terminalde görüntüleyin.
$ kedro run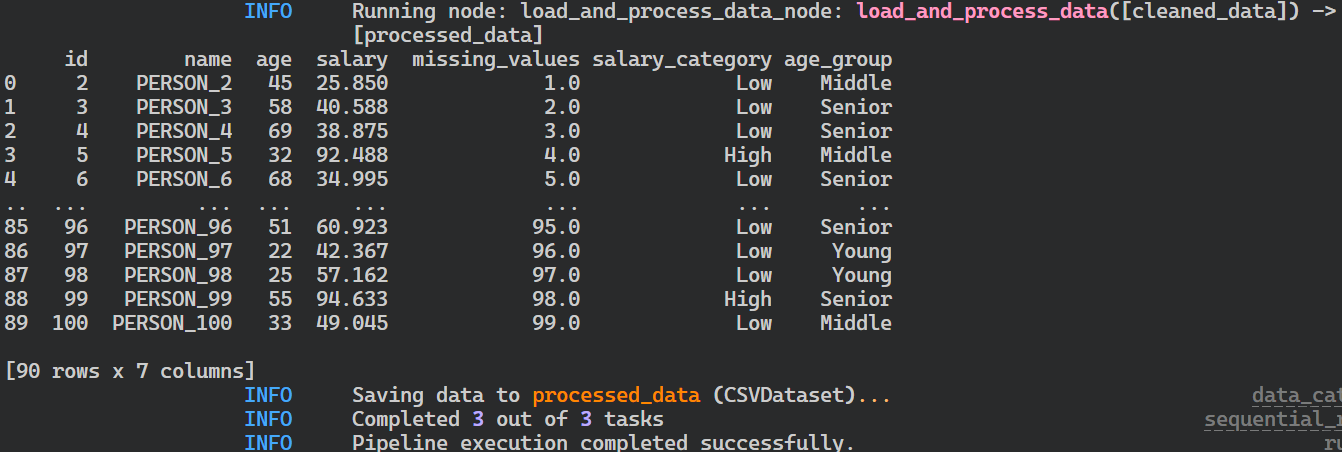
Kedro hat çalıştırma günlükleri.
Hattı çalıştırdıktan sonra, dosyalarınız veri kataloğunda tanımlanan konumda CSV biçiminde saklanacaktır.
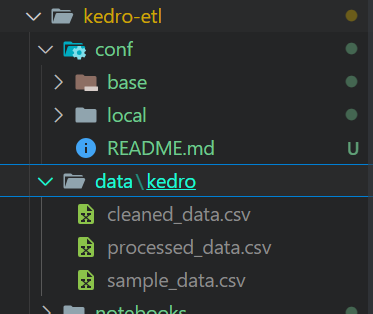
Kedro hat çalıştırmasının çıktı dosyaları.
Hattı çalıştırırken sorunlarla karşılaşırsanız, lütfen Kedro'yu tüm eklentilerle kurmayı düşünün.
$ pip install "kedro[all]"Hatlarımızı görselleştirmek ve paylaşmak için kedro-viz aracını kurabiliriz.
$ pip install kedro-vizDaha sonra, aşağıdaki komutu çalıştırmak tüm veri hatlarını ve veri düğümlerini görselleştirmemizi sağlar. Deney izleme seçeneği ve hat görselleştirmesini paylaşma olanağı da sunar.
$ kedro viz run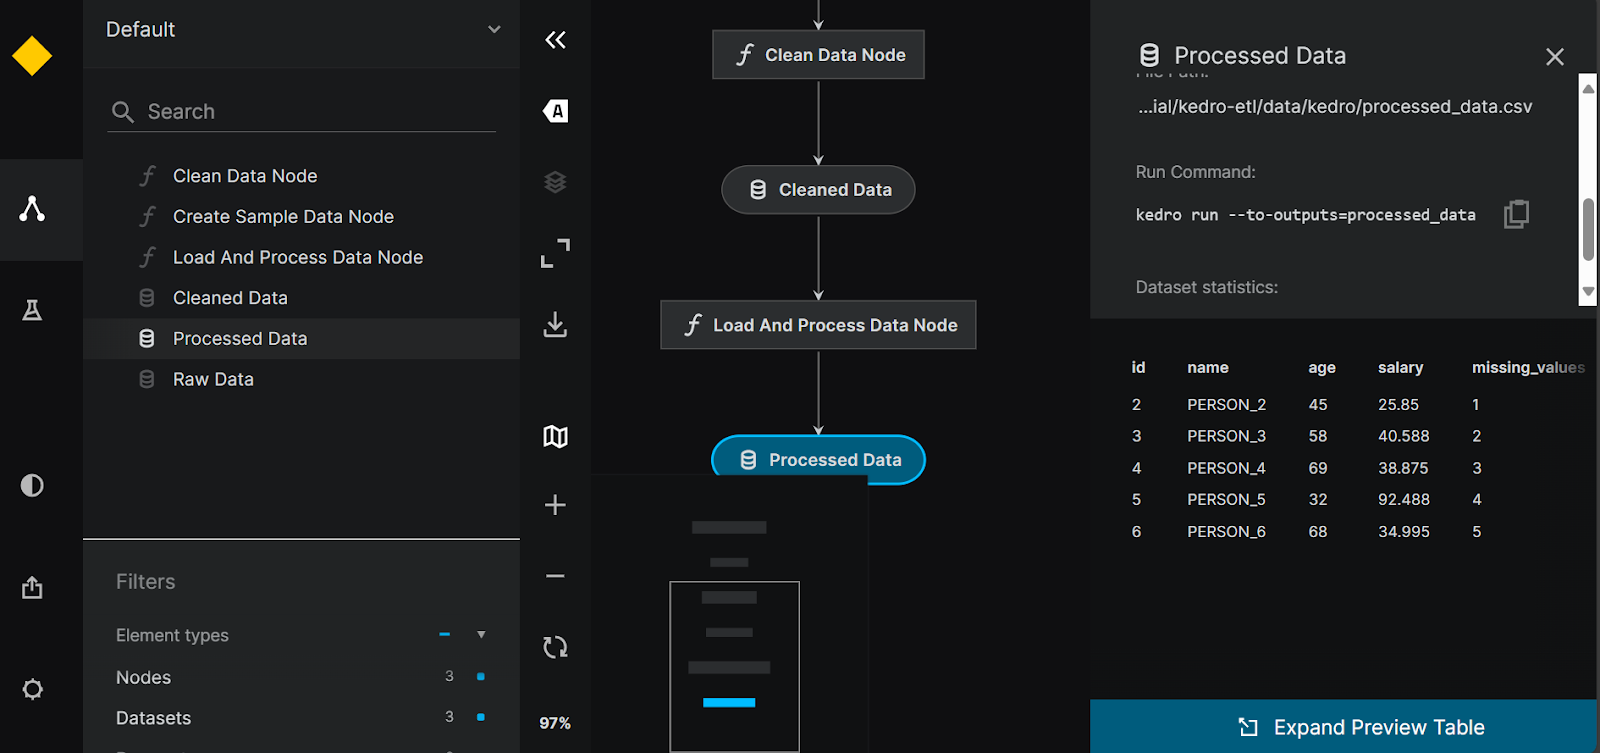
Kedro hat görselleştirmesi.
Luigi, Spotify tarafından geliştirilen, uzun süreli toplu işlemleri ve karmaşık veri hatlarını yönetmede başarılı, Python tabanlı açık kaynak bir çerçevedir. Bağımlılık çözümleme, iş akışı yönetimi, görselleştirme ve hata kurtarma konularında iyidir; bu da onu veri iş akışlarını orkestre etmek için güçlü bir araç yapar.
Airflow ile karşılaştırıldığında Luigi; minimal bir API, takvim tabanlı zamanlama ve veri orkestrasyon hattıyla ilgili sorunlarda size yardımcı olacak sadık bir kullanıcı tabanına sahiptir.
Python'a yeni başlayan biriyseniz, hatları kurup çalıştırmayı zor bulabilirsiniz. Ancak dokümantasyon ve rehberler hızlı başlamanıza yardımcı olabilir. Günlükler sınırlı bilgi sağlar ve kontrol paneli yalnızca DAG ve bağımlılıkların görselleştirilmesidir.
Abid Ali Awan, Author
Bir Luigi veri hattı oluşturmak, nesne yönelimli programlamayı anlamayı gerektirir. Luigi Python paketini kurarak başlayalım.
$ pip install luigiLuigi ile basit bir ETL hattı geliştirmek için, birbiriyle bağlı görevler oluşturacağız. Görevleri Python fonksiyonları olarak oluşturmak yerine, hattın her adımı için birer Python sınıfı oluşturacağız: FetchData, ProcessData ve GenerateReport. Her sınıfta üç fonksiyon bulunur: requires(), output() ve run().
requires() ve output() fonksiyonları görevleri birbirine bağlar; run() fonksiyonu ise işleme kodunu yürütür. Sonunda, hattı, hattaki son görevi kullanarak inşa edeceğiz.
import luigi
import pandas as pd
import numpy as np

class FetchData(luigi.Task):
    def output(self):
        return luigi.LocalTarget('data/fetch_data.csv')

    def run(self):
        # Simulate fetching data by creating a sample CSV file
        data = {
            'column1': [1, 2, np.nan, 4],
            'column2': ['A', 'B', 'C', np.nan]
        }
        df = pd.DataFrame(data)
        df.to_csv(self.output().path, index=False)

class ProcessData(luigi.Task):
    def requires(self):
        return FetchData()

    def output(self):
        return luigi.LocalTarget('data/process_data.csv')

    def run(self):
        df = pd.read_csv(self.input().path)
        # Fill missing values
        df['column1'].fillna(df['column1'].mean(), inplace=True)
        df['column2'].fillna('B', inplace=True)
        df.to_csv(self.output().path, index=False)

class GenerateReport(luigi.Task):
    def requires(self):
        return ProcessData()

    def output(self):
        return luigi.LocalTarget('data/generate_report.txt')

    def run(self):
        df = pd.read_csv(self.input().path)
        # Simple data analysis: calculate mean of column1 and value counts of column2
        mean_column1 = df['column1'].mean()
        value_counts_column2 = df['column2'].value_counts()

        with self.output().open('w') as out_file:
            out_file.write(f'Mean of column1: {mean_column1}\n')
            out_file.write('Value counts of column2:\n')
            out_file.write(value_counts_column2.to_string())

if __name__ == '__main__':
    luigi.build([GenerateReport()], local_scheduler=True)
Yukarıdaki kodu Jupyter Notebook'ta çalıştırın ya da bir Python dosyası oluşturup terminalden çalıştırın.
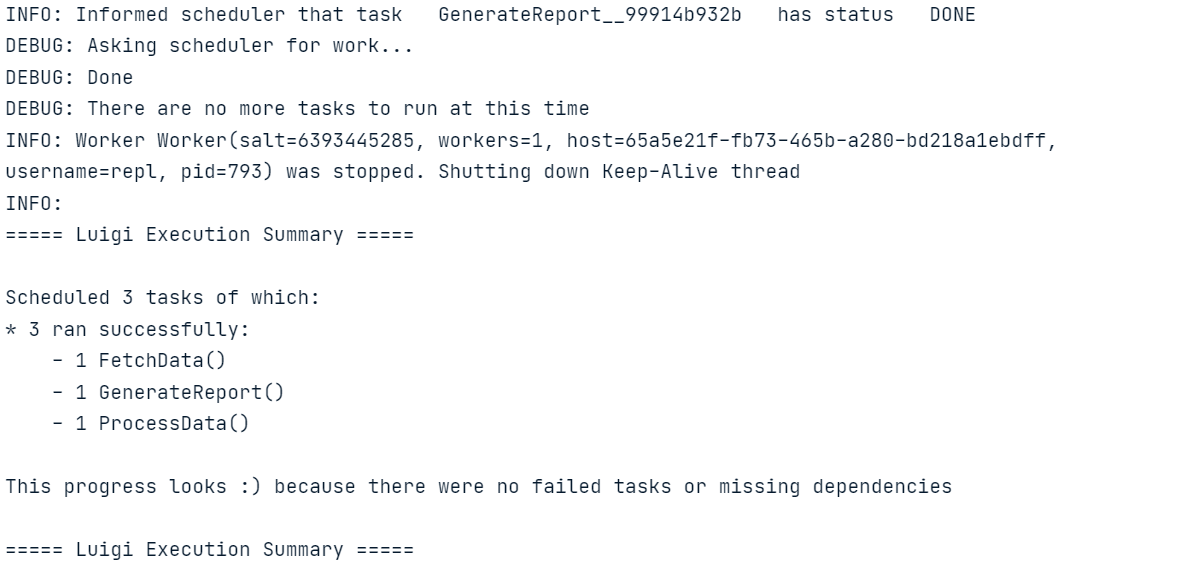
Luigi'ye benzer şekilde, Apache Airflow ile bir ETL hattı nasıl oluşturulur konusunu da öğrenebilirsiniz. Eğitim, Apache Airflow ile veri çıkarma, dönüştürme ve yüklemenin temellerini kapsar.
Hat çalıştırmalarını zamanlamak veya bir olayla tetiklemek için Luigi central planner'ı başlatmamız gerekir.
Zamanlayıcıyı başlatmak için terminale aşağıdaki komutu yazın.
$ luigid 2024-06-22 13:35:18,636 luigi[25056] INFO: logging configured by default settings
2024-06-22 13:35:18,636 luigi.scheduler[25056] INFO: No prior state file exists at /var/lib/luigi-server/state.pickle. Starting with empty state
2024-06-22 13:35:18,640 luigi.server[25056] INFO: Scheduler starting upHattı çalıştırmak için yeni bir terminal açın ve aşağıdaki komutu yazın. Luigi komutu, bir Python dosya adı ve çalıştırmak istediğimiz son görevi ister. Bu durumda dosya adı luigi_pipe.py ve son Luigi görevimiz GenerateReport.
$ python -m luigi --module luigi_pipe GenerateReportHat çalıştırmasını ve görev durumunu görselleştirmek isterseniz, tarayıcınızda doğrudan http://localhost:8082 adresine gidebilirsiniz.
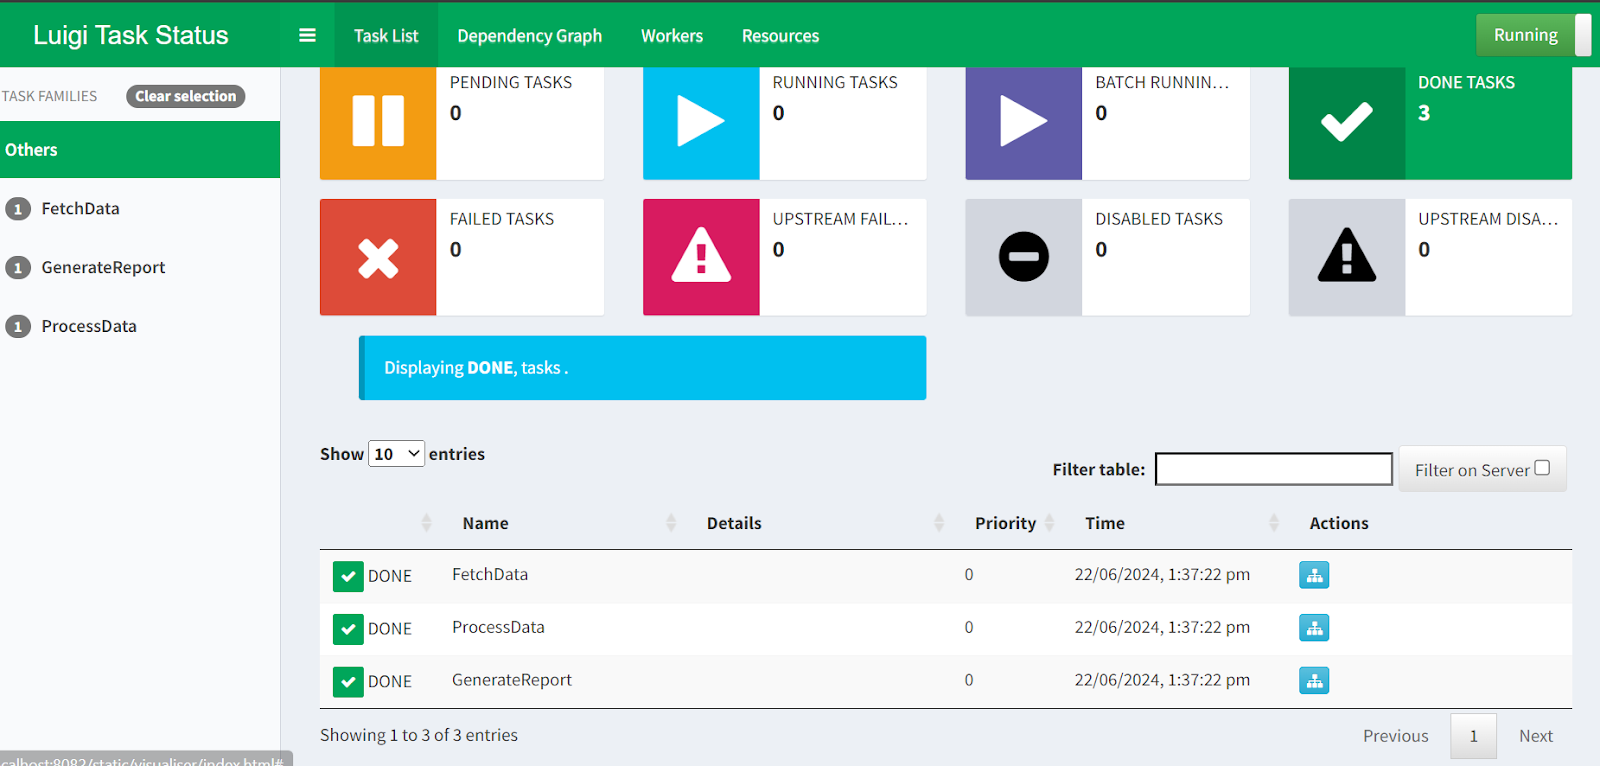
Luigi Central Planner web arayüzü.
Böylece Airflow'a en iyi 5 alternatifin üzerinden geçmiş olduk! Bu yazıdaki örneklerden herhangi birine daha derinlemesine dalmak isterseniz, göz atabileceğiniz bazı kaynaklar:
Bu eğitimde, açık kaynaklı ve ücretsiz en iyi Airflow alternatiflerini tartıştık. Ayrıca her bir veri orkestrasyon aracını öğrendik; basit bir ETL hattı kurup çalıştırdık. Kod örneklerini görmek, kullanım senaryonuza en uygun olanı seçmenize yardımcı olacaktır.
Yeni başlıyorsanız, kullanıcı dostu ve kurulumu basit oldukları için Prefect veya Mage AI ile başlamanızı öneririm. Ancak yazılım mühendisliği uygulamalarına daha sıkı uyan gelişmiş araçlar arıyorsanız Dagster, Kedro ve Luigi'yi keşfetmenizi tavsiye ederim.
Bu yazıyı inceledikten sonra veri mühendisliği yolculuğunuzda doğal bir sonraki adım, üretime dağıtabileceğiniz uçtan uca bir veri hattı kurmayı ve diğer araçları öğrenmeyi sağlayan DataCamp'in Python ile Veri Mühendisi gibi bir sertifika almaktır.
Bu kurslarla veri mühendisliği hakkında daha fazla bilgi edinin!
Kurs
Program
Kurs
blog
Abid Ali Awan
14 dk.
blog
Dario Radečić
15 dk.
Eğitim
Kurtis Pykes
8 dk.
Eğitim
Adel Nehme