
Cours
Introduction au data engineering
4 h
129.8K
Image de l’auteur.
Apache Airflow est un outil open source d’orchestration des données largement adopté, conçu pour créer, planifier et superviser des pipelines de données. Son tableau de bord facilite la gestion de l’état des workflows, ce qui en fait un excellent choix pour la plupart des besoins d’orchestration.
Cependant, Airflow présente certaines limites importantes qui peuvent peser pour des exigences modernes et complexes d’orchestration des données.
Dans ce tutoriel, nous explorerons cinq alternatives à Airflow qui apportent des fonctionnalités avancées et répondent à certaines de ses limites. Nous apprendrons aussi à construire un simple pipeline ETL avec chaque outil, à l’exécuter et à le visualiser dans leur tableau de bord.
Airflow est puissant pour divers workflows de données, mais plusieurs limites peuvent pousser des entreprises à considérer d’autres options.
Voici quelques raisons de préférer une alternative :
Avant d’explorer le code des autres outils d’orchestration, il est utile d’apprendre à écrire un pipeline de données avec Apache Airflow en suivant le tutoriel Getting Started with Apache Airflow, afin de comparer équitablement les alternatives.
Si vous débutez totalement avec Airflow, envisagez le cours court Introduction to Airflow in Python pour apprendre les bases de la création et de la planification de pipelines de données.
Passons en revue les 5 meilleures alternatives à Airflow et voyons comment les utiliser avec des exemples de code concrets.
Prefect est un outil open source d’orchestration de workflows en Python, pensé pour les ingénieurs data et machine learning modernes. Il propose une API simple pour construire rapidement un pipeline et le piloter via un tableau de bord interactif.
Prefect offre un modèle d’exécution hybride : vous pouvez déployer le workflow dans le cloud et l’y exécuter, ou l’exécuter localement depuis votre dépôt.
Par rapport à Airflow, Prefect intègre des fonctionnalités avancées comme les dépendances de tâches automatiques, les déclencheurs basés sur des événements, les notifications intégrées, une infrastructure spécifique au workflow et le partage de données entre tâches. Ces atouts en font une solution puissante pour gérer efficacement des workflows complexes.
Prefect est simple et très complet. Il m’a fallu à peine 5 minutes pour exécuter l’exemple de code. J’aime particulièrement le design du tableau de bord, la configuration des notifications, la possibilité de relancer des pipelines, et la gestion/monitoring centralisés via le Dashboard.
Abid Ali Awan, Author
Lisez l’article Airflow vs Prefect : choisir l’outil adapté à votre workflow data pour une comparaison détaillée de ces deux solutions d’orchestration.
Nous allons démarrer le projet Prefect en installant le package Python. Exécutez la commande suivante dans un terminal.
$ pip install -U prefectEnsuite, créez un script Python nommé prefect_etl.py et collez le code suivant.
from prefect import task, flow
import pandas as pd

# Extract data
@task
def extract_data():
    # Simulating data extraction
    data = {
        "name": ["Alice", "Bob", "Charlie"],
        "age": [25, 30, 35],
        "city": ["New York", "Los Angeles", "Chicago"]
    }
    df = pd.DataFrame(data)
    return df

# Transform data
@task
def transform_data(df: pd.DataFrame):
    # Example transformation: adding a new column
    df["age_plus_ten"] = df["age"] + 10
    return df

# Load data
@task
def load_data(df: pd.DataFrame):
    # Simulating data load
    print("Loading data to target destination:")
    print(df)

# Defining the flow
@flow(log_prints=True)
def etl():
    raw_data = extract_data()
    transformed_data = transform_data(raw_data)
    load_data(transformed_data)

# Running the flow
if __name__ == "__main__":
    etl()
Le code ci-dessus définit les fonctions tâches extract_data(), transform_data(), et load_data(), puis les exécute en série dans une fonction de flow nommée etl(). Ces fonctions sont créées via des décorateurs Prefect.
En bref, nous créons un DataFrame pandas, nous l’enrichissons, puis nous affichons le résultat final avec print. Une façon simple de simuler un pipeline ETL.
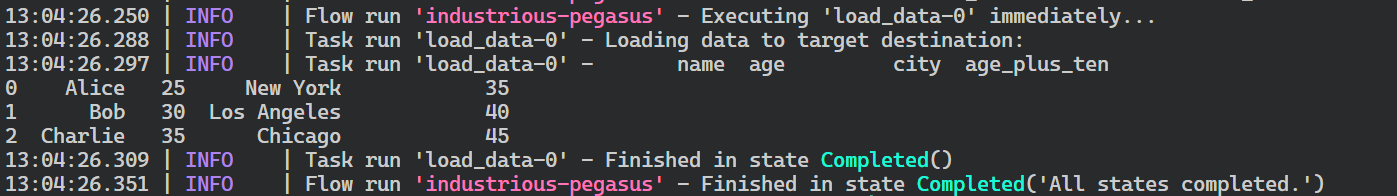
Pour exécuter le workflow, lancez simplement le script Python avec la commande suivante.
$ python prefect_etl.py Comme vous le voyez, l’exécution s’est terminée avec succès.
Logs d’exécution du flow Prefect.
Nous allons maintenant déployer notre workflow pour l’exécuter selon un planning ou le déclencher sur événement. Le déploiement permet aussi de superviser et gérer plusieurs workflows de façon centralisée.
Pour déployer le flow, utilisons la CLI Prefect. La commande deploy nécessite le nom du fichier Python, le nom de la fonction de flow, et le nom du déploiement. Ici, nous appelons ce déploiement « simple_etl ».
$ prefect deploy prefect_etl.py:etl -n 'simple_etl'Après exécution, il se peut que vous receviez un message indiquant qu’aucun worker pool n’est disponible pour ce déploiement. Pour en créer un, utilisez la commande suivante.
$ prefect worker start --pool 'datacamp'Maintenant que le worker pool est démarré, ouvrez un autre terminal et lancez le déploiement. La commande prefect deployment run attend l’argument « <nom-du-flow>/<nom-du-déploiement> », comme ci-dessous.
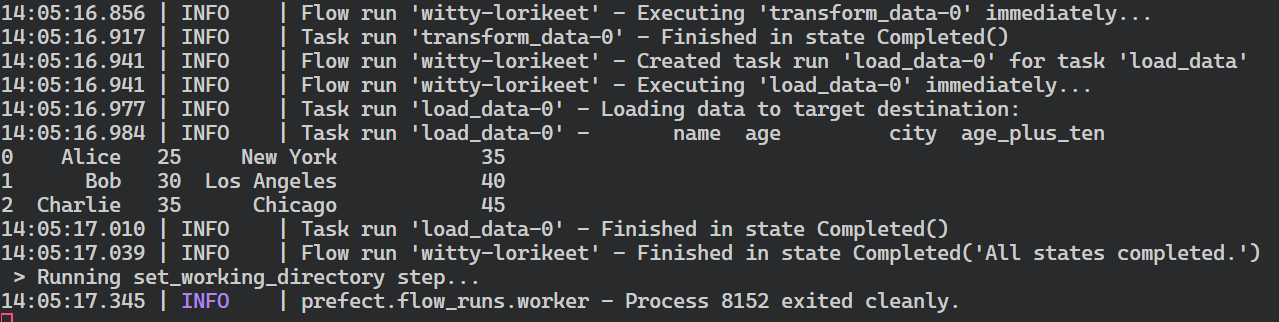
$ prefect deployment run 'etl/simple_etlÀ l’exécution, vous verrez un message indiquant que le workflow tourne. En général, le flow run reçoit un nom aléatoire, dans mon cas witty-lorikeet.
Creating flow run for deployment 'etl/simple_etl'...
Created flow run 'witty-lorikeet'.
└── UUID: 4e0495b0-9c7e-4ed8-b9ab-5160994dc7f0
└── Parameters: {}
└── Job Variables: {}
└── Scheduled start time: 2024-06-22 14:05:01 PKT (now)
└── URL: <no dashboard available>
Pour consulter l’intégralité des logs, revenez au terminal où vous avez démarré le worker pool.
Résumé d’exécution du flow Prefect.
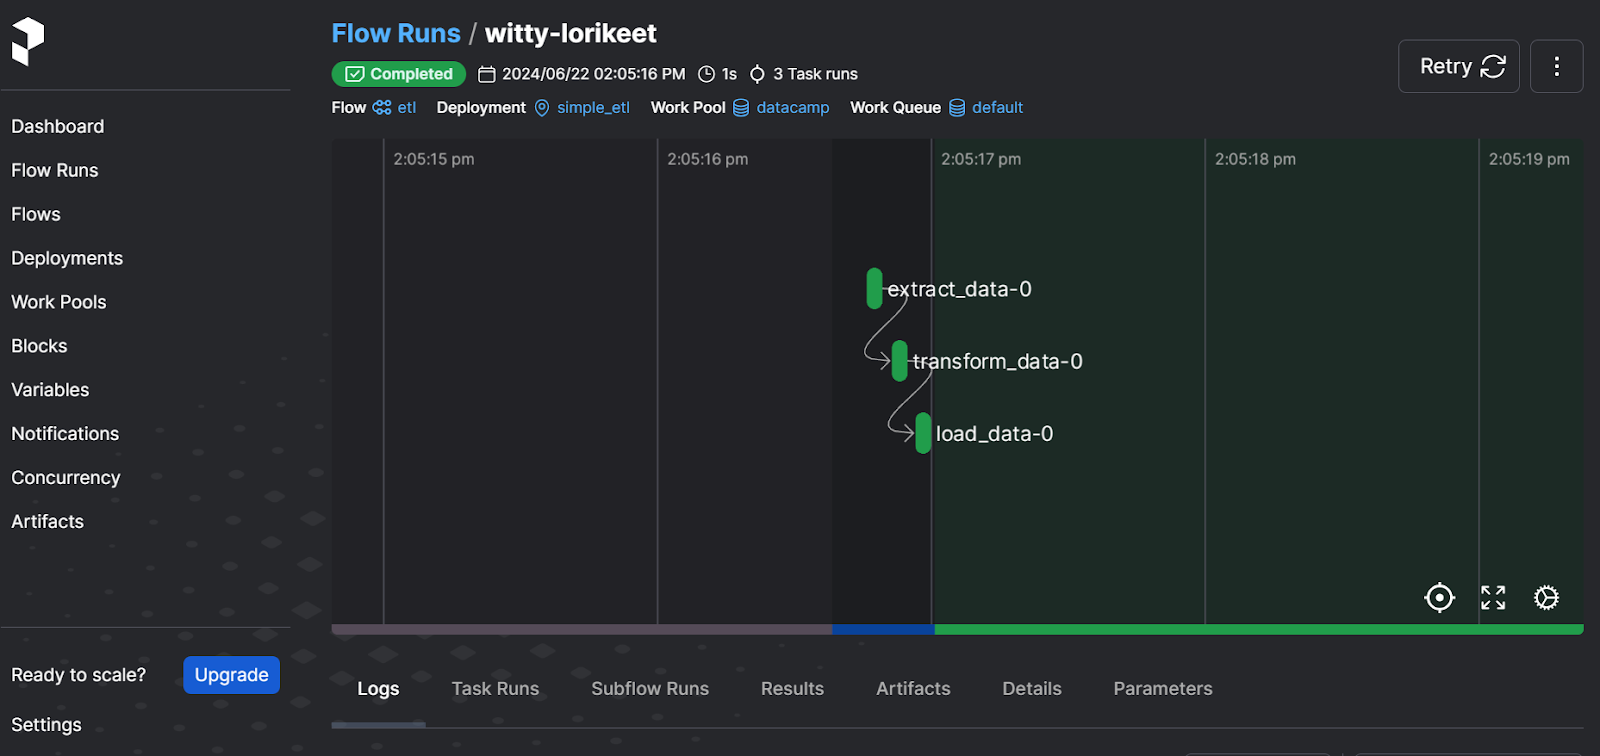
Pour visualiser l’exécution de manière plus conviviale et gérer d’autres workflows, vous devez démarrer le serveur web Prefect.
$ prefect server start Après avoir exécuté la commande, vous devriez être redirigé vers le tableau de bord Prefect. Sinon, accédez directement à l’adresse http://127.0.0.1:4200 dans votre navigateur.
Interface du serveur web Prefect
Le tableau de bord permet de relancer un workflow, d’afficher les logs, de vérifier les work pools, de configurer des notifications et d’accéder à d’autres options avancées. Une solution complète pour vos besoins modernes d’orchestration des données.
Pour apprendre à construire et exécuter des pipelines de machine learning avec Prefect, suivez le tutoriel Using Prefect for Machine Learning Workflows.
Dagster est un framework open source permettant aux ingénieurs data de définir, planifier et superviser des pipelines de données. Il est hautement scalable et favorise la collaboration entre équipes data.
Dagster permet de définir des « assets » de données sous forme de fonctions Python via des décorateurs. Une fois définis, ces assets peuvent être exécutés via un planning ou des déclencheurs événementiels.
Comparé à Airflow, Dagster facilite le développement, le test et la revue locale des pipelines, propose une approche d’orchestration centrée sur les assets, et est natif cloud et conteneurs.
Plutôt que de penser en étapes et en flows, j’ai dû changer d’approche et construire un pipeline à partir d’assets de données. Mis à part cela, créer et exécuter un ETL simple est resté très accessible. L’interface web est minimaliste, mais fournit toutes les infos pour suivre les assets, les runs et les déploiements.
Abid Ali Awan, Author
Nous allons créer un pipeline ETL simple, l’exécuter et le visualiser via le serveur web Dagster. À l’instar du tableau de bord Prefect, le serveur web Dagster centralise la supervision de multiples workflows et la planification des runs et des assets.
Commençons par installer le package Python.
$ pip install dagster -qPuis nous créerons trois fonctions Python pour l’extraction, la transformation et le chargement des données. Elles s’appellent create_dirty_data(), clean_data() et load_cleaned_data() dans le code. Avec le décorateur @asset, nous les déclarerons comme assets de données dans Dagster.
Ensuite, nous créerons le job d’assets (variable job) à partir de tous les assets (variable all_assets), puis la définition des assets (variable defs).
Vous pouvez ignorer la partie définition des assets, mais elle devient essentielle si vous souhaitez planifier des runs, exécuter plusieurs jobs et configurer des capteurs.
import pandas as pd
import numpy as np
from dagster import asset, Definitions, define_asset_job, materialize

@asset
def create_dirty_data():
    # Create a sample DataFrame with dirty data
    data = {
        'Name': [' John Doe ', 'Jane Smith', 'Bob Johnson ', '  Alice Brown'],
        'Age': [30, np.nan, 40, 35],
        'City': ['New York', 'los angeles', 'CHICAGO', 'Houston'],
        'Salary': ['50,000', '60000', '75,000', 'invalid']
    }
    df = pd.DataFrame(data)

    # Save the DataFrame to a CSV file
    dirty_file_path = 'dag_data/dirty_data.csv'
    df.to_csv(dirty_file_path, index=False)

    return dirty_file_path

@asset
def clean_data(create_dirty_data):
    # Read the dirty CSV file
    df = pd.read_csv(create_dirty_data)

    # Clean the data
    df['Name'] = df['Name'].str.strip()
    df['Age'] = pd.to_numeric(df['Age'], errors='coerce').fillna(df['Age'].mean())
    df['City'] = df['City'].str.upper()
    df['Salary'] = df['Salary'].replace('[\$,]', '', regex=True)
    df['Salary'] = pd.to_numeric(df['Salary'], errors='coerce').fillna(0)

    # Calculate average salary
    avg_salary = df['Salary'].mean()

    # Save the cleaned DataFrame to a new CSV file
    cleaned_file_path = 'dag_data/cleaned_data.csv'
    df.to_csv(cleaned_file_path, index=False)

    return {
        'cleaned_file_path': cleaned_file_path,
        'avg_salary': avg_salary
    }

@asset
def load_cleaned_data(clean_data):
    cleaned_file_path = clean_data['cleaned_file_path']
    avg_salary = clean_data['avg_salary']

    # Read the cleaned CSV file to verify
    df = pd.read_csv(cleaned_file_path)

    print({
        'num_rows': len(df),
        'num_columns': len(df.columns),
        'avg_salary': avg_salary
    })

# Define all assets
all_assets = [create_dirty_data, clean_data, load_cleaned_data]

# Create a job that will materialize all assets
job = define_asset_job("all_assets_job", selection=all_assets)

# Create Definitions object
defs = Definitions(
    assets=all_assets,
    jobs=[job]
)

if __name__ == "__main__":
    result = materialize(all_assets)
    print("Pipeline execution result:", result.success)
Vous pouvez exécuter ce code dans un Jupyter Notebook ou créer un fichier Python et l’exécuter.
À l’exécution, vous obtiendrez le log complet du workflow.
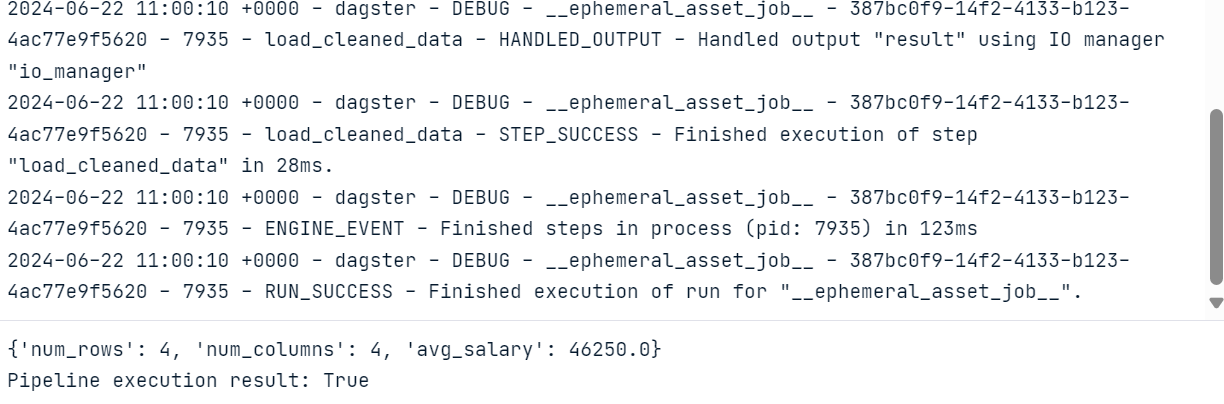
Pour visualiser les assets et les runs, nous devons installer et lancer le serveur web Dagster. Il permet d’exécuter des jobs, de matérialiser des assets individuellement et de suivre plusieurs jobs en parallèle.
$ pip install dagster-webserverPour démarrer le serveur Dagster, utilisons la CLI Dagster en lui indiquant l’emplacement du fichier Python. Ici, j’ai nommé le fichier dagster_pipe.py.
$ dagster dev -f dagster_pipe.py Cette commande lancera automatiquement le serveur web dans votre navigateur. Vous pouvez aussi accéder directement à http://127.0.0.1:3000 dans votre navigateur.
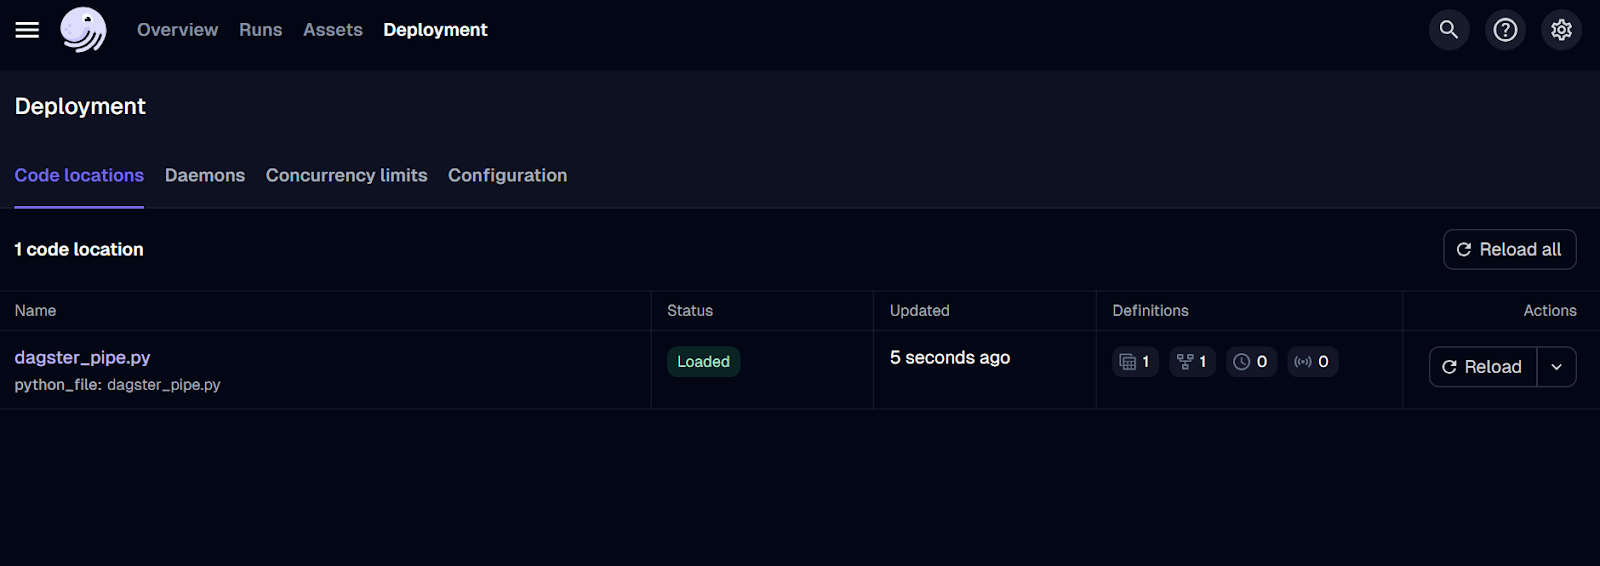
Interface du serveur web Dagster.
À ce stade, seul le job a été déployé. Pour lancer le workflow, rendez-vous dans l’onglet « Runs » et cliquez sur « Launch a new run ».
L’exécution devrait se terminer avec succès ! Pour consulter les logs, cliquez sur l’ID du run qui vous intéresse.
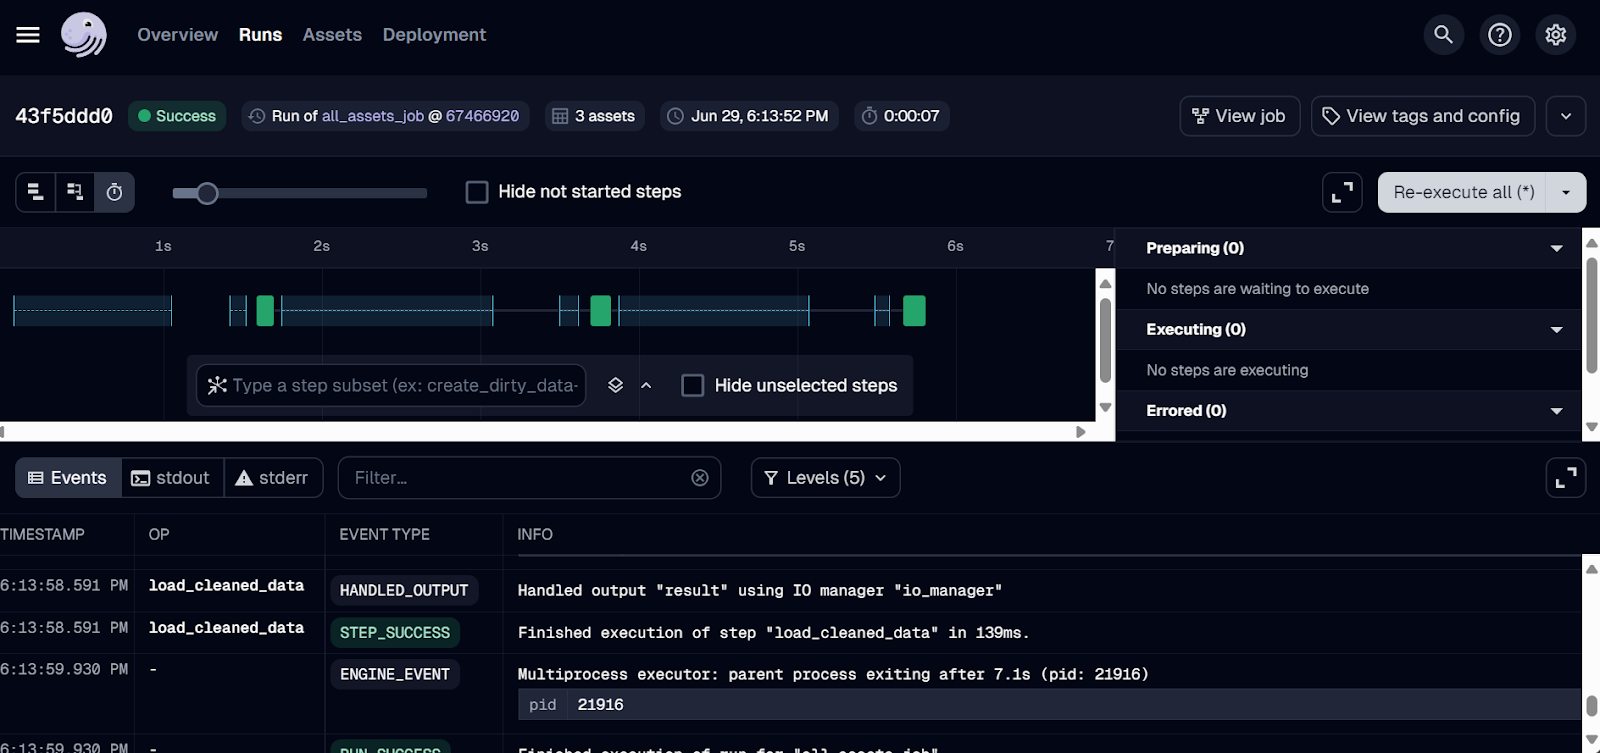
Logs des runs Dagster.
Mage AI est un framework open source d’orchestration de données en mode hybride. Hybride signifie que vous bénéficiez à la fois de la flexibilité d’un Jupyter Notebook et du contrôle d’un code modulaire.
Même avec peu de connaissances en Python, chacun peut construire, exécuter et superviser des pipelines de données. Au lieu d’écrire et d’exécuter un fichier Python directement, vous créez un projet Mage AI et le lancez dans le tableau de bord, où vous construisez, exécutez et gérez vos pipelines.
Comparé à Airflow, Mage AI offre une interface conviviale et une prise en main rapide, ce qui en fait un excellent choix pour les débutants en data engineering. Conçu pour la scalabilité, il gère efficacement de gros volumes de données et des pipelines complexes.
L’expérience m’a paru déroutante car très différente de mes habitudes. Il faut installer et lancer l’UI web de Mage AI. En théorie c’est simple, mais j’ai trouvé plus difficile de construire et d’exécuter le pipeline ETL. À l’inverse, je comprends pourquoi ce design peut séduire les débutants : c’est essentiellement du glisser-déposer et des boutons à cliquer.
Abid Ali Awan, Author
Démarrer avec Mage AI est très simple. Il suffit d’installer le package Python.
$ pip install mage-aiPuis de lancer le projet Mage AI.
$ mage start mage_ai_etl La commande ci-dessus démarre le serveur web. Comme indiqué, tout l’édition du code, l’exécution et le suivi des jobs se font via l’UI de Mage AI.
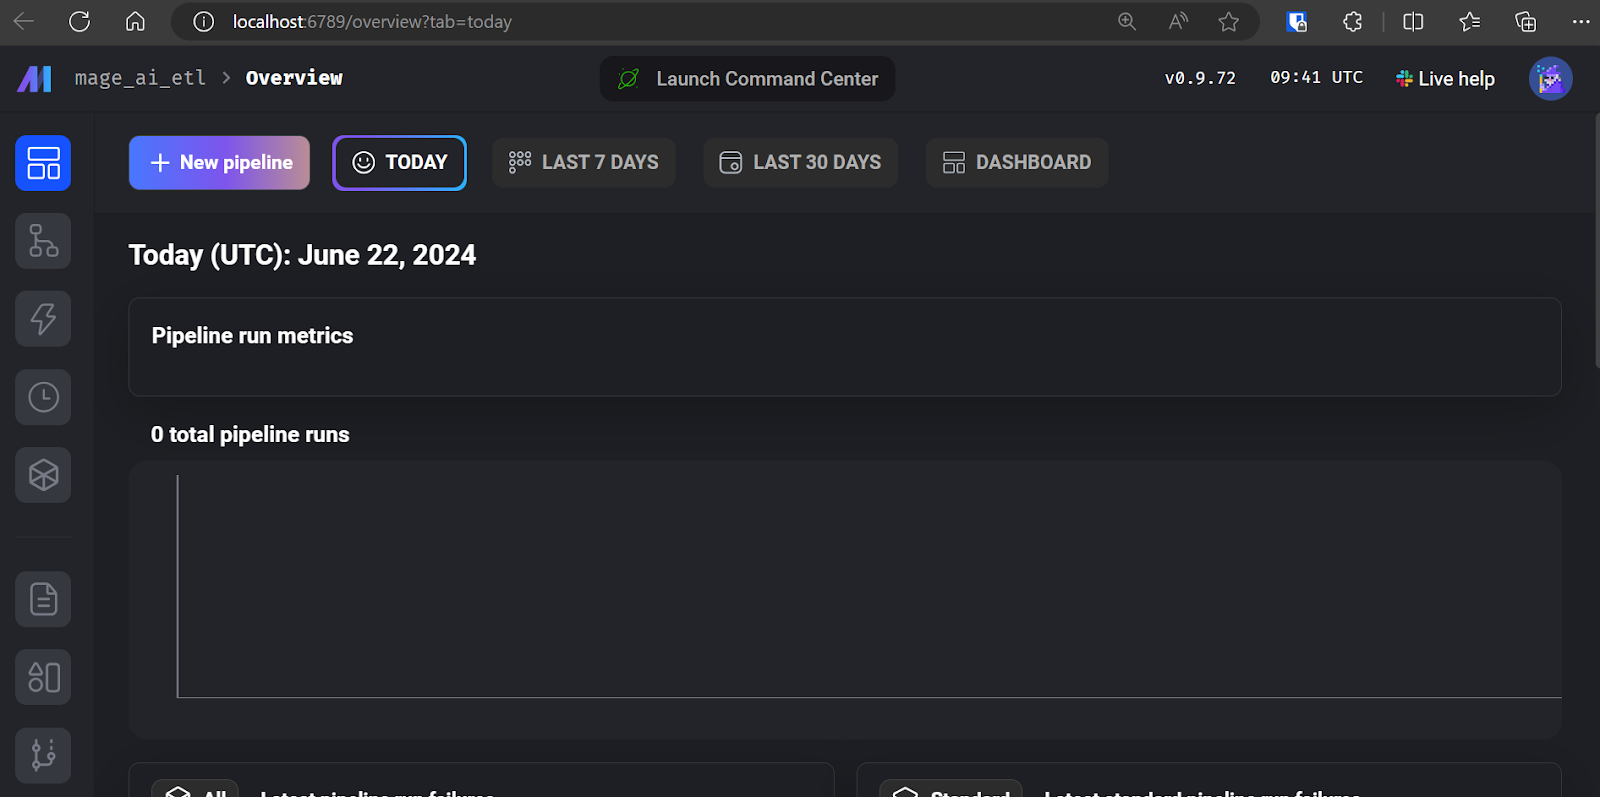
Interface de Mage AI.
Cliquez sur « + New pipeline » pour créer votre premier pipeline ETL. J’ai nommé le mien « simple_etl ».
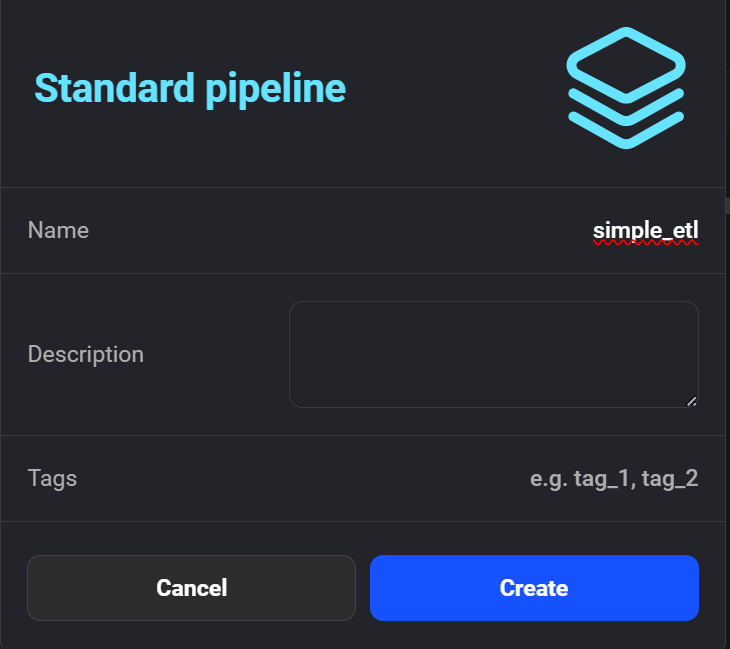
Création d’un nouveau pipeline dans Mage AI.
L’interface vous demande ensuite d’ajouter un module pour commencer à coder. Sélectionnez le module « Data Loader » et ajoutez le code Python suivant.
Ici, nous déclarons une fonction create_sample_csv(), première étape du pipeline, avec le décorateur @data_loader de Mage AI. Nous définissons aussi test_output() pour vérifier l’existence de la sortie, ce qui aide à gérer les dépendances.
import io
import pandas as pd

if 'data_loader' not in globals():
    from mage_ai.data_preparation.decorators import data_loader
if 'test' not in globals():
    from mage_ai.data_preparation.decorators import test

@data_loader
def create_sample_csv() -> pd.DataFrame:
    """
    Create a sample CSV file with duplicates and missing values
    """
    csv_data = """
category,product,quantity,price
Electronics,Laptop,5,1000
Electronics,Smartphone,10,500
Clothing,T-shirt,50,20
Clothing,Jeans,30,50
Books,Novel,100,15
Books,Textbook,20,80
Electronics,Laptop,5,1000
Clothing,T-shirt,,20
Electronics,Tablet,,300
Books,Magazine,25,
"""
    return pd.read_csv(io.StringIO(csv_data.strip()))

@test
def test_output(df) -> None:
    """
    Template code for testing the output of the block.
    """
    assert df is not None, 'The output is undefined'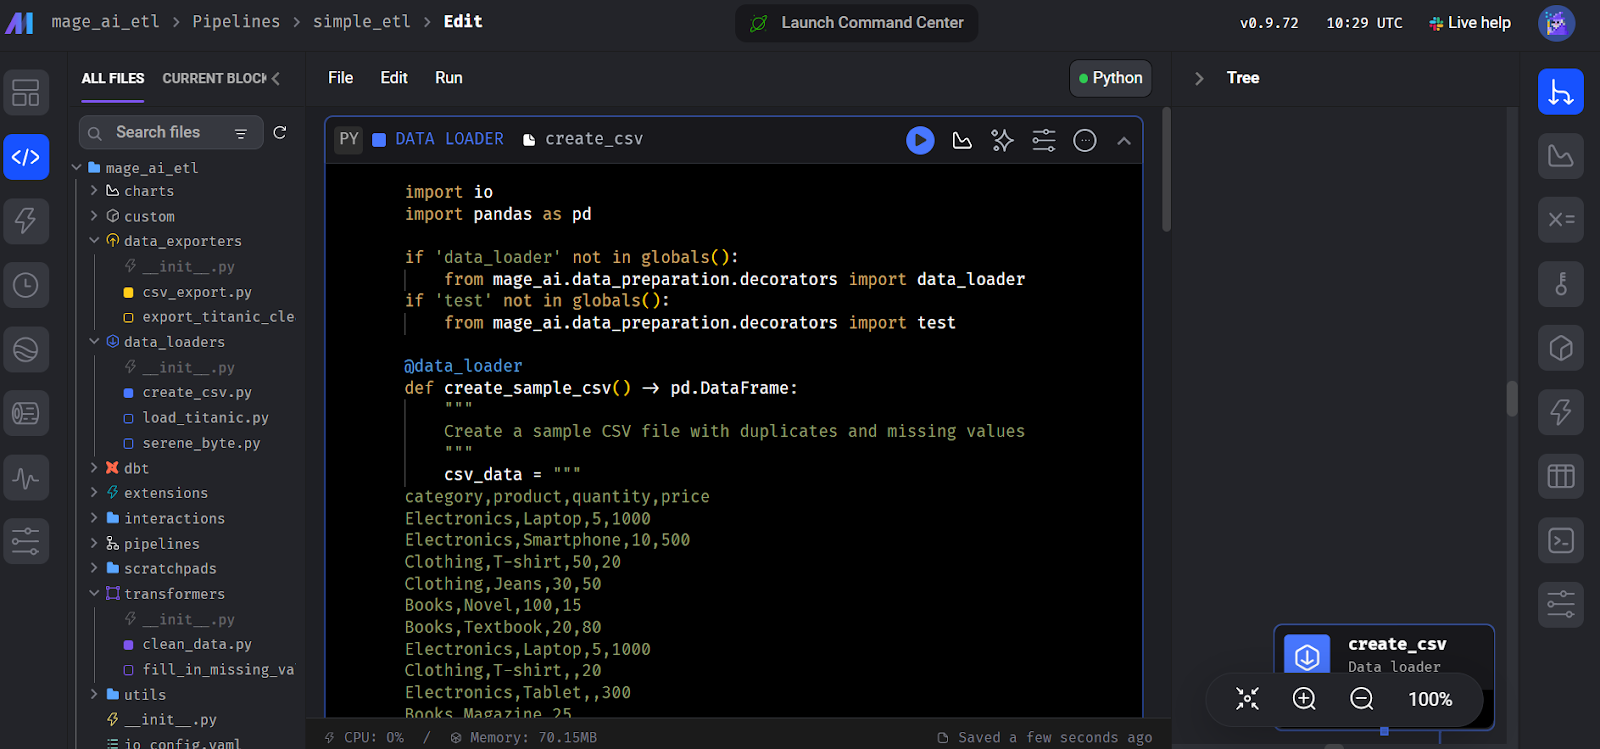
Création du bloc Data Loader dans Mage AI.
Créez ensuite un module « Transformer » et ajoutez la fonction clean_data() comme ci-dessous.
Vous pouvez ignorer la fonction test() ; l’essentiel est la fonction principale, clean_data().
import pandas as pd

if 'transformer' not in globals():
    from mage_ai.data_preparation.decorators import transformer
if 'test' not in globals():
    from mage_ai.data_preparation.decorators import test

@transformer
def clean_data(df: pd.DataFrame) -> pd.DataFrame:
    """
    Clean and transform the data
    """
    # Remove duplicates
    df = df.drop_duplicates()
    # Fill missing values with 0
    df = df.fillna(0)
    return df

@test
def test_output(df) -> None:
    """
    Template code for testing the output of the block.
    """
    assert df is not None, 'The output is undefined'
De la même manière, créez un module « Data Exporter » et ajoutez le code suivant. Il déclare une fonction de chargement, export_data_to_csv(), qui enregistre les données transformées en CSV.
import pandas as pd

if 'data_exporter' not in globals():
    from mage_ai.data_preparation.decorators import data_exporter

@data_exporter
def export_data_to_csv(df: pd.DataFrame) -> None:
    """
    Export the processed data to a CSV file
    """
    df.to_csv('output_data.csv', index=False)
    print("Data exported successfully to output_data.csv")
Pour exécuter le pipeline, rendez-vous dans l’onglet « Trigger » et cliquez sur « Run@once ».
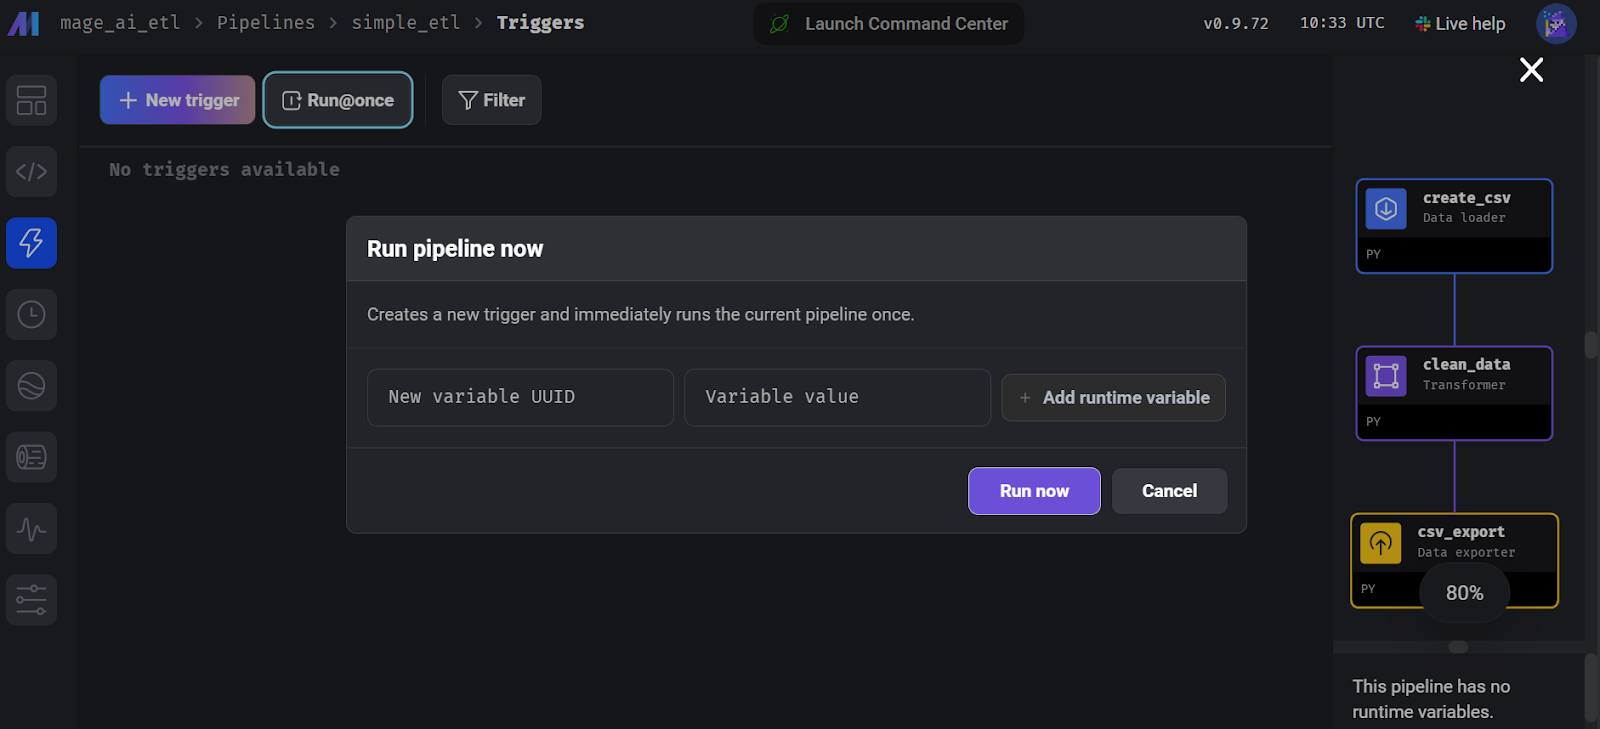
Exécution du pipeline dans Mage AI.
Pour consulter les logs d’exécution, allez dans l’onglet « Runs » et cliquez sur « Logs » du pipeline récemment exécuté.
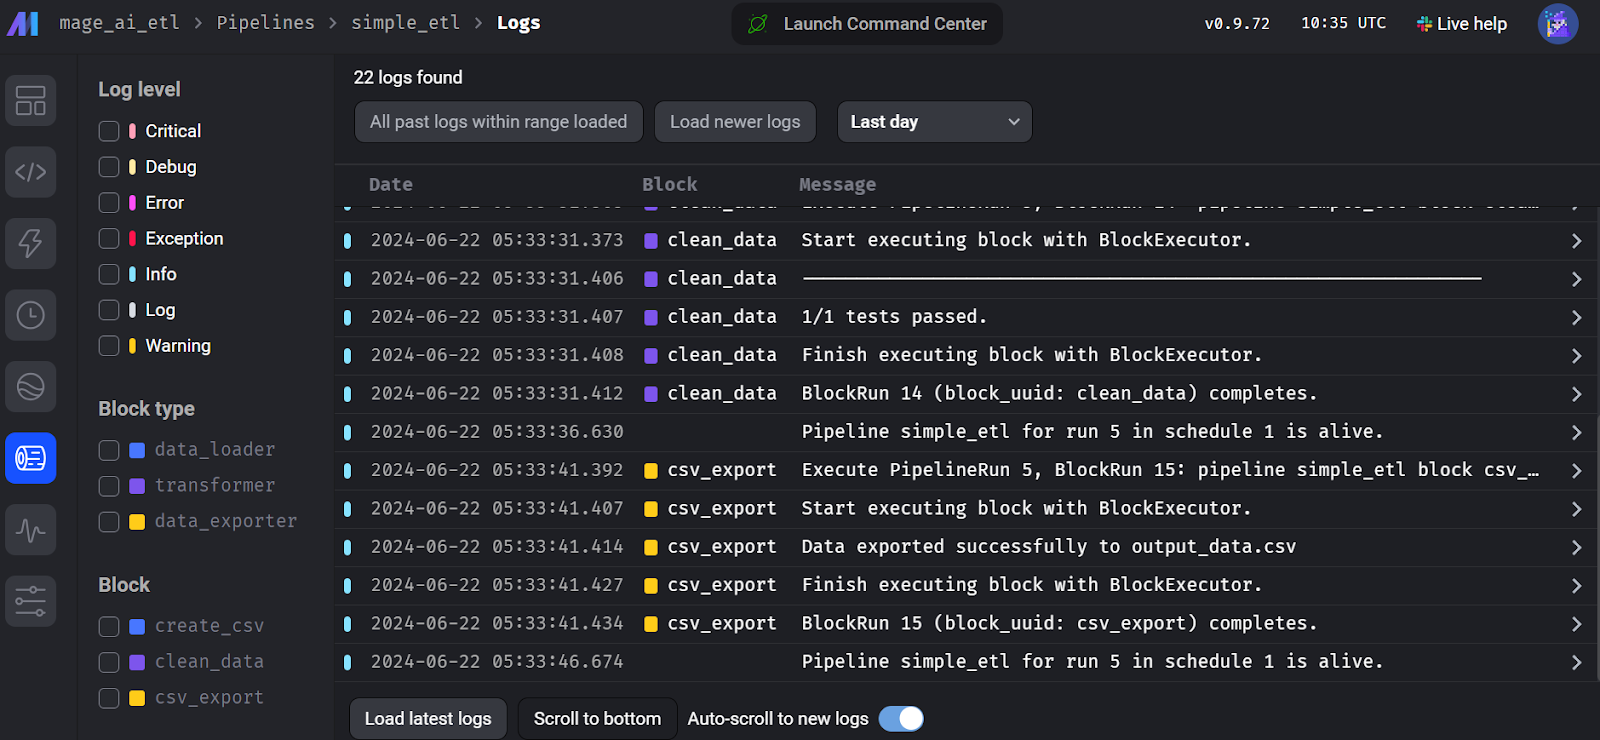
Logs d’exécution du flow Mage AI.
Kedro est un autre framework open source d’orchestration de données, un peu différent des autres outils. Créé pour les ingénieurs en machine learning, il reprend de nombreux concepts d’ingénierie logicielle et les applique aux projets ML.
Kedro est hautement modulaire : même pour exporter un jeu de données, vous devez créer un catalog de données qui précise l’emplacement et le type de données, garantissant une gestion normalisée et efficace tout au long du pipeline.
Pour comprendre la place de Kedro dans l’écosystème du machine learning, explorez différents outils MLOps dans l’article 25 Top MLOps Tools You Need to Know in 2024.
Comparé à Airflow, l’API Kedro est plus simple pour construire un pipeline de données. Il met l’accent sur l’ingénierie ML et propose catégorisation et versionnement des données.
La partie code est assez directe, mais des difficultés apparaissent au moment d’exécuter le pipeline. Il faut créer un catalog de données, enregistrer le pipeline et comprendre la structure d’un projet Kedro. C’est plus exigeant que Dagster et Prefect. Je comprends toutefois ce choix : garantir des pipelines fiables et robustes.
Abid Ali Awan, Author
Construire un pipeline de données Kedro demande une approche différente. Le framework est modulaire : il faut comprendre la structure projet et les étapes pour exécuter le workflow correctement.
Commencez par installer le package Python Kedro.
$ pip install kedroInitialisez le projet Kedro.
$ kedro new --name=kedro_etl --tools=none --example=n Placez-vous dans le répertoire du projet.
$ cd kedro-etl Créez un dossier dans pipelines nommé data_processing.
$ mkdir -p src/kedro_etl/pipelines/data_processing Créez un fichier Python nommé kedro_pipe.py et ouvrez-le dans votre IDE préféré, par exemple Visual Studio Code.
$ code src/kedro_etl/pipelines/data_processing/kedro_pipe.pyLe script doit contenir les fonctions d’extraction, de transformation et de chargement, qui sont les nœuds du pipeline : create_sample_data(), clean_data(), et load_and_process_data().
Nous relions ensuite ces nœuds via la classe Pipeline de Kedro dans la fonction create_pipeline(). Chaque nœud y définit ses inputs, outputs et un name.
import pandas as pd
import numpy as np
from kedro.pipeline import Pipeline, node

def create_sample_data():
    data = {
        'id': range(1, 101),
        'name': [f'Person_{i}' for i in range(1, 101)],
        'age': np.random.randint(18, 80, 100),
        'salary': np.random.randint(20000, 100000, 100),
        'missing_values': [np.nan if i % 10 == 0 else i for i in range(100)]
    }
    return pd.DataFrame(data)

def clean_data(df: pd.DataFrame):
    # Remove rows with missing values
    df_cleaned = df.dropna()

    # Convert salary to thousands
    df_cleaned['salary'] = df_cleaned['salary'] / 1000

    # Capitalize names
    df_cleaned['name'] = df_cleaned['name'].str.upper()

    return df_cleaned

def load_and_process_data(df: pd.DataFrame):
    # Calculate average salary
    avg_salary = df['salary'].mean()

    # Add a new column for salary category
    df['salary_category'] = df['salary'].apply(
        lambda x: 'High' if x > avg_salary else 'Low')

    # Calculate age groups
    df['age_group'] = pd.cut(df['age'], bins=[0, 30, 50, 100], labels=[
                             'Young', 'Middle', 'Senior'])

    print(df)
    return df

def create_pipeline(**kwargs):
    return Pipeline(
        [
            node(
                func=create_sample_data,
                inputs=None,
                outputs="raw_data",
                name="create_sample_data_node",
            ),
            node(
                func=clean_data,
                inputs="raw_data",
                outputs="cleaned_data",
                name="clean_data_node",
            ),
            node(
                func=load_and_process_data,
                inputs="cleaned_data",
                outputs="processed_data",
                name="load_and_process_data_node",
            ),
        ]
    )
Si vous exécutez le pipeline sans créer le catalog de données, rien ne sera exporté. Rendez-vous donc dans le fichier conf/base/catalog.yml et renseignez la configuration des jeux de données.
raw_data:
  type: pandas.CSVDataset
  filepath: ./data/kedro/sample_data.csv

cleaned_data:
  type: pandas.CSVDataset
  filepath: ./data/kedro/cleaned_data.csv

processed_data:
  type: pandas.CSVDataset
  filepath: ./data/kedro/processed_data.csv
Il faut aussi référencer notre nouveau fichier Python dans le registre des pipelines. Pour cela, ouvrez src/simple_etl/pipeline_registry.py et ajoutez le code suivant.
"""Project pipelines."""
from __future__ import annotations

from kedro.pipeline import Pipeline
from kedro_etl.pipelines.data_processing import kedro_pipe

def register_pipelines() -> Dict[str, Pipeline]:
    data_processing_pipeline = kedro_pipe.create_pipeline()

    return {
        "__default__": data_processing_pipeline,
        "data_processing": data_processing_pipeline,
    }
Exécutez le pipeline et suivez les logs en direct dans le terminal avec la commande suivante.
$ kedro run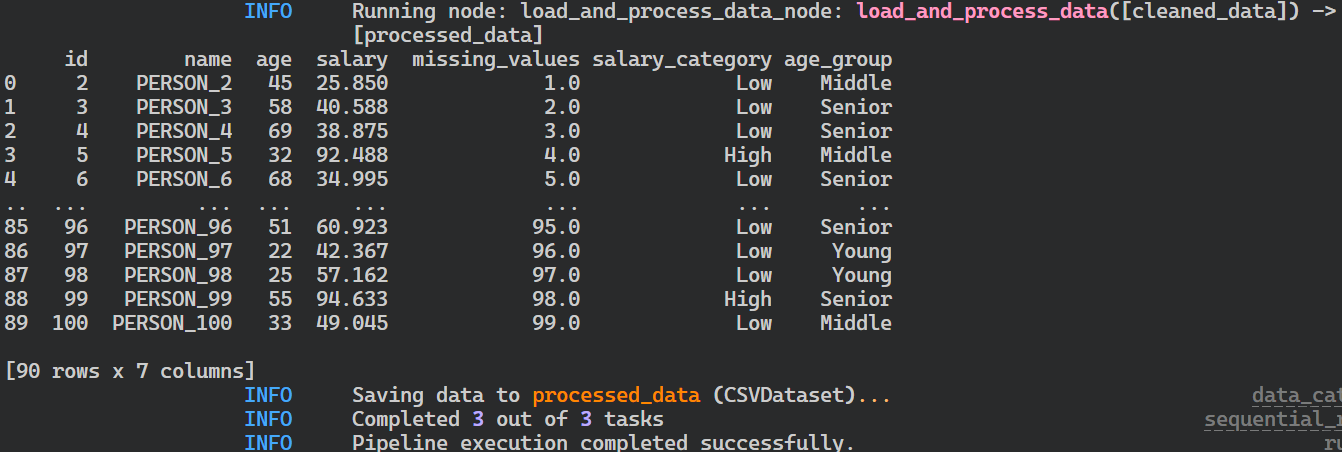
Logs d’exécution du pipeline Kedro.
Après exécution, vos fichiers seront stockés en format CSV à l’emplacement défini dans le catalog.
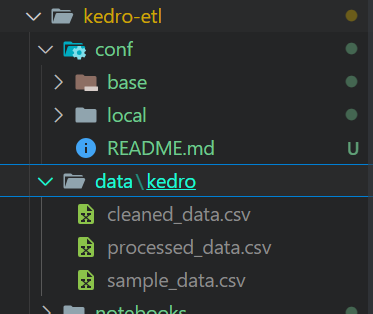
Fichiers de sortie du pipeline Kedro.
Si vous rencontrez des problèmes, envisagez d’installer Kedro avec toutes les extensions.
$ pip install "kedro[all]"Vous pouvez visualiser et partager vos pipelines en installant l’outil kedro-viz.
$ pip install kedro-vizEnsuite, exécutez la commande suivante pour visualiser tous les pipelines et nœuds. Elle propose aussi le suivi des expériences et le partage de la visualisation.
$ kedro viz run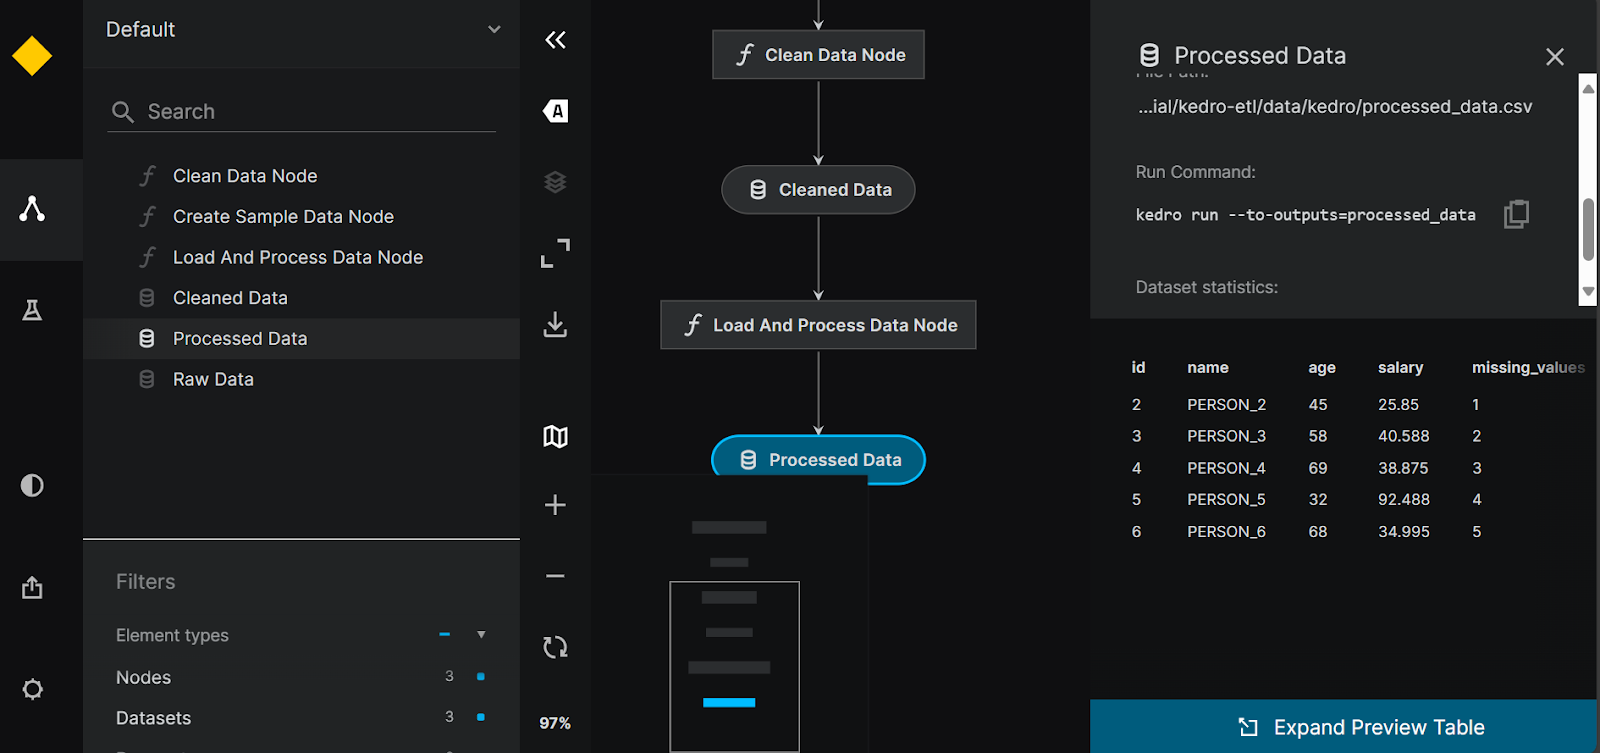
Visualisation du pipeline Kedro.
Luigi est un framework open source en Python, développé par Spotify, qui excelle dans la gestion de traitements batch longue durée et de pipelines complexes. Il brille par la résolution des dépendances, la gestion de workflows, la visualisation et la reprise sur incident, ce qui en fait un outil solide pour orchestrer des workflows de données.
Comparé à Airflow, Luigi propose une API minimale, une planification calendaire et une communauté fidèle prête à aider sur les problématiques d’orchestration.
Si vous débutez en Python, construire et exécuter des pipelines peut sembler ardu. La documentation et les guides aident toutefois à démarrer vite. Les logs sont peu verbeux, et le tableau de bord sert surtout à visualiser les DAGs et dépendances.
Abid Ali Awan, Author
Créer un pipeline Luigi suppose de comprendre la programmation orientée objet. Commençons par installer le package Luigi.
$ pip install luigiPour développer un simple pipeline ETL avec Luigi, nous allons créer des tâches interconnectées. Au lieu de fonctions Python, chaque étape est une classe : FetchData, ProcessData et GenerateReport. Chaque classe implémente trois fonctions : requires(), output() et run().
Les méthodes requires() et output() enchaînent les tâches, tandis que run() exécute le traitement. Enfin, nous construisons le pipeline à partir de la dernière tâche.
import luigi
import pandas as pd
import numpy as np

class FetchData(luigi.Task):
    def output(self):
        return luigi.LocalTarget('data/fetch_data.csv')

    def run(self):
        # Simulate fetching data by creating a sample CSV file
        data = {
            'column1': [1, 2, np.nan, 4],
            'column2': ['A', 'B', 'C', np.nan]
        }
        df = pd.DataFrame(data)
        df.to_csv(self.output().path, index=False)

class ProcessData(luigi.Task):
    def requires(self):
        return FetchData()

    def output(self):
        return luigi.LocalTarget('data/process_data.csv')

    def run(self):
        df = pd.read_csv(self.input().path)
        # Fill missing values
        df['column1'].fillna(df['column1'].mean(), inplace=True)
        df['column2'].fillna('B', inplace=True)
        df.to_csv(self.output().path, index=False)

class GenerateReport(luigi.Task):
    def requires(self):
        return ProcessData()

    def output(self):
        return luigi.LocalTarget('data/generate_report.txt')

    def run(self):
        df = pd.read_csv(self.input().path)
        # Simple data analysis: calculate mean of column1 and value counts of column2
        mean_column1 = df['column1'].mean()
        value_counts_column2 = df['column2'].value_counts()

        with self.output().open('w') as out_file:
            out_file.write(f'Mean of column1: {mean_column1}\n')
            out_file.write('Value counts of column2:\n')
            out_file.write(value_counts_column2.to_string())

if __name__ == '__main__':
    luigi.build([GenerateReport()], local_scheduler=True)
Exécutez ce code dans un Jupyter Notebook ou créez un fichier Python et lancez-le depuis le terminal.
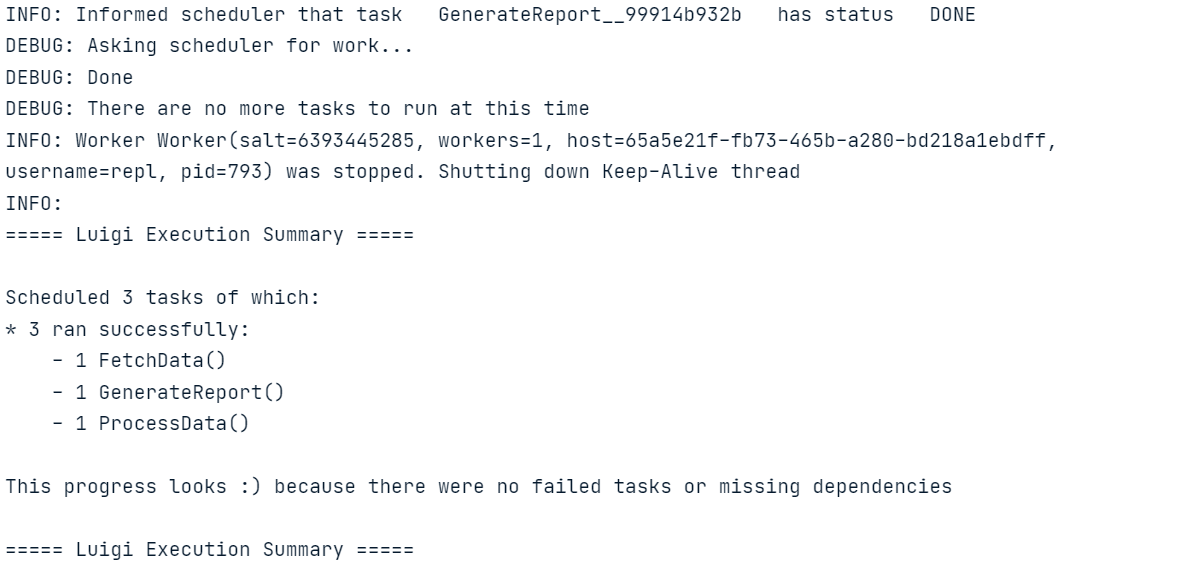
À l’instar de Luigi, vous pouvez aussi apprendre à créer un pipeline ETL avec Apache Airflow. Ce tutoriel couvre les bases de l’extraction, transformation et du chargement avec Airflow.
Nous devons initialiser le planificateur central de Luigi pour programmer les exécutions ou les déclencher sur événement.
Démarrez le scheduler avec la commande suivante.
$ luigid 2024-06-22 13:35:18,636 luigi[25056] INFO: logging configured by default settings
2024-06-22 13:35:18,636 luigi.scheduler[25056] INFO: No prior state file exists at /var/lib/luigi-server/state.pickle. Starting with empty state
2024-06-22 13:35:18,640 luigi.server[25056] INFO: Scheduler starting upPour exécuter le pipeline, ouvrez un nouveau terminal et tapez la commande suivante. La commande Luigi nécessite le nom du fichier Python et la dernière tâche à exécuter. Ici, le fichier s’appelle luigi_pipe.py et la dernière tâche est GenerateReport.
$ python -m luigi --module luigi_pipe GenerateReportPour visualiser le run et l’état des tâches, allez simplement sur http://localhost:8082 dans votre navigateur.
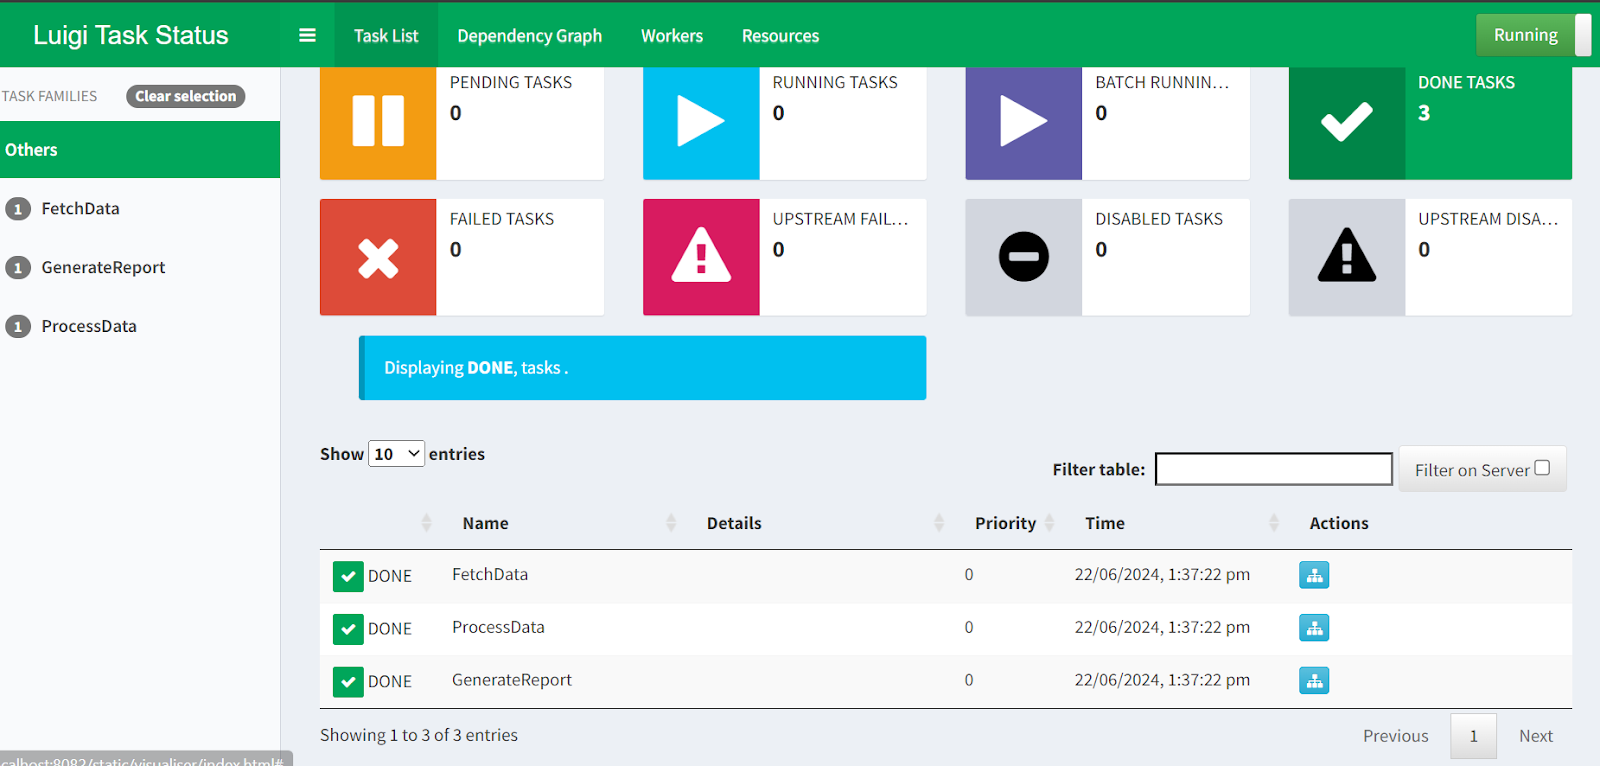
Interface web du planificateur central Luigi.
Voilà pour notre tour d’horizon des 5 meilleures alternatives à Airflow ! Pour aller plus loin sur les exemples de cet article, consultez ces ressources :
Dans ce tutoriel, nous avons parcouru les meilleures alternatives open source et gratuites à Airflow. Nous avons présenté chaque outil d’orchestration, puis construit et exécuté un simple pipeline ETL. Ces exemples de code vous aideront à choisir l’outil le plus adapté à votre cas d’usage.
Si vous débutez, je vous conseille de commencer par Prefect ou Mage AI, conviviaux et simples à mettre en place. Pour des besoins plus avancés, alignés avec les pratiques d’ingénierie logicielle, explorez Dagster, Kedro et Luigi.
Après cette lecture, l’étape suivante naturelle dans votre parcours d’ingénierie des données est de viser une certification comme le parcours DataCamp Data Engineer in Python pour découvrir d’autres outils et construire un pipeline de bout en bout prêt pour la production.
Approfondissez l’ingénierie des données avec ces cours !
Cours
Cursus
Cours
blog
Kurtis Pykes
15 min
blog
Nisha Arya Ahmed
15 min
Tutoriel
Kurtis Pykes
15 min
Tutoriel
DataCamp Team
3 min
Tutoriel
Moez Ali
6 min
Tutoriel


