Courses
Data Engineering 入门
4小时
129.7K
图片来源:作者。
Apache Airflow 是一款广受欢迎的开源数据编排工具,旨在构建、调度和监控数据流水线。它提供的仪表板有助于管理工作流状态,是大多数工作流需求的理想选择。
不过,Airflow 也缺少一些对复杂、现代数据编排需求至关重要的功能。
本教程将介绍五个 Airflow 的替代方案,这些工具提供更强大的能力并弥补其部分局限。此外,我们还将使用每个工具构建一个简单的 ETL 流水线,运行它,并在各自的仪表板中进行可视化。
Airflow 能胜任多种数据工作流,但也存在一些限制,可能会促使企业考虑其他选择。
以下是您可能选择替代方案的原因:
在探索其他数据编排工具的编码部分之前,建议先按照Apache Airflow 入门教程学习如何使用 Airflow 编写数据流水线,以便公平比较替代方案。
如果您完全是 Airflow 新手,可考虑学习短课程 Python 中的 Airflow 入门,掌握构建与调度数据流水线的基础知识。
接下来,我们将介绍排名前五的 Airflow 替代方案,并通过实用代码示例展示其用法。
Prefect 是一款面向现代数据与机器学习工程师的开源 Python 工作流编排工具。它提供简洁的 API,便于快速构建数据流水线,并通过交互式仪表板进行管理。
Prefect 提供混合执行模型,意味着您既可以将工作流部署到云端并在其上运行,也可使用本地仓库。
与 Airflow 相比,Prefect 带来了更高级的功能,如自动化任务依赖、基于事件的触发器、内置通知、工作流专属基础设施以及跨任务数据共享。这些能力使其能高效、有效地管理复杂工作流。
Prefect 简单易用且功能强大。我基本上用 5 分钟就跑通了示例代码。我尤其喜欢其仪表板 UI 的设计、通知设置、重跑流水线、以及通过 Dashboard 管理和监控一切的方式。
Abid Ali Awan, Author
阅读 Airflow vs Prefect:如何为您的数据工作流择优一文,了解这两款数据编排工具的详细对比。
先安装 Python 包。在终端运行以下命令。
$ pip install -U prefect随后,新建名为 prefect_etl.py 的 Python 脚本,并写入如下代码。
from prefect import task, flow
import pandas as pd

# Extract data
@task
def extract_data():
    # Simulating data extraction
    data = {
        "name": ["Alice", "Bob", "Charlie"],
        "age": [25, 30, 35],
        "city": ["New York", "Los Angeles", "Chicago"]
    }
    df = pd.DataFrame(data)
    return df

# Transform data
@task
def transform_data(df: pd.DataFrame):
    # Example transformation: adding a new column
    df["age_plus_ten"] = df["age"] + 10
    return df

# Load data
@task
def load_data(df: pd.DataFrame):
    # Simulating data load
    print("Loading data to target destination:")
    print(df)

# Defining the flow
@flow(log_prints=True)
def etl():
    raw_data = extract_data()
    transformed_data = transform_data(raw_data)
    load_data(transformed_data)

# Running the flow
if __name__ == "__main__":
    etl()
以上代码定义了 extract_data()、transform_data() 与 load_data() 三个任务函数,并在名为 etl() 的 flow 函数中串行执行。上述函数通过 Prefect 的 Python 装饰器创建。
简而言之,我们创建一个 pandas DataFrame,进行转换,然后用 print 显示最终结果。这是模拟 ETL 流水线的简便方法。
要执行工作流,只需用以下命令运行该 Python 脚本。
$ python prefect_etl.py 如我们所见,工作流运行已成功完成。
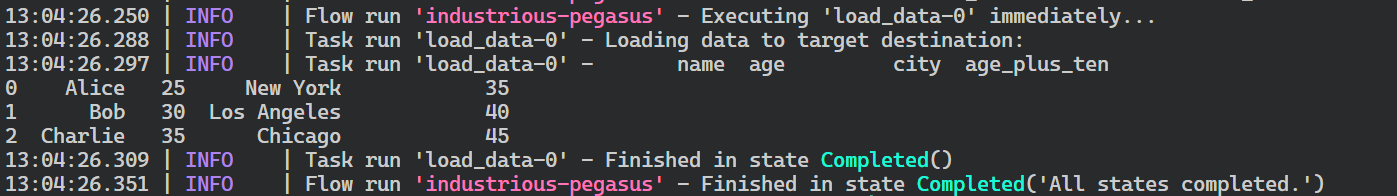
Prefect 流运行日志。
现在我们来部署工作流,以便按计划运行,或基于事件触发。部署后,也便于以集中方式监控和管理多个工作流。
要部署 flow,我们将使用 Prefect CLI。其 deploy 命令需要提供 Python 文件名、其中的 flow 函数名,以及部署名称。本例中,我们将部署命名为 “simple_etl”。
$ prefect deploy prefect_etl.py:etl -n 'simple_etl'在终端运行上述脚本后,可能会提示没有 worker pool 无法运行部署。要创建 worker pool,请使用以下命令。
$ prefect worker start --pool 'datacamp'创建好 worker pool 后,打开另一个终端窗口并运行部署。如下命令所示,prefect deployment run 命令需要以“<flow-function-name>/<deployment-name>”作为参数。
$ prefect deployment run 'etl/simple_etl运行部署后,您将收到工作流正在运行的消息。通常,创建的 flow run 会被分配一个随机名称,我这里是 witty-lorikeet。
Creating flow run for deployment 'etl/simple_etl'...
Created flow run 'witty-lorikeet'.
└── UUID: 4e0495b0-9c7e-4ed8-b9ab-5160994dc7f0
└── Parameters: {}
└── Job Variables: {}
└── Scheduled start time: 2024-06-22 14:05:01 PKT (now)
└── URL: <no dashboard available>
要查看完整日志,请切回启动 worker pool 的终端窗口。
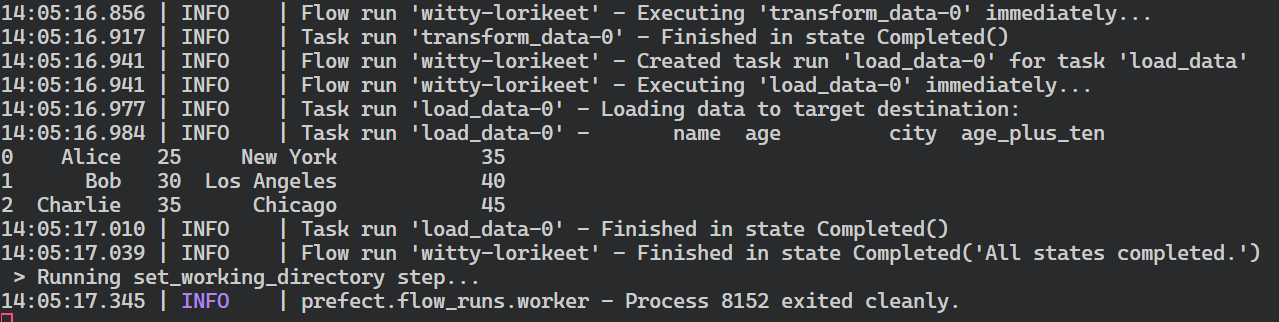
Prefect 流运行摘要。
您需要启动 Prefect Web 服务器,以更友好地可视化 flow 运行并管理其他工作流。
$ prefect server start 执行上述命令后,应该会自动跳转至 Prefect 仪表板。或者,您也可以在浏览器中直接访问http://127.0.0.1:4200。
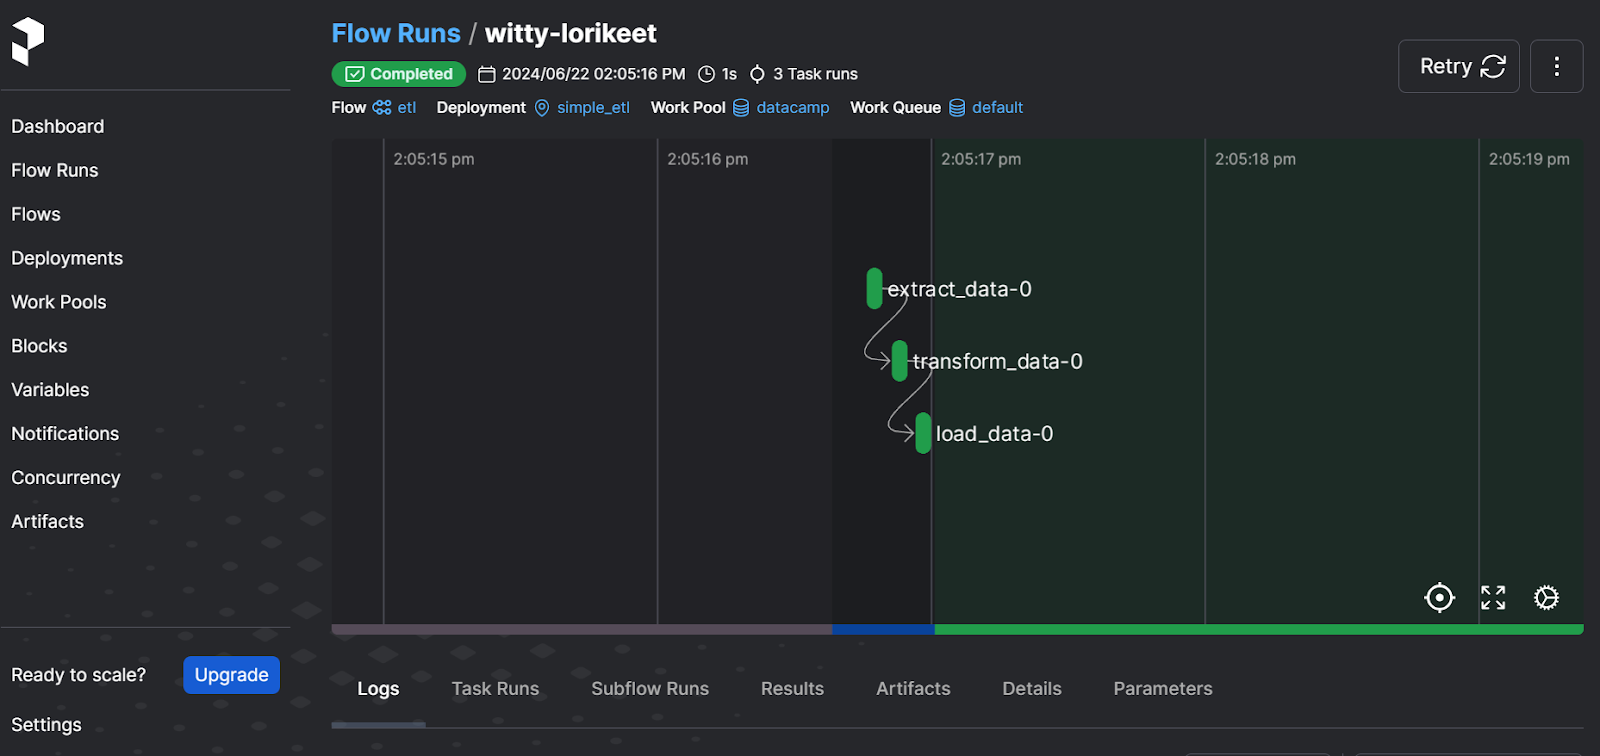
Prefect Web 服务器界面
仪表板允许您重跑工作流、查看日志、检查工作池、设置通知,并选择其他高级选项。它是满足现代数据编排需求的一体化解决方案。
若想了解如何使用 Prefect 构建与执行机器学习流水线,可参考使用 Prefect 进行机器学习工作流编排教程。
Dagster 是一个开源框架,旨在帮助数据工程师定义、调度和监控数据流水线。它具有高度可扩展性,并促进各类数据团队之间的协作。
Dagster 允许用户通过装饰器将数据资产定义为 Python 函数。定义完成后,用户可以通过调度或基于事件的触发无缝执行这些资产。
与 Airflow 相比,Dagster 支持在本地开发、测试与评审流水线,提供基于资产的编排方法,并且原生支持云与容器环境。
不再按步骤和流程来思考工作流,而是转为用数据资产来构建流水线,这点需要转变思路。除此之外,构建并执行一个简单的 ETL 流水线相当容易。Web 服务器相对简洁,但提供了监控资产、运行与部署所需的全部信息。
Abid Ali Awan, Author
我们将创建一个简单的 ETL 流水线,执行它,并通过 Dagster Web 服务器进行可视化。类似 Prefect 的仪表板,Dagster Web 服务器提供集中化方式来监控多个工作流,以及调度运行与资产。
先安装 Python 包。
$ pip install dagster -q然后,我们将创建三个用于抽取、转换和加载数据的 Python 函数。在代码中,这些函数分别命名为 create_dirty_data()、clean_data() 与 load_cleaned_data()。使用 @asset 装饰器,我们会将这些函数声明为 Dagster 中的数据资产。
接着,我们将使用所有资产(变量 all_assets)创建资产作业(变量 job),然后创建资产定义(变量 defs)。
您可以跳过资产定义这一步,但如果需要调度运行、运行多个作业或设置传感器,它就很重要。
import pandas as pd
import numpy as np
from dagster import asset, Definitions, define_asset_job, materialize

@asset
def create_dirty_data():
    # Create a sample DataFrame with dirty data
    data = {
        'Name': [' John Doe ', 'Jane Smith', 'Bob Johnson ', '  Alice Brown'],
        'Age': [30, np.nan, 40, 35],
        'City': ['New York', 'los angeles', 'CHICAGO', 'Houston'],
        'Salary': ['50,000', '60000', '75,000', 'invalid']
    }
    df = pd.DataFrame(data)

    # Save the DataFrame to a CSV file
    dirty_file_path = 'dag_data/dirty_data.csv'
    df.to_csv(dirty_file_path, index=False)

    return dirty_file_path

@asset
def clean_data(create_dirty_data):
    # Read the dirty CSV file
    df = pd.read_csv(create_dirty_data)

    # Clean the data
    df['Name'] = df['Name'].str.strip()
    df['Age'] = pd.to_numeric(df['Age'], errors='coerce').fillna(df['Age'].mean())
    df['City'] = df['City'].str.upper()
    df['Salary'] = df['Salary'].replace('[\$,]', '', regex=True)
    df['Salary'] = pd.to_numeric(df['Salary'], errors='coerce').fillna(0)

    # Calculate average salary
    avg_salary = df['Salary'].mean()

    # Save the cleaned DataFrame to a new CSV file
    cleaned_file_path = 'dag_data/cleaned_data.csv'
    df.to_csv(cleaned_file_path, index=False)

    return {
        'cleaned_file_path': cleaned_file_path,
        'avg_salary': avg_salary
    }

@asset
def load_cleaned_data(clean_data):
    cleaned_file_path = clean_data['cleaned_file_path']
    avg_salary = clean_data['avg_salary']

    # Read the cleaned CSV file to verify
    df = pd.read_csv(cleaned_file_path)

    print({
        'num_rows': len(df),
        'num_columns': len(df.columns),
        'avg_salary': avg_salary
    })

# Define all assets
all_assets = [create_dirty_data, clean_data, load_cleaned_data]

# Create a job that will materialize all assets
job = define_asset_job("all_assets_job", selection=all_assets)

# Create Definitions object
defs = Definitions(
    assets=all_assets,
    jobs=[job]
)

if __name__ == "__main__":
    result = materialize(all_assets)
    print("Pipeline execution result:", result.success)
您可以在 Jupyter Notebook 中运行上述代码,或创建 Python 文件后运行。
执行后,我们将获得工作流运行的完整日志。
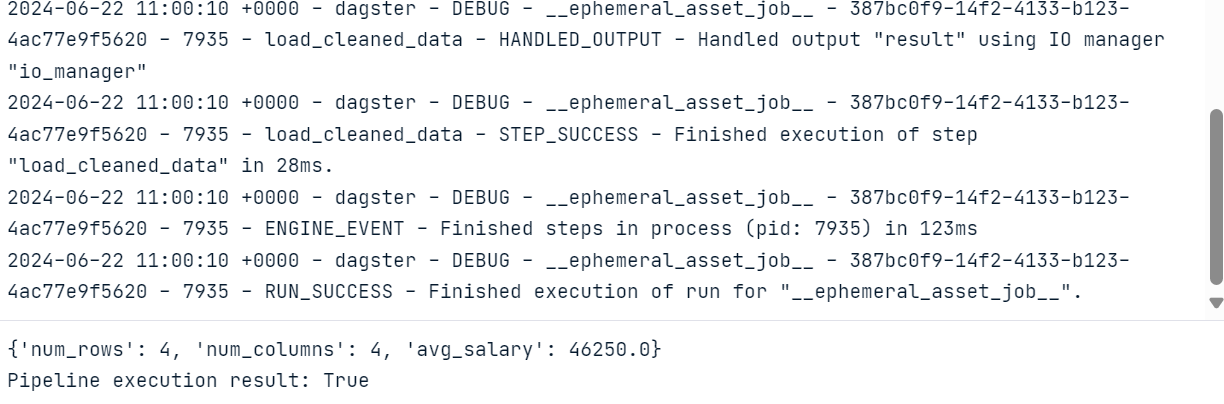
要可视化资产与作业运行情况,我们需要安装并运行 Dagster Web 服务器。该服务器允许您运行作业、物化单个资产,并同时监控多个作业。
$ pip install dagster-webserver要启动 Dagster 服务器,我们将使用 Dagster CLI,并提供 Python 文件位置。本例中文件名为 dagster_pipe.py。
$ dagster dev -f dagster_pipe.py 上述命令将自动在浏览器中启动 Web 服务器。 或者,您也可以直接访问http://127.0.0.1:3000。
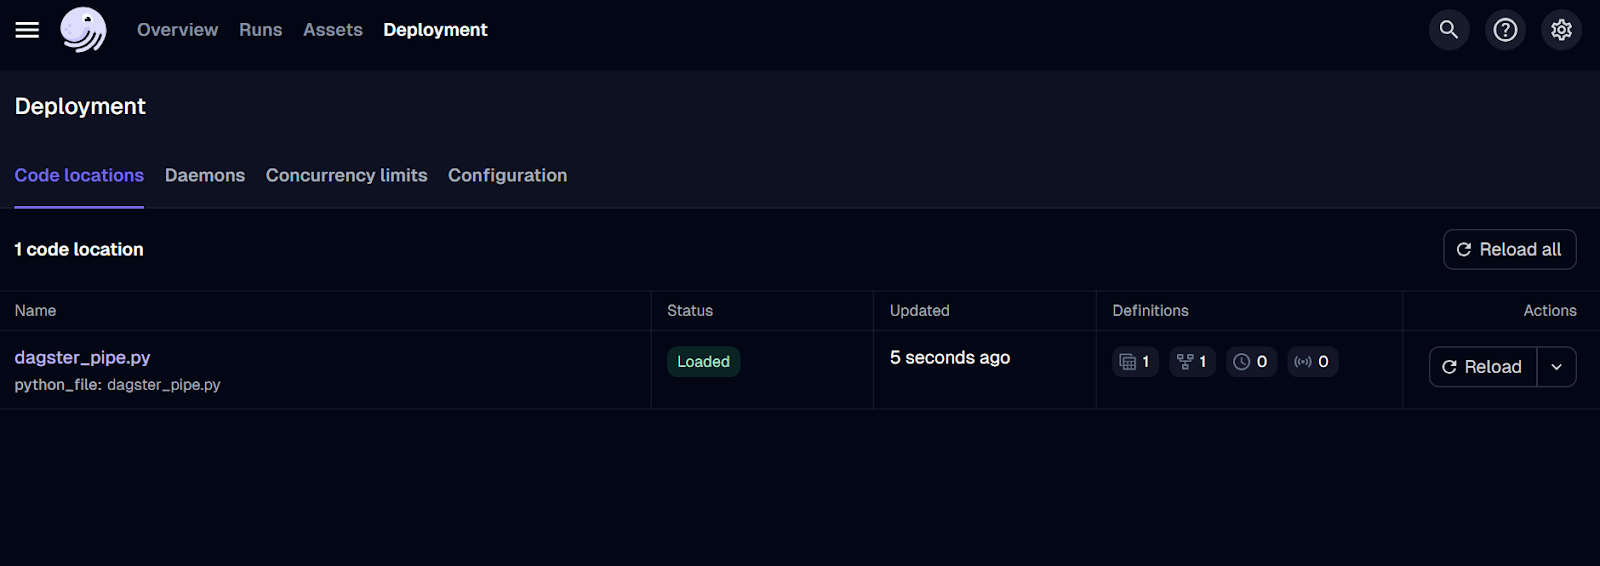
Dagster Web 服务器界面。
目前我们只部署了作业。要运行工作流,请转到 “Runs” 选项卡并点击 “Launch a new run”。
运行应已成功完成!若要查看日志,点击您感兴趣的运行的 ID。
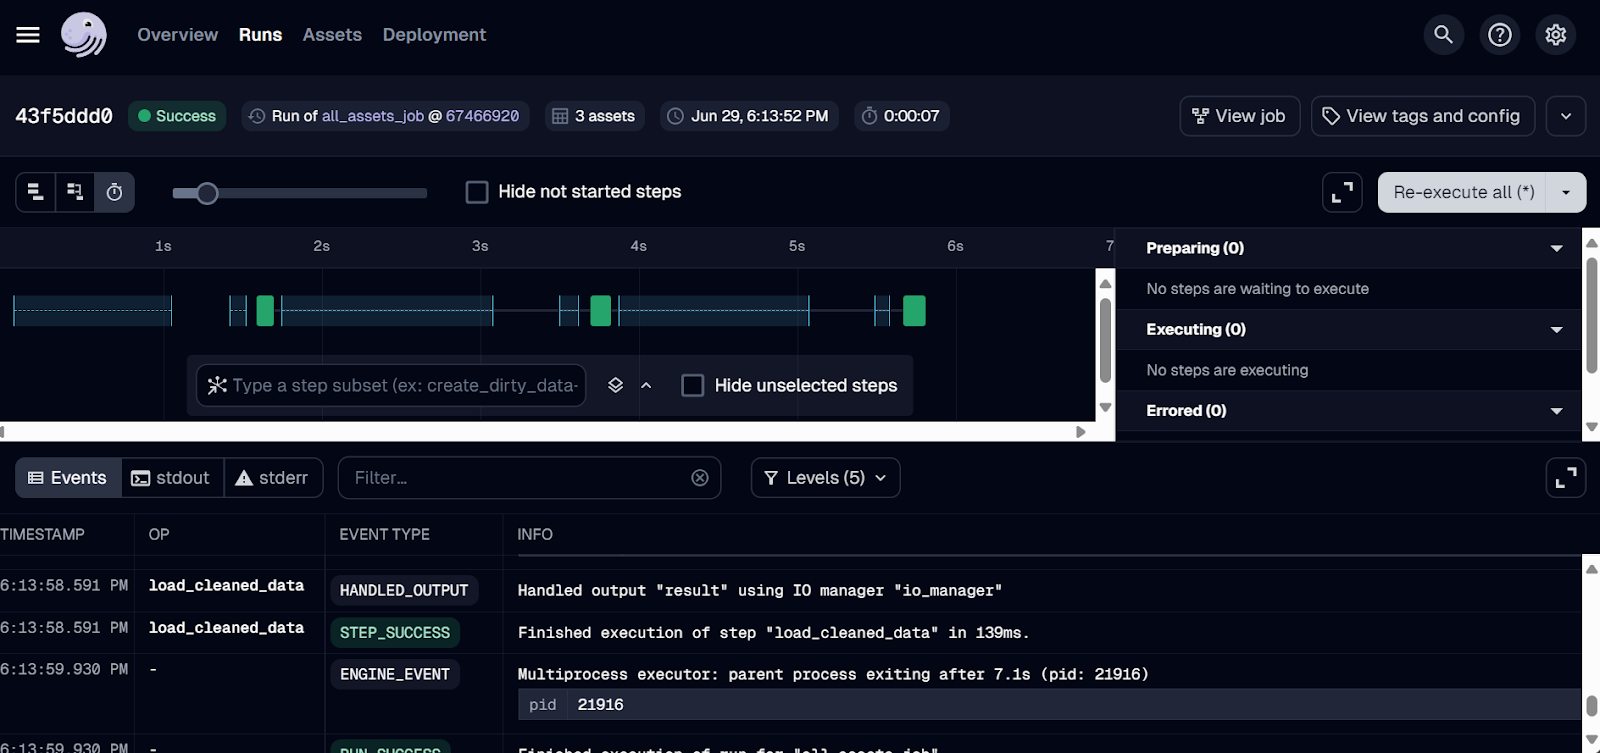
Dagster 运行日志。
Mage AI 是一款开源的混合型数据编排框架。所谓混合,是指它既具备 Jupyter Notebook 的灵活性,又拥有模块化代码的可控性。
任何人,即便仅具备有限的 Python 经验,也能构建、运行并监控数据流水线。您无需直接编写并运行 Python 文件,而是创建一个 Mage AI 项目并在仪表板中启动,在那里构建、运行与管理数据流水线。
相较 Airflow,Mage AI 提供更友好的界面和更易用的体验,非常适合数据工程新手。它在设计上考虑了可扩展性,能够高效处理大量数据与复杂的流水线结构。
一开始我感觉有些不适应,因为这与我习惯的方式完全不同。我需要安装并启动 Mage AI 的 Web UI。理论上应该很简单,但我发现构建和运行 ETL 流水线并不轻松。另一方面,我能理解这种独特设计对新手的吸引力——基本就是拖拽和点按钮。
Abid Ali Awan, Author
启动 Mage AI 十分简单。我们只需安装 Mage AI 的 Python 包。
$ pip install mage-ai并启动 Mage AI 项目。
$ mage start mage_ai_etl 上述命令会启动 Web 服务器。如前所述,所有代码编辑、作业运行与监控均在 Mage AI 的 UI 中完成。
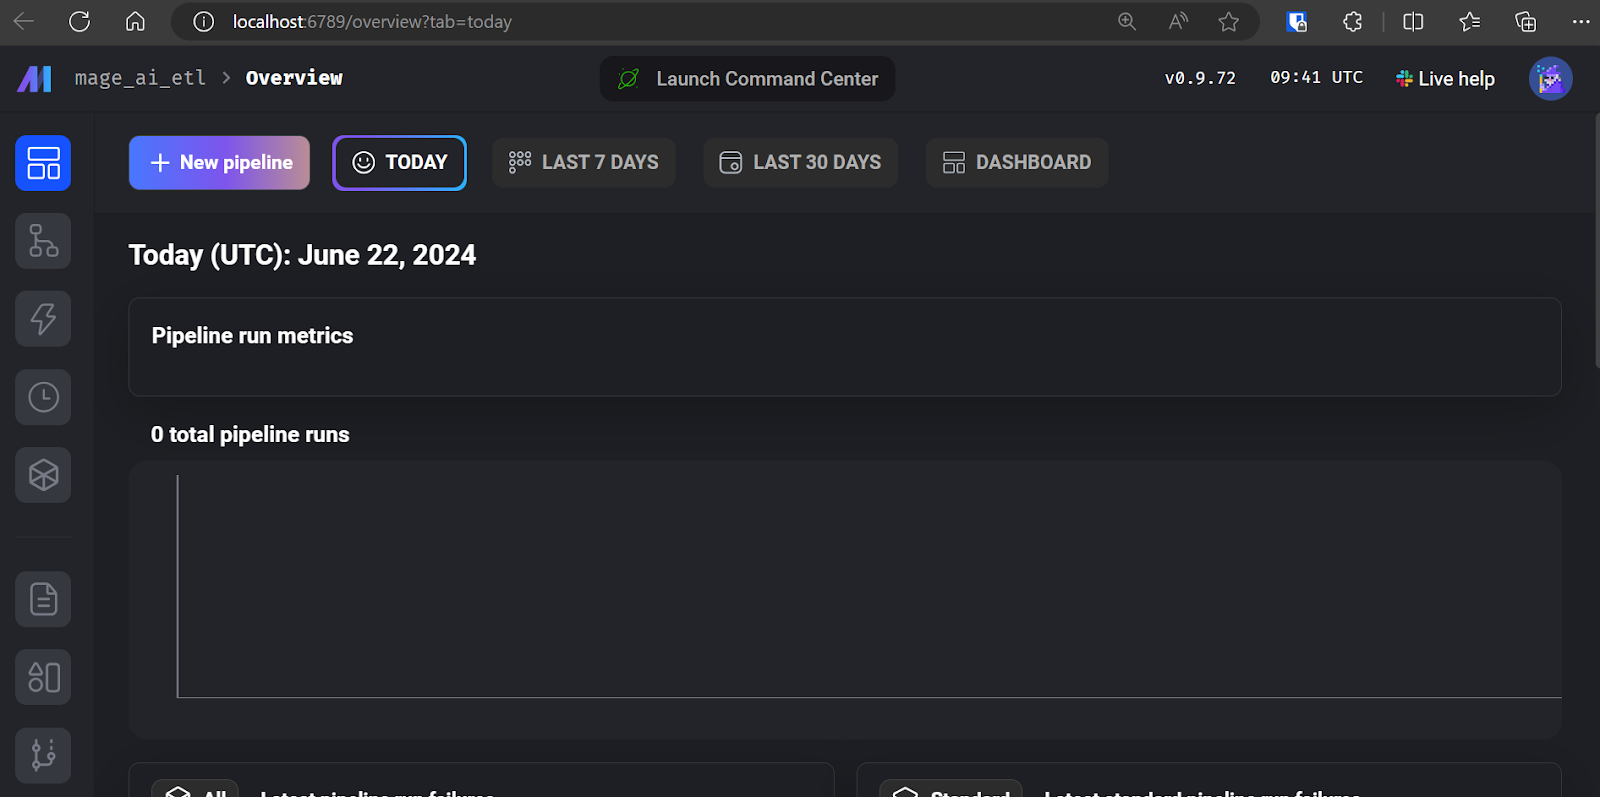
Mage AI 界面。
点击 “+ New pipeline” 创建您的第一个 ETL 流水线。我将其命名为 “simple_etl”。
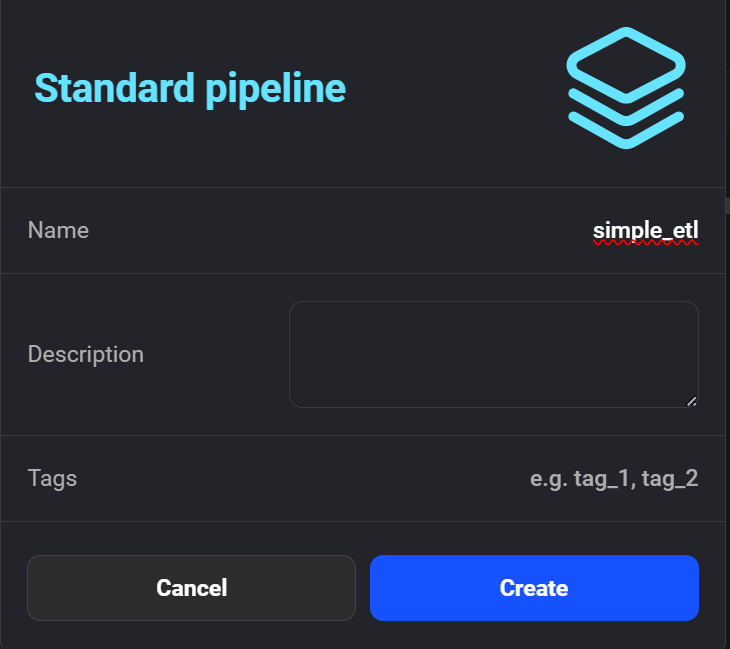
在 Mage AI 中创建新流水线。
随后界面会提示您添加一个模块以开始编码。选择 “Data Loader” 模块,并编写以下 Python 代码。
此处我们声明了一个 create_sample_csv() 函数,作为流水线的第一步。我们使用 Mage AI 的 @data_loader 装饰器。同时定义了断言输出是否存在的 test_output() 函数,有助于任务依赖管理。
import io
import pandas as pd

if 'data_loader' not in globals():
    from mage_ai.data_preparation.decorators import data_loader
if 'test' not in globals():
    from mage_ai.data_preparation.decorators import test

@data_loader
def create_sample_csv() -> pd.DataFrame:
    """
    Create a sample CSV file with duplicates and missing values
    """
    csv_data = """
category,product,quantity,price
Electronics,Laptop,5,1000
Electronics,Smartphone,10,500
Clothing,T-shirt,50,20
Clothing,Jeans,30,50
Books,Novel,100,15
Books,Textbook,20,80
Electronics,Laptop,5,1000
Clothing,T-shirt,,20
Electronics,Tablet,,300
Books,Magazine,25,
"""
    return pd.read_csv(io.StringIO(csv_data.strip()))

@test
def test_output(df) -> None:
    """
    Template code for testing the output of the block.
    """
    assert df is not None, 'The output is undefined'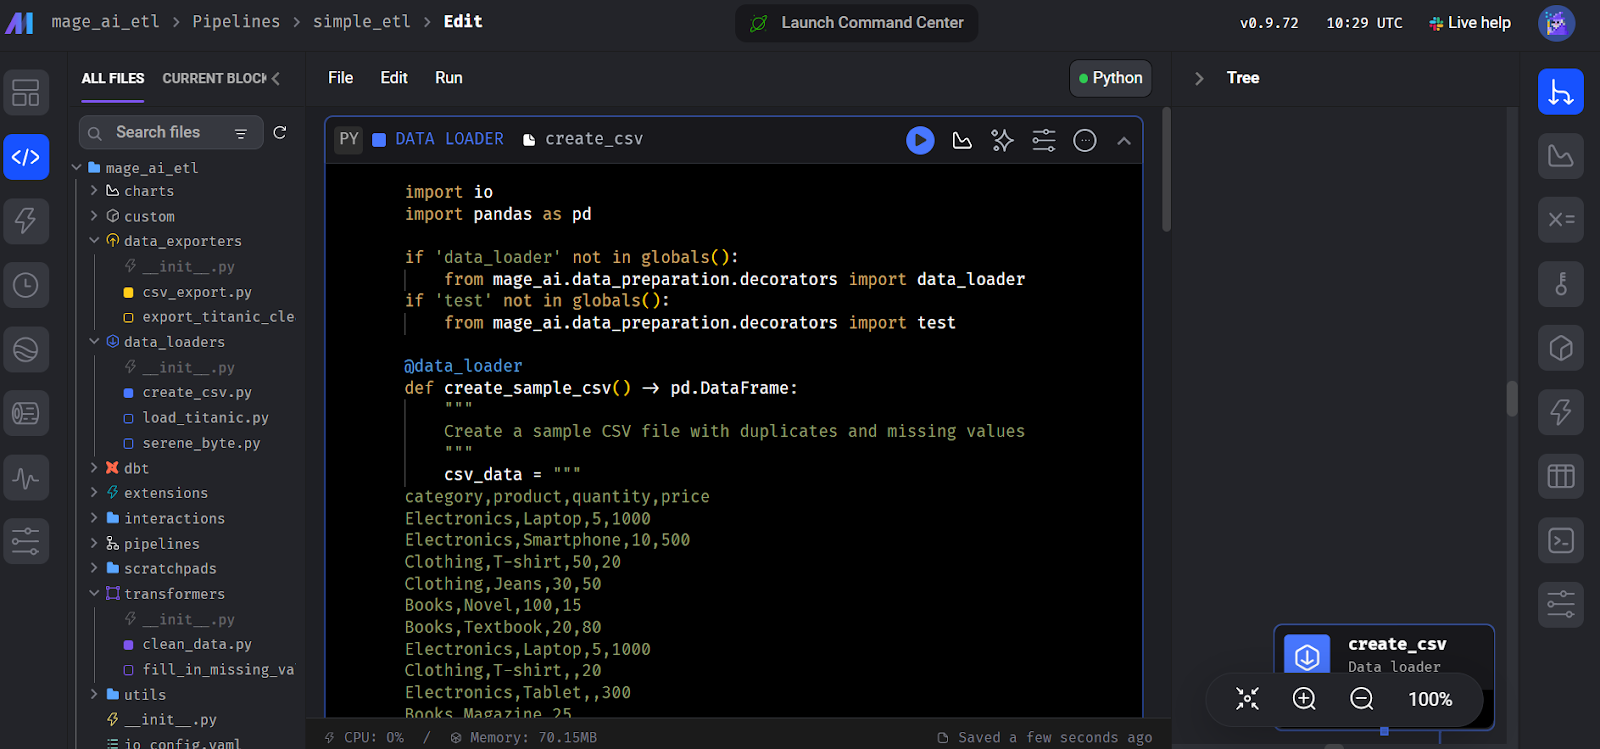
在 Mage AI 中创建数据加载模块。
接着,新建名为 “Transformer” 的模块,并添加 clean_data() 函数,如下所示。
您可忽略 test() 函数;只需添加主要的转换函数 clean_data() 即可。
import pandas as pd

if 'transformer' not in globals():
    from mage_ai.data_preparation.decorators import transformer
if 'test' not in globals():
    from mage_ai.data_preparation.decorators import test

@transformer
def clean_data(df: pd.DataFrame) -> pd.DataFrame:
    """
    Clean and transform the data
    """
    # Remove duplicates
    df = df.drop_duplicates()
    # Fill missing values with 0
    df = df.fillna(0)
    return df

@test
def test_output(df) -> None:
    """
    Template code for testing the output of the block.
    """
    assert df is not None, 'The output is undefined'
同理,创建 “Data Exporter” 模块并添加以下代码。该代码声明了一个数据加载函数 export_data_to_csv(),用于将转换后的数据保存为 CSV 文件。
import pandas as pd

if 'data_exporter' not in globals():
    from mage_ai.data_preparation.decorators import data_exporter

@data_exporter
def export_data_to_csv(df: pd.DataFrame) -> None:
    """
    Export the processed data to a CSV file
    """
    df.to_csv('output_data.csv', index=False)
    print("Data exported successfully to output_data.csv")
要运行流水线,请前往 “Trigger” 选项卡,点击 “Run@once”。
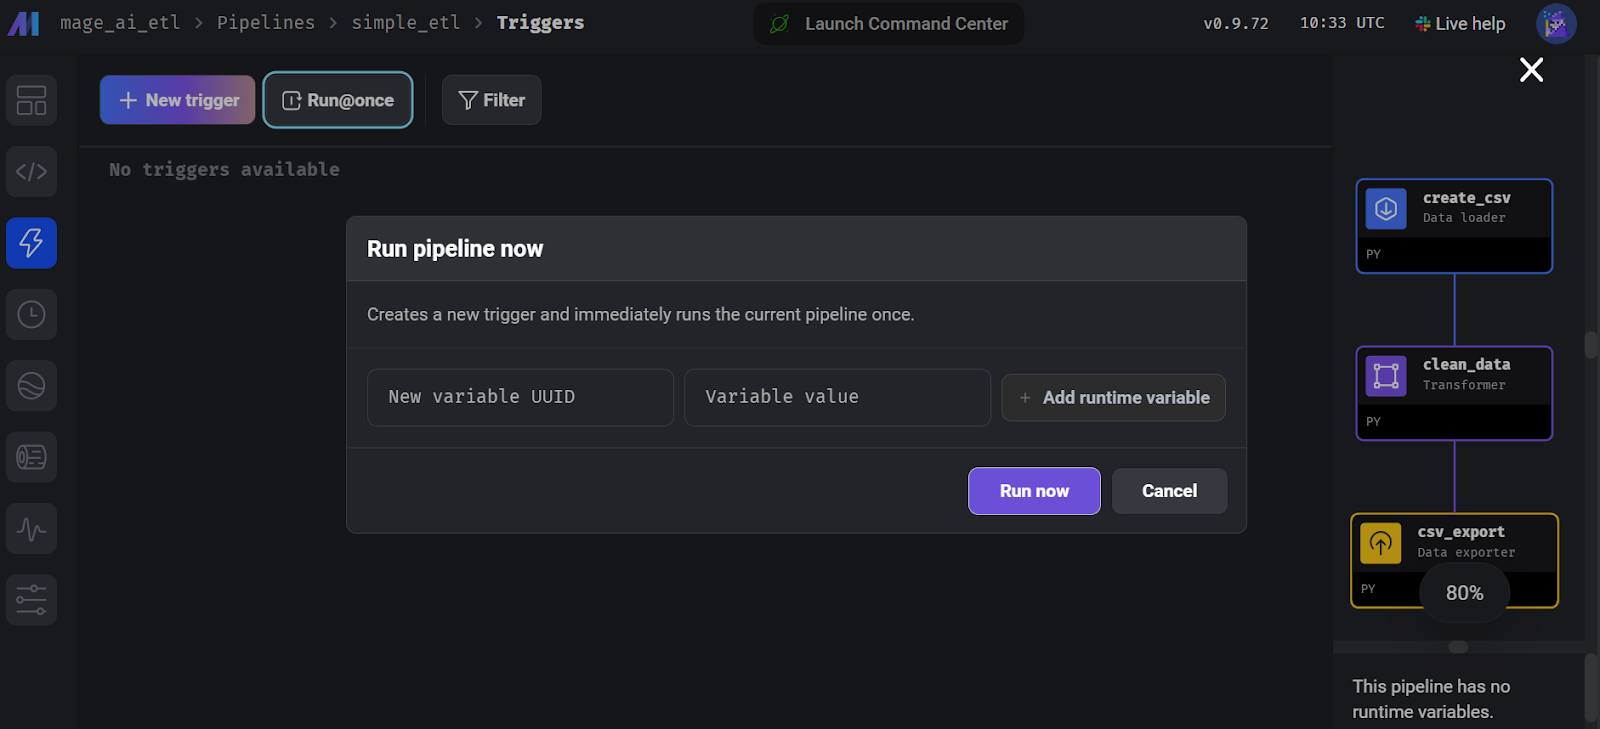
在 Mage AI 中运行流水线。
要查看运行日志,请转到 “Runs” 选项卡,并点击最近运行的流水线上的 “Logs” 按钮。
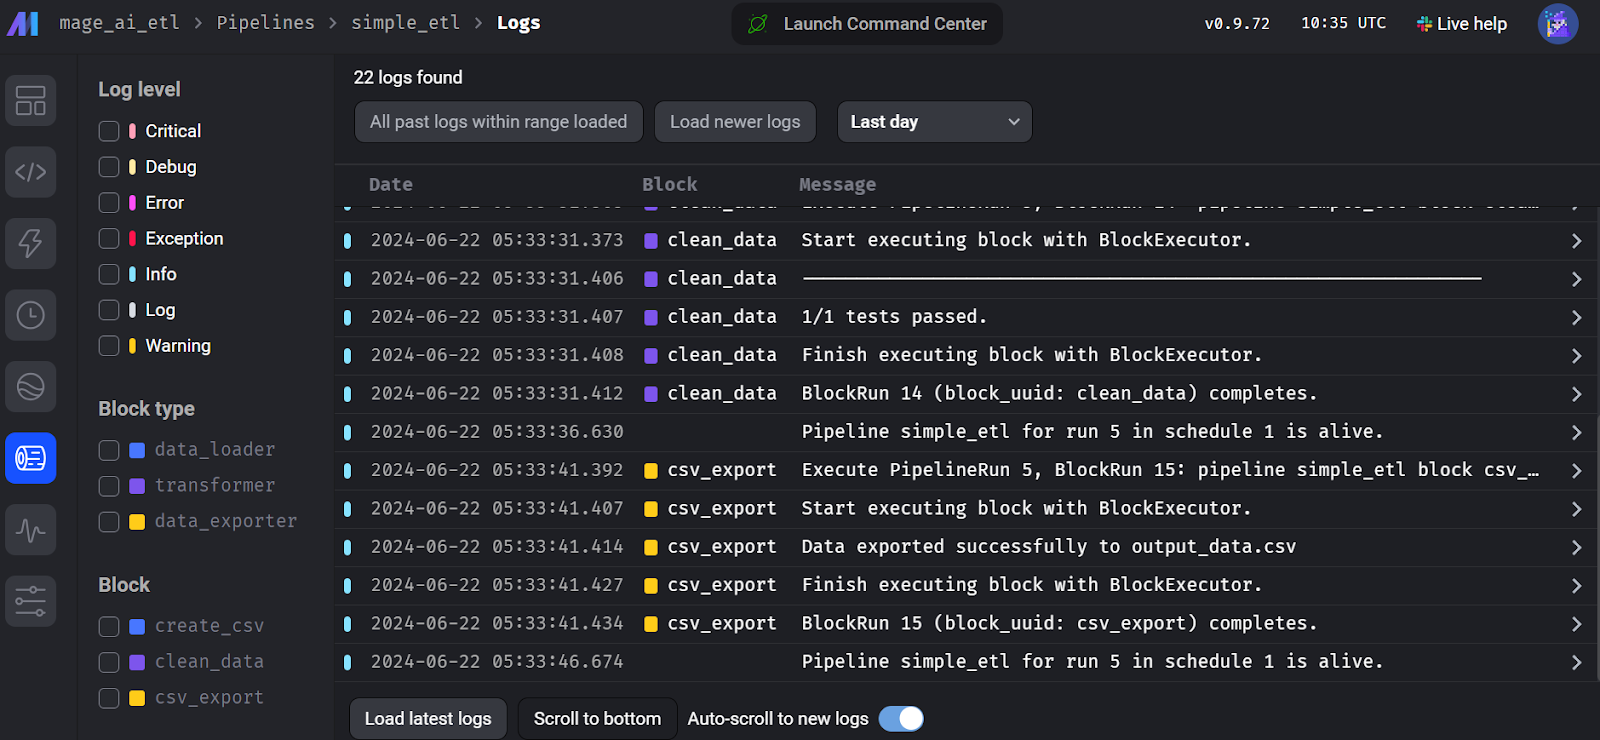
Mage AI 流运行日志。
Kedro 也是一款颇受欢迎的开源数据编排框架,与其他工具略有不同。它为机器学习工程师而生,借鉴了诸多软件工程理念并将其应用到机器学习项目中。
Kedro 设计高度模块化,这意味着即便是导出数据集,也需要先创建数据目录(data catalog)来指定数据的位置与类型,从而在整个流水线中实现标准化与高效的数据管理。
要理解 Kedro 如何融入机器学习生态,您可以通过阅读文章2024 年值得了解的 25 款 MLOps 工具来探索各类 MLOps 工具。
与 Airflow 相比,Kedro 的 API 在构建数据流水线方面更为简洁。它更专注于机器学习工程,提供数据分类与版本管理。
编码本身相当直接,但在真正要执行流水线时会遇到问题。您需要创建数据目录、注册流水线,并熟悉 Kedro 的项目结构。我认为它比 Dagster 和 Prefect 更具挑战性。不过,我也理解这种设计的初衷:让数据流水线更可靠、少出错。
Abid Ali Awan, Author
构建 Kedro 数据流水线的方式有所不同。该框架模块化程度较高,您需要了解项目结构及执行工作流所涉及的各个步骤,才能顺利运行。
先安装 Kedro 的 Python 包。
$ pip install kedro初始化 Kedro 项目。
$ kedro new --name=kedro_etl --tools=none --example=n 进入项目目录。
$ cd kedro-etl 在 pipelines 文件夹下创建名为 data_processing 的文件夹。
$ mkdir -p src/kedro_etl/pipelines/data_processing 创建名为 kedro_pipe.py 的 Python 文件,并在您喜爱的 IDE 中打开,例如 Visual Studio Code。
$ code src/kedro_etl/pipelines/data_processing/kedro_pipe.py该 Python 脚本应包含抽取、转换与加载函数,它们是流水线中的节点。本例中分别为 create_sample_data()、clean_data() 与 load_and_process_data()。
随后,我们在 create_pipeline() 函数中使用 Kedro 的 Pipeline 类将这些节点连接起来。在流水线函数中,我们定义各节点,每个节点包含 inputs、outputs 和节点 name。
import pandas as pd
import numpy as np
from kedro.pipeline import Pipeline, node

def create_sample_data():
    data = {
        'id': range(1, 101),
        'name': [f'Person_{i}' for i in range(1, 101)],
        'age': np.random.randint(18, 80, 100),
        'salary': np.random.randint(20000, 100000, 100),
        'missing_values': [np.nan if i % 10 == 0 else i for i in range(100)]
    }
    return pd.DataFrame(data)

def clean_data(df: pd.DataFrame):
    # Remove rows with missing values
    df_cleaned = df.dropna()

    # Convert salary to thousands
    df_cleaned['salary'] = df_cleaned['salary'] / 1000

    # Capitalize names
    df_cleaned['name'] = df_cleaned['name'].str.upper()

    return df_cleaned

def load_and_process_data(df: pd.DataFrame):
    # Calculate average salary
    avg_salary = df['salary'].mean()

    # Add a new column for salary category
    df['salary_category'] = df['salary'].apply(
        lambda x: 'High' if x > avg_salary else 'Low')

    # Calculate age groups
    df['age_group'] = pd.cut(df['age'], bins=[0, 30, 50, 100], labels=[
                             'Young', 'Middle', 'Senior'])

    print(df)
    return df

def create_pipeline(**kwargs):
    return Pipeline(
        [
            node(
                func=create_sample_data,
                inputs=None,
                outputs="raw_data",
                name="create_sample_data_node",
            ),
            node(
                func=clean_data,
                inputs="raw_data",
                outputs="cleaned_data",
                name="clean_data_node",
            ),
            node(
                func=load_and_process_data,
                inputs="cleaned_data",
                outputs="processed_data",
                name="load_and_process_data_node",
            ),
        ]
    )
如果在未创建数据目录的情况下运行流水线,数据将不会被导出。因此,我们需要编辑 conf/base/catalog.yml 文件,提供数据集配置。
raw_data:
  type: pandas.CSVDataset
  filepath: ./data/kedro/sample_data.csv

cleaned_data:
  type: pandas.CSVDataset
  filepath: ./data/kedro/cleaned_data.csv

processed_data:
  type: pandas.CSVDataset
  filepath: ./data/kedro/processed_data.csv
我们还必须在流水线注册表中包含新建的 Python 文件。为此,请前往 src/simple_etl/pipeline_registry.py 文件,并加入以下代码。
"""Project pipelines."""
from __future__ import annotations

from kedro.pipeline import Pipeline
from kedro_etl.pipelines.data_processing import kedro_pipe

def register_pipelines() -> Dict[str, Pipeline]:
    data_processing_pipeline = kedro_pipe.create_pipeline()

    return {
        "__default__": data_processing_pipeline,
        "data_processing": data_processing_pipeline,
    }
在终端运行以下命令以执行流水线,并查看实时日志。
$ kedro run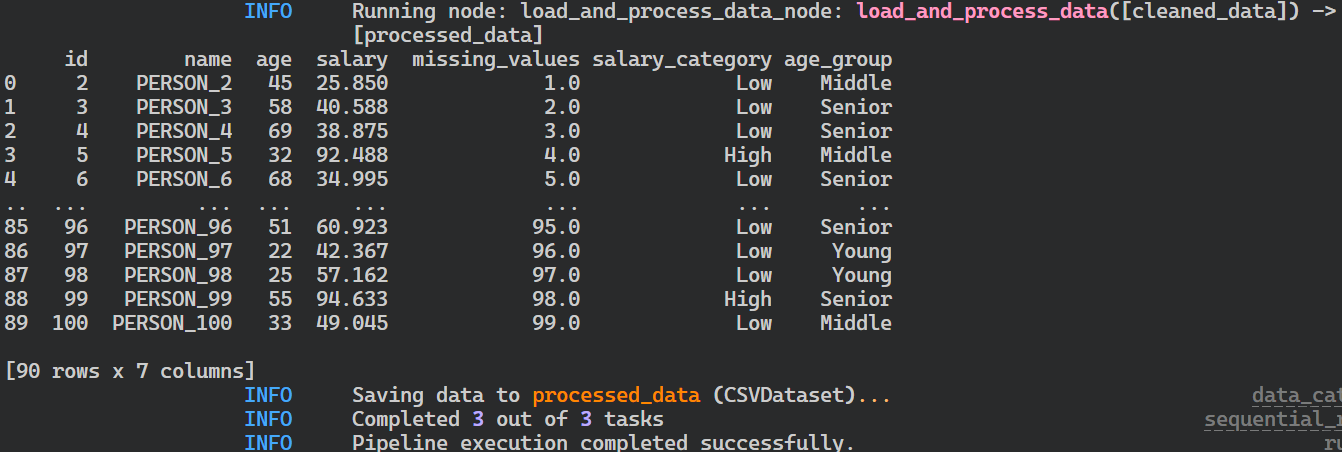
Kedro 流水线运行日志。
流水线运行结束后,文件将按数据目录中定义的位置以 CSV 格式保存。
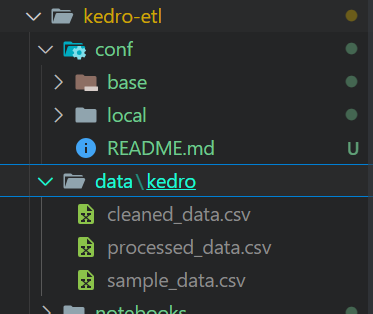
Kedro 流水线运行输出文件。
如果运行流水线时遇到问题,请考虑安装包含所有扩展的 Kedro。
$ pip install "kedro[all]"我们可以通过安装 kedro-viz 工具来可视化并分享我们的流水线。
$ pip install kedro-viz随后执行以下命令,即可可视化所有数据流水线与数据节点。它还提供实验追踪和分享流水线可视化的选项。
$ kedro viz run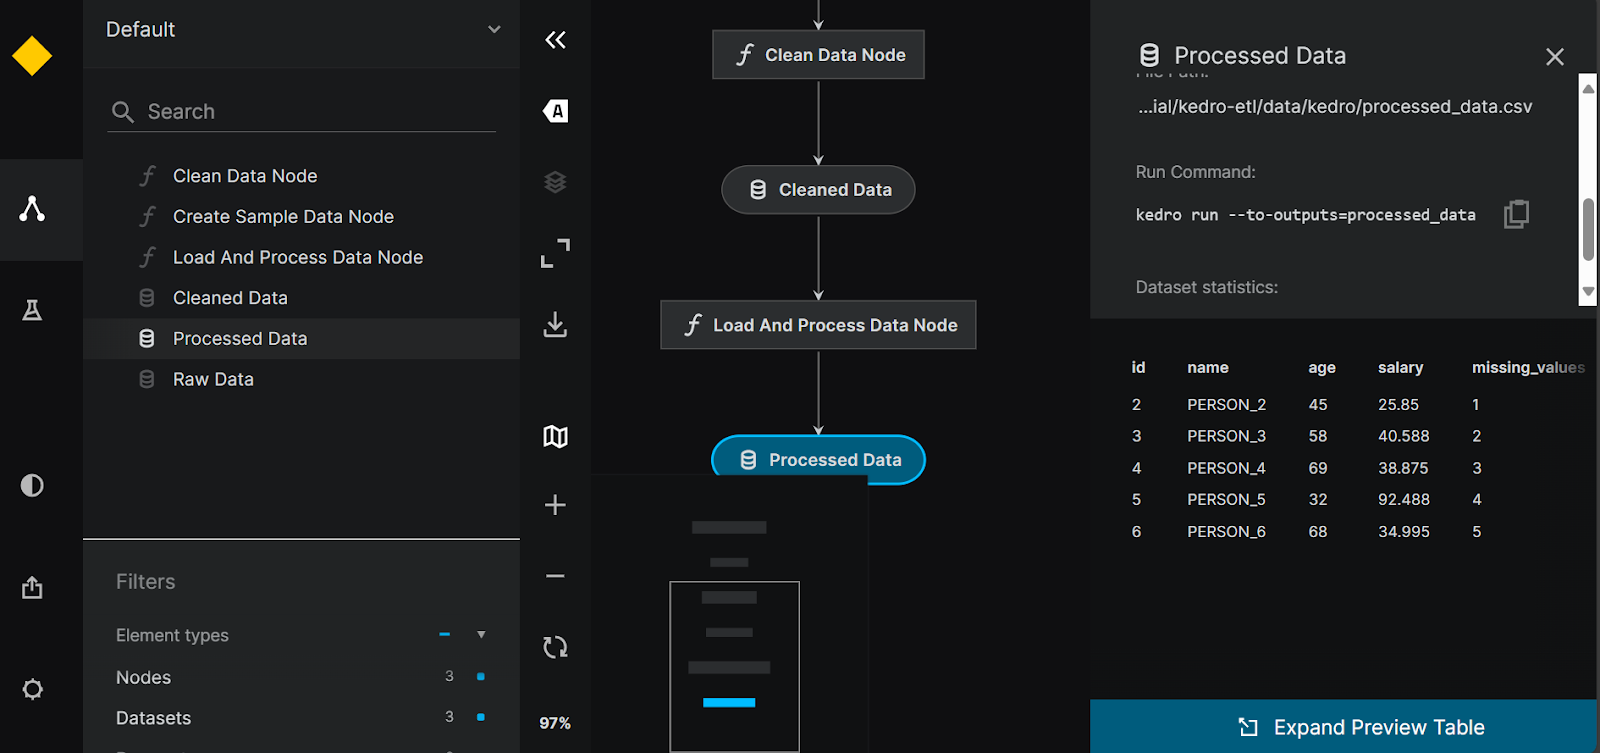
Kedro 流水线可视化。
Luigi 是由 Spotify 开发的开源 Python 框架,擅长管理长时运行的批处理与复杂数据流水线。它在依赖解析、工作流管理、可视化与故障恢复方面表现出色,是强大的数据工作流编排工具。
与 Airflow 相比,Luigi 的 API 更精简,支持日历调度,并拥有忠实的用户群,可帮助您解决数据编排流水线中的各种问题。
如果您是 Python 初学者,可能会觉得构建与运行流水线较为困难。不过文档与指南可以帮助您快速入门。日志信息较为有限,仪表板基本只是用于展示 DAG 与依赖关系。
Abid Ali Awan, Author
创建 Luigi 数据流水线需要理解面向对象编程。我们先安装 Luigi 的 Python 包。
$ pip install luigi为了在 Luigi 中开发一个简单的 ETL 流水线,我们将创建相互关联的任务。与将 Python 函数作为任务不同,我们会为流水线中的每一步创建一个 Python 类,分别为 FetchData、ProcessData 和 GenerateReport。每个类都包含三个函数: requires()、output() 和 run()。
其中,requires() 与 output() 用于连接任务,run() 则执行处理代码。最后,我们将通过流水线中的最后一个任务来构建整个流水线。
import luigi
import pandas as pd
import numpy as np

class FetchData(luigi.Task):
    def output(self):
        return luigi.LocalTarget('data/fetch_data.csv')

    def run(self):
        # Simulate fetching data by creating a sample CSV file
        data = {
            'column1': [1, 2, np.nan, 4],
            'column2': ['A', 'B', 'C', np.nan]
        }
        df = pd.DataFrame(data)
        df.to_csv(self.output().path, index=False)

class ProcessData(luigi.Task):
    def requires(self):
        return FetchData()

    def output(self):
        return luigi.LocalTarget('data/process_data.csv')

    def run(self):
        df = pd.read_csv(self.input().path)
        # Fill missing values
        df['column1'].fillna(df['column1'].mean(), inplace=True)
        df['column2'].fillna('B', inplace=True)
        df.to_csv(self.output().path, index=False)

class GenerateReport(luigi.Task):
    def requires(self):
        return ProcessData()

    def output(self):
        return luigi.LocalTarget('data/generate_report.txt')

    def run(self):
        df = pd.read_csv(self.input().path)
        # Simple data analysis: calculate mean of column1 and value counts of column2
        mean_column1 = df['column1'].mean()
        value_counts_column2 = df['column2'].value_counts()

        with self.output().open('w') as out_file:
            out_file.write(f'Mean of column1: {mean_column1}\n')
            out_file.write('Value counts of column2:\n')
            out_file.write(value_counts_column2.to_string())

if __name__ == '__main__':
    luigi.build([GenerateReport()], local_scheduler=True)
在 Jupyter Notebook 中运行上述代码,或创建 Python 文件后在终端中运行。
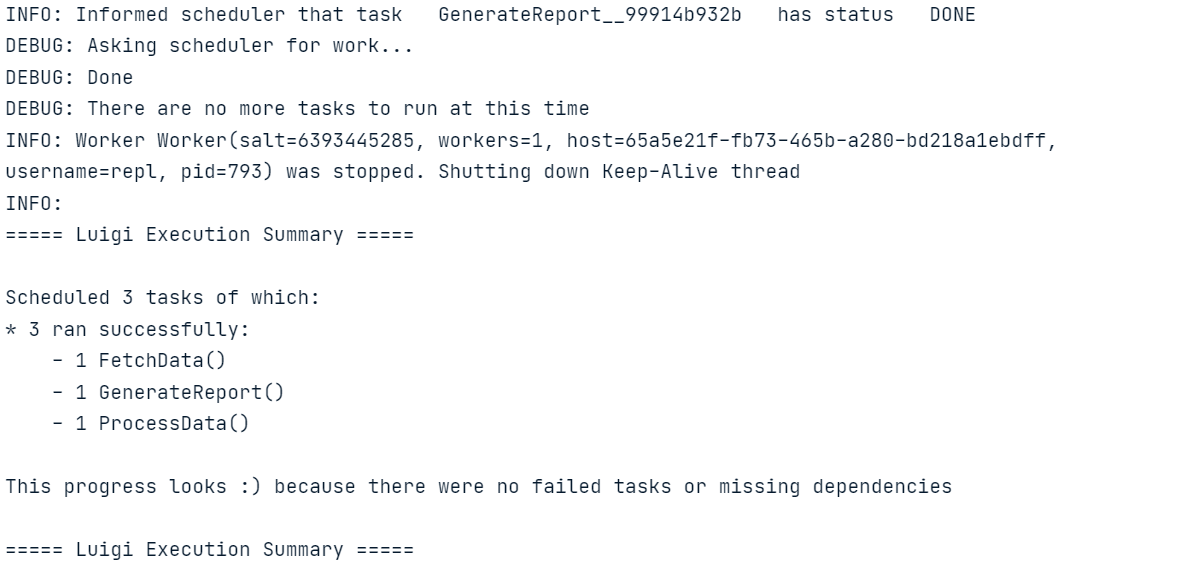
与 Luigi 类似,您也可以学习 使用 Apache Airflow 构建 ETL 流水线。该教程涵盖了在 Apache Airflow 中抽取、转换和加载数据的基础知识。
我们需要初始化 Luigi 的中央调度器,以便调度流水线运行或基于事件进行触发。
在终端中输入以下命令启动调度器。
$ luigid 2024-06-22 13:35:18,636 luigi[25056] INFO: logging configured by default settings
2024-06-22 13:35:18,636 luigi.scheduler[25056] INFO: No prior state file exists at /var/lib/luigi-server/state.pickle. Starting with empty state
2024-06-22 13:35:18,640 luigi.server[25056] INFO: Scheduler starting up要运行流水线,请新开一个终端并输入以下命令。Luigi 命令需要提供 Python 文件名和我们希望执行的最后一个任务。本例中文件名为 luigi_pipe.py,最后一个 Luigi 任务为 GenerateReport。
$ python -m luigi --module luigi_pipe GenerateReport若要可视化流水线运行与任务状态,只需在浏览器中访问http://localhost:8082。
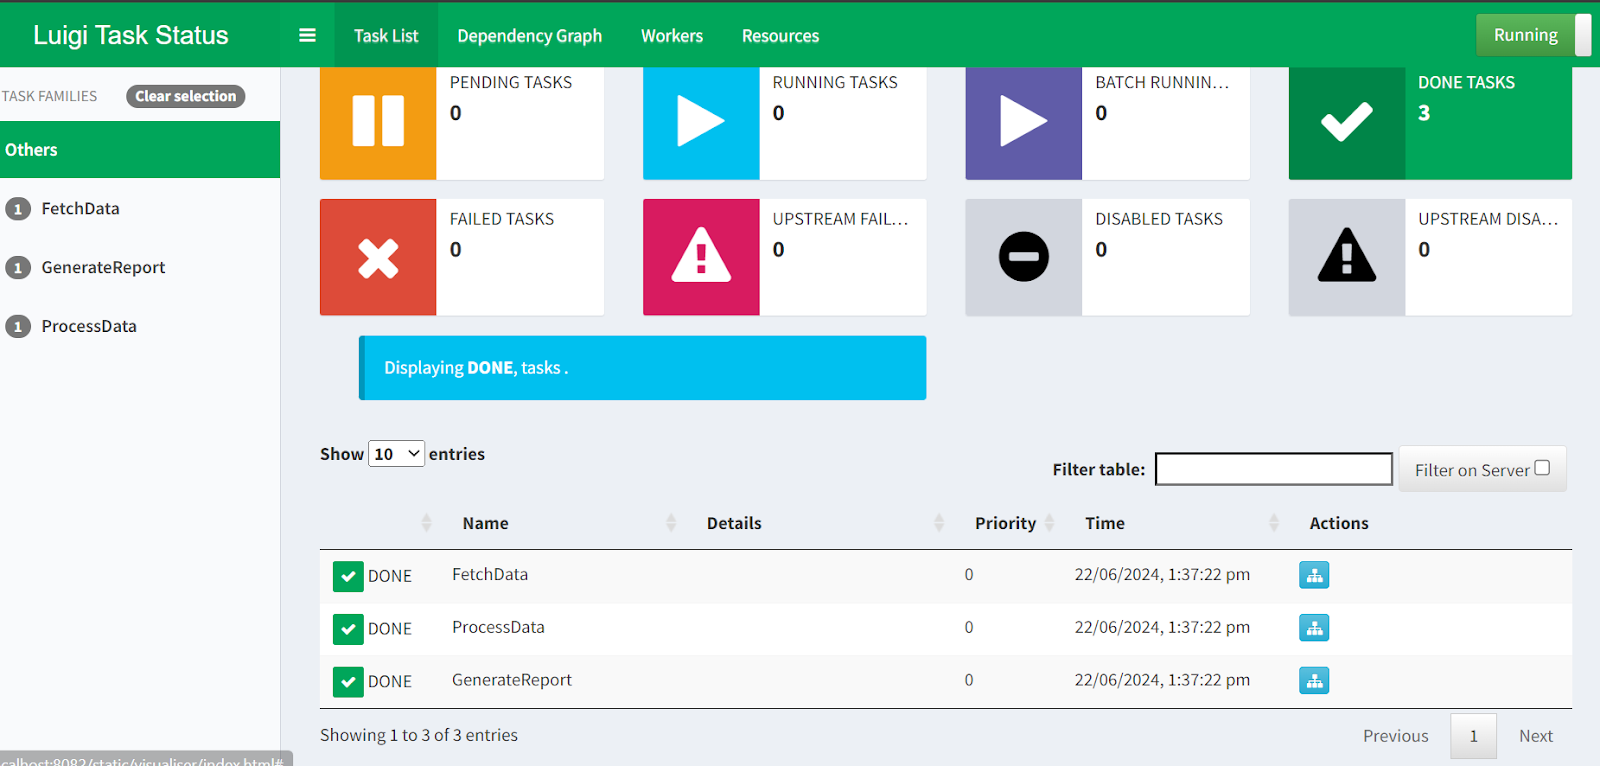
Luigi 中央调度器 Web UI。
以上就是我们对 5 个最佳 Airflow 替代方案的演示!如果您想更深入地学习本文示例,以下资源可供参考:
在本教程中,我们讨论了最顶尖的开源、免费的 Airflow 替代方案。我们还了解了每款数据编排工具,并构建与执行了一个简单的 ETL 流水线。通过代码示例,您可以更好地判断哪一款更适合您的使用场景。
如果您是初学者,我建议从 Prefect 或 Mage AI 入手,因为它们更易用,设置也更简单。而若您在寻找更先进、遵循软件工程实践的工具,建议深入了解 Dagster、Kedro 与 Luigi。
阅读完本文后,您在数据工程之路上的下一步自然是获取一项认证,如 DataCamp 的Python 数据工程师,学习更多工具并构建可部署到生产环境的端到端数据流水线。
通过以下课程进一步学习数据工程!
Courses
Tracks
Courses