
Kurs
Einführung in das Data Engineering
4 Std.
129.8K
Bild vom Autor.
Apache Airflow ist ein beliebtes Open-Source-Tool für Data Orchestration, mit dem sich Datenpipelines erstellen, planen und überwachen lassen. Ein zentrales Dashboard zeigt den Status deiner Workflows und macht Airflow für viele Einsatzszenarien zur ersten Wahl.
Allerdings fehlen Airflow einige wichtige Funktionen, die bei komplexen, modernen Orchestrierungsanforderungen entscheidend sein können.
In diesem Tutorial sehen wir uns fünf Alternativen zu Airflow an, die erweiterte Funktionen bieten und einige seiner Einschränkungen adressieren. Außerdem bauen wir mit jedem Tool eine einfache ETL-Pipeline, führen sie aus und visualisieren sie im jeweiligen Dashboard.
Airflow ist stark für viele Daten-Workflows, hat aber Einschränkungen, die Unternehmen zu Alternativen greifen lassen können.
Hier sind einige Gründe, die für Alternativen sprechen:
Bevor wir in die Praxis mit anderen Orchestrierungstools einsteigen, lohnt es sich, eine Pipeline in Apache Airflow zu schreiben. Folge dazu dem Tutorial Getting Started with Apache Airflow, um Alternativen fair vergleichen zu können.
Wenn du ganz neu bei Airflow bist, empfiehlt sich der kurze Kurs Introduction to Airflow in Python, um die Grundlagen zum Erstellen und Planen von Datenpipelines zu lernen.
Schauen wir uns nun die fünf Top-Alternativen zu Airflow an – inklusive praktischer Codebeispiele.
Prefect ist ein Open-Source-Orchestrierungstool für Python-Workflows, entwickelt für moderne Daten- und Machine-Learning-Engineers. Eine schlanke API erlaubt dir, Pipelines schnell aufzubauen und sie über ein interaktives Dashboard zu verwalten.
Prefect bietet ein hybrides Ausführungsmodell: Du kannst Workflows in der Cloud bereitstellen und dort ausführen oder lokal arbeiten.
Im Vergleich zu Airflow bringt Prefect erweiterte Features mit wie automatische Task-Abhängigkeiten, ereignisbasierte Trigger, integrierte Benachrichtigungen, workflowspezifische Infrastruktur und datenteiligen Austausch über Tasks hinweg. Damit lassen sich auch komplexe Workflows effizient steuern.
Prefect ist einfach und gleichzeitig sehr leistungsfähig. Ich hatte das Beispiel in 5 Minuten zum Laufen. Besonders gefallen mir das Dashboard-Design, die einfachen Benachrichtigungen, das erneute Ausführen von Pipelines und die zentrale Steuerung und Überwachung im Dashboard.
Abid Ali Awan, Author
Lies den Blogartikel Airflow vs Prefect: Deciding Which is Right For Your Data Workflow für einen detaillierten Vergleich der beiden Orchestrierungstools.
Wir starten das Prefect-Projekt mit der Installation des Python-Packages. Führe dazu folgenden Befehl im Terminal aus.
$ pip install -U prefectErstelle anschließend ein Python-Skript namens prefect_etl.py und füge folgenden Code ein.
from prefect import task, flow
import pandas as pd

# Extract data
@task
def extract_data():
    # Simulating data extraction
    data = {
        "name": ["Alice", "Bob", "Charlie"],
        "age": [25, 30, 35],
        "city": ["New York", "Los Angeles", "Chicago"]
    }
    df = pd.DataFrame(data)
    return df

# Transform data
@task
def transform_data(df: pd.DataFrame):
    # Example transformation: adding a new column
    df["age_plus_ten"] = df["age"] + 10
    return df

# Load data
@task
def load_data(df: pd.DataFrame):
    # Simulating data load
    print("Loading data to target destination:")
    print(df)

# Defining the flow
@flow(log_prints=True)
def etl():
    raw_data = extract_data()
    transformed_data = transform_data(raw_data)
    load_data(transformed_data)

# Running the flow
if __name__ == "__main__":
    etl()
Der Code definiert die Task-Funktionen extract_data(), transform_data() und load_data() und führt sie seriell in der Flow-Funktion etl() aus. Die Funktionen werden mit Prefect-Python-Decoratoren erstellt.
Kurz gesagt: Wir erzeugen ein pandas-DataFrame, transformieren es und geben das Ergebnis mit print aus. So simulieren wir eine ETL-Pipeline.
Zum Ausführen des Workflows rufst du das Skript mit folgendem Befehl auf.
$ python prefect_etl.py Wie zu sehen ist, wurde der Workflow erfolgreich abgeschlossen.
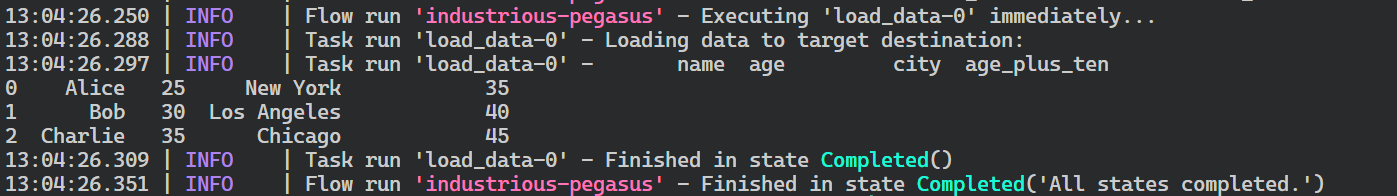
Logs des Prefect-Flow-Runs.
Jetzt deployen wir den Workflow, um ihn zeitgesteuert oder ereignisbasiert laufen zu lassen. Das Deployment ermöglicht zudem die zentrale Überwachung und Verwaltung mehrerer Workflows.
Für das Deployment nutzen wir die Prefect-CLI. Die Funktion deploy erwartet den Dateinamen, den Namen der Flow-Funktion und den Deployment-Namen. Hier nennen wir das Deployment „simple_etl“.
$ prefect deploy prefect_etl.py:etl -n 'simple_etl'Nach dem Befehl kann die Meldung erscheinen, dass kein Worker-Pool vorhanden ist. Lege ihn mit folgendem Befehl an.
$ prefect worker start --pool 'datacamp'Nun starten wir in einem zweiten Terminalfenster das Deployment. Der Befehl prefect deployment run benötigt „<flow-function-name>/<deployment-name>“ als Argument, wie unten gezeigt.
$ prefect deployment run 'etl/simple_etlAls Ergebnis siehst du die Meldung, dass der Workflow läuft. Dem Flow-Run wird üblicherweise ein zufälliger Name zugewiesen, in meinem Fall witty-lorikeet.
Creating flow run for deployment 'etl/simple_etl'...
Created flow run 'witty-lorikeet'.
└── UUID: 4e0495b0-9c7e-4ed8-b9ab-5160994dc7f0
└── Parameters: {}
└── Job Variables: {}
└── Scheduled start time: 2024-06-22 14:05:01 PKT (now)
└── URL: <no dashboard available>
Wechsle für die vollständigen Logs zurück in das Terminalfenster, in dem du den Worker-Pool gestartet hast.
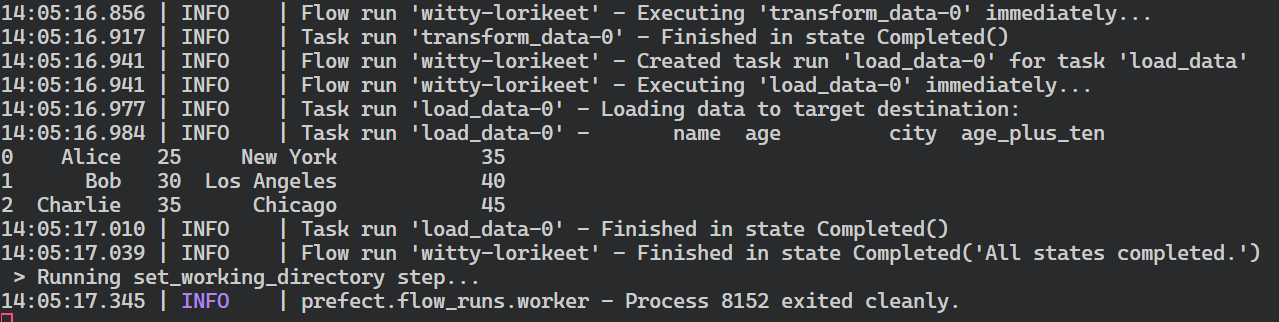
Zusammenfassung des Prefect-Flow-Runs.
Um Runs komfortabel zu visualisieren und weitere Workflows zu verwalten, startest du den Prefect-Webserver.
$ prefect server start Nach dem Start wirst du zum Prefect-Dashboard weitergeleitet. Alternativ öffne direkt http://127.0.0.1:4200 in deinem Browser.
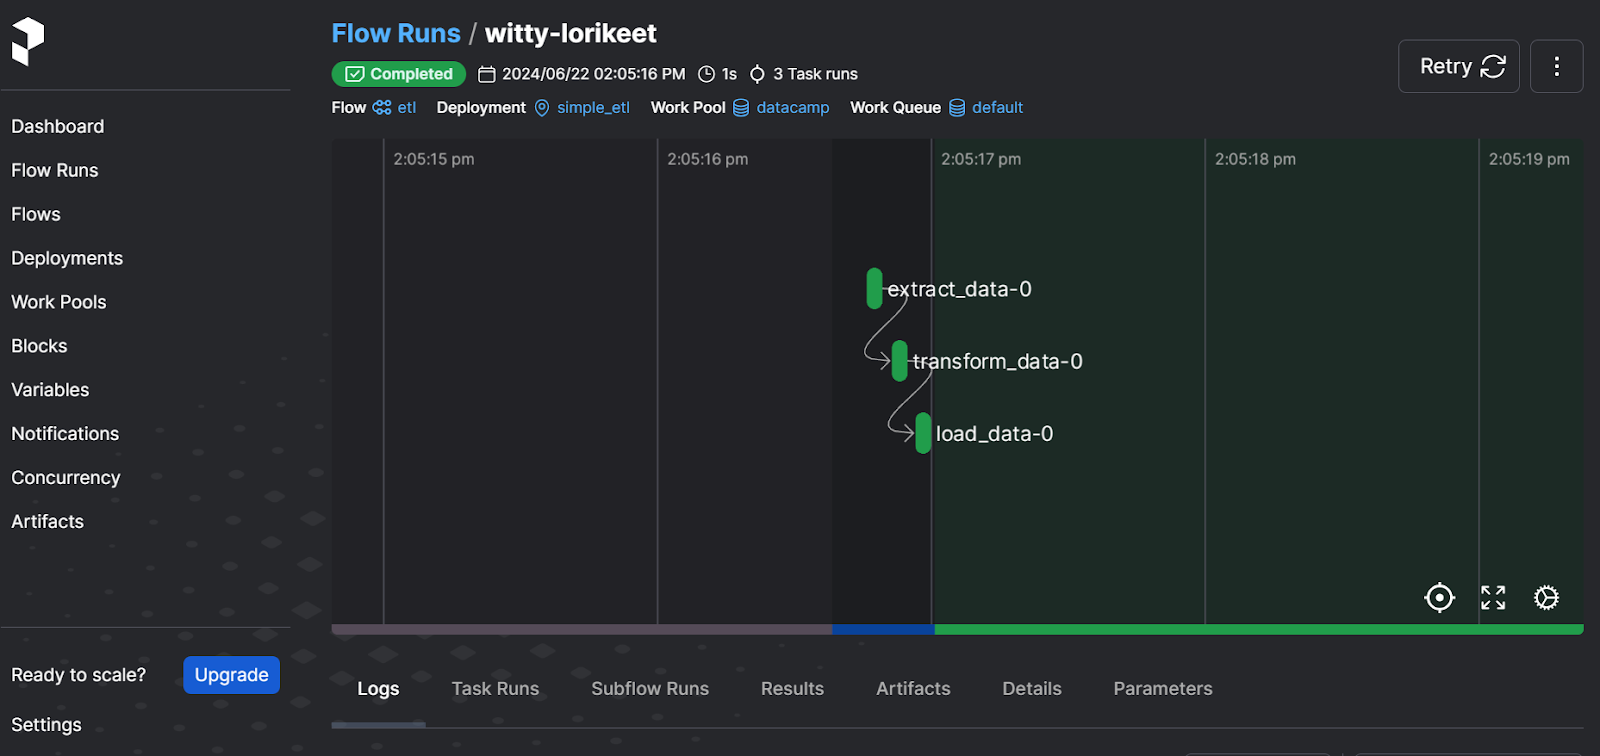
Prefect-Webserver-UI
Im Dashboard kannst du Workflows neu starten, Logs einsehen, Work-Pools prüfen, Benachrichtigungen setzen und viele weitere Optionen nutzen. Eine runde Lösung für moderne Orchestrierungsanforderungen.
Wie du mit Prefect Machine-Learning-Pipelines baust und ausführst, zeigt das Tutorial Using Prefect for Machine Learning Workflows.
Dagster ist ein Open-Source-Framework, mit dem Data Engineers Datenpipelines definieren, planen und überwachen. Es ist hoch skalierbar und fördert die Zusammenarbeit über Datenteams hinweg.
Mit Dagster definierst du Daten-Assets als Python-Funktionen via Decorators. Anschließend kannst du sie per Zeitplan oder ereignisbasiert ausführen.
Im Vergleich zu Airflow entwickelt, testet und reviewst du Pipelines lokal, profitierst von einem Asset-zentrierten Orchestrierungsansatz und einer Cloud- sowie Container-nativen Architektur.
Statt in Schritten und Flows zu denken, musste ich umstellen und die Pipeline über Daten-Assets aufbauen. Abgesehen davon war das Erstellen und Ausführen einer einfachen ETL-Pipeline sehr unkompliziert. Der Webserver ist minimalistisch, liefert aber alle nötigen Infos zu Assets, Runs und Deployments.
Abid Ali Awan, Author
Wir erstellen eine einfache ETL-Pipeline, führen sie aus und visualisieren sie im Dagster-Webserver. Ähnlich wie bei Prefect bietet der Dagster-Webserver eine zentrale Überwachung mehrerer Workflows sowie Zeitplanung für Runs und Assets.
Beginnen wir mit der Installation des Python-Packages.
$ pip install dagster -qDann erstellen wir drei Python-Funktionen für Extract, Transform und Load. Sie heißen create_dirty_data(), clean_data() und load_cleaned_data(). Mit dem @asset-Decorator deklarieren wir sie als Daten-Assets in Dagster.
Als Nächstes erzeugen wir den Asset-Job (Variable job) aus allen Assets (Variable all_assets) und erstellen dann die Asset-Definition (Variable defs).
Den Schritt der Asset-Definition kannst du auslassen, er wird jedoch wichtig, wenn du Runs planen, mehrere Jobs starten oder Sensoren einrichten willst.
import pandas as pd
import numpy as np
from dagster import asset, Definitions, define_asset_job, materialize

@asset
def create_dirty_data():
    # Create a sample DataFrame with dirty data
    data = {
        'Name': [' John Doe ', 'Jane Smith', 'Bob Johnson ', '  Alice Brown'],
        'Age': [30, np.nan, 40, 35],
        'City': ['New York', 'los angeles', 'CHICAGO', 'Houston'],
        'Salary': ['50,000', '60000', '75,000', 'invalid']
    }
    df = pd.DataFrame(data)

    # Save the DataFrame to a CSV file
    dirty_file_path = 'dag_data/dirty_data.csv'
    df.to_csv(dirty_file_path, index=False)

    return dirty_file_path

@asset
def clean_data(create_dirty_data):
    # Read the dirty CSV file
    df = pd.read_csv(create_dirty_data)

    # Clean the data
    df['Name'] = df['Name'].str.strip()
    df['Age'] = pd.to_numeric(df['Age'], errors='coerce').fillna(df['Age'].mean())
    df['City'] = df['City'].str.upper()
    df['Salary'] = df['Salary'].replace('[\$,]', '', regex=True)
    df['Salary'] = pd.to_numeric(df['Salary'], errors='coerce').fillna(0)

    # Calculate average salary
    avg_salary = df['Salary'].mean()

    # Save the cleaned DataFrame to a new CSV file
    cleaned_file_path = 'dag_data/cleaned_data.csv'
    df.to_csv(cleaned_file_path, index=False)

    return {
        'cleaned_file_path': cleaned_file_path,
        'avg_salary': avg_salary
    }

@asset
def load_cleaned_data(clean_data):
    cleaned_file_path = clean_data['cleaned_file_path']
    avg_salary = clean_data['avg_salary']

    # Read the cleaned CSV file to verify
    df = pd.read_csv(cleaned_file_path)

    print({
        'num_rows': len(df),
        'num_columns': len(df.columns),
        'avg_salary': avg_salary
    })

# Define all assets
all_assets = [create_dirty_data, clean_data, load_cleaned_data]

# Create a job that will materialize all assets
job = define_asset_job("all_assets_job", selection=all_assets)

# Create Definitions object
defs = Definitions(
    assets=all_assets,
    jobs=[job]
)

if __name__ == "__main__":
    result = materialize(all_assets)
    print("Pipeline execution result:", result.success)
Du kannst den Code in einem Jupyter Notebook ausführen oder in eine Python-Datei schreiben und laufen lassen.
Nach der Ausführung erhältst du ausführliche Logs des Workflow-Runs.
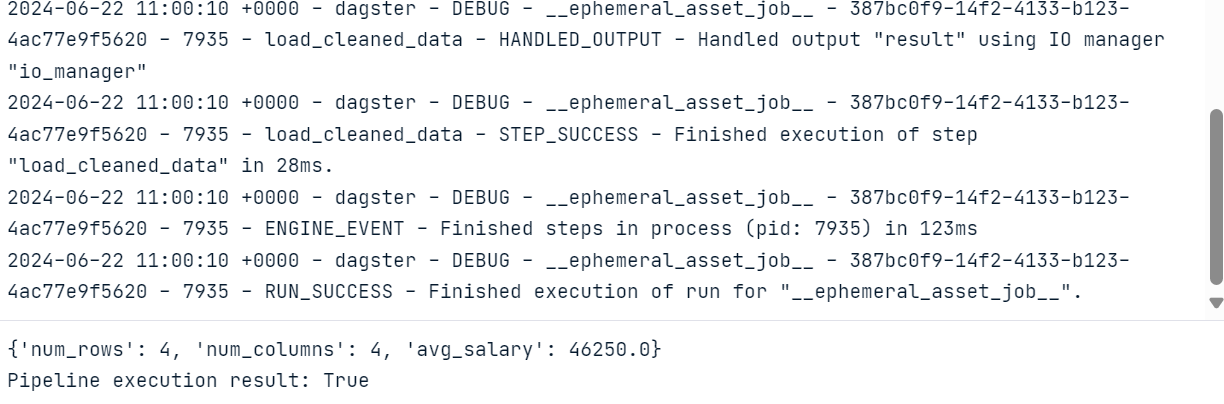
Für die Visualisierung der Assets und Job-Runs installieren und starten wir den Dagster-Webserver. Darüber kannst du Jobs starten, einzelne Assets materialisieren und mehrere Jobs parallel überwachen.
$ pip install dagster-webserverZum Starten nutzen wir die Dagster-CLI und geben den Pfad zur Python-Datei an. In meinem Fall heißt sie dagster_pipe.py.
$ dagster dev -f dagster_pipe.py Der Befehl öffnet den Webserver automatisch im Browser. Alternativ rufst du http://127.0.0.1:3000 direkt auf.
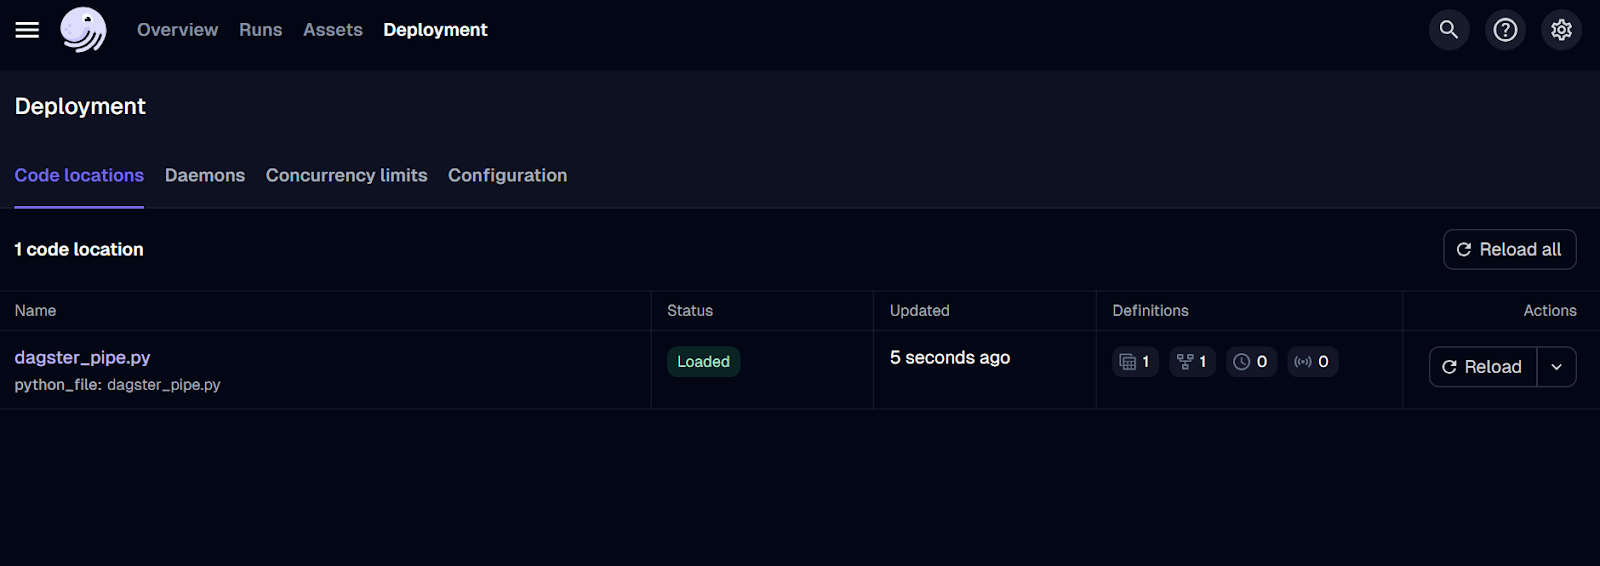
Dagster-Webserver-UI.
Bisher haben wir nur den Job deployt. Um den Workflow zu starten, wechsle in den Tab „Runs“ und klicke auf „Launch a new run“.
Der Run sollte erfolgreich durchlaufen! Für die Logs klickst du auf die ID des entsprechenden Runs.
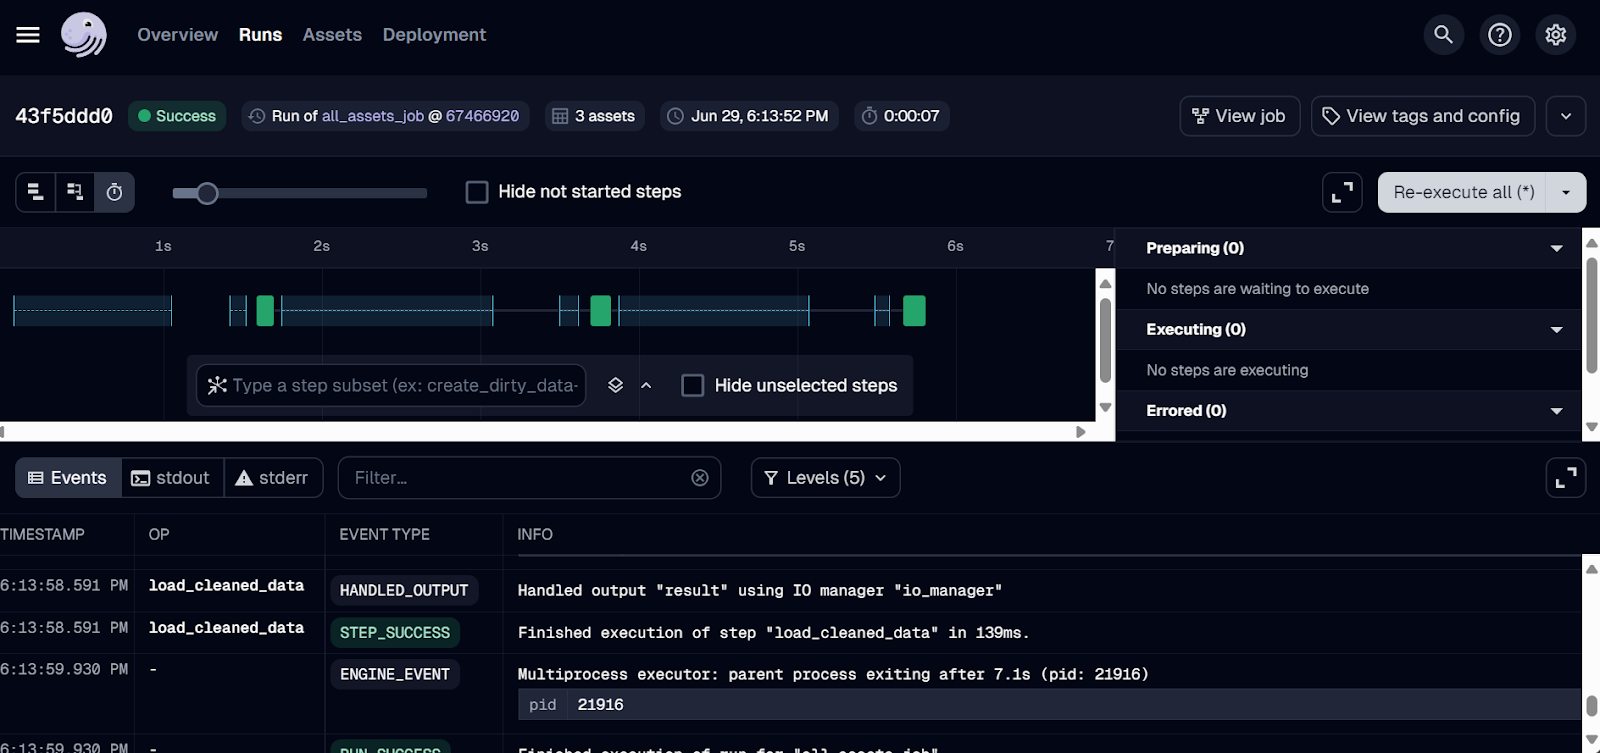
Dagster-Run-Logs.
Mage AI ist ein hybrides Open-Source-Framework für Data Orchestration. Hybrid bedeutet hier: die Flexibilität eines Jupyter Notebooks kombiniert mit der Struktur modularem Codes.
Auch mit wenig Python-Kenntnissen lassen sich Datenpipelines bauen, ausführen und überwachen. Anstatt direkt eine Python-Datei zu schreiben, erstellst du ein Mage-AI-Projekt und arbeitest im Dashboard, wo du Pipelines entwickelst, ausführst und verwaltest.
Im Vergleich zu Airflow punktet Mage AI mit einer sehr nutzerfreundlichen Oberfläche und einfacher Bedienung – ideal für Einsteiger in Data Engineering. Es ist auf Skalierbarkeit ausgelegt und meistert große Datenmengen sowie komplexe Pipeline-Strukturen effizient.
Es fühlte sich ungewohnt an, weil der Ansatz ganz anders ist als das, was ich kenne. Ich musste die Mage-AI-Weboberfläche installieren und starten. Eigentlich sollte alles leicht von der Hand gehen, aber das Erstellen und Ausführen der ETL-Pipeline fand ich zunächst schwierig. Andererseits verstehe ich, warum das Design Einsteigern entgegenkommt: Vieles funktioniert per Drag & Drop und Klick.
Abid Ali Awan, Author
Der Start mit Mage AI ist recht einfach. Zuerst installieren wir das Python-Package.
$ pip install mage-aiUnd starten anschließend das Mage-AI-Projekt.
$ mage start mage_ai_etl Der obige Befehl startet den Webserver. Wie erwähnt, erfolgen Code-Editing, Job-Starts und Monitoring vollständig über die Mage-AI-UI.
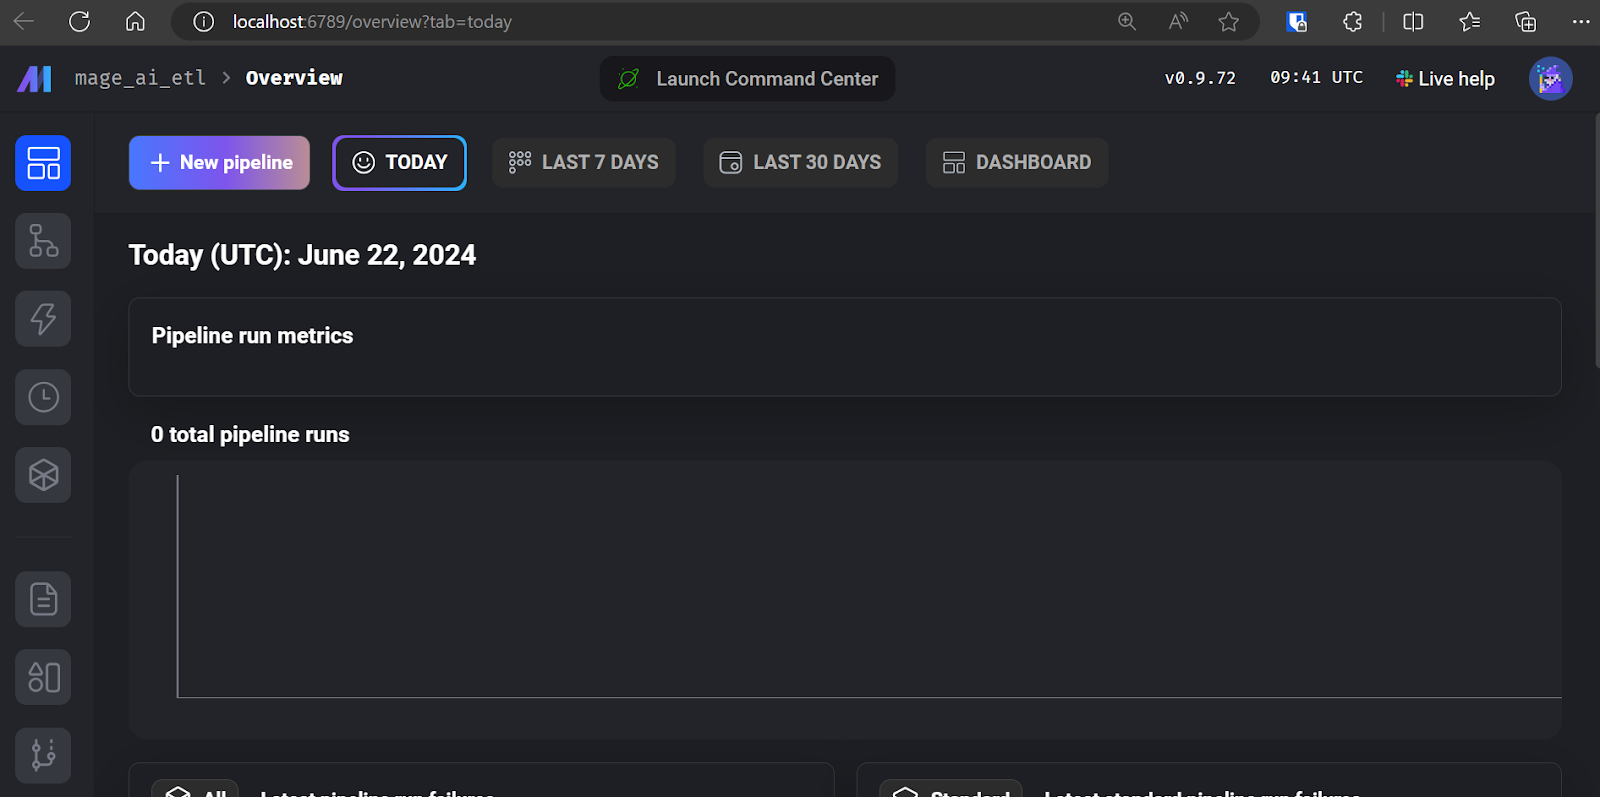
Mage-AI-UI.
Klicke auf „+ New pipeline“, um deine erste ETL-Pipeline zu erstellen. Ich habe meine „simple_etl“ genannt.
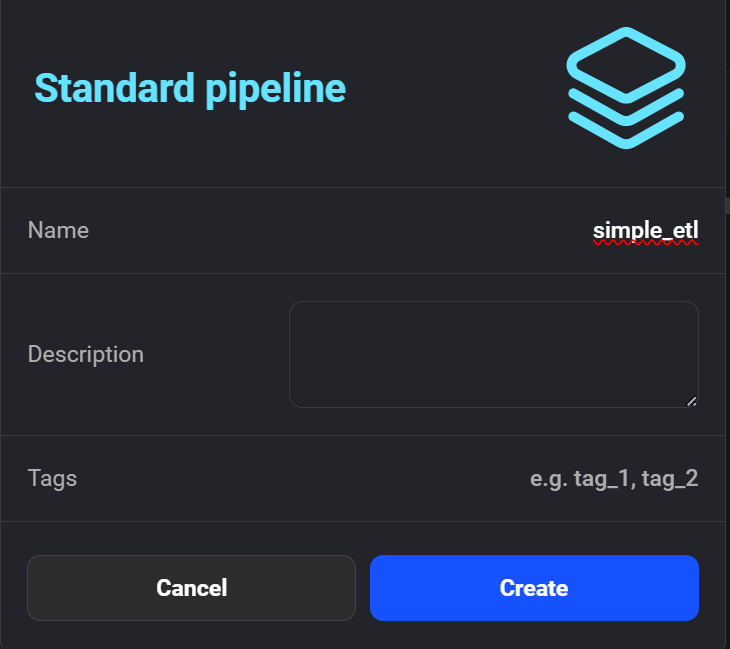
Neue Pipeline in Mage AI erstellen.
Anschließend fordert dich die Oberfläche auf, ein Modul hinzuzufügen. Wähle „Data Loader“ und füge den folgenden Python-Code ein.
Hier definieren wir die Funktion create_sample_csv() als ersten Pipeline-Schritt mit dem Mage-AI-@data_loader-Decorator. Zudem prüfen wir mit test_output(), ob es ein Ergebnis gibt – hilfreich für die Abhängigkeitssteuerung.
import io
import pandas as pd

if 'data_loader' not in globals():
    from mage_ai.data_preparation.decorators import data_loader
if 'test' not in globals():
    from mage_ai.data_preparation.decorators import test

@data_loader
def create_sample_csv() -> pd.DataFrame:
    """
    Create a sample CSV file with duplicates and missing values
    """
    csv_data = """
category,product,quantity,price
Electronics,Laptop,5,1000
Electronics,Smartphone,10,500
Clothing,T-shirt,50,20
Clothing,Jeans,30,50
Books,Novel,100,15
Books,Textbook,20,80
Electronics,Laptop,5,1000
Clothing,T-shirt,,20
Electronics,Tablet,,300
Books,Magazine,25,
"""
    return pd.read_csv(io.StringIO(csv_data.strip()))

@test
def test_output(df) -> None:
    """
    Template code for testing the output of the block.
    """
    assert df is not None, 'The output is undefined'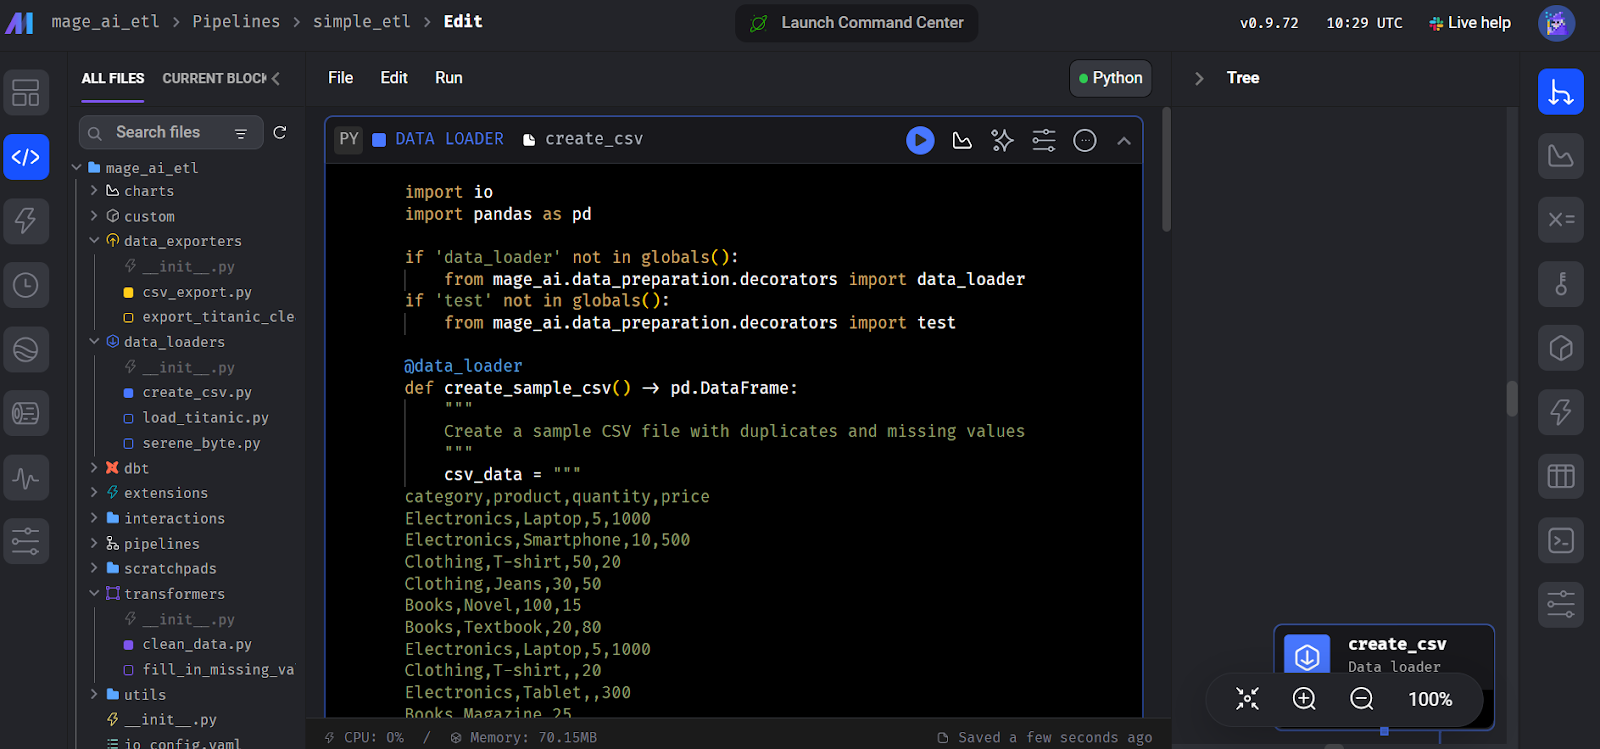
Data-Loader-Block in Mage AI erstellen.
Erstelle nun ein weiteres Modul „Transformer“ und füge die Funktion clean_data() ein, wie unten gezeigt.
Die Funktion test() ist optional – wichtig ist die Transformationsfunktion clean_data().
import pandas as pd

if 'transformer' not in globals():
    from mage_ai.data_preparation.decorators import transformer
if 'test' not in globals():
    from mage_ai.data_preparation.decorators import test

@transformer
def clean_data(df: pd.DataFrame) -> pd.DataFrame:
    """
    Clean and transform the data
    """
    # Remove duplicates
    df = df.drop_duplicates()
    # Fill missing values with 0
    df = df.fillna(0)
    return df

@test
def test_output(df) -> None:
    """
    Template code for testing the output of the block.
    """
    assert df is not None, 'The output is undefined'
Erstelle analog ein Modul „Data Exporter“ und füge folgenden Code ein. Die Funktion export_data_to_csv() speichert die transformierten Daten als CSV-Datei.
import pandas as pd

if 'data_exporter' not in globals():
    from mage_ai.data_preparation.decorators import data_exporter

@data_exporter
def export_data_to_csv(df: pd.DataFrame) -> None:
    """
    Export the processed data to a CSV file
    """
    df.to_csv('output_data.csv', index=False)
    print("Data exported successfully to output_data.csv")
Zum Ausführen wechsle in den Tab „Trigger“ und klicke auf „Run@once“.
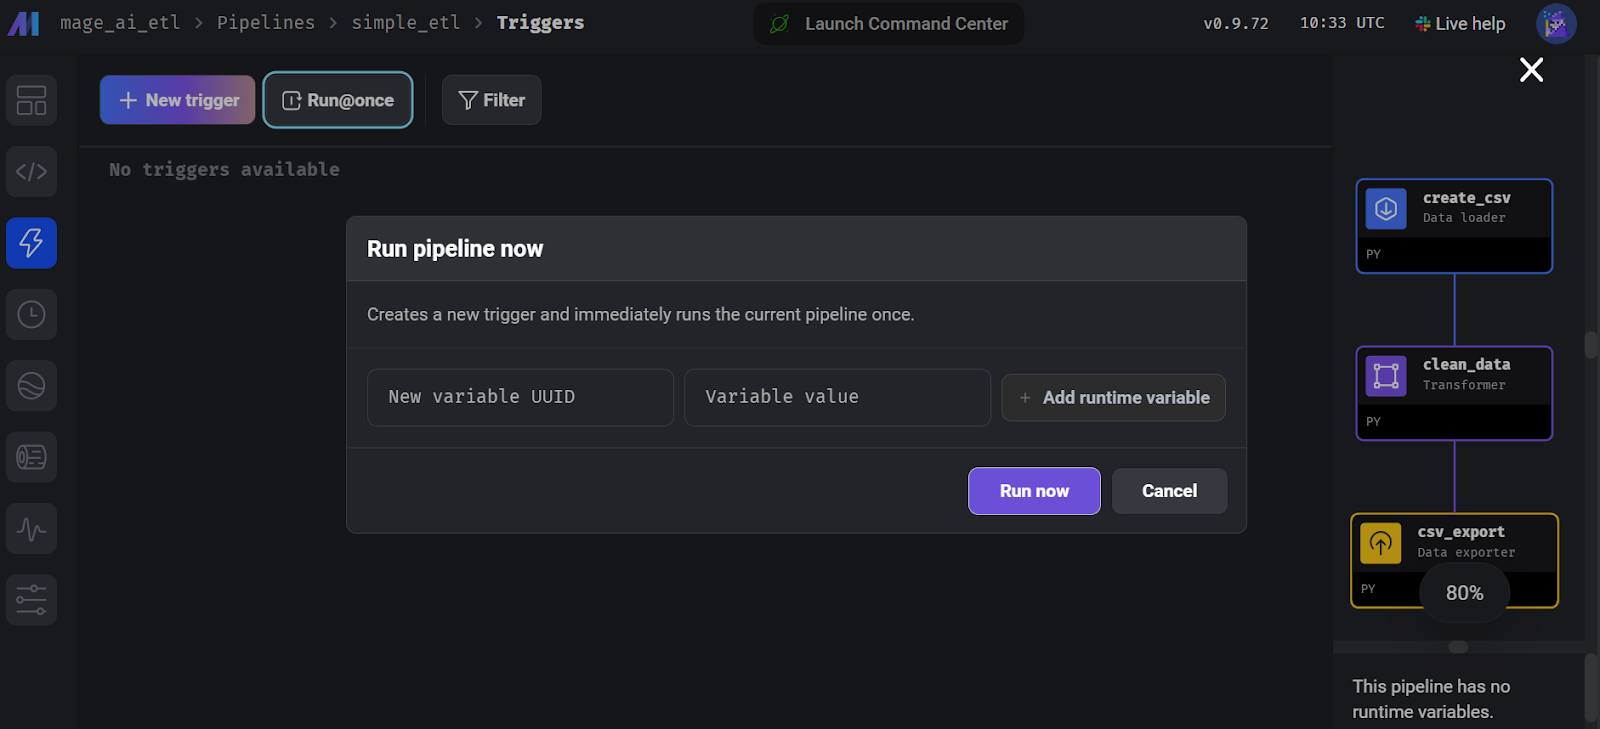
Pipeline in Mage AI ausführen.
Die Run-Logs findest du im Tab „Runs“. Klicke dort beim letzten Run auf „Logs“.
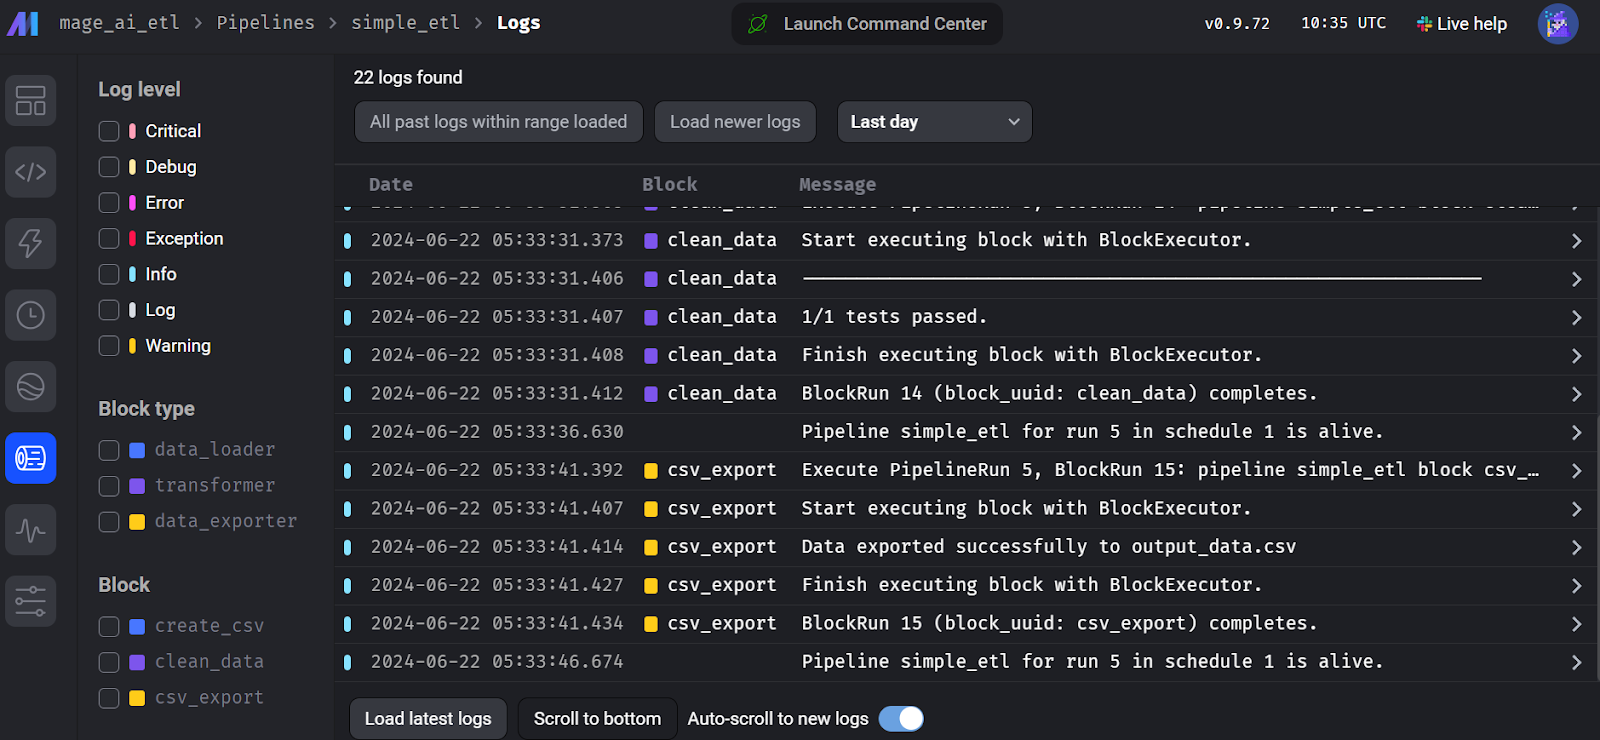
Mage-AI-Flow-Logs.
Kedro ist ein weiteres populäres Open-Source-Orchestrierungsframework, das sich etwas von den anderen Tools unterscheidet. Es wurde für Machine-Learning-Engineers entwickelt und überträgt viele Best Practices aus der Softwareentwicklung auf ML-Projekte.
Kedro ist stark modularisiert. Selbst für das Exportieren eines Datasets legst du einen Data Catalog an, der Speicherort und Datentyp festlegt – für standardisierte, effiziente Datenverwaltung entlang der gesamten Pipeline.
Um Kedros Rolle im ML-Ökosystem einzuordnen, lohnt sich ein Blick auf verschiedene MLOps-Tools im Artikel 25 Top MLOps Tools You Need to Know in 2024.
Gegenüber Airflow ist die Kedro-API zum Bau einer Pipeline einfacher. Der Fokus liegt auf ML-Engineering sowie Datenkatalogisierung und -versionierung.
Das Coden ist recht geradlinig, die Herausforderungen beginnen bei der Ausführung: Du brauchst einen Data Catalog, musst die Pipeline registrieren und die Kedro-Projektstruktur verstehen. Insgesamt anspruchsvoller als Dagster und Prefect – aber sinnvoll, um Pipelines robust und fehlerarm zu machen.
Abid Ali Awan, Author
Eine Kedro-Pipeline zu bauen, ist ein anderes Spiel. Das Framework ist modular und du solltest Projektstruktur und Abläufe kennen, um den Workflow sauber auszuführen.
Installiere zunächst das Kedro-Python-Package.
$ pip install kedroInitialisiere anschließend das Kedro-Projekt.
$ kedro new --name=kedro_etl --tools=none --example=n Wechsle ins Projektverzeichnis.
$ cd kedro-etl Erstelle innerhalb des Ordners pipelines den Unterordner data_processing.
$ mkdir -p src/kedro_etl/pipelines/data_processing Lege die Datei kedro_pipe.py an und öffne sie in deinem Editor, zum Beispiel Visual Studio Code.
$ code src/kedro_etl/pipelines/data_processing/kedro_pipe.pyDas Skript enthält die Funktionen für Extract, Transform und Load – in Kedro „Nodes“: create_sample_data(), clean_data(), und load_and_process_data().
Dann verknüpfen wir die Nodes mit der Kedro-Klasse Pipeline in der Funktion create_pipeline(). Jede Node hat inputs, outputs und einen name.
import pandas as pd
import numpy as np
from kedro.pipeline import Pipeline, node

def create_sample_data():
    data = {
        'id': range(1, 101),
        'name': [f'Person_{i}' for i in range(1, 101)],
        'age': np.random.randint(18, 80, 100),
        'salary': np.random.randint(20000, 100000, 100),
        'missing_values': [np.nan if i % 10 == 0 else i for i in range(100)]
    }
    return pd.DataFrame(data)

def clean_data(df: pd.DataFrame):
    # Remove rows with missing values
    df_cleaned = df.dropna()

    # Convert salary to thousands
    df_cleaned['salary'] = df_cleaned['salary'] / 1000

    # Capitalize names
    df_cleaned['name'] = df_cleaned['name'].str.upper()

    return df_cleaned

def load_and_process_data(df: pd.DataFrame):
    # Calculate average salary
    avg_salary = df['salary'].mean()

    # Add a new column for salary category
    df['salary_category'] = df['salary'].apply(
        lambda x: 'High' if x > avg_salary else 'Low')

    # Calculate age groups
    df['age_group'] = pd.cut(df['age'], bins=[0, 30, 50, 100], labels=[
                             'Young', 'Middle', 'Senior'])

    print(df)
    return df

def create_pipeline(**kwargs):
    return Pipeline(
        [
            node(
                func=create_sample_data,
                inputs=None,
                outputs="raw_data",
                name="create_sample_data_node",
            ),
            node(
                func=clean_data,
                inputs="raw_data",
                outputs="cleaned_data",
                name="clean_data_node",
            ),
            node(
                func=load_and_process_data,
                inputs="cleaned_data",
                outputs="processed_data",
                name="load_and_process_data_node",
            ),
        ]
    )
Ohne Data Catalog werden die Daten beim Run nicht exportiert. Ergänze daher die Datei conf/base/catalog.yml um folgende Dataset-Konfiguration.
raw_data:
  type: pandas.CSVDataset
  filepath: ./data/kedro/sample_data.csv

cleaned_data:
  type: pandas.CSVDataset
  filepath: ./data/kedro/cleaned_data.csv

processed_data:
  type: pandas.CSVDataset
  filepath: ./data/kedro/processed_data.csv
Außerdem musst du die neue Python-Datei im Pipeline-Register eintragen. Öffne dazu src/simple_etl/pipeline_registry.py und füge den folgenden Code hinzu.
"""Project pipelines."""
from __future__ import annotations

from kedro.pipeline import Pipeline
from kedro_etl.pipelines.data_processing import kedro_pipe

def register_pipelines() -> Dict[str, Pipeline]:
    data_processing_pipeline = kedro_pipe.create_pipeline()

    return {
        "__default__": data_processing_pipeline,
        "data_processing": data_processing_pipeline,
    }
Starte die Pipeline und sieh dir die Live-Logs im Terminal an:
$ kedro run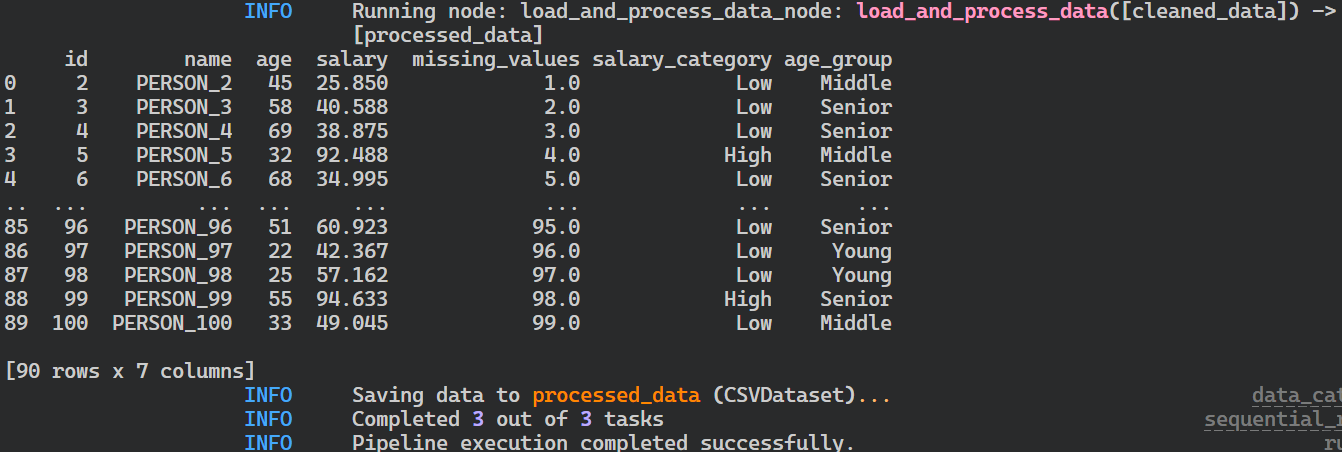
Logs des Kedro-Pipeline-Runs.
Nach dem Run findest du die Dateien als CSV an den im Data Catalog definierten Pfaden.
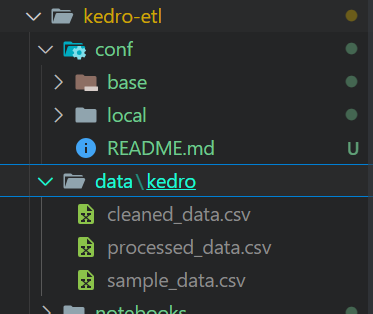
Ausgabedateien des Kedro-Runs.
Wenn es Probleme beim Ausführen gibt, installiere Kedro mit allen Erweiterungen.
$ pip install "kedro[all]"Zur Visualisierung und zum Teilen der Pipelines installieren wir das Tool kedro-viz.
$ pip install kedro-vizMit folgendem Befehl visualisierst du alle Pipelines und Daten-Nodes. Außerdem gibt es Experiment-Tracking und die Möglichkeit, die Visualisierung zu teilen.
$ kedro viz run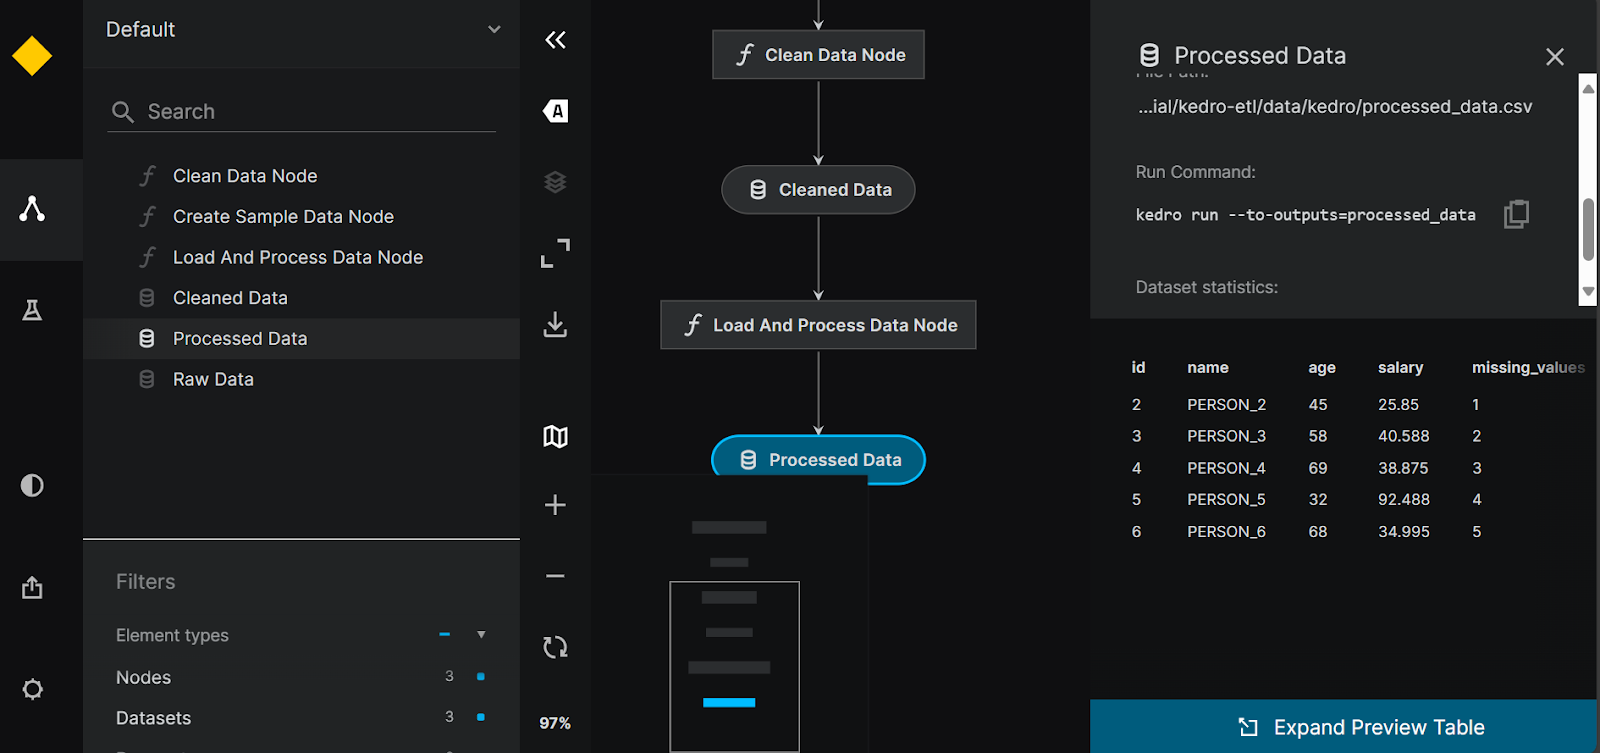
Kedro-Pipeline-Visualisierung.
Luigi ist ein Open-Source-Framework auf Python-Basis, entwickelt von Spotify. Es glänzt beim Management langlaufender Batch-Prozesse und komplexer Pipelines. Stärken sind Abhängigkeitsauflösung, Workflow-Management, Visualisierung und Fehlerbehandlung – ideal für die Orchestrierung von Datenworkflows.
Im Vergleich zu Airflow bietet Luigi eine schlanke API, Kalenderplanung und eine engagierte Community, die bei Orchestrierungsfragen unterstützt.
Wenn du Python-Einsteiger bist, kann der Bau und die Ausführung von Pipelines herausfordernd sein. Allerdings helfen Doku und Guides beim schnellen Einstieg. Die Logs sind eher knapp, und das Dashboard dient primär zur Visualisierung von DAGs und Abhängigkeiten.
Abid Ali Awan, Author
Für eine Luigi-Pipeline brauchst du ein Grundverständnis von objektorientierter Programmierung. Installieren wir zunächst das Luigi-Package.
$ pip install luigiFür eine einfache ETL-Pipeline in Luigi erstellen wir miteinander verknüpfte Tasks. Statt Funktionen werden Klassen für die einzelnen Schritte definiert: FetchData, ProcessData und GenerateReport. Jede Klasse besitzt die Methoden requires(), output() und run().
Über requires() und output() werden Tasks verbunden, während run() die Logik ausführt. Abschließend bauen wir die Pipeline über den letzten Task.
import luigi
import pandas as pd
import numpy as np

class FetchData(luigi.Task):
    def output(self):
        return luigi.LocalTarget('data/fetch_data.csv')

    def run(self):
        # Simulate fetching data by creating a sample CSV file
        data = {
            'column1': [1, 2, np.nan, 4],
            'column2': ['A', 'B', 'C', np.nan]
        }
        df = pd.DataFrame(data)
        df.to_csv(self.output().path, index=False)

class ProcessData(luigi.Task):
    def requires(self):
        return FetchData()

    def output(self):
        return luigi.LocalTarget('data/process_data.csv')

    def run(self):
        df = pd.read_csv(self.input().path)
        # Fill missing values
        df['column1'].fillna(df['column1'].mean(), inplace=True)
        df['column2'].fillna('B', inplace=True)
        df.to_csv(self.output().path, index=False)

class GenerateReport(luigi.Task):
    def requires(self):
        return ProcessData()

    def output(self):
        return luigi.LocalTarget('data/generate_report.txt')

    def run(self):
        df = pd.read_csv(self.input().path)
        # Simple data analysis: calculate mean of column1 and value counts of column2
        mean_column1 = df['column1'].mean()
        value_counts_column2 = df['column2'].value_counts()

        with self.output().open('w') as out_file:
            out_file.write(f'Mean of column1: {mean_column1}\n')
            out_file.write('Value counts of column2:\n')
            out_file.write(value_counts_column2.to_string())

if __name__ == '__main__':
    luigi.build([GenerateReport()], local_scheduler=True)
Führe den Code im Jupyter Notebook aus oder als Python-Datei über das Terminal.
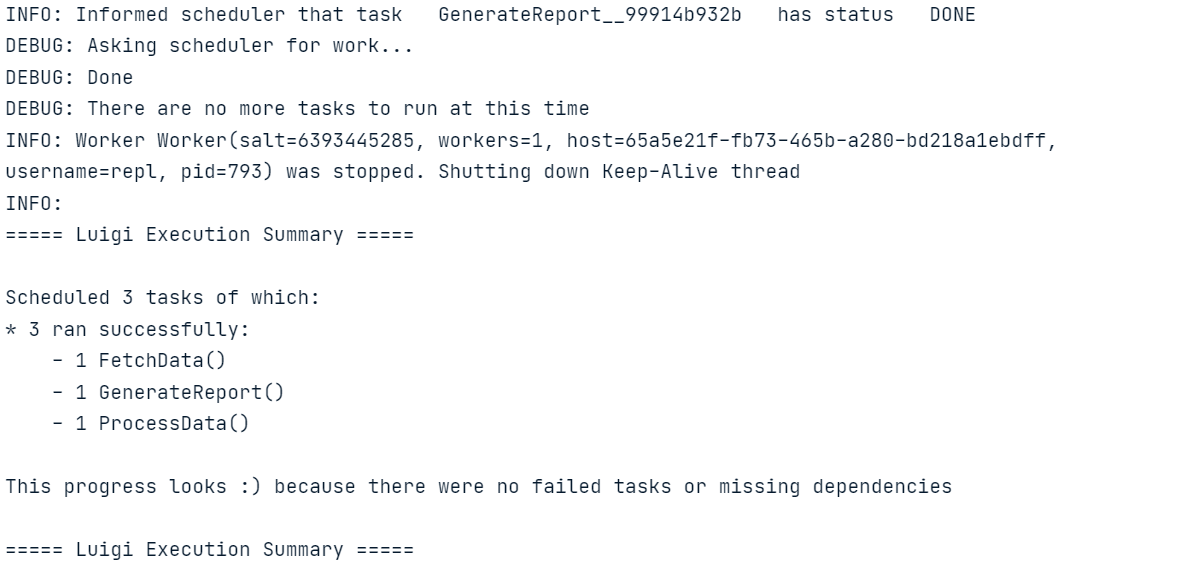
Ähnlich wie bei Luigi kannst du auch lernen, eine ETL-Pipeline mit Apache Airflow zu bauen. Das Tutorial behandelt die Grundlagen von Extract, Transform und Load mit Airflow.
Um Pipeline-Runs zu planen oder per Event zu starten, benötigen wir den Luigi Central Planner.
Starte den Scheduler mit folgendem Befehl:
$ luigid 2024-06-22 13:35:18,636 luigi[25056] INFO: logging configured by default settings
2024-06-22 13:35:18,636 luigi.scheduler[25056] INFO: No prior state file exists at /var/lib/luigi-server/state.pickle. Starting with empty state
2024-06-22 13:35:18,640 luigi.server[25056] INFO: Scheduler starting upZum Ausführen der Pipeline öffne ein neues Terminal und nutze diesen Befehl. Er erwartet den Dateinamen und den letzten Task der Pipeline. In unserem Fall heißt die Datei luigi_pipe.py und der letzte Task ist GenerateReport.
$ python -m luigi --module luigi_pipe GenerateReportZur Visualisierung von Runs und Task-Status rufe einfach http://localhost:8082 in deinem Browser auf.
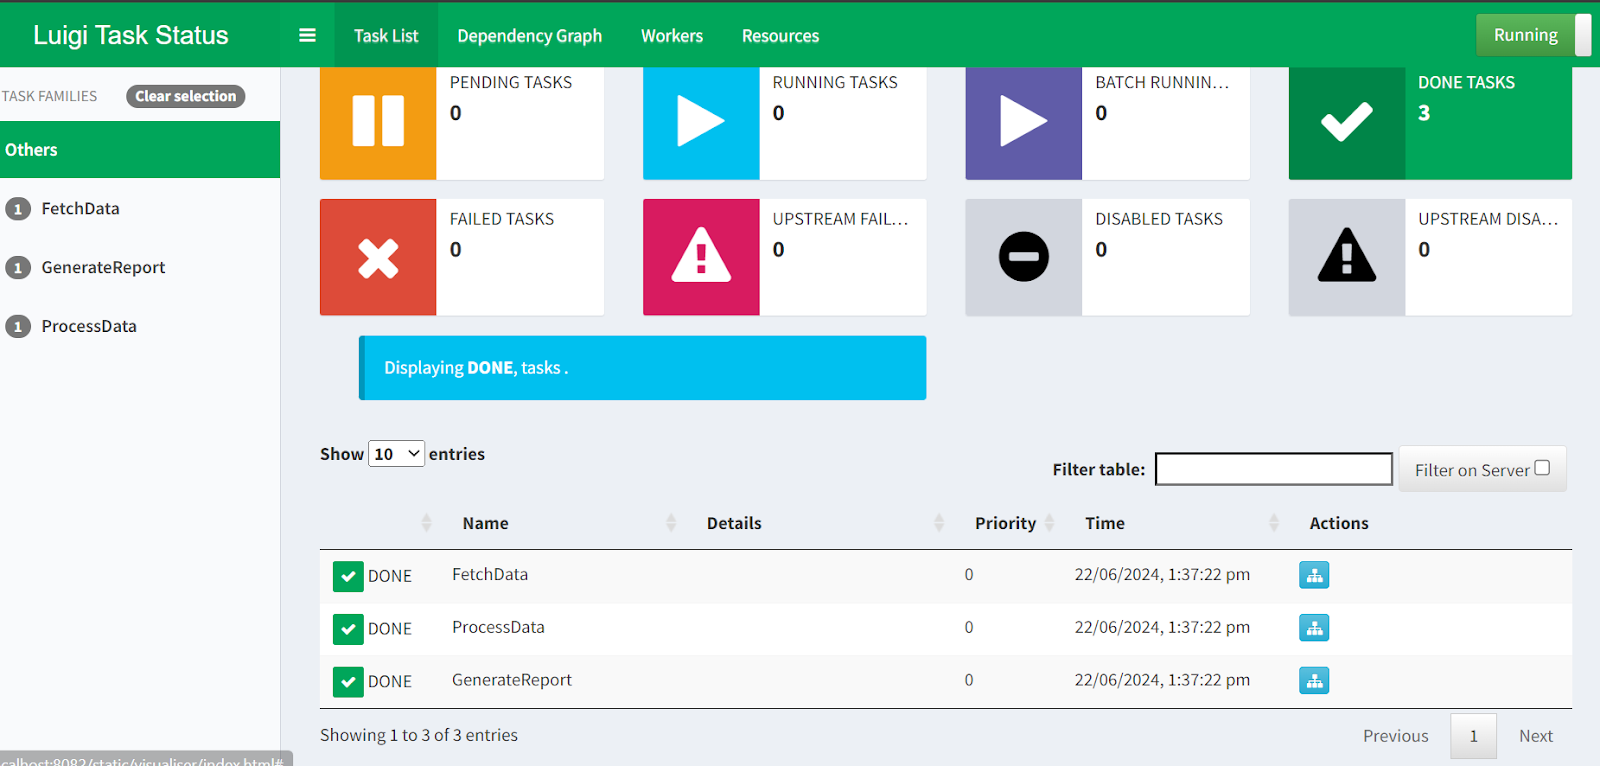
Luigi Central Planner Web-UI.
Damit sind wir mit den fünf besten Alternativen zu Airflow durch! Wenn du tiefer in die Beispiele einsteigen möchtest, sieh dir diese Ressourcen an:
In diesem Tutorial haben wir die wichtigsten Open-Source-Alternativen zu Airflow vorgestellt. Für jedes Tool haben wir zudem eine einfache ETL-Pipeline gebaut und ausgeführt. Die Codebeispiele helfen dir einzuschätzen, welches Tool für deinen Use Case am besten passt.
Für Einsteiger empfehle ich Prefect oder Mage AI: benutzerfreundlich und schnell eingerichtet. Suchst du Tools mit stärkerem Software-Engineering-Fokus, schau dir Dagster, Kedro und Luigi an.
Als nächster Schritt auf deinem Data-Engineering-Weg bietet sich eine Zertifizierung wie DataCamps Data Engineer in Python an. Dort lernst du weitere Tools kennen und baust eine End-to-End-Datenpipeline, die du in Produktion bringen kannst.
Vertiefe dein Wissen im Data Engineering mit diesen Kursen!
Kurs
Lernpfad
Kurs
Blog
Nisha Arya Ahmed
15 Min.
Tutorial
Matt Crabtree
5 Min.
Tutorial
Kurtis Pykes
15 Min.
Tutorial
Sejal Jaiswal
9 Min.
Tutorial
DataCamp Team
3 Min.
Tutorial
Allan Ouko
11 Min.



