Curso
Introdução à Engenharia de Dados
4 h
129.7K
Imagem do autor.
Apache Airflow é uma popular ferramenta open source de orquestração de dados, criada para construir, agendar e monitorar pipelines de dados. Ela conta com um dashboard que ajuda a gerenciar o estado dos workflows, tornando-se uma ótima opção para a maioria das necessidades de orquestração.
Apesar disso, o Airflow deixa a desejar em alguns recursos que podem ser vitais para requisitos modernos e complexos de orquestração de dados.
Neste tutorial, vamos explorar cinco alternativas ao Airflow que oferecem capacidades aprimoradas e cobrem algumas de suas limitações. Além disso, vamos criar um pipeline ETL simples em cada ferramenta, executá-lo e visualizá-lo em seus respectivos dashboards.
O Airflow é poderoso para vários workflows de dados, mas tem limitações que podem levar empresas a considerar alternativas.
Alguns motivos para optar por outra solução:
Antes de partir para o código de outras ferramentas de orquestração, vale aprender a escrever um pipeline de dados no Apache Airflow seguindo o Getting started with Apache Airflow para poder comparar as alternativas com justiça.
Se você é totalmente novo em Airflow, considere fazer o curso rápido Introduction to Airflow in Python para aprender o básico de construção e agendamento de pipelines de dados.
Agora, vamos apresentar as 5 principais alternativas ao Airflow e mostrar como usá-las com exemplos práticos de código.
Prefect é uma ferramenta open source de orquestração de workflows em Python, feita para engenheiros de dados e de machine learning modernos. Ela oferece uma API simples para você montar um pipeline rapidamente e gerenciá-lo por um dashboard interativo.
O Prefect oferece um modelo híbrido de execução: você pode implantar o workflow na nuvem e executá-lo lá ou usar o repositório local.
Em comparação ao Airflow, o Prefect traz recursos avançados como dependências de tarefas automatizadas, gatilhos orientados a eventos, notificações nativas, infraestrutura específica por workflow e compartilhamento de dados entre tarefas. Esses recursos tornam a solução poderosa para gerenciar workflows complexos de forma eficiente.
O Prefect é simples e vem com recursos poderosos. Levei basicamente 5 minutos para rodar o código de exemplo. Curti especialmente o design do dashboard, como dá para configurar notificações, reexecutar pipelines e gerenciar e monitorar tudo pela interface.
Abid Ali Awan, Author
Leia o blog Airflow vs Prefect: deciding which is right for your data workflow para conhecer uma comparação detalhada entre essas duas ferramentas de orquestração de dados.
Vamos iniciar o projeto com Prefect instalando o pacote Python. Rode o comando abaixo no terminal.
$ pip install -U prefectDepois, crie um script Python chamado prefect_etl.py e adicione o código a seguir.
from prefect import task, flow
import pandas as pd

# Extract data
@task
def extract_data():
    # Simulating data extraction
    data = {
        "name": ["Alice", "Bob", "Charlie"],
        "age": [25, 30, 35],
        "city": ["New York", "Los Angeles", "Chicago"]
    }
    df = pd.DataFrame(data)
    return df

# Transform data
@task
def transform_data(df: pd.DataFrame):
    # Example transformation: adding a new column
    df["age_plus_ten"] = df["age"] + 10
    return df

# Load data
@task
def load_data(df: pd.DataFrame):
    # Simulating data load
    print("Loading data to target destination:")
    print(df)

# Defining the flow
@flow(log_prints=True)
def etl():
    raw_data = extract_data()
    transformed_data = transform_data(raw_data)
    load_data(transformed_data)

# Running the flow
if __name__ == "__main__":
    etl()
O código acima define as funções de tarefa extract_data(), transform_data() e load_data() e as executa em série dentro de um flow chamado etl(). As funções são criadas com decorators do Prefect em Python.
Em resumo, criamos um DataFrame do pandas, transformamos e exibimos o resultado final com print. É uma forma simples de simular um pipeline ETL.
Para executar o workflow, basta rodar o script Python com o comando abaixo.
$ python prefect_etl.py Como vemos, a execução do workflow foi concluída com sucesso.
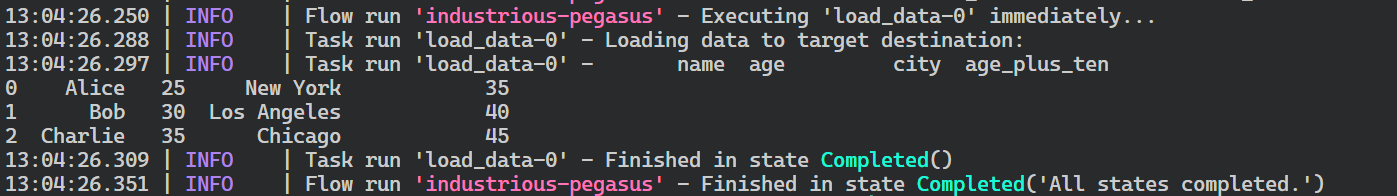
Logs de execução do flow no Prefect.
Agora vamos fazer o deploy do workflow para executá-lo com agendamento ou dispará-lo por evento. O deploy também permite monitorar e gerenciar múltiplos workflows de forma centralizada.
Para implantar o flow, vamos usar o CLI do Prefect. A função deploy requer o nome do arquivo Python, o nome da função do flow no arquivo e o nome da implantação. Aqui, chamamos a implantação de “simple_etl”.
$ prefect deploy prefect_etl.py:etl -n 'simple_etl'Após rodar o comando, você pode receber a mensagem de que não há um pool de workers para executar a implantação. Para criar o pool, use o comando a seguir.
$ prefect worker start --pool 'datacamp'Com o worker pool pronto, abra outro terminal e execute a implantação. O comando prefect deployment run requer “<nome-da-funcao-do-flow>/<nome-da-implantacao>” como argumento, conforme abaixo.
$ prefect deployment run 'etl/simple_etlAo executar a implantação, você verá a mensagem de que o workflow está rodando. Normalmente, o flow run criado recebe um nome aleatório, no meu caso witty-lorikeet.
Creating flow run for deployment 'etl/simple_etl'...
Created flow run 'witty-lorikeet'.
└── UUID: 4e0495b0-9c7e-4ed8-b9ab-5160994dc7f0
└── Parameters: {}
└── Job Variables: {}
└── Scheduled start time: 2024-06-22 14:05:01 PKT (now)
└── URL: <no dashboard available>
Para ver o log completo, volte ao terminal onde você iniciou o pool de workers.
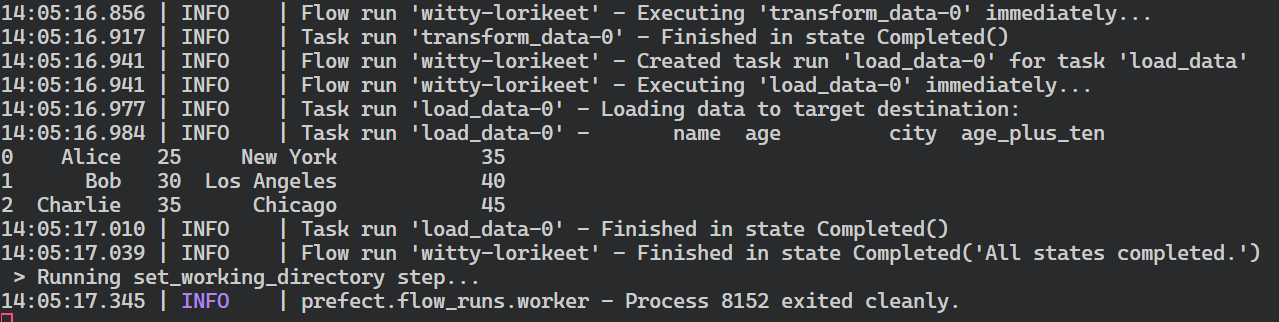
Resumo da execução do flow no Prefect.
Para visualizar a execução do flow de forma mais amigável e gerenciar outros workflows, você precisa iniciar o servidor web do Prefect.
$ prefect server start Após executar o comando, você deve ser redirecionado ao dashboard do Prefect. Como alternativa, acesse diretamente http://127.0.0.1:4200 no navegador.
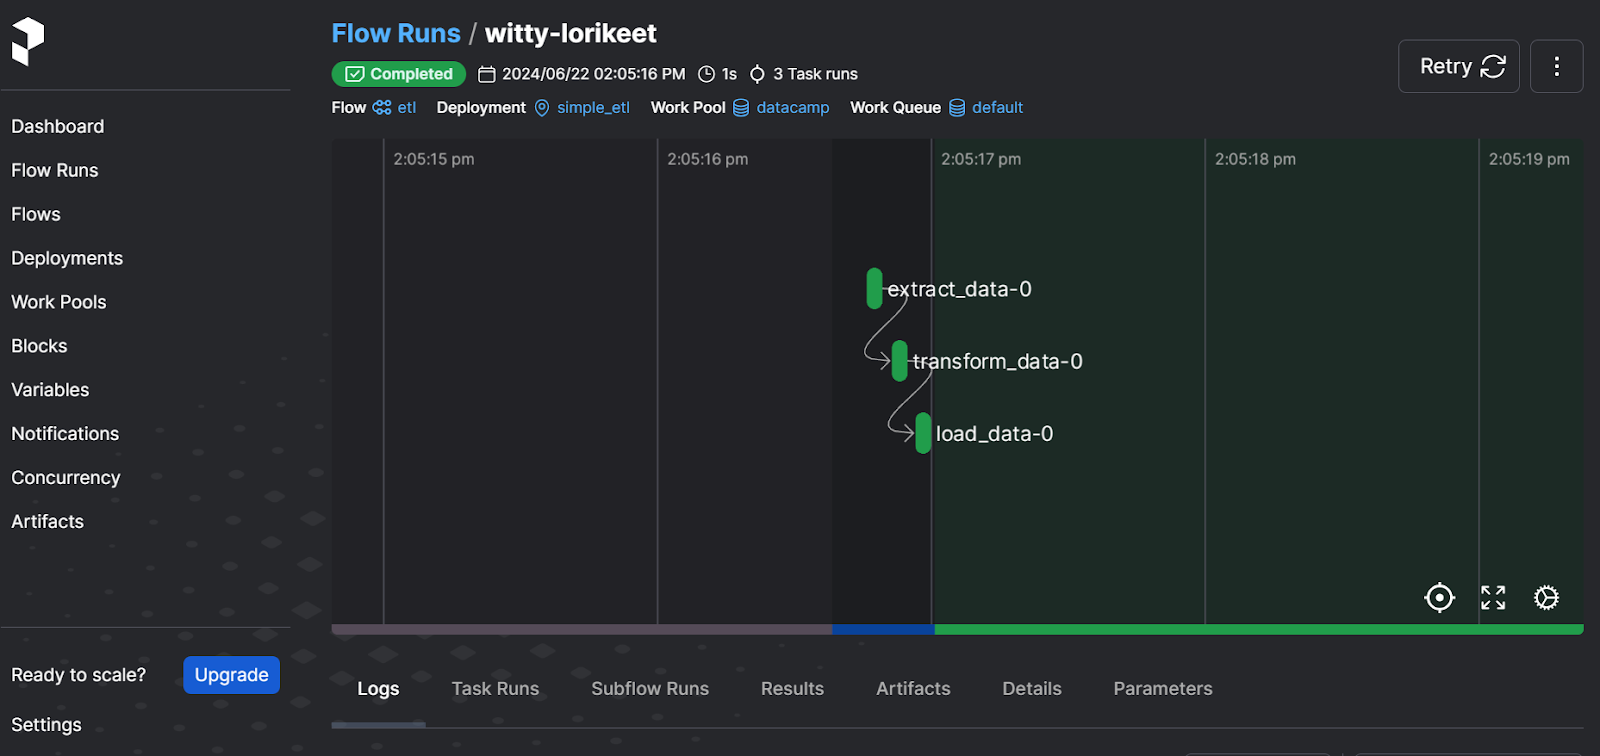
Interface do servidor web do Prefect
No dashboard, você pode reexecutar o workflow, ver logs, checar pools de trabalho, configurar notificações e acessar outras opções avançadas. É uma solução completa para orquestração de dados moderna.
Para aprender a construir e executar pipelines de machine learning com Prefect, siga o tutorial Using Prefect for Machine Learning Workflows.
Dagster é um framework open source para engenheiros de dados definirem, agendarem e monitorarem pipelines. É altamente escalável e facilita a colaboração entre diferentes times de dados.
O Dagster permite definir ativos de dados como funções Python usando decorators. Depois de definidos, você pode executá-los via agendamentos ou gatilhos baseados em eventos.
Em relação ao Airflow, o Dagster facilita desenvolver, testar e revisar o pipeline localmente, adota uma abordagem baseada em ativos para orquestração e é nativo de nuvem e contêineres.
Em vez de pensar o workflow em termos de passos e fluxos, precisei mudar a mentalidade e construir o pipeline com ativos de dados. Fora isso, criar e executar um ETL simples foi bem tranquilo. O webserver é minimalista, mas traz tudo para monitorar ativos, execuções e implantações.
Abid Ali Awan, Author
Vamos criar um pipeline ETL simples, executá-lo e visualizá-lo pelo servidor web do Dagster. Assim como no dashboard do Prefect, o servidor web do Dagster oferece formas centralizadas de monitorar múltiplos workflows e agendar execuções e ativos.
Comece instalando o pacote Python.
$ pip install dagster -qEm seguida, vamos criar três funções Python para extrair, transformar e carregar os dados. No código, elas se chamam create_dirty_data(), clean_data() e load_cleaned_data(). Usando o decorator @asset, vamos declará-las como ativos de dados no Dagster.
Depois, criaremos o job de ativos (variável job) usando todos os ativos (variável all_assets) e então a definição de ativos (variável defs).
Você pode pular a parte da definição, mas ela é importante para agendar execuções, rodar múltiplos jobs e configurar sensores.
import pandas as pd
import numpy as np
from dagster import asset, Definitions, define_asset_job, materialize

@asset
def create_dirty_data():
    # Create a sample DataFrame with dirty data
    data = {
        'Name': [' John Doe ', 'Jane Smith', 'Bob Johnson ', '  Alice Brown'],
        'Age': [30, np.nan, 40, 35],
        'City': ['New York', 'los angeles', 'CHICAGO', 'Houston'],
        'Salary': ['50,000', '60000', '75,000', 'invalid']
    }
    df = pd.DataFrame(data)

    # Save the DataFrame to a CSV file
    dirty_file_path = 'dag_data/dirty_data.csv'
    df.to_csv(dirty_file_path, index=False)

    return dirty_file_path

@asset
def clean_data(create_dirty_data):
    # Read the dirty CSV file
    df = pd.read_csv(create_dirty_data)

    # Clean the data
    df['Name'] = df['Name'].str.strip()
    df['Age'] = pd.to_numeric(df['Age'], errors='coerce').fillna(df['Age'].mean())
    df['City'] = df['City'].str.upper()
    df['Salary'] = df['Salary'].replace('[\$,]', '', regex=True)
    df['Salary'] = pd.to_numeric(df['Salary'], errors='coerce').fillna(0)

    # Calculate average salary
    avg_salary = df['Salary'].mean()

    # Save the cleaned DataFrame to a new CSV file
    cleaned_file_path = 'dag_data/cleaned_data.csv'
    df.to_csv(cleaned_file_path, index=False)

    return {
        'cleaned_file_path': cleaned_file_path,
        'avg_salary': avg_salary
    }

@asset
def load_cleaned_data(clean_data):
    cleaned_file_path = clean_data['cleaned_file_path']
    avg_salary = clean_data['avg_salary']

    # Read the cleaned CSV file to verify
    df = pd.read_csv(cleaned_file_path)

    print({
        'num_rows': len(df),
        'num_columns': len(df.columns),
        'avg_salary': avg_salary
    })

# Define all assets
all_assets = [create_dirty_data, clean_data, load_cleaned_data]

# Create a job that will materialize all assets
job = define_asset_job("all_assets_job", selection=all_assets)

# Create Definitions object
defs = Definitions(
    assets=all_assets,
    jobs=[job]
)

if __name__ == "__main__":
    result = materialize(all_assets)
    print("Pipeline execution result:", result.success)
Rode o código acima em um Jupyter Notebook ou crie um arquivo Python e execute-o.
Ao executar, você verá um log completo da execução do workflow.
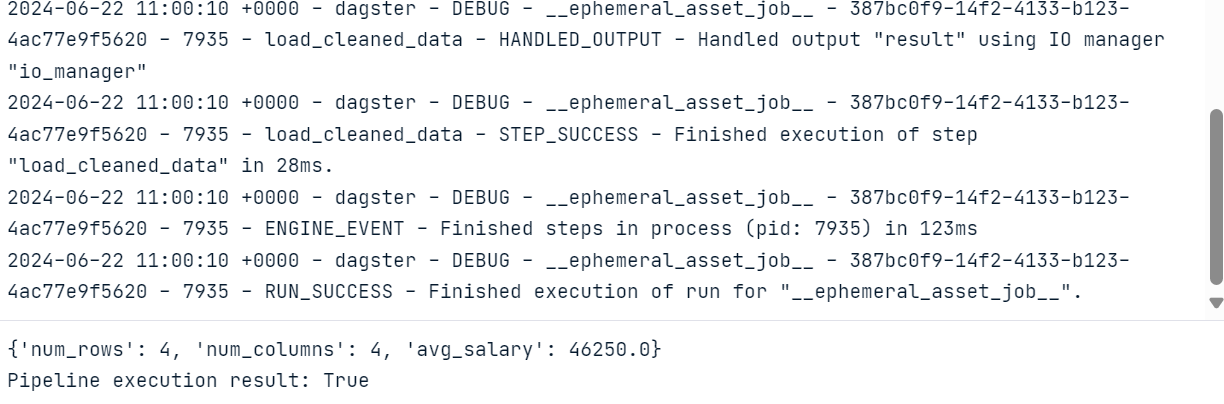
Para visualizar os ativos e execuções, precisamos instalar e rodar o servidor web do Dagster. Com ele, dá para executar jobs, materializar ativos individualmente e monitorar vários jobs de uma vez.
$ pip install dagster-webserverPara iniciar o servidor do Dagster, vamos usar o CLI e informar o caminho do arquivo Python. No meu caso, o arquivo se chama dagster_pipe.py.
$ dagster dev -f dagster_pipe.py O comando acima vai abrir o servidor web automaticamente no navegador. Como alternativa, acesse diretamente http://127.0.0.1:3000 no navegador.
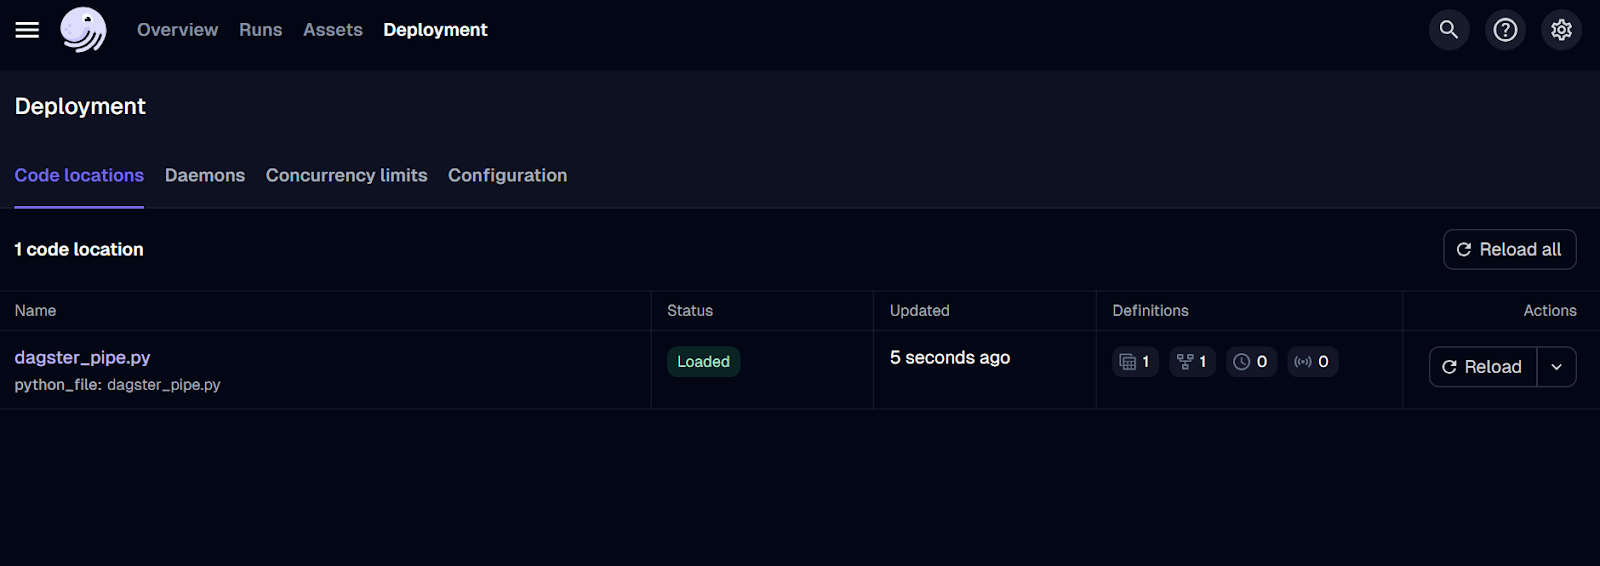
Interface do servidor web do Dagster.
Até agora, só implantamos o job. Para rodar o workflow, vá até a aba “Runs” e clique em “Launch a new run”.
A execução deve terminar com sucesso! Para ver os logs, clique no ID da execução que você quer analisar.
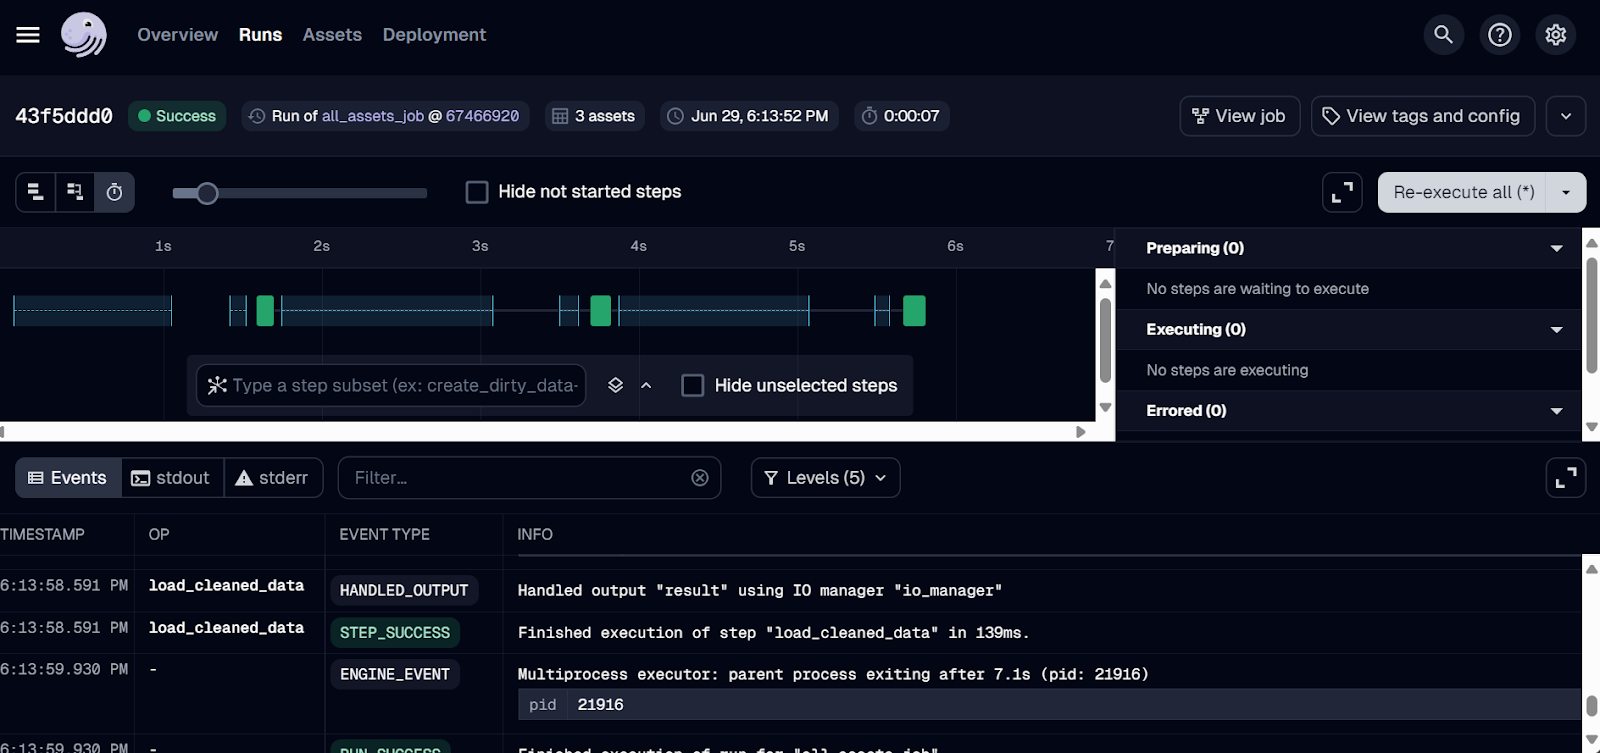
Logs de execução no Dagster.
Mage AI é um framework híbrido open source de orquestração de dados. Híbrido porque oferece a flexibilidade de um Jupyter Notebook com o controle de um código modular.
Qualquer pessoa, mesmo com conhecimento limitado de Python, consegue criar, executar e monitorar pipelines de dados. Em vez de escrever e rodar um arquivo Python diretamente, você cria um projeto no Mage AI e o abre no dashboard, onde constrói, executa e gerencia seus pipelines.
Comparado ao Airflow, o Mage AI tem uma interface amigável e é fácil de usar, sendo uma ótima escolha para quem está começando em engenharia de dados. Ele foi projetado com escalabilidade em mente e lida bem com grandes volumes de dados e pipelines complexos.
Achei estranho no começo, pois é bem diferente do que estou acostumado. Precisei instalar e abrir a UI do Mage AI. Era para ser fácil, mas tive dificuldade para montar e rodar o ETL. Por outro lado, dá para ver por que esse design agrada iniciantes: é basicamente arrastar, soltar e clicar em botões.
Abid Ali Awan, Author
Começar com o Mage AI é bem simples. Basta instalar o pacote Python do Mage AI.
$ pip install mage-aiE iniciar o projeto do Mage AI.
$ mage start mage_ai_etl O comando acima vai iniciar o servidor web. Como dito, toda a edição de código, execução e monitoramento é feita pela UI do Mage AI.
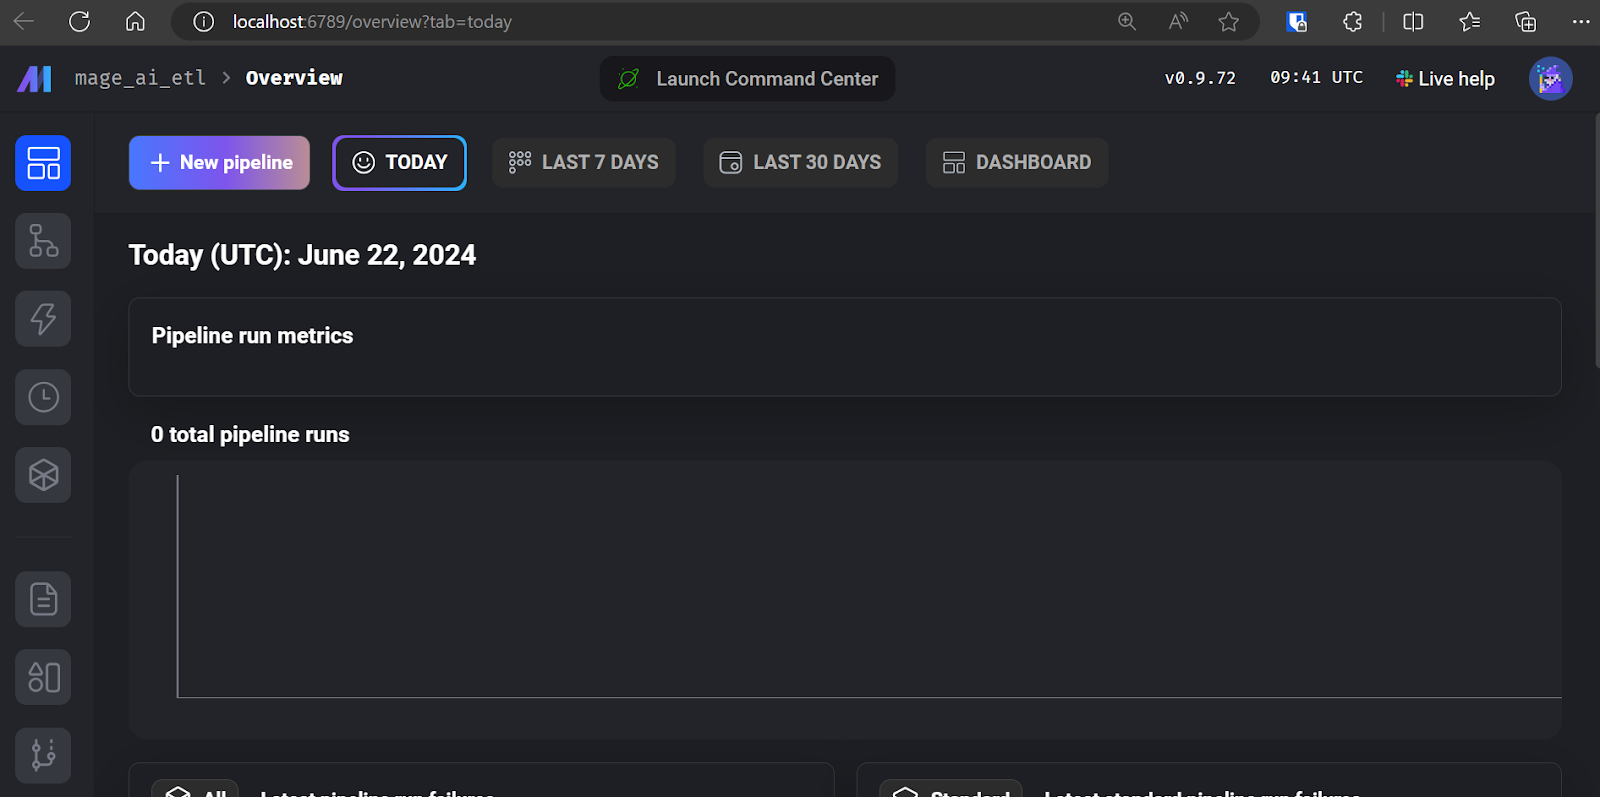
Interface do Mage AI.
Clique em “+ New pipeline” para criar seu primeiro ETL. Eu chamei o meu de “simple_etl”.
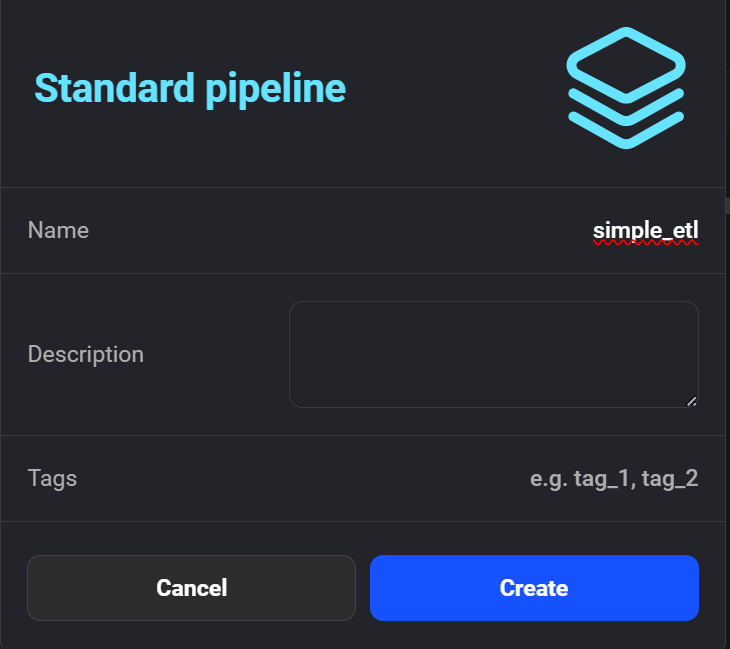
Criando um novo pipeline no Mage AI.
Depois, a interface vai pedir para adicionar um módulo para começar a codar. Selecione o módulo “Data Loader” e escreva o código Python abaixo.
Aqui declaramos a função create_sample_csv(), que é a primeira etapa do pipeline, com o decorator @data_loader do Mage AI. Também definimos test_output() para verificar se há saída, o que ajuda a gerenciar dependências.
import io
import pandas as pd

if 'data_loader' not in globals():
    from mage_ai.data_preparation.decorators import data_loader
if 'test' not in globals():
    from mage_ai.data_preparation.decorators import test

@data_loader
def create_sample_csv() -> pd.DataFrame:
    """
    Create a sample CSV file with duplicates and missing values
    """
    csv_data = """
category,product,quantity,price
Electronics,Laptop,5,1000
Electronics,Smartphone,10,500
Clothing,T-shirt,50,20
Clothing,Jeans,30,50
Books,Novel,100,15
Books,Textbook,20,80
Electronics,Laptop,5,1000
Clothing,T-shirt,,20
Electronics,Tablet,,300
Books,Magazine,25,
"""
    return pd.read_csv(io.StringIO(csv_data.strip()))

@test
def test_output(df) -> None:
    """
    Template code for testing the output of the block.
    """
    assert df is not None, 'The output is undefined'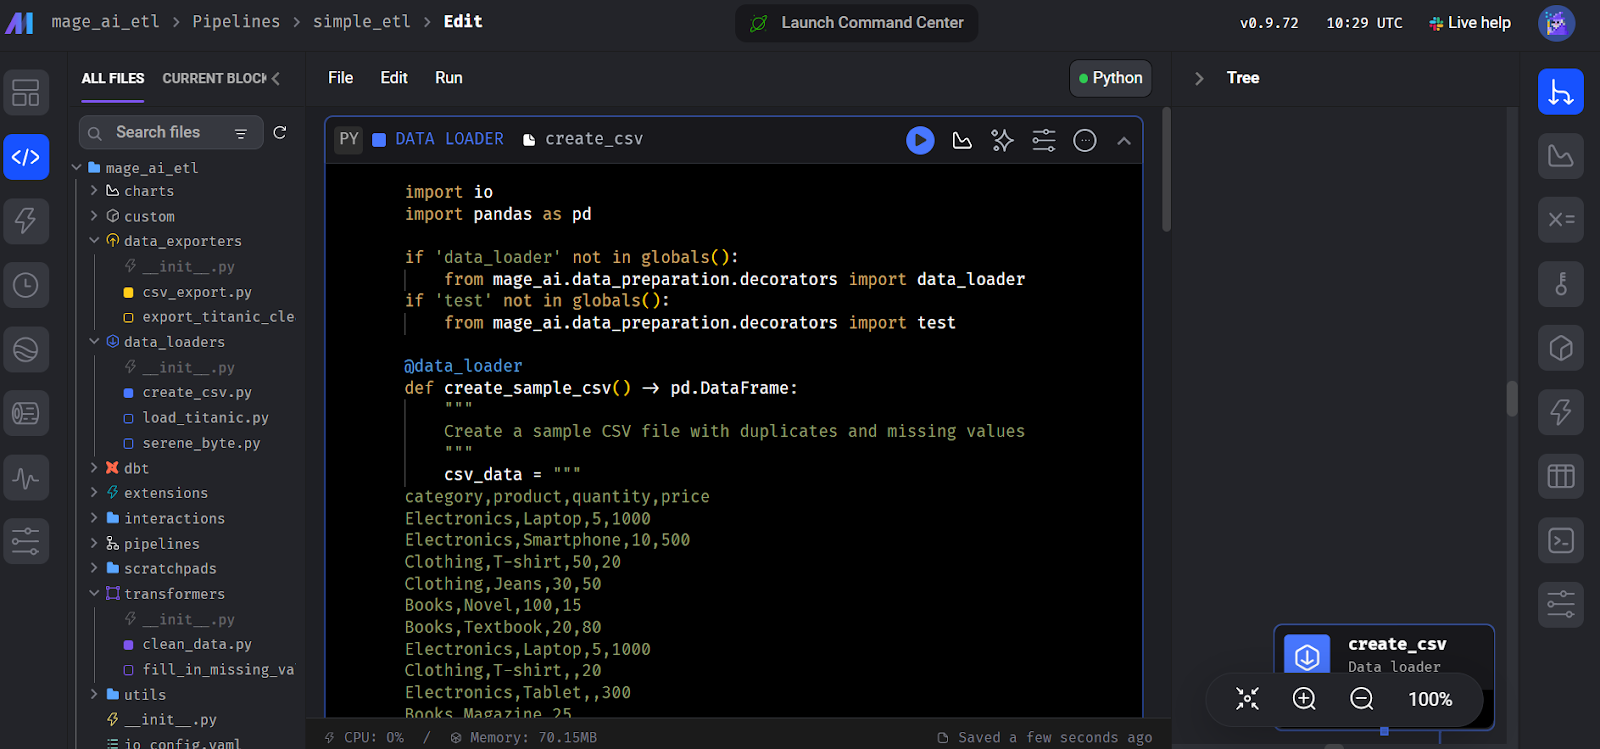
Criando o bloco de data loader no Mage AI.
Depois, crie outro módulo “Transformer” e adicione a função clean_data(), como no código abaixo.
Você pode ignorar a função test(); o essencial é o transformer principal, clean_data().
import pandas as pd

if 'transformer' not in globals():
    from mage_ai.data_preparation.decorators import transformer
if 'test' not in globals():
    from mage_ai.data_preparation.decorators import test

@transformer
def clean_data(df: pd.DataFrame) -> pd.DataFrame:
    """
    Clean and transform the data
    """
    # Remove duplicates
    df = df.drop_duplicates()
    # Fill missing values with 0
    df = df.fillna(0)
    return df

@test
def test_output(df) -> None:
    """
    Template code for testing the output of the block.
    """
    assert df is not None, 'The output is undefined'
Por fim, crie um módulo “Data Exporter” e adicione o código abaixo. Ele declara a função de carregamento export_data_to_csv(), que salva os dados transformados em um arquivo CSV.
import pandas as pd

if 'data_exporter' not in globals():
    from mage_ai.data_preparation.decorators import data_exporter

@data_exporter
def export_data_to_csv(df: pd.DataFrame) -> None:
    """
    Export the processed data to a CSV file
    """
    df.to_csv('output_data.csv', index=False)
    print("Data exported successfully to output_data.csv")
Para rodar o pipeline, vá até “Trigger” e clique em “Run@once”.
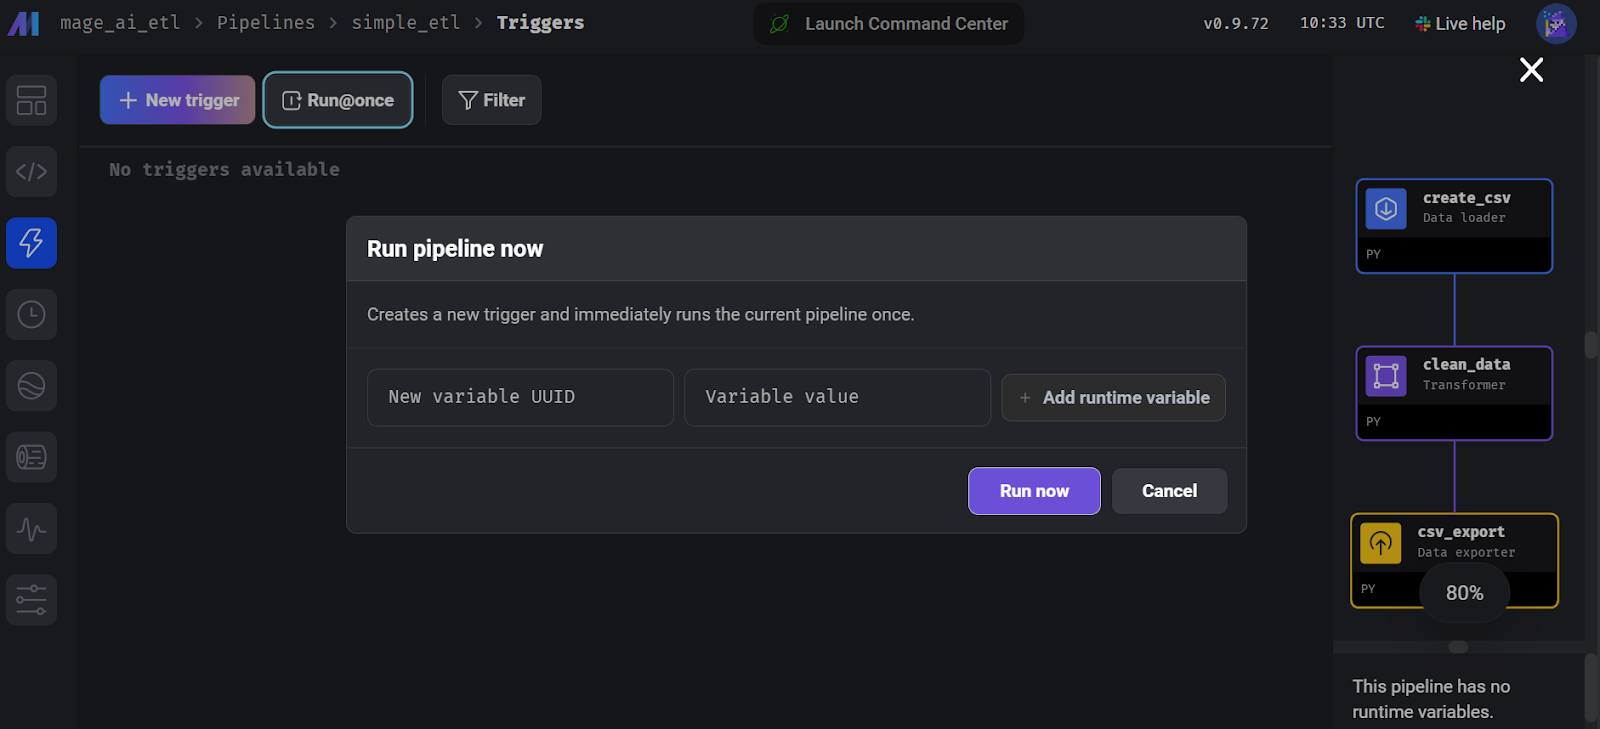
Executando o pipeline no Mage AI.
Para ver os logs, vá até “Runs” e clique em “Logs” no pipeline executado recentemente.
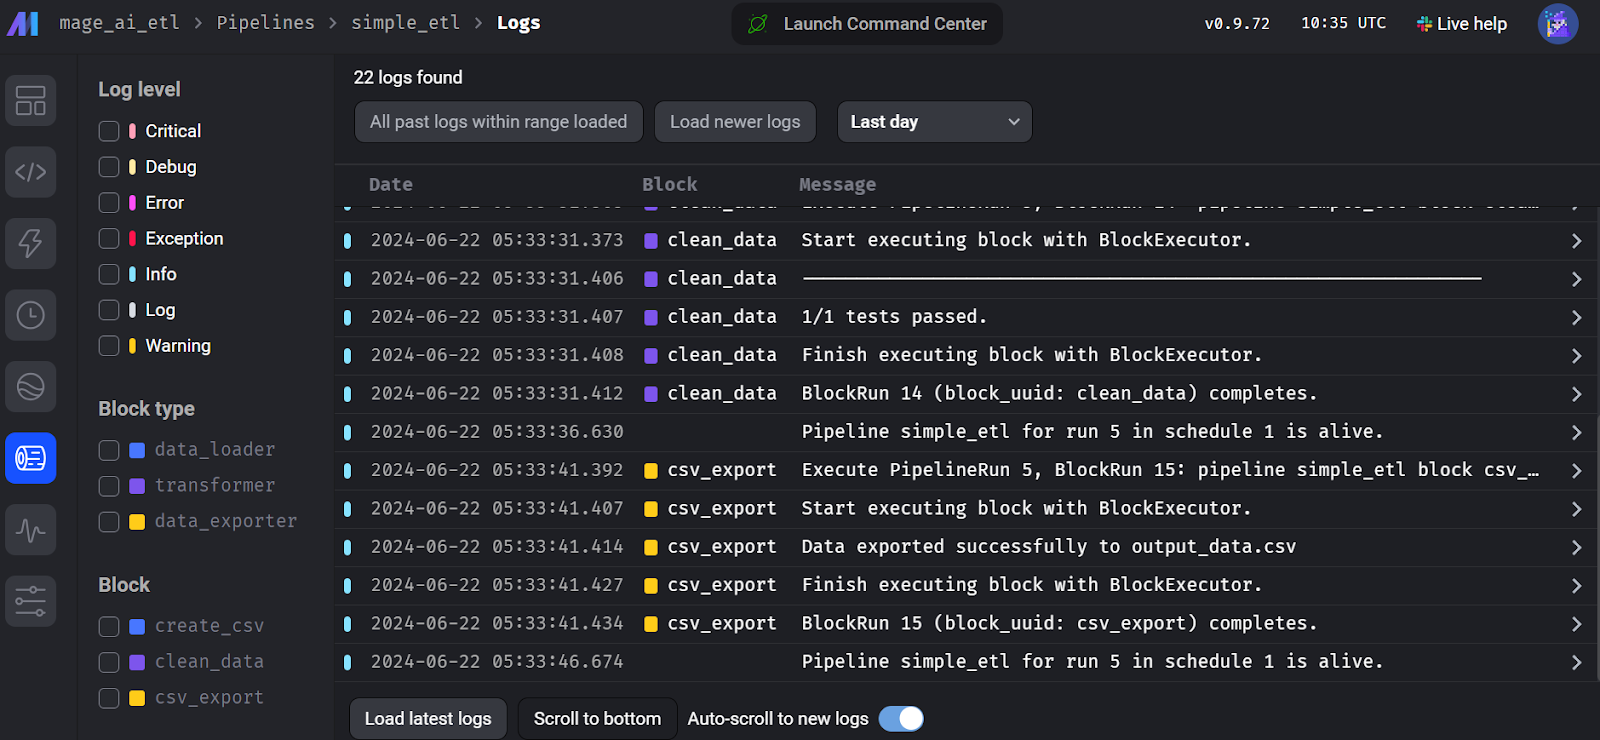
Logs de execução no Mage AI.
Kedro é outro framework open source popular de orquestração de dados, com algumas diferenças em relação às demais ferramentas. Criado para engenheiros de machine learning, ele traz vários conceitos de engenharia de software para projetos de ML.
O Kedro é altamente modular. Isso significa que, até para exportar um dataset, você precisa criar um catálogo de dados que especifica local e tipo dos dados, assegurando gestão padronizada e eficiente ao longo do pipeline.
Para entender como o Kedro se encaixa no ecossistema de machine learning, explore ferramentas de MLOps lendo o artigo 25 top MLOps tools you need to know in 2024.
Em relação ao Airflow, a API do Kedro é mais simples para construir um pipeline de dados. Ele foca mais em engenharia de ML e oferece categorização e versionamento de dados.
A parte de código é bem direta, mas surgem desafios na hora de executar o pipeline. Você precisa criar um catálogo de dados, registrar o pipeline e entender a estrutura do projeto Kedro. Eu diria que é mais desafiador do que Dagster e Prefect. Porém, faz sentido: a ideia é tornar seu pipeline confiável e com menos erros.
Abid Ali Awan, Author
Construir um pipeline no Kedro é um jogo diferente. O framework é modular, e você precisa entender a estrutura do projeto e as etapas para executar o workflow com sucesso.
Comece instalando o pacote Python do Kedro.
$ pip install kedroInicialize o projeto Kedro.
$ kedro new --name=kedro_etl --tools=none --example=n Entre no diretório do projeto.
$ cd kedro-etl Crie uma pasta dentro de pipelines chamada data_processing.
$ mkdir -p src/kedro_etl/pipelines/data_processing Crie um arquivo Python chamado kedro_pipe.py e abra-o no seu IDE favorito, por exemplo, o Visual Studio Code.
$ code src/kedro_etl/pipelines/data_processing/kedro_pipe.pyO script deve conter as funções de extração, transformação e carga, que são os nós do pipeline. Aqui, elas são create_sample_data(), clean_data(), e load_and_process_data().
Depois, conectamos esses nós com a classe Pipeline do Kedro, dentro da função create_pipeline(). Em cada nó, definimos inputs, outputs e o name do nó.
import pandas as pd
import numpy as np
from kedro.pipeline import Pipeline, node

def create_sample_data():
    data = {
        'id': range(1, 101),
        'name': [f'Person_{i}' for i in range(1, 101)],
        'age': np.random.randint(18, 80, 100),
        'salary': np.random.randint(20000, 100000, 100),
        'missing_values': [np.nan if i % 10 == 0 else i for i in range(100)]
    }
    return pd.DataFrame(data)

def clean_data(df: pd.DataFrame):
    # Remove rows with missing values
    df_cleaned = df.dropna()

    # Convert salary to thousands
    df_cleaned['salary'] = df_cleaned['salary'] / 1000

    # Capitalize names
    df_cleaned['name'] = df_cleaned['name'].str.upper()

    return df_cleaned

def load_and_process_data(df: pd.DataFrame):
    # Calculate average salary
    avg_salary = df['salary'].mean()

    # Add a new column for salary category
    df['salary_category'] = df['salary'].apply(
        lambda x: 'High' if x > avg_salary else 'Low')

    # Calculate age groups
    df['age_group'] = pd.cut(df['age'], bins=[0, 30, 50, 100], labels=[
                             'Young', 'Middle', 'Senior'])

    print(df)
    return df

def create_pipeline(**kwargs):
    return Pipeline(
        [
            node(
                func=create_sample_data,
                inputs=None,
                outputs="raw_data",
                name="create_sample_data_node",
            ),
            node(
                func=clean_data,
                inputs="raw_data",
                outputs="cleaned_data",
                name="clean_data_node",
            ),
            node(
                func=load_and_process_data,
                inputs="cleaned_data",
                outputs="processed_data",
                name="load_and_process_data_node",
            ),
        ]
    )
Se rodarmos o pipeline sem criar o catálogo de dados, nada será exportado. Então, edite o arquivo conf/base/catalog.yml e informe a configuração dos datasets.
raw_data:
  type: pandas.CSVDataset
  filepath: ./data/kedro/sample_data.csv

cleaned_data:
  type: pandas.CSVDataset
  filepath: ./data/kedro/cleaned_data.csv

processed_data:
  type: pandas.CSVDataset
  filepath: ./data/kedro/processed_data.csv
Também precisamos incluir nosso novo arquivo Python no registro do pipeline. Para isso, edite o arquivo src/simple_etl/pipeline_registry.py e inclua o código abaixo.
"""Project pipelines."""
from __future__ import annotations

from kedro.pipeline import Pipeline
from kedro_etl.pipelines.data_processing import kedro_pipe

def register_pipelines() -> Dict[str, Pipeline]:
    data_processing_pipeline = kedro_pipe.create_pipeline()

    return {
        "__default__": data_processing_pipeline,
        "data_processing": data_processing_pipeline,
    }
Execute o pipeline e acompanhe os logs em tempo real no terminal com o comando abaixo.
$ kedro run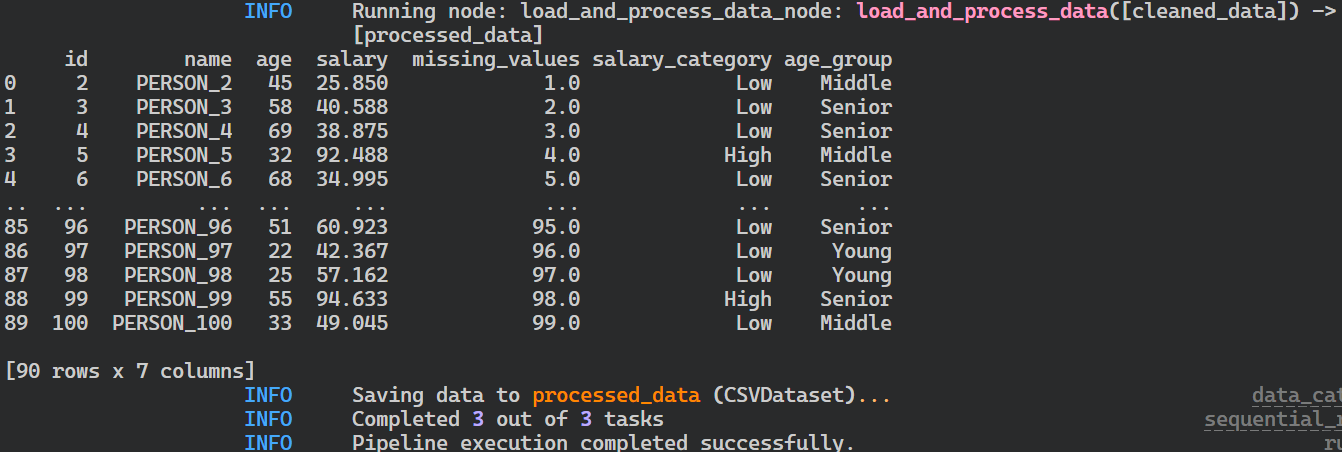
Logs da execução do pipeline no Kedro.
Depois de rodar, os arquivos serão salvos em CSV nos caminhos definidos no catálogo de dados.
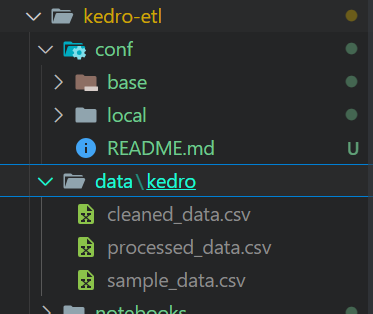
Arquivos gerados pelo pipeline do Kedro.
Se tiver problemas para rodar, considere instalar o Kedro com todas as extensões.
$ pip install "kedro[all]"Podemos visualizar e compartilhar os pipelines instalando a ferramenta kedro-viz.
$ pip install kedro-vizDepois, execute o comando abaixo para visualizar todos os pipelines e nós de dados. Ele também oferece rastreamento de experimentos e compartilhamento da visualização.
$ kedro viz run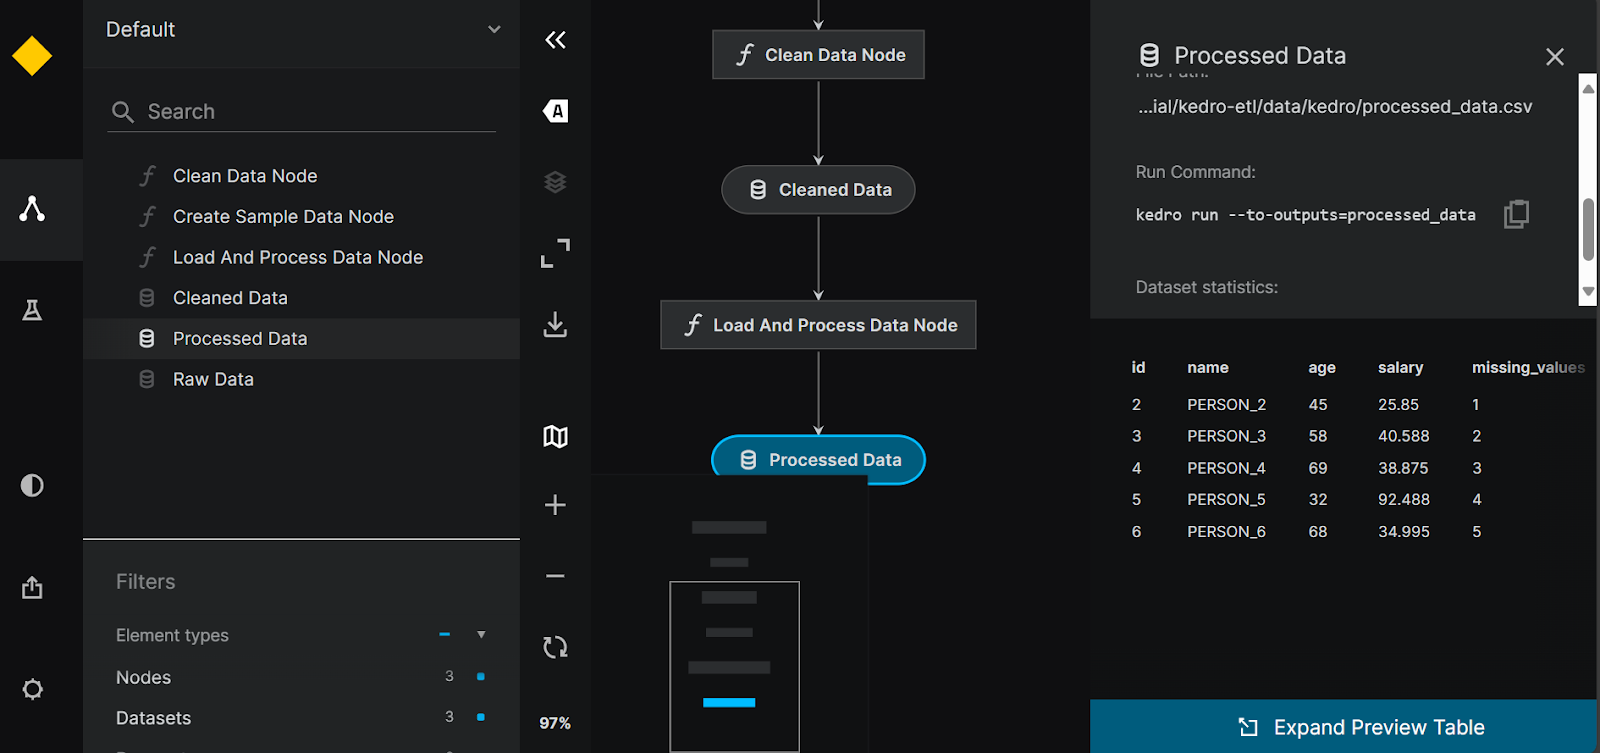
Visualização do pipeline no Kedro.
Luigi é um framework open source em Python desenvolvido pelo Spotify, excelente para gerenciar processos em lote de longa duração e pipelines complexos. Ele se destaca em resolução de dependências, gestão de workflows, visualização e recuperação de falhas, sendo uma ferramenta poderosa para orquestrar dados.
Comparado ao Airflow, o Luigi tem uma API minimalista, agendamento por calendário e uma base fiel de usuários que ajuda a resolver problemas de orquestração.
Se você está começando em Python, pode achar difícil construir e rodar os pipelines. Porém, a documentação e os guias ajudam a iniciar rápido. Os logs trazem informações limitadas e o dashboard serve basicamente para visualizar DAGs e dependências.
Abid Ali Awan, Author
Criar um pipeline no Luigi exige entender programação orientada a objetos. Vamos começar instalando o pacote Python do Luigi.
$ pip install luigiPara desenvolver um ETL simples no Luigi, vamos criar tarefas interconectadas. Em vez de funções, criaremos uma classe Python para cada etapa do pipeline, FetchData, ProcessData e GenerateReport. Cada classe terá três funções: requires(), output() e run().
As funções requires() e output() conectam as tarefas, e a run() executa o processamento. No fim, construímos o pipeline a partir da última tarefa.
import luigi
import pandas as pd
import numpy as np

class FetchData(luigi.Task):
    def output(self):
        return luigi.LocalTarget('data/fetch_data.csv')

    def run(self):
        # Simulate fetching data by creating a sample CSV file
        data = {
            'column1': [1, 2, np.nan, 4],
            'column2': ['A', 'B', 'C', np.nan]
        }
        df = pd.DataFrame(data)
        df.to_csv(self.output().path, index=False)

class ProcessData(luigi.Task):
    def requires(self):
        return FetchData()

    def output(self):
        return luigi.LocalTarget('data/process_data.csv')

    def run(self):
        df = pd.read_csv(self.input().path)
        # Fill missing values
        df['column1'].fillna(df['column1'].mean(), inplace=True)
        df['column2'].fillna('B', inplace=True)
        df.to_csv(self.output().path, index=False)

class GenerateReport(luigi.Task):
    def requires(self):
        return ProcessData()

    def output(self):
        return luigi.LocalTarget('data/generate_report.txt')

    def run(self):
        df = pd.read_csv(self.input().path)
        # Simple data analysis: calculate mean of column1 and value counts of column2
        mean_column1 = df['column1'].mean()
        value_counts_column2 = df['column2'].value_counts()

        with self.output().open('w') as out_file:
            out_file.write(f'Mean of column1: {mean_column1}\n')
            out_file.write('Value counts of column2:\n')
            out_file.write(value_counts_column2.to_string())

if __name__ == '__main__':
    luigi.build([GenerateReport()], local_scheduler=True)
Rode o código acima no Jupyter Notebook ou crie um arquivo Python e execute pelo terminal.
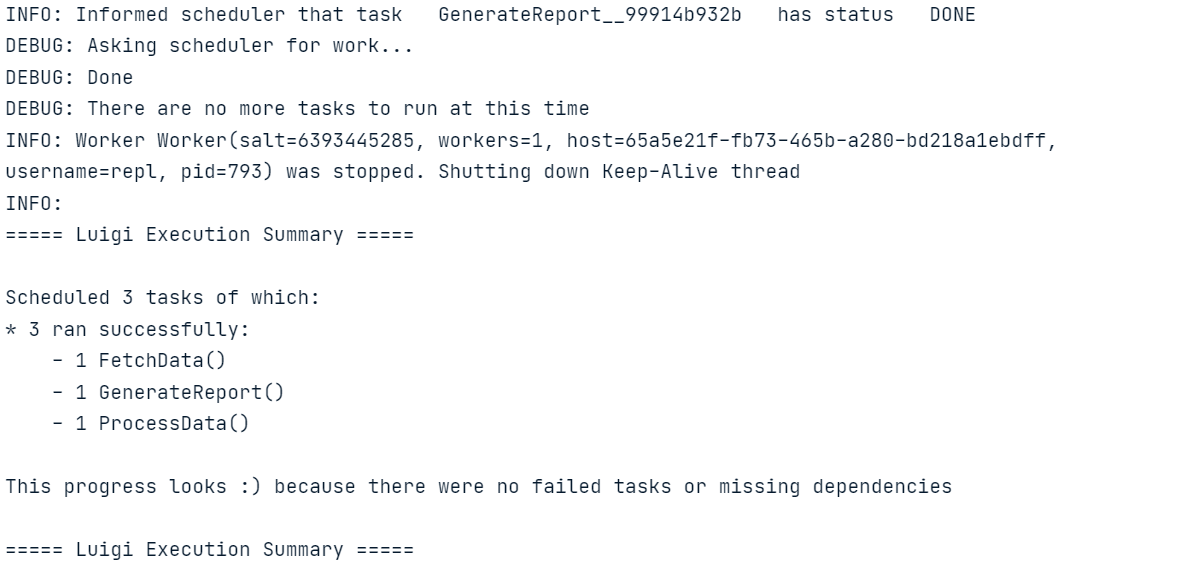
Assim como no Luigi, você também pode aprender a construir um pipeline ETL com Apache Airflow. O tutorial cobre o básico de extração, transformação e carga com Airflow.
Precisamos inicializar o central planner do Luigi para agendar execuções ou dispará-las por evento.
Inicie o scheduler com o comando abaixo no terminal.
$ luigid 2024-06-22 13:35:18,636 luigi[25056] INFO: logging configured by default settings
2024-06-22 13:35:18,636 luigi.scheduler[25056] INFO: No prior state file exists at /var/lib/luigi-server/state.pickle. Starting with empty state
2024-06-22 13:35:18,640 luigi.server[25056] INFO: Scheduler starting upPara rodar o pipeline, abra um novo terminal e rode o comando a seguir. O Luigi precisa do nome do arquivo Python e da última tarefa que queremos executar. Aqui, o arquivo é luigi_pipe.py e a última tarefa é GenerateReport.
$ python -m luigi --module luigi_pipe GenerateReportPara visualizar a execução e o status das tarefas, acesse http://localhost:8082 no navegador.
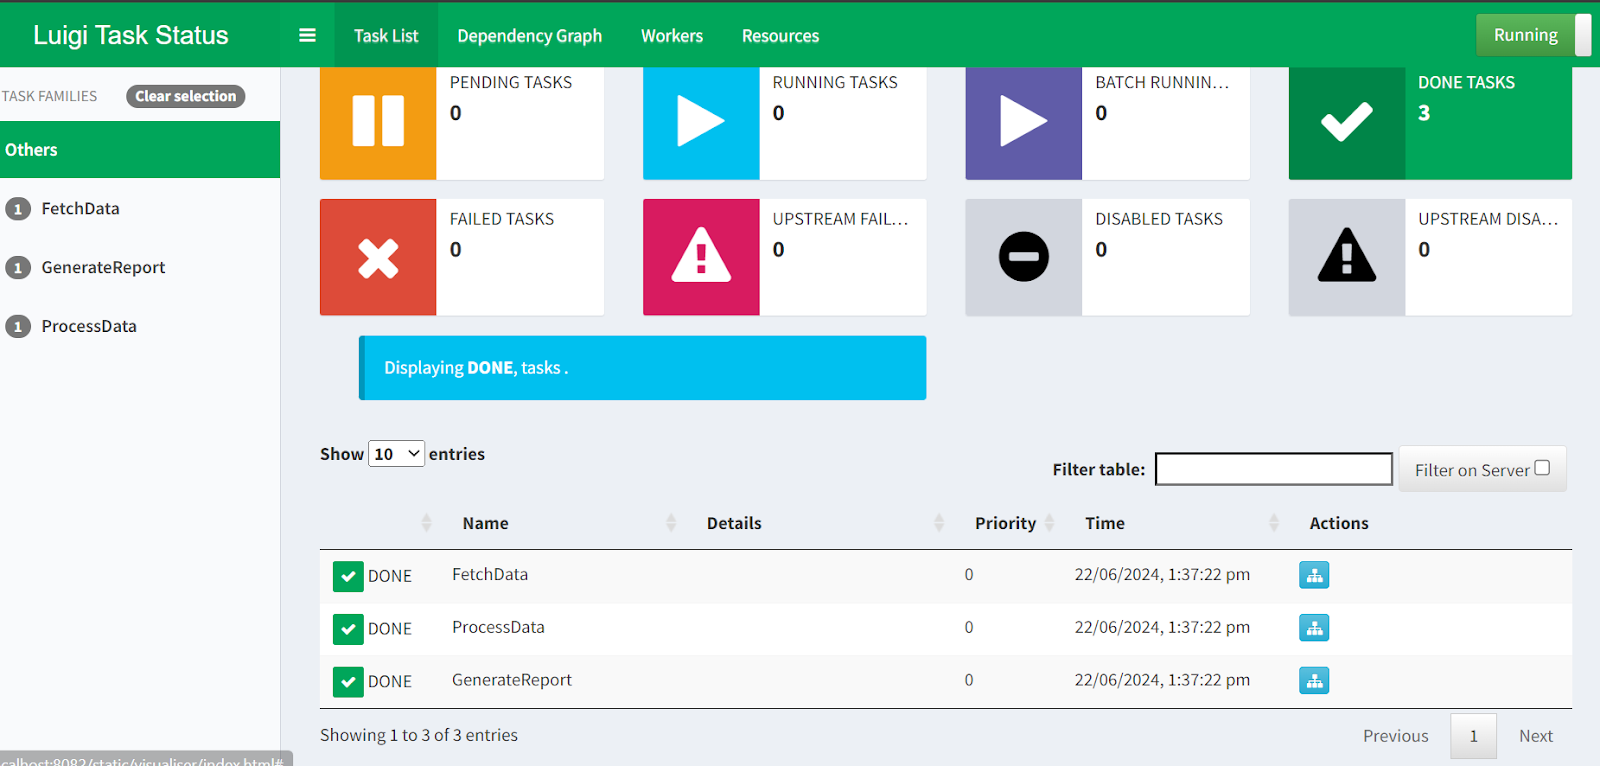
Interface do Luigi Central Planner.
Encerramos nosso tour pelas 5 melhores alternativas ao Airflow! Se quiser se aprofundar em algum exemplo do artigo, confira:
Neste tutorial, vimos as principais alternativas open source e gratuitas ao Airflow. Também conhecemos cada ferramenta de orquestração de dados, além de construir e executar um ETL simples. Ver os exemplos de código ajuda você a decidir qual funciona melhor para o seu caso.
Se você é iniciante, sugiro começar por Prefect ou Mage AI, pois são mais amigáveis e fáceis de configurar. Já se busca ferramentas mais avançadas e alinhadas a práticas de engenharia de software, vale explorar Dagster, Kedro e Luigi.
Depois de ler este artigo, um próximo passo natural na sua jornada em engenharia de dados é tirar uma certificação como a trilha da DataCamp Data Engineer in Python para conhecer outras ferramentas e construir um pipeline de dados de ponta a ponta pronto para produção.
Aprofunde seus conhecimentos em engenharia de dados com estes cursos!
Curso
Programa
Curso
blog
DataCamp Team
12 min
blog
Javier Canales Luna
12 min
blog
Javier Canales Luna
9 min
Tutorial
Adel Nehme
9 min
Tutorial
Oluseye Jeremiah
13 min