course
Introduction to Data Engineering
4 घंटा
129.7K
छवि लेखक द्वारा।
Apache Airflow एक लोकप्रिय ओपन-सोर्स डेटा ऑर्केस्ट्रेशन टूल है, जिसे डेटा पाइपलाइनों को बनाने, शेड्यूल करने और मॉनिटर करने के लिए डिज़ाइन किया गया है। इसमें एक डैशबोर्ड होता है जो वर्कफ़्लो की स्थिति प्रबंधित करने में मदद करता है, जिससे यह अधिकांश वर्कफ़्लो आवश्यकताओं के लिए उपयुक्त टूल बन जाता है।
हालाँकि, Airflow में कुछ महत्वपूर्ण विशेषताओं की कमी है जो जटिल, आधुनिक डेटा ऑर्केस्ट्रेशन आवश्यकताओं के लिए महत्वपूर्ण हो सकती हैं।
इस ट्यूटोरियल में, हम Airflow के पाँच विकल्पों का पता लगाएंगे जो उन्नत क्षमताएँ प्रदान करते हैं और इसकी कुछ सीमाओं को संबोधित करते हैं। साथ ही, हम प्रत्येक टूल का उपयोग करके एक सरल ETL पाइपलाइन बनाना, उसे चलाना, और उनके डैशबोर्ड में विज़ुअलाइज़ करना सीखेंगे।
Airflow विभिन्न डेटा वर्कफ़्लोज़ के लिए एक शक्तिशाली टूल है, लेकिन इसमें कई सीमाएँ हैं जिनके कारण कंपनियाँ विकल्पों पर विचार कर सकती हैं।
यहाँ कुछ कारण दिए गए हैं जिनसे आप विकल्प चुन सकते हैं:
अन्य डेटा ऑर्केस्ट्रेशन टूल्स के कोडिंग भाग में जाने से पहले, Getting Started with Apache Airflow ट्यूटोरियल का अनुसरण करते हुए Apache Airflow से डेटा पाइपलाइन लिखना सीखना महत्वपूर्ण है, ताकि आप विकल्पों की निष्पक्ष तुलना कर सकें।
यदि आप Airflow में पूरी तरह नए हैं, तो संक्षिप्त Introduction to Airflow in Python कोर्स लेने पर विचार करें, ताकि डेटा पाइपलाइनों को बनाना और शेड्यूल करना सीख सकें।
अब, आइए Airflow के शीर्ष 5 विकल्पों का वर्णन करें और व्यावहारिक कोड उदाहरणों के साथ उनका उपयोग कैसे करें, यह दिखाएँ।
Prefect एक ओपन-सोर्स Python वर्कफ़्लो ऑर्केस्ट्रेशन टूल है, जिसे आधुनिक डेटा और मशीन लर्निंग इंजीनियरों के लिए बनाया गया है। यह एक सरल API प्रदान करता है जो आपको तेजी से डेटा पाइपलाइन बनाने और उसे एक इंटरैक्टिव डैशबोर्ड के माध्यम से प्रबंधित करने देता है।
Prefect एक हाइब्रिड निष्पादन मॉडल प्रदान करता है, यानी आप वर्कफ़्लो को क्लाउड पर परिनियोजित करके वहाँ चला सकते हैं या लोकल रिपॉजिटरी का उपयोग कर सकते हैं।
Airflow की तुलना में, Prefect उन्नत सुविधाएँ प्रदान करता है जैसे स्वचालित टास्क निर्भरताएँ, इवेंट-आधारित ट्रिगर्स, बिल्ट-इन नोटिफिकेशन, वर्कफ़्लो-विशिष्ट इंफ्रास्ट्रक्चर, और क्रॉस-टास्क डेटा शेयरिंग। ये क्षमताएँ जटिल वर्कफ़्लोज़ को कुशलतापूर्वक और प्रभावी ढंग से प्रबंधित करने के लिए इसे एक शक्तिशाली समाधान बनाती हैं।
Prefect सरल है और शक्तिशाली सुविधाओं के साथ आता है। मुझे उदाहरण कोड चलाने में मूलतः 5 मिनट लगे। मुझे खास तौर पर डैशबोर्ड UI का डिज़ाइन, नोटिफिकेशन सेटअप करने का तरीका, पाइपलाइनों को दोबारा चलाना, और डैशबोर्ड के माध्यम से सबकुछ प्रबंधित और मॉनिटर करना पसंद आया।
Abid Ali Awan, Author
विस्तृत तुलना जानने के लिए पढ़ें Airflow vs Prefect: आपके डेटा वर्कफ़्लो के लिए कौन सही है ब्लॉग।
हम Prefect प्रोजेक्ट की शुरुआत Python पैकेज इंस्टॉल करके करेंगे। टर्मिनल में निम्न कमांड चलाएँ।
$ pip install -U prefectइसके बाद, हम prefect_etl.py नामक एक Python स्क्रिप्ट बनाएँगे और निम्न कोड लिखेंगे।
from prefect import task, flow
import pandas as pd

# Extract data
@task
def extract_data():
    # Simulating data extraction
    data = {
        "name": ["Alice", "Bob", "Charlie"],
        "age": [25, 30, 35],
        "city": ["New York", "Los Angeles", "Chicago"]
    }
    df = pd.DataFrame(data)
    return df

# Transform data
@task
def transform_data(df: pd.DataFrame):
    # Example transformation: adding a new column
    df["age_plus_ten"] = df["age"] + 10
    return df

# Load data
@task
def load_data(df: pd.DataFrame):
    # Simulating data load
    print("Loading data to target destination:")
    print(df)

# Defining the flow
@flow(log_prints=True)
def etl():
    raw_data = extract_data()
    transformed_data = transform_data(raw_data)
    load_data(transformed_data)

# Running the flow
if __name__ == "__main__":
    etl()
ऊपर दिए गए कोड में extract_data(), transform_data(), और load_data() टास्क फ़ंक्शंस परिभाषित हैं और उन्हें etl() नामक फ़्लो फ़ंक्शन में क्रम से चलाया जाता है। ये फ़ंक्शंस Prefect Python डेकोरेटर्स का उपयोग करके बनाए गए हैं।
संक्षेप में, हम एक pandas DataFrame बना रहे हैं, उसे ट्रांसफ़ॉर्म कर रहे हैं, और फिर प्रिंट के ज़रिए अंतिम परिणाम दिखा रहे हैं। यह ETL पाइपलाइन को सिमुलेट करने का सरल तरीका है।
वर्कफ़्लो को निष्पादित करने के लिए, बस निम्न कमांड से Python स्क्रिप्ट चलाएँ।
$ python prefect_etl.py जैसा कि हम देख सकते हैं, हमारा वर्कफ़्लो रन सफलतापूर्वक पूरा हो गया है।
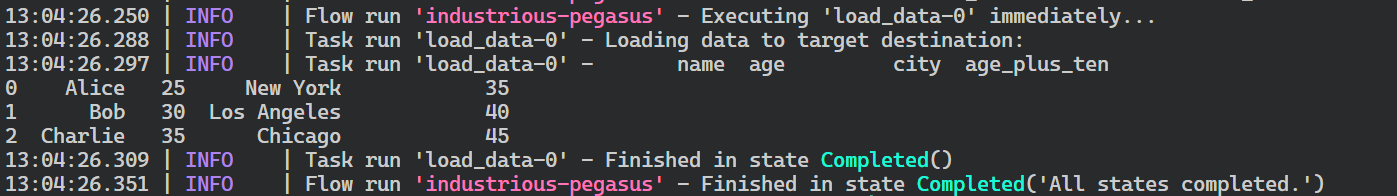
Prefect फ़्लो रन लॉग्स।
अब हम अपने वर्कफ़्लो को परिनियोजित करेंगे ताकि हम इसे शेड्यूल पर चला सकें या किसी इवेंट के आधार पर ट्रिगर कर सकें। फ़्लो को परिनियोजित करने से हमें कई वर्कफ़्लोज़ को केंद्रीकृत तरीके से मॉनिटर और प्रबंधित करने में भी मदद मिलती है।
फ़्लो को परिनियोजित करने के लिए, हम Prefect CLI का उपयोग करेंगे। deploy फ़ंक्शन को Python फ़ाइल का नाम, फ़ाइल में फ़्लो फ़ंक्शन का नाम, और डिप्लॉयमेंट नाम चाहिए। इस मामले में, हम इस डिप्लॉयमेंट को “simple_etl” कह रहे हैं।
$ prefect deploy prefect_etl.py:etl -n 'simple_etl'ऊपर दिया गया स्क्रिप्ट टर्मिनल में चलाने के बाद, हो सकता है आपको संदेश मिले कि हमारे पास डिप्लॉयमेंट चलाने के लिए वर्कर पूल नहीं है। वर्कर पूल बनाने के लिए निम्न कमांड का उपयोग करें।
$ prefect worker start --pool 'datacamp'अब जब हमारे पास वर्कर पूल है, तो हम एक और टर्मिनल विंडो शुरू करेंगे और डिप्लॉयमेंट चलाएँगे। prefect deployment run कमांड को “<flow-function-name>/<deployment-name>” आर्ग्युमेंट चाहिए, जैसा कि नीचे दिखाया गया है।
$ prefect deployment run 'etl/simple_etlडिप्लॉयमेंट चलाने के परिणामस्वरूप, आपको संदेश मिलेगा कि वर्कफ़्लो चल रहा है। आमतौर पर, बनाए गए फ़्लो रन को एक रैंडम नाम असाइन होता है—मेरे मामले में witty-lorikeet।
Creating flow run for deployment 'etl/simple_etl'...
Created flow run 'witty-lorikeet'.
└── UUID: 4e0495b0-9c7e-4ed8-b9ab-5160994dc7f0
└── Parameters: {}
└── Job Variables: {}
└── Scheduled start time: 2024-06-22 14:05:01 PKT (now)
└── URL: <no dashboard available>
पूरा लॉग देखने के लिए, उस टर्मिनल विंडो पर वापस जाएँ जहाँ आपने वर्कर पूल शुरू किया था।
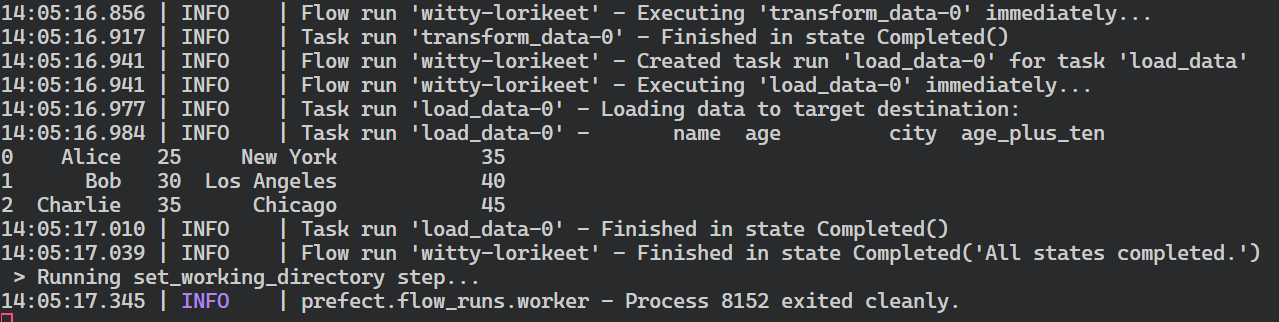
Prefect फ़्लो रन सारांश।
फ़्लो रन को अधिक उपयोगकर्ता-अनुकूल तरीके से विज़ुअलाइज़ करने और अन्य वर्कफ़्लोज़ को प्रबंधित करने के लिए आपको Prefect वेब सर्वर प्रारंभ करना होगा।
$ prefect server start ऊपर दिए गए कमांड को चलाने के बाद, आपको Prefect डैशबोर्ड पर रीडायरेक्ट कर दिया जाना चाहिए। वैकल्पिक रूप से, आप अपने ब्राउज़र में सीधे http://127.0.0.1:4200 पते पर जा सकते हैं।
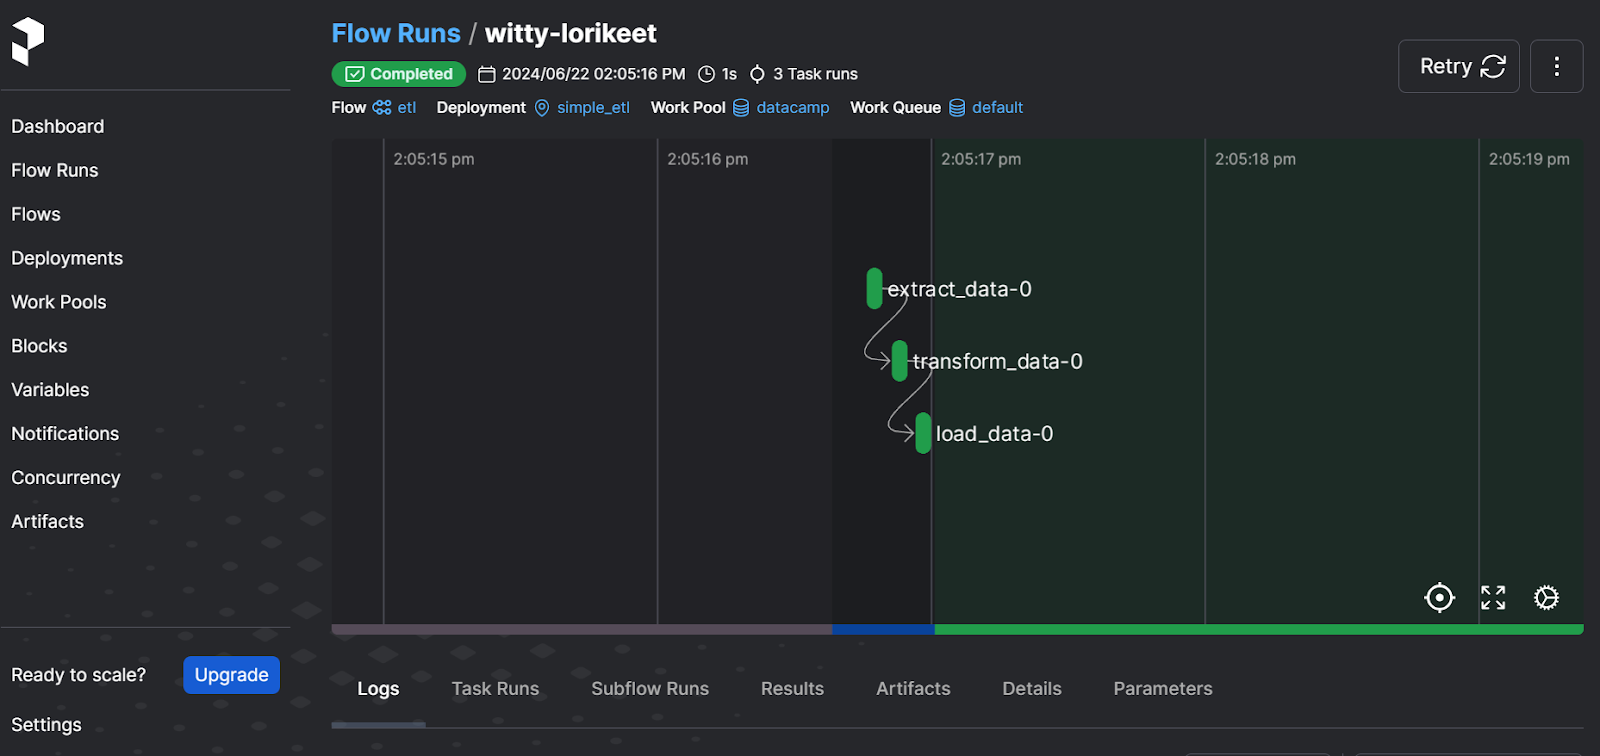
Prefect वेब सर्वर UI
डैशबोर्ड आपको वर्कफ़्लो को फिर से चलाने, लॉग देखने, वर्क पूल्स की जाँच करने, नोटिफिकेशन सेट करने और अन्य उन्नत विकल्प चुनने देता है। यह आपकी आधुनिक डेटा ऑर्केस्ट्रेशन आवश्यकताओं के लिए एक संपूर्ण समाधान है।
Prefect का उपयोग करके मशीन लर्निंग पाइपलाइंस बनाना और चलाना सीखने के लिए, आप Using Prefect for Machine Learning Workflows ट्यूटोरियल का अनुसरण कर सकते हैं।
Dagster एक ओपन-सोर्स फ़्रेमवर्क है, जिसे डेटा इंजीनियरों के लिए डेटा पाइपलाइनों को परिभाषित करने, शेड्यूल करने और मॉनिटर करने हेतु डिज़ाइन किया गया है। यह अत्यधिक स्केलेबल है और विभिन्न डेटा टीमों के बीच सहयोग को सरल बनाता है।
Dagster उपयोगकर्ताओं को डेकोरेटर्स का उपयोग करते हुए अपनी डेटा एसेट्स को Python फ़ंक्शंस के रूप में परिभाषित करने में सक्षम बनाता है। एक बार एसेट्स परिभाषित हो जाने के बाद, उपयोगकर्ता उन्हें शेड्यूलिंग या इवेंट-आधारित ट्रिगर्स के माध्यम से निर्बाध रूप से चला सकते हैं।
Airflow की तुलना में, Dagster हमें लोकल रूप से पाइपलाइन विकसित, परीक्षण और समीक्षा करने देता है, ऑर्केस्ट्रेशन के लिए एसेट-आधारित दृष्टिकोण प्रदान करता है, और क्लाउड व कंटेनर-नेटिव है।
कदमों और फ़्लोज़ के संदर्भ में वर्कफ़्लो के बारे में सोचने के बजाय, मुझे अपना दृष्टिकोण बदलकर डेटा एसेट्स का उपयोग करके पाइपलाइन बनानी पड़ी। इसके अलावा, एक सरल ETL पाइपलाइन बनाना और चलाना काफ़ी सरल था। साथ ही, वेब सर्वर अपेक्षाकृत न्यूनतम है, लेकिन एसेट्स, रन और डिप्लॉयमेंट्स की निगरानी के लिए सभी जानकारी प्रदान करता है।
Abid Ali Awan, Author
हम एक सरल ETL पाइपलाइन बनाएँगे, उसे चलाएँगे, और Dagster वेब सर्वर का उपयोग कर उसे विज़ुअलाइज़ करेंगे। Prefect डैशबोर्ड की तरह ही, Dagster वेब सर्वर कई वर्कफ़्लोज़ की निगरानी करने और रन व एसेट्स को शेड्यूल करने के केंद्रीकृत तरीके प्रदान करता है।
हम Python पैकेज इंस्टॉल करके शुरुआत करेंगे।
$ pip install dagster -qइसके बाद, हम डेटा को एक्सट्रैक्ट, ट्रांसफ़ॉर्म और लोड करने के लिए तीन Python फ़ंक्शंस बनाएँगे। कोड में इन फ़ंक्शंस के नाम हैं create_dirty_data(), clean_data(), और load_cleaned_data()। @asset डेकोरेटर का उपयोग करके, हम इन फ़ंक्शंस को Dagster में डेटा एसेट्स के रूप में घोषित करेंगे।
अगले चरण में, हम सभी एसेट्स (all_assets वेरिएबल) का उपयोग करके एसेट जॉब (job वेरिएबल) बनाएँगे और फिर एसेट डेफिनिशन (defs वेरिएबल) बनाएँगे।
आप एसेट डेफिनिशन वाले भाग को छोड़ सकते हैं, लेकिन यदि आप अपना रन शेड्यूल करना, कई जॉब्स चलाना और सेंसर सेट करना चाहते हैं, तो यह महत्वपूर्ण हो जाता है।
import pandas as pd
import numpy as np
from dagster import asset, Definitions, define_asset_job, materialize

@asset
def create_dirty_data():
    # Create a sample DataFrame with dirty data
    data = {
        'Name': [' John Doe ', 'Jane Smith', 'Bob Johnson ', '  Alice Brown'],
        'Age': [30, np.nan, 40, 35],
        'City': ['New York', 'los angeles', 'CHICAGO', 'Houston'],
        'Salary': ['50,000', '60000', '75,000', 'invalid']
    }
    df = pd.DataFrame(data)

    # Save the DataFrame to a CSV file
    dirty_file_path = 'dag_data/dirty_data.csv'
    df.to_csv(dirty_file_path, index=False)

    return dirty_file_path

@asset
def clean_data(create_dirty_data):
    # Read the dirty CSV file
    df = pd.read_csv(create_dirty_data)

    # Clean the data
    df['Name'] = df['Name'].str.strip()
    df['Age'] = pd.to_numeric(df['Age'], errors='coerce').fillna(df['Age'].mean())
    df['City'] = df['City'].str.upper()
    df['Salary'] = df['Salary'].replace('[\$,]', '', regex=True)
    df['Salary'] = pd.to_numeric(df['Salary'], errors='coerce').fillna(0)

    # Calculate average salary
    avg_salary = df['Salary'].mean()

    # Save the cleaned DataFrame to a new CSV file
    cleaned_file_path = 'dag_data/cleaned_data.csv'
    df.to_csv(cleaned_file_path, index=False)

    return {
        'cleaned_file_path': cleaned_file_path,
        'avg_salary': avg_salary
    }

@asset
def load_cleaned_data(clean_data):
    cleaned_file_path = clean_data['cleaned_file_path']
    avg_salary = clean_data['avg_salary']

    # Read the cleaned CSV file to verify
    df = pd.read_csv(cleaned_file_path)

    print({
        'num_rows': len(df),
        'num_columns': len(df.columns),
        'avg_salary': avg_salary
    })

# Define all assets
all_assets = [create_dirty_data, clean_data, load_cleaned_data]

# Create a job that will materialize all assets
job = define_asset_job("all_assets_job", selection=all_assets)

# Create Definitions object
defs = Definitions(
    assets=all_assets,
    jobs=[job]
)

if __name__ == "__main__":
    result = materialize(all_assets)
    print("Pipeline execution result:", result.success)
आप ऊपर दिया गया कोड Jupyter Notebook में चला सकते हैं या Python फ़ाइल बनाकर चला सकते हैं।
कोड निष्पादित करने के परिणामस्वरूप, हमें वर्कफ़्लो रन का पूरा लॉग मिलेगा।
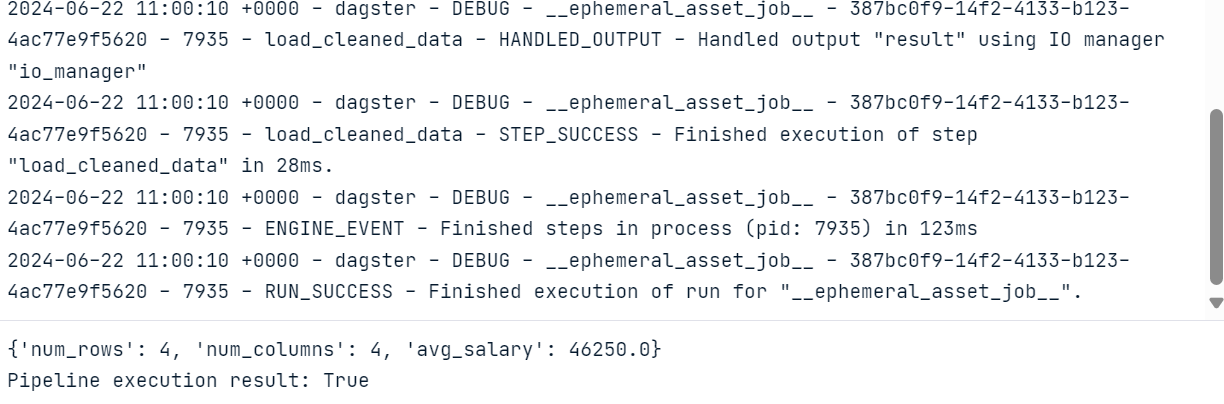
एसेट्स और जॉब रन को विज़ुअलाइज़ करने के लिए, हमें Dagster वेब सर्वर इंस्टॉल और रन करना होगा। वेब सर्वर आपको जॉब्स चलाने, व्यक्तिगत एसेट्स मैटेरियलाइज़ करने और एक साथ कई जॉब्स मॉनिटर करने देता है।
$ pip install dagster-webserverDagster सर्वर शुरू करने के लिए, हम Dagster CLI का उपयोग करेंगे और उसे Python फ़ाइल का लोकेशन देंगे। इस मामले में, मैंने फ़ाइल का नाम dagster_pipe.py रखा है।
$ dagster dev -f dagster_pipe.py ऊपर दिया गया कमांड स्वतः आपके ब्राउज़र में वेब सर्वर लॉन्च कर देगा। वैकल्पिक रूप से, आप सीधे http://127.0.0.1:3000 पते पर जा सकते हैं।
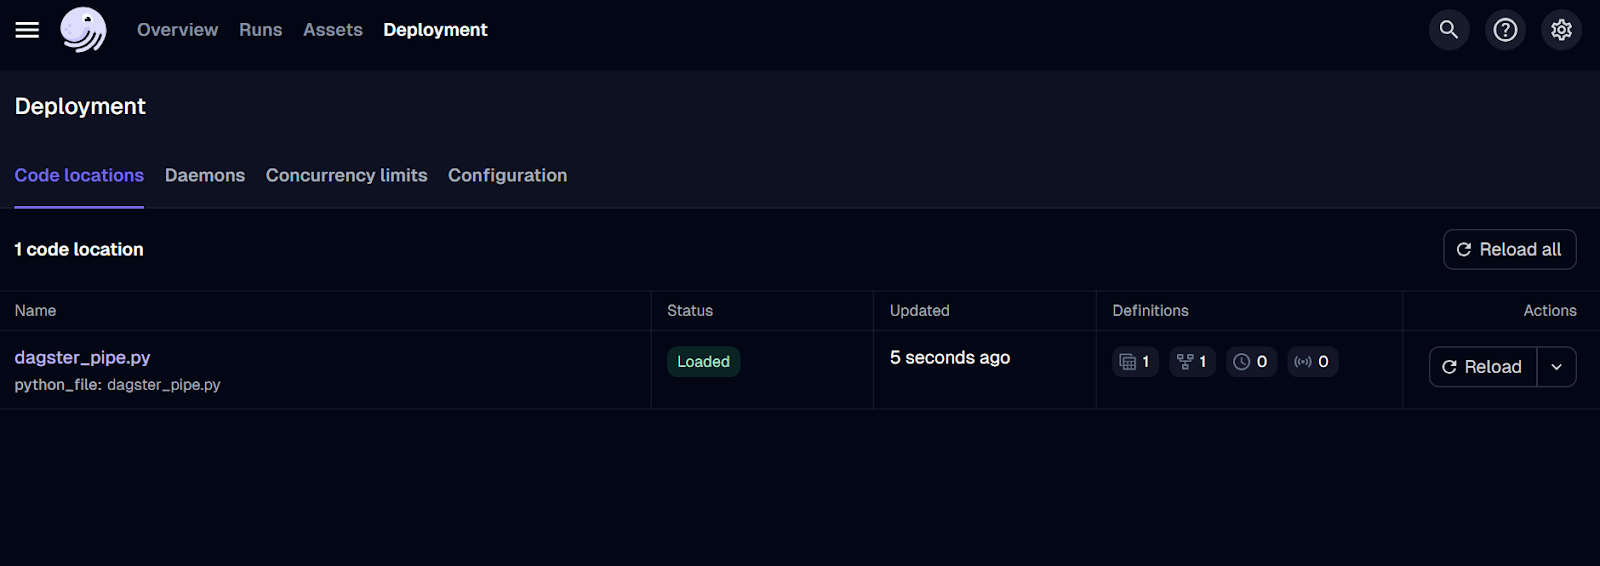
Dagster वेब सर्वर UI।
अब तक हमने केवल जॉब को परिनियोजित किया है। वर्कफ़्लो चलाने के लिए, “Runs” टैब पर जाएँ और “Launch a new run” बटन पर क्लिक करें।
रन सफलतापूर्वक पूरा होना चाहिए! लॉग देखने के लिए, जिस रन में आपकी रुचि है उसके ID पर क्लिक करें।
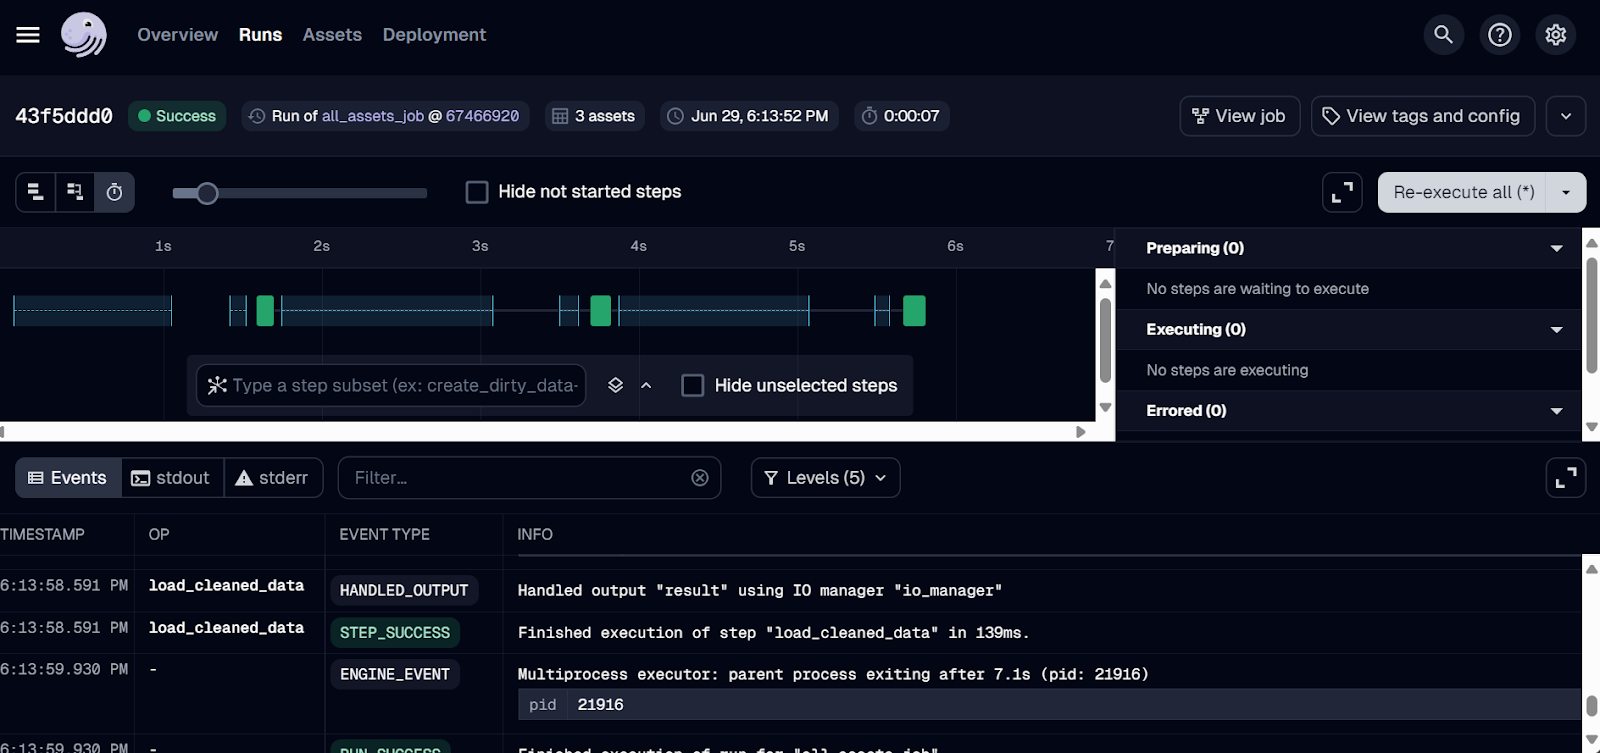
Dagster रन लॉग्स।
Mage AI एक ओपन-सोर्स हाइब्रिड डेटा ऑर्केस्ट्रेशन फ़्रेमवर्क है। हाइब्रिड का मतलब है कि आपको Jupyter Notebook की लचीलापन और मॉड्यूलर कोड का नियंत्रण दोनों मिलते हैं।
कोई भी, चाहे Python का सीमित ज्ञान ही क्यों न हो, डेटा पाइपलाइंस बना, चला और मॉनिटर कर सकता है। सीधे Python फ़ाइल लिखने और चलाने के बजाय, आप एक Mage AI प्रोजेक्ट बनाएँगे और उसे डैशबोर्ड में लॉन्च करेंगे, जहाँ आप अपनी डेटा पाइपलाइनों का निर्माण, संचालन और प्रबंधन करेंगे।
Airflow की तुलना में, Mage AI उपयोगकर्ता-अनुकूल इंटरफ़ेस और उपयोग में आसानी प्रदान करता है, जो डेटा इंजीनियरिंग में नए लोगों के लिए एक उत्कृष्ट विकल्प बनाता है। इसे स्केलेबिलिटी को ध्यान में रखकर डिज़ाइन किया गया है और यह बड़े पैमाने पर डेटा और जटिल पाइपलाइन संरचनाओं को कुशलतापूर्वक संभालने में सक्षम है।
मुझे थोड़ा अजीब लगा क्योंकि यह पूरी तरह से उस चीज़ से अलग था जिसकी मुझे आदत है। मुझे Mage AI वेब UI इंस्टॉल और लॉन्च करना पड़ा। यह आसान होना चाहिए था, लेकिन मुझे ETL पाइपलाइन बनाना और चलाना मुश्किल लगा। दूसरी ओर, मैं समझ सकता हूँ कि यह अनोखा डिज़ाइन इस क्षेत्र में नए लोगों के लिए क्यों आकर्षक हो सकता है, क्योंकि यह मूलतः ड्रैग-एंड-ड्रॉप और बटन दबाने जैसा है।
Abid Ali Awan, Author
Mage AI शुरू करना काफ़ी सरल है। हमें बस Mage AI Python पैकेज इंस्टॉल करना है।
$ pip install mage-aiऔर Mage AI प्रोजेक्ट शुरू करें।
$ mage start mage_ai_etl ऊपर दिया गया कमांड वेब सर्वर प्रारंभ करेगा। जैसा कि पहले बताया गया, सारा कोड एडिटिंग, जॉब रनिंग और जॉब मॉनिटरिंग Mage AI UI के माध्यम से होती है।
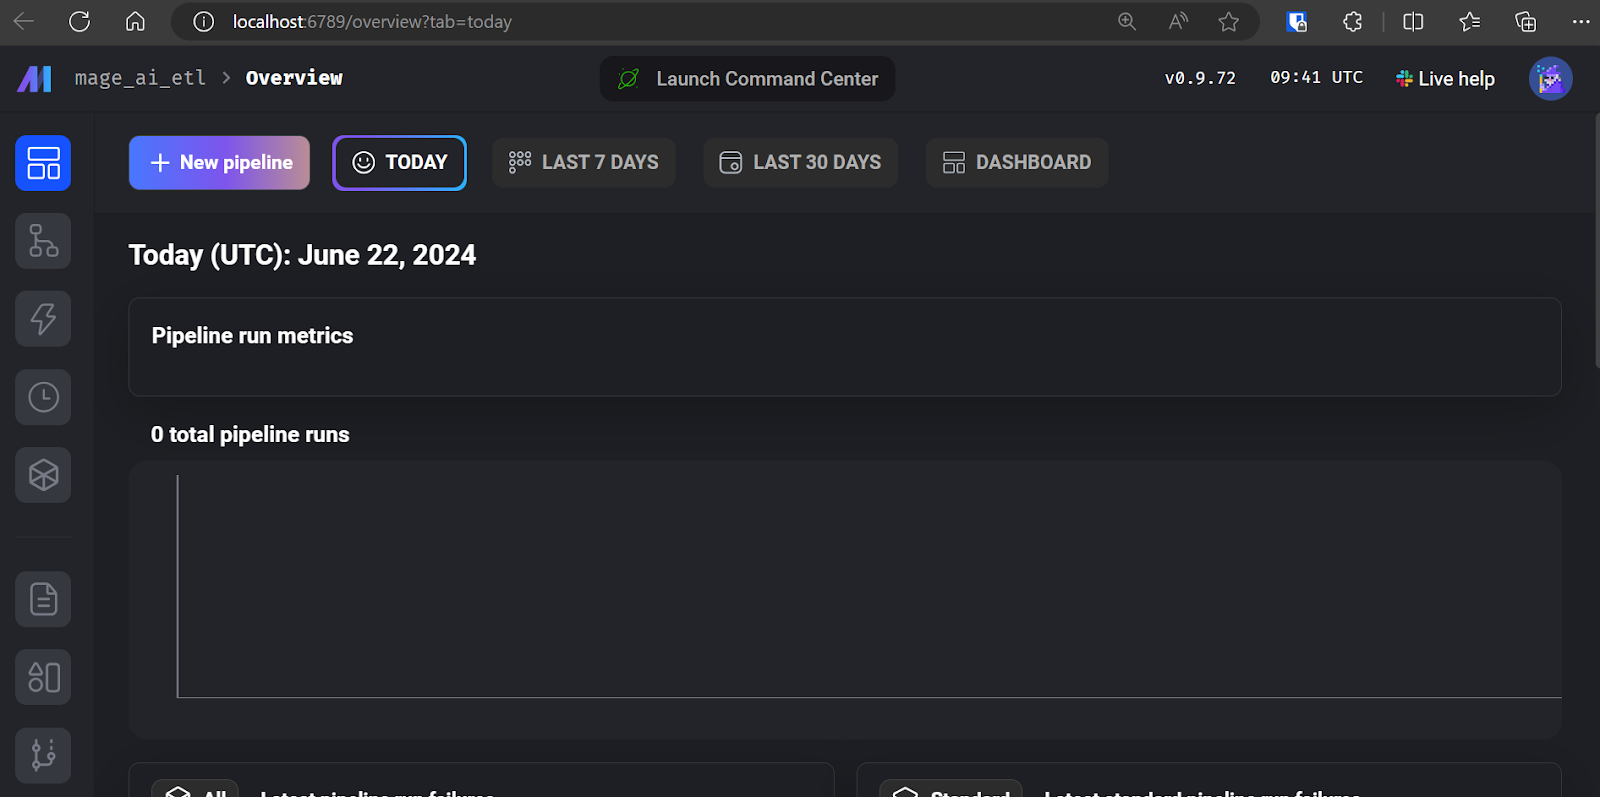
Mage AI UI।
अपनी पहली ETL पाइपलाइन बनाने के लिए “+ New pipeline” पर क्लिक करें। मैंने अपनी पाइपलाइन का नाम “simple_etl” रखा।
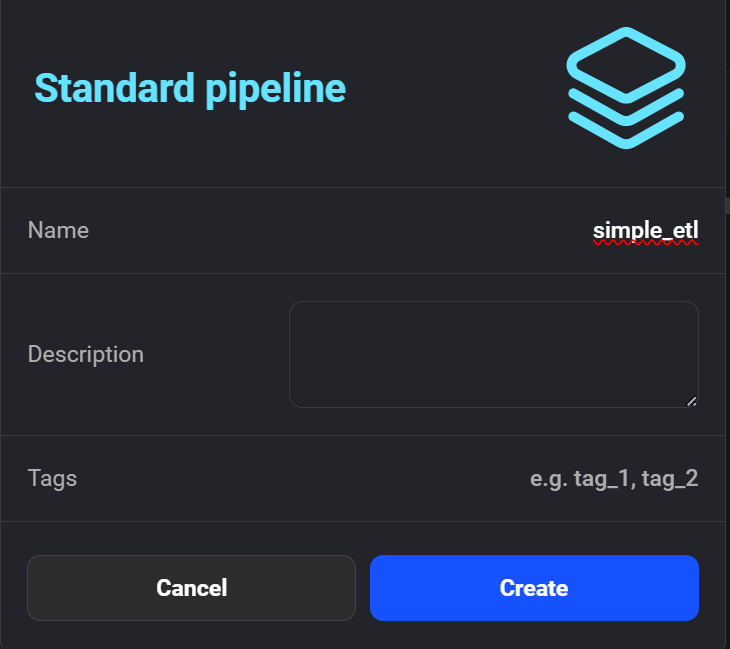
Mage AI में नई पाइपलाइन बनाना।
इसके बाद, इंटरफ़ेस आपसे कोडिंग शुरू करने के लिए एक मॉड्यूल जोड़ने के लिए कहेगा। “Data Loader” मॉड्यूल चुनें और निम्न Python कोड लिखें।
यहाँ, हम एक create_sample_csv() फ़ंक्शन घोषित करते हैं, जो हमारी पाइपलाइन का पहला चरण है। हम Mage AI के @data_loader डेकोरेटर का उपयोग करते हैं। हम एक test_output() फ़ंक्शन भी परिभाषित करते हैं, जो यह सत्यापित करता है कि आउटपुट मौजूद है। यह टास्क निर्भरता प्रबंधन में मदद करता है।
import io
import pandas as pd

if 'data_loader' not in globals():
    from mage_ai.data_preparation.decorators import data_loader
if 'test' not in globals():
    from mage_ai.data_preparation.decorators import test

@data_loader
def create_sample_csv() -> pd.DataFrame:
    """
    Create a sample CSV file with duplicates and missing values
    """
    csv_data = """
category,product,quantity,price
Electronics,Laptop,5,1000
Electronics,Smartphone,10,500
Clothing,T-shirt,50,20
Clothing,Jeans,30,50
Books,Novel,100,15
Books,Textbook,20,80
Electronics,Laptop,5,1000
Clothing,T-shirt,,20
Electronics,Tablet,,300
Books,Magazine,25,
"""
    return pd.read_csv(io.StringIO(csv_data.strip()))

@test
def test_output(df) -> None:
    """
    Template code for testing the output of the block.
    """
    assert df is not None, 'The output is undefined'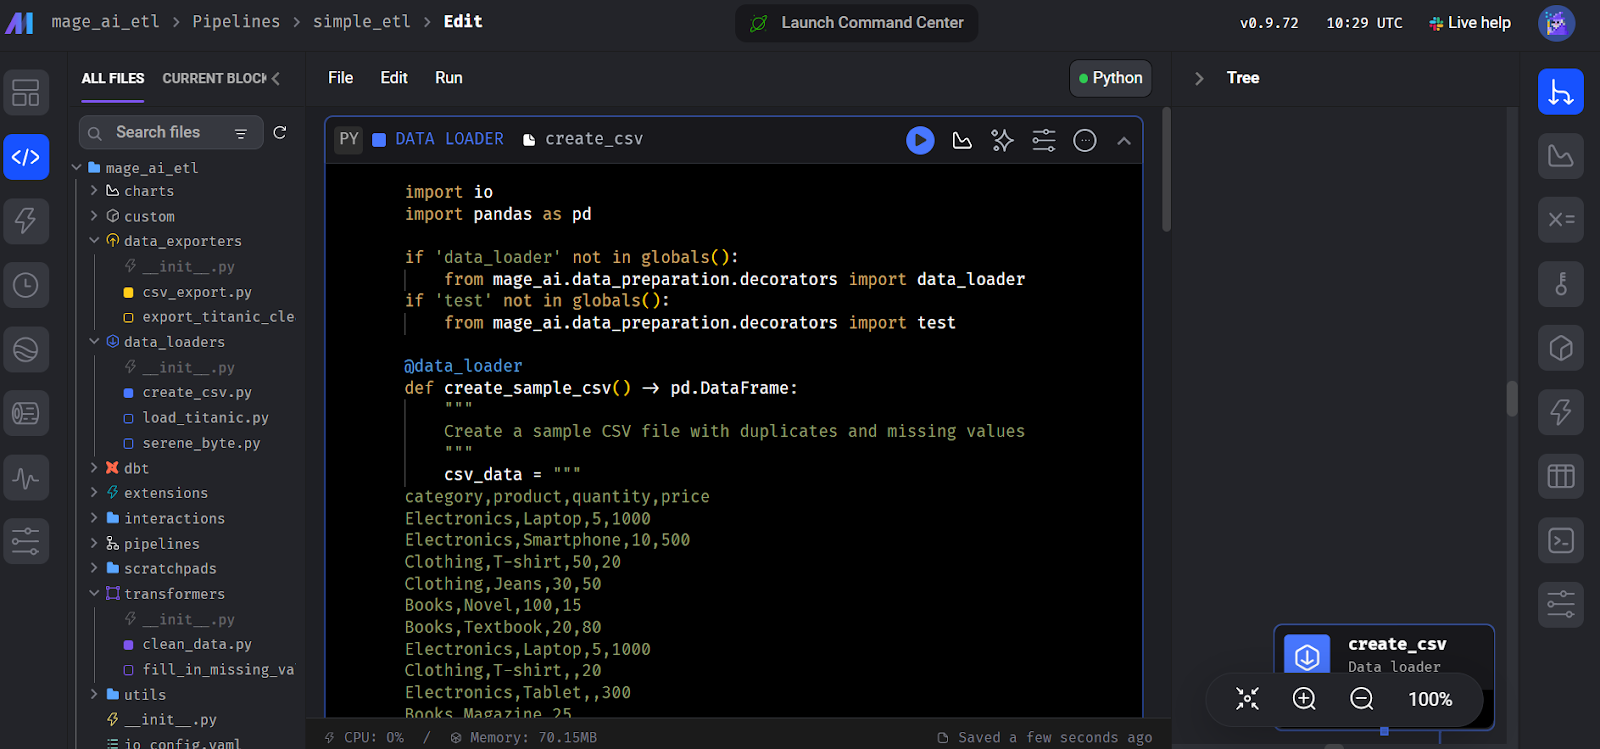
Mage AI में डेटा लोडर ब्लॉक बनाना।
इसी तरह, “Transformer” नामक एक और मॉड्यूल बनाएँ और नीचे दिए गए कोड के अनुसार clean_data() फ़ंक्शन जोड़ें।
आप test() फ़ंक्शन को नज़रअंदाज़ कर सकते हैं; आपको केवल मुख्य ट्रांसफ़ॉर्मर फ़ंक्शन clean_data() जोड़ना है।
import pandas as pd

if 'transformer' not in globals():
    from mage_ai.data_preparation.decorators import transformer
if 'test' not in globals():
    from mage_ai.data_preparation.decorators import test

@transformer
def clean_data(df: pd.DataFrame) -> pd.DataFrame:
    """
    Clean and transform the data
    """
    # Remove duplicates
    df = df.drop_duplicates()
    # Fill missing values with 0
    df = df.fillna(0)
    return df

@test
def test_output(df) -> None:
    """
    Template code for testing the output of the block.
    """
    assert df is not None, 'The output is undefined'
इसी तरह, “Data Exporter” मॉड्यूल बनाएँ और निम्न कोड जोड़ें। कोड में एक डेटा लोडिंग फ़ंक्शन export_data_to_csv() घोषित है, जो ट्रांसफ़ॉर्म किए गए डेटा को CSV फ़ाइल में सेव करता है।
import pandas as pd

if 'data_exporter' not in globals():
    from mage_ai.data_preparation.decorators import data_exporter

@data_exporter
def export_data_to_csv(df: pd.DataFrame) -> None:
    """
    Export the processed data to a CSV file
    """
    df.to_csv('output_data.csv', index=False)
    print("Data exported successfully to output_data.csv")
पाइपलाइन चलाने के लिए, “Trigger” टैब पर जाएँ, और “Run@once” पर क्लिक करें।
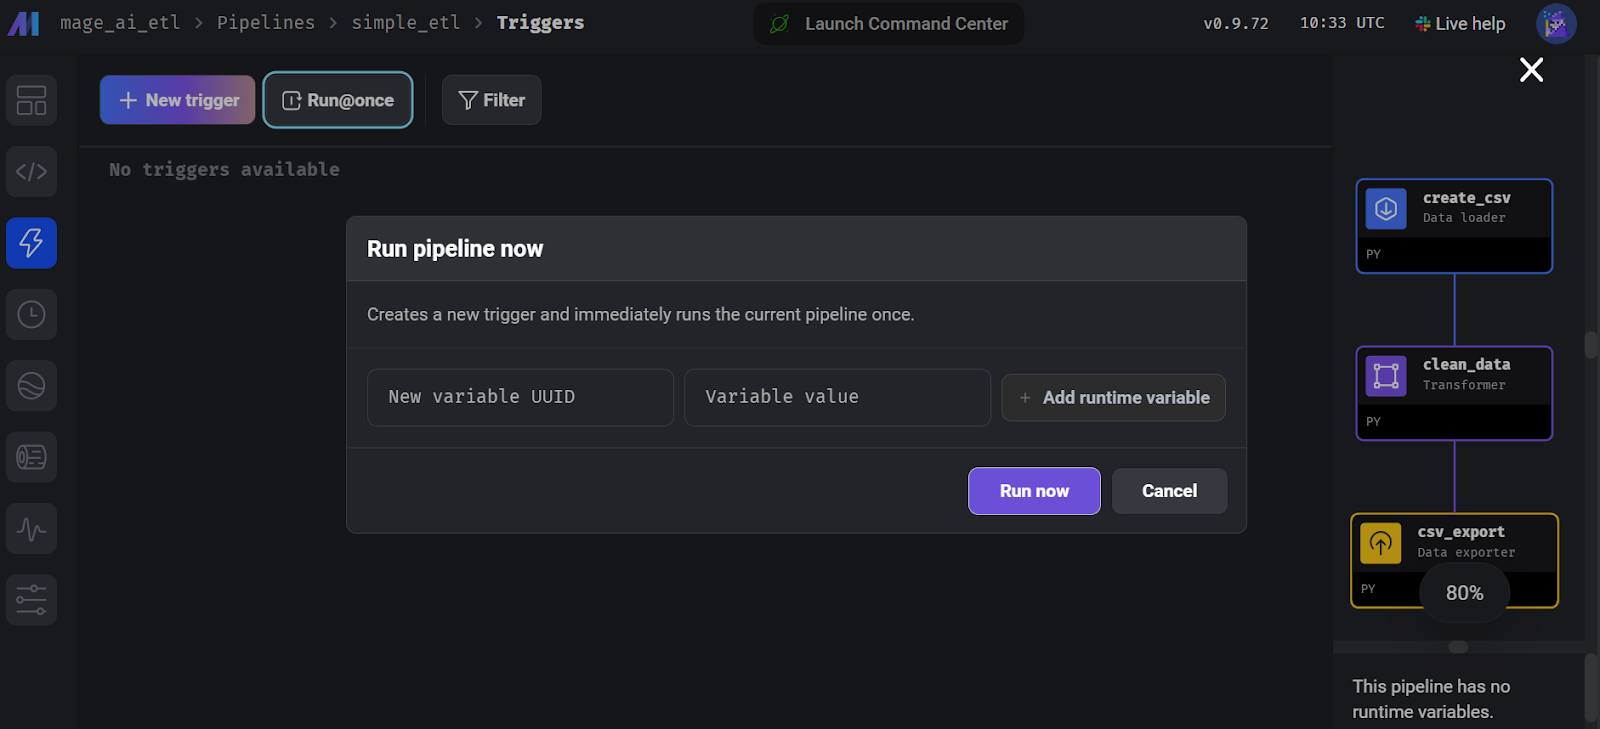
Mage AI में पाइपलाइन चलाना।
रन लॉग देखने के लिए, “Runs” टैब पर जाएँ और हाल ही में चले पाइपलाइन पर “Logs” बटन पर क्लिक करें।
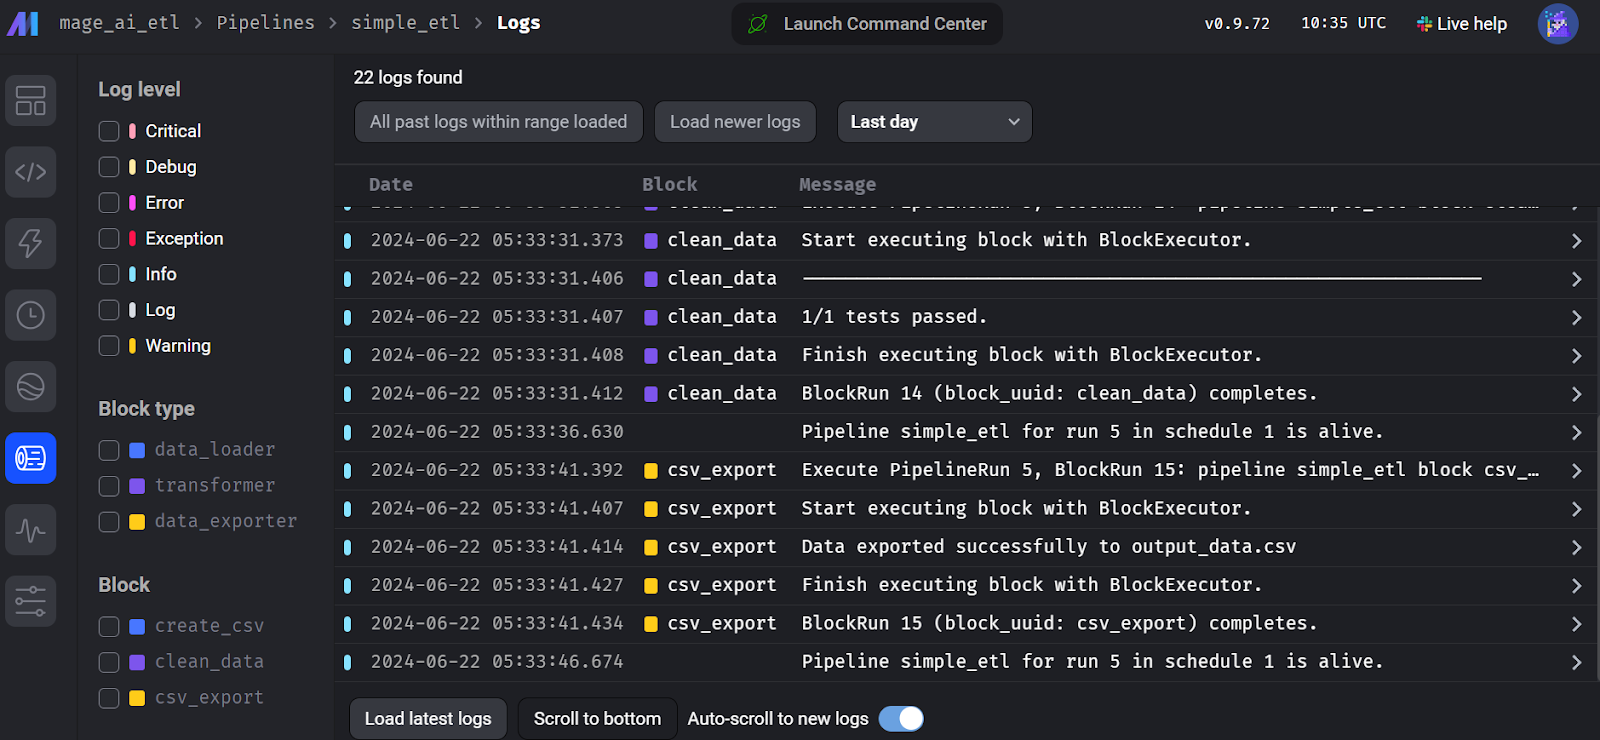
Mage AI फ़्लो रन लॉग्स।
Kedro एक और लोकप्रिय ओपन-सोर्स डेटा ऑर्केस्ट्रेशन फ़्रेमवर्क है जो अन्य टूल्स से थोड़ा भिन्न है। इसे मशीन लर्निंग इंजीनियरों के लिए बनाया गया है और यह सॉफ़्टवेयर इंजीनियरिंग की कई अवधारणाओं को मशीन लर्निंग प्रोजेक्ट्स में लागू करता है।
Kedro को अत्यधिक मॉड्यूलर बनाया गया है, जिसका अर्थ है कि किसी डेटासेट को एक्सपोर्ट करने के लिए भी आपको एक डेटा कैटलॉग बनाना पड़ता है, जो डेटा का स्थान और प्रकार निर्दिष्ट करता है, और पाइपलाइन भर में मानकीकृत और कुशल डेटा प्रबंधन सुनिश्चित करता है।
यह समझने के लिए कि Kedro मशीन लर्निंग इकोसिस्टम में कैसे फिट बैठता है, आप लेख 25 Top MLOps Tools You Need to Know in 2024 पढ़कर विभिन्न MLOps टूल्स का अन्वेषण कर सकते हैं।
Airflow की तुलना में, Kedro API डेटा पाइपलाइन बनाने के लिए सरल है। यह अधिकतर मशीन लर्निंग इंजीनियरिंग पर केंद्रित है और डेटा का वर्गीकरण व वर्शनिंग प्रदान करता है।
कोडिंग भाग काफी सीधा है, लेकिन जब आप अपनी पाइपलाइन निष्पादित करना चाहते हैं तब समस्याएँ आती हैं। आपको डेटा कैटलॉग बनाना, पाइपलाइन रजिस्टर करना, और Kedro प्रोजेक्ट संरचना समझनी होती है। मैं कहूँगा कि यह Dagster और Prefect की तुलना में अधिक चुनौतीपूर्ण है। हालाँकि, मैं समझता हूँ कि इसे इस तरह क्यों डिज़ाइन किया गया है: ताकि आपकी डेटा पाइपलाइन विश्वसनीय और त्रुटि-रहित हो।
Abid Ali Awan, Author
Kedro डेटा पाइपलाइन बनाना एक अलग तरह का काम है। फ़्रेमवर्क मॉड्यूलर है, और वर्कफ़्लो को सफलतापूर्वक चलाने के लिए आपको प्रोजेक्ट संरचना और विभिन्न चरणों को समझना होगा।
Kedro Python पैकेज इंस्टॉल करके शुरू करें।
$ pip install kedroKedro प्रोजेक्ट इनिशियलाइज़ करें।
$ kedro new --name=kedro_etl --tools=none --example=n प्रोजेक्ट डायरेक्टरी में जाएँ।
$ cd kedro-etl pipelines फ़ोल्डर के भीतर data_processing नाम का फ़ोल्डर बनाएँ।
$ mkdir -p src/kedro_etl/pipelines/data_processing kedro_pipe.py नामक एक Python फ़ाइल बनाएँ और उसे अपने पसंदीदा IDE में खोलें, उदाहरण के लिए आप Visual Studio Code का उपयोग कर सकते हैं।
$ code src/kedro_etl/pipelines/data_processing/kedro_pipe.pyPython स्क्रिप्ट में एक्सट्रैक्ट, ट्रांसफ़ॉर्म, और लोड फ़ंक्शंस होने चाहिए, जो पाइपलाइन में नोड्स होते हैं। इस मामले में, ये हैं create_sample_data(), clean_data(), और load_and_process_data() फ़ंक्शंस।
फिर, हम इन नोड्स को Kedro की Pipeline क्लास का उपयोग करके create_pipeline() फ़ंक्शन के अंदर जोड़ते हैं। पाइपलाइन फ़ंक्शन में, हम नोड्स परिभाषित करते हैं, और प्रत्येक नोड के inputs, outputs, और एक नोड name होते हैं।
import pandas as pd
import numpy as np
from kedro.pipeline import Pipeline, node

def create_sample_data():
    data = {
        'id': range(1, 101),
        'name': [f'Person_{i}' for i in range(1, 101)],
        'age': np.random.randint(18, 80, 100),
        'salary': np.random.randint(20000, 100000, 100),
        'missing_values': [np.nan if i % 10 == 0 else i for i in range(100)]
    }
    return pd.DataFrame(data)

def clean_data(df: pd.DataFrame):
    # Remove rows with missing values
    df_cleaned = df.dropna()

    # Convert salary to thousands
    df_cleaned['salary'] = df_cleaned['salary'] / 1000

    # Capitalize names
    df_cleaned['name'] = df_cleaned['name'].str.upper()

    return df_cleaned

def load_and_process_data(df: pd.DataFrame):
    # Calculate average salary
    avg_salary = df['salary'].mean()

    # Add a new column for salary category
    df['salary_category'] = df['salary'].apply(
        lambda x: 'High' if x > avg_salary else 'Low')

    # Calculate age groups
    df['age_group'] = pd.cut(df['age'], bins=[0, 30, 50, 100], labels=[
                             'Young', 'Middle', 'Senior'])

    print(df)
    return df

def create_pipeline(**kwargs):
    return Pipeline(
        [
            node(
                func=create_sample_data,
                inputs=None,
                outputs="raw_data",
                name="create_sample_data_node",
            ),
            node(
                func=clean_data,
                inputs="raw_data",
                outputs="cleaned_data",
                name="clean_data_node",
            ),
            node(
                func=load_and_process_data,
                inputs="cleaned_data",
                outputs="processed_data",
                name="load_and_process_data_node",
            ),
        ]
    )
यदि हम डेटा कैटलॉग बनाए बिना पाइपलाइन चलाते हैं, तो यह हमारा डेटा एक्सपोर्ट नहीं करेगा। इसलिए, हमें conf/base/catalog.yml फ़ाइल में जाकर डेटासेट कॉन्फ़िगरेशन प्रदान करके उसे संपादित करना होगा।
raw_data:
  type: pandas.CSVDataset
  filepath: ./data/kedro/sample_data.csv

cleaned_data:
  type: pandas.CSVDataset
  filepath: ./data/kedro/cleaned_data.csv

processed_data:
  type: pandas.CSVDataset
  filepath: ./data/kedro/processed_data.csv
हमें अपने नए बनाए गए Python फ़ाइल को पाइपलाइन रजिस्ट्री में भी शामिल करना होगा। ऐसा करने के लिए, src/simple_etl/pipeline_registry.py Python फ़ाइल पर जाएँ और निम्न कोड शामिल करें।
"""Project pipelines."""
from __future__ import annotations

from kedro.pipeline import Pipeline
from kedro_etl.pipelines.data_processing import kedro_pipe

def register_pipelines() -> Dict[str, Pipeline]:
    data_processing_pipeline = kedro_pipe.create_pipeline()

    return {
        "__default__": data_processing_pipeline,
        "data_processing": data_processing_pipeline,
    }
निम्न कमांड चलाकर पाइपलाइन चलाएँ और टर्मिनल में लाइव लॉग देखें।
$ kedro run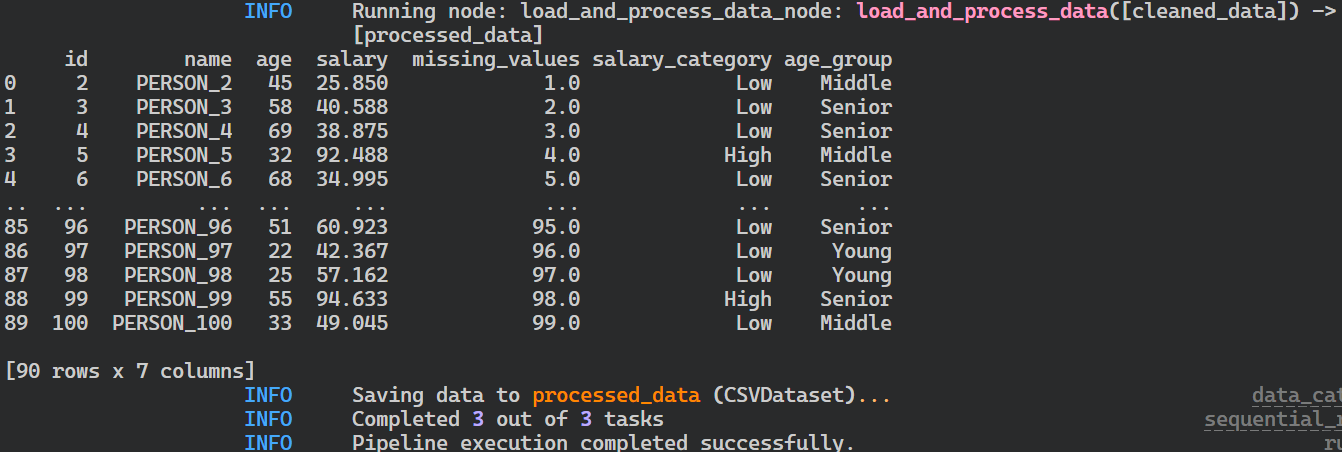
Kedro पाइपलाइन रन के लॉग्स।
पाइपलाइन चलाने के बाद, आपकी फ़ाइलें डेटा कैटलॉग में परिभाषित लोकेशन पर CSV फ़ॉर्मेट में सेव हो जाएँगी।
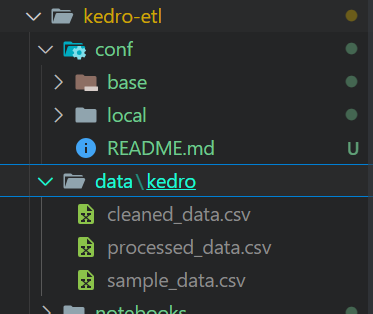
Kedro पाइपलाइन रन की आउटपुट फ़ाइलें।
यदि आपको पाइपलाइन चलाने में समस्याएँ आती हैं, तो कृपया सभी एक्सटेंशंस के साथ Kedro इंस्टॉल करने पर विचार करें।
$ pip install "kedro[all]"हम kedro-viz टूल इंस्टॉल करके अपनी पाइपलाइनों को विज़ुअलाइज़ और साझा कर सकते हैं।
$ pip install kedro-vizफिर, निम्न कमांड चलाने से हम सभी डेटा पाइपलाइनों और डेटा नोड्स को विज़ुअलाइज़ कर पाएँगे। यह प्रयोग ट्रेसिंग और पाइपलाइन विज़ुअलाइज़ेशन साझा करने का विकल्प भी प्रदान करता है।
$ kedro viz run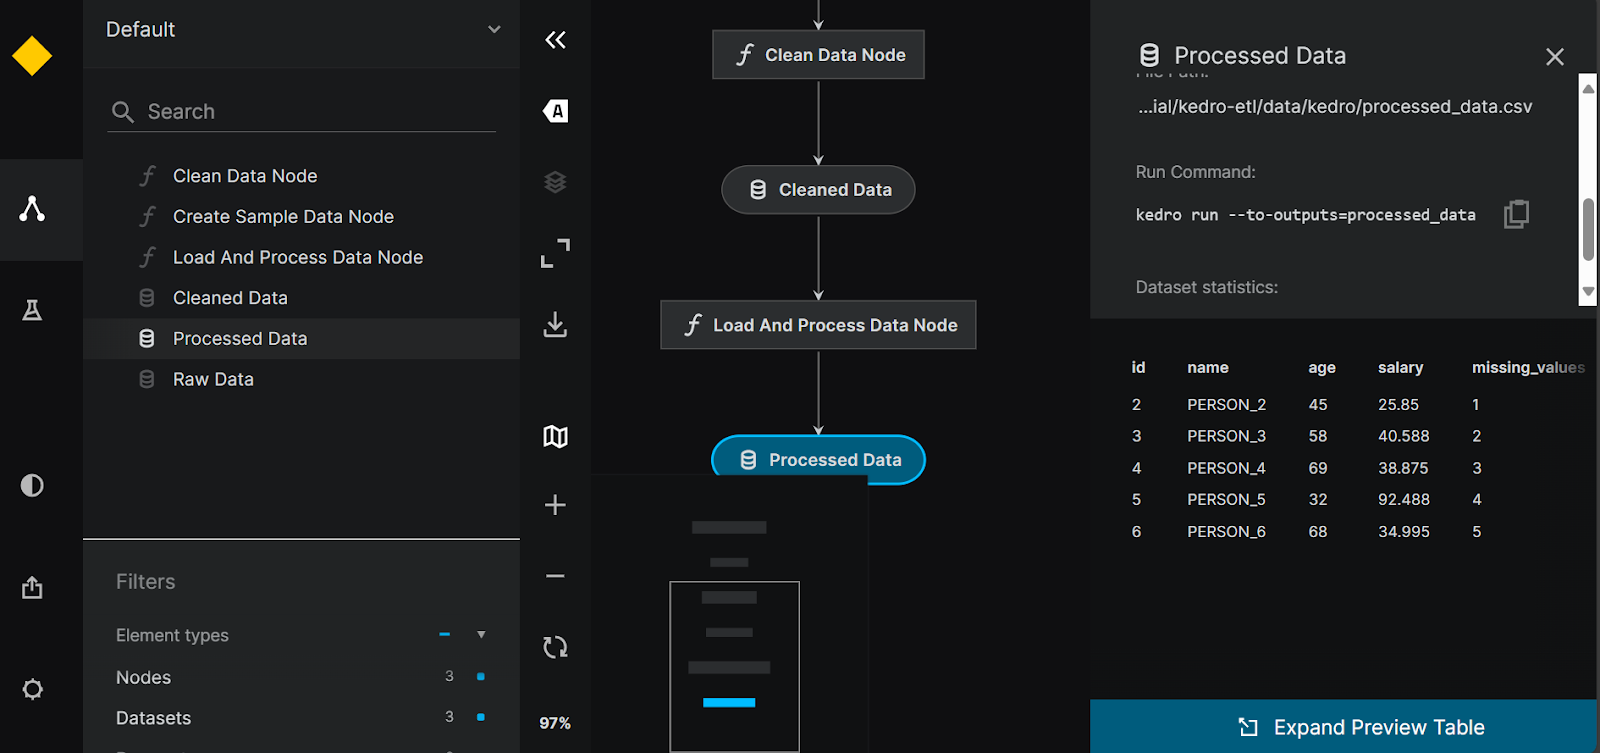
Kedro पाइपलाइन विज़ुअलाइज़ेशन।
Luigi एक ओपन-सोर्स, Python-आधारित फ़्रेमवर्क है जिसे Spotify ने विकसित किया है। यह लंबे समय तक चलने वाली बैच प्रक्रियाओं और जटिल डेटा पाइपलाइनों के प्रबंधन में उत्कृष्ट है। यह निर्भरता समाधान, वर्कफ़्लो प्रबंधन, विज़ुअलाइज़ेशन और फेल्योर रिकवरी में अच्छा है, जिससे यह डेटा वर्कफ़्लोज़ को ऑर्केस्ट्रेट करने के लिए एक शक्तिशाली टूल बनता है।
Airflow की तुलना में, Luigi में न्यूनतम API, कैलेंडर शेड्यूलिंग, और एक वफादार उपयोगकर्ता समुदाय है जो डेटा ऑर्केस्ट्रेशन पाइपलाइन से संबंधित किसी भी समस्या में आपकी मदद करेगा।
यदि आप Python में शुरुआती हैं, तो आपको पाइपलाइनों को बनाना और चलाना कठिन लग सकता है। हालाँकि, प्रलेखन और गाइड्स आपको जल्दी शुरू करने में मदद कर सकते हैं। लॉग सीमित जानकारी प्रदान करते हैं, और डैशबोर्ड केवल DAGs और निर्भरताओं के विज़ुअलाइज़ेशन के लिए एक टूल है।
Abid Ali Awan, Author
Luigi डेटा पाइपलाइन बनाने के लिए ऑब्जेक्ट-ओरिएंटेड प्रोग्रामिंग की समझ आवश्यक है। आइए Luigi Python पैकेज इंस्टॉल करके शुरू करें।
$ pip install luigiLuigi में एक सरल ETL पाइपलाइन विकसित करने के लिए, हम इंटरकनेक्टेड टास्क बनाएँगे। टास्क के रूप में Python फ़ंक्शंस बनाने के बजाय, हम पाइपलाइन के प्रत्येक चरण के लिए एक Python क्लास बनाएँगे— FetchData, ProcessData और GenerateReport। प्रत्येक क्लास में तीन फ़ंक्शंस होंगे: requires(), output(), और run()।
requires() और output() फ़ंक्शंस टास्क्स को जोड़ेंगे, और run() फ़ंक्शन प्रोसेसिंग कोड निष्पादित करेगा। अंत में, हम पाइपलाइन को पाइपलाइन के अंतिम टास्क का उपयोग करके बिल्ड करेंगे।
import luigi
import pandas as pd
import numpy as np

class FetchData(luigi.Task):
    def output(self):
        return luigi.LocalTarget('data/fetch_data.csv')

    def run(self):
        # Simulate fetching data by creating a sample CSV file
        data = {
            'column1': [1, 2, np.nan, 4],
            'column2': ['A', 'B', 'C', np.nan]
        }
        df = pd.DataFrame(data)
        df.to_csv(self.output().path, index=False)

class ProcessData(luigi.Task):
    def requires(self):
        return FetchData()

    def output(self):
        return luigi.LocalTarget('data/process_data.csv')

    def run(self):
        df = pd.read_csv(self.input().path)
        # Fill missing values
        df['column1'].fillna(df['column1'].mean(), inplace=True)
        df['column2'].fillna('B', inplace=True)
        df.to_csv(self.output().path, index=False)

class GenerateReport(luigi.Task):
    def requires(self):
        return ProcessData()

    def output(self):
        return luigi.LocalTarget('data/generate_report.txt')

    def run(self):
        df = pd.read_csv(self.input().path)
        # Simple data analysis: calculate mean of column1 and value counts of column2
        mean_column1 = df['column1'].mean()
        value_counts_column2 = df['column2'].value_counts()

        with self.output().open('w') as out_file:
            out_file.write(f'Mean of column1: {mean_column1}\n')
            out_file.write('Value counts of column2:\n')
            out_file.write(value_counts_column2.to_string())

if __name__ == '__main__':
    luigi.build([GenerateReport()], local_scheduler=True)
ऊपर दिया गया कोड Jupyter Notebook में चलाएँ या Python फ़ाइल बनाकर टर्मिनल से चलाएँ।
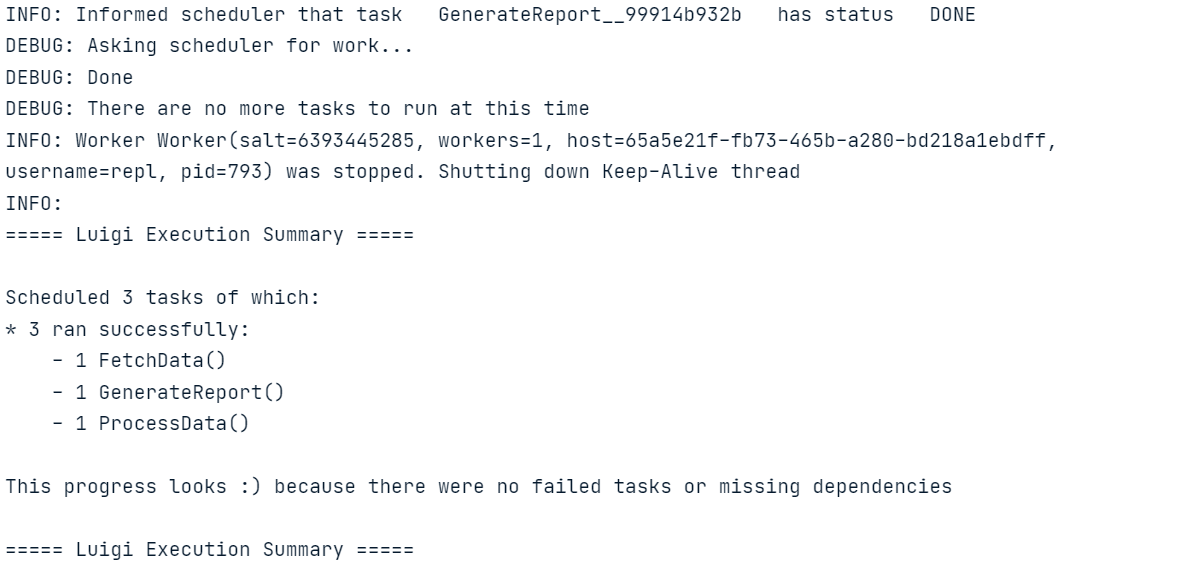
Luigi की तरह ही, आप यह भी सीख सकते हैं कि Apache Airflow के साथ ETL पाइपलाइन कैसे बनाते हैं। यह ट्यूटोरियल Apache Airflow के साथ डेटा को एक्सट्रैक्ट, ट्रांसफ़ॉर्म और लोड करने की मूल बातें कवर करता है।
हमें पाइपलाइन रन को शेड्यूल करने या इवेंट के साथ ट्रिगर करने के लिए Luigi सेंट्रल प्लानर को इनिशियलाइज़ करना होगा।
टर्मिनल में निम्न कमांड टाइप करके शेड्यूलर शुरू करें।
$ luigid 2024-06-22 13:35:18,636 luigi[25056] INFO: logging configured by default settings
2024-06-22 13:35:18,636 luigi.scheduler[25056] INFO: No prior state file exists at /var/lib/luigi-server/state.pickle. Starting with empty state
2024-06-22 13:35:18,640 luigi.server[25056] INFO: Scheduler starting upपाइपलाइन चलाने के लिए, नया टर्मिनल खोलें और निम्न कमांड टाइप करें। Luigi कमांड को Python फ़ाइल का नाम और वह अंतिम टास्क चाहिए जिसे हम चलाना चाहते हैं। इस मामले में, फ़ाइल का नाम luigi_pipe.py है, और हमारा अंतिम Luigi टास्क है GenerateReport।
$ python -m luigi --module luigi_pipe GenerateReportयदि आप पाइपलाइन रन और टास्क की स्थिति को विज़ुअलाइज़ करना चाहते हैं, तो अपने ब्राउज़र में बस http://localhost:8082 पर जाएँ।
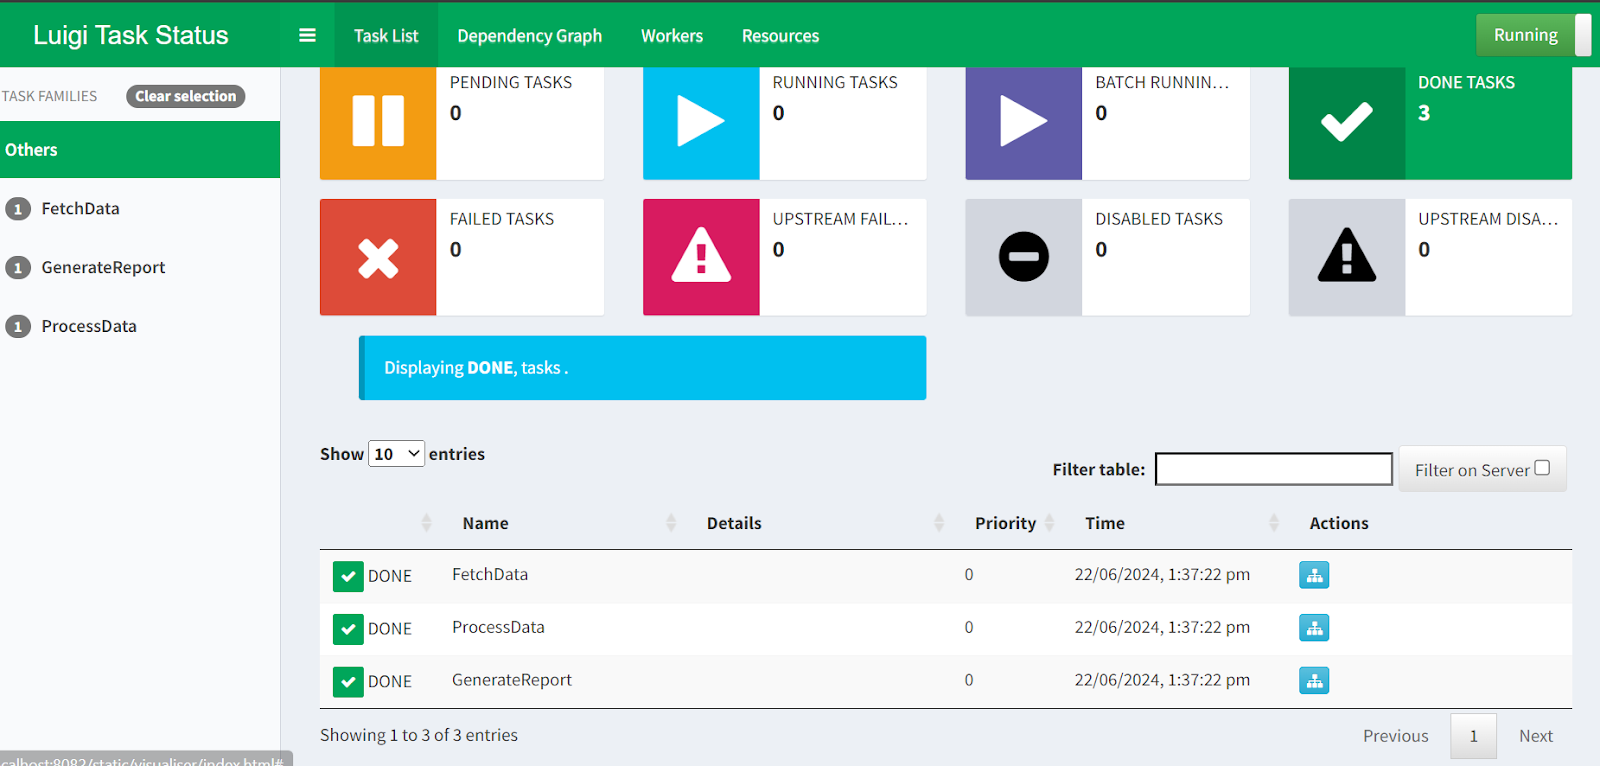
Luigi Central Planner वेब UI।
Airflow के 5 बेहतरीन विकल्पों की हमारी वॉकथ्रू यहीं समाप्त होती है! यदि आप इस लेख में प्रस्तुत किसी भी उदाहरण में और गहराई से जाना चाहते हैं, तो इन संसाधनों पर विचार करें:
इस ट्यूटोरियल में, हमने Airflow के शीर्ष ओपन-सोर्स, निःशुल्क विकल्पों पर चर्चा की। हमने प्रत्येक डेटा ऑर्केस्ट्रेशन टूल के बारे में सीखा, और एक सरल ETL पाइपलाइन बनाई व चलाई। कोड उदाहरण देखने से आपको यह तय करने में मदद मिलेगी कि आपके उपयोग-केस के लिए कौन-सा सबसे बेहतर काम करता है।
यदि आप शुरुआती हैं, तो मैं Prefect या Mage AI से शुरू करने का सुझाव देता हूँ, क्योंकि ये उपयोगकर्ता-अनुकूल हैं और सरल सेटअप के साथ आते हैं। हालाँकि, यदि आप सॉफ़्टवेयर इंजीनियरिंग प्रथाओं का पालन करने वाले अधिक उन्नत टूल्स की तलाश में हैं, तो मैं Dagster, Kedro और Luigi का अन्वेषण करने की अनुशंसा करता हूँ।
इस लेख को पढ़ने के बाद, आपके डेटा इंजीनियरिंग सफ़र में अगला स्वाभाविक कदम DataCamp के Data Engineer in Python जैसे सर्टिफिकेशन प्राप्त करना है, ताकि आप अन्य टूल्स के बारे में जान सकें और एक एंड-टू-एंड डेटा पाइपलाइन बना सकें जिसे आप प्रोडक्शन में परिनियोजित कर सकें।
इन कोर्सेज़ के साथ डेटा इंजीनियरिंग के बारे में और जानें!
course
Track
course