Curso
Introducción a la ingeniería de datos
4 h
129.7K
Imagen del autor.
Apache Airflow es una popular herramienta de orquestación de datos de código abierto pensada para crear, programar y monitorizar pipelines de datos. Incluye un panel para gestionar el estado de los flujos de trabajo, lo que la convierte en una gran opción para la mayoría de necesidades.
Aun así, Airflow carece de algunas funciones importantes que pueden ser clave en requisitos modernos y complejos de orquestación de datos.
En este tutorial, veremos cinco alternativas a Airflow que amplían sus capacidades y cubren algunas de sus limitaciones. Además, aprenderás a construir un pipeline ETL sencillo con cada herramienta, ejecutarlo y visualizarlo en sus paneles.
Airflow es potente para muchos flujos de datos, pero presenta limitaciones que pueden llevar a algunas empresas a valorar otras opciones.
Algunas razones para optar por una alternativa:
Antes de entrar en el código de otras herramientas de orquestación, conviene aprender a escribir un pipeline de datos con Apache Airflow siguiendo el tutorial Getting Started with Apache Airflow para poder comparar con criterio.
Si eres totalmente nuevo en Airflow, plantéate hacer el curso corto Introduction to Airflow in Python para aprender lo básico de crear y programar pipelines de datos.
A continuación describimos las 5 principales alternativas a Airflow y cómo usarlas con ejemplos de código.
Prefect es una herramienta de orquestación de flujos en Python de código abierto pensada para ingenieros de datos e ingenieros de machine learning. Ofrece una API sencilla para crear pipelines rápidamente y gestionarlos desde un panel interactivo.
Perfect ofrece un modelo de ejecución híbrido: puedes desplegar el flujo en la nube y ejecutarlo allí o usar tu repositorio local.
En comparación con Airflow, Prefect incorpora funciones avanzadas como dependencias de tareas automáticas, disparadores basados en eventos, notificaciones integradas, infraestructura específica por flujo y compartición de datos entre tareas. Todo ello lo convierte en una solución potente para gestionar flujos complejos de forma eficiente.
Prefect es sencillo y viene con funciones muy potentes. Me llevó básicamente 5 minutos ejecutar el código de ejemplo. Me gusta especialmente el diseño del panel, cómo configuras notificaciones, relanzas pipelines y gestionas y monitorizas todo desde el Dashboard.
Abid Ali Awan, Author
Lee el artículo Airflow vs Prefect: Deciding Which is Right For Your Data Workflow para una comparativa detallada entre estas dos herramientas de orquestación.
Empezaremos el proyecto instalando el paquete de Python. Ejecuta este comando en una terminal.
$ pip install -U prefectDespués crearemos un script de Python llamado prefect_etl.py y añadiremos el siguiente código.
from prefect import task, flow
import pandas as pd

# Extract data
@task
def extract_data():
    # Simulating data extraction
    data = {
        "name": ["Alice", "Bob", "Charlie"],
        "age": [25, 30, 35],
        "city": ["New York", "Los Angeles", "Chicago"]
    }
    df = pd.DataFrame(data)
    return df

# Transform data
@task
def transform_data(df: pd.DataFrame):
    # Example transformation: adding a new column
    df["age_plus_ten"] = df["age"] + 10
    return df

# Load data
@task
def load_data(df: pd.DataFrame):
    # Simulating data load
    print("Loading data to target destination:")
    print(df)

# Defining the flow
@flow(log_prints=True)
def etl():
    raw_data = extract_data()
    transformed_data = transform_data(raw_data)
    load_data(transformed_data)

# Running the flow
if __name__ == "__main__":
    etl()
El código anterior define las funciones de tarea extract_data(), transform_data() y load_data() y las ejecuta en serie dentro de un flow llamado etl(). Estas funciones se crean con decoradores de Prefect.
En resumen, creamos un DataFrame de pandas, lo transformamos y mostramos el resultado final con print. Es una forma sencilla de simular un pipeline ETL.
Para ejecutar el flujo, basta con lanzar el script de Python con este comando.
$ python prefect_etl.py Como ves, la ejecución del flujo se completó correctamente.
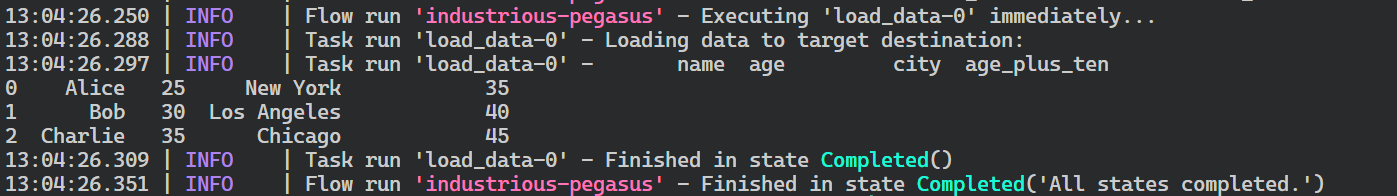
Registros de ejecución del flujo en Prefect.
Ahora vamos a desplegar el flujo para poder programarlo o dispararlo por evento. Desplegar también permite monitorizar y gestionar varios flujos de forma centralizada.
Para desplegarlo, usaremos la CLI de Prefect. La función deploy necesita el nombre del archivo Python, el nombre de la función del flow y el nombre del deployment. En este caso, lo llamamos “simple_etl”.
$ prefect deploy prefect_etl.py:etl -n 'simple_etl'Tras ejecutar el script anterior en la terminal, puede que recibas el mensaje de que no tienes un worker pool para ejecutar el deployment. Para crearlo, usa este comando.
$ prefect worker start --pool 'datacamp'Ahora que ya tienes un worker pool, abre otra terminal y lanza el deployment. El comando prefect deployment run requiere “<flow-function-name>/<deployment-name>” como argumento, como ves abajo.
$ prefect deployment run 'etl/simple_etlComo resultado, verás un mensaje indicando que el flujo se está ejecutando. Normalmente, la ejecución recibe un nombre aleatorio; en mi caso fue witty-lorikeet.
Creating flow run for deployment 'etl/simple_etl'...
Created flow run 'witty-lorikeet'.
└── UUID: 4e0495b0-9c7e-4ed8-b9ab-5160994dc7f0
└── Parameters: {}
└── Job Variables: {}
└── Scheduled start time: 2024-06-22 14:05:01 PKT (now)
└── URL: <no dashboard available>
Para ver el log completo, vuelve a la ventana de terminal donde iniciaste el worker pool.
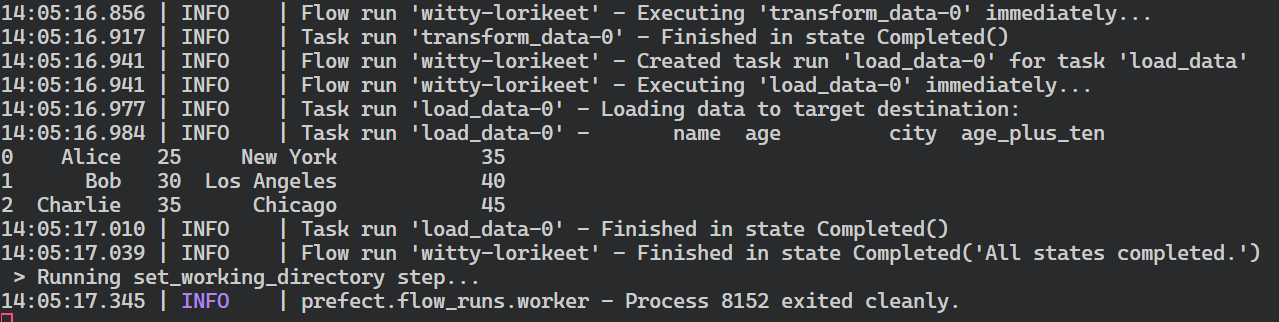
Resumen de ejecución del flujo en Prefect.
Para visualizar las ejecuciones y gestionar otros flujos, debes iniciar el servidor web de Prefect.
$ prefect server start Tras ejecutar el comando, deberías ser redirigido al panel de Prefect. Alternativamente, entra directamente en http://127.0.0.1:4200 en tu navegador.
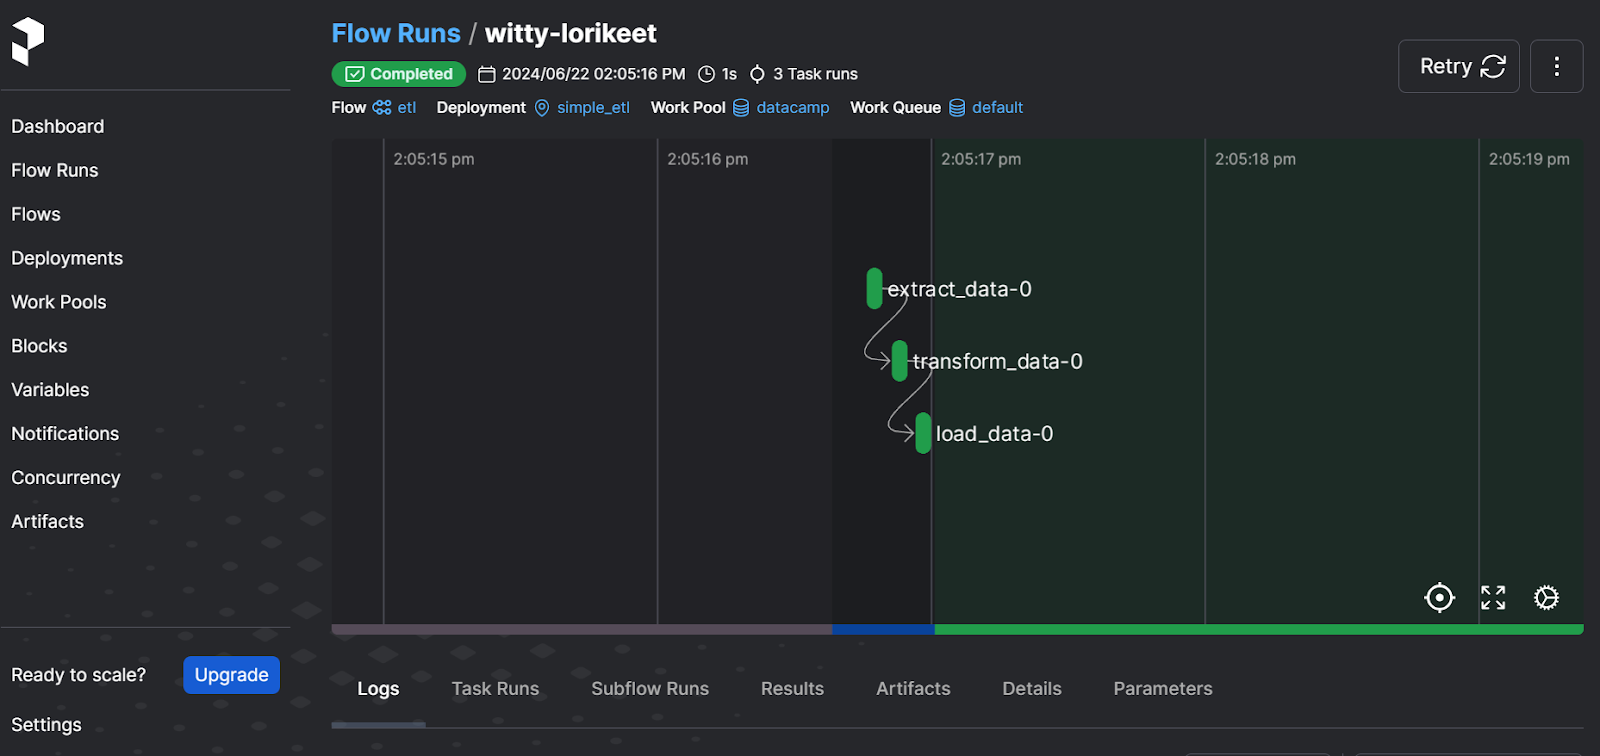
Interfaz del servidor web de Prefect.
Desde el panel puedes volver a ejecutar el flujo, ver logs, revisar pools de trabajo, configurar notificaciones y acceder a opciones avanzadas. Es una solución completa para orquestación de datos moderna.
Si quieres aprender a construir y ejecutar pipelines de machine learning con Prefect, sigue el tutorial Using Prefect for Machine Learning Workflows.
Dasgter es un framework de código abierto diseñado para que los ingenieros de datos definan, programen y monitoricen pipelines. Es muy escalable y facilita la colaboración entre equipos de datos.
Dagster permite definir activos de datos como funciones de Python mediante decoradores. Una vez definidos, se pueden ejecutar con facilidad mediante programación o disparadores por eventos.
Frente a Airflow, Dagster facilita desarrollar, probar y revisar el pipeline en local, ofrece un enfoque basado en activos y es nativo de cloud y contenedores.
En lugar de pensar el workflow en pasos y flujos, tuve que cambiar el chip y construirlo con activos de datos. Aparte de eso, crear y ejecutar un ETL sencillo fue bastante fácil. El servidor web es minimalista pero da toda la información para monitorizar assets, ejecuciones y despliegues.
Abid Ali Awan, Author
Crearemos un pipeline ETL simple, lo ejecutaremos y lo visualizaremos con el servidor web de Dagster. Igual que el panel de Prefect, el servidor web de Dagster ofrece formas centralizadas de monitorizar varios flujos y programar ejecuciones y assets.
Empezamos instalando el paquete de Python.
$ pip install dagster -qDespués crearemos tres funciones de Python para extraer, transformar y cargar los datos. En el código se llaman create_dirty_data(), clean_data() y load_cleaned_data(). Con el decorador @asset las declararemos como activos de datos en Dagster.
A continuación, crearemos el asset job (variable job) usando todos los assets (variable all_assets) y luego la definición de assets (variable defs).
Puedes saltarte la parte de la definición, pero es importante si quieres programar ejecuciones, lanzar varios jobs y configurar sensores.
import pandas as pd
import numpy as np
from dagster import asset, Definitions, define_asset_job, materialize

@asset
def create_dirty_data():
    # Create a sample DataFrame with dirty data
    data = {
        'Name': [' John Doe ', 'Jane Smith', 'Bob Johnson ', '  Alice Brown'],
        'Age': [30, np.nan, 40, 35],
        'City': ['New York', 'los angeles', 'CHICAGO', 'Houston'],
        'Salary': ['50,000', '60000', '75,000', 'invalid']
    }
    df = pd.DataFrame(data)

    # Save the DataFrame to a CSV file
    dirty_file_path = 'dag_data/dirty_data.csv'
    df.to_csv(dirty_file_path, index=False)

    return dirty_file_path

@asset
def clean_data(create_dirty_data):
    # Read the dirty CSV file
    df = pd.read_csv(create_dirty_data)

    # Clean the data
    df['Name'] = df['Name'].str.strip()
    df['Age'] = pd.to_numeric(df['Age'], errors='coerce').fillna(df['Age'].mean())
    df['City'] = df['City'].str.upper()
    df['Salary'] = df['Salary'].replace('[\$,]', '', regex=True)
    df['Salary'] = pd.to_numeric(df['Salary'], errors='coerce').fillna(0)

    # Calculate average salary
    avg_salary = df['Salary'].mean()

    # Save the cleaned DataFrame to a new CSV file
    cleaned_file_path = 'dag_data/cleaned_data.csv'
    df.to_csv(cleaned_file_path, index=False)

    return {
        'cleaned_file_path': cleaned_file_path,
        'avg_salary': avg_salary
    }

@asset
def load_cleaned_data(clean_data):
    cleaned_file_path = clean_data['cleaned_file_path']
    avg_salary = clean_data['avg_salary']

    # Read the cleaned CSV file to verify
    df = pd.read_csv(cleaned_file_path)

    print({
        'num_rows': len(df),
        'num_columns': len(df.columns),
        'avg_salary': avg_salary
    })

# Define all assets
all_assets = [create_dirty_data, clean_data, load_cleaned_data]

# Create a job that will materialize all assets
job = define_asset_job("all_assets_job", selection=all_assets)

# Create Definitions object
defs = Definitions(
    assets=all_assets,
    jobs=[job]
)

if __name__ == "__main__":
    result = materialize(all_assets)
    print("Pipeline execution result:", result.success)
Puedes ejecutar el código en un Jupyter Notebook o crear el archivo Python y lanzarlo.
Como resultado, obtendrás un log completo de la ejecución del flujo.
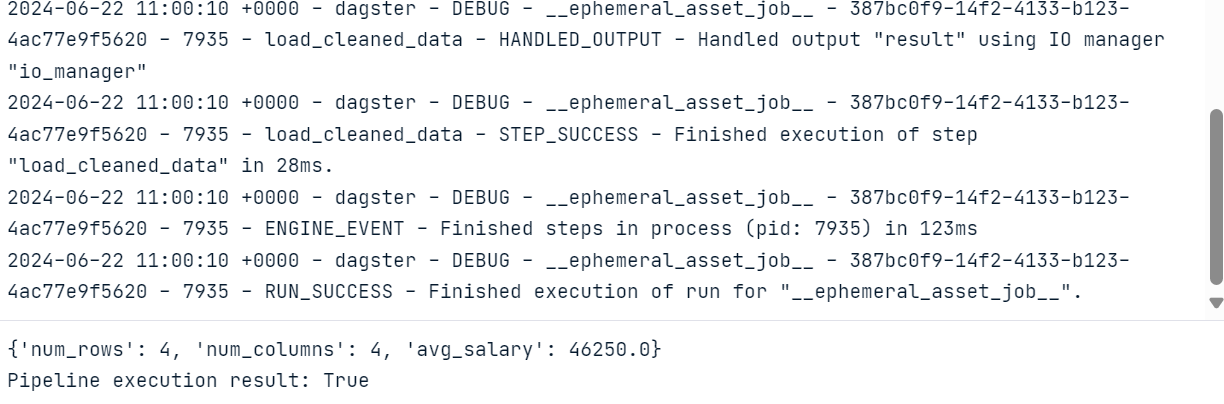
Para visualizar assets y ejecuciones de jobs, hay que instalar y lanzar el servidor web de Dagster. Desde ahí puedes ejecutar jobs, materializar assets individuales y monitorizar varios jobs a la vez.
$ pip install dagster-webserverPara iniciar el servidor de Dagster, usaremos la CLI de Daster indicando la ubicación del archivo Python. En este caso, el archivo se llama dagster_pipe.py.
$ dagster dev -f dagster_pipe.py El comando abrirá el servidor web automáticamente en el navegador. También puedes ir directamente a http://127.0.0.1:3000 en tu navegador.
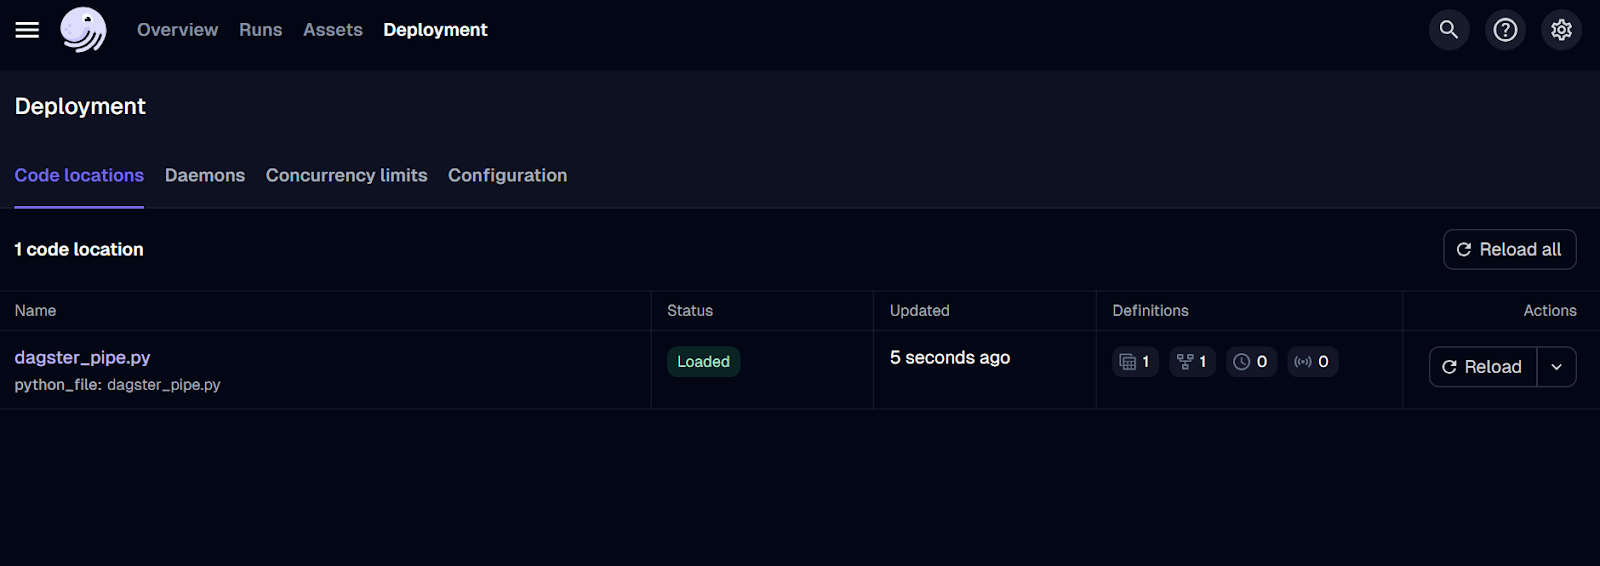
Interfaz del servidor web de Dagster.
De momento solo hemos desplegado el job. Para ejecutar el workflow, ve a la pestaña “Runs” y haz clic en “Launch a new run”.
¡La ejecución debería completarse con éxito! Para ver los logs, haz clic en el ID de la ejecución que te interese.
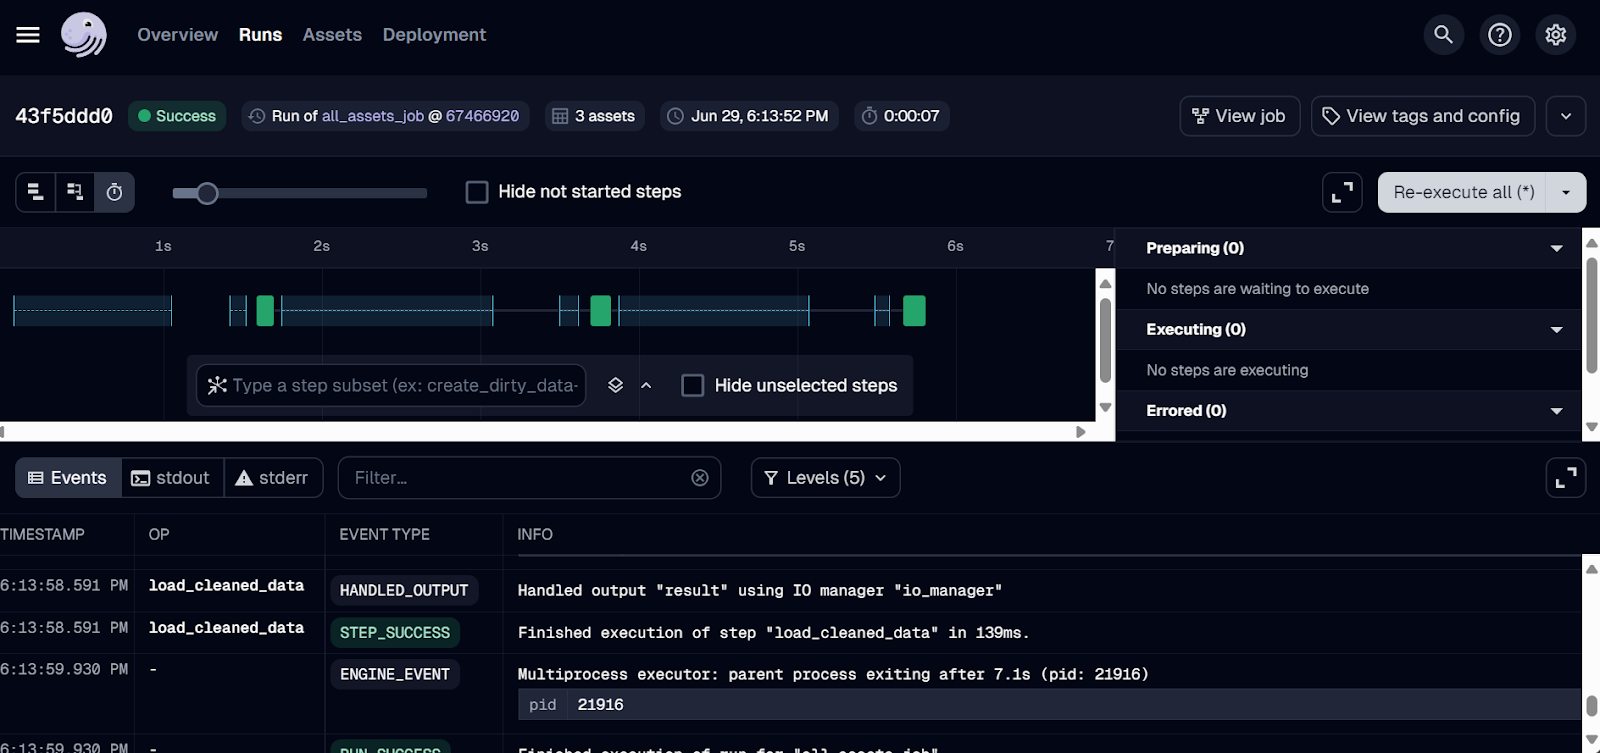
Logs de ejecuciones en Dagster.
Mage AI es un framework híbrido de orquestación de datos de código abierto. Híbrido significa que combina la flexibilidad de un Jupyter Notebook con el control de código modular.
Cualquiera, incluso con conocimientos limitados de Python, puede crear, ejecutar y monitorizar pipelines de datos. En lugar de escribir y ejecutar directamente un archivo de Python, crearás un proyecto de Mage AI y lo lanzarás en su panel, donde podrás construir, ejecutar y gestionar tus pipelines.
Frente a Airflow, Mage AI ofrece una interfaz muy amigable y facilidad de uso, ideal para quienes empiezan en ingeniería de datos. Está diseñado para escalar y puede manejar grandes volúmenes de datos y pipelines complejos con eficiencia.
Al principio me resultó raro porque es muy distinto a lo que suelo usar. Tuve que instalar y lanzar la interfaz web de Mage AI. En teoría es fácil, pero me costó construir y ejecutar el ETL. Por otro lado, entiendo por qué este enfoque puede atraer a quien empieza: es básicamente arrastrar, soltar y pulsar botones.
Abid Ali Awan, Author
Arrancar Mage AI es bastante sencillo. Solo hay que instalar el paquete de Python.
$ pip install mage-aiY crear el proyecto de Mage AI.
$ mage start mage_ai_etl Este comando iniciará el servidor web. Como comentábamos, toda la edición de código, ejecución y monitorización se hace desde la UI de Mage AI.
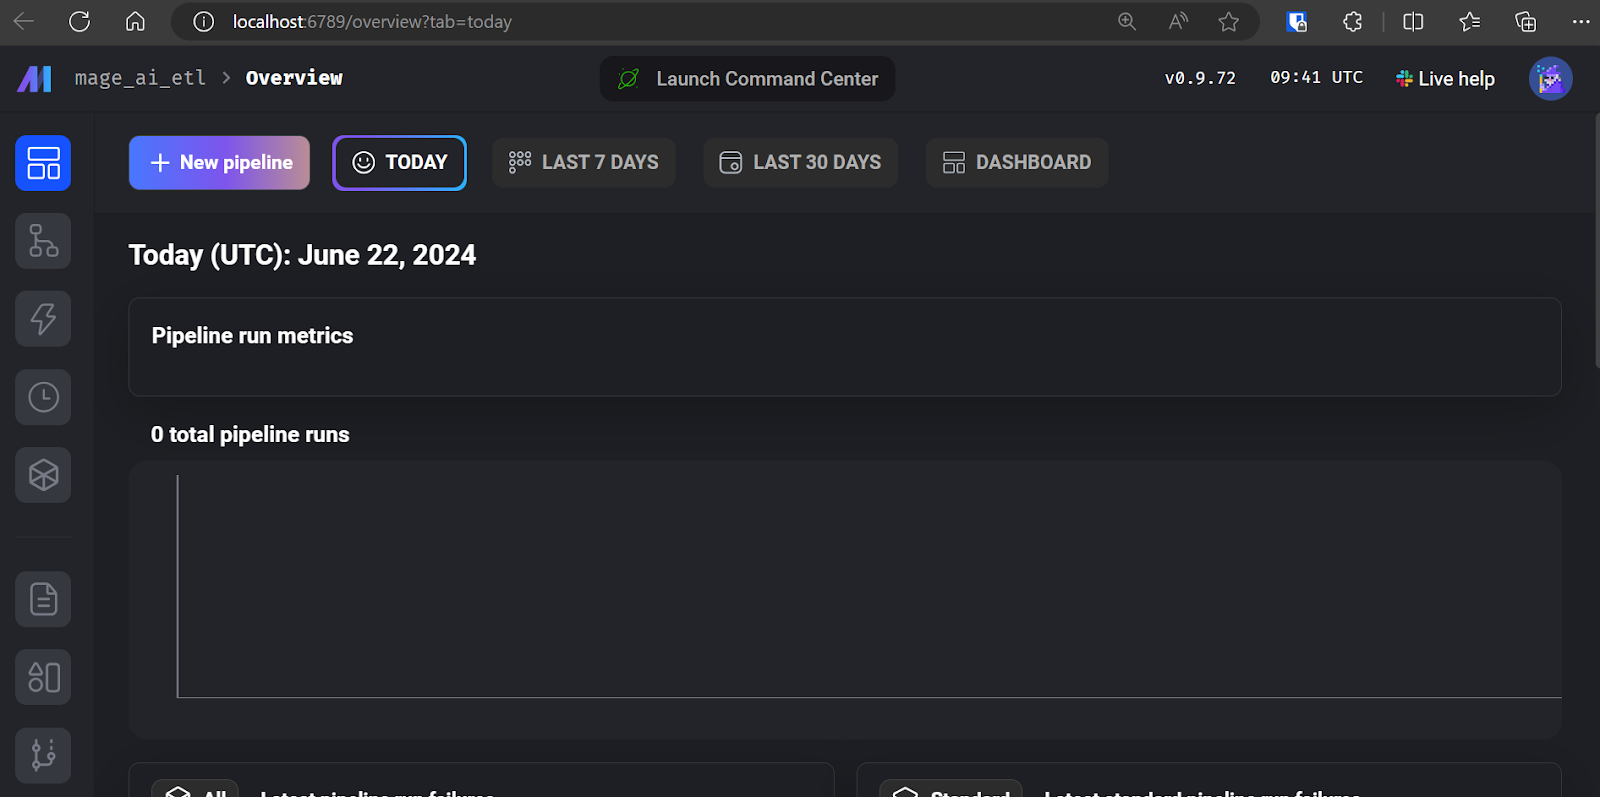
Interfaz de Mage AI.
Haz clic en “+ New pipeline” para crear tu primer ETL. Yo lo llamé “simple_etl”.
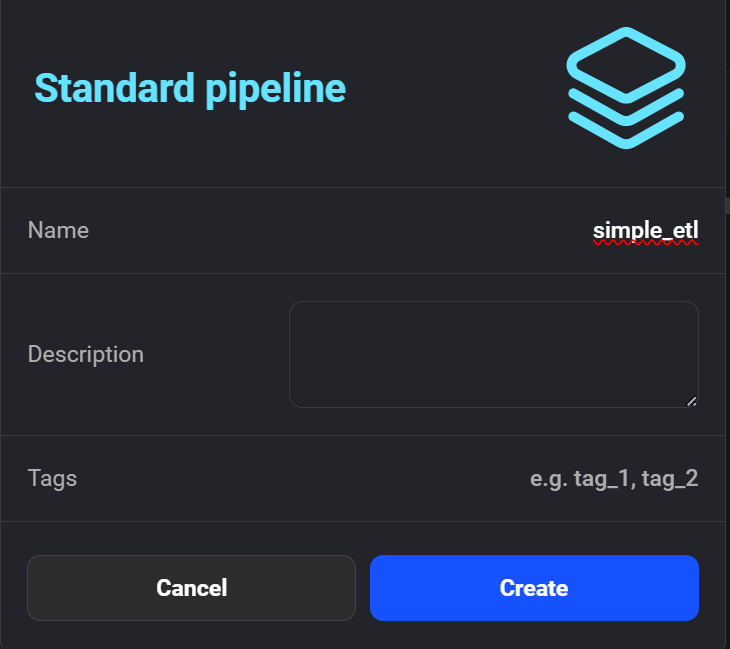
Creación del nuevo pipeline en Mage AI.
La interfaz te pedirá añadir un módulo para empezar a codificar. Selecciona “Data Loader” y pega este código en Python.
Aquí declaramos la función create_sample_csv(), primer paso del pipeline, usando el decorador de Mage AI @data_loader. También definimos test_output() para comprobar la salida y ayudar con dependencias.
import io
import pandas as pd

if 'data_loader' not in globals():
    from mage_ai.data_preparation.decorators import data_loader
if 'test' not in globals():
    from mage_ai.data_preparation.decorators import test

@data_loader
def create_sample_csv() -> pd.DataFrame:
    """
    Create a sample CSV file with duplicates and missing values
    """
    csv_data = """
category,product,quantity,price
Electronics,Laptop,5,1000
Electronics,Smartphone,10,500
Clothing,T-shirt,50,20
Clothing,Jeans,30,50
Books,Novel,100,15
Books,Textbook,20,80
Electronics,Laptop,5,1000
Clothing,T-shirt,,20
Electronics,Tablet,,300
Books,Magazine,25,
"""
    return pd.read_csv(io.StringIO(csv_data.strip()))

@test
def test_output(df) -> None:
    """
    Template code for testing the output of the block.
    """
    assert df is not None, 'The output is undefined'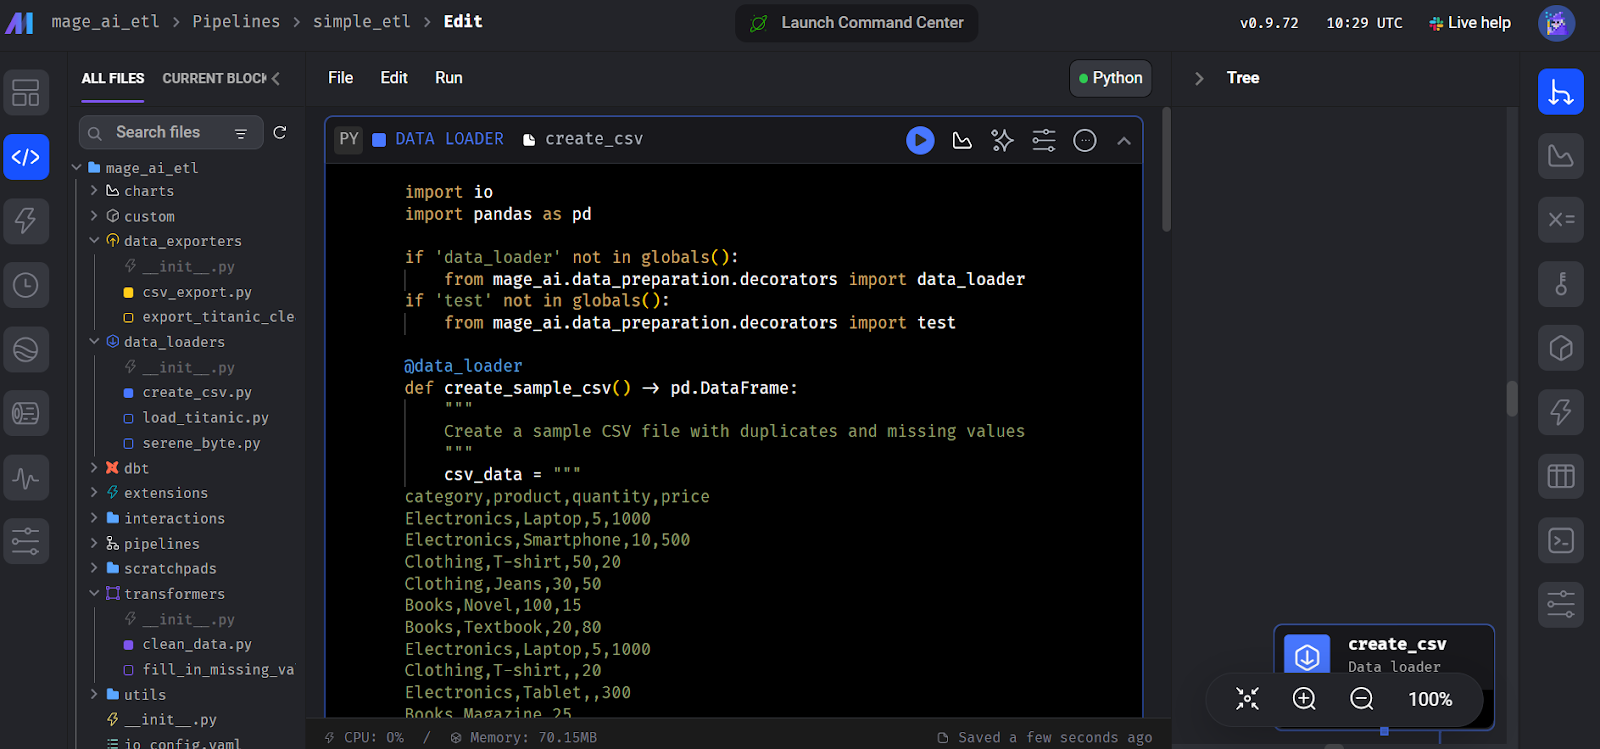
Creación del bloque de carga de datos en Mage AI.
Luego, crea otro módulo “Transformer” y añade la función clean_data() como ves abajo.
Puedes ignorar la función test(); lo importante es añadir la función principal del transformador, clean_data().
import pandas as pd

if 'transformer' not in globals():
    from mage_ai.data_preparation.decorators import transformer
if 'test' not in globals():
    from mage_ai.data_preparation.decorators import test

@transformer
def clean_data(df: pd.DataFrame) -> pd.DataFrame:
    """
    Clean and transform the data
    """
    # Remove duplicates
    df = df.drop_duplicates()
    # Fill missing values with 0
    df = df.fillna(0)
    return df

@test
def test_output(df) -> None:
    """
    Template code for testing the output of the block.
    """
    assert df is not None, 'The output is undefined'
De forma similar, crea un módulo “Data Exporter” y añade este código. Declara la función de carga de datos export_data_to_csv(), que guarda los datos transformados en un CSV.
import pandas as pd

if 'data_exporter' not in globals():
    from mage_ai.data_preparation.decorators import data_exporter

@data_exporter
def export_data_to_csv(df: pd.DataFrame) -> None:
    """
    Export the processed data to a CSV file
    """
    df.to_csv('output_data.csv', index=False)
    print("Data exported successfully to output_data.csv")
Para ejecutar el pipeline, ve a la pestaña “Trigger” y haz clic en “Run@once”.
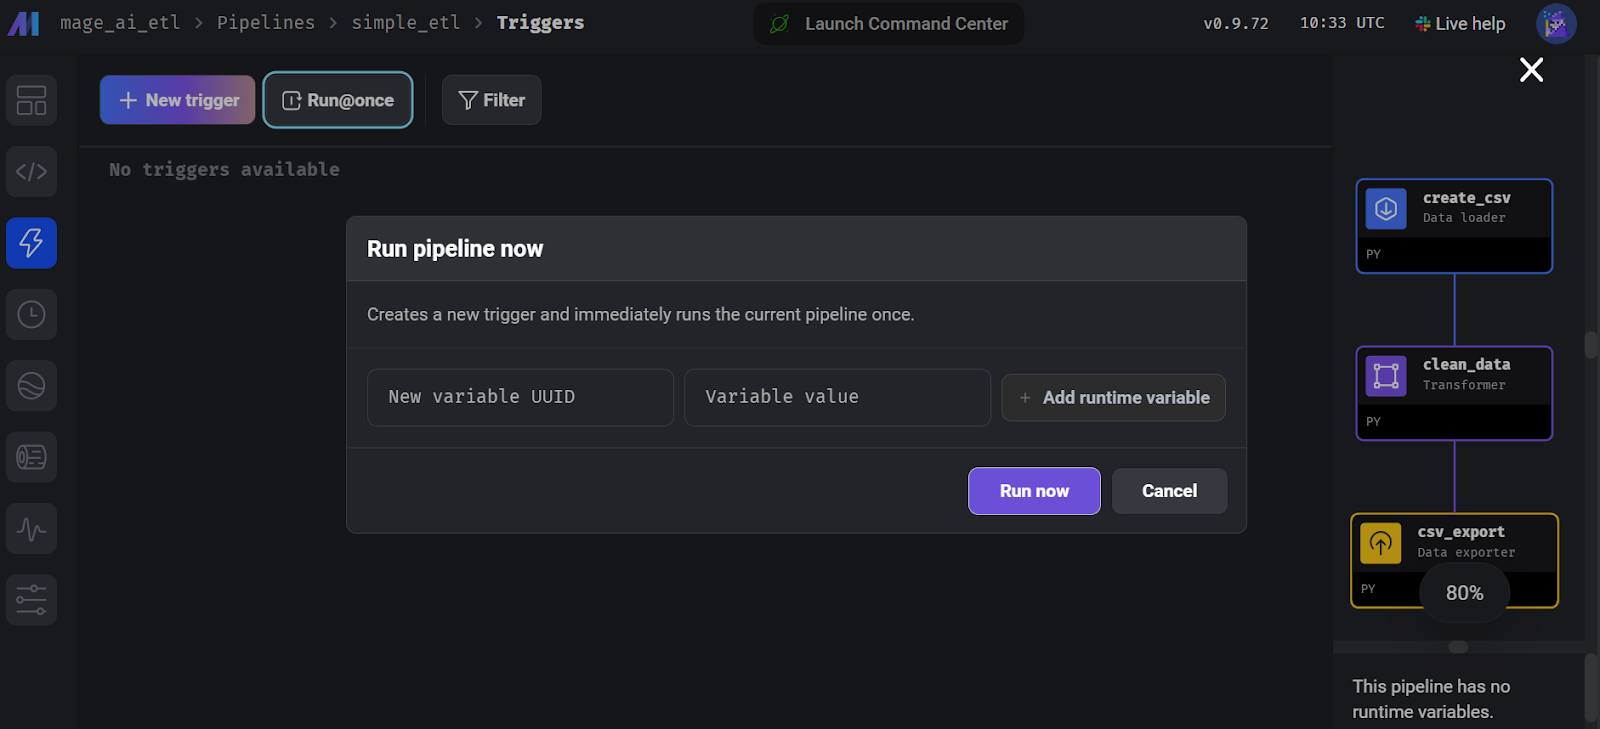
Ejecución del pipeline en Mage AI.
Para ver los logs, ve a la pestaña “Runs” y haz clic en “Logs” en el pipeline que acabas de ejecutar.
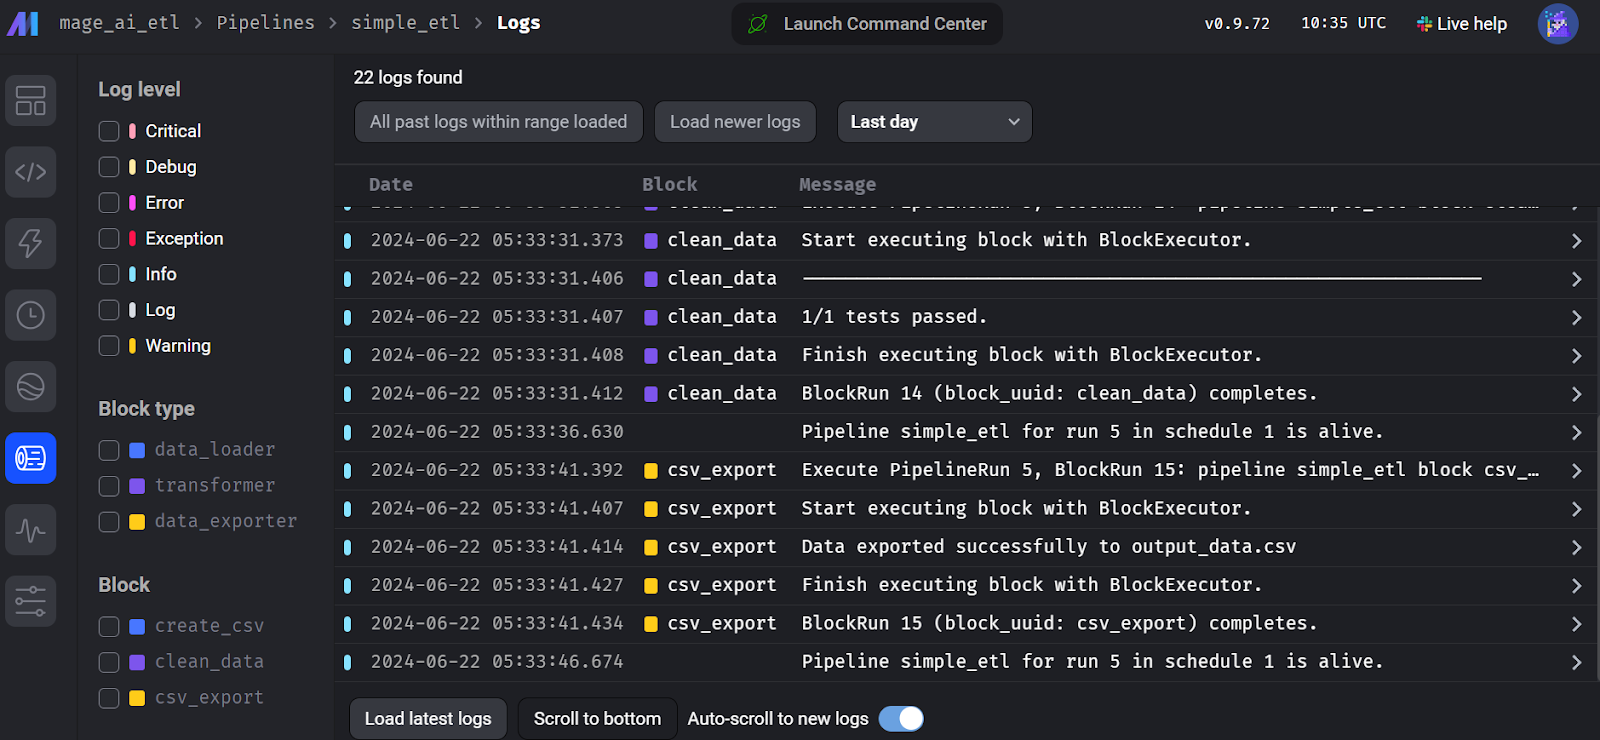
Logs de ejecución en Mage AI.
Kedro es otro framework de orquestación de datos de código abierto, algo distinto al resto. Nació para ingenieros de machine learning e incorpora muchos conceptos de ingeniería de software aplicados a proyectos de ML.
Kedro es altamente modular, lo que significa que incluso para exportar un dataset necesitas crear un catálogo de datos que especifique la ubicación y el tipo de datos, asegurando una gestión estandarizada y eficiente en todo el pipeline.
Para entender cómo encaja Kedro en el ecosistema de ML, puedes explorar distintas herramientas de MLOps en el artículo 25 Top MLOps Tools You Need to Know in 2024.
Frente a Airflow, la API de Kedro es más sencilla para crear un pipeline de datos. Se centra más en ingeniería de ML y ofrece categorización y versionado de datos.
La parte de código es bastante directa, pero surgen problemas al ejecutar el pipeline. Hay que crear un catálogo de datos, registrar el pipeline y entender la estructura del proyecto Kedro. Diría que es más exigente que Dagster y Prefect. Aun así, tiene sentido: busca hacer tu pipeline fiable y sin errores.
Abid Ali Awan, Author
Construir un pipeline de Kedro es otro mundo. El framework es modular y hay que entender la estructura del proyecto y los pasos necesarios para ejecutar el flujo con éxito.
Empieza instalando el paquete de Python de Kedro.
$ pip install kedroInicializa el proyecto de Kedro.
$ kedro new --name=kedro_etl --tools=none --example=n Muévete al directorio del proyecto.
$ cd kedro-etl Crea una carpeta dentro de pipelines llamada data_processing.
$ mkdir -p src/kedro_etl/pipelines/data_processing Crea un archivo Python llamado kedro_pipe.py y ábrelo en tu IDE favorito, por ejemplo Visual Studio Code.
$ code src/kedro_etl/pipelines/data_processing/kedro_pipe.pyEl script debe contener las funciones de extracción, transformación y carga, que son los nodos del pipeline: create_sample_data(), clean_data(), y load_and_process_data().
Después uniremos estos nodos con la clase Pipeline de Kedro dentro de la función create_pipeline(). En la función del pipeline definimos nodos, y cada nodo tiene inputs, outputs y un name.
import pandas as pd
import numpy as np
from kedro.pipeline import Pipeline, node

def create_sample_data():
    data = {
        'id': range(1, 101),
        'name': [f'Person_{i}' for i in range(1, 101)],
        'age': np.random.randint(18, 80, 100),
        'salary': np.random.randint(20000, 100000, 100),
        'missing_values': [np.nan if i % 10 == 0 else i for i in range(100)]
    }
    return pd.DataFrame(data)

def clean_data(df: pd.DataFrame):
    # Remove rows with missing values
    df_cleaned = df.dropna()

    # Convert salary to thousands
    df_cleaned['salary'] = df_cleaned['salary'] / 1000

    # Capitalize names
    df_cleaned['name'] = df_cleaned['name'].str.upper()

    return df_cleaned

def load_and_process_data(df: pd.DataFrame):
    # Calculate average salary
    avg_salary = df['salary'].mean()

    # Add a new column for salary category
    df['salary_category'] = df['salary'].apply(
        lambda x: 'High' if x > avg_salary else 'Low')

    # Calculate age groups
    df['age_group'] = pd.cut(df['age'], bins=[0, 30, 50, 100], labels=[
                             'Young', 'Middle', 'Senior'])

    print(df)
    return df

def create_pipeline(**kwargs):
    return Pipeline(
        [
            node(
                func=create_sample_data,
                inputs=None,
                outputs="raw_data",
                name="create_sample_data_node",
            ),
            node(
                func=clean_data,
                inputs="raw_data",
                outputs="cleaned_data",
                name="clean_data_node",
            ),
            node(
                func=load_and_process_data,
                inputs="cleaned_data",
                outputs="processed_data",
                name="load_and_process_data_node",
            ),
        ]
    )
Si ejecutamos el pipeline sin crear el catálogo de datos, no exportará nada. Así que ve al archivo conf/base/catalog.yml y edítalo añadiendo la configuración del dataset.
raw_data:
  type: pandas.CSVDataset
  filepath: ./data/kedro/sample_data.csv

cleaned_data:
  type: pandas.CSVDataset
  filepath: ./data/kedro/cleaned_data.csv

processed_data:
  type: pandas.CSVDataset
  filepath: ./data/kedro/processed_data.csv
También debemos incluir nuestro archivo Python en el registro del pipeline. Para ello, ve al archivo src/simple_etl/pipeline_registry.py e incluye el siguiente código.
"""Project pipelines."""
from __future__ import annotations

from kedro.pipeline import Pipeline
from kedro_etl.pipelines.data_processing import kedro_pipe

def register_pipelines() -> Dict[str, Pipeline]:
    data_processing_pipeline = kedro_pipe.create_pipeline()

    return {
        "__default__": data_processing_pipeline,
        "data_processing": data_processing_pipeline,
    }
Ejecuta el pipeline y ve los logs en vivo en la terminal con este comando.
$ kedro run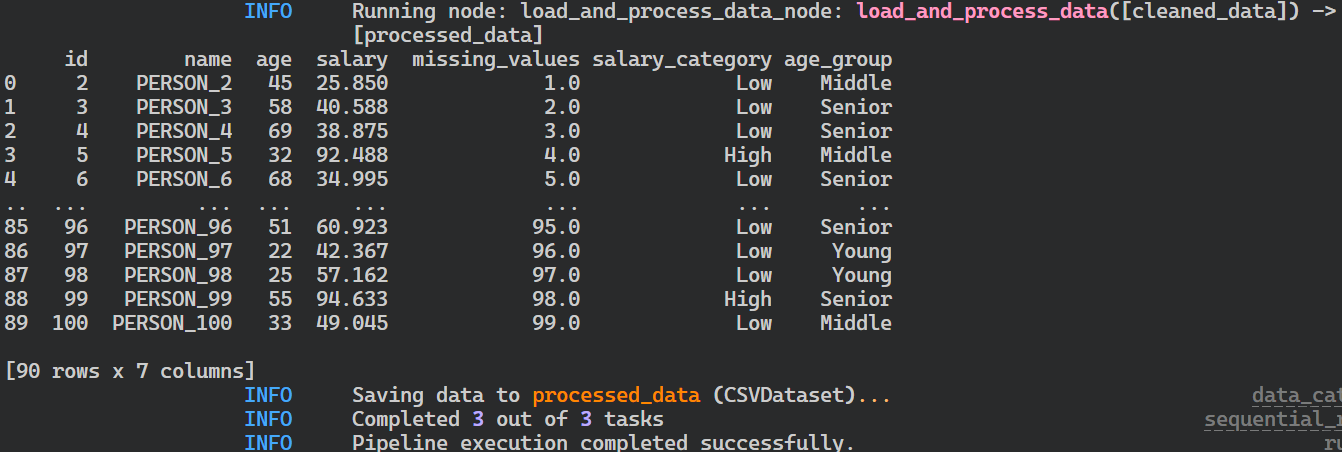
Logs de ejecución del pipeline de Kedro.
Tras ejecutar el pipeline, los archivos se guardarán en formato CSV en la ruta definida en el catálogo.
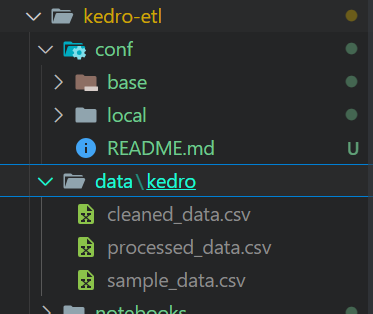
Archivos de salida del pipeline de Kedro.
Si tienes problemas al ejecutar el pipeline, plantéate instalar Kedro con todas las extensiones.
$ pip install "kedro[all]"Podemos visualizar y compartir nuestros pipelines instalando la herramienta kedro-viz.
$ pip install kedro-vizDespués, ejecuta este comando para visualizar todos los pipelines y nodos de datos. También ofrece trazabilidad de experimentos y la opción de compartir la visualización.
$ kedro viz run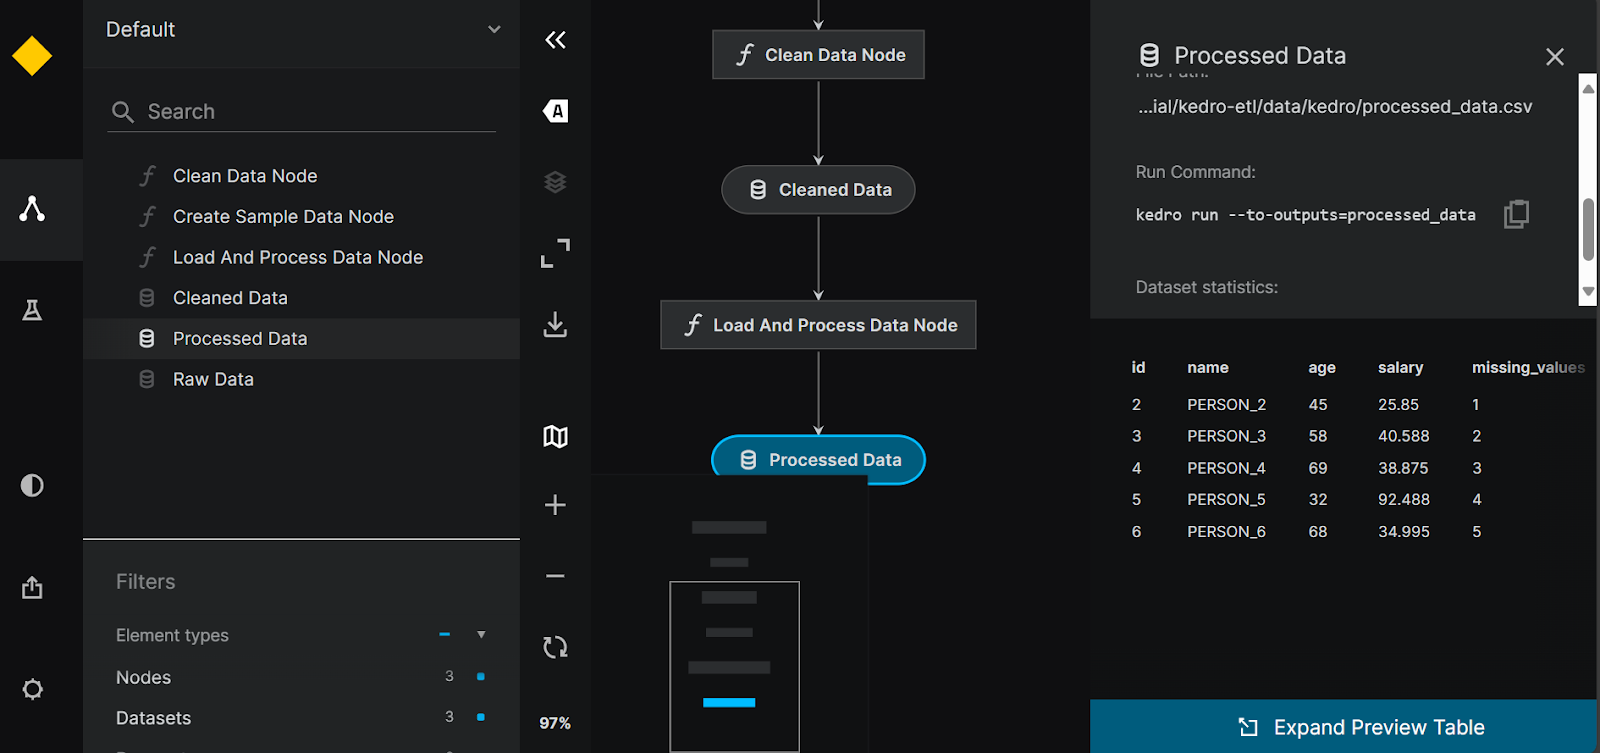
Visualización del pipeline en Kedro.
Luigi es un framework de código abierto en Python desarrollado por Spotify que destaca en la gestión de procesos por lotes de larga duración y pipelines complejos. Es muy bueno resolviendo dependencias, gestionando flujos, visualizando y recuperándose de fallos, lo que lo convierte en una herramienta potente para orquestar workflows.
Frente a Airflow, Luigi tiene una API mínima, programación por calendario y una comunidad fiel que te ayudará con dudas sobre el pipeline de orquestación.
Si estás empezando con Python, puede costarte construir y ejecutar los pipelines. Aun así, la documentación y las guías ayudan a arrancar rápido. Los logs son algo limitados y el panel es básicamente una visualización de DAGs y dependencias.
Abid Ali Awan, Author
Crear un pipeline en Luigi requiere entender programación orientada a objetos. Empecemos instalando el paquete de Python de Luigi.
$ pip install luigiPara desarrollar un ETL sencillo en Luigi, crearemos tareas interconectadas. En lugar de funciones, crearemos una clase de Python por cada paso del pipeline: FetchData, ProcessData y GenerateReport. Cada clase tendrá tres funciones: requires(), output() y run().
Las funciones requires() y output() conectan las tareas, y run() ejecuta el procesamiento. Finalmente construimos el pipeline llamando a la última tarea.
import luigi
import pandas as pd
import numpy as np

class FetchData(luigi.Task):
    def output(self):
        return luigi.LocalTarget('data/fetch_data.csv')

    def run(self):
        # Simulate fetching data by creating a sample CSV file
        data = {
            'column1': [1, 2, np.nan, 4],
            'column2': ['A', 'B', 'C', np.nan]
        }
        df = pd.DataFrame(data)
        df.to_csv(self.output().path, index=False)

class ProcessData(luigi.Task):
    def requires(self):
        return FetchData()

    def output(self):
        return luigi.LocalTarget('data/process_data.csv')

    def run(self):
        df = pd.read_csv(self.input().path)
        # Fill missing values
        df['column1'].fillna(df['column1'].mean(), inplace=True)
        df['column2'].fillna('B', inplace=True)
        df.to_csv(self.output().path, index=False)

class GenerateReport(luigi.Task):
    def requires(self):
        return ProcessData()

    def output(self):
        return luigi.LocalTarget('data/generate_report.txt')

    def run(self):
        df = pd.read_csv(self.input().path)
        # Simple data analysis: calculate mean of column1 and value counts of column2
        mean_column1 = df['column1'].mean()
        value_counts_column2 = df['column2'].value_counts()

        with self.output().open('w') as out_file:
            out_file.write(f'Mean of column1: {mean_column1}\n')
            out_file.write('Value counts of column2:\n')
            out_file.write(value_counts_column2.to_string())

if __name__ == '__main__':
    luigi.build([GenerateReport()], local_scheduler=True)
Ejecuta el código anterior en Jupyter Notebook o crea el archivo Python y lánzalo desde la terminal.
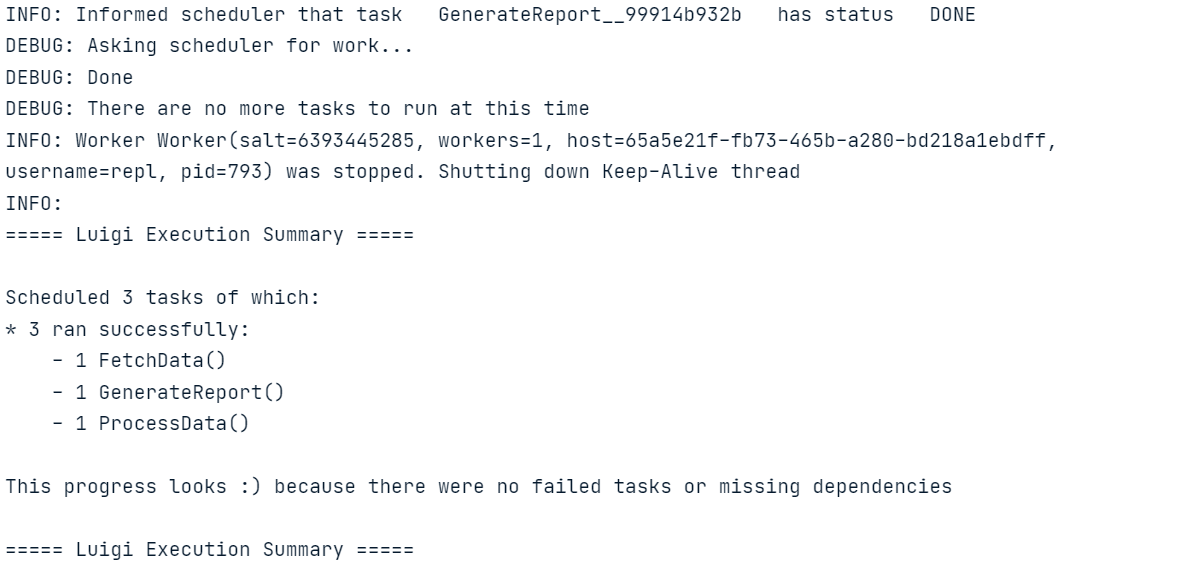
Igual que con Luigi, también puedes aprender a construir un pipeline ETL con Apache Airflow. El tutorial cubre lo básico de extraer, transformar y cargar datos con Airflow.
Necesitamos iniciar el planificador central de Luigi para programar o disparar ejecuciones.
Arranca el scheduler con este comando en la terminal.
$ luigid 2024-06-22 13:35:18,636 luigi[25056] INFO: logging configured by default settings
2024-06-22 13:35:18,636 luigi.scheduler[25056] INFO: No prior state file exists at /var/lib/luigi-server/state.pickle. Starting with empty state
2024-06-22 13:35:18,640 luigi.server[25056] INFO: Scheduler starting upPara ejecutar el pipeline, abre una nueva terminal y escribe este comando. Luigi necesita el nombre del archivo Python y la última tarea que queremos ejecutar. En este caso, el archivo es luigi_pipe.py y la última tarea es GenerateReport.
$ python -m luigi --module luigi_pipe GenerateReportSi quieres visualizar la ejecución y el estado de las tareas, entra en http://localhost:8082 en tu navegador.
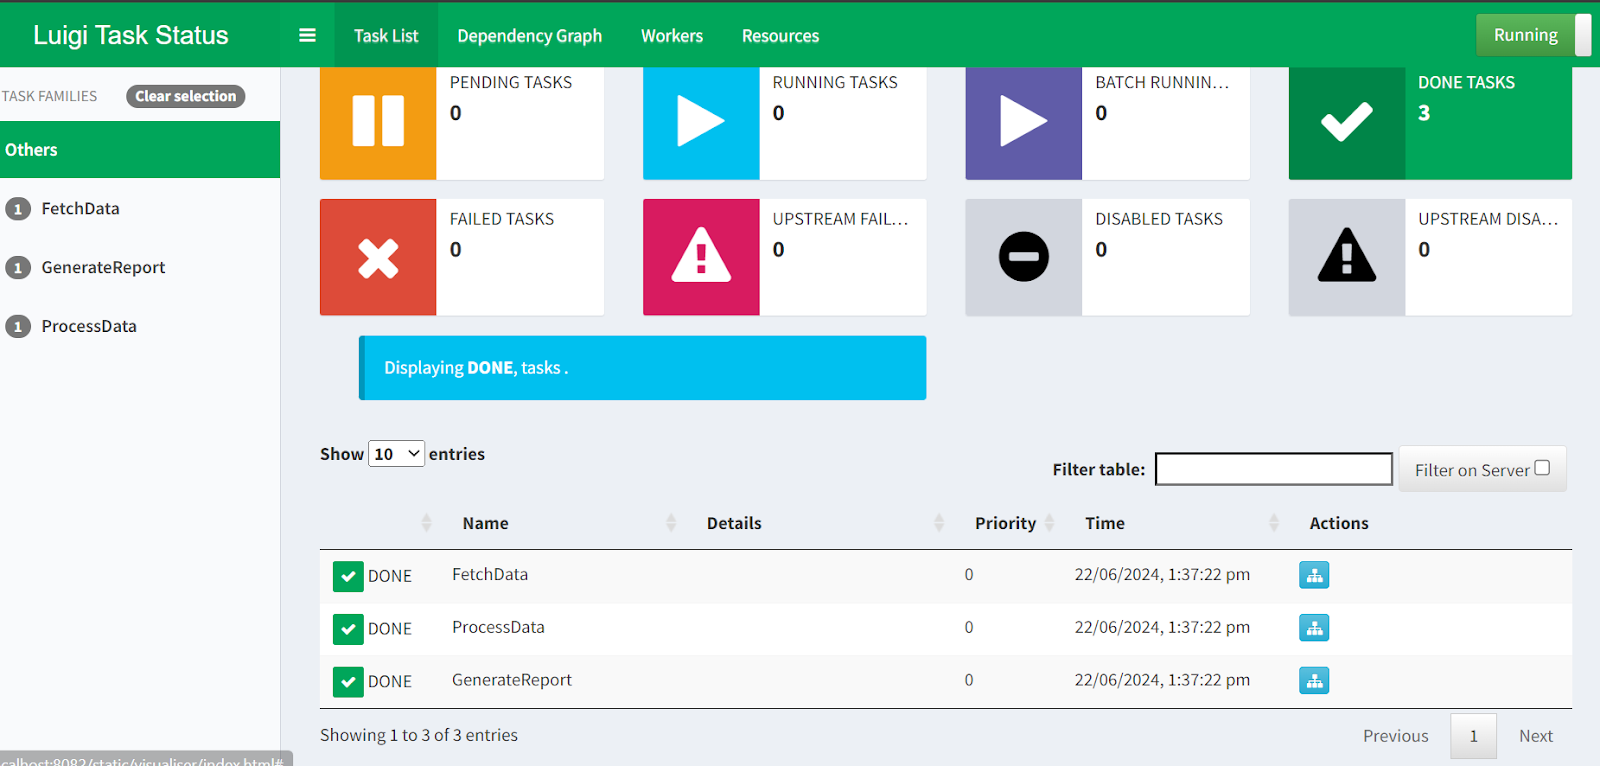
Interfaz web del planificador central de Luigi.
Con esto cerramos el repaso a las 5 mejores alternativas a Airflow. Si quieres profundizar en cualquiera de los ejemplos del artículo, aquí tienes recursos útiles:
En este tutorial hemos visto las principales alternativas gratuitas y de código abierto a Airflow. También hemos conocido cada herramienta de orquestación, y hemos creado y ejecutado un ETL sencillo. Ver ejemplos de código te ayudará a decidir cuál encaja mejor con tu caso de uso.
Si estás empezando, te sugiero comenzar con Prefect o Mage AI: son fáciles de usar y de configurar. Si buscas herramientas más avanzadas y alineadas con prácticas de ingeniería de software, explora Dagster, Kedro y Luigi.
Después de leer este artículo, un siguiente paso natural en tu carrera de ingeniería de datos es obtener una certificación como Data Engineer in Python de DataCamp, para conocer otras herramientas y construir un pipeline de datos de extremo a extremo listo para producción.
¡Sigue aprendiendo ingeniería de datos con estos cursos!
Curso
programa
Curso
blog
DataCamp Team
12 min
blog
Javier Canales Luna
12 min
blog
Tim Lu
11 min
blog
Abid Ali Awan
13 min
blog
Kurtis Pykes
13 min
blog
Abid Ali Awan
15 min