Curso
Introdução ao R
4 h
3.1M
Em machine learning, as support vector machines são modelos de aprendizado supervisionado, com algoritmos associados, que analisam dados para classificação e regressão. Porém, seu uso mais comum é em problemas de classificação. Neste tutorial, vamos construir uma compreensão de alto nível de como as SVMs funcionam e depois implementá-las em R. O foco aqui é desenvolver intuição, não rigor matemático. Em outras palavras: vamos pular o máximo possível da matemática e reforçar a intuição sobre o princípio de funcionamento.
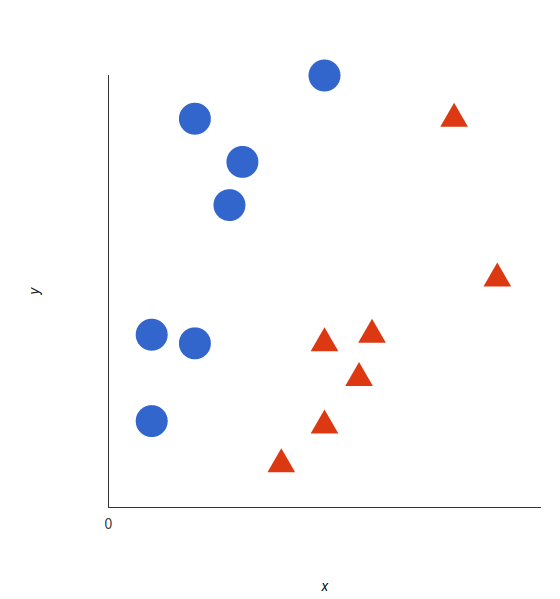
O básico de Support Vector Machines e seu funcionamento fica mais claro com um exemplo simples. Imagine que temos duas classes: vermelho e azul, e nossos dados têm duas variáveis: x e y. Queremos um classificador que, dado um par de coordenadas (x,y), diga se é vermelho ou azul. Vamos plotar nossos dados de treino já rotulados em um plano:
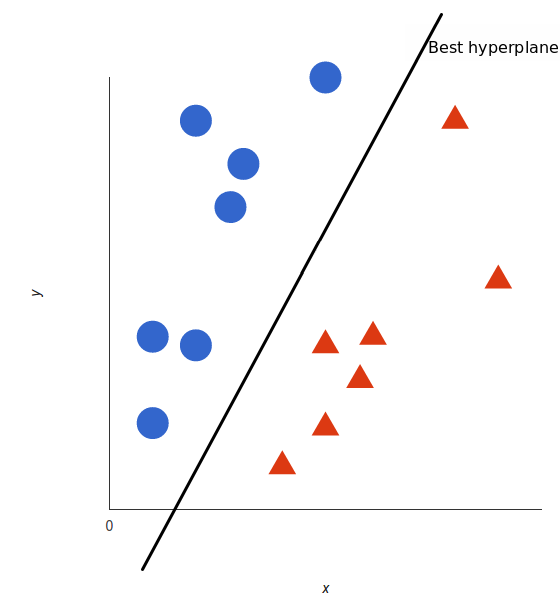
Uma support vector machine pega esses pontos e encontra o hiperplano (em duas dimensões, é simplesmente uma reta) que melhor separa as classes. Essa reta é a fronteira de decisão: tudo que cair de um lado será classificado como azul, e do outro lado, como vermelho.
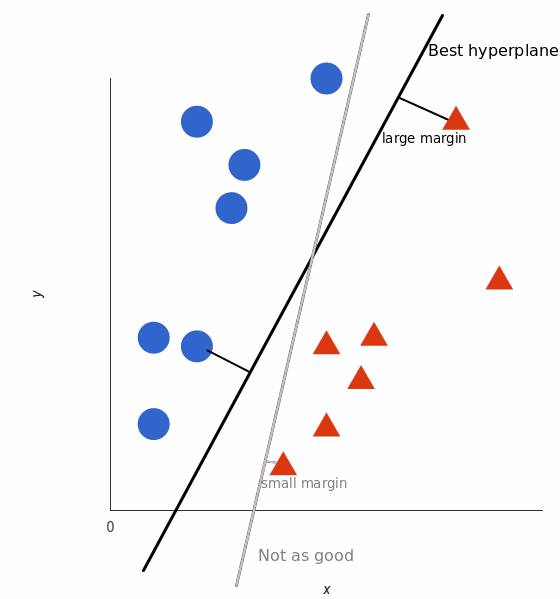
Mas o que exatamente é o melhor hiperplano? Para SVM, é aquele que maximiza as margens em relação às duas classes. Em outras palavras: o hiperplano (lembre que aqui é uma reta) cuja distância ao elemento mais próximo de cada classe seja a maior possível.
O exemplo acima foi tranquilo porque os dados eram linearmente separáveis — conseguimos traçar uma reta para separar vermelho de azul. Na prática, isso nem sempre acontece. Veja este caso:
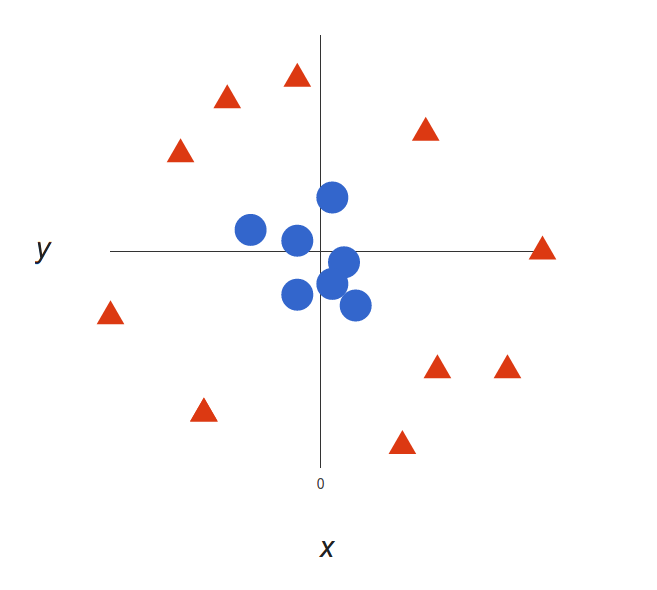
Está claro que não há uma fronteira de decisão linear (uma reta única que separe as duas classes). Mesmo assim, os vetores estão bem segregados e parece que deveria ser fácil separá-los.
O que vamos fazer: adicionar uma terceira dimensão. Até agora, tínhamos duas dimensões: $x$ e $y$. Criamos uma nova dimensão z e definimos seu cálculo de um jeito conveniente para nós: $z = x² + y²$ (você vai notar que essa é a equação de um círculo).
Isso nos dá um espaço tridimensional. Olhando um corte desse espaço, fica assim:
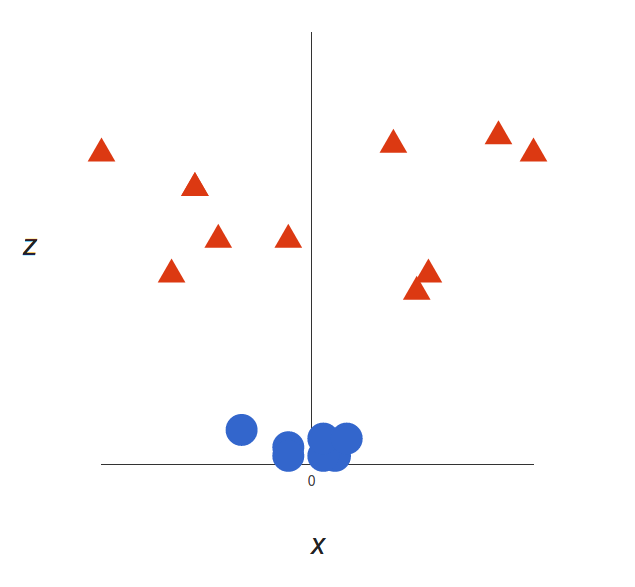
O que a SVM pode fazer com isso? Vamos ver:
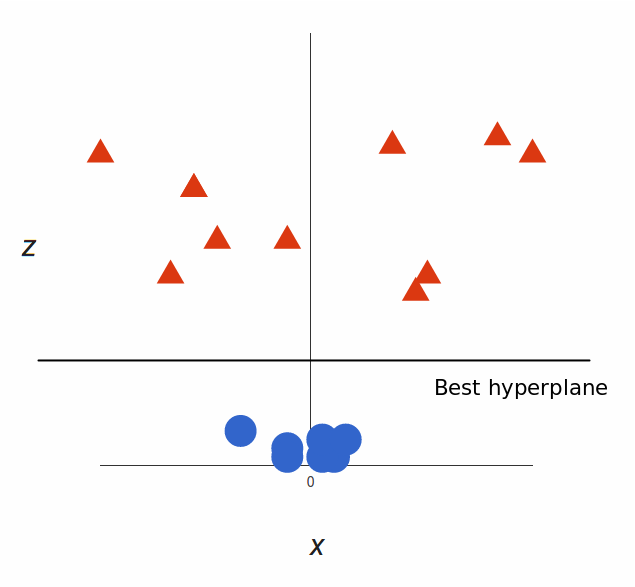
Perfeito! Note que, como agora estamos em três dimensões, o hiperplano é um plano paralelo ao eixo $x$ em um certo $z$ (digamos, $z = 1$).
O que falta é mapear de volta para duas dimensões:
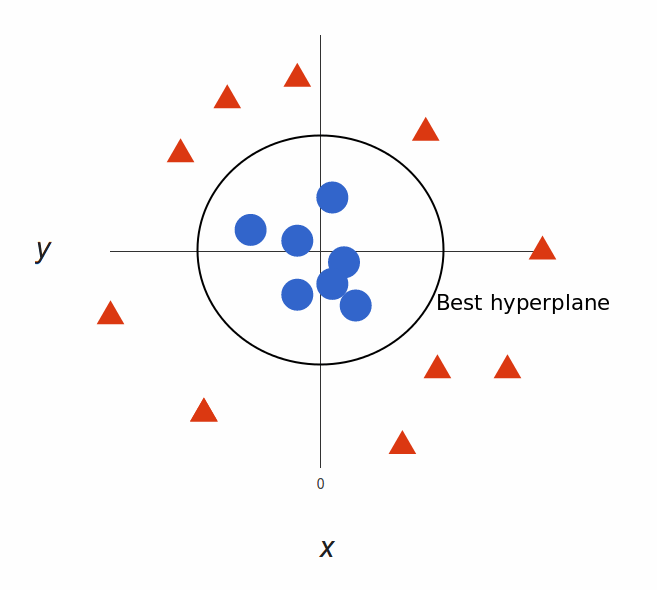
Pronto! Nossa fronteira de decisão é uma circunferência de raio 1, separando as duas classes usando SVM.
No exemplo acima, conseguimos classificar dados não lineares mapeando o espaço para uma dimensão maior. Só que calcular essa transformação pode sair caro computacionalmente: podem surgir muitas novas dimensões, cada uma exigindo um cálculo complicado. Fazer isso para cada vetor do conjunto de dados dá trabalho, então seria ótimo ter algo mais barato.
Aqui vai um truque: a SVM não precisa dos vetores explicitamente para funcionar; ela consegue operar apenas com os produtos internos entre eles. Isso significa que podemos contornar os cálculos caros das novas dimensões! Em vez disso, fazemos o seguinte:


Isso é conhecido como o truque do kernel, que amplia o espaço de atributos para acomodar uma fronteira não linear entre as classes. Kernels comuns para separar dados não lineares incluem o kernel polinomial, o radial basis (RBF) e o linear (que equivale ao classificador de vetores de suporte). Em resumo, esses kernels transformam os dados para que uma fronteira linear (hiperplano) consiga classificá-los.
Vamos ver algumas vantagens e desvantagens das SVMs:
Vantagens
Alta dimensionalidade: SVM é eficaz em espaços de alta dimensão, algo muito útil em classificação de documentos e análise de sentimento, onde a dimensionalidade pode ser extremamente grande.
Eficiência de memória: como apenas um subconjunto dos pontos de treino é usado na decisão (os vetores de suporte), só esses pontos precisam ser armazenados (e calculados) na hora de classificar novos exemplos.
Versatilidade: a separação das classes costuma ser altamente não linear. A possibilidade de aplicar diferentes kernels oferece muita flexibilidade nas fronteiras de decisão, levando a uma classificação melhor.
Desvantagens
Escolha de parâmetros do kernel: SVMs são bem sensíveis à escolha dos parâmetros do kernel. Em situações em que o número de atributos por objeto excede o número de amostras de treino, o desempenho pode cair. Intuitivamente, se o espaço de atributos de alta dimensão é muito maior que o número de amostras, haverá poucos vetores de suporte eficazes para sustentar os hiperplanos lineares ótimos, o que degrada o desempenho conforme novas amostras são adicionadas.
Não probabilística: como o classificador posiciona objetos acima ou abaixo de um hiperplano, não há uma interpretação probabilística direta de pertencimento à classe. Um possível indicativo de "confiança" é a distância do novo ponto à fronteira de decisão.
Vamos primeiro gerar alguns dados em 2 dimensões, com uma separação leve. Depois de fixar a semente aleatória, você cria uma matriz x, normalmente distribuída, com 20 observações em 2 variáveis e 2 classes. Em seguida, cria a variável y, que será -1 ou 1, com 10 observações em cada classe. Para y = 1, deslocamos as médias de 0 para 1 em cada coordenada. Por fim, plote os dados e pinte os pontos conforme a resposta. O caractere de plotagem 19 gera pontos grandes e visíveis, em azul ou vermelho conforme a resposta seja -1 ou 1.
set.seed(10111)
x = matrix(rnorm(40), 20, 2)
y = rep(c(-1, 1), c(10, 10))
x[y == 1,] = x[y == 1,] + 1
plot(x, col = y + 3, pch = 19)
Agora, carregue o pacote e1071, que contém a função svm (lembre de instalar o pacote, se ainda não tiver feito isso).
library(e1071)Em seguida, você cria um dataframe com os dados, transformando y em fator. Depois, chama svm nesse dataframe, usando y como variável resposta e as demais como preditoras. O dataframe vai descompactar a matriz x em 2 colunas chamadas x1 e x2. Informe à SVM que o kernel é linear, o parâmetro de custo é 10 e scale é falso. Neste exemplo, pedimos para não padronizar as variáveis.
dat = data.frame(x, y = as.factor(y))
svmfit = svm(y ~ ., data = dat, kernel = "linear", cost = 10, scale = FALSE)
print(svmfit)
Imprimir svmfit exibe seu resumo. É possível ver que o número de vetores de suporte é 6 — são os pontos próximos à fronteira ou do lado "errado" da fronteira.
Existe uma função de plot para SVM que mostra a fronteira de decisão, como abaixo. Não há muito controle sobre as cores. Ela foge um pouco do comum porque coloca x2 no eixo horizontal e x1 no vertical.
plot(svmfit, dat)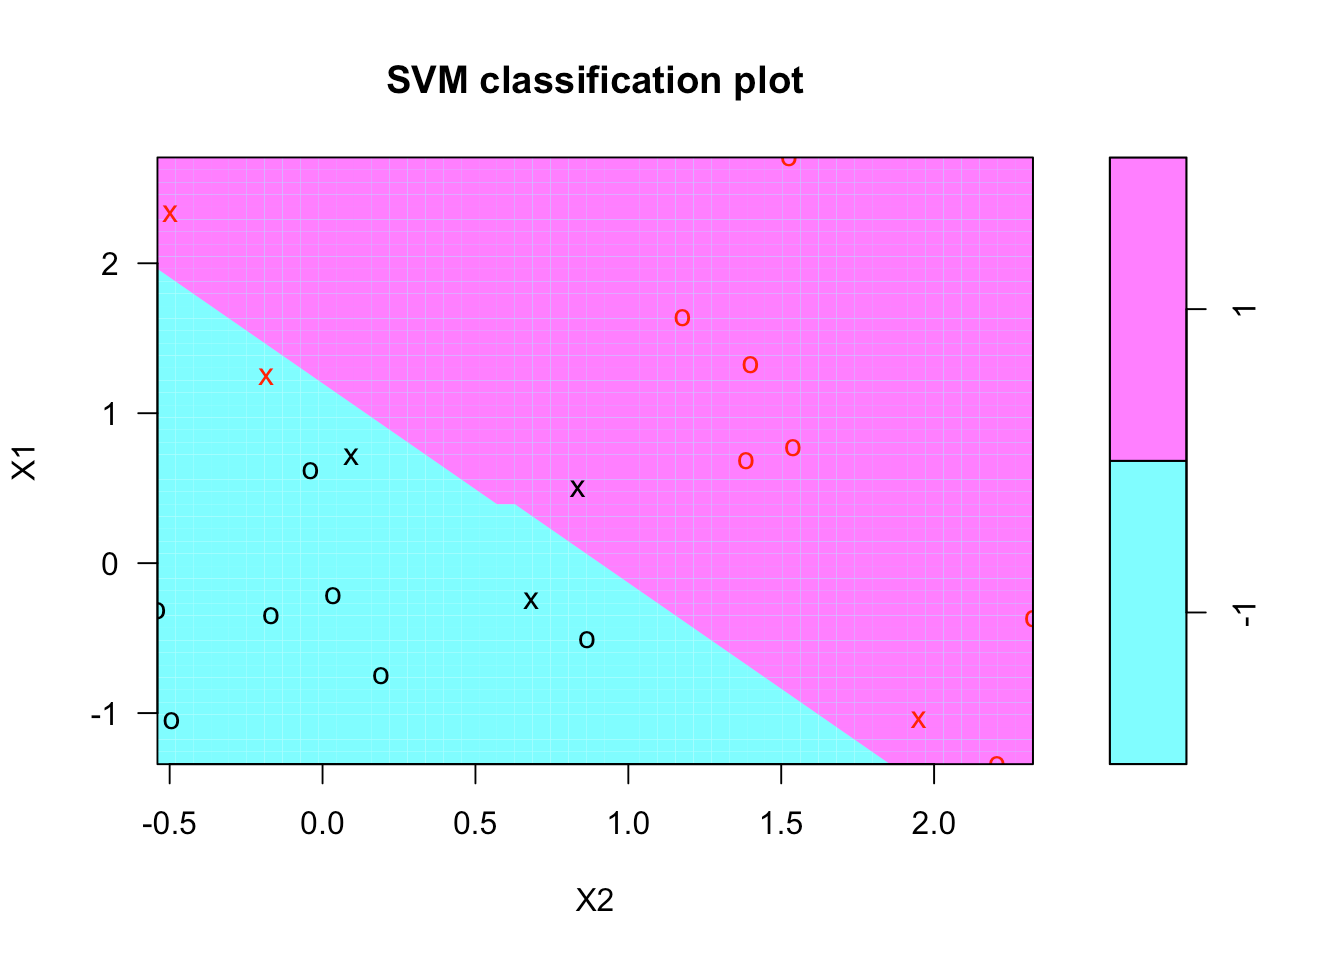
Vamos tentar fazer nosso próprio gráfico. Primeiro, crie uma malha (grid) de valores para x1 e x2 que cubra todo o domínio em uma grade bem fina. Para isso, vamos escrever a função make.grid. Ela recebe a matriz x e um argumento n, que é o número de pontos em cada direção. Aqui vamos pedir uma grade 75 x 75.
Dentro da função, usamos a apply para obter o intervalo de cada variável em x. Depois, para x1 e x2, usamos seq para ir do menor ao maior valor e gerar uma sequência de comprimento n. Assim, temos x1 e x2, cada um com 75 valores igualmente espaçados em suas coordenadas. Por fim, usamos expand.grid, que combina x1 e x2 e monta a malha.
make.grid = function(x, n = 75) {
  grange = apply(x, 2, range)
  x1 = seq(from = grange[1,1], to = grange[2,1], length = n)
  x2 = seq(from = grange[1,2], to = grange[2,2], length = n)
  expand.grid(X1 = x1, X2 = x2)
}
Agora aplique make.grid em x. Vamos olhar os primeiros valores da malha, de 1 a 10.
xgrid = make.grid(x)
xgrid[1:10,]
Como você pode ver, a grade varia primeiro pela 1ª coordenada, mantendo a 2ª fixa.
Com a malha pronta, vamos prever em cada ponto da grade. Com os novos dados xgrid, use predict e chame a resposta de ygrid. Depois, plote e pinte os pontos conforme a classificação para destacar a fronteira de decisão. Vamos também colocar os pontos originais no gráfico com a função points.
svmfit tem um componente chamado index que indica quais são os vetores de suporte. Inclua-os no gráfico usando novamente points.
ygrid = predict(svmfit, xgrid)
plot(xgrid, col = c("red","blue")[as.numeric(ygrid)], pch = 20, cex = .2)
points(x, col = y + 3, pch = 19)
points(x[svmfit$index,], pch = 5, cex = 2)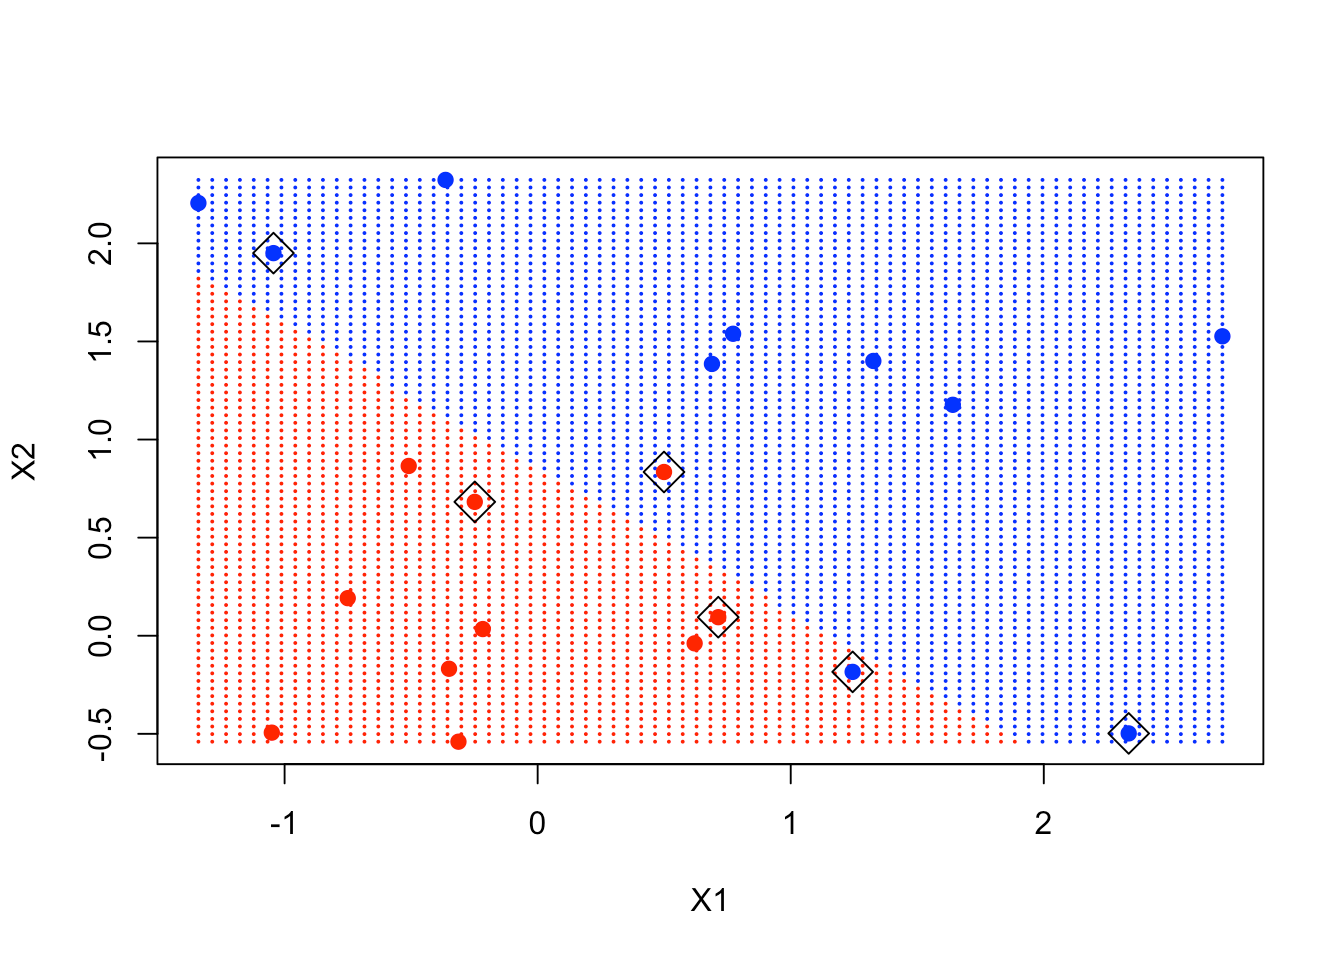
Como se vê, os pontos marcados com caixas estão perto da fronteira de decisão e são fundamentais para determiná-la.
Infelizmente, a função svm não é tão amigável para recuperar os coeficientes lineares. Provavelmente porque isso só faz sentido para kernels lineares, e a função é mais geral. Então vamos usar uma fórmula para extrair os coeficientes de forma mais eficiente. Extraímos beta e beta0, que são os coeficientes lineares.
beta = drop(t(svmfit$coefs)%*%x[svmfit$index,])
beta0 = svmfit$rho
Agora podemos reprojetar os pontos na grade, recolocar os pontos (incluindo os vetores de suporte) e usar os coeficientes para desenhar a fronteira de decisão com uma equação simples do tipo:
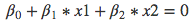
A partir dessa equação, obtemos a inclinação e a interceptação da fronteira de decisão. Em seguida, usamos abline com esses dois argumentos. As duas chamadas seguintes de abline representam a margem superior e a inferior, respectivamente.
plot(xgrid, col = c("red", "blue")[as.numeric(ygrid)], pch = 20, cex = .2)
points(x, col = y + 3, pch = 19)
points(x[svmfit$index,], pch = 5, cex = 2)
abline(beta0 / beta[2], -beta[1] / beta[2])
abline((beta0 - 1) / beta[2], -beta[1] / beta[2], lty = 2)
abline((beta0 + 1) / beta[2], -beta[1] / beta[2], lty = 2)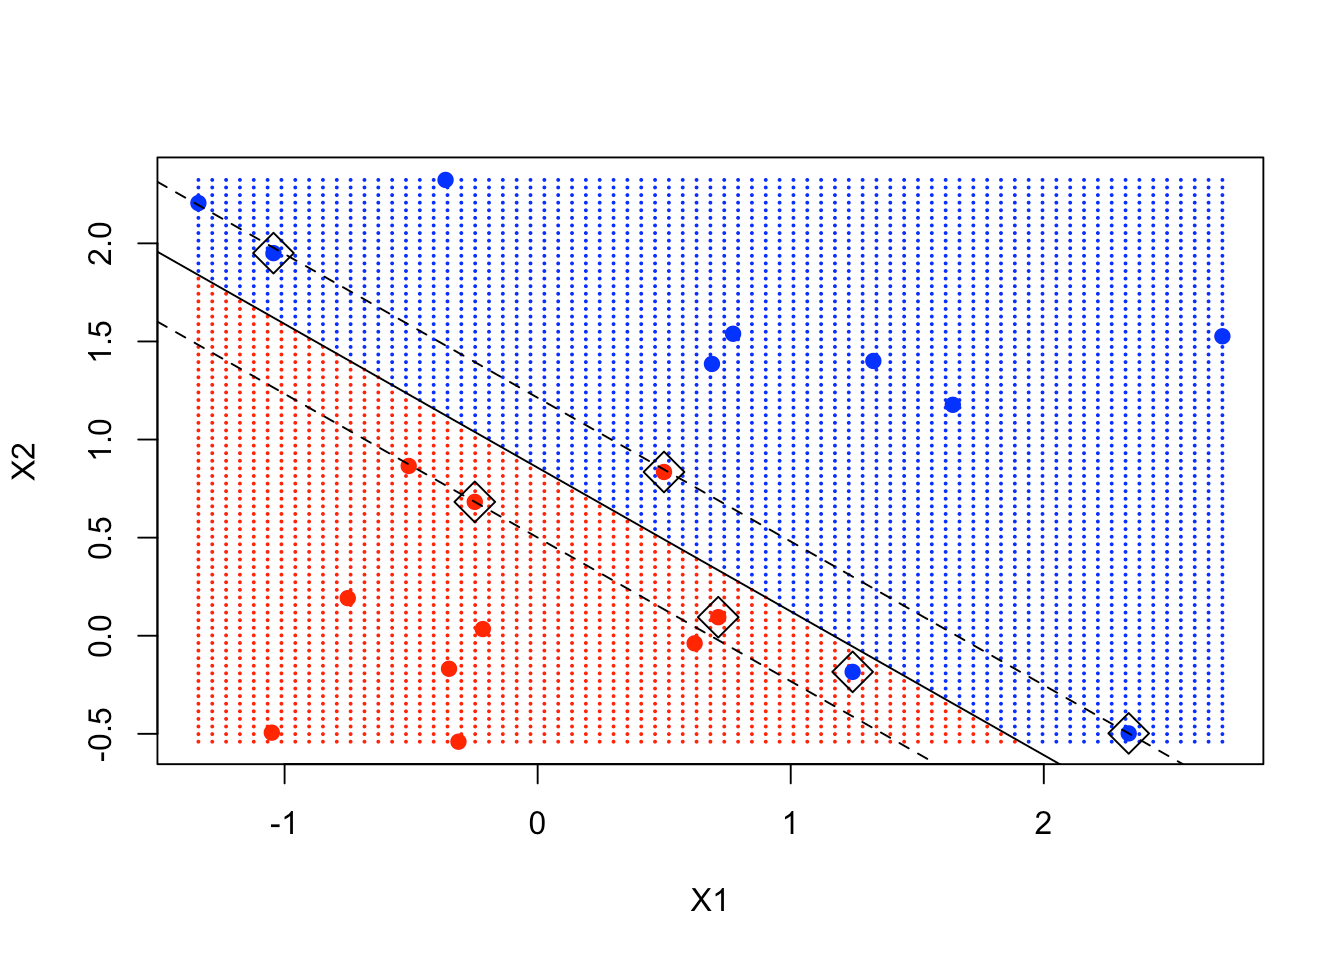
Dá para ver claramente que alguns vetores de suporte estão exatamente na margem, enquanto outros ficam dentro da margem.
Acabamos de ver a SVM linear. Agora vamos para a versão não linear. Vamos analisar um exemplo do livro Elements of Statistical Learning, com um caso canônico em 2 dimensões onde a fronteira de decisão é não linear. Vamos usar a SVM com kernel para aprender essa fronteira.
Primeiro, baixe os dados desse exemplo diretamente nesta URL, que é onde os dados ficam. São dados simulados e mistos. Depois, inspecione os nomes das colunas.
load(file = "ESL.mixture.rda")
names(ESL.mixture)
Por enquanto, os dados de treino são x e y. Já tínhamos um x e y no exemplo anterior. Vamos removê-los para anexar os novos dados.
rm(x, y)
attach(ESL.mixture)
Os dados também são bidimensionais. Vamos plotá-los para dar uma boa olhada.
plot(x, col = y + 1)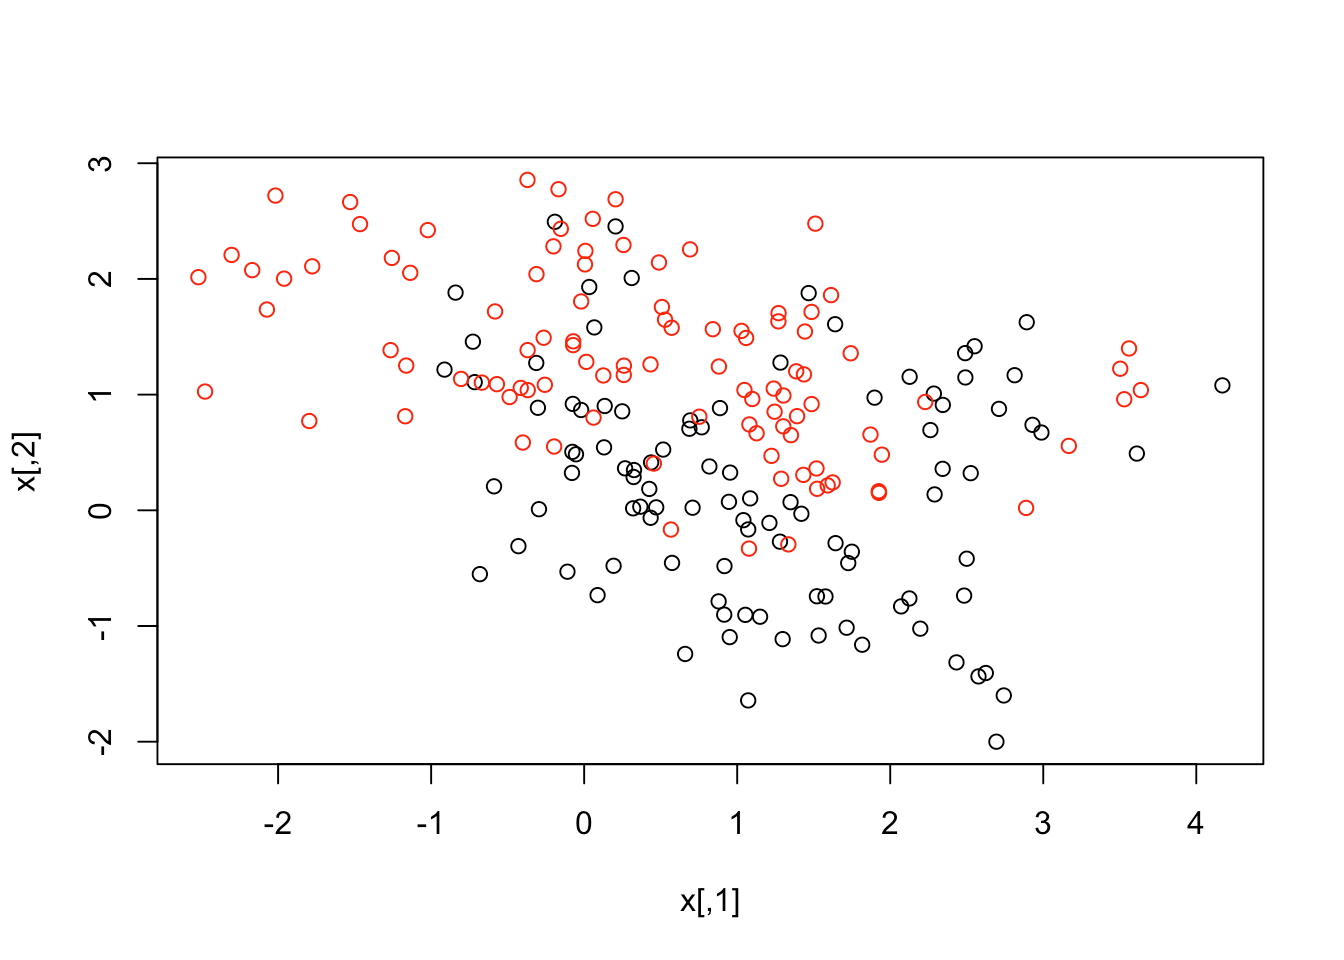
Os dados parecem se sobrepor bastante, mas dá para perceber uma estrutura especial. Agora, vamos montar um data frame com a resposta y, transformando-a em fator. Em seguida, ajustamos uma SVM com kernel radial e custo 5.
dat = data.frame(y = factor(y), x)
fit = svm(factor(y) ~ ., data = dat, scale = FALSE, kernel = "radial", cost = 5)
Hora de criar uma grade e fazer previsões. Esses dados já vêm com pontos de grade. No resumo dos nomes da lista, há duas variáveis, px1 e px2, que são as grades de valores para cada variável. Use expand.grid para criar a grade e, depois, preveja a classificação em cada ponto.
xgrid = expand.grid(X1 = px1, X2 = px2)
ygrid = predict(fit, xgrid)
Por fim, plote os pontos e pinte-os conforme a fronteira de decisão. Note que a fronteira é não linear. Coloque também os pontos de dados para ver onde caem.
plot(xgrid, col = as.numeric(ygrid), pch = 20, cex = .2)
points(x, col = y + 1, pch = 19)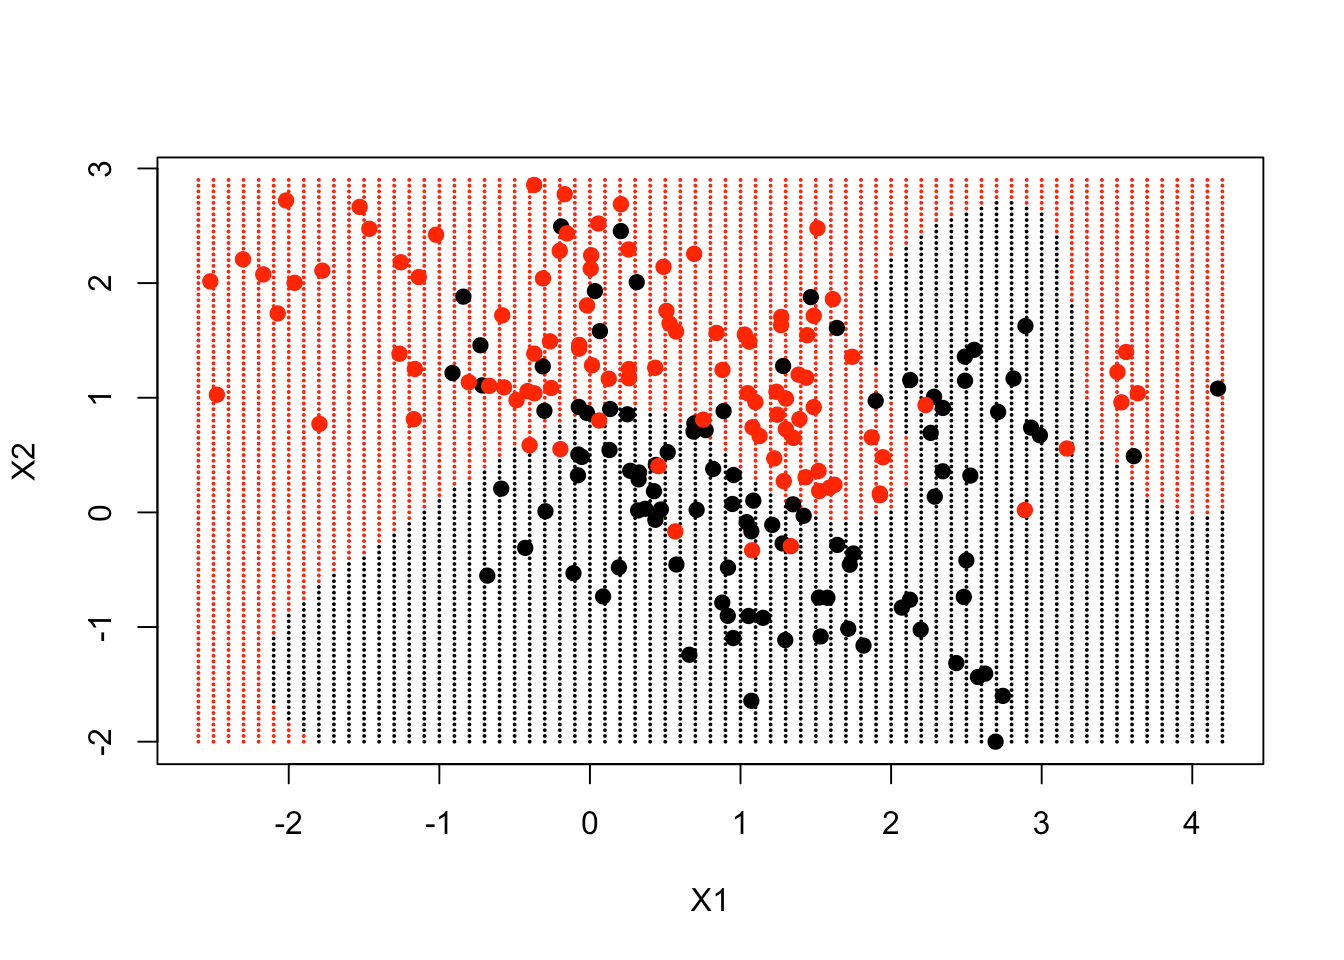
A fronteira de decisão, em boa parte, acompanha onde os dados estão, mas de forma bem não linear.
Vamos melhorar esse gráfico pedindo que predict produza os valores da função em cada ponto da grade. Em particular, queremos traçar a curva da fronteira de decisão usando contour. No data frame, há também a variável prob, que é a probabilidade verdadeira da classe 1 nesses dados, nos pontos da grade. Se plotarmos a curva de nível 0,5, teremos a fronteira de decisão de Bayes, que é o melhor possível.
Primeiro, prevemos o ajuste na grade. Definimos decision.values como TRUE porque queremos a função, não só a classificação. Ela retorna um atributo junto com os valores classificados; precisamos extrair esse atributo e acessar o chamado decision.
Depois, repetimos os passos para criar a grade, fazer as previsões e plotar os pontos.
Agora é a vez do contour. Ele precisa das duas sequências de grade, de uma função e dos argumentos level e add. Queremos a função em formato de matriz, com dimensões de px1 e px2 (69 e 99, respectivamente). Definimos level = 0 e adicionamos ao gráfico. Assim, o contorno acompanha a fronteira de decisão — uma forma prática de plotar uma fronteira não linear em 2D.
Por fim, incluímos a verdade, isto é, o contorno das probabilidades. É o contorno 0,5, que seria a fronteira de decisão em termos probabilísticos (também chamada de fronteira de decisão de Bayes).
func = predict(fit, xgrid, decision.values = TRUE)
func = attributes(func)$decision

xgrid = expand.grid(X1 = px1, X2 = px2)
ygrid = predict(fit, xgrid)
plot(xgrid, col = as.numeric(ygrid), pch = 20, cex = .2)
points(x, col = y + 1, pch = 19)

contour(px1, px2, matrix(func, 69, 99), level = 0, add = TRUE)
contour(px1, px2, matrix(func, 69, 99), level = 0.5, add = TRUE, col = "blue", lwd = 2)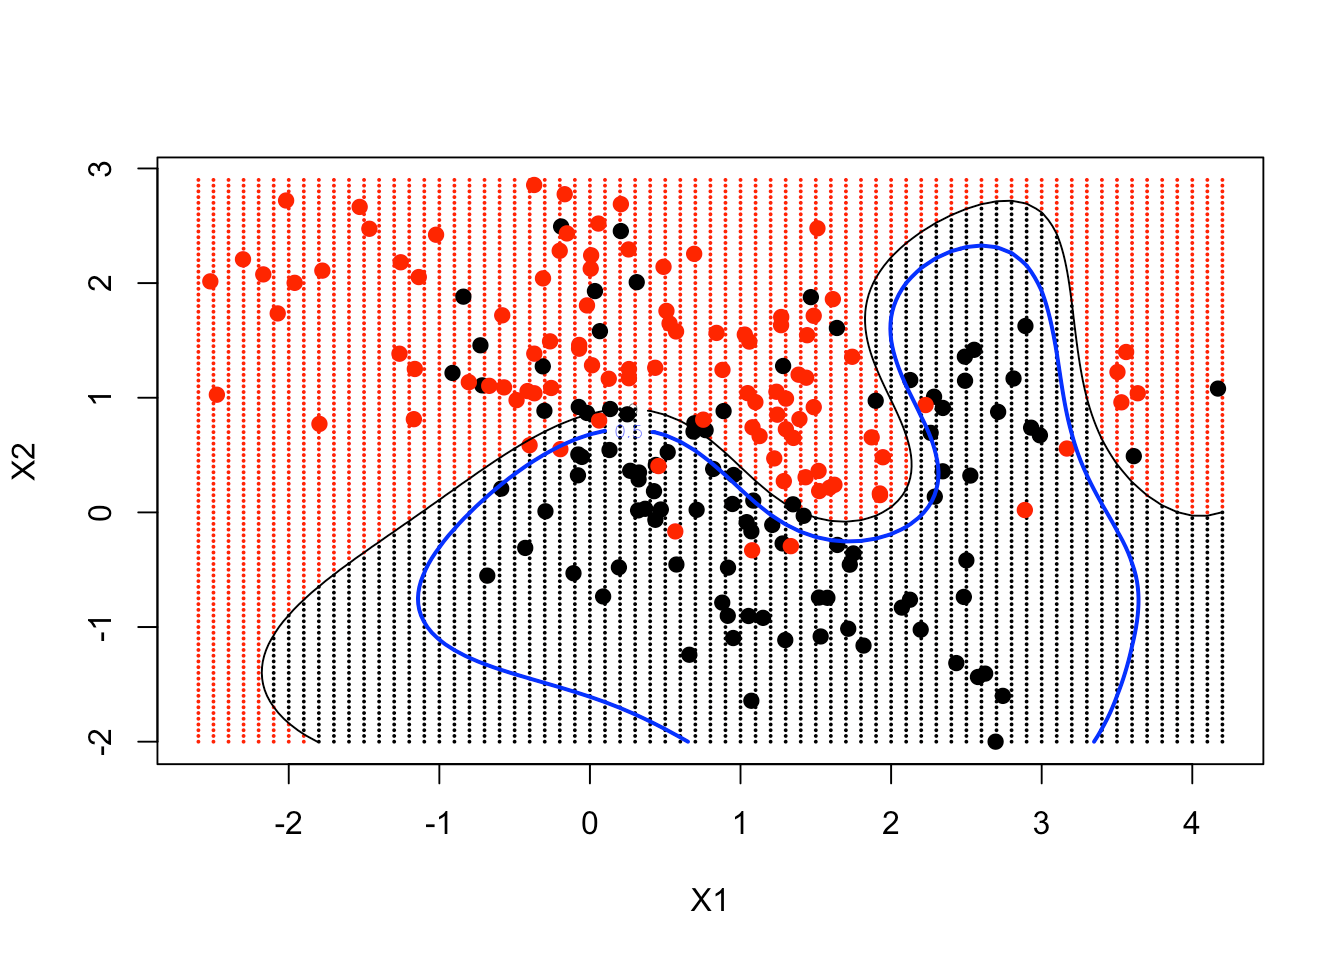
Como resultado, dá para ver que nossa SVM não linear chegou bem perto da fronteira de decisão de Bayes.
Recapitulando, Support Vector Machines são uma subclasse de classificadores supervisionados que tentam particionar um espaço de atributos em dois ou mais grupos. Elas fazem isso buscando a melhor forma de separar esses grupos com base em seus rótulos conhecidos:
Na minha opinião, SVMs são ótimos classificadores para situações em que os grupos estão claramente separados. Também funcionam muito bem quando os dados são separáveis de forma não linear. Você pode transformar os dados para separá-los linearmente ou deixar que a SVM faça essa conversão e separe as classes de forma linear automaticamente. Esse é um dos principais motivos para usar SVMs: você não precisa transformar dados não lineares por conta própria. Um ponto negativo é a natureza de “caixa-preta”. O uso de kernels para separar dados não lineares dificulta (ou até impossibilita) a interpretação. Entendê-las oferece uma alternativa a GLMs e árvores de decisão para classificação. Espero que este tutorial amplie sua visão sobre SVMs e ajude você a entendê-las melhor.
Se quiser aprender mais sobre R, faça o curso Machine Learning Toolbox da DataCamp.
Confira também nosso tutorial de Support Vector Machines com Scikit-learn.
Cursos de R
Curso
Curso
Curso
Tutorial
Eugenia Anello
8 min
Tutorial
Eladio Montero Porras
15 min
Tutorial
Abid Ali Awan
10 min
Tutorial
Arunn Thevapalan
15 min
Tutorial
Abid Ali Awan
11 min
Tutorial
Vidhi Chugh
14 min


