Curso
Introdução ao R
4 h
3.1M
Como você já sabe, machine learning é um subcampo da ciência da computação (CS). Deep learning, por sua vez, é um subcampo de machine learning composto por um conjunto de algoritmos inspirados na estrutura e no funcionamento do cérebro, normalmente chamados de redes neurais artificiais (ANN). Deep learning é uma das maiores tendências em machine learning no momento, e há muitos problemas em que ele brilha, como robótica, reconhecimento de imagens e inteligência artificial (IA).
O tutorial de hoje traz uma introdução rápida ao deep learning em R com Keras usando o pacote keras:
Quer saber mais sobre o Keras original ou sobre conceitos-chave de deep learning, como perceptrons e Perceptrons Multicamadas (MLPs)? Considere fazer o curso Deep Learning in Python da DataCamp ou seguir o Keras Tutorial: Deep Learning in Python.
Dica: encontre nosso cheat sheet de Keras aqui.
Com a popularização do deep learning, o CRAN ganhou mais pacotes de deep learning para R; abaixo você vê um panorama desses pacotes, retirado da CRAN Task View de Machine Learning e Statistical Learning. A coluna “Percentile” indica o percentil conforme encontrado no RDocumentation:
| Pacote R | Percentil | Descrição |
|---|---|---|
| nnet | 96º | Software para redes neurais feed-forward com uma única camada oculta e para modelos log-lineares multinomiais. |
| neuralnet | 96º | Treinamento de redes neurais usando backpropagation |
| h2o | 95º | Funcionalidades de script em R para H2O |
| RSNNS | 88º | Interface para o Stuttgart Neural Network Simulator (SNNS) |
| tensorflow | 88º | Interface para TensorFlow |
| deepnet | 84º | Ferramentas de deep learning em R |
| darch | 79º | Pacote para arquiteturas profundas e Restricted Boltzmann Machines |
| rnn | 73º | Pacote para implementar redes neurais recorrentes (RNNs) |
| FCNN4R | 52º | Interface para a biblioteca FCNN que permite ANNs extensíveis pelo usuário |
| rcppDL | 7º | Implementação de métodos básicos de machine learning com muitas camadas (deep learning), incluindo dA (Denoising Autoencoder), SdA (Stacked Denoising Autoencoder), RBM (Restricted Boltzmann Machine) e DBN (Deep Belief Nets) |
| deepr | ??* | Pacote para simplificar os processos de treinamento, ajuste fino e predição em deep learning baseado em darch e deepnet |
| MXNetR | ??* | Pacote que leva computação flexível e eficiente em GPU e deep learning de ponta para R |
Dica: para uma comparação de pacotes de deep learning em R, leia este post. Para mais informações sobre ranking e pontuação no RDocumentation, confira este artigo.
Os pacotes deepr e MXNetR não foram encontrados no RDocumentation.org, então o percentil é desconhecido para eles.
Recentemente, dois novos pacotes chegaram à comunidade R: o pacote kerasR, criado por Taylor Arnold, e o pacote keras do RStudio.
Ambos fornecem uma interface em R para o pacote Python Keras de deep learning, do qual você talvez já tenha ouvido falar — ou até usado! Para quem não conhece, o Keras oferece “uma API de alto nível para redes neurais, escrita em Python e capaz de rodar sobre TensorFlow, Microsoft Cognitive Toolkit (CNTK) ou Theano”.
Começar com Keras é uma das maneiras mais fáceis de se familiarizar com deep learning em Python, e isso explica por que kerasR e keras oferecem uma interface desse pacote fantástico para usuários de R.
Nesse caso, vale entender exatamente o que significa quando um pacote, como o keras em R, é “uma interface” para outro pacote, o Keras em Python. Em termos simples, isso quer dizer que o pacote keras em R permite que você programe em R e, ao mesmo tempo, aproveite as capacidades do Keras em Python.
Isso é bem comum: por exemplo, o pacote h2o também oferece uma interface — neste caso, como o nome já sugere — para o H2O, um mecanismo matemático open source para big data que permite computar algoritmos de machine learning paralelos e distribuídos. Outros pacotes que talvez você conheça e que funcionam como interfaces: RWeka (interface em R para Weka), tensorflow (interface em R para TensorFlow), openml-r (interface em R para OpenML), … e por aí vai!
Agora que você sabe disso tudo, pode surgir a pergunta: como comparar o pacote original em Python com os pacotes em R?
Em essência, você não vai encontrar muitas diferenças entre os pacotes em R e o pacote original em Python, principalmente porque os nomes das funções são quase os mesmos; as diferenças aparecem mais por conta da linguagem (atribuição de variáveis, carregamento de bibliotecas, …), mas o ponto mais importante é o quanto da funcionalidade original foi incorporada no pacote em R.
Essa observação vale não só para a biblioteca keras, mas também para tensorflow, openml-r, … e outras interfaces mencionadas acima!
Em segundo lugar, você pode se perguntar qual a diferença entre os dois pacotes em R. Para comparar, considere estes pontos:
O pacote keras usa o operador pipe (%>%) para encadear funções/operações, enquanto isso não aparece no kerasR: por exemplo, para montar seu modelo com kerasR, você precisará usar o operador $. O uso do pipe geralmente melhora a legibilidade do código — e você certamente já viu esse operador se trabalha com os pacotes do Tidyverse.
Você verá que o kerasR traz funções com nomes parecidos, mas não idênticos aos do Keras original. Por exemplo, a função compile() (em Python) vira keras_compile(); o mesmo vale para fit(), que vira keras_fit(), ou predict(), que vira keras_predict no kerasR. São wrappers personalizados.
Pode-se dizer que a instalação do keras do RStudio é mais simples do que a do kerasR; para instalar o segundo, você precisa configurar antes qual versão do Python usar — o que pode complicar se sua máquina tiver múltiplos ambientes ou versões de Python instaladas. Mas deixo essa avaliação com você :)

Agora que você já tem o pano de fundo, é hora de começar de verdade com Keras em R. Como você leu na introdução, primeiro vamos preparar o ambiente. Depois, vamos carregar alguns dados e, após uma breve exploração e um passo de pré-processamento, você poderá começar a construir seu MLP!
Bora lá!
Como sempre, o primeiro passo para começar com qualquer pacote é configurar seu ambiente: instalar e carregar a biblioteca no RStudio ou no ambiente de sua preferência.
Sem stress: neste tutorial, o pacote será carregado para você!
Primeiro, certifique-se de instalar o keras: você pode fazer isso executando devtools::install_github("rstudio/keras") no console. Em seguida, carregue o pacote e instale o TensorFlow:
# Carregue o pacote keras
library(keras)

# Instale o TensorFlow
install_tensorflow()
Feito isso, você já pode começar! Rápido, né?
Dica: para mais detalhes sobre a instalação, confira o site do pacote.
Com a instalação concluída e o ambiente pronto, é hora de carregar seus dados! Neste ponto, você tem três opções principais: usar um dos conjuntos de dados embutidos que vêm com o pacote keras, carregar seu próprio conjunto (por exemplo, de arquivos CSV) ou criar dados de exemplo (dummy).
Qualquer que seja o seu caso, você vai ver que dá para começar rapidamente. Esta seção passa pelas três opções e explica como carregar (ou criar) os dados de que você precisa!
Se você já tem experiência com o Keras em Python, provavelmente já acessou os datasets embutidos do Keras com funções como mnist.load_data(), cifar10.load_data() ou imdb.load_data().
Aqui estão alguns exemplos de como carregar os dados MNIST, CIFAR10 e IMDB com o pacote keras:
# Ler dados do MNIST
mnist <- dataset_mnist()

# Ler dados do CIFAR10
cifar10 <- dataset_cifar10()

# Ler dados do IMDB
imdb <- dataset_imdb()
Note que todas as funções para carregar datasets embutidos no keras seguem o mesmo padrão; para MNIST, você usa a função dataset_mnist().
Como alternativa, você também pode criar rapidamente dados dummy para começar. Use a função matrix() para isso:
Lembre-se de inspecionar a estrutura dos dados; é crucial entender o que você tem em mãos, pois isso será necessário nas próximas etapas. Você vai ver mais sobre isso ainda neste tutorial!
Além dos datasets embutidos, você pode carregar dados de arquivos. Neste tutorial, vamos focar em CSVs, mas se quiser saber mais sobre importação em R, veja o R Data Import Tutorial da DataCamp.
Vamos usar a função read.csv() do pacote read.table para carregar um conjunto do UCI Machine Learning Repository:
Sempre vale checar se a importação deu certo. Normalmente usamos head(), str() e dim() — como no bloco DataCamp Light acima — para isso rapidamente.
Os resultados não mostram nada fora do comum; pelo str(), você vê que as strings da coluna Species foram lidas como fatores. Não é problema, mas é bom saber para os próximos passos, quando vamos explorar e pré-processar os dados.
Neste tutorial, vamos continuar com o famoso conjunto iris que você importou com read.csv().
Para quem não tem o background de biologia necessário para trabalhar com esses dados, aqui vai: todas as flores têm sépalas e pétalas. A sépala envolve as pétalas e geralmente é verde e semelhante a uma folha, enquanto as pétalas são, em geral, coloridas. No caso das flores de íris, isso é um pouco diferente, como você vê na imagem a seguir:

Você deve ter notado na seção anterior que o data frame iris não tinha nomes de colunas após a importação. Para o restante do tutorial, isso não é tão crítico: embora read.csv() retorne um data.frame, os dados que você vai passar para a função fit() precisam ser uma matriz ou array.
Alguns lembretes sobre essas duas estruturas: - Matrizes e arrays não têm nomes de colunas; - Matrizes são objetos bidimensionais de um único tipo de dado; - Arrays são objetos multidimensionais de um único tipo de dado;
Dica: veja este vídeo se quiser relembrar as estruturas de dados em R!
Já o data frame é uma lista nomeada especial em que todos os elementos têm o mesmo comprimento. É um objeto multidimensional que pode conter múltiplos tipos de dados. Você já viu isso ao checar a estrutura do iris antes. Sabendo disso e considerando que vamos precisar de um objeto bi ou multidimensional de um único tipo, já dá para se preparar para algum pré-processamento antes de construir a rede neural!
Por ora, nomes de coluna ajudam na exploração e na compreensão dos dados, então vamos adicioná-los com names(). Em seguida, já usamos a variável iris na exploração! Plote, for exemplo, como o comprimento e a largura da pétala se correlacionam com plot().
Note que usamos unclass() para converter os nomes das espécies — “setosa, versicolor” e “virginica” — em valores numéricos 1, 2 e 3.
Agora olhe mais de perto o resultado do gráfico:

O gráfico indica correlação positiva entre Petal.Length e Petal.Width para as diferentes espécies de íris. Mesmo assim, você provavelmente vai querer testar isso com a função cor(), que dá a correlação geral entre todos os atributos incluídos no conjunto:
Além disso, você pode usar o pacote corrplot em conjunto com cor() para visualizar as correlações entre os atributos; aqui, calculamos a correlação geral para todos os atributos do data frame iris. Guardamos o resultado em M e o passamos para corrplot().
Não esqueça de indicar o método (method) de visualização!
Você pode experimentar com o método de visualização no bloco DataCamp Light abaixo:

Use o console do R para explorar os dados ainda mais.
Se quiser fazer gráficos com o pacote ggvis, que traz uma gramática de gráficos interativa, veja o tutorial Machine Learning in R For Beginners da DataCamp ou faça o curso de ggvis.
Antes de construir o modelo, você precisa garantir que os dados estejam limpos, normalizados (se aplicável) e divididos em treino e teste. Como o dataset vem do UCI Machine Learning Repository, dá para esperar que esteja relativamente limpo — mas vamos conferir a qualidade mesmo assim.
A princípio, quando olhou com head(), nada estranho, certo? Vamos usar summary() e str() para recapitular o que aprendemos ao checar a importação:
Agora que você tem certeza de que os dados estão bons, confira se a normalização é necessária para algum dos atributos usados neste tutorial.
Pelo resultado de summary() no bloco acima, vemos que o conjunto Iris não precisa de normalização: Sepal.Length vai de 4,3 a 7,9; Sepal.Width, de 2 a 4,4; Petal.Length, de 1 a 6,9; e Petal.Width, de 0,1 a 2,5. Em outras palavras, todos os valores estão entre 0,1 e 7,9 — aceitável.
Ainda assim, pode ser uma boa estudar o efeito da normalização; você pode até passar os dados normalizados ao modelo para ver se há impacto. Está fora do escopo aqui, mas sinta-se à vontade para testar! O código está todo neste tutorial :)
Você pode criar sua própria função para normalizar os dados de iris; aqui usamos a normalização min-max, que transforma linearmente para (x-min)/(max-min). Traduzir essa fórmula para R é simples: crie uma função que receba x. Calcule x-min e guarde em num. Depois, calcule max-min e guarde em denom. A função normalize() deve retornar num/denom.
Para aplicar essa UDF aos dados de iris (excluindo o alvo), use normalize junto com lapply(), assim:
Dica: use hist() no console para estudar a distribuição dos dados antes (iris) e depois da normalização (iris_norm).
Para usar a função normalize() do pacote keras, primeiro garanta que você está trabalhando com uma matriz. Como vimos, matrizes contêm elementos de um mesmo tipo; aqui, o alvo é factor, enquanto o resto é numérico.
Isso precisa mudar primeiro.
Use as.numeric() para converter os dados para números:
Um data frame numérico está ok, mas você precisa converter para matriz ou array para usar o keras. Faça isso com as.matrix(); não esqueça de definir dimnames como NULL.
Como vimos acima, normalizar o Iris não é necessário. Ainda assim, vale estudar o efeito e ver como fazer isso não só com uma UDF, mas também com a normalize() do keras.
Com os dados já em matriz, você também pode usar o keras para estudar o efeito da normalização:
Aqui, usamos dimnames() para definir os nomes de dimensão como NULL, garantindo que não haja nomes de coluna.
Com a qualidade verificada e sabendo que a normalização não é necessária, siga com os dados originais e separe-os em treino e teste para enfim construir o modelo. Assim, você garante avaliações honestas do desempenho do modelo depois.
Antes de dividir, defina uma semente com set.seed(): passe um inteiro aleatório. A semente alimenta o gerador de números aleatórios do R. A grande vantagem é a reprodutibilidade: com a mesma semente, você obtém a mesma sequência.
Use sample() para amostrar com tamanho igual ao número de linhas do Iris (150). A amostra é com reposição: você escolhe de um vetor com 2 elementos e atribui 1 ou 2 às 150 linhas. A atribuição segue pesos de probabilidade 0,67 e 0,33.
O argumento replace de sample() está como TRUE, o que significa que você atribui 1 ou 2 a uma linha e então o vetor volta ao estado original.
Ou seja, para as próximas linhas, você pode atribuir 1 ou 2 novamente. A probabilidade de escolher 1 ou 2 não deve depender dos itens restantes; por isso definimos pesos.
Observação: se você usar um dataset embutido como o dataset_imdb(), por exemplo, dá para separar os dados facilmente com o operador $:
x_train <- imdb$train$x
y_train <- imdb$train$y
x_test <- imdb$test$x
y_test <- imdb$test$y
Você separou seus dados, mas ainda falta um passo para começar a construir o modelo. Consegue adivinhar qual?
Ao modelar problemas de classificação multiclasse com redes neurais, é prática comum transformar o atributo alvo de um vetor com valores de classe para uma matriz com booleanos, indicando para cada classe se uma instância pertence a ela ou não.
Essa é uma explicação livre de One-Hot Encoding (OHE). Parece complexo, né?
Felizmente, o pacote keras tem a função to_categorical() que faz isso para você; passe iris.trainingtarget e iris.testtarget e guarde em iris.trainLabels e iris.testLabels:
Pronto: fim da exploração e do pré-processamento neste tutorial. Agora vamos construir a rede neural com keras!
Para começar, inicialize um modelo sequencial com keras_model_sequential(). Depois, comece a modelar.
Antes, vale revisitar a pergunta original: dá para prever a espécie de uma flor de íris? Trabalhar com dados numéricos é mais fácil, e você já pré-processou e aplicou one-hot encoding ao alvo: a flor é versicolor, setosa ou virginica — representado por 1 e 0 binários.
Um tipo de rede que funciona bem nesse problema é o perceptron multicamadas. Esse tipo de rede neural costuma ser totalmente conectada. Ou seja, vamos montar uma pilha simples de camadas densas para resolver o problema. Quanto às funções de ativação, a mais comum para começar com Keras e redes neurais é a relu. Essa função retificadora é usada em uma camada oculta — em geral, uma boa prática.
Além disso, usamos a softmax na camada de saída, para garantir que os valores de saída fiquem entre 0 e 1 e possam ser interpretados como probabilidades previstas:
Veja como a camada de saída cria 3 valores de saída, um para cada classe de íris (versicolor, virginica ou setosa). Já a primeira camada, com 8 nós ocultos, tem input_shape de 4 — pois iris.training tem 4 colunas.
Você pode inspecionar seu modelo com as funções abaixo:
Com a arquitetura pronta, é hora de compilar e ajustar o modelo aos dados. Para compilar, configure o otimizador adam e a função de perda categorical_crossentropy. Além disso, monitore a acurácia durante o treino passando 'accuracy' no argumento metrics.
Optimizer e loss são argumentos obrigatórios na compilação.
Algoritmos populares de otimização incluem Stochastic Gradient Descent (SGD), ADAM e RMSprop. Dependendo da escolha, você ajusta parâmetros como taxa de aprendizado (learning rate) ou momentum. A escolha da função de perda depende da tarefa: por exemplo, para regressão, usa-se geralmente Mean Squared Error (MSE).
Neste exemplo, usamos categorical_crossentropy para o problema multiclasse de determinar se uma íris é versicolor, virginica ou setosa. Note que, para classificação binária, você deveria usar binary_crossentropy.
Agora ajuste o modelo aos dados; aqui, treinamos por 200 epochs (iterações sobre todas as amostras em iris.training e iris.trainLabels), em lotes (batches) de 5 amostras.
Dica: se quiser, você pode definir o argumento verbose em fit(). Com valor 1, você vê a barra de progresso.
O código acima treina o modelo por um número definido de epochs (exposições ao conjunto de treino). Uma epoch é uma passagem única por todo o treino, seguida de teste no conjunto de validação. O batch_size define quantas amostras são propagadas pela rede de cada vez. Isso também ajuda na eficiência, evitando carregar padrões demais na memória ao mesmo tempo.
Você também pode visualizar o ajuste se armazenar o resultado do fit em uma variável. Depois, passe essa variável para plot(), como neste bloco!
Estude o gráfico com atenção.
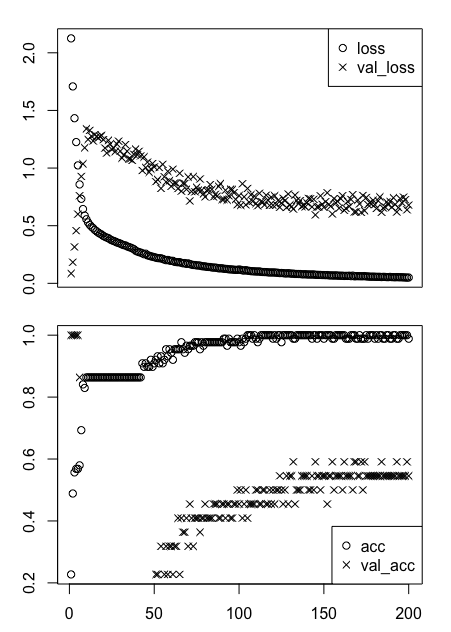
À primeira vista, é normal parecer meio bagunçado. Talvez não esteja claro o que observar.
Algo útil: loss e acc indicam perda e acurácia no treino, enquanto val_loss e val_acc são essas mesmas métricas nos dados de validação (teste).
Ainda assim, não é trivial interpretar os dois gráficos juntos. Vamos separar em dois: um para a perda do modelo e outro para a acurácia. Felizmente, dá para usar o operador $ para acessar os dados e plotar passo a passo.
Veja como fazer abaixo:
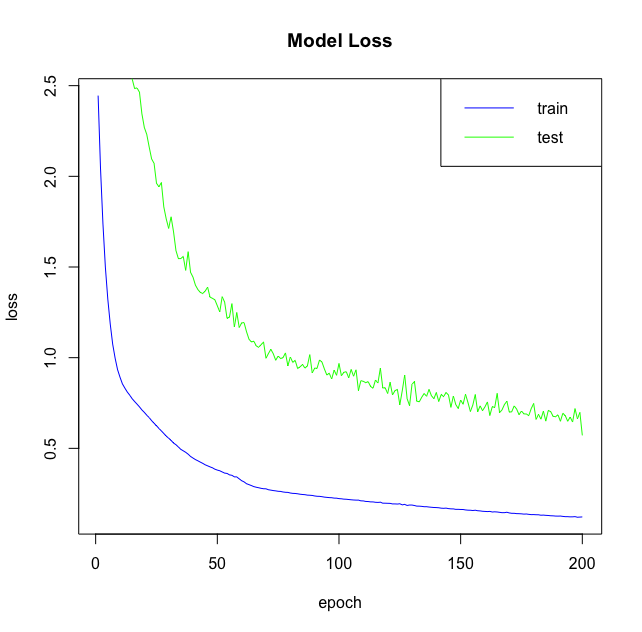
No primeiro gráfico, você plotou a perda do modelo no treino e no teste. Agora faça o mesmo para a acurácia:
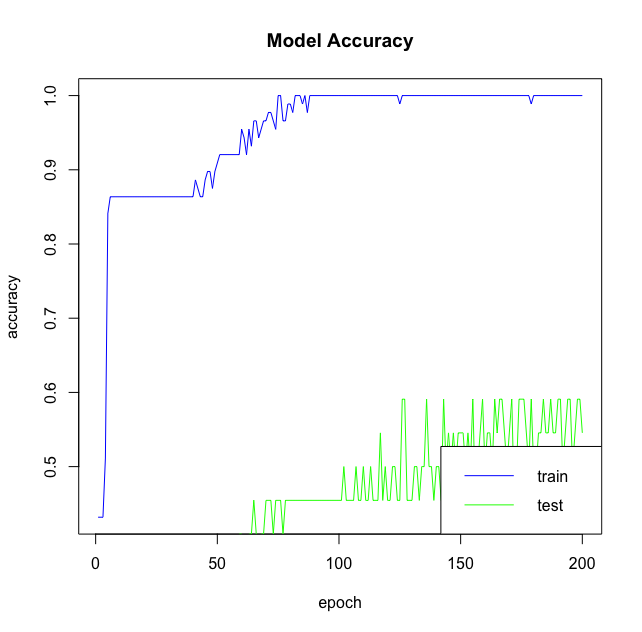
Alguns pontos para ter em mente:
Com o modelo criado, compilado e ajustado, é hora de usá-lo para prever os rótulos do conjunto de teste iris.test. Como esperado, use predict(). Depois, imprima a matriz de confusão para comparar previsões e rótulos reais do iris.test com table().
O que achou dos resultados? À primeira vista, o modelo parece acertar as previsões?
Mesmo tendo uma ideia do desempenho ao olhar as previsões para iris.test, ainda é importante avaliar o modelo. Use evaluate(): passe os dados de teste iris.test, os rótulos iris.testLabels e defina o batch size. Guarde o resultado em score, como abaixo:
Ao imprimir score, você recebe o valor da perda e o valor da métrica (neste caso, 'accuracy').
Ajustar o modelo é algo que você vai fazer bastante, especialmente no começo, porque nem todos os problemas de classificação e regressão são tão diretos quanto o primeiro exemplo. Como vimos, há duas decisões-chave que você provavelmente vai ajustar: quantas camadas usar e quantas “unidades ocultas” em cada camada.
No início, é uma jornada de experimentação.
Além de brincar com o número de epochs ou o batch size, há outras formas de melhorar o modelo: adicionando camadas, aumentando o número de unidades ocultas e passando seus próprios parâmetros de otimização para compile(). Esta seção cobre essas três opções.
O que acontece se você adicionar outra camada ao modelo? E se ficar assim?
Você também pode visualizar as métricas de loss e accuracy deste novo modelo! Teste no bloco abaixo:
|
|
|
Além de adicionar camadas e brincar com as unidades ocultas, você pode ajustar parâmetros do algoritmo de otimização passado para compile(). Até agora, passamos apenas a string 'adam' para o argumento optimizer.
Mas não precisa ser sempre assim!
Experimente outros algoritmos, como o Stochastic Gradient Descent (SGD). Tente, por exemplo, usar a função optimizer_sgd() para ajustar a taxa de aprendizado (lr). Nota algum efeito?
Além de outro otimizador, tente usar uma taxa de aprendizado menor. É uma técnica comum de ajuste fino; uma prática frequente é reduzir a taxa inicial em 10 vezes em relação à usada anteriormente.
Vamos visualizar o histórico de treino mais uma vez para ver o efeito desse ajuste:
|
|
|
Por fim, você pode salvar ou exportar seu modelo para carregá-lo depois.
save_model_hdf5(model, "my_model.h5")
model <- load_model_hdf5("my_model.h5")
save_model_weights_hdf5("my_model_weights.h5")
model %>% load_model_weights_hdf5("my_model_weights.h5")
json_string <- model_to_json(model)
model <- model_from_json(json_string)

yaml_string <- model_to_yaml(model)
model <- model_from_yaml(yaml_string)
Parabéns! Você concluiu este tutorial de deep learning em R com keras. Este foi apenas um pequeno passo na sua jornada; há muito mais para cobrir! Se ainda não fez, considere o curso Deep Learning in Python da DataCamp.
Enquanto isso, confira a documentação do Keras e a documentação do keras do RStudio. Você encontrará mais exemplos e informações sobre funções, argumentos, camadas, etc. Além disso, confira o livro de François Chollet, “Deep Learning with Python”. Todos esses recursos serão indispensáveis para aprender a trabalhar com redes neurais em R!
Cursos relacionados
Curso
Curso
Curso
Tutorial
Abid Ali Awan
10 min
Tutorial
Sejal Jaiswal
15 min
Tutorial
Abid Ali Awan
11 min
Tutorial
Eladio Montero Porras
15 min
Tutorial
Arunn Thevapalan
15 min
Tutorial
Zoumana Keita
12 min