Curs
Introducere în modelele Claude
3 ore
14.9K
GPT-6 Astra este modelul flagship de vârf al OpenAI, succesorul lui GPT-5.6 Sol, construit în jurul execuției agentice, nu al chatului. OpenAI îl poziționează pe utilizarea computerului, munca profesională și ingineria software, și este primul model OpenAI care depășește pragul „Critic” în securitate cibernetică din Preparedness Framework al companiei. Rulează cu o fereastră de context de 1.050.000 de tokeni, output maxim 128K și un knowledge cutoff la 30 aprilie 2026.
Două lucruri ies în evidență în anunț. În Codex, Astra păstrează notițe între ferestrele de context în loc să le compacteze într-un rezumat, astfel încât ferestrele mai vechi rămân căutabile, și decide când să pună o întrebare de clarificare, în loc să ghicească mereu sau să întrebe mereu.
Pentru lista completă de funcții, tabele de benchmark și detalii de acces, vezi ghidul GPT-6 Astra. Merită citit în paralel cu acoperirea predecesorului său din GPT-5.6 Sol, Terra și Luna.
Claude Fable 5.1 este modelul de vârf disponibil în general al Anthropic pentru raționament solicitant și muncă agentică pe orizont lung. Rulează o fereastră de context de 1M tokeni cu output maxim 128K, gândire adaptivă mereu activă și knowledge cutoff în iunie 2026. Documentația Anthropic îl evaluează ca având o latență mai mare decât Claude Opus 5 și Claude Sonnet 5, ambele mai ieftine.
Claude Mythos 5.1 este același model cu alte măsuri de siguranță, disponibil prin invitație prin Project Glasswing. Schimbarea principală pentru toți ceilalți este prețul la citirea din cache, redus cu 75% la 0,25$ per milion de tokeni, în timp ce tarifele de listă au rămas neschimbate.
Ghidul Claude Fable 5.1 are defalcarea completă a benchmarkurilor, iar tutorialul API Claude Fable 5.1 construiește un agent pentru dezvoltatori, conștient de repository, inclusiv o defalcare reală a costurilor pe niveluri de efort.
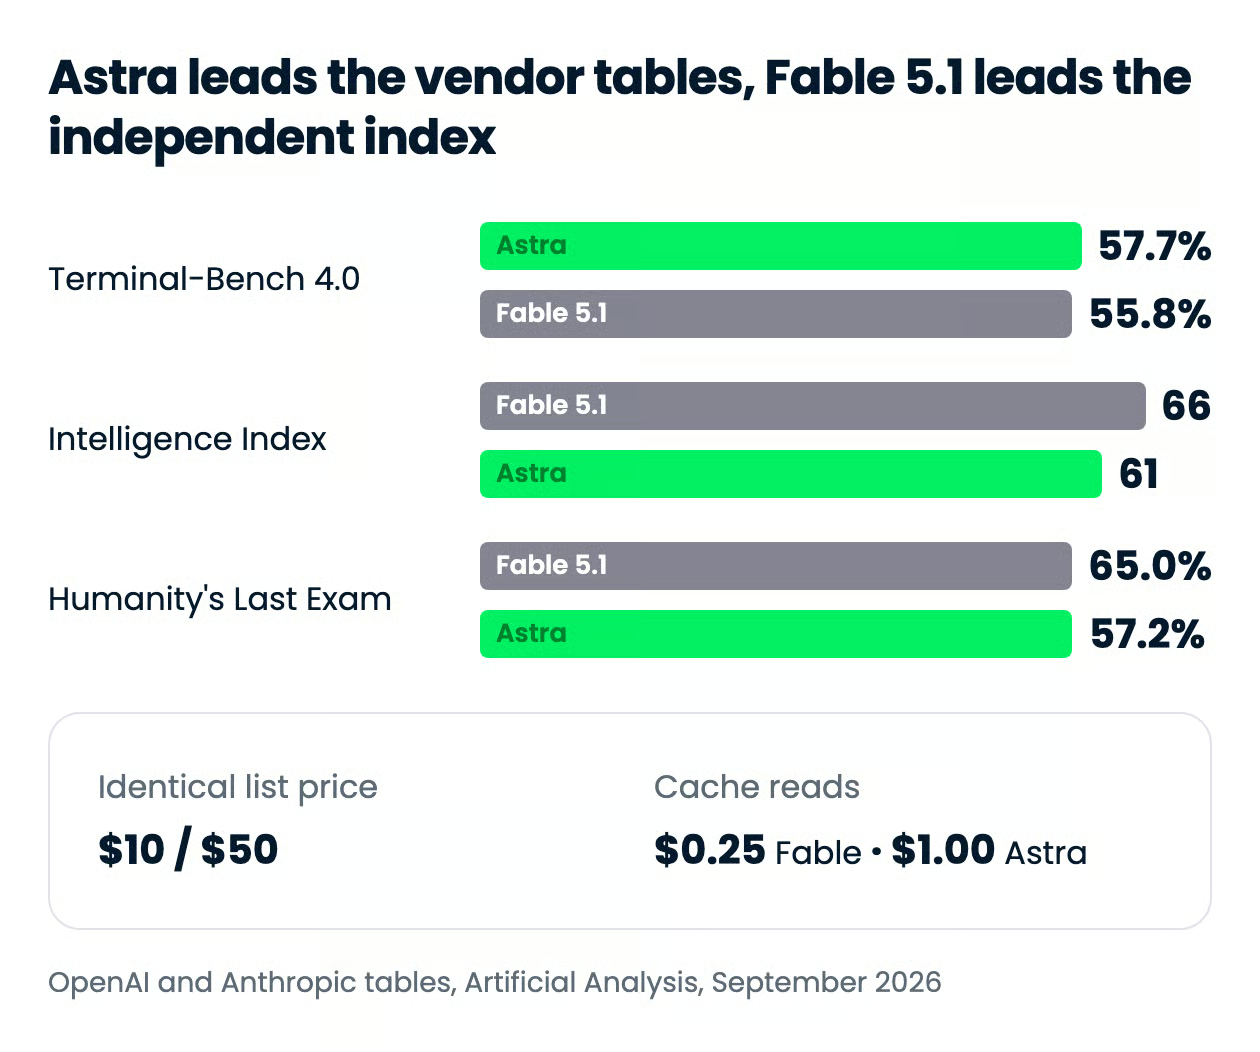
Pe scurt: tabelul de comparație al OpenAI îl arată pe Astra înaintea lui Fable 5.1 la aproape fiecare rând publicat, iar Artificial Analysis arată invers pe ambii săi indici. În care crezi depinde de câtă greutate acorzi unui vendor care își punctează competitorul.
| Funcție | GPT-6 Astra | Claude Fable 5.1 |
|---|---|---|
| Data lansării | 3 septembrie 2026 | 1 septembrie 2026 |
| ID model API | gpt-6-astra |
claude-fable-5-1 |
| Fereastră de context | 1,05M tokeni | 1M tokeni |
| Output maxim | 128K tokeni | 128K tokeni |
| Knowledge cutoff | 30 aprilie 2026 | Iunie 2026 |
| Preț de listă per 1M tokeni | 10$ input / 50$ output | 10$ input / 50$ output |
| Citire input din cache per 1M | 1,00$ (2,00$ peste 272K) | 0,25$ |
| Tarife peste 272K tokeni de input | 2x input și cache, 1,5x output | Fără suprataxă |
| FrontierMath Tier 4 (v2) | 97,6% | 87,8% |
| Humanity's Last Exam, cu unelte | 57,2% | 65,0% |
| ScreenSpot-Pro (fără unelte) | 92,7% | 87,3% (Fable 5, din Mythos) |
| AutomationBench | 41,4% | 31,4% |
| ExploitBench | 100% | 70% |
| AA Intelligence Index (efort max) | 61 | 66 |
| Cost AA per task pe Intelligence Index (max) | 1,67$ | 3,76$ |
| Zonă de forță | Utilizare computer, matematică, securitate cibernetică, cost per task | Profunzime în raționament, bucle agent dominate de cache |
Astra conduce pe benchmarkurile de cod alese de OpenAI pentru publicare, dar marjele sunt mici, iar indicele independent nu e de acord. Pe Terminal-Bench 4.0, care testează inginerie software, configurare de sistem și analiză de date în terminal, OpenAI raportează 57,7% pentru Astra față de 55,8% pentru Fable 5.1. Anthropic publică același 55,8%, deci cel puțin acel rând e necontestat.
Diferența crește pe DeepSWE v1.1, unde Astra ajunge la 74,1% față de 67,4%, și aproape dispare pe FrontierCode 1.1 Main, unde 53,3% față de 50,9% se încadrează în intervalul pe care Claude Fable 5 (53,5%) și Claude Opus 5 (53,4%) îl ocupaseră deja.
| Benchmark | GPT-6 Astra | Claude Fable 5.1 | Note |
|---|---|---|---|
| Terminal-Bench 4.0 | 57,7% | 55,8% | Tabelul OpenAI spune 57,7% în timp ce legenda graficului spune 57,9% |
| DeepSWE v1.1 | 74,1% | 67,4% | Raportat de OpenAI |
| FrontierCode 1.1 Main | 53,3% | 50,9% | Practic la egalitate cu Fable 5 la 53,5% și Opus 5 la 53,4% |
| Migrare internă de bază de date | 63,9% | 57,8% | Evaluare internă OpenAI, fără replicare externă |
| CursorBench 3.2.0 | Nepublicat | 73,4% | Raportat de Anthropic; SpaceXAI a confirmat 73,4% la efort maxim |
| AA Coding Agent Index | 67 în Codex | 70 în Claude Code | Independent, dar harness-uri diferite |
Ultimul rând este cel la care tot revin. Artificial Analysis îl pune pe Fable 5.1 în Claude Code la 70, cel mai mare scor pe Coding Agent Index, și pe Astra în Codex la 67, aproximativ la nivelul Claude Opus 5 și Claude Fable 5. Două avertismente merită reținute aici:
Astra câștigă rândurile de cod publicate la mustață și câștigă clar argumentul eficienței, în timp ce Fable 5.1 deține singurul scor independent de agent de cod care îi depășește pe amândoi.
Aici este cea mai curată separare din toată comparația și merge în ambele sensuri. Astra ia rândurile de matematică și științe: 97,6% față de 87,8% pe FrontierMath Tier 4 v2, 96,0% față de 93,7% pe GPQA Diamond și 64,6% față de 52,6% pe Terminal-Bench Science 0.1, benchmarkul agentic de cercetare în jurul căruia Anthropic și-a construit lansarea.
Fable 5.1 ia Humanity's Last Exam cu unelte, 65,0% față de 57,2%, și diferența este clară. Artificial Analysis confirmă independent direcția rezultatului, punctând Fable 5.1 la 66 pe Intelligence Index față de 61 pentru Astra, cel mai mare scor măsurat până acum.
Un avertisment pentru acel 66. Artificial Analysis a rulat Fable 5.1 cu fallback-ul implicit pe server al Anthropic, care redirecționează cererile marcate de siguranță către Claude Opus 4.8 sau Claude Opus 5, iar fallback-ul a servit aproximativ 4% din tokenii de output pe index. Scorul este al lui Fable 5.1, așa cum îl vor apela majoritatea, nu al modelului izolat.
Dacă munca ta este matematică sau știință la nivel de master/doctorat, Astra. Dacă este raționament larg și dificil, de tipul celui sondat de Humanity's Last Exam, Fable 5.1.
Astra domină această dimensiune, în mare parte pentru că Anthropic nu a publicat cifre comparabile. OpenAI raportează 72,6% pentru Astra pe setul offline al OSWorld 2.0 față de 70,2% pentru Claude Opus 5 și 92,7% pe ScreenSpot-Pro față de 87,3% pentru Claude Fable 5. Cifrele proprii ale Anthropic pentru Fable 5.1, 77,9% parțial și 41,7% strict, provin dintr-o altă versiune de task-uri și un alt setup de notare.
Cifrele pentru artefacte sunt mai puțin ambigue: 95,9% pe BenchCAD față de 84,3% și 41,4% față de 31,4% pe AutomationBench.
Pentru agenți care dau click prin software real și produc slide-uri sau output CAD, Astra este alegerea mai puternică.
Cifrele de aliniere ale lui Astra sunt partea cel mai puțin discutată a lansării. Pe benchmarkul intern OpenAI de siguranță a utilizării computerului, unde mai mic e mai bun, obține 2,4% față de 9,5% pentru Fable 5.1.
La securitate cibernetică, e în altă ligă: 100% pe ExploitBench și 86 din 226 provocări FrontierCyber rezolvate față de 34 pentru GPT-5.6 Sol în testarea independentă a Irregular. Anthropic a relaxat suficient Fable 5.1 pentru a identifica vulnerabilități, dar nu pentru a le exploata.
Două avertismente, ambele importante:
Astra este atât agentul mai sigur, cât și atacatorul mai capabil, de aici și limitările de acces.
Tarifele de listă sunt identice, deci în grila de tarife singura diferență dintre aceste două modele vine din cache și context lung. Această încadrare e valabilă doar dacă ambele modele cheltuie același număr de tokeni pe aceeași sarcină, iar ele nu o fac, motiv pentru care cifrele măsurate per task de mai jos contează mai mult decât grila.
| Tarif | GPT-6 Astra | Claude Fable 5.1 |
|---|---|---|
| Input, per 1M tokeni | 10,00$ | 10,00$ |
| Output, per 1M tokeni | 50,00$ | 50,00$ |
| Citire input din cache, per 1M tokeni | 1,00$ | 0,25$ |
| Scriere în cache (5 minute), per 1M tokeni | 12,50$ | 12,50$ |
| Discount pentru batch | 50% | 50% |
| Tarife peste 272K tokeni de input | 20,00$ input / 2,00$ cache / 75,00$ output | Fără suprataxă |
Inputul, outputul, scrierile în cache și discountul de batch se potrivesc la cent. Linia pentru citirea din cache este excepția și este o diferență de 4x: Anthropic reduce citirile din cache ale lui Fable 5.1 la 0,25$, în timp ce OpenAI evaluează la 1,00$ pe Astra, un discount de 90% față de tariful la input.
Peste 272K tokeni de input, diferența se lărgește la 8x, deoarece suprataxa OpenAI dublează citirile din cache la 2,00$ odată cu inputul, în timp ce documentația de prețuri Anthropic plasează întreaga fereastră de 1M tokeni la tarife standard. Observă cât de jos este pragul relativ la ce promite Astra: 272K este aproximativ un sfert din fereastra de 1,05M, deci orice cerere care folosește mai mult de un sfert din context este taxată la nivelul mai ridicat.
Citirile din cache sunt tariful care se compune pe o buclă lungă, deoarece un agent retrimite același prompt de sistem, definițiile de unelte și contextul repository la fiecare tură. Ghidul nostru despre caching-ul prompturilor acoperă mecanica distincției cache write–cache read, dacă îți este nouă.
Tot ce e în acest tabel este aritmetică la tarifele de listă pe o formă fixă de tokeni, nu un rezultat măsurat. Răspunde la întrebarea „dacă ambele modele ar consuma tokeni identici, ce ar taxa grila?”. Secțiunea următoare răspunde la ce consumă ele de fapt.
| Workload | GPT-6 Astra | Claude Fable 5.1 | Diferență |
|---|---|---|---|
| Asistent echilibrat: 1M input / 250K output | 22,50$ | 22,50$ | 0$, 0% |
| Retrieval, sub prag: 10M input / 1M output | 150$ | 150$ | 0$, 0% |
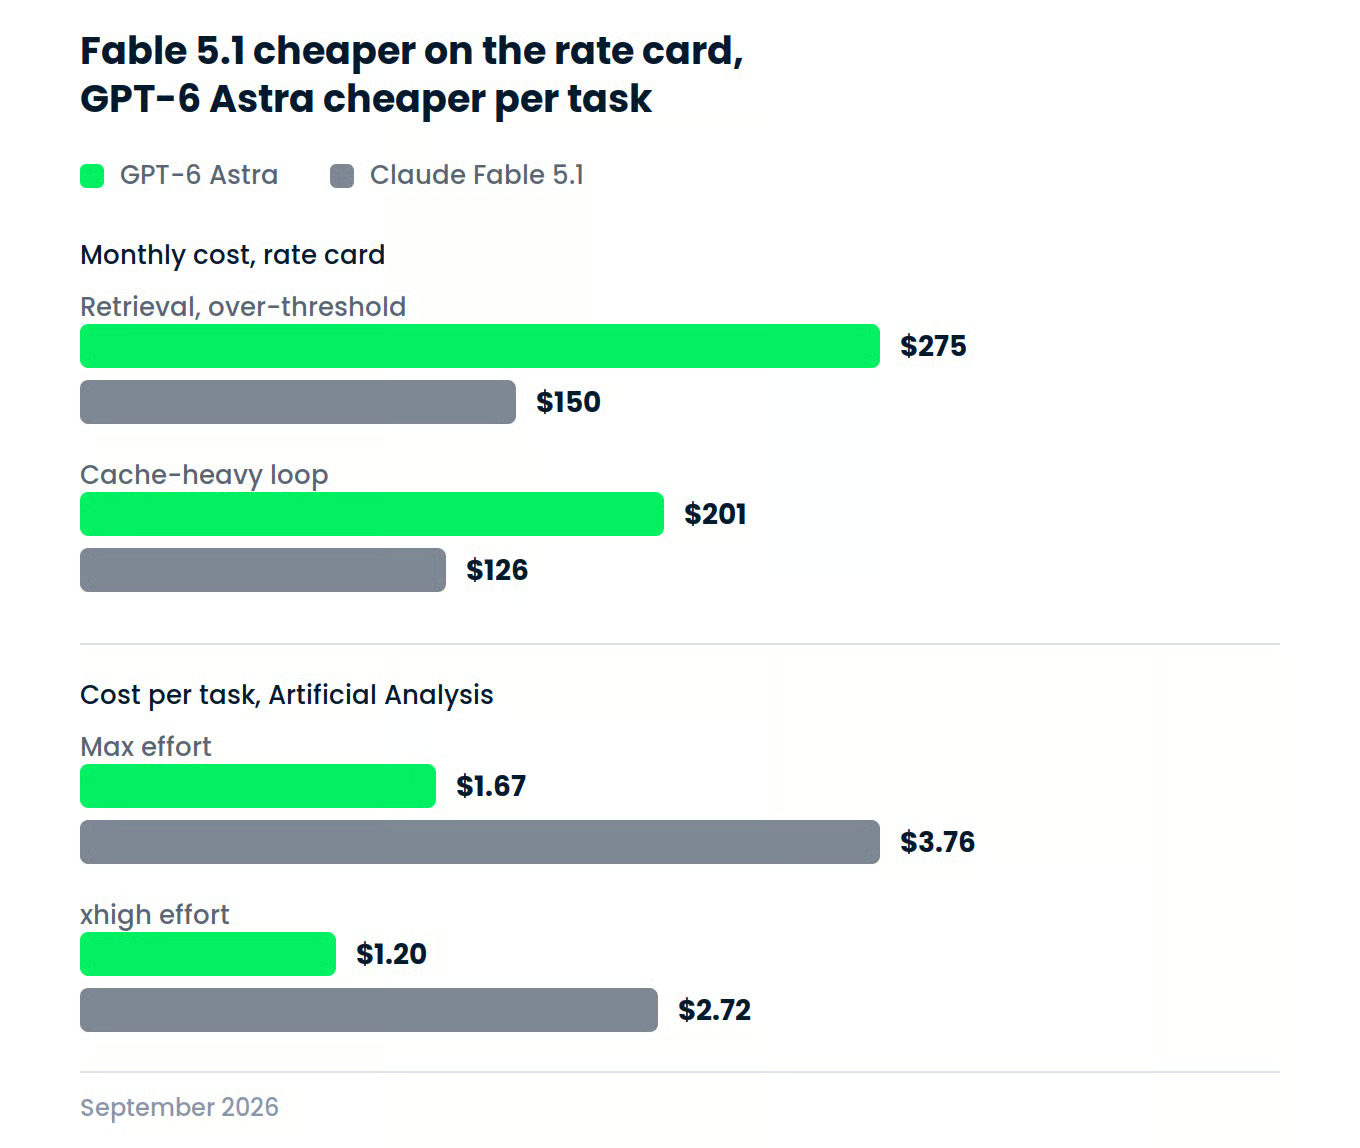
| Retrieval, peste prag: 10M input / 1M output | 275$ | 150$ | 125$, cu 83% mai mult pentru Astra |
| Buclă dominată de cache: prefix 100K, 1.000 citiri | 201$ | 126$ | 75$, cu 59% mai mult pentru Astra |
Formula e aceeași pentru fiecare rând: (volum ÷ 1M) × tarif, însumat peste input proaspăt, citiri din cache, scrieri în cache și output. Rândul cu bucla dominată de cache presupune un prefix de 100K scris o dată și citit înapoi de 1.000 de ori, plus 5K input proaspăt și 1K output per cerere.
Rândul cu retrieval peste prag este de titlu. Ține fiecare cerere sub 272K tokeni de input, iar cele două modele costă exact același 150$. Împinge aceiași 10M tokeni prin cereri care depășesc fiecare 272K, iar Astra sare la 275$ în timp ce Fable 5.1 rămâne la 150$, deoarece Anthropic taxează întreaga fereastră de 1M tokeni la tarife standard.
Bucla dominată de cache este cea pe care o vor întâlni cei mai mulți cititori. La 1.000 de citiri cached ale unui prefix de 100K, diferența de 0,75$ per milion de tokeni cached se transformă într-o diferență de 75$ pe un workload altfel identic. Observă însă forma acelui workload: este deliberat sărac în output, 1K tokeni de output per cerere la 100K citiri cached. Aceasta este singura formă în care avantajul de cache al lui Fable 5.1 decide factura.
Când măsori consumul real de tokeni în loc să îl presupui, imaginea se inversează. Artificial Analysis evaluează fiecare model la cost per task pe Intelligence Index, iar metoda include deja tokenii de input, hit de cache, scriere în cache, raționament și răspuns, deci cache-ul mai ieftin al lui Fable 5.1 este deja încorporat.
| Nivel de efort | GPT-6 Astra: scor/cost per task | Claude Fable 5.1: scor/cost per task |
|---|---|---|
| max | 61 / 1,67$ | 66 / 3,76$ |
| xhigh | 61 / 1,20$ | 65 / 2,72$ |
La efort maxim, Fable 5.1 costă de 2,25 ori cât Astra pentru același set de sarcini la același preț de listă. Artificial Analysis ajunge la aceeași concluzie pe indexul de cod, unde Astra se potrivește cu Fable 5 „la mai puțin de jumătate din cost, datorită unor câștiguri semnificative de eficiență a tokenilor”. Plaja pentru Astra coboară la 0,46$ per task la efort scăzut.
Fable 5.1 nu este penalizat aici de grila sa de tarife, ci de volumul de output. Artificial Analysis a măsurat că folosește aproximativ 1,7x tokenii de output ai lui Fable 5 la efort maxim, motiv pentru care costă cu 20% mai mult per task decât predecesorul, în ciuda reducerii la cache. Fără reducere, cifra ar fi aproximativ 5,16$, deci discountul chiar contează, doar că nu suficient.
Plătești acel premium pentru ceva. Fable 5.1 obține cu 5 puncte mai mult pe același index, și cu 4 puncte mai mult la xhigh. Dacă merită 5 puncte pentru 2,25x cost este decizia ta, nu a mea, dar varianta în care prețurile de listă identice înseamnă facturi identice nu rezistă în fața măsurătorilor.
Legendele propriilor grafice OpenAI indică aceeași direcție, cu valoarea pe care o are auto-raportarea unui vendor. Plasează costul API estimat per task al lui Astra cu aproximativ 31% sub Fable 5.1 pe Terminal-Bench Science 0.1, aproximativ 63% sub pe Terminal-Bench 4.0 și aproximativ 86% sub pe BenchCAD, măsurat la setările de efort alese de OpenAI pentru fiecare model.
Astra a câștigat ușor testul nostru per ansamblu, deși ambele modele au livrat o simulare funcțională din prima încercare.
Am rulat o singură sarcină grea pe ambele modele în condiții identice, nu mai multe superficiale. Testul ales pentru această comparație este o simulare fizică de la zero construită ca un singur fișier HTML, aleasă pentru că sondează exact ce ambii vendori susțin că au îmbunătățit: corectitudine susținută pe durata unui build lung, fără o bibliotecă de sprijin.
Această instanță este o versiune reîmprospătată a acelui test. Varianta publicată folosea un container pătrat rotitor, așa că acest rulaj înlocuiește cu un hexagon rotitor cu un obstacol central care contrarotește și masă proporțională cu dimensiunea, ceea ce ridică dificultatea păstrând închiderea ca trecere sau eșec neechivoc. Iată promptul, lipit mot-a-mot într-un chat nou pentru fiecare model:
Build a single-file HTML page (inline CSS and JS, canvas, no build step, no external libraries, no network) that simulates a few dozen balls of varying sizes bouncing under gravity inside a **slowly rotating hexagonal container**, with a **smaller counter-rotating obstacle at the centre** that the balls also collide with.
Ball mass should scale with size, so larger balls shove smaller ones around.
The balls should collide with each other, with the hexagon's walls, and with the central obstacle, and lose a little energy on each collision so the system settles rather than gaining energy over time.
Both the hexagon and the inner obstacle keep rotating throughout, so the balls should slosh and re-pile as they turn.

Ship it as one working file named `index.html` that starts animating on load.
Do not install packages.
Do not open, screenshot, or headless-render the page (no Playwright, Puppeteer, or Chrome).
Do not ask me clarifying questions — make reasonable assumptions and note them briefly in a comment at the top of the file.
Ambele modele rulează la efort de raționament ridicat, o încercare fiecare, fără retry-uri, în același agent de cod cu aceleași unelte. Scorarea este un check de rulare pass/fail mai întâi, apoi o rubrică de la 1 la 5 pentru corectitudinea fizicii, stabilitatea pe 30 de secunde și calitatea vizuală.
Astra a trecut verificarea de rulare și a obținut 5/5 pe toate cele trei axe ale rubricii. A ajuns acolo în 6 ture și 9 apeluri de unelte, iar mixul de unelte e partea interesantă: a scris fișierul, l-a citit înapoi de 5 ori, a făcut grep de două ori și a aplicat două patch-uri înainte să declare că e gata.
Simularea este corectă. 44 de bile, masa scalată cu aria, închidere menținută pe toată durata de 30 de secunde în timp ce hexagonul se rotește. Astra a dimensionat obstacolul interior mare relativ la cameră, astfel încât bilele continuă să se ciocnească de el în loc să se așeze undeva unde nu ajunge.
A construit și o întreagă pagină editorială în jurul simulării, cu un titlu serif, etichete monospaced cu letterspacing și un panou de telemetrie care raportează ratele de rotație în timp real. Nimeni nu a cerut asta, dar arată destul de bine, după părerea mea. A livrat și controale de pauză și restart, pe care promptul nu le-a cerut, dar care au făcut artefactul mai ușor de inspectat.
Astra rotește camera la 0,09 rad/s și obstacolul la -0,16 rad/s, cam de 3 ori mai încet decât Fable pe peretele exterior și de 5 ori mai încet pe obstacol. Mai ușor de urmărit și un test mai blând al frontierei în mișcare decât o rotație mai rapidă. Din moment ce promptul cere un container care se rotește lent, e în regulă.
| Măsură | GPT-6 Astra | Claude Fable 5.1 |
|---|---|---|
| Ture | 6 | 2 |
| Apeluri de unelte | 9 | 1 |
| Rulabilitate | Pass | Pass |
| Corectitudinea fizicii | 5 | 4 |
| Stabilitate în timp | 5 | 5 |
| Calitate vizuală | 5 | 4 |
| Scor pe rubrică | 5,0 | 4,3 |
Astra câștigă la calitate, iar marja e mai mare la prezentare decât la fizică. Diferența e în felul în care fiecare model a citit sarcina. Astra a tratat promptul ca pe un brief de interpretat, adăugând controale, un layout editorial complet și o rotație mai lentă, potrivită pentru vizionare. Fable l-a tratat ca pe o specificație de satisfăcut, a satisfăcut-o dintr-o singură scriere și și-a cheltuit efortul rămas pe un HUD de diagnostic.
Aceasta este o singură rulare per model, deci trateaz-o ca pe un punct de date, nu un benchmark. Raportează ture, nu tokeni sau cost, și sondează doar cod de simulare de la zero, nu utilizarea computerului sau raționamentul acoperite mai sus.
Deoarece tarifele de listă se potrivesc, decizia se reduce la forma workloadului, consumul măsurat de tokeni și agentul de cod pe care îl rulezi deja. Trei numere ar trebui să te influențeze: diferența de 4x la citirea din cache, pragul de suprataxă la 272K și costul măsurat per task de 2,25x.
| Suprafață | GPT-6 Astra | Claude Fable 5.1 |
|---|---|---|
| Aplicație pentru consumatori | ChatGPT Plus, Pro, Business, Enterprise | Claude web, mobil, desktop (Pro, Max, Team, Enterprise) |
| API de la producător | OpenAI API | Claude API |
| Platforme cloud | Amazon Bedrock, Microsoft Azure/Foundry | Amazon Bedrock, Google Cloud, Microsoft Azure/Foundry |
| Agenți de cod | Codex | Claude Code, Cursor |
| Routere terțe | OpenRouter, Vercel AI Gateway | OpenRouter, Vercel AI Gateway |
| ID model API | gpt-6-astra |
claude-fable-5-1 |
Două detalii de acces te pot opri înainte de primul apel. Astra este dezactivat implicit pentru workspace-urile enterprise până când un administrator îl activează, iar Fable 5.1 cere retenție de date 30 de zile și nu este suportat pe Priority Tier. Acoperirea în cloud este aproape la egalitate între cei doi, Google Cloud fiind în prezent singura platformă pe care Fable 5.1 o are, iar GPT-6 Astra nu.
Fiecare model este nativ în propriul său harness, Astra în Codex și Fable 5.1 în Claude Code, unde schimbi cu /model claude-fable-5-1 sau flagul --model. Prin API, schimbarea este un singur string, deși SDK-urile diferă.
from anthropic import Anthropic

client = Anthropic()
response = client.messages.create(
    model="claude-fable-5-1",  # OpenAI SDK equivalent: model="gpt-6-astra"
    max_tokens=16000,          # thinking plus response share this budget
    output_config={"effort": "high"},
    messages=[{"role": "user", "content": "Refactor this module..."}],
)
print(response.content[0].text)
Trei schimbări în Fable 5.1 îți vor rupe codul scris pentru Fable 5: selecția forțată a uneltelor returnează 400, modelele anterioare nu pot citi blocurile de gândire, iar blocurile de gândire sunt legate de istoricul exact dinaintea lor. Tutorialul API Claude Fable 5.1 parcurge toate cele trei, iar ghidul pentru începători al OpenAI API acoperă setarea echivalentă de cealaltă parte.
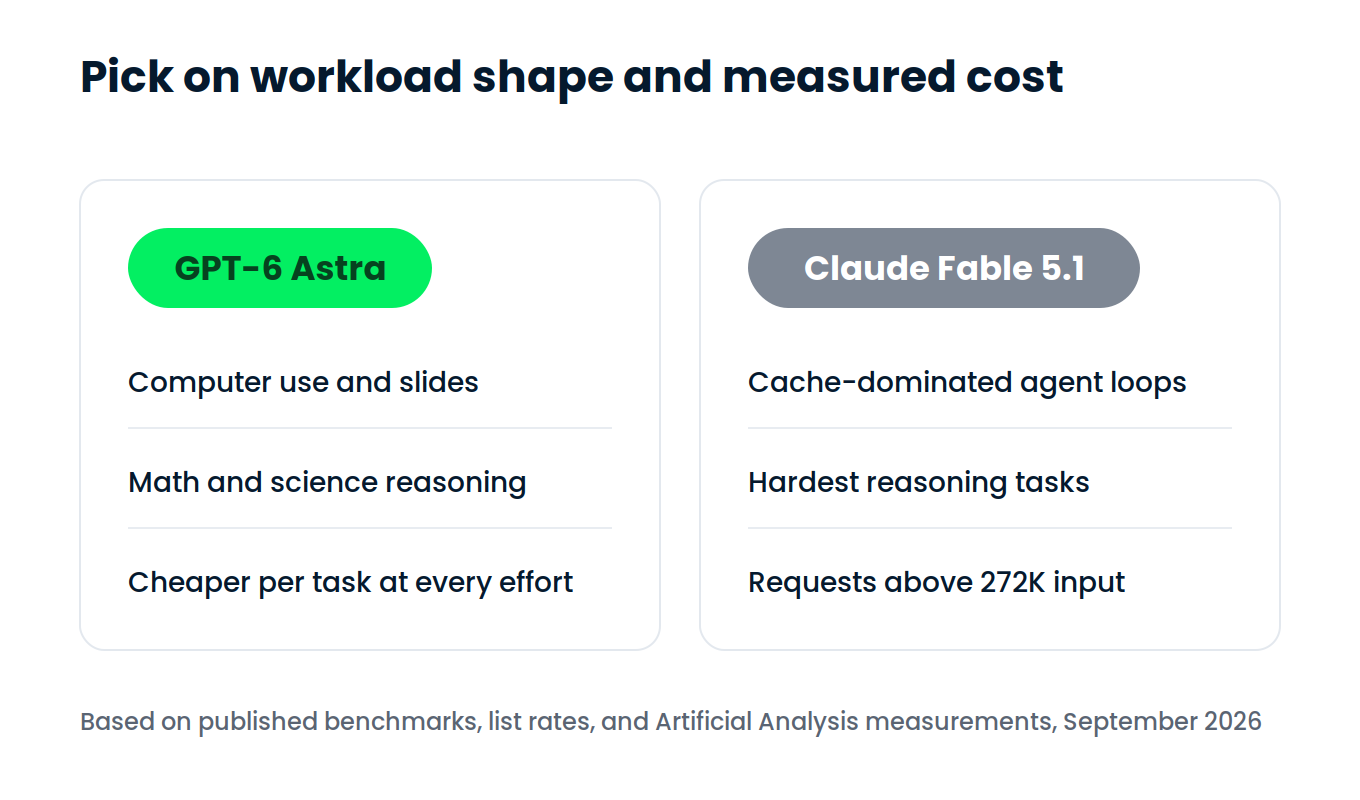
Alege după forma workloadului și costul măsurat, nu după tabelele de benchmark. GPT-6 Astra este mai puternic pentru agenți care navighează prin software, fac matematică sau produc artefacte gata de client și pare mai ieftin per task, în ciuda grilei de tarife identice. Claude Fable 5.1 îți aduce cel mai mare scor independent la raționament disponibil și costă mai puțin la cereri foarte mari și în bucle dominate de cache.
Grila de tarife este capcana în această comparație. Două modele la 10$ și 50$ par interschimbabile ca preț, iar singurul decalaj vizibil, citirile din cache, îl favorizează pe Anthropic de 4x. Apoi măsori cât cheltuie fiecare ca să termine o sarcină, iar Astra iese la 44% din costul lui Fable 5.1. Nu aș fi prezis asta din paginile de prețuri, și este singurul lucru pe care l-aș verifica pe traficul tău înainte de a decide.
Dacă vrei să lucrezi cu oricare model, nu doar să citești despre ele, îți recomand cursul nostru Introducere în modelele Claude pentru partea Anthropic și Lucrul cu OpenAI API pentru OpenAI.
Învață AI cu DataCamp!
Curs
Curs
Curs